
Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.7K
La maggior parte degli annunci di AI nel 2026 è stata una corsa al rialzo su chat e ragionamento, come si è visto con GPT-6 Astra di OpenAI e Fable 5.1 di Anthropic.
TypeSafe propone un approccio diverso. Il 15 settembre 2026, l'azienda ha annunciato un modello che non genera affatto testo.
Il modello si chiama Jev e appartiene a una nuova categoria di modelli di AI che TypeSafe definisce modelli System One.
Invece di produrre stringhe un token alla volta, Jev prende in input uno stato di programma non strutturato e restituisce decisioni tipizzate e probabilistiche in un'unica passata parallela.
Le dichiarazioni di punta di TypeSafe sono che Jev è 40-200 volte più veloce dei frontier LLM su task comparabili, costa $0,042 per milione di token in input con output gratuito e matematicamente non può allucinare o produrre errori di tipo.
In questo articolo, vedremo cosa sia davvero un modello System One, in cosa Jev differisca da un LLM standard, cosa mostrino i benchmark di workflow rispetto ad altri modelli e dove penso si collochi in uno stack reale.
Per approfondire i modelli con cui viene confrontato Jev, vedi i nostri confronti tra Jev e GPT-6 Astra, GPT-5.6 Terra e Claude Sonnet 5 e Claude Opus 5 e GPT-5.6 Sol. Consiglio anche di dare un'occhiata alla nostra guida alle alternative a Jev e al nostro tutorial sull'API di Jev.
Un modello System One è un modello di AI di frontiera che restituisce decisioni probabilistiche tipizzate invece di testo.
Gli fornisci un blocco di stato e un insieme di domande tipizzate; le valuta tutte in parallelo e restituisce risposte strutturate con punteggi di confidenza calibrati, senza generazione di stringhe e senza nulla da fare parsing. TypeSafe ha coniato il nome della categoria con Jev, la sua prima release pubblica del settembre 2026.
Jev è un modello di frontiera progettato per prendere decisioni rapide e strutturate che il software può consumare direttamente, senza uno step di parsing o validazione.
È la prima release pubblica della classe System One di TypeSafe, disponibile in early access da settembre 2026 e prende il nome dall'economista William Stanley Jevons.
Il nome richiama Pensieri lenti e veloci di Daniel Kahneman.
Il Sistema 1 di Kahneman è veloce e intuitivo; il Sistema 2 è lento e deliberativo.
Gli LLM esistenti, con chain-of-thought e tracce di ragionamento di più secondi, stanno saldamente nel territorio del Sistema 2.
Diogo Almeida, fondatore di TypeSafe e co-inventore di ChatGPT in OpenAI, sostiene che il gap di automazione deriva dal fatto che tutti costruiscono modelli di Sistema 2, quando la maggior parte delle decisioni software vuole una risposta veloce da Sistema 1.
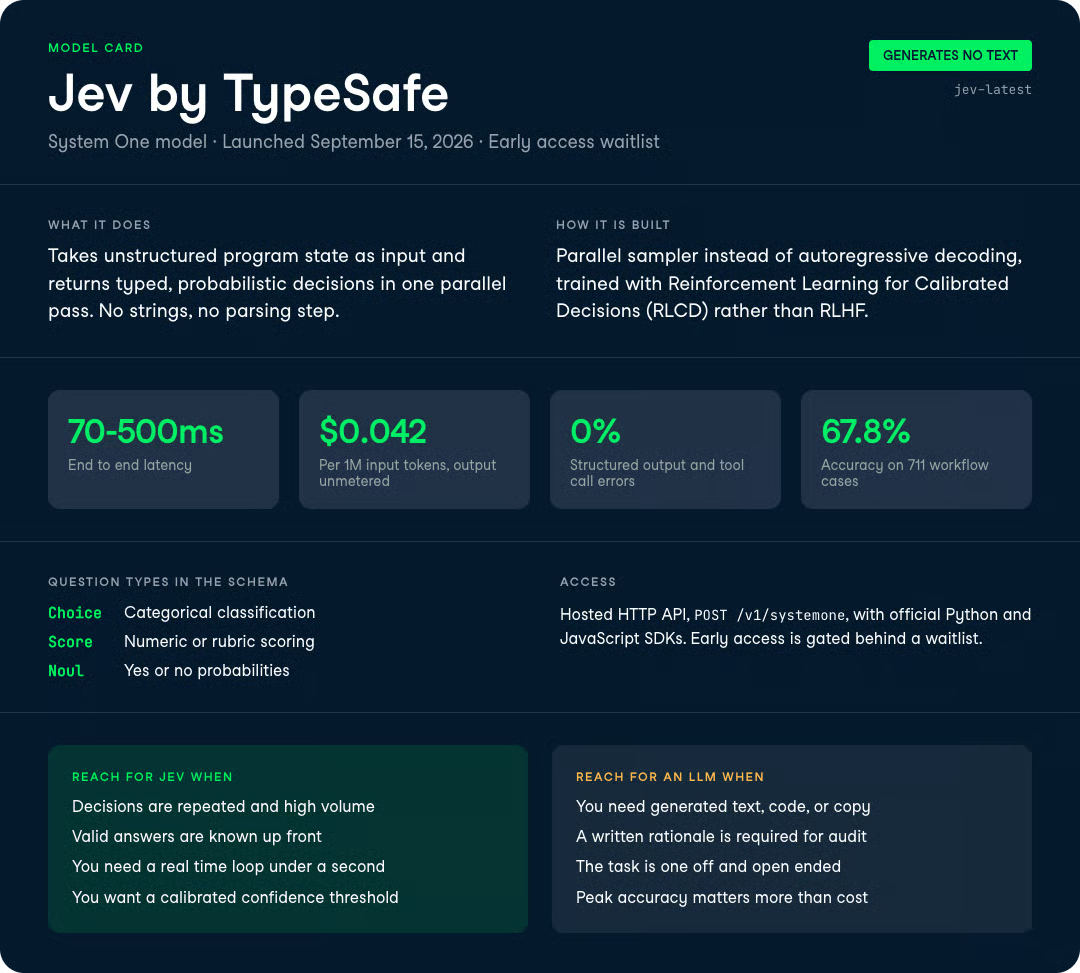
Architettonicamente, Jev si discosta davvero da un LLM transformer.
Utilizza una nuova architettura con un campionatore parallelo che genera tutti gli output in una singola query invece che in modo autoregressivo, e un metodo di training che TypeSafe chiama Reinforcement Learning for Calibrated Decisions (RLCD).
Dove GPT-5.6 e Opus 5 sono addestrati con RLHF e ricompense verificabili per produrre testo preferito dagli umani, RLCD ottimizza per probabilità calibrate su decisioni strutturate.
Il risultato, secondo i numeri di TypeSafe, è un tasso di errore dell'output strutturato pari allo 0% e una latenza end-to-end di 70-500 ms.
Una nota sul metodo di training RLCD: TypeSafe lo posiziona direttamente in contrapposizione a RLHF e RLVR. Mentre RLHF ottimizza per risposte in chat preferite dai valutatori umani e RLVR per output che un programma può verificare, RLCD ottimizza per probabilità epistemicamente oneste sui task decisionali. Ecco perché la calibrazione è una proprietà di prima classe di Jev invece di qualcosa aggiunto a posteriori via prompt.
Ecco il contrasto architetturale di base in una tabella, perché la differenza è facile da perdere nel testo.
| Proprietà | Frontier LLM (GPT-5.6, Opus 5) | Jev (modello System One) |
|---|---|---|
| Output | Stringhe generate, da fare parsing | Valori tipizzati, garantiti dallo schema |
| Campionamento | Sequenziale, un token alla volta | Parallelo, singola query |
| Prezzo input / 1M token | $0,20-$10 | $0,042 |
| Prezzo output | ~5x l'input | Gratuito |
| Latenza | 3-329 s | 70-500 ms |
| Allucinazioni / errori di tipo | Possibili | Impossibili per costruzione |
| Confidenza | Sovraconfidente, incoerente | Calibrata per output |
Tutte le funzionalità derivano da una scelta progettuale: Jev rinuncia del tutto alla generazione di stringhe.
Questa sottrazione è ciò che consente velocità, prezzo e garanzie di tipo.
Jev restituisce valori strutturati type-safe i cui output possibili sono definiti nel tuo schema prima della chiamata.
L'API espone un piccolo set di tipi di domanda:
Pensalo come una chiamata di funzione con intelligenza di frontiera: lo stato non strutturato entra, decisioni probabilistiche tipizzate escono.
Se devi smistare un ticket di supporto, potresti definire una Choice su {billing, technical, sales, spam} e uno Score per l'urgenza da 0 a 100, e Jev compila entrambi in un'unica passata. Non c'è JSON da fare parsing e nessun rischio che il modello divaghi scrivendo un paragrafo.
La riserva ovvia è che questo funziona solo quando lo spazio delle risposte valide è limitato e noto a priori. Jev è inutile per la generazione open-ended e non scrive lo schema per te.
Ogni output di Jev è accompagnato da una probabilità calibrata, il che significa che maggiore confidenza corrisponde davvero a maggiore accuratezza.
Questa è la funzione che credo sarà più utile nella pratica.
Gli LLM standard sono notoriamente sovraconfidenti anche quando li inviti esplicitamente a fornire una probabilità.
Se un modello può classificare correttamente qualcosa il 95% delle volte ma non sa dirti in quale 5% è incerto, non puoi automatizzare in modo sicuro attorno a esso.
La calibrazione di Jev ti permette di impostare una soglia di confidenza e di agire in automatico solo al di sopra di essa, indirizzando i casi incerti a un umano o a un LLM più lento.
Il limite da segnalare è che Jev ti fornisce un numero, non una motivazione.
Non c'è una spiegazione in linguaggio naturale del perché abbia assegnato un certo punteggio, cosa che conta per il debug e per gli audit in domini regolamentati.
Poiché gli output di Jev sono vincolati dallo schema, è matematicamente impossibile che produca un valore non valido o un errore di tipo.
TypeSafe riporta uno 0% di errori negli output strutturati e uno 0% di errori nelle chiamate agli strumenti.
Per confronto, nel test di output strutturato di TypeSafe, luna e terra di OpenAI erano allo 0,58%, Opus 5 di Anthropic al 5,73% e Claude Haiku 4.5 al 45,5%.
Sulle tool call, GPT-5.6 Sol è il peggiore con il 17,0%.
Una tool call allucinata è un fastidio in un agente interattivo, ma un vero problema quando è sepolta diversi livelli in profondità in una catena di dipendenze con garanzie di latenza.
Jev genera l'intero output in una singola query parallela invece di emettere un token alla volta.
Da qui deriva la latenza di 70-500 ms.
Quella velocità apre casi d'uso che gli LLM token-by-token non possono toccare.
La demo di TypeSafe mostra Jev che gioca a Doom reagendo allo stato di gioco strutturato (fornito come testo) circa 10 volte al secondo, a circa $7/ora di inferenza.
Il punto non è che Jev giochi bene a Doom, un bot scriptato lo batterebbe, ma che può prendere decisioni reattive dentro un loop real-time dove una chiamata LLM da 3-30 secondi è improponibile.
Il costo per caso di Jev, circa $0,0004, lo rende adatto a eseguire una decisione su ogni riga di un grande dataset, cosa proibitiva in termini di costo con un LLM di frontiera.
TypeSafe lo propone come trasformare petabyte di dati grezzi in feature e insight facendo map-reduce di decisioni sull'insieme.
Un esempio concreto è il punteggio di ogni recensione prodotto in una tabella da 50 milioni di righe per sentiment e violazioni di policy, che costerebbe circa $20 in chiamate decisionali con Jev alla tariffa dichiarata, contro migliaia con un LLM fatturato a token.
In breve, Jev si colloca più o meno dove stanno gli LLM di frontiera di fascia media in termini di accuratezza, battendo però tutti su costo e latenza di uno o due ordini di grandezza.
Tutti i numeri seguenti provengono dalle tabelle di valutazione di TypeSafe e non sono ancora emerse riproduzioni indipendenti su larga scala, quindi trattali come dati riportati dal fornitore.
TypeSafe ha costruito una valutazione personalizzata su 4 workflow (risposta a incidenti di sicurezza, osservabilità di trace di agenti, elaborazione fatture e customer service), valutando ogni modello contro le previsioni medie di GPT-6 Astra e Fable di Anthropic.
Jev ha in media il 67,8% di accordo con le risposte di riferimento.
Ecco come si confronta con i frontier LLM sugli stessi workflow:
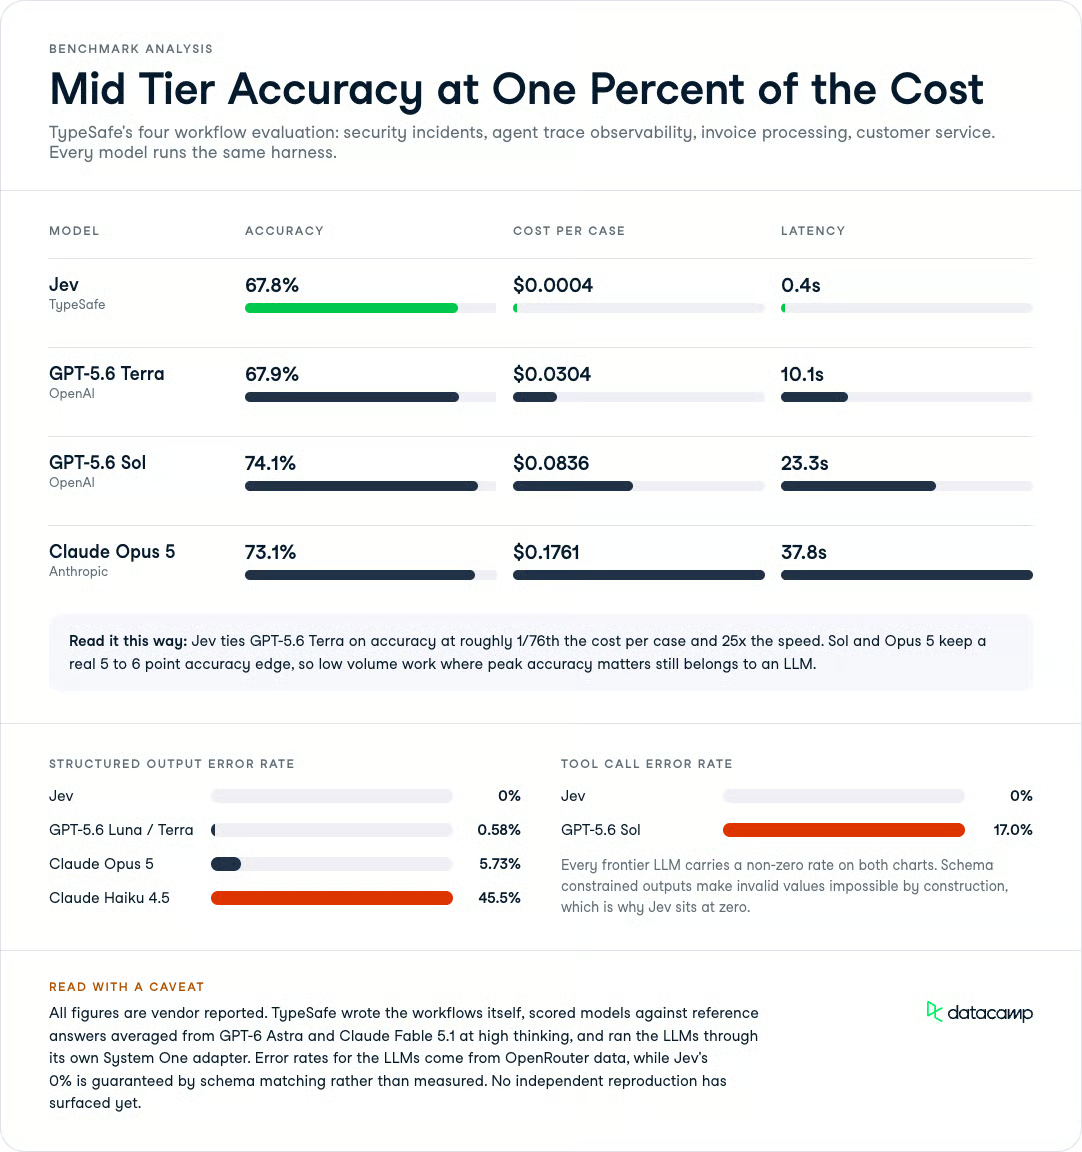
Il pattern è coerente: Jev scambia qualche punto di accuratezza rispetto ai modelli migliori per enormi risparmi in costo e latenza.
| Modello | Accuratezza | Costo per caso | Latenza |
|---|---|---|---|
| Jev (TypeSafe) | 67,8% | $0,0004 | 0,4 s |
| GPT-5.6 Terra | 67,9% | $0,0304 | 10,1 s |
| GPT-5.6 Sol | 74,1% | $0,0836 | 23,3 s |
| Claude Opus 5 | 73,1% | $0,1761 | 37,8 s |
Jev è di fatto alla pari con Terra sull'accuratezza, pur costando circa 1/76 per caso e andando 25 volte più veloce.
I modelli al top per accuratezza, Sol al 74,1% e Opus 5 al 73,1%, mantengono un reale vantaggio di 5-6 punti, quindi se ti serve il massimo dell'accuratezza su un task a basso volume, l'LLM vince ancora.
Nei grafici di affidabilità, Jev è allo 0% di errore sia sugli output strutturati sia sulle tool call, che è il punto centrale del design vincolato dallo schema.
Tutti i frontier LLM hanno qui un certo tasso di fallimento diverso da zero.
Spiccano due numeri. Claude Haiku 4.5 riporta un 45,5% di errori sugli output strutturati, e GPT-5.6 Sol un 17,0% di errori nelle tool call.
Non sono casi limite oscuri; sono il tipo di errori che rompono una pipeline non presidiata non appena gira in volume.
Jev restituisce probabilità ma non motivazioni in linguaggio naturale, cosa che i revisori segnalano come un vero vincolo per il debug e per gli audit in domini regolamentati.
Se un team compliance deve sapere perché una domanda di prestito è stata valutata in un certo modo, un semplice numero di confidenza non li soddisferà.
La soluzione pratica è riservare Jev al livello di instradamento ad alto volume ed elevare i casi segnalati o a bassa confidenza a un modello che possa produrre una spiegazione scritta.
Così mantieni i benefici di throughput preservando una traccia di audit dove è legalmente richiesta.
TypeSafe è piacevolmente trasparente sui bias delle sue valutazioni.
I workflow sono stati scritti dal team di capacità del modello interno, quindi qualche bias può esistere, e le risposte di riferimento provengono da modelli OpenAI e Anthropic, il che probabilmente sottostima la performance relativa di Jev e quella dei modelli di DeepSeek.
Gli LLM in questi test passano attraverso l'adapter open-source System One di TypeSafe, che li forza a emettere decisioni strutturate compatibili con l'API.
TypeSafe afferma che sia il modo più accurato per ottenere decisioni da un LLM, sebbene sia più lento e più costoso che lasciare al modello di rispondere senza probabilità.
Finché una suite indipendente non riproduce questi risultati su un harness neutrale, leggerei la parità di accuratezza come promettente più che definitiva.
Jev non compete con GPT-5.6 o Opus 5 per gli stessi lavori, quindi la domanda utile è a quale classe di modelli ricorrere.
La distinzione dipende dal fatto che il tuo task richieda una decisione limitata o una risposta open-ended.
| Caso d'uso | Scegli | Perché |
|---|---|---|
| Classificare o instradare milioni di ticket | Jev | Output limitati, contano costo e throughput |
| Valutare o mettere guardrail agli output LLM su larga scala | Jev | Probabilità sì/no rapide, nessun rischio di allucinazioni |
| Decisioni in tempo reale dentro un loop applicativo | Jev | 70-500 ms di latenza vs 3-30 s per un LLM |
| Scrivere codice, email o riassunti | Frontier LLM | Jev non genera alcun testo |
| Ragionamento multi-step una tantum con spiegazione | Frontier LLM | Serve una motivazione e un output open-ended |
In pratica, i due si combinano bene: usa Jev come livello decisionale veloce che classifica, assegna punteggi e instrada, e passa la piccola quota di casi difficili o open-ended a un modello come Terra o Opus 5. La calibrazione di Jev rende quel passaggio pulito, perché puoi instradare in base a una soglia di confidenza.
I prezzi di Jev sono dove il pitch diventa aggressivo.
I token di input costano $0,042 per milione ($42 per miliardo) e i token di output non sono misurati, descritti da TypeSafe come troppo economici per essere conteggiati perché il modello restituisce decisioni strutturate invece di lunghi testi.
Per dare un'idea, quella tariffa di input è circa 1/48 di $2,00 per milione di token di input di GPT-5.6 Terra, e Terra fattura anche $12,00 per milione di token di output in aggiunta.
A livello di workflow, le valutazioni interne di TypeSafe collocano Jev a circa $0,0004 per caso contro $0,0304 per Terra e $0,0836 per Sol.
TypeSafe ammette apertamente di non poter dimostrare che i prezzi non siano sovvenzionati e afferma che il lungo periodo dovrà dimostrare la sostenibilità, sebbene si aspetti che i prezzi scendano piuttosto che salire.
Jev è in early access dal 15 settembre 2026, dietro una waitlist con sviluppatori che vengono abilitati nel tempo. Non ho visto alcun programma esplicito di crediti gratuiti o trial nei materiali di lancio.
Jev è un modello proprietario, ospitato, raggiungibile tramite l'HTTP API di TypeSafe. Tuttavia, per accedere, dovrai iscriverti alla waitlist e seguire la community sul TypeSafe AI Blog.
L'endpoint è POST https://api.typesafe.ai/v1/systemone e il route del modello in early access è indicato come jev-latest.
TypeSafe fornisce SDK ufficiali per Python e JavaScript oltre alla raw HTTP API.
Definisci i tipi di domanda (Choice, Score, Noul) nello schema e passi lo stato del tuo programma come input; la risposta torna come valori tipizzati con probabilità calibrate.
Ecco la forma minima di una richiesta contro la route serverless:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())
Per il riferimento completo dello schema e la configurazione degli SDK, la fonte autorevole sono i documenti ufficiali di TypeSafe.
TypeSafe sta facendo una scommessa strategica: molta della roba che oggi chiediamo agli LLM è in realtà decisione strutturata mascherata da chat.
Se è così, il vantaggio di costo di 40-400 volte di Jev e la garanzia di errori di tipo allo 0% cambiano l'economia dell'automazione ad alto volume in un modo che GPT-5.6 e Opus 5 non possono eguagliare sul prezzo.
La mia impressione onesta è che Jev sia davvero utile come livello rapido di decisione e guardrail, e la storia della calibrazione è la parte su cui costruirei davvero.
Le domande aperte sono se un benchmark indipendente confermerà la parità di accuratezza e se i prezzi reggeranno una volta finita l'eventuale sovvenzione.
Se vuoi capire i problemi decisionali per cui è costruito Jev, il nostro percorso di competenze AI Fundamentals copre i concetti di classificazione e calibrazione alla base.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



