
Programma
Ingegnere AI associato per sviluppatori
26 h
L’ho già detto: le aspettative devono essere allineate al modello. Questo è particolarmente vero nel caso di Jev e ha soprattutto a che fare con la sua classe di modelli, indicata come System One.
Un modello System One restituisce decisioni tipizzate invece di testo. Invi un blocco di stato più un insieme di domande, ciascuna con uno spazio di risposta che definisci tu, e il modello restituisce una risposta per domanda con probabilità allegate. Nulla è prodotto token per token, quindi non c’è nessuna stringa da fare il parse e nessun JSON malformato da riparare. TypeSafe ha coniato questo termine riferendosi alla famosa distinzione di Daniel Kahneman:
Poiché lo spazio delle risposte è uno schema dichiarato dal tuo codice, i modelli System One per progettazione non possono mai restituire una categoria che non hai definito. Questo significa che non possono mai andare fuori schema. Detto questo, possono comunque sbagliare, e vedremo più avanti alcuni casi insidiosi.
TypeSafe è uscita dallo stealth il 15 settembre 2026 con Jev in early access, riportando risposte tra 70 e 500 ms e $0,042 per milione di token in input con output gratuito. Sul proprio benchmark a quattro workflow, Jev si attesta intorno al 68% di accuratezza, più o meno al livello di un LLM di fascia media a una frazione del costo.
Per maggiori informazioni su funzionalità e prestazioni dei benchmark, ti consiglio di leggere la nostra guida a Jev.
Scrivi le risposte valide prima di effettuare la chiamata. Se puoi enumerarle, hai un problema “a forma di Jev”:
Scegli un LLM quando l’output è prosa o codice, quando lo spazio delle risposte è aperto o quando il compito richiede diversi passaggi di ragionamento concatenati. Jev è anche lo strumento sbagliato per tutto ciò che è numerico, e tornerò sul perché tra poco.
Prima di scrivere codice, crea un account TypeSafe e apri il Playground. Qui puoi incollare del testo come stato, aggiungere domande e vedere gli oggetti risposta completi senza installare nulla. È il modo più veloce per capire cosa restituisce ogni tipo di domanda (e per scoprire se la tua domanda è formulata male).
Userò un ticket di supporto come stato per tutti e tre gli esempi:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Ogni tipo di domanda accetta instructions, la domanda in linguaggio naturale a cui vuoi una risposta. Ciò che cambia tra loro è criteria e ciò che viene restituito.
Una Choice sceglie un’opzione da un insieme definito da te.
Passi criteria come un dizionario che mappa ogni opzione a una descrizione, da 1 a 255, e la risposta torna con:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Per vedere l’output in codice che riceveresti anche via API, fai clic sul pulsante </> in alto a destra e poi su Run per far rispondere Jev alla domanda.
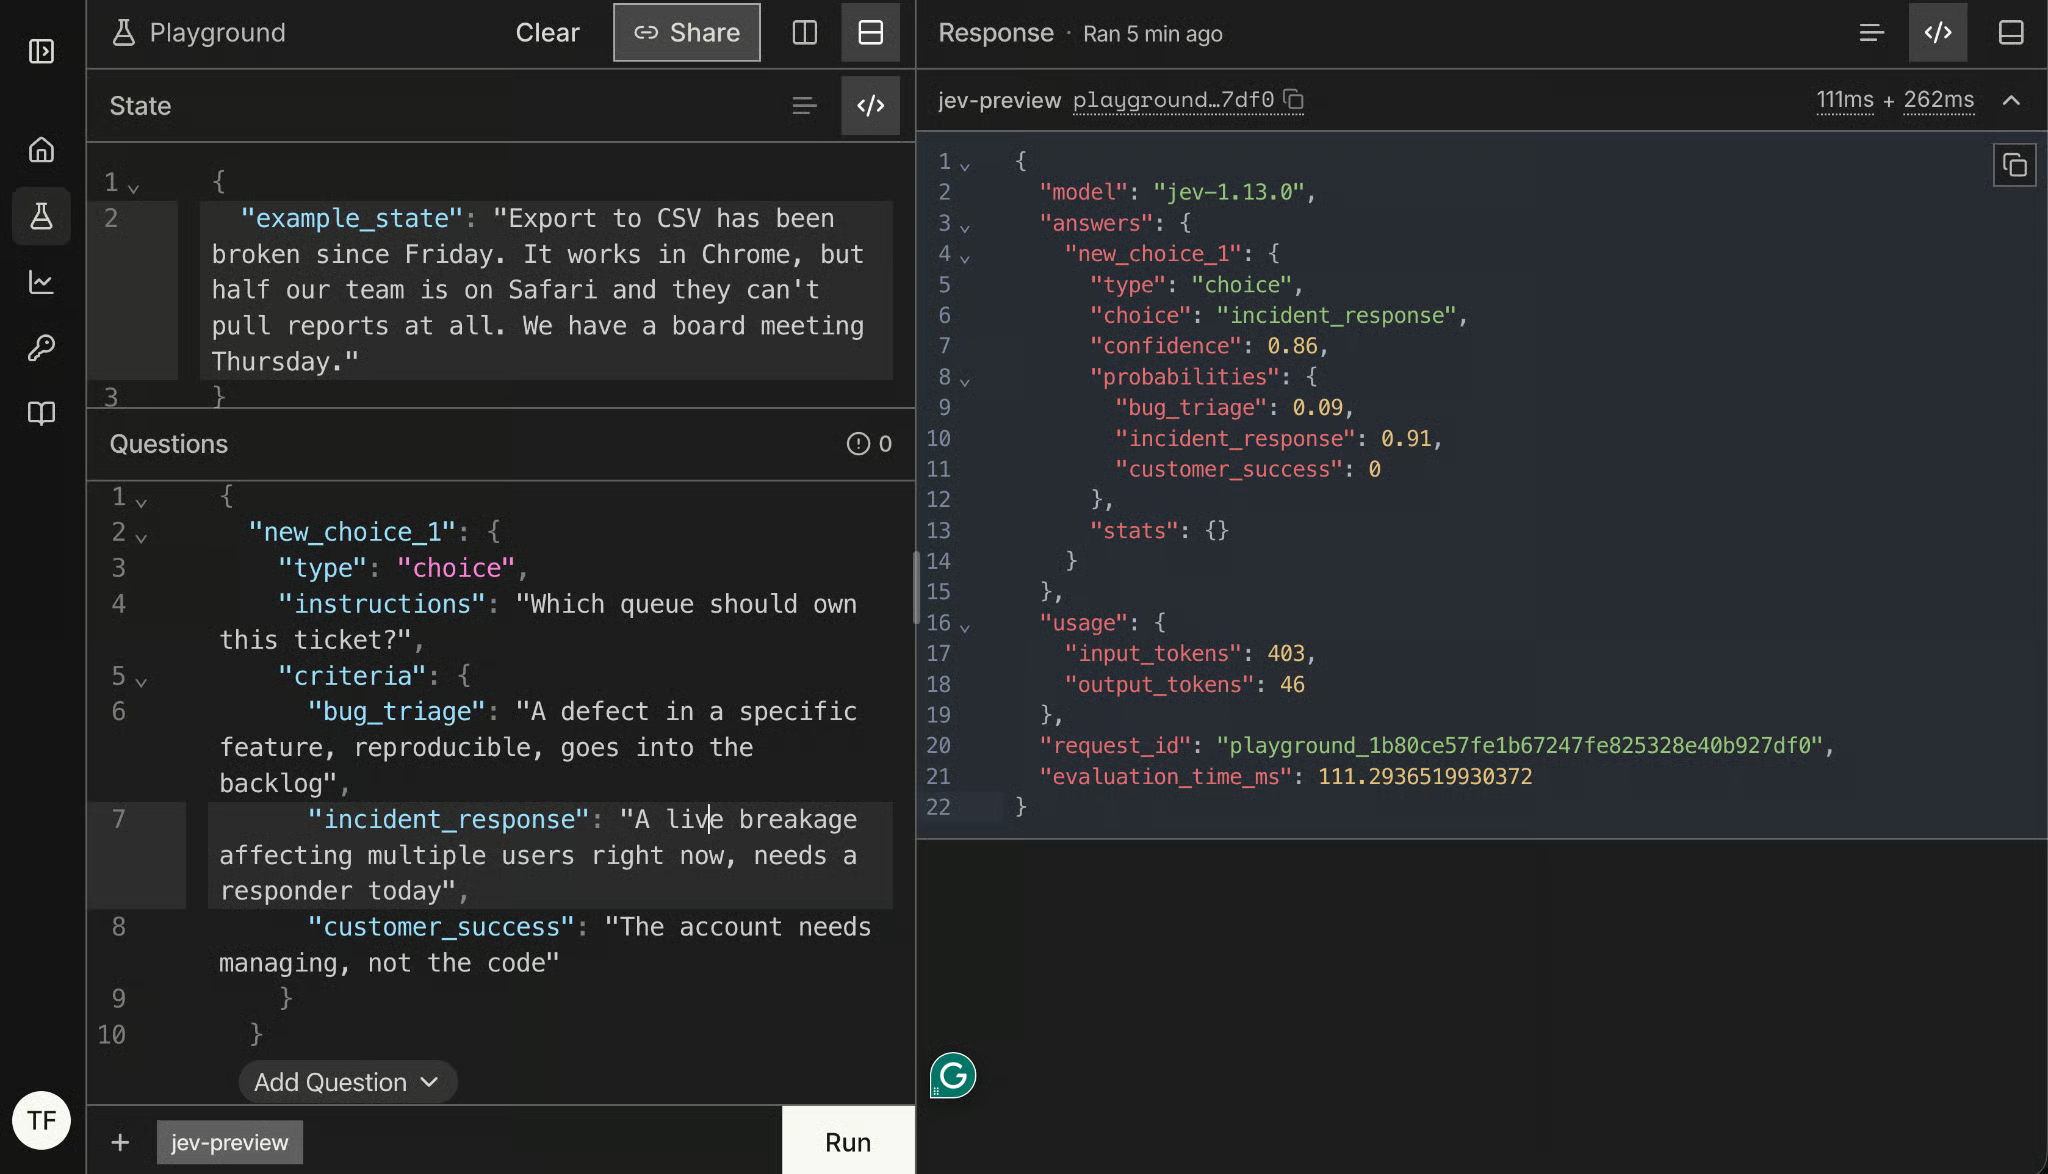
In questo caso, incident_response è la choice con una probabilità del 91%. La confidence di Jev per la scelta è 86%.
La distribuzione completa è la parte a cui vale la pena prestare attenzione.
choice ti dice solo quale opzione ha vinto.
probabilities ti dice di quanto.
Sono informazioni diverse quando stai per instradare un ticket in automatico. Una ripartizione 0,41/0,38/0,21 e quella 0,91/0,09/0 che abbiamo ricevuto potrebbero entrambe restituire la stessa choice.
Uno Score valuta lo stato rispetto a livelli ordinati. Passi criteria come un’array di 2–10 descrizioni di livello, dalla più bassa alla più alta, e la risposta include uno score, una legend che mappa ogni posizione alla tua descrizione, una probabilità per livello e la confidenza.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}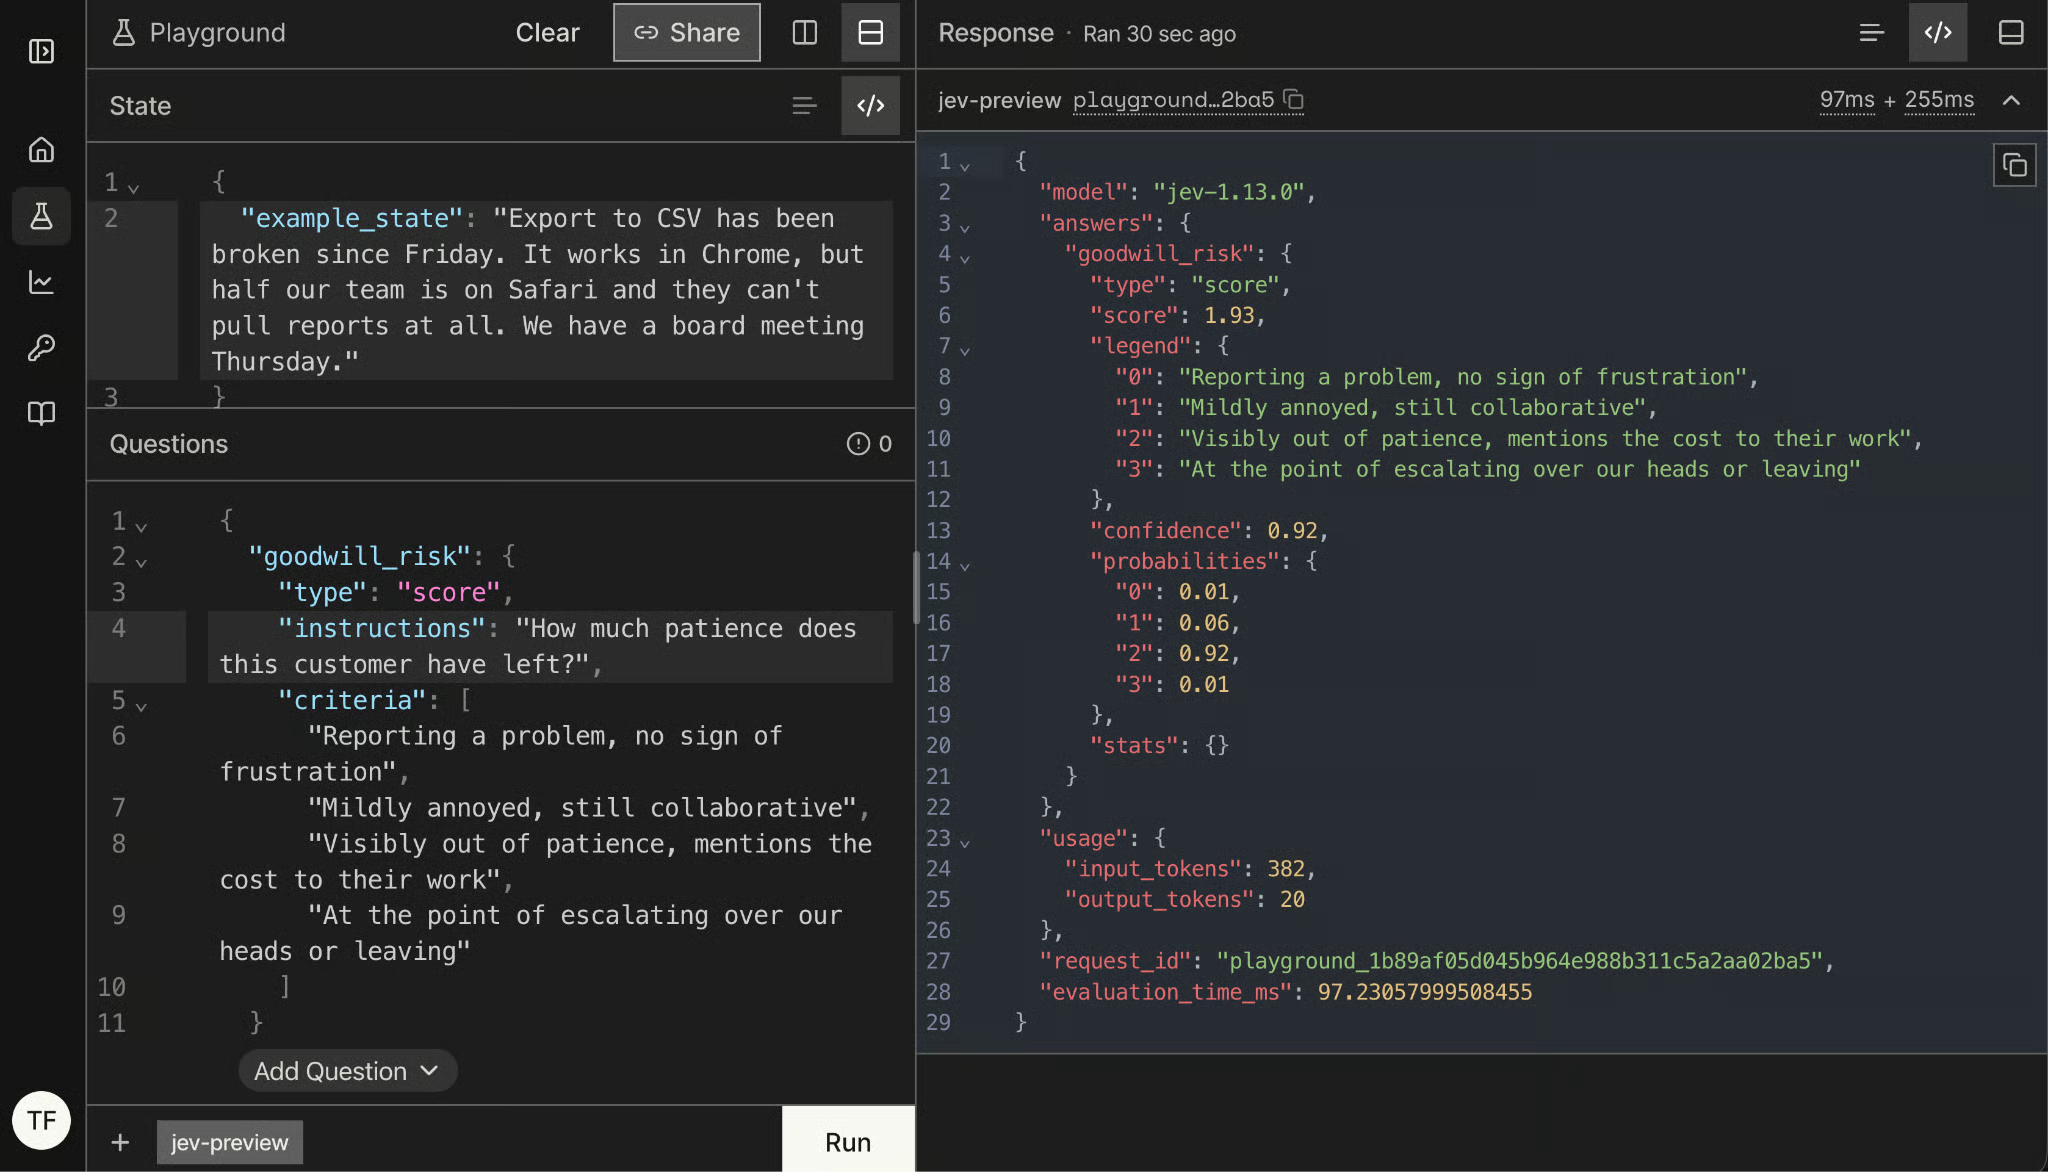
Lo score può cadere tra i tuoi livelli, ed è proprio questo il punto della legend. Uno score di 1,93 qui significa che il modello è diviso tra “lievemente infastidito” e “visibilmente a corto di pazienza”, con una forte preferenza per il secondo, che è una lettura plausibile di un ticket che resta cortese mentre indica una scadenza che rischia di saltare.
Di nuovo, leggi la distribuzione delle probabilities più che il numero da solo: probabilità concentrata su un livello significa una risposta decisa, probabilità spalmata su tre significa che hai ottenuto una media invece di un giudizio.
Un Noul è il tipo per domande binarie, e il nome è stato coniato da TypeSafe. criteria è opzionale, anche se puoi descrivere cosa significano true e false, cosa che vale la pena fare quando “sì” potrebbe essere interpretato in due modi.
Formula la domanda in modo che un valore alto significhi sì. La documentazione di TypeSafe lo dice esplicitamente, e un Noul il cui true mappa a “no” ha prestazioni misurabilmente peggiori.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}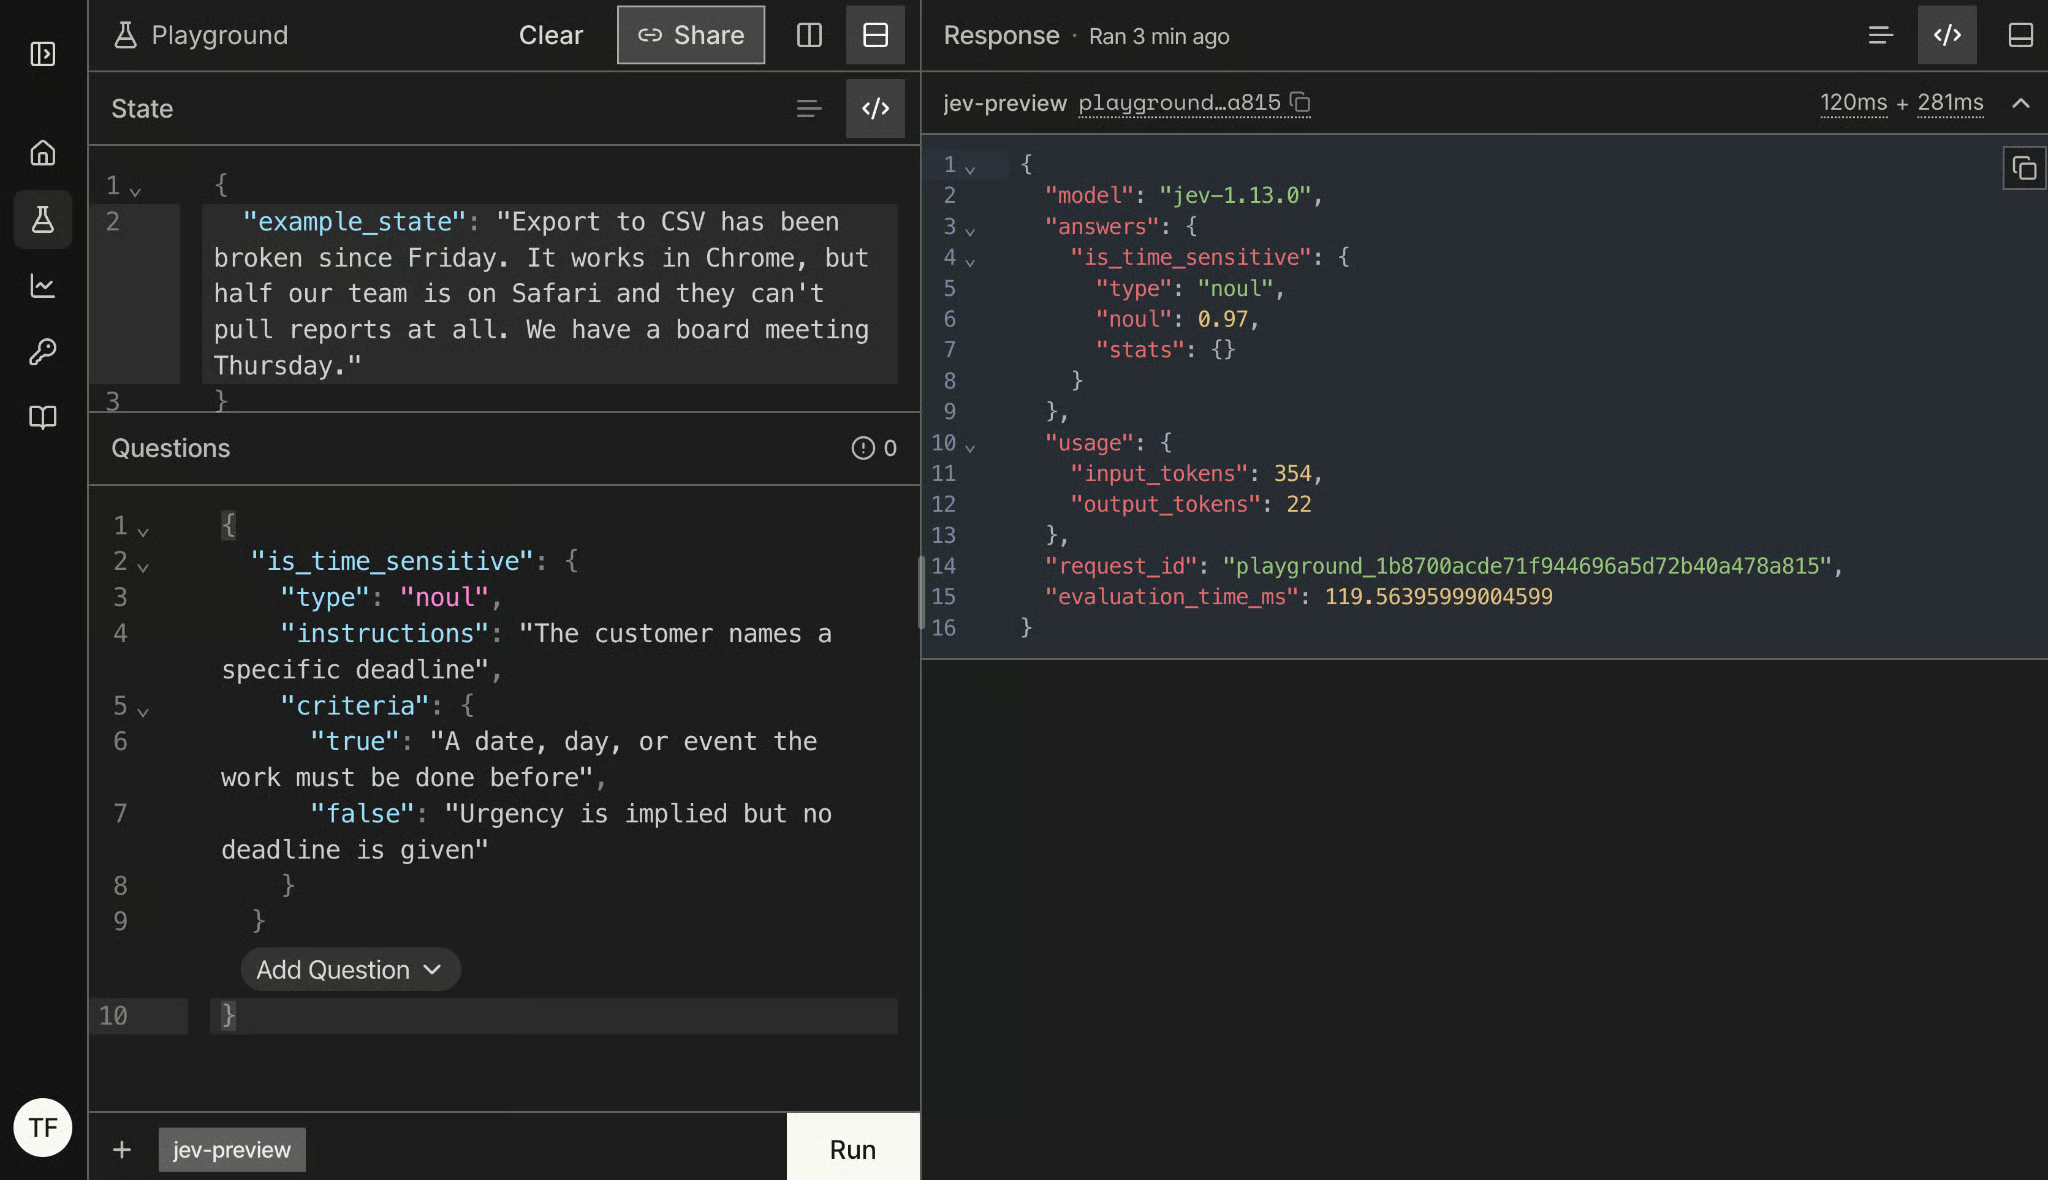
Dato che nello stato è menzionata una riunione del consiglio giovedì, l’alto valore noul di 0,97 era atteso.
Choice e Score restituiscono la confidenza insieme alle probabilità. Un Noul no, e questo manda in confusione: vale la pena essere precisi sul perché.
Confidenza e probabilità sono assi separati. Per una Choice, le probabilità dicono come il modello distribuisce la sua convinzione tra le opzioni, e la confidenza dice quanto fermamente sostiene quella risposta, motivo per cui una Choice può restituire un’opzione top a 0,85 con confidenza 0,78. Un Noul ha solo due esiti, quindi la singola probabilità porta già entrambe le informazioni: 0,97 è un sì deciso, 0,03 è un no deciso e 0,52 è il modello che ti dice che non ne ha idea.
Questo significa che la distanza da 0,5 è il tuo segnale di decisione, non un campo separato da leggere. Significa anche che non puoi portare una soglia da un Noul a una Choice, e tornerò su questo nella sezione sulle irregolarità, perché morde più di quanto sembri.
Per seguire ti serviranno solo Python 3.10+ e una chiave di early access TypeSafe.
Installa lo SDK:
pip install typesafe-sdkOppure con uv:
uv add typesafe-sdkCrea quindi una chiave nella console TypeSafe ed esportala. Il client legge TYPESAFE_API_KEY dall’ambiente, quindi non la passerai mai nel codice:
export TYPESAFE_API_KEY="your-key"I seguenti import ti danno tutto ciò che hai visto nel playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul e Score sono gli stessi tipi di domanda che hai appena cliccato, come oggetti Python.
TypeSafeClient è il client sincrono, e c’è un AsyncTypeSafeClient con la stessa interfaccia se chiami Jev da un servizio async. Entrambi funzionano come context manager, che è ciò che userei in qualsiasi cosa più lunga di uno script:
with TypeSafeClient() as client:
...Lasciato com’è, il client chiama jev-latest, che si muove ogni volta che TypeSafe rilascia una nuova versione, e che useremo per tutto il tutorial. Per qualsiasi cosa in cui hai già tarato una soglia, fissa invece la versione:
client = TypeSafeClient(model="jev-1.13.0")La risposta ti dice quale modello ha effettivamente risposto in ogni caso, e c’è una sezione verso la fine sul perché dovresti registrarlo nei log.
Per effettuare una chiamata API a Jev, devi definire un elemento response usando TypeSafeClient e la funzione system_one(), che prende il contesto della domanda come parametro state e le questions nello stesso formato visto nel playground.
Possiamo creare una chiamata che risponda a tutte e 3 le nostre domande del playground, dato che condividono lo stesso state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Le risposte tornano sotto gli stessi nomi che hai scelto per ogni domanda, ed è il dettaglio che rende il tutto piacevole da usare:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Se la tua prima chiamata fallisce con un TypeError su output_buffer_limit: è un disallineamento di versione nel backend di compressione dello SDK, non del tuo codice. Lo SDK include un proprio client HTTP, httpx2, che decomprime le risposte tramite zstandard e brotli, e una copia più vecchia di uno dei due non ha l’argomento con cui viene chiamata. pip install -U typesafe-sdk httpx2 zstandard brotli l’ha risolto per me.
Due elementi in quell’output meritano una pausa.
Primo, response.model ha restituito jev-1.13.0, non jev-latest. Hai chiesto l’alias mobile e Jev ti ha detto quale versione ha effettivamente risposto, che è il motivo per cui registrare quel campo è abbastanza economico da valere la pena.
Secondo, gli oggetti risposta sono tipizzati per tipo di domanda, quindi .choice, .score e .noul sono attributi reali e il tuo editor li conosce. Non c’è alcuna stringa JSON in questo codice, nulla da fare il parse e nessun ramo per la chiamata tornata malformata. Se preferisci raggruppare, lo SDK espone anche response.choices, response.scores e response.nouls, con le stesse chiavi.
Controlla anche response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78I token in output sono a una cifra e gratuiti. Paghi per lo stato e per le domande, quindi puoi controllare completamente la leva dei costi decidendo quanta context inviare. Questo conta più di quanto sembri e torna nella sezione sulle irregolarità: uno stato gonfio ti costa denaro e accuratezza allo stesso tempo.
Questo è uno dei casi d’uso per cui Jev è costruito. Arriva un ticket di supporto e qualcosa deve decidere in quale coda inserirlo, se prima deve vederlo un umano e con quale urgenza. Ognuno di questi è un giudizio con uno spazio di risposta che puoi scrivere prima che il ticket arrivi.
La regola di design da affermare subito: Jev decide cosa è, il tuo codice decide cosa succede. Jev non instrada mai niente. Restituisce numeri, e l’instradamento vive in una normale funzione che puoi leggere, testare e modificare senza toccare il modello.
Le domande in una singola richiesta vengono valutate in parallelo, quindi una sesta domanda ti costa i token in cui è scritta e quasi nessuna latenza aggiuntiva. Questo cambia come chiedi. Con un LLM avresti fatto batching con attenzione per risparmiare round-trip, qui invece chiedi tutto quello che potresti voler sapere su un certo contesto, incluse domande che probabilmente ignorerai.
Espandiamo le domande precedenti con altre tre Noul che ci danno informazioni importanti su come gestire il ticket:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Sei domande, tutte risposte in una chiamata e una fattura. is_automated è quella speculativa: è falsa su quasi ogni ticket reale, e vale la pena chiederla comunque perché l’unica volta che è vera risparmia a una persona di aprire un bounce del mailer daemon.
Due abitudini che adottarei qui.
Tieni l’insieme di domande come costante a livello di modulo invece di costruirlo inline, perché è ciò che versionerai insieme alle soglie.
E dai alle domande il nome di ciò che misurano, non di ciò che farai con la risposta, perché is_time_sensitive sopravvive a un cambio di policy mentre route_to_incident no.
Domande formulate positivamente: avremmo potuto chiamare is_automated qualcosa come needs_no_reply, ma secondo TypeSafe le prestazioni per domande formulate in positivo sono migliori.
Ora la parte che Jev non fa. Ogni risposta arriva con un valore di confidenza o una probabilità, e quel secondo numero è ciò che ti permette di costruire tre percorsi invece di due:
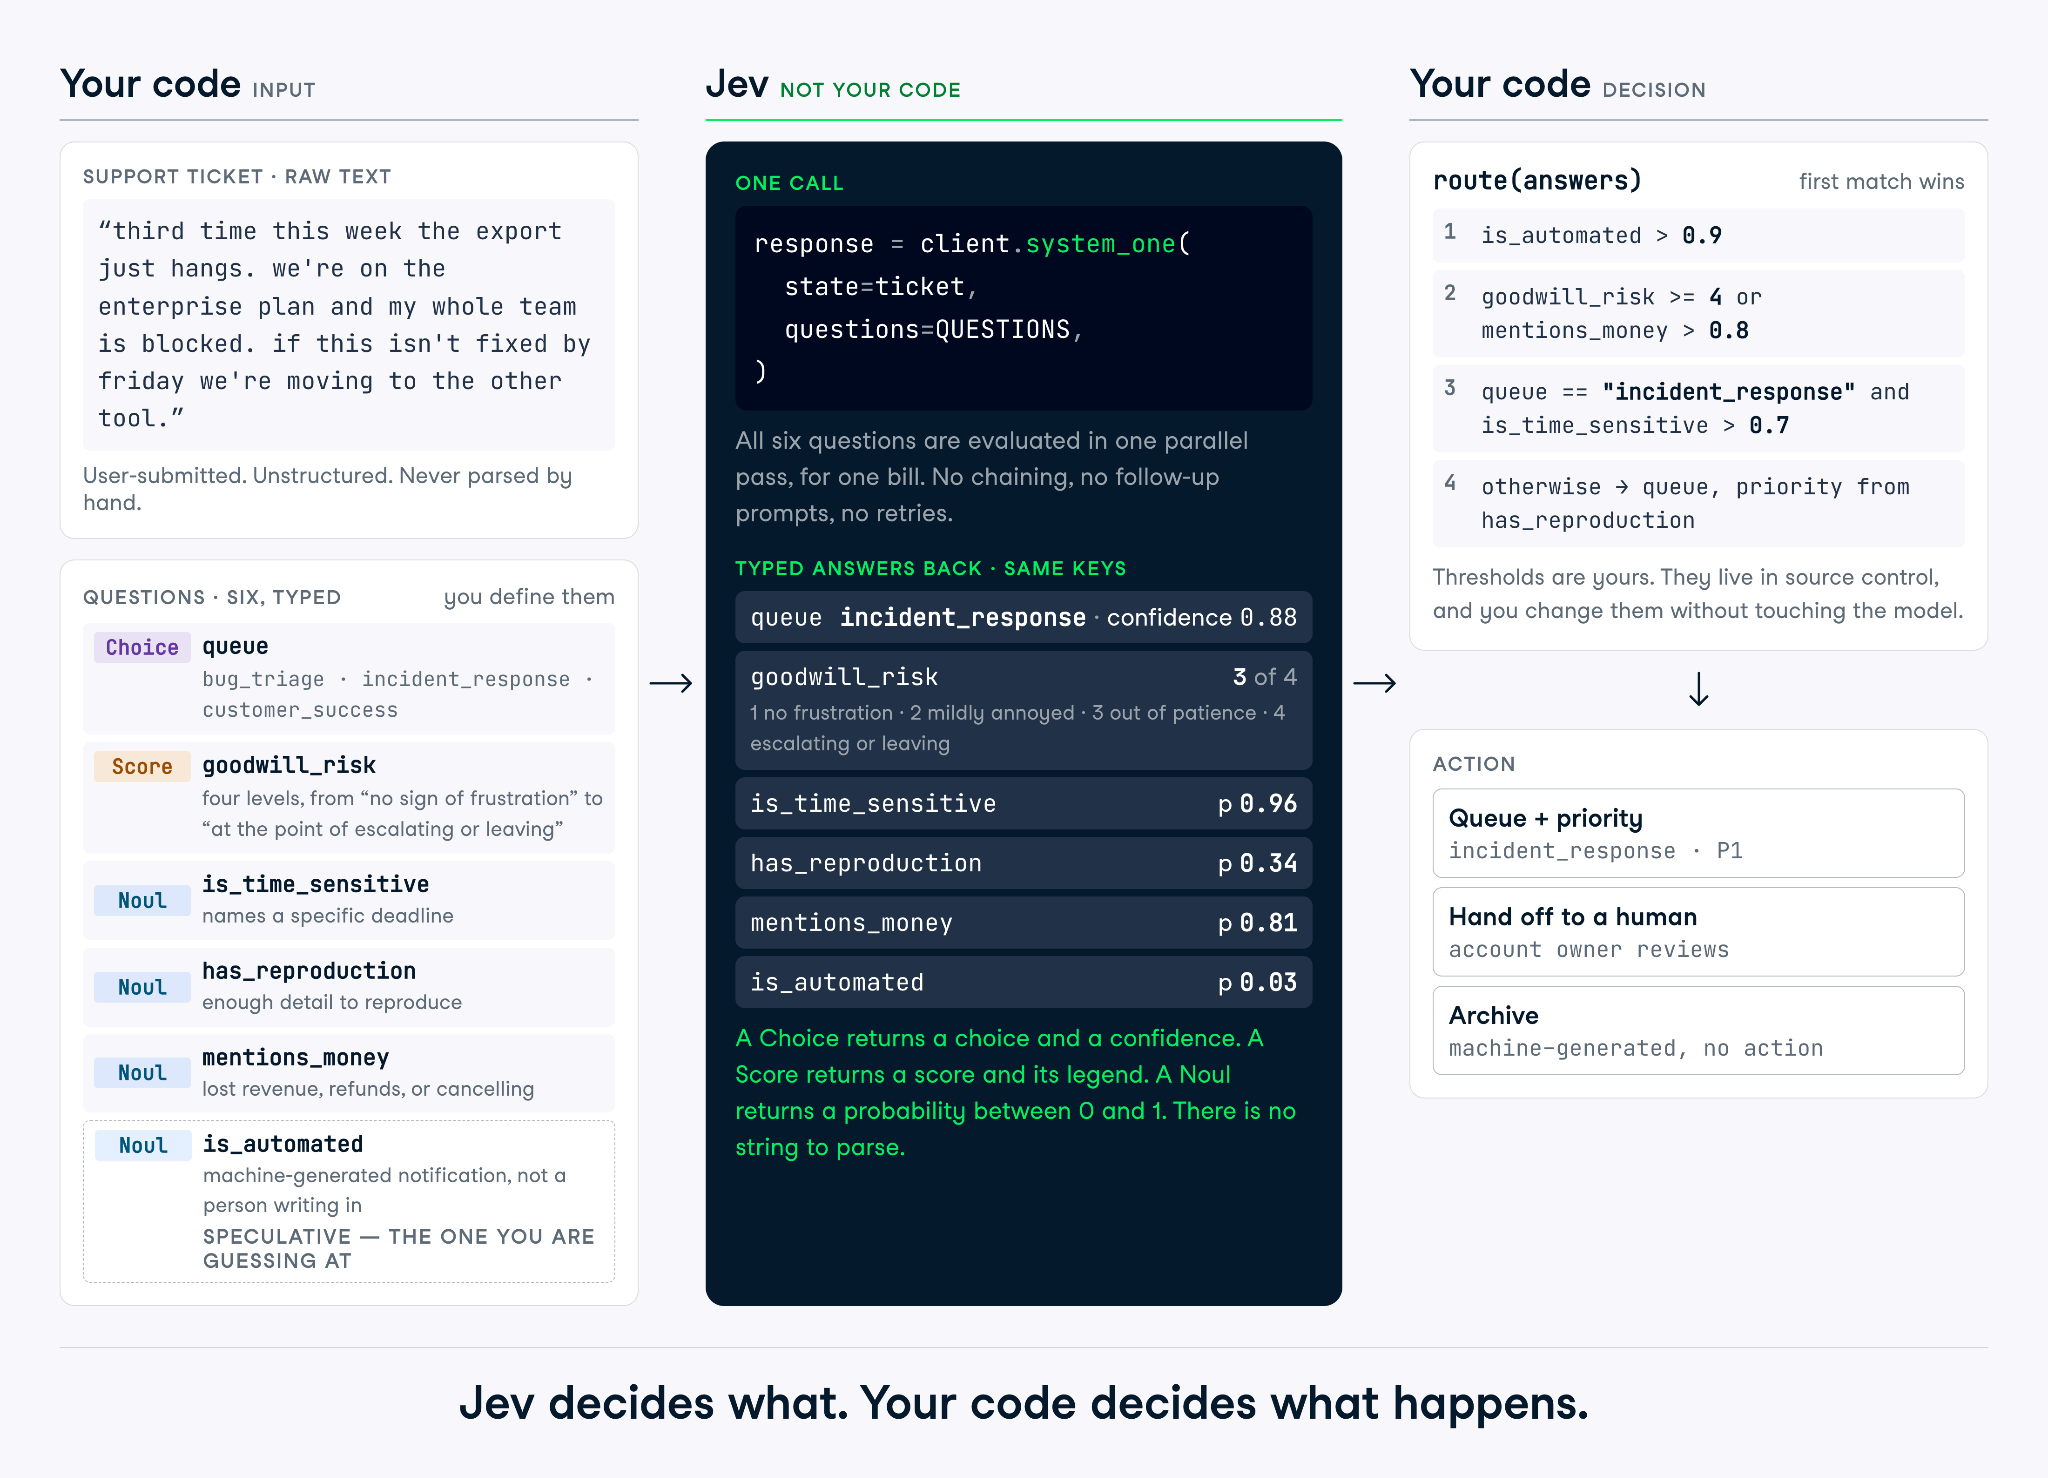
Trasformiamo questo in un paio di regole per l’instradamento dei ticket:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Leggi cosa fa quella funzione. Il modello ha fornito sei giudizi, e la policy ha deciso che uno di essi, mentions_money incrociato con un cliente frustrato, prevale sulla coda scelta da Jev. Quell’override è una decisione di business, appartiene al codice e puoi cambiarlo un venerdì pomeriggio senza ritestare un modello.
has_reproduction non viene mai usato. L’ho lasciato apposta, perché è così che appare in pratica il pattern a raggiera: chiedi più di quanto la policy attuale consumi, registri tutto e, quando qualcuno chiede se i ticket bug_triage senza passi di riproduzione impiegano più tempo a chiudersi, hai già sei settimane di risposta.
Le soglie sopra sono solo esempi. Capire quelle giuste è una questione di calibrazione, e alla fine c’è una sezione su come impostarle con i dati invece che a sensazione.
Puoi accedere allo script completo da questo repo GitHub di accompagnamento. Quando ho eseguito lo script Python con il nostro scenario, il giudizio è stato di instradare il ticket al team di incident response per oggi.
python routing.py('incident_response', 'today')TypeSafe pubblica una pagina delle irregolarità per versione del modello, con l’elenco delle modalità di fallimento note. Vorrei che più lab lo facessero. Leggila prima di costruire qualsiasi cosa e rileggila quando esegui un upgrade, perché l’elenco è versionato e i bordi si spostano.
Ecco le cinque che mi avrebbero fatto perdere più tempo.
Non puoi portare una soglia tra tipi di domanda. Nell’esempio di TypeSafe la domanda “Il cliente sta chiedendo un rimborso?” viene posta in entrambi i modi sullo stesso ticket: il Noul restituisce 0,22, la Choice sì/no restituisce 0,01 per il sì, con confidenza 0,97. Stessa domanda, due numeri, due ordini di grandezza di differenza.
Nemmeno le negazioni collaborano. Un Noul e il suo opposto sono tornati a 0,72 e 0,47, che fa somma 1,19.
Il motivo è che i due tipi chiedono cose diverse. Una Choice è relativa e decide quale opzione vince, mentre ogni Noul è assoluto e può essere basso per tutte. Tarare le soglie per domanda, nella forma in cui verrà distribuita, e non dare mai per scontato che P(yes) e 1 - P(no) siano lo stesso numero.
I livelli di Score sono ordinati, non equidistanti. Un 1,6 ti dice che il modello è tra il secondo e il terzo livello, con inclinazione verso il terzo, e questo è tutto ciò che ti dice.
Quello che non puoi fare è interpolare una quantità reale da lì. Se i tuoi livelli sono “meno di un’ora”, “qualche ora” e “un giorno”, un 1,5 non significa cinque ore. Usa lo score per testare una soglia, poi tieni ogni numero reale nel codice.
Jev tratta lo stato come dati, ma non è indurito contro codice scritto nello stato per orientarlo. Un’istruzione iniettata, un framing fuorviante o del testo che sostiene la propria classificazione possono spostare la risposta, e TypeSafe dice di aspettarsi miglioramenti qui. Se la superficie d’attacco è nuova per te, copriamo la casistica generale nella nostra guida al prompt injection.
Questo conta soprattutto quando lo stato è fornito dall’utente, che per un instradatore di ticket è sempre. Scrivi criteri abbastanza precisi perché le affermazioni del ticket su se stesso non decidano l’esito, e testa con input ostili prima di automatizzare qualsiasi instradamento.
Jev non sa contare, fare calcoli con date o numeri
Contare è inaffidabile e peggiora con l’aumentare di ciò che si conta, perché il modello riconosce la forma di una risposta invece di fare un conteggio. Le date vengono lette come testo, quindi ordinamenti, distanze e finestre falliscono. Le codifiche numeriche hanno prestazioni peggiori delle equivalenti semantiche, quindi chiedi di “rosso” piuttosto che di #FF0000.
La soluzione è la stessa in tutti e tre i casi: suddividere il lavoro.
Se ti serve un conteggio, itera nel codice e poni un Noul per elemento:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Tre problemi minori con una causa comune. Jev risponde alla domanda che hai scritto, non a quella che intendevi, quindi parole di ambito e negazioni vengono lette alla lettera. Doppie negazioni e domande su una proprietà di una proprietà costano accuratezza. E uno stato ampio imbottito di dettagli irrilevanti costa sia accuratezza sia denaro, perché il materiale non correlato funge da distrattore.
Il segnale rivelatore per il primo: quando guardi una risposta sbagliata e ti ritrovi a spiegare cosa intendevi davvero, quella spiegazione è l’altra metà mancante delle tue istruzioni.
In base a quanto abbiamo già imparato, ecco alcune best practice per ottenere il massimo da Jev.
Scrivi la condizione invece dell’intento. Se, rivedendo una risposta sbagliata, stai spiegando cosa intendevi, quella spiegazione appartiene alle istruzioni. In pratica:
jev-latest si muove. Fissa la versione una volta che una soglia dipende dal comportamento del modello:
client = TypeSafeClient(model="jev-1.13.0")Registra nei log response.model insieme alle risposte complete a ogni chiamata, non solo il valore su cui hai agito. Quando una soglia inizia a comportarsi male, quel log è l’unico modo per distinguere un cambio di modello da una deriva nei tuoi ticket.
Infine, le soglie non sono date, ma il risultato di sperimentazione.
Jev è uno strumento stretto, e in realtà è proprio questo il punto. Risponde a domande le cui risposte puoi enumerare, a costi abbastanza bassi da smettere di razionarle, e rimette la decisione al tuo codice.
Ciò su cui spingerei indietro è l’inquadramento “non può allucinare”. È vero in senso stretto che il modello non può rispondere fuori schema, ma non dice nulla sul fatto che la risposta sia corretta. Una Choice restituisce sempre una coda valida. Può comunque essere la coda sbagliata con confidenza 0,9, e l’output tipizzato rende quel fallimento più silenzioso.
Per testarlo sul tuo lavoro, ti suggerisco di trovare una decisione che il tuo codice prende con una regola fragile o una chiamata LLM lenta e provare a scrivere le risposte valide. Se ci riesci, è “a forma di Jev”. Se non ci riesci, nessuna ingegneria delle domande lo cambierà.
Se vuoi iniziare a costruire sistemi che usano l’AI, ti consiglio vivamente di iscriverti al percorso di carriera Associate AI Engineer for Developers. Ti insegna a lavorare con OpenAI API, MCP, LangChain e molto altro.
Impara l’AI Engineering con DataCamp!
Programma
Corso
Corso