
Last chance! 50% off DataCamp Premium
Sale ends in
Banyak aplikasi AI menggunakan model bahasa besar untuk tugas yang sebenarnya tidak memerlukan pembuatan teks.
Sebuah agen mungkin hanya perlu memutuskan alat mana yang harus dipanggil, apakah sebuah dokumen relevan, seberapa mendesak sebuah permintaan, atau apakah suatu tindakan perlu dieskalasi.
Jev dari TypeSafe AI mendekati tugas-tugas ini secara berbeda. Alih-alih menghasilkan jawaban token demi token, ia mengambil state aplikasi dan pertanyaan terstruktur lalu mengembalikan keputusan bertipe seperti pilihan, skor, penilaian ya/tidak, dan probabilitas. Lihat aksinya dalam tutorial API Jev kami
TypeSafe AI menggambarkan ini sebagai pendekatan System One Model: menggunakan AI sebagai lapisan pengambilan keputusan yang cepat alih-alih generator teks serbaguna.
Tantangannya adalah kita masih relatif sedikit mengetahui cara kerja internal Jev.
TypeSafe AI telah membagikan beberapa detail tentang pendekatan pengambilan keputusan paralel dan metode pelatihannya, tetapi arsitektur lengkap, bobot model, data pelatihan, dan resep pelatihan lengkap belum dipublikasikan.
Hal ini menyulitkan untuk menginspeksi, mereproduksi, atau mengadaptasi Jev itu sendiri.
Proyek-proyek open-source mengeksplorasi ide yang sama menggunakan arsitektur yang benar-benar dapat kita periksa dan jalankan secara lokal.
Sebagian menggunakan model bidirectional kecil, yang lain mengadaptasi Qwen dengan decision head khusus, sementara yang lain mengekstrak probabilitas langsung dari model bahasa yang sudah ada.
Karena Anda mengendalikan seluruh stack, Anda juga dapat mengoptimalkan ukuran model, kuantisasi, batching, caching, perangkat keras, dan serving untuk membangun lapisan keputusan yang lebih cepat dan lebih murah untuk beban kerja Anda sendiri.
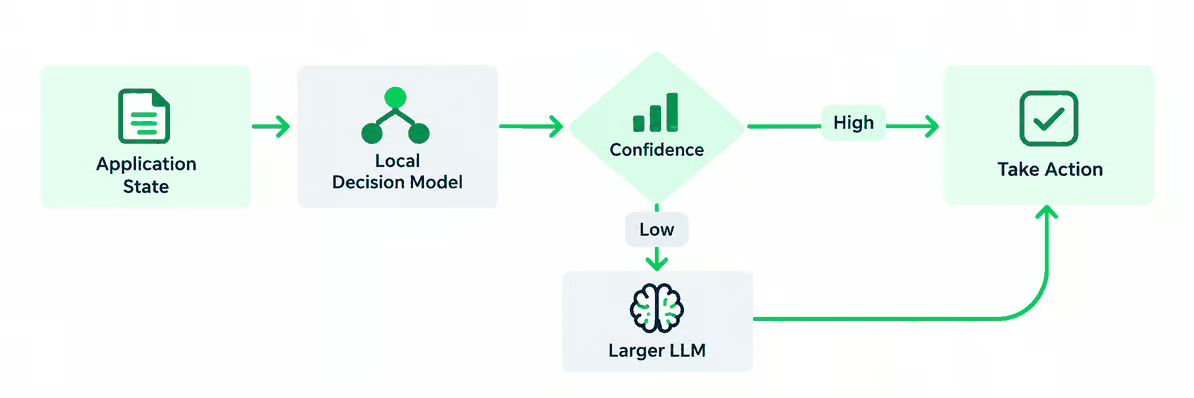
Dalam blog ini, saya akan membandingkan tujuh alternatif open-source untuk Jev, termasuk Laya, Nimble, Kev, SemIf, Rizzo Flow, Von, dan NanoJev, melihat cara kerja masing-masing, seberapa dekat pendekatannya dengan Jev, keunggulannya, dan cara menjalankannya secara lokal.
Disclaimer: Proyek-proyek yang dibahas dalam panduan ini sangat baru dan berkembang pesat. Contoh kode didasarkan pada dokumentasi dan repositori resmi mereka, tetapi tidak semua contoh telah diuji secara independen dari ujung ke ujung.
Laya adalah model keputusan non-autoregresif yang dibuat khusus berdasarkan ModernBERT-large, dengan mmBERT terpisah untuk beban kerja multibahasa.
Alih-alih menghasilkan teks, ia memproses state, pertanyaan, dan opsi yang tersedia secara bersamaan dan langsung memberi skor pada jawaban yang mungkin dalam satu forward pass. Ia mendukung keputusan bergaya Jev choice, score, dan noul, dengan checkpoint khusus untuk beban kerja berbahasa Inggris, multibahasa, dan keputusan bertipe.
Ini menjadikan Laya salah satu alternatif arsitektur yang paling dekat dengan Jev karena keduanya dirancang khusus untuk keputusan probabilistik alih-alih pembuatan teks.
Laya menonjol karena modelnya yang relatif kecil 322M–421M, dukungan multibahasa untuk 100+ bahasa, dan kemampuan mengevaluasi banyak pertanyaan secara efisien tanpa menjalankan model generatif berparameter miliaran.
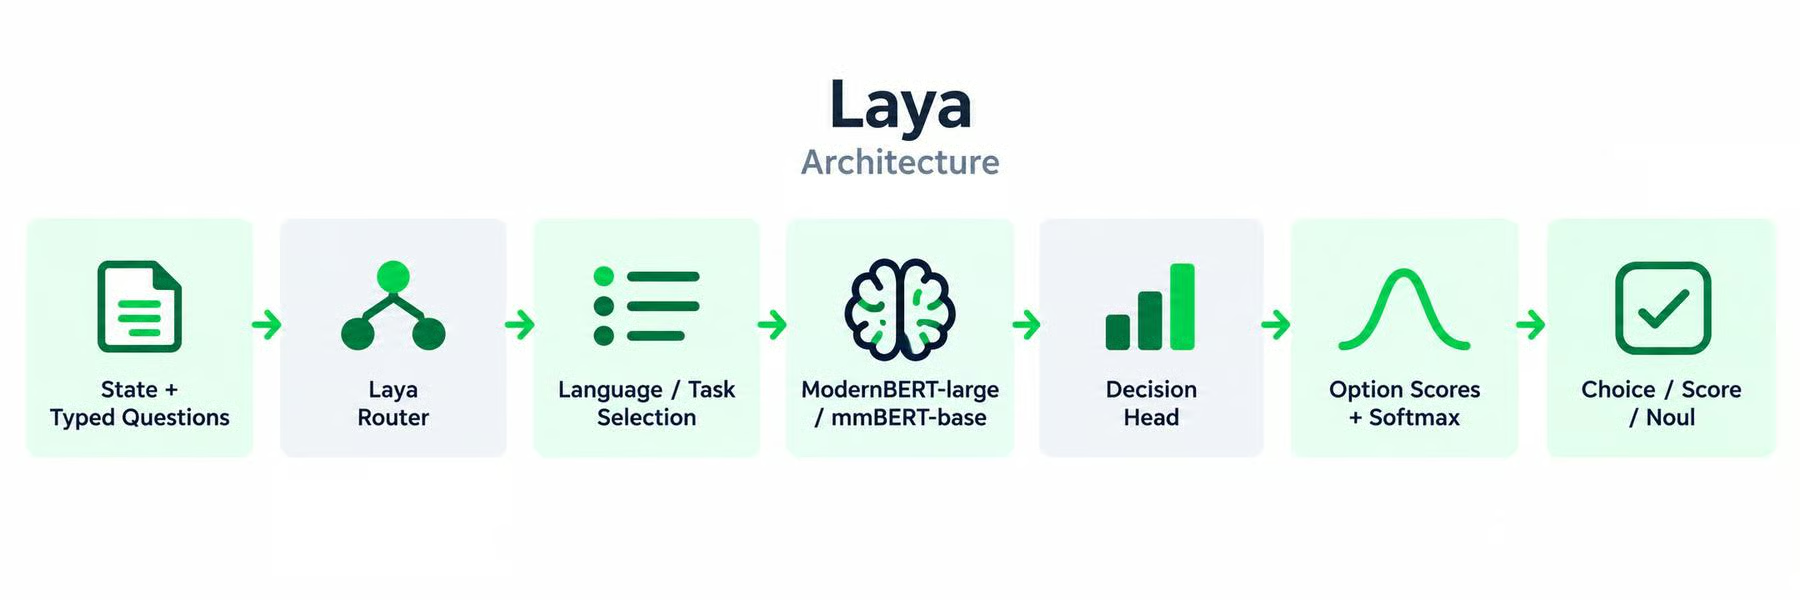
Laya mengambil sebuah state seperti email, tiket dukungan, dokumen, atau objek JSON, bersama pertanyaan bertipe seperti choice, score, atau noul.
Router-nya memilih checkpoint yang paling sesuai untuk permintaan tersebut, seperti ModernBERT-large untuk bahasa Inggris atau mmBERT-base untuk masukan multibahasa.
Model terpilih memproses state dan pertanyaan dalam satu forward pass, lalu decision head memberi skor pada opsi yang tersedia dan mengubahnya menjadi probabilitas.
Ini menciptakan alur langsung dari masukan, melalui routing dan encoding, hingga keputusan bertipe akhir.
 Mulai menggunakan Laya
Laya tersedia sebagai paket Python:
pip install layaPerintah ini memasang pustaka Laya dan dependensinya, tetapi tidak menyertakan bobot model di dalam paket.
Model-modelnya dihosting di Hugging Face.
Saat Anda membuat router dengan preload=True, Laya mengunduh dan memuat checkpoint yang tersedia segera sehingga siap sebelum permintaan pertama.
Bobot yang diunduh di-cache secara lokal, sehingga tidak perlu diunduh lagi setiap kali Anda menjalankan aplikasi.
from laya import Router

router = Router(preload=True)

state = {
    "subject": "Duplicate charge",
    "body": "I was charged twice. Please refund this today."
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "Which department should handle this?",
        "criteria": {
            "billing": "Payments and refunds",
            "technical": "Errors and outages",
            "sales": "Pricing and purchases"
        }
    }
}

result = router.predict(state, questions)

print(result["answers"]["department"]["choice"])
Di sini, Router(preload=True) adalah bagian terpenting.
Pada run pertama, Laya mengambil file model yang diperlukan dari repositori Hugging Face-nya dan memuatnya ke memori. Run berikutnya dapat memakai salinan cache lokal.
Jika Anda menggunakan:
router = Router()Laya menggunakan lazy loading. Ia menunggu hingga checkpoint tertentu diperlukan dan mengunduh/membangunnya saat pertama kali digunakan.
Bespoke Nimble menggunakan Qwen3.5-9B sebagai tulang punggung dan menyetelnya dengan LoRA rank-16 khusus untuk pengambilan keputusan bertipe.
Anda memberikan beberapa teks bersama skema datar yang berisi pertanyaan boolean atau enum, dan Nimble mengembalikan jawaban terpilih plus probabilitas untuk setiap opsi yang diizinkan.
Alih-alih melakukan decoding jawaban token demi token, pelatihan dan inferensi beroperasi langsung pada kandidat logit.
Seperti Jev, Nimble dibangun di sekitar gagasan state masuk, keputusan probabilistik bertipe keluar, tetapi implementasinya menunjukkan bagaimana perilaku itu dapat ditambahkan ke LLM open-source yang ada alih-alih memerlukan arsitektur keputusan proprietari.
Kekuatan utamanya adalah keterbukaan di seluruh proses: Bespoke Labs merilis model, resep pelatihan, setup evaluasi, dan pipeline kurasi data, menjadikan Nimble sangat berguna bagi pengembang yang ingin melatih atau mempelajari model bergaya Jev mereka sendiri.
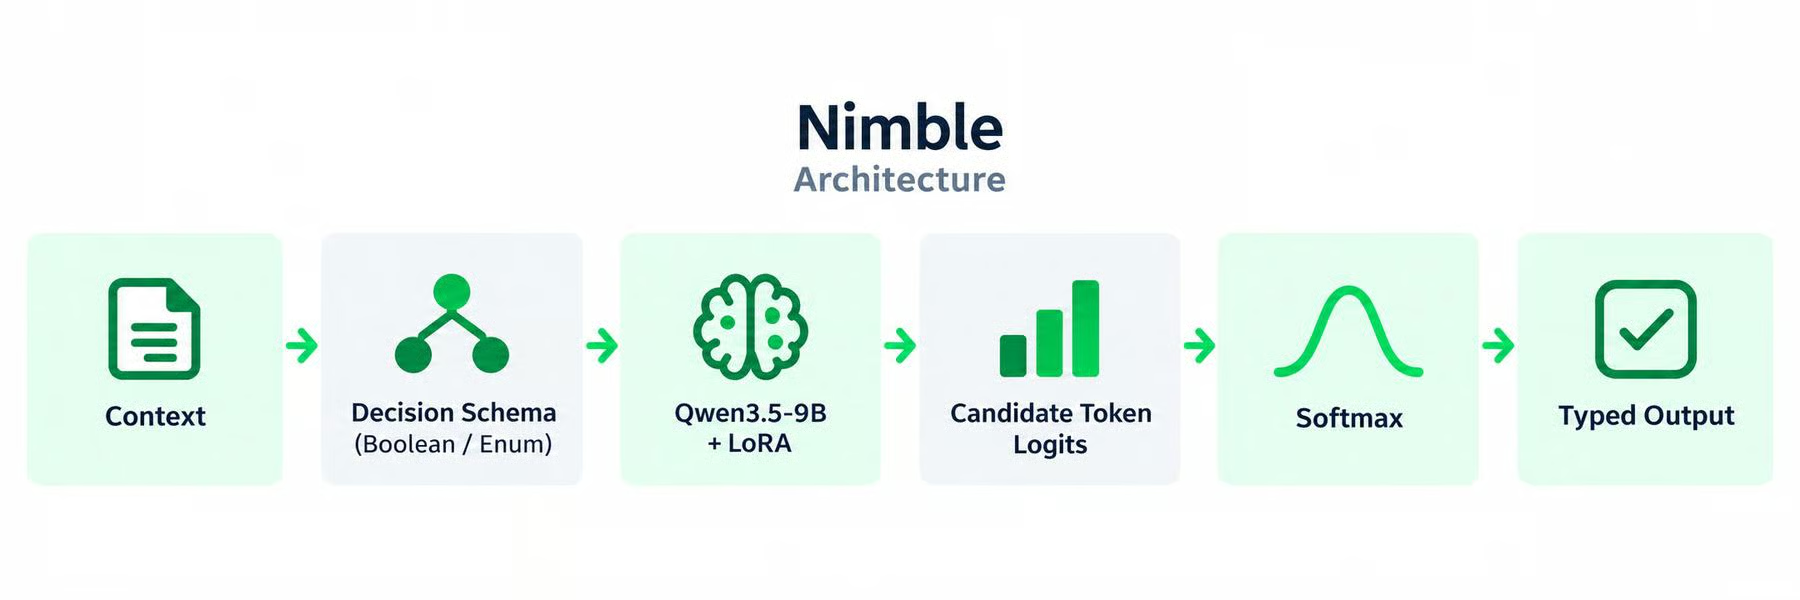
Nimble dimulai dengan konteks dan skema keputusan yang mendefinisikan keluaran yang diizinkan, seperti boolean atau satu nilai dari enum.
Ia menggunakan Qwen3.5-9B dengan LoRA untuk memproses konteks dan skema, lalu membaca logit untuk token kandidat yang diizinkan alih-alih menghasilkan respons penuh.
Logit tersebut dilewatkan melalui softmax untuk menghasilkan probabilitas, yang dikembalikan sebagai keluaran bertipe terstruktur.
 Mulai menggunakan Nimble
Nimble memerlukan Python 3.12 dan menggunakan checkpoint Bespoke-Nimble-9B. Mulailah dengan mengkloning repositori dan memasang dependensi:
git clone https://github.com/bespokelabsai/nimble.git nimble
cd nimble

python3.12 -m venv .cache/venvs/nimble
source .cache/venvs/nimble/bin/activate

python -m pip install torch==2.8.0 -r requirements/training.txt
Selanjutnya, unduh dan siapkan model. Langkah persiapan resmi mengunduh bespokelabs/Bespoke-Nimble-9B dari Hugging Face dan, bila perlu, menggabungkan adaptor LoRA-nya dengan model dasar Qwen3.5 yang dipin. Kemudian membuat .cache/nimble-model.json.
import json
from pathlib import Path
from huggingface_hub import snapshot_download

repo = "bespokelabs/Bespoke-Nimble-9B"

snapshot = Path(
    snapshot_download(
        repo,
        cache_dir=".cache/huggingface/hub"
    )
)

config = {
    "model_path": str(snapshot.resolve()),
    "model_id": repo,
    "revision": snapshot.name,
    "max_input_tokens": 2048,
}

Path(".cache/nimble-model.json").write_text(
    json.dumps(config, indent=2)
)
Jika rilis yang diunduh adalah adaptor LoRA, gunakan blok persiapan penuh Nimble dari quickstart resmi agar dapat menggabungkan adaptor dengan model dasar yang dipin sebelum inferensi.
Pada GPU NVIDIA, muat model yang telah disiapkan:
import json
from pathlib import Path
from nimble.scoring.cuda_scorer import CudaCandidateScorer

config = json.loads(
    Path(".cache/nimble-model.json").read_text()
)

scorer = CudaCandidateScorer(**config)
Then make a typed decision:
schema = {
    "priority": {
        "type": "enum",
        "choices": ["HIGH", "LOW"],
        "description": "Urgency based on current business impact."
    },
    "requires_review": {
        "type": "boolean",
        "description": "Whether a human should review this incident."
    }
}

result = scorer.score(
    "The payment service is down for all customers.",
    schema
)

print(result["output"])
print(result["fields"]["priority"]["scores"])
Nimble mengembalikan nilai yang dipilih beserta probabilitas yang diberikan pada setiap kandidat alih-alih menghasilkan respons teks.
Kev adalah keluarga model keputusan terinspirasi Jev yang dibangun di atas Qwen3.5, dengan varian 0.8B, 4B, dan 9B.
Ia menambahkan adaptor LoRA rank-16 dan pointer head kecil yang membandingkan setiap representasi opsi dengan representasi keputusan pada pertanyaan.
Beberapa pertanyaan dapat berbagi state yang sama, sementara Kev menjaga pertanyaan tetap terisolasi dan mengembalikan distribusi probabilitasnya tanpa menghasilkan teks.
Kev sangat dekat dengan Jev karena arsitekturnya secara eksplisit didasarkan pada rekonstruksi publik Jev, dan servernya mengimplementasikan kontrak API /v1/systemone dari TypeSafe.
Ia mendukung gaya pertanyaan yang sama noul, choice, dan score, sehingga kode SDK TypeSafe yang ada dapat diarahkan ke server Kev lokal.
Keuntungan utamanya adalah kombinasi perilaku mirip Jev, bobot terbuka, beberapa ukuran model, dan pipeline pelatihan terbuka.
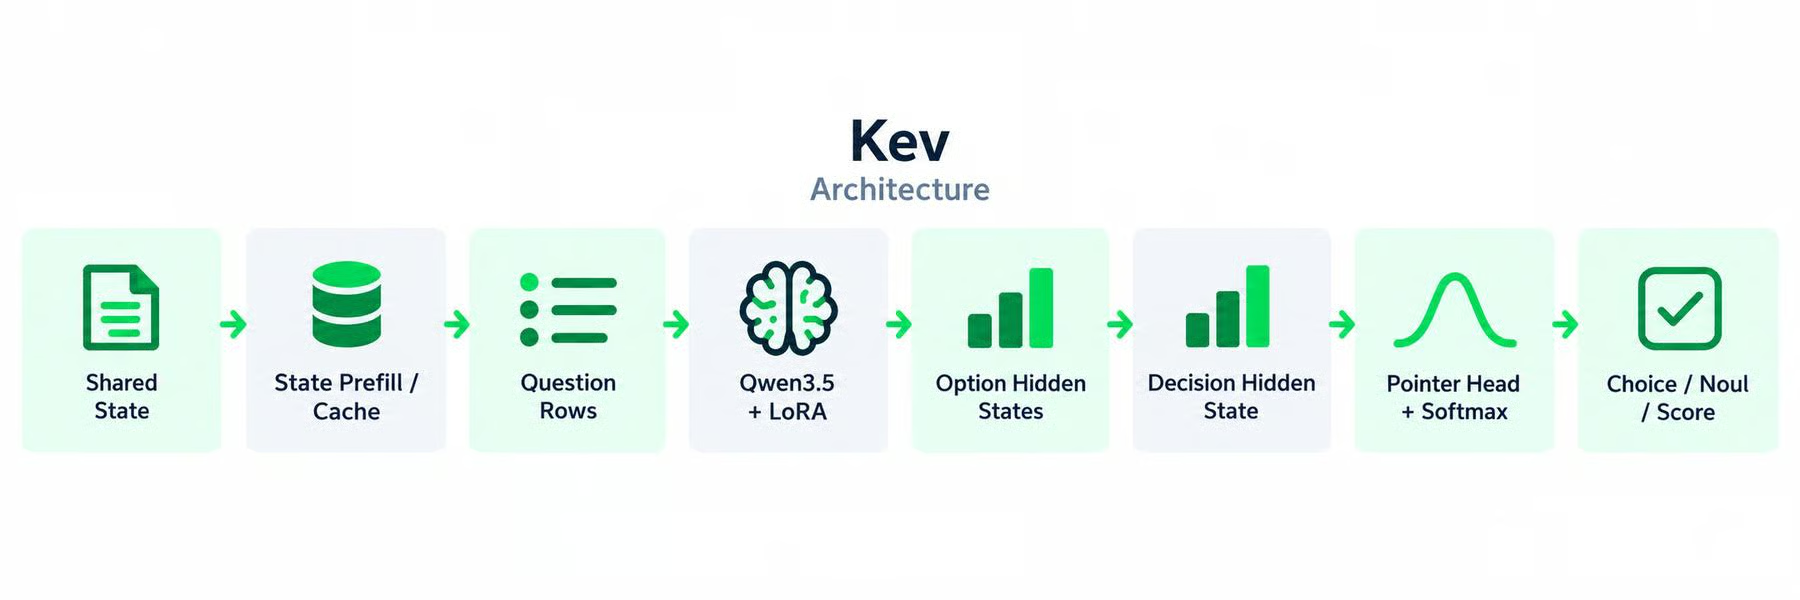
Kev menggunakan model dasar Qwen dengan adaptor LoRA dan pointer head kecil.
State bersama diproses sekali dan digunakan ulang di banyak pertanyaan, sehingga model tidak perlu berulang kali memproses konteks yang sama.
Untuk setiap pertanyaan, Kev membuat representasi laten untuk opsi dan token keputusan, lalu pointer head membandingkannya dan menghasilkan skor opsi.
Softmax mengubah skor tersebut menjadi probabilitas untuk choice, noul, atau score akhir.
 Mulai menggunakan Kev
Kev berjalan sebagai server System One lokal.
Mulai dengan mengkloning proyek dan memasang dependensi serving-nya:
git clone https://github.com/jaredpalmer/kev.git
cd kev

uv sync --extra serve
Ini memasang Kev, tetapi belum tentu semua bobot modelnya.
Mulai Kev-4B dengan:
KEV_DTYPE=bf16 \
uv run --extra serve python -m kev.serve \
    --run jaredpalmer/kev-4b \
    --port 8009
Pada run pertama, Kev secara otomatis mengunduh adaptor/checkpoint Kev dan model dasar Qwen-nya dari Hugging Face.
Start berikutnya menggunakan ulang file model yang di-cache alih-alih mengunduhnya lagi.
Setelah server berjalan, Anda dapat menggunakan SDK TypeSafe dengannya:
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)

response = client.system_one(
    state="I was charged twice.",
    questions={
        "team": Choice(
            instructions="Which team owns this?",
            criteria={
                "billing": None,
                "technical": None,
            },
        )
    },
)

print(response.choices["team"].choice)
Jadi dengan Kev, perintah server juga berfungsi sebagai langkah pemuatan model: peluncuran pertama mengunduh bobot yang diperlukan secara otomatis.
SemIf mengambil pendekatan yang lebih sederhana: ia tidak melatih model keputusan baru sama sekali.
Sebaliknya, ia menggunakan model terbuka yang ada seperti Qwen3.5-4B dan langsung membaca logit yang diberikan pada jawaban yang diizinkan.
State, kriteria, dan opsi bertipe diteruskan ke model, dan SemIf mengonversi logit opsi native menjadi probabilitas tanpa sampling atau menghasilkan jawaban.
Ini mereplikasi salah satu sifat praktis terpenting Jev, membuat keputusan tanpa keluaran autoregresif, sekaligus menghindari kebutuhan akan checkpoint khusus.
SemIf menonjol karena fleksibilitasnya: Anda dapat menggunakan berbagai model terbuka di bawahnya, menggunakan ulang state panjang di banyak pertanyaan, dan bereksperimen dengan penilaian langsung di CUDA, Apple Silicon, atau model browser yang di-kuantisasi.
Ini sangat berguna saat Anda ingin menguji ide System One tanpa terlebih dahulu melatih model khusus.
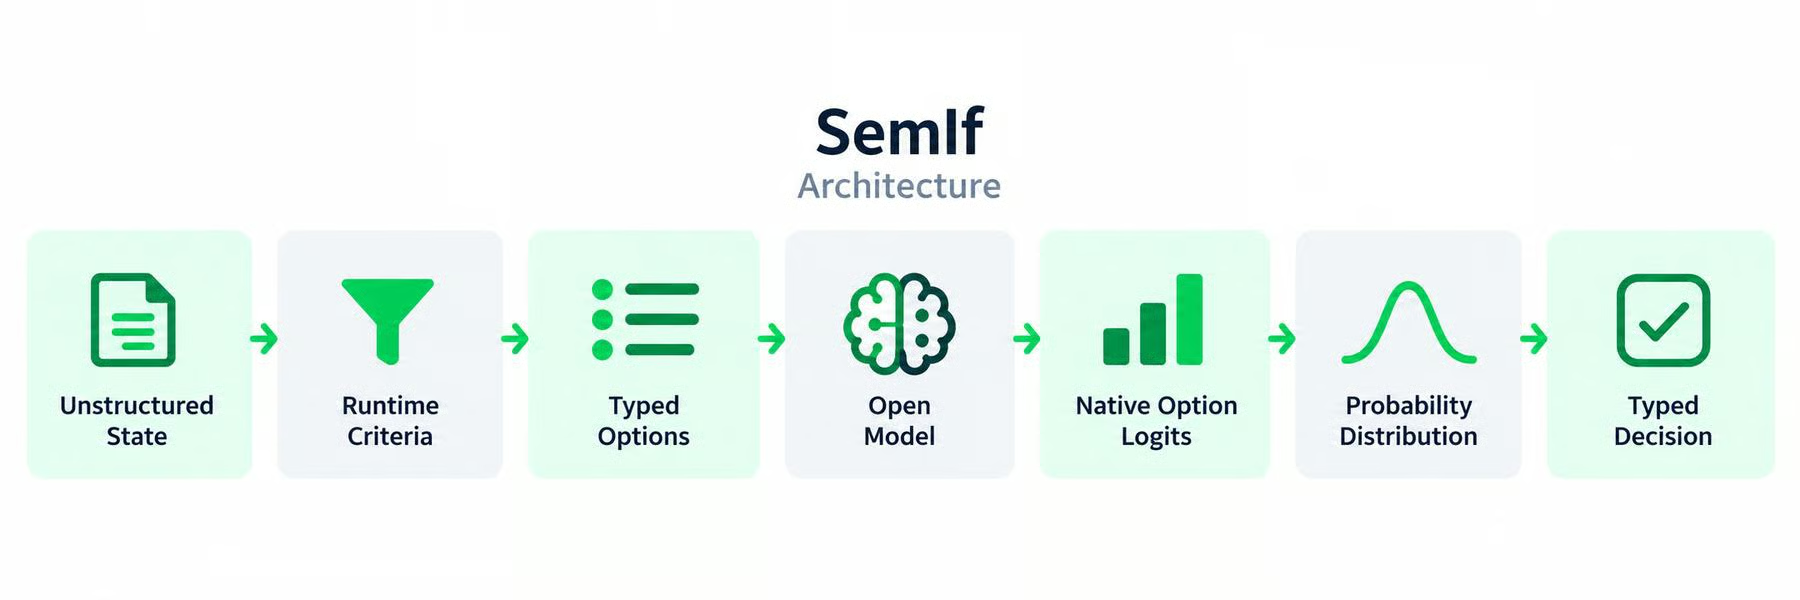
SemIf mengambil state tidak terstruktur, kriteria runtime, dan sekumpulan opsi yang diizinkan dan melewatkannya melalui model terbuka yang ada.
Alih-alih meminta model menghasilkan jawaban, ia langsung membaca logit yang diberikan pada opsi yang telah ditentukan itu.
Logit ini dikonversi menjadi distribusi probabilitas, memungkinkan aplikasi membuat keputusan bertipe tanpa menghasilkan teks atau mengurai respons setelahnya.
 Mulai menggunakan SemIf
SemIf tidak memiliki checkpoint model fondasi khusus. Sebaliknya, ia menjalankan penilaian keputusan pada model terbuka yang ada.
Kloning dan pasang:
git clone https://github.com/TheoLeeCJ/SemIf.git
cd SemIf

python -m venv .venv
source .venv/bin/activate

pip install -e '.[test]'
Ini memasang SemIf, tetapi belum mengunduh Qwen.
Jalankan scorer:
CUDA_VISIBLE_DEVICES=0 semif-score \
    --mode direct \
    --model Qwen/Qwen3.5-4B \
    --revision 851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a \
    --input examples/decisions.jsonl \
    --output results.jsonl
Pada run pertama, model Qwen yang dipilih diunduh dari Hugging Face dan disimpan di cache Hugging Face. Dokumentasi SemIf bahkan merekomendasikan untuk mengatur HF_HOME ke drive yang besar karena file model bisa memakan ruang yang signifikan.
Sebagai contoh:
export HF_HOME=/path/to/large-drive/huggingfaceSetelah model di-cache, run berikutnya dapat menggunakan salinan lokal.
Jadi SemIf sendiri relatif kecil. Sebagian besar ukuran unduhan berasal dari model terbuka mana pun yang Anda pilih untuk dijalankan di bawahnya.
Rizzo Flow adalah sistem inferensi gaya Jev yang local-first, dibangun di sekitar model Spark-X2.5 terbuka dan serving berbasis llama.cpp.
Alih-alih menghasilkan jawaban JSON, ia mengonversi setiap keputusan menjadi sekumpulan token jawaban terbatas, membaca logit yang diberikan pada token-token tersebut, dan mengubahnya menjadi probabilitas.
State dapat diproses sekali dan digunakan ulang di beberapa pertanyaan, mengurangi komputasi berulang.
Seperti Jev, Rizzo Flow menerima state tidak terstruktur dan mengembalikan keputusan bertipe seperti penilaian ya/tidak, pilihan, skor, dan keluaran numerik.
Ia juga mencerminkan antarmuka HTTP TypeSafe, sehingga relatif mudah mengganti panggilan hosted dengan endpoint lokal.
Rizzo Flow sangat menonjol untuk deployment lokal dan fleksibilitas perangkat keras, menggabungkan model terbuka, kuantisasi, dan API yang familier alih-alih mencoba mereproduksi arsitektur pelatihan proprietari Jev.
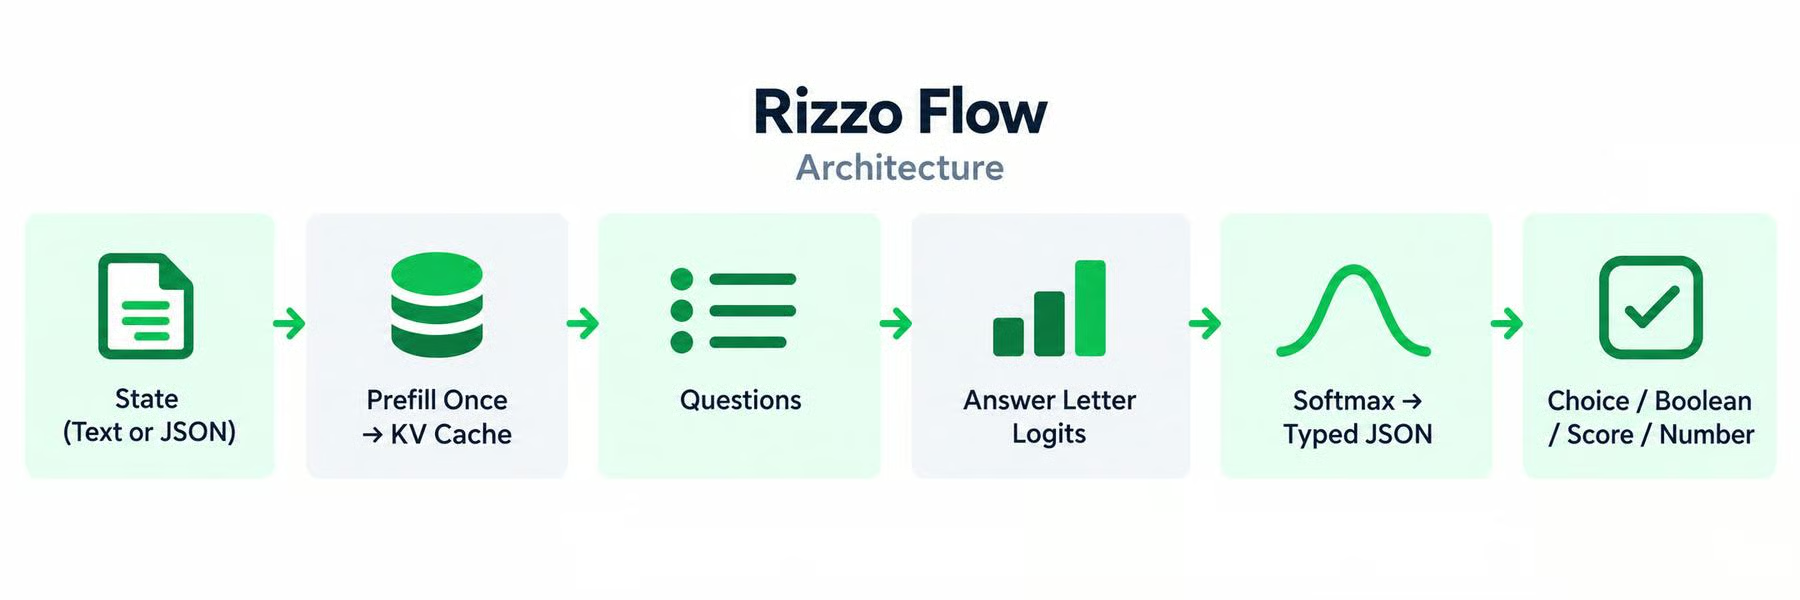
Rizzo Flow memproses state sekali dan menyimpan hasilnya dalam KV cache model.
Beberapa pertanyaan kemudian dapat menggunakan ulang state yang di-cache tersebut alih-alih memproses konteks penuh lagi. Setiap pertanyaan diubah menjadi masalah pilihan ganda, dengan jawaban kandidat direpresentasikan oleh huruf seperti A, B, atau C.
Rizzo Flow hanya membaca logit untuk huruf jawaban tersebut, menerapkan softmax, dan mengonversi probabilitas yang dihasilkan menjadi keluaran bertipe seperti boolean, pilihan, skor, atau angka.
Rizzo Flow memerlukan Python 3.11+, Git, dan uv.
Saat memasangnya, pilih backend komputasi untuk mesin Anda. Misalnya, di Linux dengan GPU NVIDIA:
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow

uv sync --locked --extra cuda
source .venv/bin/activate
Untuk Apple Silicon, gunakan --extra mlx; sistem hanya CPU dapat menggunakan --extra cpu.
Selanjutnya, unduh model Spark-X2.5 default dan runtime lokalnya:
rizzo downloadLalu mulai server:
rizzo serveModel kini berjalan secara lokal di http://127.0.0.1:8017.
Anda dapat menguji endpoint yang kompatibel dengan Jev menggunakan keputusan nyata:
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "My payouts have been failing for three days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and outages",
          "sales": null
        }
      }
    }
  }'
Rizzo Flow mengembalikan jawaban dan distribusi probabilitas secara langsung, tanpa menghasilkan token respons keluaran token demi token.
Von adalah model System One yang dibuat khusus berdasarkan arsitektur ModernBERT bidirectional dengan 395 juta parameter.
Alih-alih melakukan decoding teks, ia mengevaluasi state dan kriteria kandidat secara bersamaan menggunakan representasi OptionMarker, lalu langsung menghasilkan logit untuk keputusan Choice, Noul, dan Score.
Ia juga menerapkan kalibrasi pasca pelatihan sehingga distribusi probabilitas yang dihasilkan dapat digunakan langsung oleh logika aplikasi.
Von sangat mirip dengan Jev pada level antarmuka: non-autoregresif, mendukung tiga primitif keputusan inti yang sama, mengevaluasi banyak pertanyaan dalam satu forward pass, dan mengimplementasikan protokol /v1/systemone.
Kekuatan utamanya adalah jejak yang kecil dan desain inferensi lokal: model memiliki ratusan juta, bukan miliaran, parameter dan mendukung eksekusi CUDA, ROCm, Apple Silicon, dan CPU.
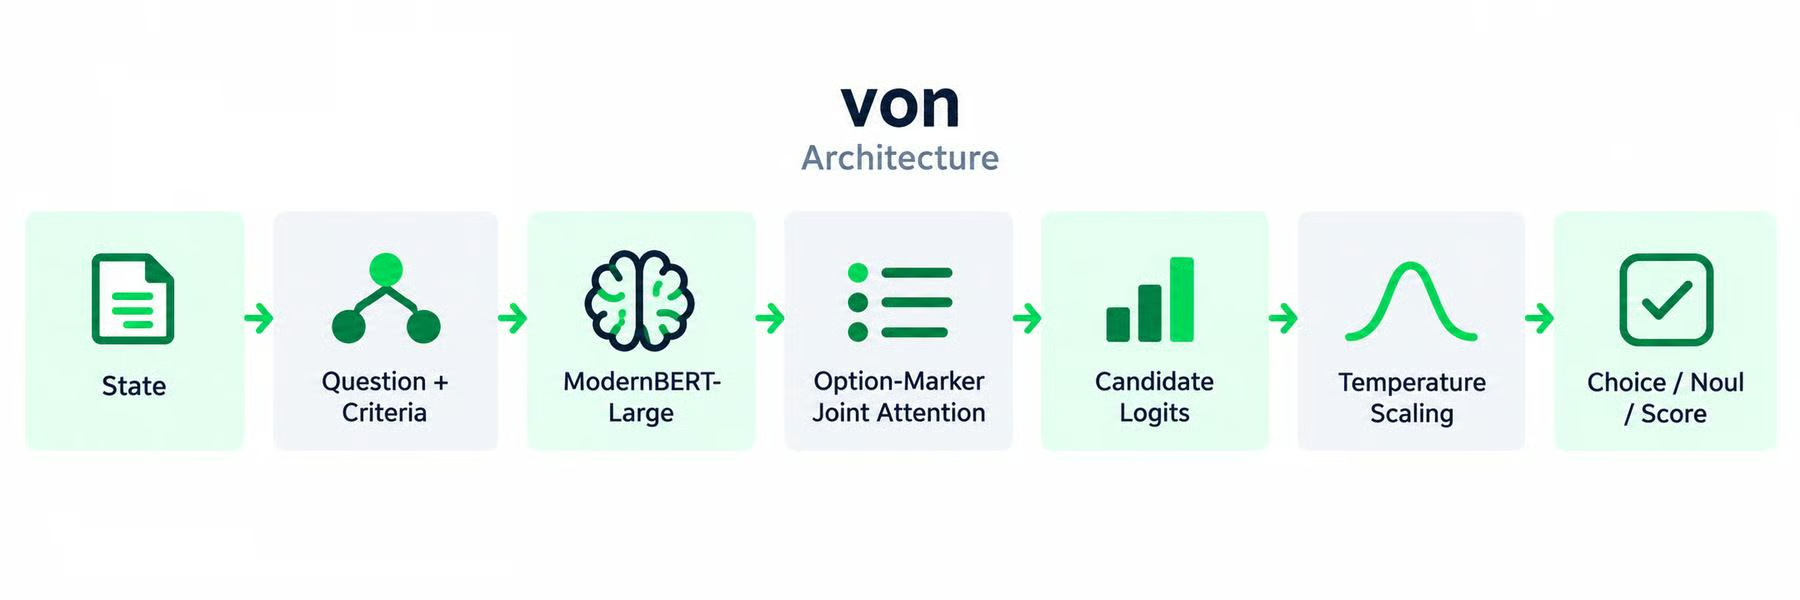
von menggunakan model ModernBERT bidirectional yang ringkas untuk memproses state, pertanyaan, dan kriteria kandidat secara bersamaan.
Mekanisme Option-Marker-nya membuat representasi untuk jawaban yang mungkin, yang diubah menjadi logit kandidat.
Temperature scaling kemudian diterapkan untuk meningkatkan distribusi probabilitas sebelum von mengembalikan choice, noul, atau score akhir.
Arsitektur yang sama juga dapat mengevaluasi banyak pertanyaan dalam satu forward pass.
Von memiliki salah satu antarmuka paling sederhana.
Pasang SDK Python:
pip install von-sdkIni memasang perangkat lunak Von. Model sebenarnya diterbitkan terpisah sebagai wfzyx/von-1.0 di Hugging Face.
Saat model dimuat untuk pertama kali, checkpoint ModernBERT-nya diunduh dan di-cache secara lokal melalui sistem pemuatan model Hugging Face/Transformers.
Setelah di-cache, inferensi berikutnya dapat menggunakan salinan lokal alih-alih mengunduh bobot lagi.
Anda kemudian dapat membuat keputusan dengan:
import von

result = von.decide(
    state="Database replication lag exceeded 45 seconds.",
    choices={
        "infrastructure": "Database or network failures",
        "billing": "Payments and invoices",
        "feature": "Requests for new functionality",
    },
    instructions="Classify the root cause.",
)

print(result.choice)
print(result.confidence)
For a binary decision:
p_blocking = von.judge(
    state="Requests are timing out.",
    instructions="Is this actively blocking customers?"
)

print(p_blocking)
Jadi panggilan pertama bisa lebih lama karena model perlu diunduh dan diinisialisasi. Setelah itu, inferensi sebenarnya terjadi secara lokal.
NanoJev adalah replika Jev 0,6B yang dibangun di atas Qwen3-0.6B dengan decision head khusus untuk keluaran terstruktur.
Setiap permintaan berisi state, pertanyaan, dan set kandidat, yang diteruskan melalui backbone sebelum head bersama menghasilkan distribusi probabilitas lengkap.
Choice menggunakan set attention dan scalar head, keputusan Boolean menggunakan sigmoid, dan Score mengevaluasi level berurutan serta menghasilkan distribusi dan skor ekspektasi.
NanoJev mengikuti desain Jev dengan sangat dekat: mendukung keputusan paralel, set kandidat dinamis, distribusi probabilitas penuh, dan nol decoding output.
Keunggulannya adalah backbone yang sangat kecil dan pipeline pelatihan end-to-end yang eksplisit.
Ia dapat melakukan batch beberapa state, pertanyaan, dan jalur kandidat ke dalam satu forward pass backbone, menjadikannya opsi menarik bagi pengembang yang ingin bereksperimen dengan arsitektur bergaya Jev yang ringkas dan dapat dilatih alih-alih mengadaptasi LLM serbaguna yang lebih besar.
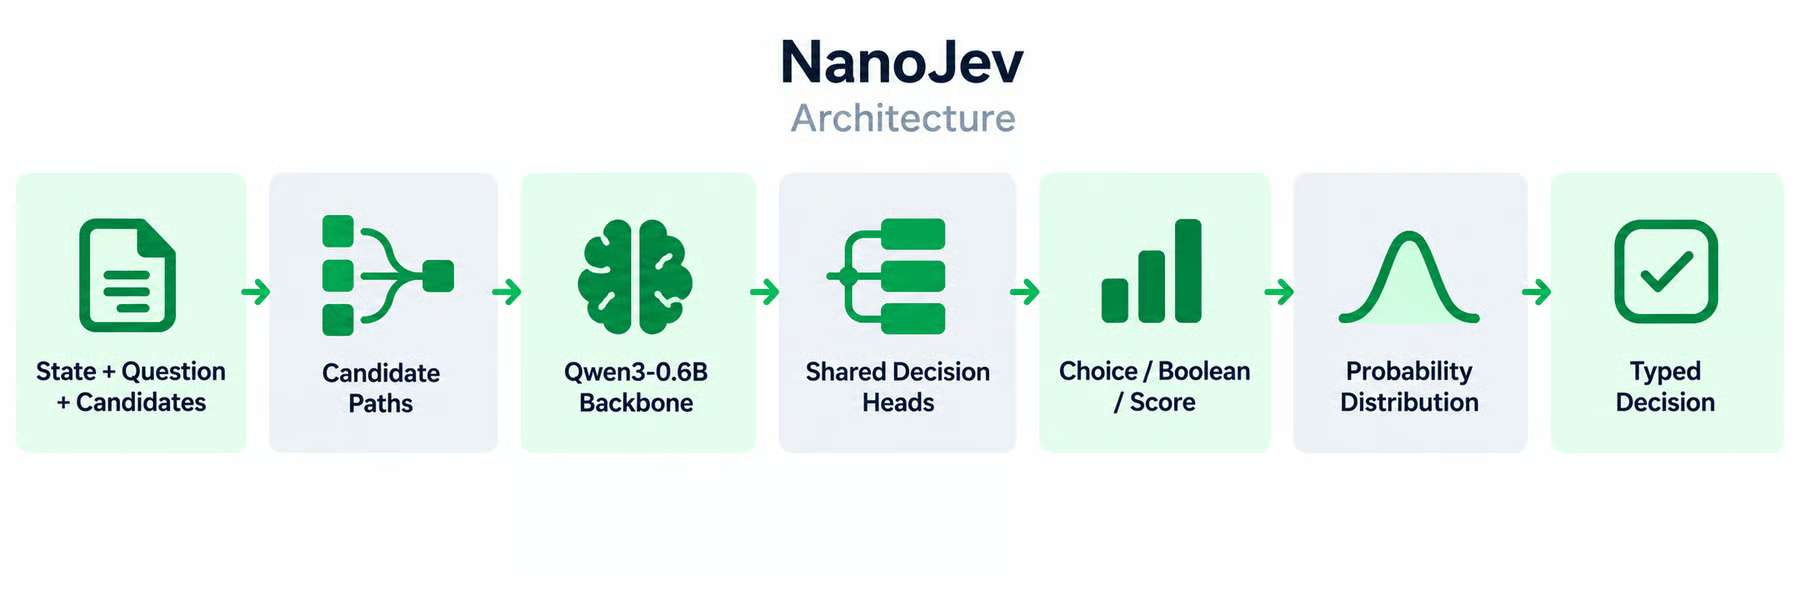
NanoJev mengambil sebuah state, pertanyaan, dan jawaban kandidat yang boleh dipilih oleh model.
Setiap kandidat digabungkan dengan masukan yang relevan dan dilewatkan melalui backbone Qwen3-0.6B bersama.
NanoJev kemudian menggunakan decision head khusus untuk memberi skor kandidat secara langsung: Choice menggunakan set attention dan softmax, Boolean menggunakan sigmoid, dan Score menghasilkan distribusi probabilitas pada level berurutan.
Karena membaca probabilitas ini langsung dari forward pass, ia dapat mengembalikan distribusi bertipe lengkap tanpa menghasilkan token output.
NanoJev memisahkan pengunduhan model dari pemasangan repositori.
Mulai dengan memasang proyek:
git clone https://github.com/TianyuCodings/NanoJev.git
cd NanoJev

python -m pip install \
    -r requirements-toy.txt \
    huggingface_hub
Lalu unduh checkpoint publik yang dipin:
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="C-Tianyu/NanoJev",
    revision="unified-games-v1",
    local_dir="checkpoints/NanoJev-unified",
    allow_patterns=[
        "best.safetensors",
        "config.json",
        "tokenizer/*",
        "backbone_config/*",
    ],
)
Mulai server inferensi lokal:
CUDA_VISIBLE_DEVICES=0 python scripts/serve_decisions.py \
    --checkpoint-dir checkpoints/NanoJev-unified \
    --web-root web \
    --host 127.0.0.1 \
    --port 8765 \
    --precision bf16
Buat sebuah permintaan:
cat > data/request.json <<'JSON'
{
  "states": [{
    "id": "living_room",
    "state": "The living room is 29 degrees. The target is 24 degrees. The window is closed and someone is home.",
    "questions": {
      "action": {
        "type": "choice",
        "instructions": "Choose the action that most directly lowers the room temperature.",
        "criteria": {
          "cool": "Turn on air conditioning",
          "light": "Turn on the lights",
          "wait": "Keep the current settings"
        }
      },
      "occupied": {
        "type": "boolean",
        "instructions": "Someone is home."
      }
    }
  }]
}
JSON
Lalu kirimkan ke NanoJev:
curl http://127.0.0.1:8765/api/evaluate \
  -H 'Content-Type: application/json' \
  --data-binary @data/request.json
Server menyimpan checkpoint tetap dimuat dan mengembalikan distribusi probabilitas untuk setiap pertanyaan. NanoJev juga dapat melakukan batch beberapa state dan pertanyaan dalam permintaan yang sama.
Perbedaan utama adalah bagaimana setiap proyek menghasilkan keputusan.
Laya dan Von menggunakan encoder bidirectional kecil yang dibuat khusus untuk pemberian skor opsi.
Kev, Nimble, dan NanoJev mengadaptasi model Qwen dengan pelatihan khusus atau decision head.
SemIf dan Rizzo Flow mengambil pendekatan yang lebih ringan dengan mengekstrak probabilitas langsung dari model generatif yang ada.
|
Proyek |
Arsitektur |
Ukuran |
Keputusan gaya Jev |
Paling cocok untuk |
|
Laya |
ModernBERT/mmBERT + decision head |
322M–421M |
Ya |
Keputusan multibahasa kecil |
|
Nimble |
Qwen3.5 + LoRA candidate scoring |
9B |
Serupa |
Pelatihan dan riset |
|
Kev |
Qwen + LoRA + pointer head |
0.8B–9B |
Ya |
Deployment lokal mirip Jev |
|
SemIf |
Logit langsung dari LLM terbuka |
Tergantung model |
Serupa |
Eksperimen direct-logit |
|
Rizzo Flow |
Spark + pemberian skor opsi langsung |
1.7B–4B |
Ya |
Serving lokal yang mudah |
|
Von |
ModernBERT + OptionMarker |
~395M |
Ya |
Inferensi keputusan yang ringkas |
|
NanoJev |
Qwen3 + decision head bersama |
0.6B |
Ya |
Replika Jev kecil yang dapat dilatih |
Dalam praktiknya, encoder khusus memprioritaskan kecepatan dan efisiensi, model Qwen yang diadaptasi mempertahankan kemampuan bahasa yang lebih umum, dan metode direct-logit lebih mudah untuk dieksperimenkan karena memerlukan pelatihan yang kurang khusus.
Untuk model keputusan kecil yang terspesialisasi, Laya, Von, dan NanoJev termasuk opsi paling menarik, berkisar dari sekitar 322M hingga 600M parameter.
Jika Anda memerlukan pengambilan keputusan multibahasa, Laya menonjol dengan checkpoint berbasis mmBERT khusus yang mencakup 100+ bahasa.
Untuk aplikasi yang dibangun di sekitar API TypeSafe System One, Kev dan Von menyediakan jalur integrasi yang sangat dekat, sementara Rizzo Flow mencerminkan antarmuka HTTP yang sama untuk serving lokal.
Untuk pelatihan dan eksperimen, Nimble memublikasikan kurasi data dan resep fine-tuning LoRA-nya, sementara NanoJev menyediakan pipeline lengkap yang mencakup pembuatan data, pelatihan, evaluasi, dan serving.
Jika Anda ingin bereksperimen tanpa melatih model keputusan khusus, SemIf adalah baseline yang berguna: ia membaca probabilitas opsi langsung dari model terbuka yang ada seperti Qwen alih-alih menghasilkan jawaban.
Arsitektur Jev mungkin baru, tetapi gagasan dasarnya tidak.
Klasifikator NLI zero-shot telah memberi skor label kandidat arbitrer dari logit model selama bertahun-tahun, jauh sebelum Jev.
Yang ditambahkan TypeSafe AI adalah arsitektur yang dibuat khusus, keluaran paralel, probabilitas terkalibrasi, dan API yang rapi untuk mengubah ide itu menjadi lapisan keputusan yang dapat diprogram.
Ekosistem open-source menunjukkan bahwa Anda tidak memerlukan layanan tertutup untuk membangun sesuatu yang serupa.
Proyek seperti Kev, Von, dan Rizzo Flow dapat berjalan secara lokal dan mengekspos antarmuka bergaya Jev, sementara yang lain memungkinkan Anda mengunduh bobot, mengkuantisasinya, atau menggunakan runtime seperti llama.cpp.
Inti pelajarannya bukan bahwa Jev menemukan pengambilan keputusan AI, melainkan ia mengembalikan perhatian pada gagasan penting: jika aplikasi Anda hanya memerlukan sebuah keputusan, Anda mungkin tidak memerlukan pembuatan teks sama sekali.
Kursus DataCamp Teratas
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt




