
Leerpad
Grote taalmodellen ontwikkelen
16 uur
Veel AI-toepassingen gebruiken large language models voor taken die eigenlijk geen tekstgeneratie vereisen.
Een agent hoeft soms alleen te beslissen welke tool aan te roepen, of een document relevant is, hoe urgent een verzoek is of of een actie opgeschaald moet worden.
TypeSafe AI’s Jev pakt deze taken anders aan. In plaats van token voor token een antwoord te genereren, neemt het de applicatiestatus en gestructureerde vragen en geeft getypeerde beslissingen terug zoals keuzes, scores, ja/nee-oordelen en waarschijnlijkheden. Bekijk het in actie in onze Jev API-tutorial
TypeSafe AI beschrijft dit als een System One Model-aanpak: AI gebruiken als een snelle beslissingslaag in plaats van als algemene tekstgenerator.
De uitdaging is dat we nog relatief weinig weten over hoe Jev intern werkt.
TypeSafe AI heeft enkele details gedeeld over de parallelle besluitvorming en de trainingsmethode, maar de volledige architectuur, modelgewichten, trainingsdata en het complete trainingsrecept zijn niet openbaar.
Daardoor is het lastig om Jev zelf te inspecteren, reproduceren of aan te passen.
Open-sourceprojecten verkennen hetzelfde idee met architecturen die we daadwerkelijk kunnen bestuderen en lokaal draaien.
Sommige gebruiken kleine bidirectionele modellen, anderen passen Qwen aan met gespecialiseerde decision heads, terwijl weer anderen rechtstreeks waarschijnlijkheden uit bestaande language models halen.
Omdat je de volledige stack beheert, kun je ook optimaliseren voor modelgrootte, kwantisatie, batching, caching, hardware en serving om een snellere en goedkopere beslissingslaag voor je eigen workload te bouwen.
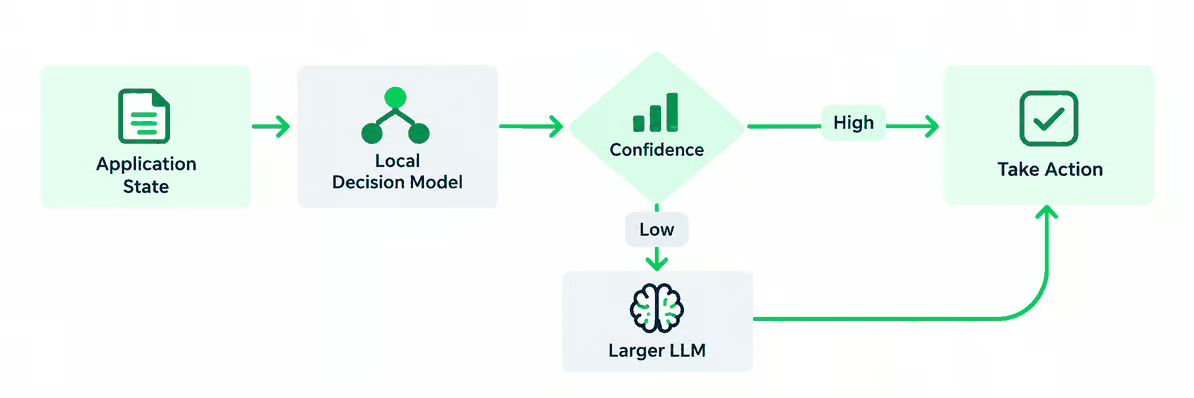
In deze blog vergelijk ik zeven open-sourcealternatieven voor Jev, waaronder Laya, Nimble, Kev, SemIf, Rizzo Flow, Von en NanoJev. Ik kijk naar hoe elk werkt, hoe nauw ze de Jev-aanpak volgen, waar ze in uitblinken en hoe je ze lokaal draait.
Disclaimer: de projecten in deze gids zijn erg nieuw en veranderen snel. De codevoorbeelden zijn gebaseerd op hun officiële documentatie en repositories, maar niet alle voorbeelden zijn end-to-end onafhankelijk getest.
Laya is een doelgericht, niet-autoregressief beslissingsmodel gebaseerd op ModernBERT-large, met een apart mmBERT-checkpoint voor meertalige workloads.
In plaats van tekst te genereren, verwerkt het de status, vraag en beschikbare opties samen en scoort het de mogelijke antwoorden direct in één forward pass. Het ondersteunt Jev-achtige choice-, score- en noul-beslissingen, met dedicated checkpoints voor Engelstalige, meertalige en getypeerde-beslissingsworkloads.
Dit maakt Laya tot een van de architecturaal dichtste alternatieven voor Jev, omdat beide specifiek zijn ontworpen voor probabilistische beslissingen in plaats van tekstgeneratie.
Laya valt op door de relatief kleine modellen van 322M–421M, meertalige ondersteuning voor 100+ talen en de mogelijkheid om meerdere vragen efficiënt te evalueren zonder een generatief model met miljarden parameters te draaien.
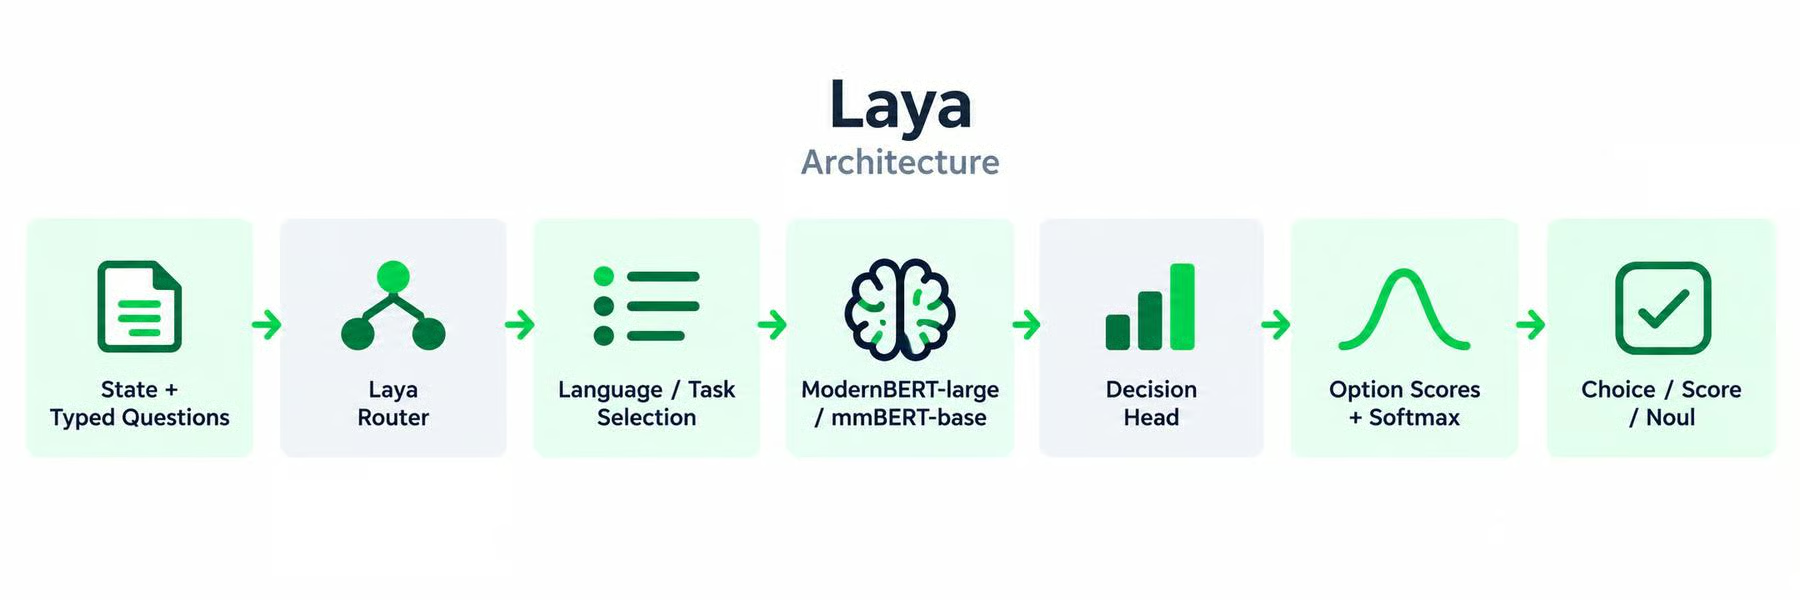
Laya neemt een status zoals een e-mail, supportticket, document of JSON-object, samen met getypeerde vragen zoals choice, score of noul.
De router kiest het meest geschikte checkpoint voor het verzoek, zoals ModernBERT-large voor Engels of mmBERT-base voor meertalige input.
Het geselecteerde model verwerkt de status en vragen in één forward pass, waarna een decision head de beschikbare opties scoort en omzet in waarschijnlijkheden.
Dit creëert een directe flow van input, via routing en encoding, naar de uiteindelijke getypeerde beslissing.
 Aan de slag met Laya
Laya is beschikbaar als Python-package:
pip install layaDeze opdracht installeert de Laya-bibliotheek en afhankelijkheden, maar bundelt de modelgewichten niet in het pakket.
De modellen staan op Hugging Face.
Als je de router maakt met preload=True, downloadt en laadt Laya direct de beschikbare checkpoints zodat ze klaarstaan vóór het eerste verzoek.
De gedownloade gewichten worden lokaal gecached, zodat ze niet telkens opnieuw hoeven te worden gedownload.
from laya import Router

router = Router(preload=True)

state = {
    "subject": "Duplicate charge",
    "body": "I was charged twice. Please refund this today."
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "Which department should handle this?",
        "criteria": {
            "billing": "Payments and refunds",
            "technical": "Errors and outages",
            "sales": "Pricing and purchases"
        }
    }
}

result = router.predict(state, questions)

print(result["answers"]["department"]["choice"])
Hier is Router(preload=True) het belangrijkste onderdeel.
Bij de eerste run haalt Laya de vereiste modelbestanden op uit de Hugging Face-repository en laadt ze in het geheugen. Volgende runs kunnen de lokaal gecachete kopieën hergebruiken.
Als je in plaats daarvan gebruikt:
router = Router()Laya gebruikt dan lazy loading. Het wacht tot een specifiek checkpoint nodig is en downloadt/bouwt het bij het eerste gebruik.
Bespoke Nimble gebruikt Qwen3.5-9B als backbone en fine-tunet het met een rank-16 LoRA specifiek voor getypeerde besluitvorming.
Je geeft tekst aan samen met een vlak schema met boolean- of enum-vragen, en Nimble retourneert het geselecteerde antwoord plus waarschijnlijkheden voor elke toegestane optie.
In plaats van token voor token een antwoord te decoderen, werken training en inferentie direct op de kandidaatlogits.
Net als Jev is Nimble gebouwd rond het idee van status erin, getypeerde probabilistische beslissingen eruit, maar de implementatie laat zien hoe dat gedrag kan worden toegevoegd aan een bestaande open LLM in plaats van een propriëtaire beslissingsarchitectuur te vereisen.
De grootste kracht is de openheid van het hele proces: Bespoke Labs publiceerde het model, het trainingsrecept, de evaluatie-setup en de datacuratiepijplijn, wat Nimble bijzonder nuttig maakt voor ontwikkelaars die hun eigen Jev-achtige modellen willen trainen of bestuderen.
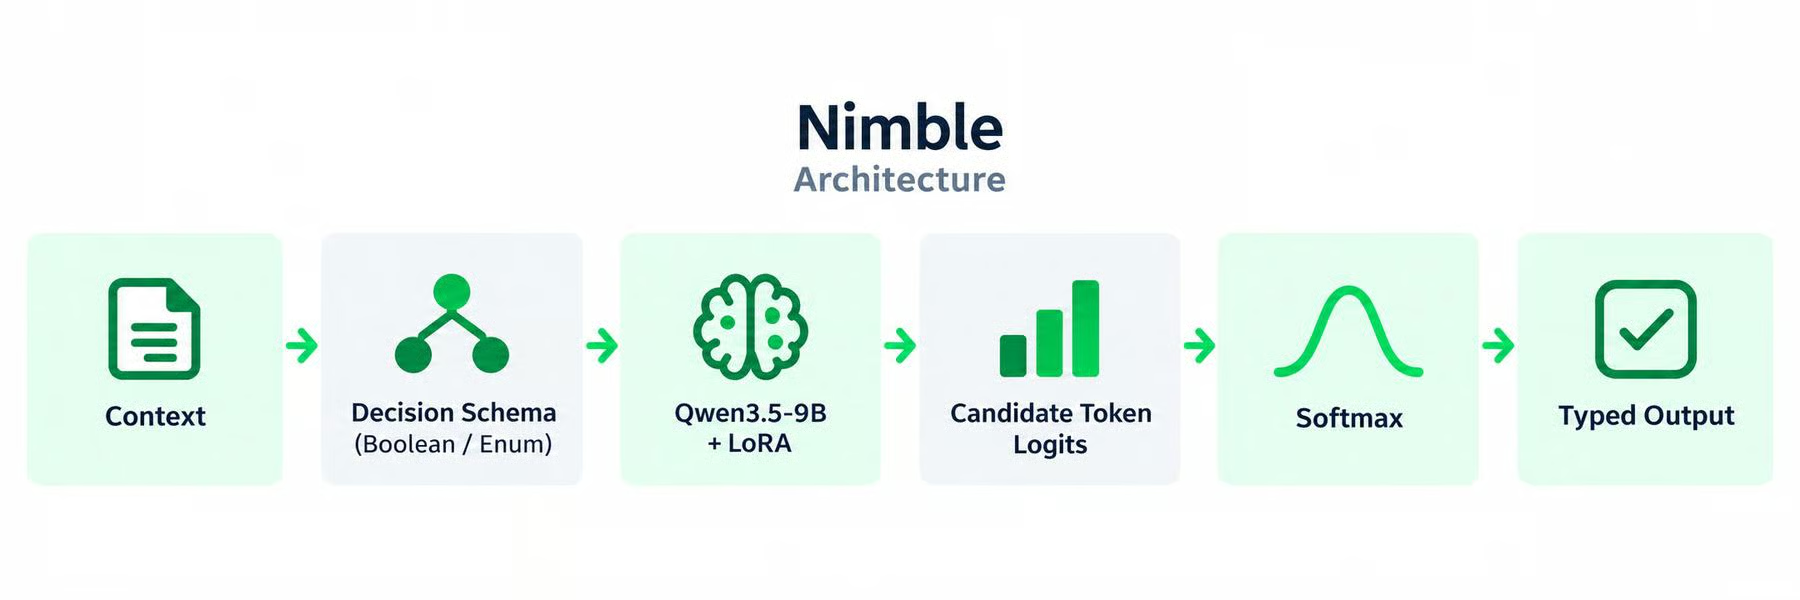
Nimble begint met een context en een beslissingsschema dat de toegestane outputs definieert, zoals een boolean of één waarde uit een enum.
Het gebruikt Qwen3.5-9B met LoRA om de context en het schema te verwerken, en leest vervolgens de logits voor de toegestane kandidaat-tokens in plaats van een volledig antwoord te genereren.
Die logits gaan door softmax om waarschijnlijkheden te produceren, die worden teruggegeven als gestructureerde getypeerde output.
 Aan de slag met Nimble
Nimble vereist Python 3.12 en gebruikt het Bespoke-Nimble-9B-checkpoint. Begin met het clonen van de repository en het installeren van de dependencies:
git clone https://github.com/bespokelabsai/nimble.git nimble
cd nimble

python3.12 -m venv .cache/venvs/nimble
source .cache/venvs/nimble/bin/activate

python -m pip install torch==2.8.0 -r requirements/training.txt
Download en bereid vervolgens het model voor. De officiële voorbereidingsstap downloadt bespokelabs/Bespoke-Nimble-9B van Hugging Face en voegt, indien nodig, de LoRA-adapter samen met het gepinde Qwen3.5-basismodel. Daarna wordt .cache/nimble-model.json aangemaakt.
import json
from pathlib import Path
from huggingface_hub import snapshot_download

repo = "bespokelabs/Bespoke-Nimble-9B"

snapshot = Path(
    snapshot_download(
        repo,
        cache_dir=".cache/huggingface/hub"
    )
)

config = {
    "model_path": str(snapshot.resolve()),
    "model_id": repo,
    "revision": snapshot.name,
    "max_input_tokens": 2048,
}

Path(".cache/nimble-model.json").write_text(
    json.dumps(config, indent=2)
)
Als de gedownloade release een LoRA-adapter is, gebruik dan Nimble's volledige voorbereidingsblok uit de officiële quickstart zodat de adapter voor inferentie kan worden samengevoegd met het gepinde basismodel.
Laad op een NVIDIA-GPU het voorbereide model:
import json
from pathlib import Path
from nimble.scoring.cuda_scorer import CudaCandidateScorer

config = json.loads(
    Path(".cache/nimble-model.json").read_text()
)

scorer = CudaCandidateScorer(**config)
Then make a typed decision:
schema = {
    "priority": {
        "type": "enum",
        "choices": ["HIGH", "LOW"],
        "description": "Urgency based on current business impact."
    },
    "requires_review": {
        "type": "boolean",
        "description": "Whether a human should review this incident."
    }
}

result = scorer.score(
    "The payment service is down for all customers.",
    schema
)

print(result["output"])
print(result["fields"]["priority"]["scores"])
Nimble retourneert de geselecteerde waarden samen met de waarschijnlijkheid die aan elke kandidaat is toegekend, in plaats van een tekstrespons te genereren.
Kev is een familie van door Jev geïnspireerde beslissingsmodellen gebouwd op Qwen3.5, met varianten van 0.8B, 4B en 9B.
Het voegt een rank-16 LoRA-adapter toe en een kleine pointer head die elke optierepresentatie vergelijkt met de beslissingsrepresentatie van de vraag.
Meerdere vragen kunnen dezelfde status delen, terwijl Kev de vragen isoleert en hun waarschijnlijkheidsverdelingen teruggeeft zonder tekst te genereren.
Kev ligt bijzonder dicht bij Jev omdat de architectuur expliciet is gebaseerd op een publieke reconstructie van Jev, en de server het /v1/systemone API-contract van TypeSafe implementeert.
Het ondersteunt dezelfde noul-, choice- en score-vraagstijlen, zodat bestaande TypeSafe-SDK-code kan worden omgeleid naar een lokale Kev-server.
Het belangrijkste voordeel is deze combinatie van Jev-achtig gedrag, open gewichten, meerdere modelgroottes en een open trainingstraject.
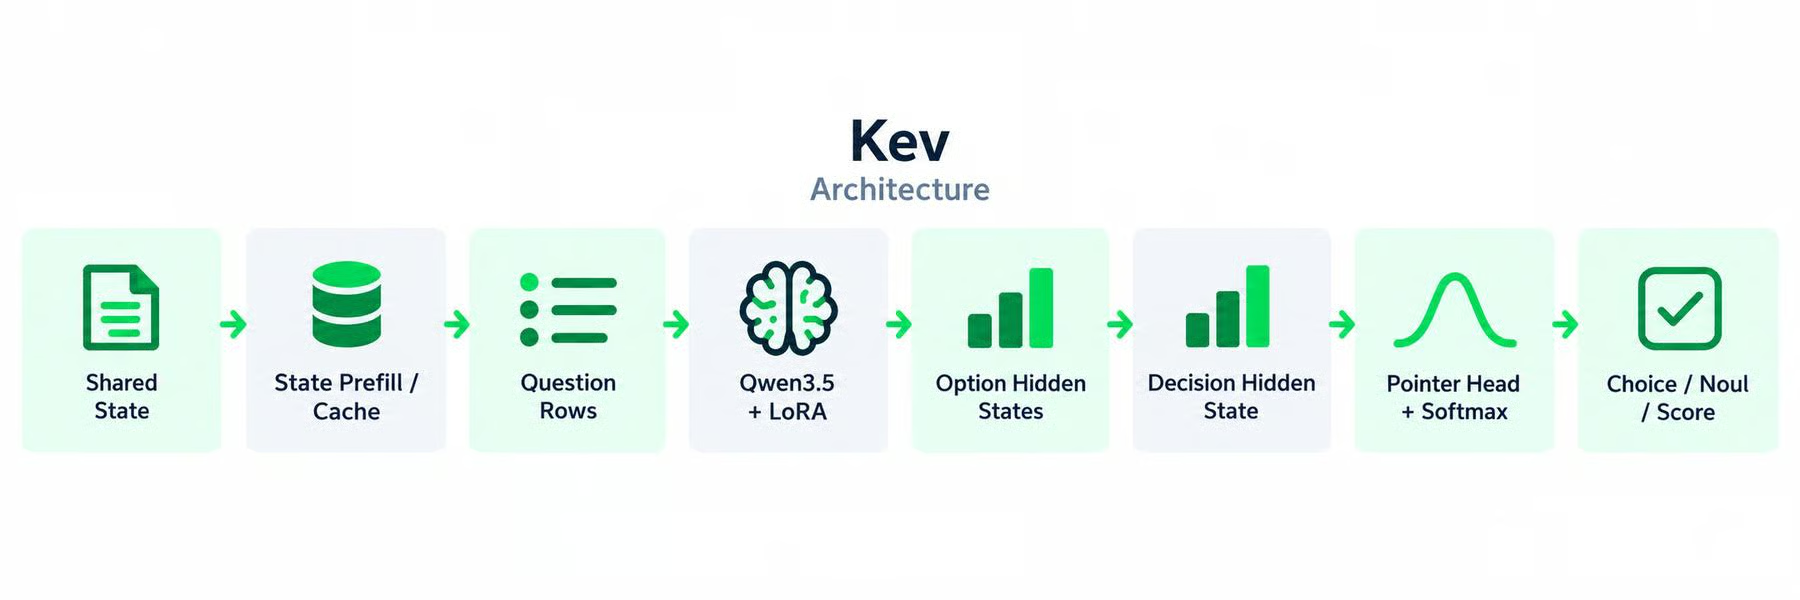
Kev gebruikt een Qwen-basismodel met een LoRA-adapter en een kleine pointer head.
De gedeelde status wordt één keer verwerkt en hergebruikt over meerdere vragen, zodat het model niet telkens dezelfde context hoeft te verwerken.
Voor elke vraag maakt Kev verborgen representaties voor de opties en de decision token, waarna de pointer head deze vergelijkt en optiescores produceert.
Softmax zet die scores om in waarschijnlijkheden voor de uiteindelijke choice, noul of score.
 Aan de slag met Kev
Kev draait als een lokale System One-server.
Begin met het clonen van het project en het installeren van de serving-dependencies:
git clone https://github.com/jaredpalmer/kev.git
cd kev

uv sync --extra serve
Dit installeert Kev zelf, maar niet per se alle modelgewichten.
Start Kev-4B met:
KEV_DTYPE=bf16 \
uv run --extra serve python -m kev.serve \
    --run jaredpalmer/kev-4b \
    --port 8009
Bij de eerste run downloadt Kev automatisch zowel de Kev-adapter/het checkpoint als het Qwen-basismodel van Hugging Face.
Latere starts hergebruiken de gecachete modelbestanden in plaats van ze opnieuw te downloaden.
Zodra de server draait, kun je de TypeSafe-SDK erop gebruiken:
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)

response = client.system_one(
    state="I was charged twice.",
    questions={
        "team": Choice(
            instructions="Which team owns this?",
            criteria={
                "billing": None,
                "technical": None,
            },
        )
    },
)

print(response.choices["team"].choice)
Bij Kev fungeert de serveropdracht dus ook als de modellaadstap: bij de eerste start worden de vereiste gewichten automatisch gedownload.
SemIf kiest een eenvoudigere aanpak: het traint helemaal geen nieuw beslissingsmodel.
In plaats daarvan gebruikt het bestaande open modellen zoals Qwen3.5-4B en leest het rechtstreeks de logits toegekend aan de toegestane antwoorden.
De status, criteria en getypeerde opties worden aan het model doorgegeven, en SemIf zet de native optie-logits om in waarschijnlijkheden zonder te sampelen of een antwoord te genereren.
Dit reproduceert een van Jev's belangrijkste praktische eigenschappen: beslissingen nemen zonder autoregressieve output, terwijl de noodzaak voor een gespecialiseerd checkpoint vervalt.
SemIf valt op door de flexibiliteit: je kunt verschillende open modellen eronder gebruiken, een lange status hergebruiken over veel vragen, en experimenteren met directe scoring op CUDA, Apple Silicon of gekwantiseerde browsermodellen.
Het is vooral nuttig als je het System One-idee wilt testen zonder eerst een dedicated model te trainen.
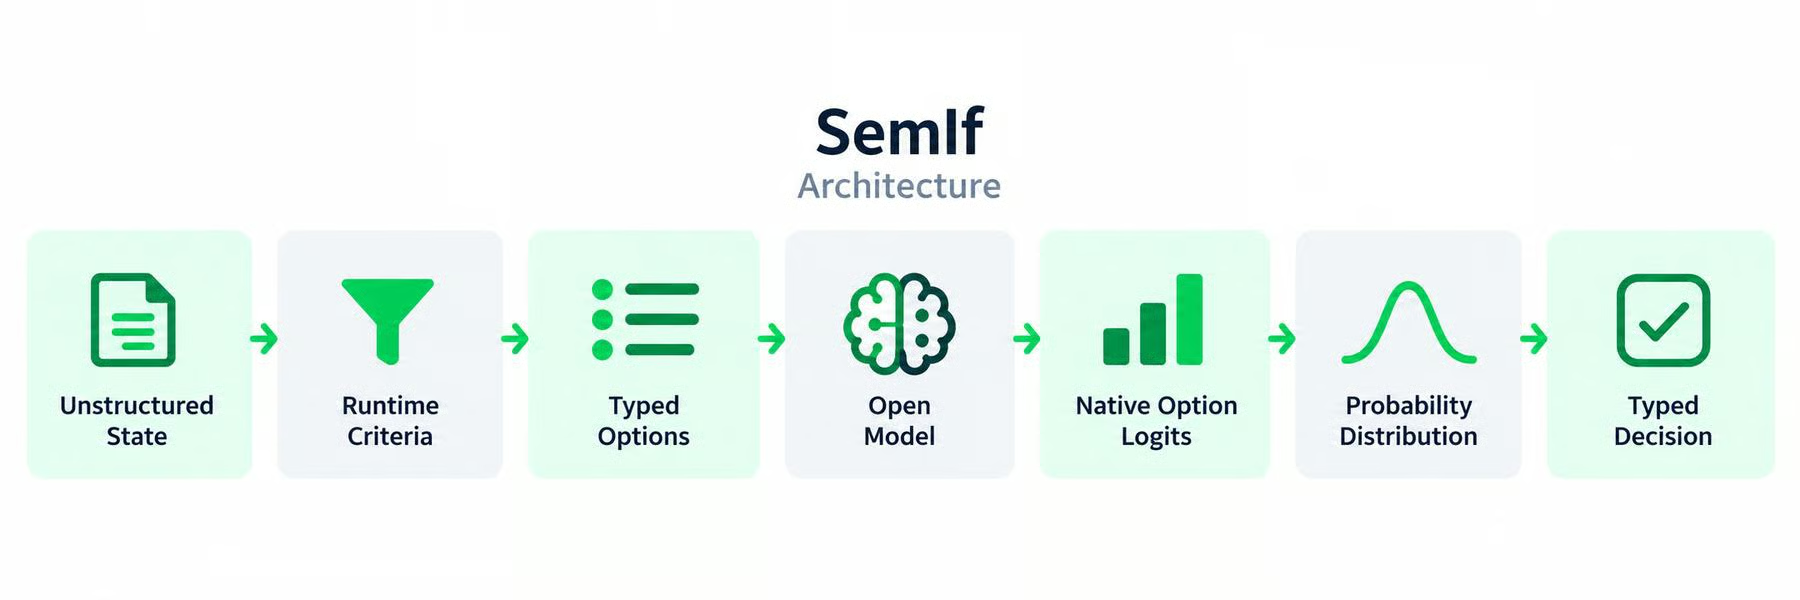
SemIf neemt een ongestructureerde status, runtime-criteria en een set toegestane opties en stuurt die door een bestaand open model.
In plaats van het model te vragen een antwoord te genereren, leest het direct de logits toegekend aan die vooraf gedefinieerde opties.
Deze logits worden omgezet in een waarschijnlijkheidsverdeling, zodat de applicatie een getypeerde beslissing kan nemen zonder tekst te genereren of achteraf een respons te parsen.
 Aan de slag met SemIf
SemIf heeft geen eigen dedicated foundation-modelcheckpoint. In plaats daarvan draait het beslissingsscoring bovenop een bestaand open model.
Clone en installeer het:
git clone https://github.com/TheoLeeCJ/SemIf.git
cd SemIf

python -m venv .venv
source .venv/bin/activate

pip install -e '.[test]'
Dit installeert SemIf, maar downloadt Qwen nog niet.
Draai de scorer:
CUDA_VISIBLE_DEVICES=0 semif-score \
    --mode direct \
    --model Qwen/Qwen3.5-4B \
    --revision 851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a \
    --input examples/decisions.jsonl \
    --output results.jsonl
Bij de eerste run wordt het geselecteerde Qwen-model van Hugging Face gedownload en in de Hugging Face-cache opgeslagen. De documentatie van SemIf raadt zelfs aan om HF_HOME op een grote schijf te zetten, omdat de modelbestanden veel ruimte kunnen innemen.
Bijvoorbeeld:
export HF_HOME=/path/to/large-drive/huggingfaceNa caching van het model kunnen volgende runs de lokale kopie hergebruiken.
SemIf zelf is dus relatief klein. Het meeste downloadvolume komt van het open model dat je eronder kiest.
Rizzo Flow is een local-first Jev-achtige inferentiesysteem, gebouwd rond open Spark-X2.5-modellen en llama.cpp-gebaseerde serving.
In plaats van een JSON-antwoord te genereren, zet het elke beslissing om in een beperkte set mogelijke antwoordtokens, leest de logits die aan die tokens zijn toegekend en maakt daar waarschijnlijkheden van.
De status kan één keer worden verwerkt en hergebruikt over meerdere vragen, wat herhaalde berekeningen vermindert.
Net als Jev accepteert Rizzo Flow ongestructureerde status en retourneert getypeerde beslissingen zoals ja/nee-oordelen, keuzes, scores en numerieke outputs.
Het spiegelt ook de HTTP-interface van TypeSafe, waardoor het relatief eenvoudig is om een gehoste call te vervangen door een lokale endpoint.
Rizzo Flow valt vooral op door lokale deployment en hardwareflexibiliteit: het combineert open modellen, kwantisatie en een vertrouwde API in plaats van te proberen Jev's propriëtaire trainingsarchitectuur te reproduceren.
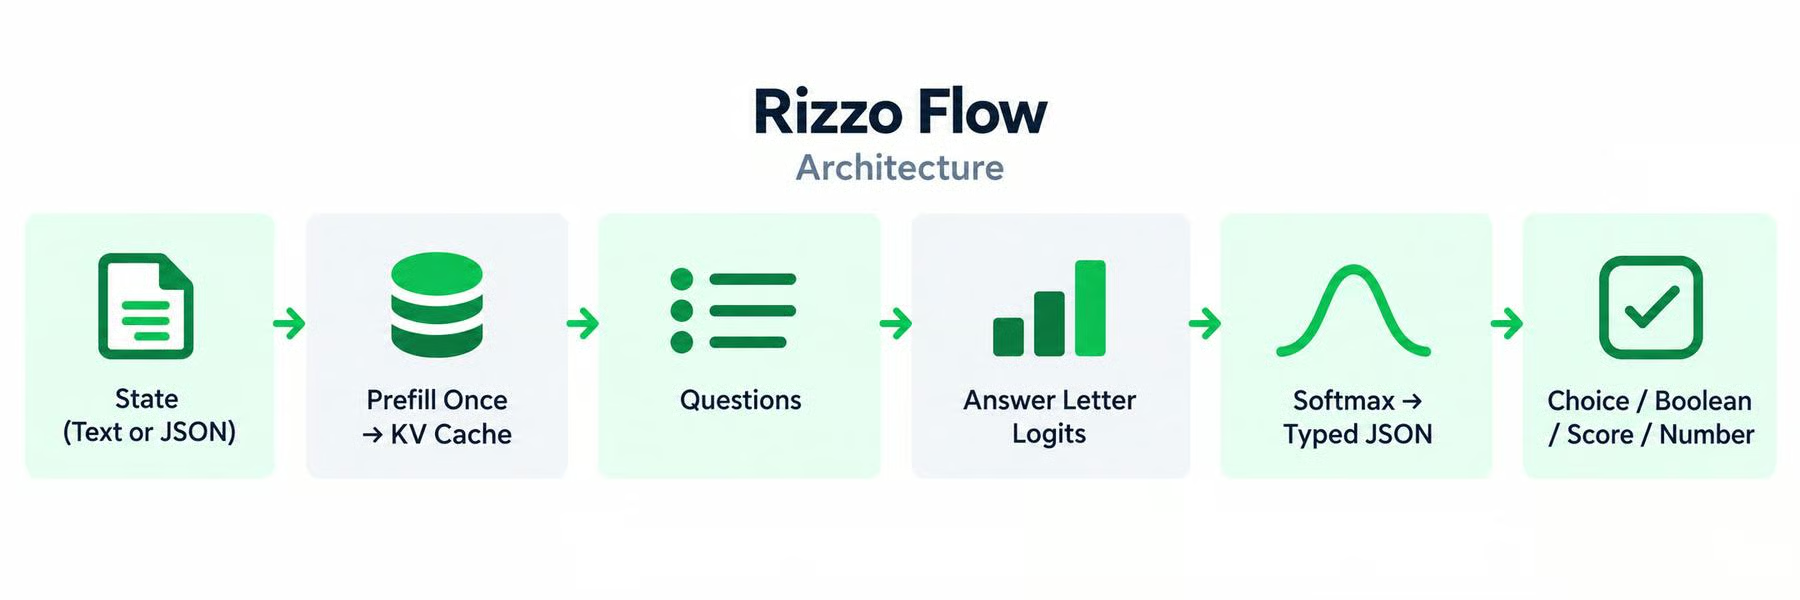
Rizzo Flow verwerkt de status eenmaal en slaat het resultaat op in de KV-cache van het model.
Vervolgens kunnen meerdere vragen die gecachete status hergebruiken in plaats van de volledige context opnieuw te verwerken. Elke vraag wordt omgezet in een multiplechoiceprobleem, met kandidaat-antwoorden weergegeven door letters zoals A, B of C.
Rizzo Flow leest alleen de logits voor die antwoordletters, past softmax toe en zet de resulterende waarschijnlijkheden om in getypeerde outputs zoals een boolean, keuze, score of getal.
Rizzo Flow vereist Python 3.11+, Git en uv.
Kies bij het installeren de compute-backend voor je machine. Bijvoorbeeld, op Linux met een NVIDIA-GPU:
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow

uv sync --locked --extra cuda
source .venv/bin/activate
Voor Apple Silicon gebruik je --extra mlx; CPU-only systemen kunnen --extra cpu gebruiken.
Download vervolgens het standaard Spark-X2.5-model en de lokale runtime:
rizzo downloadStart daarna de server:
rizzo serveHet model draait nu lokaal op http://127.0.0.1:8017.
Je kunt de Jev-compatibele endpoint testen met een echte beslissing:
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "My payouts have been failing for three days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and outages",
          "sales": null
        }
      }
    }
  }'
Rizzo Flow retourneert het antwoord en de waarschijnlijkheidsverdeling direct, zonder token voor token een outputrespons te genereren.
Von is een doelgericht System One-model gebaseerd op een bidirectionele ModernBERT-architectuur met 395M parameters.
In plaats van tekst te decoderen, evalueert het de status en kandidaatcriteria samen met OptionMarker-representaties, en produceert vervolgens direct logits voor Choice-, Noul- en Score-beslissingen.
Het past ook post-training calibratie toe zodat de resulterende waarschijnlijkheidsverdelingen direct door applicatielogica gebruikt kunnen worden.
Von lijkt op interface-niveau sterk op Jev: het is niet-autoregressief, ondersteunt dezelfde drie kernbeslissingsprimitieven, evalueert meerdere vragen in één forward pass en implementeert het /v1/systemone-protocol.
De grootste kracht is de kleine footprint en het lokale inferentiedesign: het model heeft honderden miljoenen in plaats van miljarden parameters en ondersteunt CUDA, ROCm, Apple Silicon en CPU-executie.
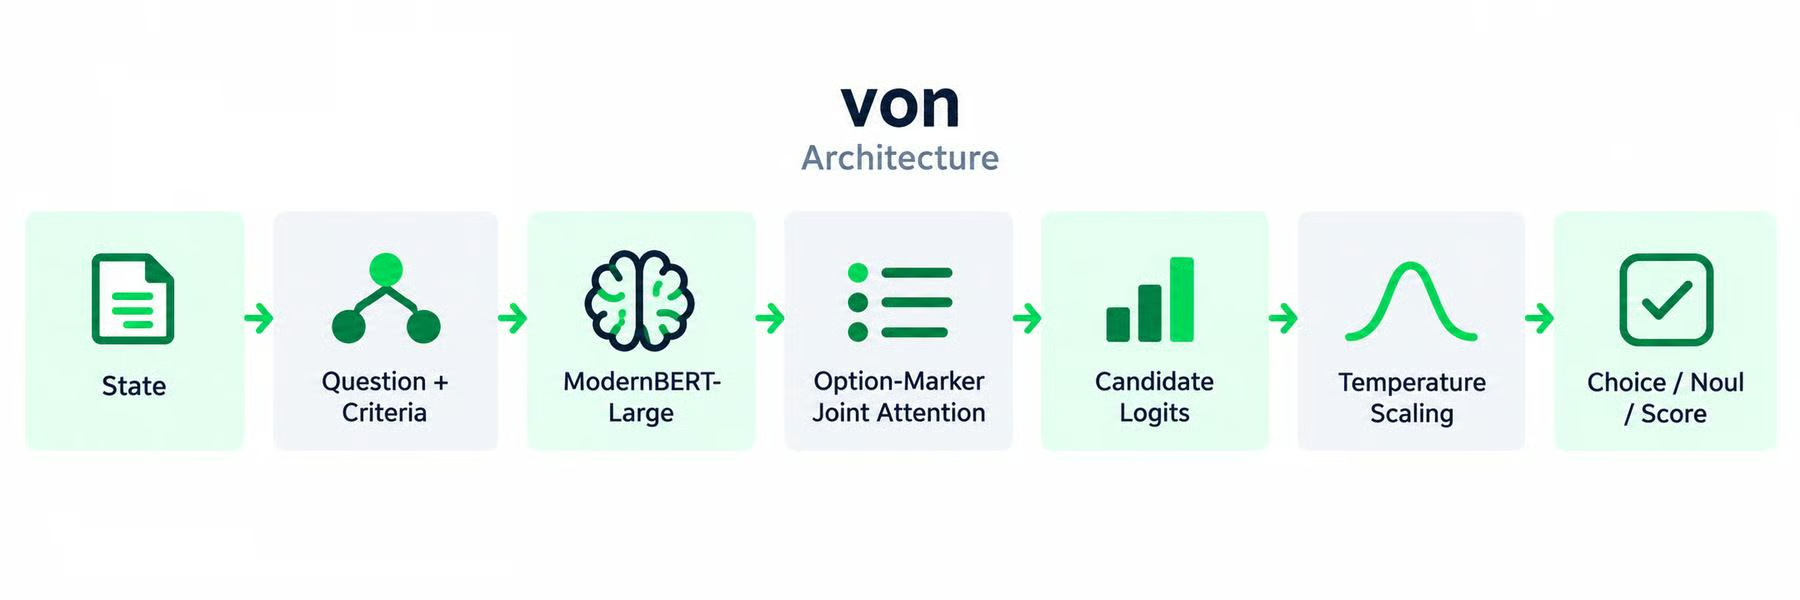
von gebruikt een compact bidirectioneel ModernBERT-gebaseerd model om de status, vraag en kandidaatcriteria samen te verwerken.
Het Option-Marker-mechanisme creëert representaties voor de mogelijke antwoorden, die worden omgezet in kandidaatlogits.
Temperatuurschaling wordt vervolgens toegepast om de waarschijnlijkheidsverdeling te verbeteren voordat von de uiteindelijke choice-, noul- of score teruggeeft.
Dezelfde architectuur kan ook meerdere vragen in één forward pass evalueren.
Von heeft een van de eenvoudigste interfaces.
Installeer de Python-SDK:
pip install von-sdkDit installeert de Von-software. Het eigenlijke model wordt apart gepubliceerd als wfzyx/von-1.0 op Hugging Face.
Wanneer het model voor het eerst wordt geladen, wordt het ModernBERT-checkpoint gedownload en lokaal gecached via het Hugging Face/Transformers-laadsysteem.
Na caching kan latere inferentie de lokale kopie gebruiken in plaats van de gewichten opnieuw te downloaden.
Je kunt vervolgens een beslissing maken met:
import von

result = von.decide(
    state="Database replication lag exceeded 45 seconds.",
    choices={
        "infrastructure": "Database or network failures",
        "billing": "Payments and invoices",
        "feature": "Requests for new functionality",
    },
    instructions="Classify the root cause.",
)

print(result.choice)
print(result.confidence)
For a binary decision:
p_blocking = von.judge(
    state="Requests are timing out.",
    instructions="Is this actively blocking customers?"
)

print(p_blocking)
De eerste aanroep kan dus langer duren omdat het model moet worden gedownload en geïnitialiseerd. Daarna vindt de inferentie lokaal plaats.
NanoJev is een 0.6B Jev-kopie gebouwd op Qwen3-0.6B met dedicated decision heads voor gestructureerde outputs.
Elke aanvraag bevat een status, vraag en kandidaten set, die door de backbone gaan voordat gedeelde heads volledige waarschijnlijkheidsverdelingen produceren.
Choice gebruikt set attention en een scalaire head, Boolean-beslissingen gebruiken een sigmoid, en Score evalueert geordende niveaus en produceert zowel een verdeling als een verwachte score.
NanoJev volgt Jev's ontwerp bijzonder nauw: het ondersteunt parallelle beslissingen, dynamische kandidatensets, volledige waarschijnlijkheidsverdelingen en nul outputdecoding.
Het valt vooral op door de zeer kleine backbone en expliciete end-to-end-trainingspijplijn.
Het kan meerdere statussen, vragen en kandidatenpaden batchen in één backbone-forward pass, wat het interessant maakt voor ontwikkelaars die willen experimenteren met een compact, trainbaar Jev-achtig ontwerp in plaats van een groter generiek LLM aan te passen.
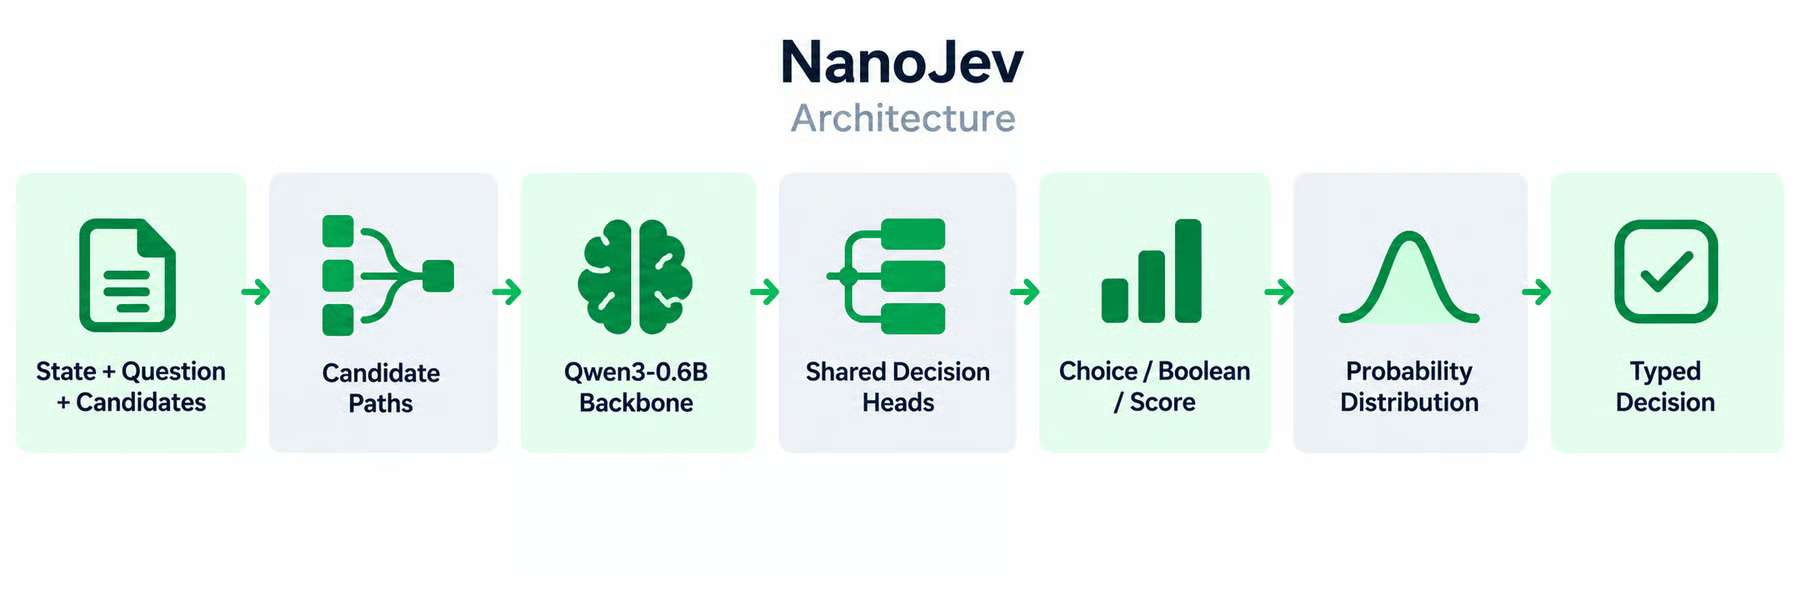
NanoJev neemt een status, een vraag en de kandidaatantwoorden waaruit het model mag kiezen.
Elke kandidaat wordt gecombineerd met de relevante input en door een gedeelde Qwen3-0.6B-backbone gestuurd.
NanoJev gebruikt vervolgens dedicated decision heads om de kandidaten direct te scoren: Choice gebruikt set attention en softmax, Boolean gebruikt een sigmoid en Score produceert een waarschijnlijkheidsverdeling over geordende niveaus.
Omdat het deze waarschijnlijkheden direct uit de forward pass leest, kan het volledige getypeerde verdelingen teruggeven zonder outputtokens te genereren.
NanoJev houdt de modeldownload gescheiden van de repository-installatie.
Begin met het installeren van het project:
git clone https://github.com/TianyuCodings/NanoJev.git
cd NanoJev

python -m pip install \
    -r requirements-toy.txt \
    huggingface_hub
Download daarna het gepinde publieke checkpoint:
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="C-Tianyu/NanoJev",
    revision="unified-games-v1",
    local_dir="checkpoints/NanoJev-unified",
    allow_patterns=[
        "best.safetensors",
        "config.json",
        "tokenizer/*",
        "backbone_config/*",
    ],
)
Start de lokale inferentieserver:
CUDA_VISIBLE_DEVICES=0 python scripts/serve_decisions.py \
    --checkpoint-dir checkpoints/NanoJev-unified \
    --web-root web \
    --host 127.0.0.1 \
    --port 8765 \
    --precision bf16
Maak een request:
cat > data/request.json <<'JSON'
{
  "states": [{
    "id": "living_room",
    "state": "The living room is 29 degrees. The target is 24 degrees. The window is closed and someone is home.",
    "questions": {
      "action": {
        "type": "choice",
        "instructions": "Choose the action that most directly lowers the room temperature.",
        "criteria": {
          "cool": "Turn on air conditioning",
          "light": "Turn on the lights",
          "wait": "Keep the current settings"
        }
      },
      "occupied": {
        "type": "boolean",
        "instructions": "Someone is home."
      }
    }
  }]
}
JSON
Stuur het vervolgens naar NanoJev:
curl http://127.0.0.1:8765/api/evaluate \
  -H 'Content-Type: application/json' \
  --data-binary @data/request.json
De server houdt het checkpoint geladen en retourneert de waarschijnlijkheidsverdeling voor elke vraag. NanoJev kan ook meerdere statussen en vragen in hetzelfde verzoek batchen.
Het belangrijkste verschil is hoe elk project de beslissing produceert.
Laya en Von gebruiken kleine bidirectionele encoders die speciaal zijn gebouwd voor optiesscoring.
Kev, Nimble en NanoJev passen Qwen-modellen aan met gespecialiseerde training of decision heads.
SemIf en Rizzo Flow kiezen een lichtere aanpak door rechtstreeks waarschijnlijkheden te halen uit bestaande generatieve modellen.
|
Project |
Architectuur |
Grootte |
Jev-stijl beslissingen |
Het meest geschikt voor |
|
Laya |
ModernBERT/mmBERT + decision head |
322M–421M |
Ja |
Kleine meertalige beslissingen |
|
Nimble |
Qwen3.5 + LoRA kandidaat-scoring |
9B |
Vergelijkbaar |
Training en onderzoek |
|
Kev |
Qwen + LoRA + pointer head |
0.8B–9B |
Ja |
Jev-achtige lokale deployment |
|
SemIf |
Directe logits van open LLM's |
Modelafhankelijk |
Vergelijkbaar |
Direct-logit experimenten |
|
Rizzo Flow |
Spark + directe optiesscoring |
1.7B–4B |
Ja |
Eenvoudig lokaal serven |
|
Von |
ModernBERT + OptionMarker |
~395M |
Ja |
Compacte beslissingsinferentie |
|
NanoJev |
Qwen3 + gedeelde decision heads |
0.6B |
Ja |
Kleine trainbare Jev-kopie |
In de praktijk geven dedicated encoders prioriteit aan snelheid en efficiëntie, behouden aangepaste Qwen-modellen meer algemene taalcapaciteit en zijn direct-logitmethoden eenvoudiger om mee te experimenteren omdat ze minder gespecialiseerde training vereisen.
Voor kleine, gespecialiseerde beslissingsmodellen zijn Laya, Von en NanoJev enkele van de meest interessante opties, variërend van ongeveer 322M tot 600M parameters.
Als je meertalige besluitvorming nodig hebt, valt Laya op met een dedicated mmBERT-checkpoint voor 100+ talen.
Voor toepassingen die draaien op de TypeSafe System One API bieden Kev en Von bijzonder nauwe integratiepaden, terwijl Rizzo Flow dezelfde HTTP-interface spiegelt voor lokaal serven.
Voor training en experimentatie publiceert Nimble zijn datacuratie- en LoRA-fine-tuningrecept, terwijl NanoJev een volledige pijplijn biedt voor datageneratie, training, evaluatie en serving.
Als je wilt experimenteren zonder een gespecialiseerd beslissingsmodel te trainen, is SemIf een nuttige baseline: het leest optie-waarschijnlijkheden rechtstreeks uit bestaande open modellen zoals Qwen in plaats van een antwoord te genereren.
JeV's exacte architectuur is misschien nieuw, maar het onderliggende idee niet.
Zero-shot NLI-classifiers scoren al jaren willekeurige kandidaatlabels op basis van modellogits, lang vóór Jev.
Wat TypeSafe AI toevoegt, is een doelgerichte architectuur, parallelle outputs, gekalibreerde waarschijnlijkheden en een strakke API om dat idee om te zetten in een programmeerbare beslissingslaag.
Het open-source-ecosysteem laat zien dat je geen gesloten dienst nodig hebt om iets vergelijkbaars te bouwen.
Projecten zoals Kev, Von en Rizzo Flow kunnen lokaal draaien en Jev-achtige interfaces blootstellen, terwijl andere je de gewichten laten downloaden, ze kwantiseren of runtimes zoals llama.cpp laten gebruiken.
De echte les is niet dat Jev AI-besluitvorming heeft uitgevonden, maar dat het de aandacht heeft teruggebracht naar een belangrijk idee: als je applicatie alleen een beslissing nodig heeft, heb je mogelijk helemaal geen tekstgeneratie nodig.
Top DataCamp-cursussen
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

