
Last chance! 50% off DataCamp Premium
Sale ends in
कई AI एप्लिकेशन ऐसे कार्यों के लिए बड़े भाषा मॉडल का उपयोग करते हैं जिनमें वास्तव में टेक्स्ट जनरेशन की आवश्यकता नहीं होती।
किसी एजेंट को बस यह तय करना हो सकता है कि कौन सा टूल कॉल करना है, कोई दस्तावेज़ प्रासंगिक है या नहीं, किसी अनुरोध की तात्कालिकता क्या है, या किसी कार्रवाई को एस्केलेट किया जाना चाहिए या नहीं।
TypeSafe AI का Jev इन कार्यों को अलग तरह से संभालता है। उत्तर को टोकन-बाई-टोकन जनरेट करने के बजाय, यह एप्लिकेशन स्टेट और संरचित प्रश्न लेता है और चॉइसेज़, स्कोर, हां/ना निर्णय और प्रायिकताएँ जैसे टाइप्ड डिसीज़न लौटाता है। इसे हमारे Jev API ट्यूटोरियल में क्रिया में देखें
TypeSafe AI इसे System One Model दृष्टिकोण के रूप में वर्णित करता है: AI को सर्व-उद्देश्यीय टेक्स्ट जनरेटर के बजाय तेज़ निर्णय परत के रूप में उपयोग करना।
चुनौती यह है कि हमें अभी भी यह अपेक्षाकृत कम पता है कि Jev अंदरूनी तौर पर कैसे काम करता है।
TypeSafe AI ने अपनी समानांतर निर्णय-निर्माण पद्धति और प्रशिक्षण विधि के बारे में कुछ विवरण साझा किए हैं, लेकिन पूर्ण आर्किटेक्चर, मॉडल वज़न, प्रशिक्षण डेटा और संपूर्ण प्रशिक्षण रेसिपी सार्वजनिक नहीं हैं।
इससे स्वयं Jev का निरीक्षण, पुनरुत्पादन या अनुकूलन करना कठिन हो जाता है।
ओपन-सोर्स प्रोजेक्ट्स इसी विचार का अन्वेषण ऐसी आर्किटेक्चर के साथ कर रहे हैं जिन्हें हम वास्तव में जांच सकते हैं और स्थानीय रूप से चला सकते हैं।
कुछ छोटे बिडायरेक्शनल मॉडल का उपयोग करते हैं, कुछ Qwen को विशेष निर्णय हेड्स के साथ अनुकूलित करते हैं, जबकि अन्य मौजूदा भाषा मॉडलों से सीधे प्रायिकताएँ निकालते हैं।
क्योंकि नियंत्रण आपके पास होता है, आप अपने वर्कलोड के लिए तेज़ और सस्ती निर्णय परत बनाने हेतु मॉडल आकार, क्वांटाइज़ेशन, बैचिंग, कैशिंग, हार्डवेयर और सर्विंग का भी अनुकूलन कर सकते हैं।
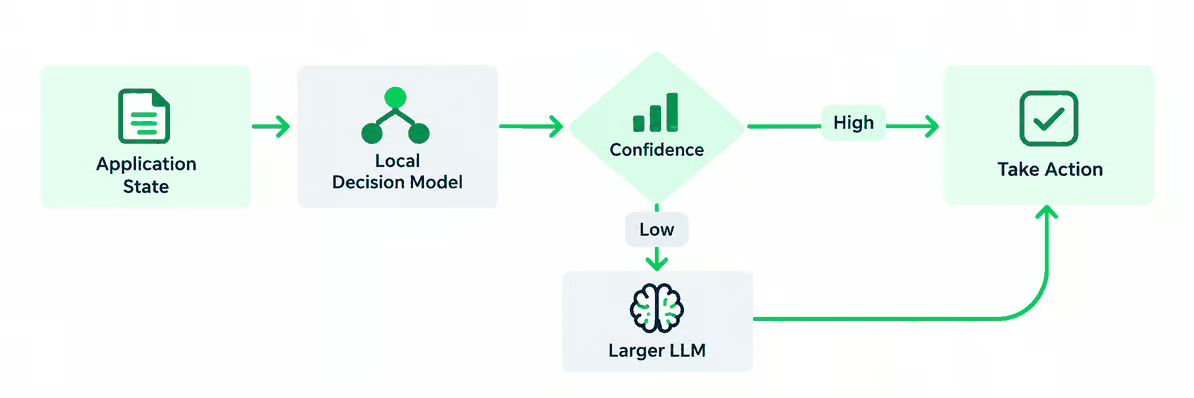
इस ब्लॉग में, मैं Jev के सात ओपन-सोर्स विकल्पों की तुलना करूंगा, जिनमें Laya, Nimble, Kev, SemIf, Rizzo Flow, Von और NanoJev शामिल हैं—यह देखते हुए कि प्रत्येक कैसे काम करता है, Jev के दृष्टिकोण का कितना करीब अनुसरण करता है, कहां अलग दिखता है, और इसे स्थानीय रूप से कैसे चलाया जाए।
अस्वीकरण: इस गाइड में शामिल प्रोजेक्ट्स बहुत नए हैं और तेज़ी से विकसित हो रहे हैं। कोड उदाहरण उनकी आधिकारिक डॉ큐मेंटेशन और रिपॉजिटरी पर आधारित हैं, लेकिन सभी उदाहरणों का स्वतंत्र रूप से एंड-टू-एंड परीक्षण नहीं किया गया है।
Laya एक उद्देश्य-निर्मित, नॉन-ऑटोरिग्रेसिव निर्णय मॉडल है जो ModernBERT-large पर आधारित है, और बहुभाषी वर्कलोड के लिए अलग mmBERT चेकपॉइंट के साथ आता है।
टेक्स्ट जनरेट करने के बजाय, यह स्टेट, प्रश्न और उपलब्ध विकल्पों को साथ में प्रोसेस करता है और एक ही फॉरवर्ड पास में संभावित उत्तरों को सीधे स्कोर करता है। यह Jev-शैली के choice, score और noul निर्णयों का समर्थन करता है, और अंग्रेज़ी, बहुभाषी तथा टाइप्ड-डिसीज़न वर्कलोड के लिए समर्पित चेकपॉइंट्स प्रदान करता है।
यह Laya को Jev के सबसे नज़दीकी आर्किटेक्चरल विकल्पों में से एक बनाता है क्योंकि दोनों को टेक्स्ट जनरेशन के बजाय प्रायिकतामूलक निर्णय के लिए विशेष रूप से डिज़ाइन किया गया है।
Laya अपनी अपेक्षाकृत छोटी 322M–421M मॉडलों, 100+ भाषाओं में बहुभाषी समर्थन, और एक मल्टी-बिलियन-पैरामीटर जेनेरेटिव मॉडल चलाए बिना कई प्रश्नों का कुशलतापूर्वक मूल्यांकन करने की क्षमता के लिए अलग दिखता है।
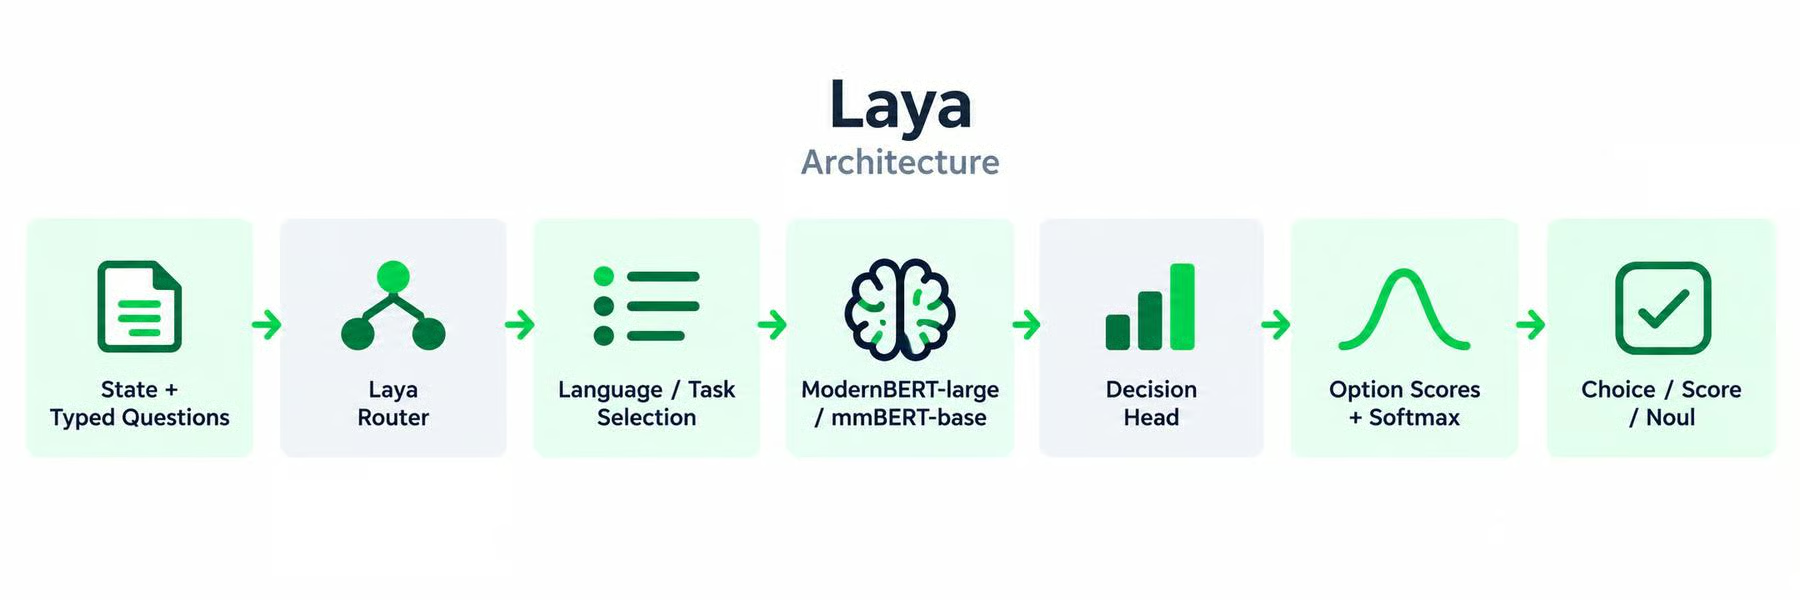
Laya ईमेल, सपोर्ट टिकट, दस्तावेज़ या JSON ऑब्जेक्ट जैसे किसी स्टेट को choice, score या noul जैसे टाइप्ड प्रश्नों के साथ लेता है।
इसका राउटर अनुरोध के लिए सबसे उपयुक्त चेकपॉइंट का चयन करता है, जैसे अंग्रेज़ी के लिए ModernBERT-large या बहुभाषी इनपुट के लिए mmBERT-base।
चयनित मॉडल एक ही फॉरवर्ड पास में स्टेट और प्रश्नों को प्रोसेस करता है, फिर एक निर्णय हेड उपलब्ध विकल्पों को स्कोर करता है और उन्हें प्रायिकताओं में बदलता है।
यह इनपुट से लेकर राउटिंग और एन्कोडिंग के माध्यम से अंतिम टाइप्ड निर्णय तक एक प्रत्यक्ष प्रवाह बनाता है।
 Laya के साथ शुरुआत
Laya एक Python पैकेज के रूप में उपलब्ध है:
pip install layaयह कमांड Laya लाइब्रेरी और उसकी निर्भरताएँ इंस्टॉल करता है, लेकिन पैकेज के अंदर मॉडल वज़न शामिल नहीं करता।
मॉडल Hugging Face पर होस्ट किए गए हैं।
जब आप preload=True के साथ राउटर बनाते हैं, तो Laya अपने उपलब्ध चेकपॉइंट्स को तुरंत डाउनलोड और लोड कर लेता है ताकि पहला अनुरोध आने से पहले वे तैयार हों।
डाउनलोड किए गए वज़न स्थानीय रूप से कैश हो जाते हैं, इसलिए हर बार एप्लिकेशन चलाने पर उन्हें फिर से डाउनलोड करने की आवश्यकता नहीं होती।
from laya import Router

router = Router(preload=True)

state = {
    "subject": "Duplicate charge",
    "body": "I was charged twice. Please refund this today."
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "Which department should handle this?",
        "criteria": {
            "billing": "Payments and refunds",
            "technical": "Errors and outages",
            "sales": "Pricing and purchases"
        }
    }
}

result = router.predict(state, questions)

print(result["answers"]["department"]["choice"])
यहां Router(preload=True) महत्वपूर्ण हिस्सा है।
पहली बार चलाने पर, Laya अपने Hugging Face रिपॉजिटरी से आवश्यक मॉडल फाइलें लाता है और उन्हें मेमोरी में लोड करता है। बाद के रन स्थानीय रूप से कैश की गई प्रतियों का पुन: उपयोग कर सकते हैं।
यदि आप इसके बजाय यह उपयोग करते हैं:
router = Router()Laya लेज़ी लोडिंग का उपयोग करता है। यह तब तक प्रतीक्षा करता है जब तक किसी विशेष चेकपॉइंट की आवश्यकता न हो, और पहली बार उपयोग पर उसे डाउनलोड/बिल्ड करता है।
Bespoke Nimble Qwen3.5-9B को बैकबोन के रूप में उपयोग करता है और टाइप्ड निर्णय-निर्माण के लिए विशेष रूप से rank-16 LoRA से फाइन-ट्यून करता है।
आप टेक्स्ट के साथ एक फ्लैट स्कीमा देते हैं जिसमें boolean या enum प्रश्न होते हैं, और Nimble अनुमत प्रत्येक विकल्प के लिए प्रायिकताओं के साथ चयनित उत्तर लौटाता है।
उत्तर को टोकन-बाई-टोकन डिकोड करने के बजाय, प्रशिक्षण और इन्फ्रेंस सीधे उम्मीदवार लॉजिट्स पर संचालित होते हैं।
Jev की तरह, Nimble भी स्टेट इन, टाइप्ड प्रायिकतामूलक निर्णय आउट के विचार पर आधारित है, लेकिन इसका इम्प्लिमेंटेशन दिखाता है कि इस व्यवहार को किसी मौजूदा ओपन LLM में कैसे जोड़ा जा सकता है, बजाय इसके कि किसी स्वामित्व वाले निर्णय आर्किटेक्चर की आवश्यकता हो।
इसकी मुख्य ताकत संपूर्ण प्रक्रिया के प्रति खुलापन है: Bespoke Labs ने मॉडल, प्रशिक्षण रेसिपी, मूल्यांकन सेटअप और डेटा-क्यूरेशन पाइपलाइन जारी की है, जिससे Nimble विशेष रूप से उन डेवलपर्स के लिए उपयोगी हो जाता है जो अपने स्वयं के Jev-शैली मॉडल ट्रेन या अध्ययन करना चाहते हैं।
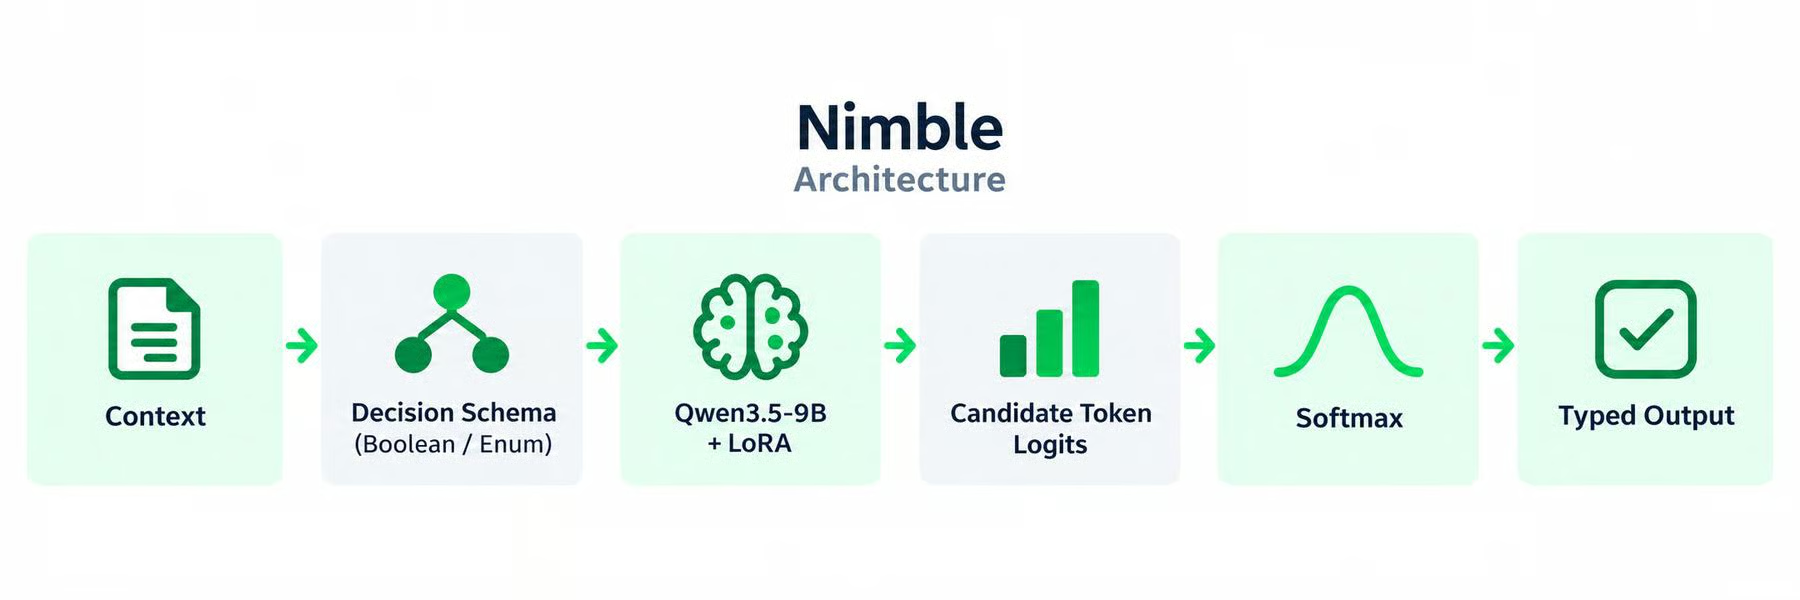
Nimble किसी संदर्भ और एक निर्णय स्कीमा से शुरू होता है जो अनुमत आउटपुट को परिभाषित करता है, जैसे कोई boolean या enum में से एक मान।
यह संदर्भ और स्कीमा को प्रोसेस करने के लिए Qwen3.5-9B को LoRA के साथ उपयोग करता है, फिर पूर्ण प्रतिक्रिया जनरेट करने के बजाय अनुमत उम्मीदवार टोकनों के लिए लॉजिट्स पढ़ता है।
उन लॉजिट्स को softmax से होकर प्रायिकताओं में बदला जाता है, जिन्हें संरचित टाइप्ड आउटपुट के रूप में लौटाया जाता है।
 Nimble के साथ शुरुआत
Nimble के लिए Python 3.12 आवश्यक है और यह Bespoke-Nimble-9B चेकपॉइंट का उपयोग करता है। रिपॉजिटरी क्लोन करके और निर्भरताएँ इंस्टॉल करके शुरू करें:
git clone https://github.com/bespokelabsai/nimble.git nimble
cd nimble

python3.12 -m venv .cache/venvs/nimble
source .cache/venvs/nimble/bin/activate

python -m pip install torch==2.8.0 -r requirements/training.txt
अगला, मॉडल डाउनलोड करें और तैयार करें। आधिकारिक तैयारी चरण Hugging Face से bespokelabs/Bespoke-Nimble-9B डाउनलोड करता है और, आवश्यक होने पर, इसके LoRA एडेप्टर को पिन किए गए Qwen3.5 बेस मॉडल के साथ मर्ज करता है। फिर यह .cache/nimble-model.json बनाता है।
import json
from pathlib import Path
from huggingface_hub import snapshot_download

repo = "bespokelabs/Bespoke-Nimble-9B"

snapshot = Path(
    snapshot_download(
        repo,
        cache_dir=".cache/huggingface/hub"
    )
)

config = {
    "model_path": str(snapshot.resolve()),
    "model_id": repo,
    "revision": snapshot.name,
    "max_input_tokens": 2048,
}

Path(".cache/nimble-model.json").write_text(
    json.dumps(config, indent=2)
)
यदि डाउनलोड किया गया रिलीज़ LoRA एडेप्टर है, तो इन्फ्रेंस से पहले एडेप्टर को उसके पिन किए गए बेस मॉडल के साथ मर्ज कराने के लिए Nimble का आधिकारिक क्विकस्टार्ट वाला पूर्ण तैयारी ब्लॉक उपयोग करें।
NVIDIA GPU पर, तैयार मॉडल लोड करें:
import json
from pathlib import Path
from nimble.scoring.cuda_scorer import CudaCandidateScorer

config = json.loads(
    Path(".cache/nimble-model.json").read_text()
)

scorer = CudaCandidateScorer(**config)
Then make a typed decision:
schema = {
    "priority": {
        "type": "enum",
        "choices": ["HIGH", "LOW"],
        "description": "Urgency based on current business impact."
    },
    "requires_review": {
        "type": "boolean",
        "description": "Whether a human should review this incident."
    }
}

result = scorer.score(
    "The payment service is down for all customers.",
    schema
)

print(result["output"])
print(result["fields"]["priority"]["scores"])
Nimble टेक्स्ट प्रतिक्रिया जनरेट करने के बजाय चयनित मानों के साथ प्रत्येक उम्मीदवार को सौंपे गए प्रायिकताओं को लौटाता है।
Kev Qwen3.5 पर आधारित Jev-प्रेरित निर्णय मॉडलों का एक परिवार है, जिसमें 0.8B, 4B और 9B वैरिएंट शामिल हैं।
यह एक rank-16 LoRA एडेप्टर और एक छोटा पॉइंटर हेड जोड़ता है जो प्रत्येक विकल्प के प्रतिनिधित्व की तुलना प्रश्न के डिसीज़न प्रतिनिधित्व से करता है।
कई प्रश्न एक ही स्टेट साझा कर सकते हैं, जबकि Kev प्रश्नों को अलग-थलग रखता है और टेक्स्ट जनरेट किए बिना उनकी प्रायिकता वितरण लौटाता है।
Kev विशेष रूप से Jev के करीब है क्योंकि इसकी आर्किटेक्चर स्पष्ट रूप से Jev के एक सार्वजनिक पुनर्निर्माण पर आधारित थी, और इसका सर्वर TypeSafe के /v1/systemone API कॉन्ट्रैक्ट को लागू करता है।
यह वही noul, choice और score प्रश्न शैलियों का समर्थन करता है, इसलिए मौजूदा TypeSafe SDK कोड को किसी स्थानीय Kev सर्वर पर रीडायरेक्ट किया जा सकता है।
इसका मुख्य लाभ है Jev-जैसा व्यवहार, ओपन वेट्स, कई मॉडल आकार और एक ओपन प्रशिक्षण पाइपलाइन का संयोजन।
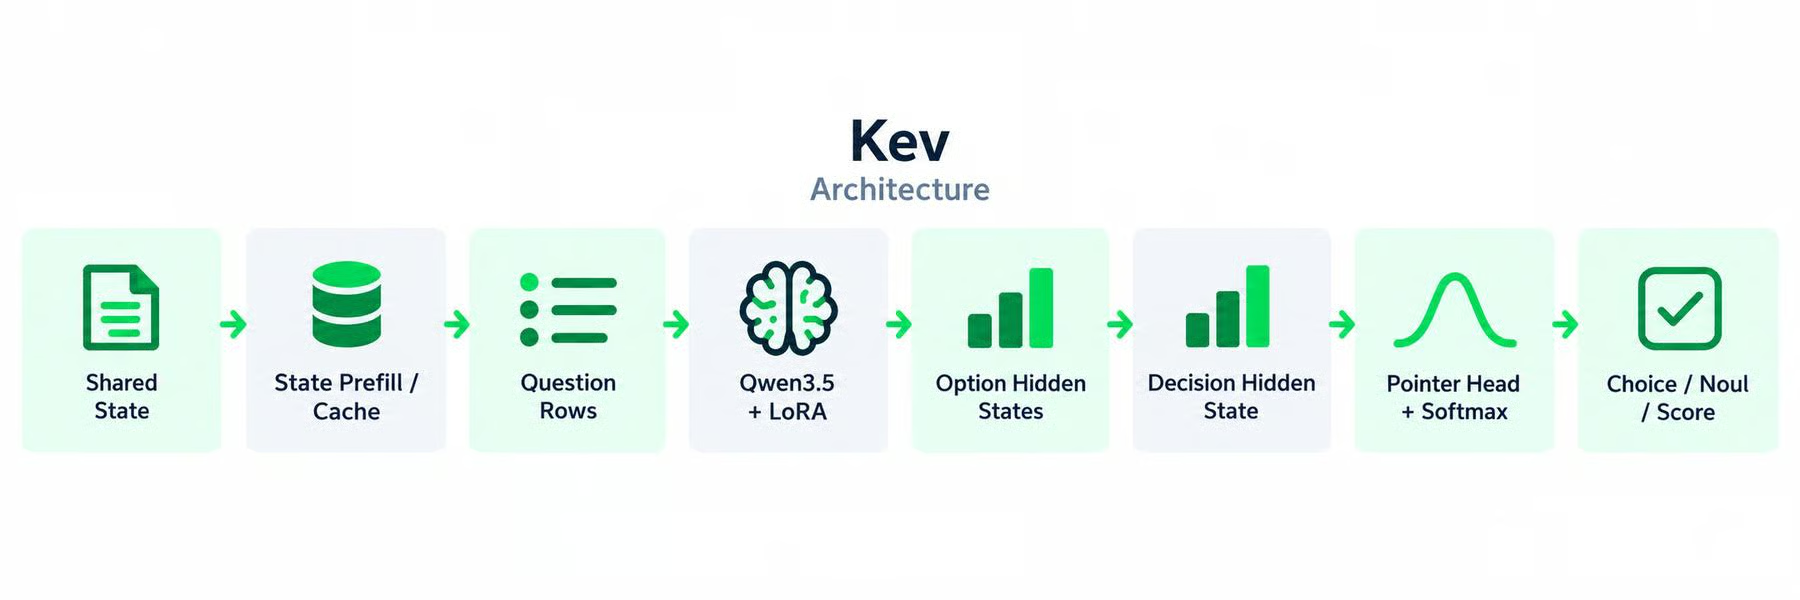
Kev LoRA एडेप्टर और एक छोटे पॉइंटर हेड के साथ Qwen बेस मॉडल का उपयोग करता है।
साझा स्टेट एक बार प्रोसेस होता है और कई प्रश्नों में पुन: उपयोग किया जाता है, इसलिए मॉडल को बार-बार उसी संदर्भ को प्रोसेस नहीं करना पड़ता।
प्रत्येक प्रश्न के लिए, Kev विकल्पों और डिसीज़न टोकन के लिए हिडन रिप्रेज़ेंटेशंस बनाता है, फिर पॉइंटर हेड उनकी तुलना करता है और विकल्प स्कोर उत्पन्न करता है।
Softmax उन स्कोरों को अंतिम choice, noul या score के लिए प्रायिकताओं में बदल देता है।
 Kev के साथ शुरुआत
Kev एक स्थानीय System One सर्वर के रूप में चलता है।
प्रोजेक्ट क्लोन करके और इसकी सर्विंग निर्भरताएँ इंस्टॉल करके शुरू करें:
git clone https://github.com/jaredpalmer/kev.git
cd kev

uv sync --extra serve
यह Kev को इंस्टॉल करता है, लेकिन जरूरी नहीं कि सभी मॉडल वज़न भी इंस्टॉल कर दे।
Kev-4B शुरू करें:
KEV_DTYPE=bf16 \
uv run --extra serve python -m kev.serve \
    --run jaredpalmer/kev-4b \
    --port 8009
पहले रन पर, Kev Hugging Face से Kev एडेप्टर/चेकपॉइंट और उसके Qwen बेस मॉडल—दोनों—को स्वचालित रूप से डाउनलोड करता है।
बाद की शुरुआतें कैश्ड मॉडल फाइलों का उपयोग करती हैं, उन्हें फिर से डाउनलोड नहीं करतीं।
एक बार सर्वर चलने पर, आप TypeSafe SDK का उपयोग इसके विरुद्ध कर सकते हैं:
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)

response = client.system_one(
    state="I was charged twice.",
    questions={
        "team": Choice(
            instructions="Which team owns this?",
            criteria={
                "billing": None,
                "technical": None,
            },
        )
    },
)

print(response.choices["team"].choice)
इस प्रकार Kev में सर्वर कमांड ही मॉडल-लोडिंग चरण का भी काम करता है: पहली लॉन्च पर आवश्यक वज़न स्वचालित रूप से डाउनलोड हो जाते हैं।
SemIf एक सरल दृष्टिकोण अपनाता है: यह कोई नया निर्णय मॉडल ट्रेन ही नहीं करता।
इसके बजाय, यह Qwen3.5-4B जैसे मौजूदा ओपन मॉडलों का उपयोग करता है और अनुमत उत्तरों को सौंपे गए लॉजिट्स को सीधे पढ़ता है।
स्टेट, मानदंड और टाइप्ड विकल्प मॉडल को पास किए जाते हैं, और SemIf मूल विकल्प लॉजिट्स को बिना सैंपलिंग या उत्तर जनरेट किए प्रायिकताओं में बदल देता है।
यह Jev के सबसे महत्वपूर्ण व्यावहारिक गुणों में से एक को पुनरुत्पादित करता है—ऑटोरिग्रेसिव आउटपुट के बिना निर्णय लेना—और साथ ही किसी विशेष चेकपॉइंट की आवश्यकता से बचता है।
SemIf अपनी लचीलापन के लिए अलग दिखता है: आप इसके नीचे अलग-अलग ओपन मॉडल उपयोग कर सकते हैं, कई प्रश्नों में एक लंबे स्टेट का पुन: उपयोग कर सकते हैं, और CUDA, Apple Silicon या क्वांटाइज़्ड ब्राउज़र मॉडलों पर सीधे स्कोरिंग के साथ प्रयोग कर सकते हैं।
यह विशेष रूप से उपयोगी है जब आप पहले कोई समर्पित मॉडल ट्रेन किए बिना System One विचार का परीक्षण करना चाहते हैं।
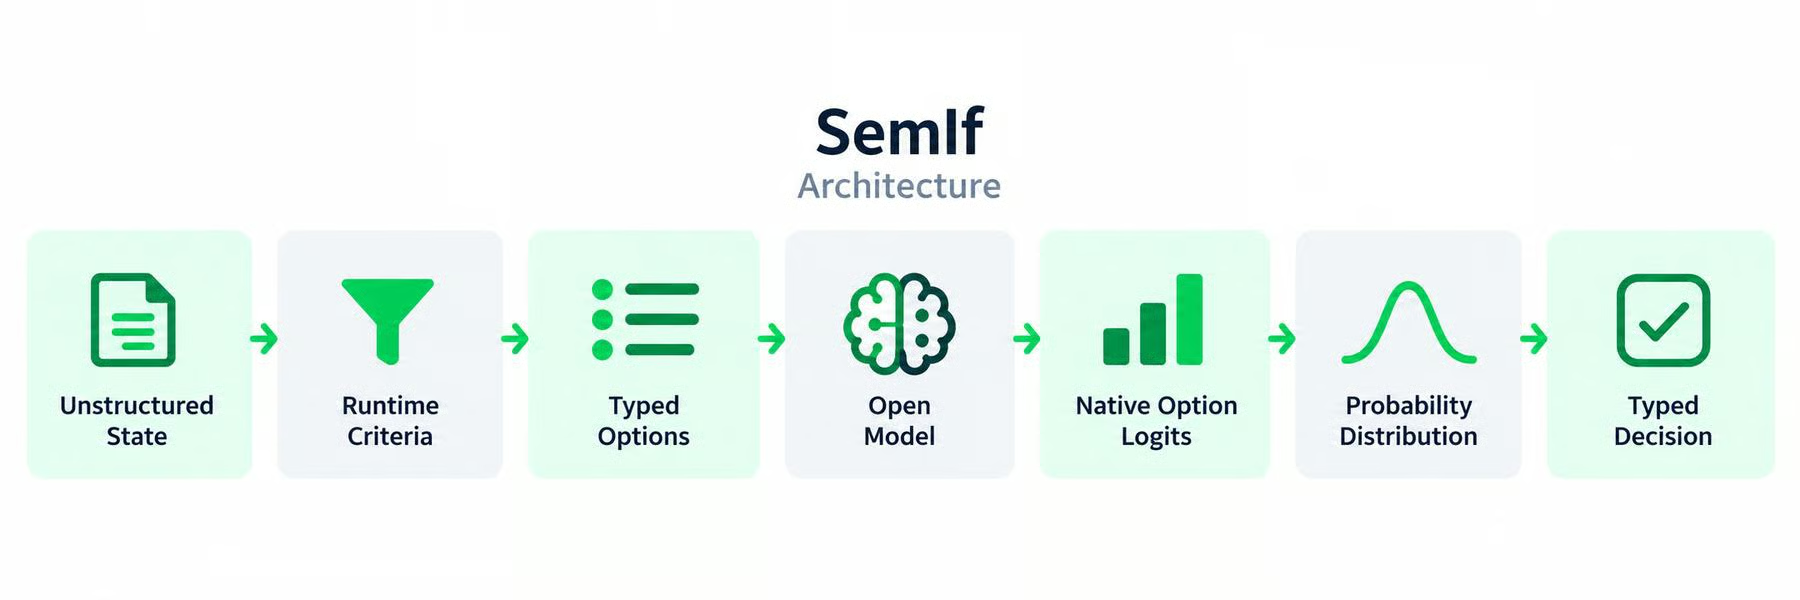
SemIf एक असंरचित स्टेट, रनटाइम मानदंड और अनुमत विकल्पों के सेट को लेता है और उन्हें किसी मौजूदा ओपन मॉडल से होकर पास करता है।
मॉडल से उत्तर जनरेट करने के लिए कहने के बजाय, यह उन पूर्वनिर्धारित विकल्पों को सौंपे गए लॉजिट्स को सीधे पढ़ता है।
इन लॉजिट्स को प्रायिकता वितरण में बदला जाता है, जिससे एप्लिकेशन बिना टेक्स्ट जनरेट किए या बाद में प्रतिक्रिया पार्स किए टाइप्ड निर्णय ले सकता है।
 SemIf के साथ शुरुआत
SemIf का अपना कोई समर्पित फाउंडेशन-मॉडल चेकपॉइंट नहीं है। इसके बजाय, यह किसी मौजूदा ओपन मॉडल पर निर्णय स्कोरिंग चलाता है।
इसे क्लोन करें और इंस्टॉल करें:
git clone https://github.com/TheoLeeCJ/SemIf.git
cd SemIf

python -m venv .venv
source .venv/bin/activate

pip install -e '.[test]'
यह SemIf को इंस्टॉल करता है, लेकिन अभी Qwen डाउनलोड नहीं करता।
स्कोरर चलाएँ:
CUDA_VISIBLE_DEVICES=0 semif-score \
    --mode direct \
    --model Qwen/Qwen3.5-4B \
    --revision 851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a \
    --input examples/decisions.jsonl \
    --output results.jsonl
पहले रन पर, चयनित Qwen मॉडल Hugging Face से डाउनलोड होकर Hugging Face कैश में संग्रहीत होता है। SemIf की डॉ큐मेंटेशन HF_HOME को किसी बड़े ड्राइव पर सेट करने की सिफारिश भी करती है क्योंकि मॉडल फाइलें काफी जगह ले सकती हैं।
उदाहरण के लिए:
export HF_HOME=/path/to/large-drive/huggingfaceमॉडल कैश हो जाने के बाद, बाद के रन स्थानीय कॉपी का पुन: उपयोग कर सकते हैं।
तो SemIf स्वयं अपेक्षाकृत छोटा है। डाउनलोड का अधिकांश आकार उस ओपन मॉडल से आता है जिसे आप इसके नीचे चलाने के लिए चुनते हैं।
Rizzo Flow ओपन Spark-X2.5 मॉडलों और llama.cpp-आधारित सर्विंग के इर्द-गिर्द निर्मित एक लोकल-फर्स्ट Jev-शैली इन्फ्रेंस प्रणाली है।
JSON उत्तर जनरेट करने के बजाय, यह प्रत्येक निर्णय को संभावित उत्तर टोकनों के एक बाधित सेट में बदल देता है, उन टोकनों को सौंपे गए लॉजिट्स पढ़ता है, और उन्हें प्रायिकताओं में बदलता है।
स्टेट को एक बार प्रोसेस किया जा सकता है और कई प्रश्नों में पुन: उपयोग किया जा सकता है, जिससे बार-बार की गणना घटती है।
Jev की तरह, Rizzo Flow असंरचित स्टेट स्वीकार करता है और हां/ना निर्णय, चॉइस, स्कोर और संख्यात्मक आउटपुट जैसे टाइप्ड डिसीज़न लौटाता है।
यह TypeSafe के HTTP इंटरफ़ेस को भी मिरर करता है, जिससे होस्टेड कॉल को किसी स्थानीय एंडपॉइंट से बदलना अपेक्षाकृत आसान हो जाता है।
Rizzo Flow विशेष रूप से स्थानीय डिप्लॉयमेंट और हार्डवेयर लचीलेपन के लिए अलग दिखता है—यह Jev की स्वामित्व वाली प्रशिक्षण आर्किटेक्चर को पुन: प्रस्तुत करने की कोशिश करने के बजाय ओपन मॉडल, क्वांटाइज़ेशन और एक परिचित API को संयोजित करता है।
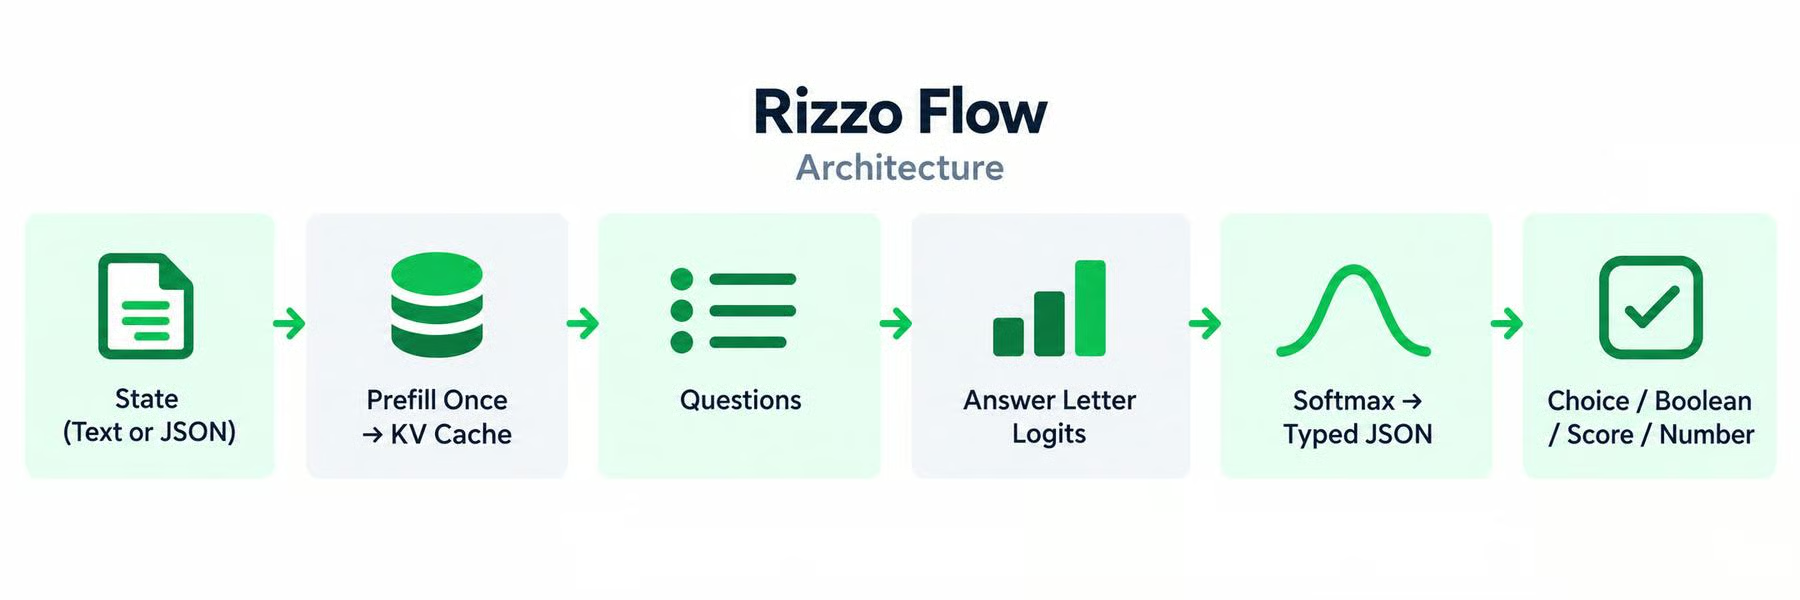
Rizzo Flow स्टेट को एक बार प्रोसेस करता है और परिणाम को मॉडल के KV कैश में संग्रहीत करता है।
कई प्रश्न तब उस कैश किए गए स्टेट का पुन: उपयोग कर सकते हैं, पूरे संदर्भ को फिर से प्रोसेस करने के बजाय। प्रत्येक प्रश्न को एक बहुविकल्पीय समस्या में बदला जाता है, जिसमें उम्मीदवार उत्तर अक्षरों जैसे A, B या C द्वारा दर्शाए जाते हैं।
Rizzo Flow केवल उन उत्तर अक्षरों के लॉजिट्स पढ़ता है, softmax लागू करता है, और परिणामी प्रायिकताओं को boolean, choice, score या number जैसे टाइप्ड आउटपुट में बदल देता है।
Rizzo Flow के लिए Python 3.11+, Git और uv आवश्यक है।
इंस्टॉलेशन के समय, अपनी मशीन के लिए कंप्यूट बैकएंड चुनें। उदाहरण के लिए, NVIDIA GPU वाले Linux पर:
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow

uv sync --locked --extra cuda
source .venv/bin/activate
Apple Silicon के लिए, --extra mlx का उपयोग करें; केवल CPU वाले सिस्टम --extra cpu उपयोग कर सकते हैं।
अगला, डिफ़ॉल्ट Spark-X2.5 मॉडल और उसका स्थानीय रनटाइम डाउनलोड करें:
rizzo downloadफिर सर्वर शुरू करें:
rizzo serveअब मॉडल स्थानीय रूप से http://127.0.0.1:8017 पर चलता है।
आप Jev-संगत एंडपॉइंट को किसी वास्तविक निर्णय के साथ परख सकते हैं:
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "My payouts have been failing for three days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and outages",
          "sales": null
        }
      }
    }
  }'
Rizzo Flow उत्तर और प्रायिकता वितरण सीधे लौटाता है, आउटपुट को टोकन-बाई-टोकन जनरेट किए बिना।
Von 395M-पैरामीटर वाले बिडायरेक्शनल ModernBERT आर्किटेक्चर पर आधारित एक उद्देश्य-निर्मित System One मॉडल है।
टेक्स्ट डिकोड करने के बजाय, यह स्टेट और उम्मीदवार मानदंडों का OptionMarker प्रतिनिधित्वों का उपयोग करके साथ में मूल्यांकन करता है, फिर Choice, Noul और Score निर्णयों के लिए सीधे लॉजिट्स उत्पन्न करता है।
यह पोस्ट-ट्रेनिंग कैलिब्रेशन भी लागू करता है ताकि परिणामी प्रायिकता वितरणों का एप्लिकेशन लॉजिक द्वारा सीधे उपयोग किया जा सके।
Von इंटरफ़ेस स्तर पर Jev से बहुत मिलता-जुलता है: यह नॉन-ऑटोरिग्रेसिव है, वही तीन मुख्य निर्णय प्रिमिटिव्स का समर्थन करता है, एक फॉरवर्ड पास में कई प्रश्नों का मूल्यांकन करता है, और /v1/systemone प्रोटोकॉल को लागू करता है।
इसकी मुख्य ताकत इसका छोटा फ़ुटप्रिंट और स्थानीय इन्फ्रेंस डिज़ाइन है: मॉडल में अरबों के बजाय सैकड़ों मिलियन पैरामीटर हैं और यह CUDA, ROCm, Apple Silicon और CPU निष्पादन का समर्थन करता है।
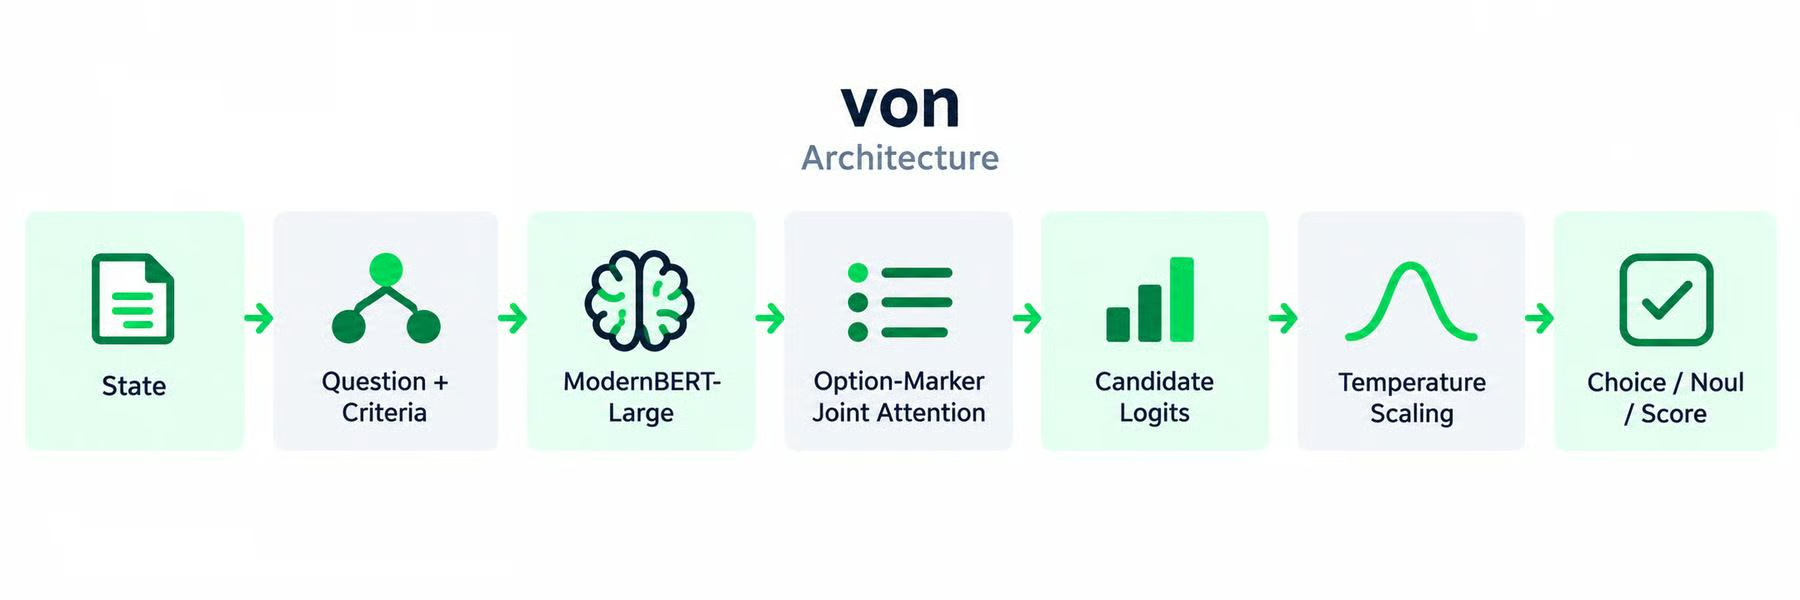
von स्टेट, प्रश्न और उम्मीदवार मानदंडों को साथ में प्रोसेस करने के लिए एक कॉम्पैक्ट बिडायरेक्शनल ModernBERT-आधारित मॉडल का उपयोग करता है।
इसका Option-Marker तंत्र संभावित उत्तरों के लिए प्रतिनिधित्व बनाता है, जिन्हें उम्मीदवार लॉजिट्स में बदला जाता है।
इसके बाद प्रायिकता वितरण में सुधार के लिए temperature scaling लागू किया जाता है, और फिर von अंतिम choice, noul या score लौटाता है।
उसी आर्किटेक्चर से एक ही फॉरवर्ड पास में कई प्रश्नों का मूल्यांकन भी किया जा सकता है।
Von के इंटरफ़ेस सबसे सरल में से एक है।
Python SDK इंस्टॉल करें:
pip install von-sdkयह Von सॉफ़्टवेयर इंस्टॉल करता है। वास्तविक मॉडल Hugging Face पर wfzyx/von-1.0 के रूप में अलग से प्रकाशित है।
जब मॉडल पहली बार लोड होता है, तो उसका ModernBERT चेकपॉइंट डाउनलोड होकर Hugging Face/Transformers मॉडल-लोडिंग सिस्टम के जरिए स्थानीय रूप से कैश हो जाता है।
कैश हो जाने के बाद, बाद का इन्फ्रेंस वज़न दोबारा डाउनलोड करने के बजाय स्थानीय कॉपी का उपयोग कर सकता है।
इसके बाद आप इस तरह निर्णय ले सकते हैं:
import von

result = von.decide(
    state="Database replication lag exceeded 45 seconds.",
    choices={
        "infrastructure": "Database or network failures",
        "billing": "Payments and invoices",
        "feature": "Requests for new functionality",
    },
    instructions="Classify the root cause.",
)

print(result.choice)
print(result.confidence)
For a binary decision:
p_blocking = von.judge(
    state="Requests are timing out.",
    instructions="Is this actively blocking customers?"
)

print(p_blocking)
इसलिए पहली कॉल अधिक समय ले सकती है क्योंकि मॉडल को डाउनलोड और इनिशियलाइज़ करना होता है। उसके बाद, वास्तविक इन्फ्रेंस स्थानीय रूप से होता है।
NanoJev Qwen3-0.6B पर आधारित 0.6B Jev प्रतिरूप है, जिसमें संरचित आउटपुट के लिए समर्पित डिसीज़न हेड्स हैं।
प्रत्येक अनुरोध में एक स्टेट, प्रश्न और उम्मीदवार सेट होता है, जिन्हें बैकबोन से पास किया जाता है, इसके बाद साझा हेड्स पूर्ण प्रायिकता वितरण उत्पन्न करते हैं।
Choice सेट अटेंशन और एक स्केलर हेड का उपयोग करता है, Boolean निर्णय sigmoid का उपयोग करते हैं, और Score क्रमबद्ध स्तरों का मूल्यांकन करता है और वितरण तथा अपेक्षित स्कोर—दोनों—उत्पन्न करता है।
NanoJev Jev के डिज़ाइन का विशेष रूप से करीब से अनुसरण करता है: यह पैरेलल निर्णय, डायनेमिक उम्मीदवार सेट, पूर्ण प्रायिकता वितरण, और शून्य आउटपुट डिकोडिंग का समर्थन करता है।
जहां यह अलग दिखता है, वह है इसका बहुत छोटा बैकबोन और स्पष्ट एंड-टू-एंड प्रशिक्षण पाइपलाइन।
यह कई स्टेट्स, प्रश्नों और उम्मीदवार पाथ्स को एक ही बैकबोन फॉरवर्ड पास में बैच कर सकता है, जिससे यह उन डेवलपर्स के लिए एक रोचक विकल्प बनता है जो बड़े सर्व-उद्देश्यीय LLM को अनुकूलित करने के बजाय किसी कॉम्पैक्ट, प्रशिक्षेय Jev-शैली आर्किटेक्चर के साथ प्रयोग करना चाहते हैं।
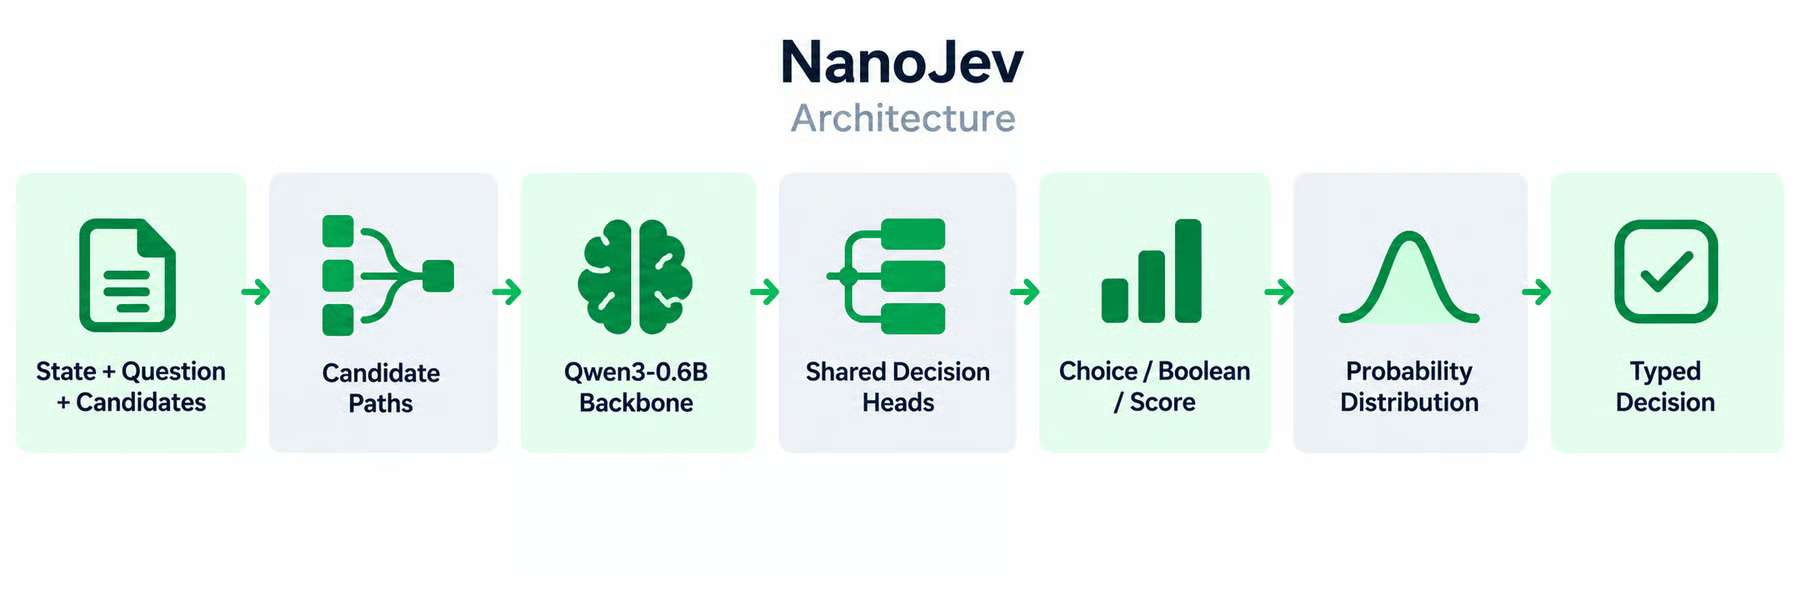
NanoJev एक स्टेट, एक प्रश्न, और वे उम्मीदवार उत्तर लेता है जिनमें से मॉडल को चुनने की अनुमति है।
प्रत्येक उम्मीदवार को संबंधित इनपुट के साथ जोड़ा जाता है और साझा Qwen3-0.6B बैकबोन से पास किया जाता है।
NanoJev तब समर्पित डिसीज़न हेड्स का उपयोग करके उम्मीदवारों को सीधे स्कोर करता है: Choice सेट अटेंशन और softmax का उपयोग करता है, Boolean sigmoid का उपयोग करता है, और Score क्रमबद्ध स्तरों पर प्रायिकता वितरण उत्पन्न करता है।
क्योंकि यह ये प्रायिकताएँ सीधे फॉरवर्ड पास से पढ़ता है, यह आउटपुट टोकन जनरेट किए बिना पूर्ण टाइप्ड वितरण लौटा सकता है।
NanoJev मॉडल डाउनलोड को रिपॉजिटरी इंस्टॉलेशन से अलग रखता है।
प्रोजेक्ट इंस्टॉल करके शुरू करें:
git clone https://github.com/TianyuCodings/NanoJev.git
cd NanoJev

python -m pip install \
    -r requirements-toy.txt \
    huggingface_hub
फिर पिन किया गया सार्वजनिक चेकपॉइंट डाउनलोड करें:
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="C-Tianyu/NanoJev",
    revision="unified-games-v1",
    local_dir="checkpoints/NanoJev-unified",
    allow_patterns=[
        "best.safetensors",
        "config.json",
        "tokenizer/*",
        "backbone_config/*",
    ],
)
लोकल इन्फ्रेंस सर्वर शुरू करें:
CUDA_VISIBLE_DEVICES=0 python scripts/serve_decisions.py \
    --checkpoint-dir checkpoints/NanoJev-unified \
    --web-root web \
    --host 127.0.0.1 \
    --port 8765 \
    --precision bf16
एक अनुरोध बनाएँ:
cat > data/request.json <<'JSON'
{
  "states": [{
    "id": "living_room",
    "state": "The living room is 29 degrees. The target is 24 degrees. The window is closed and someone is home.",
    "questions": {
      "action": {
        "type": "choice",
        "instructions": "Choose the action that most directly lowers the room temperature.",
        "criteria": {
          "cool": "Turn on air conditioning",
          "light": "Turn on the lights",
          "wait": "Keep the current settings"
        }
      },
      "occupied": {
        "type": "boolean",
        "instructions": "Someone is home."
      }
    }
  }]
}
JSON
फिर इसे NanoJev को भेजें:
curl http://127.0.0.1:8765/api/evaluate \
  -H 'Content-Type: application/json' \
  --data-binary @data/request.json
सर्वर चेकपॉइंट को लोड रखता है और प्रत्येक प्रश्न के लिए प्रायिकता वितरण लौटाता है। NanoJev एक ही अनुरोध में कई स्टेट्स और प्रश्नों को बैच भी कर सकता है।
मुख्य अंतर यह है कि हर प्रोजेक्ट निर्णय कैसे उत्पन्न करता है।
Laya और Von छोटे बिडायरेक्शनल एन्कोडर्स का उपयोग करते हैं जो विशेष रूप से विकल्प स्कोरिंग के लिए बनाए गए हैं।
Kev, Nimble और NanoJev विशेष प्रशिक्षण या निर्णय हेड्स के साथ Qwen मॉडलों को अनुकूलित करते हैं।
SemIf और Rizzo Flow मौजूदा जेनेरेटिव मॉडलों से सीधे प्रायिकताएँ निकालकर हल्का दृष्टिकोण अपनाते हैं।
|
प्रोजेक्ट |
आर्किटेक्चर |
आकार |
Jev-शैली निर्णय |
सबसे उपयुक्त |
|
Laya |
ModernBERT/mmBERT + निर्णय हेड |
322M–421M |
हाँ |
छोटे बहुभाषी निर्णय |
|
Nimble |
Qwen3.5 + LoRA उम्मीदवार स्कोरिंग |
9B |
समान |
ट्रेनिंग और शोध |
|
Kev |
Qwen + LoRA + पॉइंटर हेड |
0.8B–9B |
हाँ |
Jev-जैसा लोकल डिप्लॉयमेंट |
|
SemIf |
ओपन LLMs से डायरेक्ट लॉजिट्स |
मॉडल-निर्भर |
समान |
डायरेक्ट-लॉजिट प्रयोग |
|
Rizzo Flow |
Spark + डायरेक्ट विकल्प स्कोरिंग |
1.7B–4B |
हाँ |
आसान लोकल सर्विंग |
|
Von |
ModernBERT + OptionMarker |
~395M |
हाँ |
कॉम्पैक्ट निर्णय इन्फ्रेंस |
|
NanoJev |
Qwen3 + साझा निर्णय हेड्स |
0.6B |
हाँ |
छोटा प्रशिक्षेय Jev प्रतिरूप |
व्यवहार में, समर्पित एन्कोडर्स गति और दक्षता को प्राथमिकता देते हैं, अनुकूलित Qwen मॉडल अधिक सामान्य भाषा क्षमता बनाए रखते हैं, और डायरेक्ट-लॉजिट विधियाँ प्रयोग करना आसान होती हैं क्योंकि उन्हें कम विशिष्ट प्रशिक्षण की आवश्यकता होती है।
छोटे, विशिष्ट निर्णय मॉडलों के लिए Laya, Von और NanoJev सबसे रोचक विकल्पों में हैं, जो लगभग 322M से 600M पैरामीटर तक फैले हैं।
यदि आपको बहुभाषी निर्णय-निर्माण की आवश्यकता है, तो Laya 100+ भाषाओं को कवर करने वाले समर्पित mmBERT-आधारित चेकपॉइंट के साथ अलग दिखता है।
जो एप्लिकेशन TypeSafe System One API के इर्द-गिर्द बने हैं, उनके लिए Kev और Von विशेष रूप से नज़दीकी इंटीग्रेशन पाथ प्रदान करते हैं, जबकि Rizzo Flow स्थानीय सर्विंग के लिए वही HTTP इंटरफ़ेस मिरर करता है।
प्रशिक्षण और प्रयोग के लिए, Nimble अपनी डेटा-क्यूरेशन और LoRA फाइन-ट्यूनिंग रेसिपी प्रकाशित करता है, जबकि NanoJev डेटा जेनरेशन, प्रशिक्षण, मूल्यांकन और सर्विंग—सभी को कवर करने वाली पूर्ण पाइपलाइन प्रदान करता है।
यदि आप किसी विशेष निर्णय मॉडल को ट्रेन किए बिना प्रयोग करना चाहते हैं, तो SemIf एक उपयोगी बेसलाइन है: यह उत्तर जनरेट करने के बजाय Qwen जैसे मौजूदा ओपन मॉडलों से सीधे विकल्प प्रायिकताएँ पढ़ता है।
Jev का सटीक आर्किटेक्चर नया हो सकता है, लेकिन आधारभूत विचार नया नहीं है।
जीरो-शॉट NLI क्लासिफ़ायर्स वर्षों से मॉडल लॉजिट्स से मनमाने उम्मीदवार लेबल स्कोर करते आए हैं, Jev से बहुत पहले।
TypeSafe AI जो जोड़ता है, वह है उद्देश्य-निर्मित आर्किटेक्चर, समानांतर आउटपुट, कैलिब्रेटेड प्रायिकताएँ, और उस विचार को प्रोग्रामेबल निर्णय परत में बदलने के लिए एक साफ-सुथरा API।
ओपन-सोर्स इकोसिस्टम दिखाता है कि कुछ समान बनाने के लिए आपको किसी क्लोज़्ड सर्विस की आवश्यकता नहीं है।
Kev, Von और Rizzo Flow जैसे प्रोजेक्ट्स स्थानीय रूप से चल सकते हैं और Jev-शैली के इंटरफ़ेस उजागर कर सकते हैं, जबकि अन्य आपको वज़न डाउनलोड करने, उन्हें क्वांटाइज़ करने या llama.cpp जैसे रनटाइम का उपयोग करने देते हैं।
वास्तविक निष्कर्ष यह नहीं है कि Jev ने AI निर्णय-निर्माण का आविष्कार किया, बल्कि यह कि उसने एक महत्वपूर्ण विचार पर ध्यान वापस लाया है: यदि आपके एप्लिकेशन को केवल निर्णय चाहिए, तो आपको शायद टेक्स्ट जनरेशन की बिलकुल आवश्यकता नहीं है।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स
