
Corso
Programmazione orientata agli oggetti in Python
4 ore
105.8K
Pratica and corso your progress.
Continua Con GoogleChe tu stia cercando una nuova opportunità nello sviluppo software o nell’analisi dei dati, o che tu sia un hiring manager pronto a valutare un candidato per un’assenza nella tua azienda, conoscere le domande e risposte più comuni dei colloqui di programmazione è fondamentale.
Prepararsi a queste domande è spesso un processo difficile e dispendioso in termini di tempo, sia dal punto di vista del datore di lavoro sia da quello del candidato.
In questo articolo esamineremo 24 domande e risposte essenziali di programmazione per principianti, intermedi e avanzati. Queste Q&A ti aiuteranno a prepararti meglio al colloquio e a capire cosa aspettarti dall’intervistatore o dall’intervistato.
Iniziamo con alcune delle domande più semplici e comuni nei colloqui di programmazione.
Le variabili sono elementi fondamentali nella programmazione. Una variabile è essenzialmente un contenitore che memorizza dei dati, e il suo valore può essere modificato durante l’esecuzione di un programma. I linguaggi di programmazione moderni supportano vari tipi di variabili, ognuno pensato per specifici tipi di dati e casi d’uso.
Se vuoi sapere tutto sulle variabili, il nostro corso Introduzione a Python è un ottimo punto di partenza.
In programmazione, i tipi di dato sono le tipologie di valori che le variabili possono memorizzare. Ogni tipo di dato ha proprietà associate, essenziali per sapere quali operazioni matematiche, relazionali o logiche possono essere eseguite.
Per esempio, in Python esistono diversi tipi di dati numerici, tra cui gli interi, che memorizzano numeri interi, e i float, che memorizzano valori con la virgola. Ci sono anche le stringhe, che memorizzano sequenze ordinate di caratteri racchiuse tra apici singoli o doppi.
integer_var = 25
float_var = 10.2
String_var = "Welcome to DataCamp"
Leggi il nostro articolo dedicato per scoprire i tipi di dato più comuni in Python.
La differenza principale tra linguaggi compilati e interpretati riguarda il modo in cui le istruzioni, note anche come algoritmi, vengono tradotte in codice macchina (cioè codice binario). I linguaggi compilati sono tradotti prima dell’esecuzione, mentre quelli interpretati vengono tradotti a runtime.
Questo rende i linguaggi compilati più adatti a compiti complessi che richiedono velocità, come il tracciamento del traffico in tempo reale nelle auto a guida autonoma. Tuttavia, i linguaggi compilati, come C e C++, tendono a essere più difficili da comprendere e utilizzare rispetto ai linguaggi interpretati come Python.
Le istruzioni condizionali, comunemente note come istruzioni if-else, servono a eseguire determinati blocchi di codice in base a specifiche condizioni. Queste istruzioni aiutano a controllare il flusso di un algoritmo, facendolo comportare in modo diverso a seconda delle situazioni.
Al contrario, un ciclo in programmazione è una sequenza di codice che si ripete continuamente finché non si verifica una certa condizione, aiutando a ridurre ore di lavoro a pochi secondi. I cicli più comuni sono i for e i while. Puoi saperne di più nel nostro tutorial sui cicli.
Array e liste collegate sono tra le strutture dati più importanti. Sono strutture che memorizzano informazioni usando strategie diverse.
Un array memorizza gli elementi in locazioni di memoria contigue, cioè ogni elemento è conservato in una locazione adiacente all’altra. Inoltre, la dimensione di un array è immodificabile e viene dichiarata in anticipo.
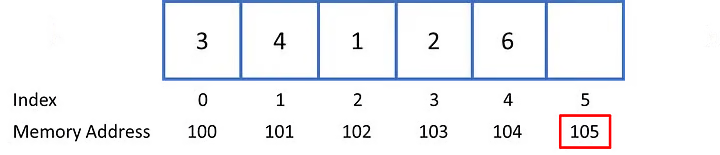
Array. Fonte
Al contrario, le liste collegate usano puntatori per memorizzare l’indirizzo di memoria dell’elemento successivo, come mostrato di seguito.
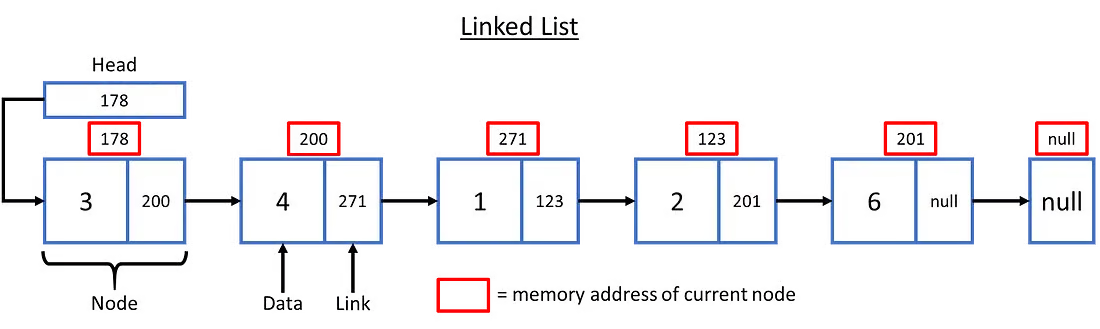
Lista collegata. Fonte
In generale, gli array sono preferiti quando serve un accesso rapido agli elementi e la memoria è un vincolo, mentre le liste collegate sono migliori quando ci sono inserimenti e cancellazioni frequenti.
In programmazione, si ha ricorsione quando una funzione chiama se stessa. Un ottimo esempio di ricorsione è una funzione progettata per calcolare il fattoriale di un numero. Ricorda che il fattoriale di un intero non negativo n è il prodotto di tutti gli interi positivi minori o uguali a n.
def factorial(n):
    if n < 2:
        return 1
    else:
        return n * factorial(n-1)

factorial(5)
>>> 120
Ti interessano le funzioni ricorsive? Leggi la nostra guida alle funzioni ricorsive in Python per iniziare.
Un puntatore è una variabile che memorizza come valore l’indirizzo di memoria di un’altra variabile. Usati comunemente in strutture dati come le liste collegate, i puntatori consentono l’accesso a basso livello alla memoria, l’allocazione dinamica e molte altre funzionalità.
La notazione Big-O è una notazione matematica usata per descrivere la complessità degli algoritmi. La notazione Big O misura la complessità nel caso peggiore di un algoritmo. Considera la complessità temporale, cioè il tempo impiegato da un algoritmo per completare l’esecuzione, e la complessità spaziale, cioè la memoria aggiuntiva richiesta da un algoritmo. Spieghiamo le basi della notazione Big O in questo tutorial.
In questa sezione ci concentriamo su domande comuni per candidati che si preparano a ruoli di livello intermedio con un po’ di esperienza.
La programmazione orientata agli oggetti è un paradigma che si concentra sugli oggetti. La OOP si basa sui seguenti quattro pilastri:
Esistono diverse risorse per imparare a usare la programmazione orientata agli oggetti, tra cui il corso OOP in Python di DataCamp, il corso OOP in R e il tutorial OOP in Java.
Nella programmazione orientata agli oggetti, dati e metodi sono organizzati in oggetti definiti dalla loro classe. Le classi sono progettate per stabilire come ogni oggetto dovrebbe comportarsi, e poi gli oggetti vengono creati all’interno di quella classe.
Nella OOP, il polimorfismo consente di usare lo stesso nome per metodi diversi che hanno comportamenti differenti a seconda dell’input. È spesso usato in combinazione con l’ereditarietà.
Per esempio, supponiamo di avere una classe genitore chiamata Shape che ha un metodo per calcolare l’area della forma. Potresti avere due classi figlie, Circle e Square. Sebbene ognuna avrà un metodo chiamato Area, la definizione di quel metodo sarà diversa per ogni forma. Confronta i metodi per l’area delle diverse forme nel blocco di codice seguente.
# Define the parent class Shape
class Shape:
	# Initialize the attributes for the shape
	def __init__(self, name):
    	    self.name = name

	# Define a generic method for calculating the area
	def area(self):
    	    print(f"The area of {self.name} is unknown.")

# Define the child class Circle that inherits from Shape
class Circle(Shape):
	# Initialize the attributes for the circle
	def __init__(self, name, radius):
    	# Call the parent class constructor
    	    super().__init__(name)
    	    self.radius = radius

	# Override the area method for the circle
	def area(self):
    	# Use the formula pi * r^2
    	    area = 3.14 * self.radius ** 2
    	    print(f"The area of {self.name} is {area}.")

# Define the child class Square that inherits from Shape
class Square(Shape):
	# Initialize the attributes for the square
	def __init__(self, name, side):
    	# Call the parent class constructor
    	    super().__init__(name)
    	    self.side = side

	# Override the area method for the square
	def area(self):
    	# Use the formula s^2
    	    area = self.side ** 2
print(f"The area of {self.name} is {area}.")Sia l’ereditarietà sia la composizione sono tecniche usate nella OOP per migliorare il riuso del codice. La prima è il meccanismo con cui una nuova classe deriva da una classe esistente, ereditandone tutte le proprietà e i metodi. La seconda consiste nel costruire oggetti complessi combinando parti semplici invece di ereditare da una classe base.
In generale, la composizione offre diversi vantaggi rispetto all’ereditarietà, tra cui maggiore flessibilità, minore complessità e migliore manutenibilità.
In informatica, la programmazione funzionale è un paradigma in cui i programmi sono costruiti applicando e componendo funzioni. È un sottoinsieme del paradigma di programmazione dichiarativa.
La programmazione funzionale si distingue per tracciabilità e prevedibilità. Questo perché le funzioni usate sono immutabili, cioè non possono essere modificate. Le funzioni sono definite, spesso in una sezione separata del codice (o talvolta in un file diverso), e poi usate nel codice quando necessario. Questa caratteristica rende semplice capire cosa succede in una sezione di codice, dato che la funzione si comporta sempre allo stesso modo e viene chiamata nello stesso modo ovunque.
Se hai ancora dubbi sulle differenze tra programmazione funzionale e OOP, consulta la nostra guida dedicata per chiarirti le idee.
In termini di paradigmi di programmazione, ci sono due ampie categorie in cui rientrano molti dei paradigmi più usati: imperativo e dichiarativo.
A un livello alto, la programmazione imperativa è una categoria di paradigmi in cui il programmatore specifica esattamente le istruzioni che il programma deve seguire passo dopo passo. L’attenzione è su come eseguire il programma. Questo stile può essere pensato come un diagramma di flusso, in cui il programma segue un percorso dato in base agli input specificati. La maggior parte dei linguaggi mainstream fa uso della programmazione imperativa.
La programmazione dichiarativa, al contrario, è una categoria di paradigmi in cui il programmatore definisce la logica del programma ma non fornisce i dettagli sui passi esatti che il programma dovrebbe seguire. L’attenzione è su cosa il programma deve eseguire piuttosto che su come esattamente farlo. Questo tipo di programmazione è meno comune ma può essere usato quando le regole sono specificate e il percorso preciso verso la soluzione non è noto. Un esempio può essere la risoluzione di un rompicapo numerico come il Sudoku.
C’è molto altro da dire sui paradigmi di programmazione. Per questo non possiamo perdere l’occasione di consigliarti il nostro corso Introduzione ai paradigmi di programmazione.
Le funzioni pure sono un componente fondamentale della programmazione funzionale. In breve, una funzione pura è un processo che prende valori in input e restituisce valori in output solo in base agli input. Le funzioni pure non hanno "effetti collaterali", cioè non influenzano altre variabili del programma, non scrivono su file e non modificano informazioni archiviate in un database.
La natura delle funzioni pure le rende perfette alleate per i programmatori. Innanzitutto, sono molto facili da fare debug, poiché qualsiasi funzione pura con lo stesso insieme di parametri restituirà sempre lo stesso valore.
Per lo stesso motivo, le funzioni pure sono più facili da parallelizzare, al contrario delle funzioni impure, che possono interferire a tal punto da produrre risultati diversi in esecuzioni differenti perché aggiornano o leggono variabili mutabili in un ordine diverso.
Nella programmazione funzionale, a differenza delle funzioni pure, una funzione di ordine superiore è una funzione che accetta una o più funzioni come argomenti (cioè un parametro procedurale, un parametro di una procedura che è essa stessa una procedura), restituisce una funzione, o entrambe le cose.
Un esempio comune di funzione di ordine superiore è map() in Python. Diffusa in molti linguaggi funzionali, map() prende come argomenti una funzione f e una collezione di elementi e restituisce una nuova collezione con la funzione applicata a ciascun elemento della collezione. Per esempio, supponiamo di avere un elenco di numeri e di volere una nuova collezione con i numeri convertiti in float.
numbers = [1,2,3,4]
res = map(float, numbers)
print(list(numbers))
>>> [1.0, 2.0, 3.0, 4.0]Infine, vediamo alcune delle domande più comuni per candidati esperti che puntano alle principali aziende tech.
La programmazione dinamica è un metodo usato per risolvere problemi complessi dividendoli in sotto-problemi più piccoli e sovrapposti.
Invece di ricominciare da zero ogni volta, si tiene traccia delle soluzioni a quelle parti più piccole, così da non dover ripetere gli stessi calcoli. Questo metodo è molto utile, per esempio, per trovare la più lunga sottosequenza comune tra due stringhe o per trovare il costo minimo per raggiungere un punto specifico su una griglia.
Memoization e tabulation sono due tecniche potenti nella programmazione dinamica per ottimizzare le prestazioni degli algoritmi, spesso quelli ricorsivi.
Memoization, nota anche come caching, consiste nel memorizzare il risultato di chiamate di funzione costose e restituire i risultati memorizzati quando si ripresentano gli stessi input. In questo modo, i sotto-problemi vengono calcolati una sola volta. La memoization segue un approccio top-down, cioè si parte dal "problema principale" e si scende ricorsivamente per risolvere e memorizzare molteplici sotto-problemi.
Al contrario, la tabulation consiste nel calcolare tutti i sotto-problemi più piccoli e memorizzare i risultati in una tabella. È considerata un approccio bottom-up perché inizia risolvendo i sotto-problemi più piccoli e, una volta ottenute tutte le soluzioni a questi, si calcola la soluzione del problema principale.
La sequenza di Fibonacci è la seguente: 0, 1, 1, 2, 3, 5, 8, 13, 21, 34 … in cui ogni numero è ottenuto sommando i due numeri precedenti.
Il modo più intuitivo per risolvere il problema è tramite ricorsione, come mostrato di seguito.
#  a simple recursive program for Fibonacci numbers
def fib(n):
    if n <= 1:
        return n

    return fib(n - 1) + fib(n - 2)
Tuttavia, questo non è il modo più efficiente per trovare la sequenza. L’algoritmo precedente ha una complessità temporale esponenziale, indicata come O(2^N), il che significa che il numero di calcoli cresce in modo esponenziale all’aumentare di N.
Un altro modo di affrontare il problema della sequenza di Fibonacci è suddividerlo in piccoli sotto-problemi, come segue:
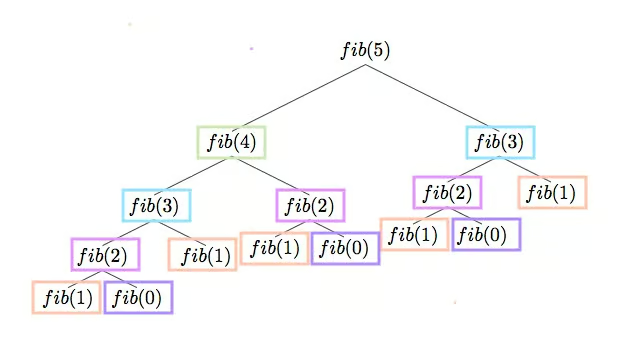
Sequenza di Fibonacci per fib(5). Fonte
Come puoi vedere, se eseguissimo il codice per n=5, la funzione fib() calcolerebbe la stessa operazione più volte, con conseguente spreco di risorse di calcolo.
La programmazione dinamica offre diverse tecniche per ottimizzare il calcolo della sequenza di Fibonacci.
Analizziamo il problema con la memoization. Come già detto, consiste nel memorizzare il risultato di chiamate di funzione costose e restituire i risultati memorizzati quando si ripresentano gli stessi input. Questo si ottiene con il seguente codice, che memorizza i risultati della funzione fibonacci_memo() in un dizionario. Con questa ottimizzazione, il calcolo di tutti gli input viene eseguito una sola volta, riducendo la complessità temporale a lineare, indicata come O(N).
cache = {0: 0, 1: 1}

def fibonacci_memo(n):
    if n in cache:  # Base case
        return cache[n]
   # Compute and cache the Fibonacci number
    cache[n] = fibonacci_memo(n - 1) + fibonacci_memo(n - 2)  # Recursive case
    return cache[n]

[fibonacci_memo(n) for n in range(15)]
[0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, 377]Nella programmazione dinamica, i sotto-problemi sono versioni più piccole del problema originale. Un problema ha sotto-problemi sovrapposti se la sua soluzione richiede di risolvere più volte lo stesso sotto-problema, come nel calcolo della sequenza di Fibonacci sopra.
D’altra parte, un problema si dice avere struttura ottima se la soluzione ottimale del problema può essere costruita a partire dalle soluzioni ottimali dei suoi sotto-problemi.
Le hashmap, note anche come hashtable, rappresentano una delle implementazioni più comuni dell’hashing. Le hashmap memorizzano coppie chiave-valore (ad es., ID dipendente e nome dipendente) in un elenco accessibile tramite il suo indice. Si può dire che una hashmap è una struttura dati che sfrutta tecniche di hashing per memorizzare dati in modo associativo.
L’idea alla base delle hashmap è distribuire le voci (coppie chiave/valore) su un array di bucket. Dato una chiave, una funzione di hashing calcolerà un indice distintivo che indica dove si può trovare la voce. L’uso di un indice invece della chiave originale rende le hashmap particolarmente adatte a molte operazioni sui dati, tra cui inserimento, rimozione e ricerca.
Un esempio illustrativo di hashtable sono i dizionari in Python. Dai un’occhiata alla nostra guida alle hashmap in Python per saperne di più su queste potenti strutture dati.
Il threading consente di eseguire in concorrenza parti diverse di un processo. Queste parti sono di solito indipendenti e hanno un’unità di esecuzione separata appartenente allo stesso processo. Il processo non è altro che un programma in esecuzione che ha unità individuali eseguibili in concorrenza.
Il deadlock si verifica quando più thread rimangono bloccati indefinitamente, in attesa di risorse detenute da altri thread. Questo scenario porta a un ciclo di dipendenze indissolubile in cui nessun thread coinvolto può progredire.
Leggi il tutorial sul threading in Python di DataCamp per saperne di più sui thread e sul perché sono importanti per l’analisi dei dati,
La breadth-first search (BFS) e la depth-first search (DFS) sono entrambe algoritmi di attraversamento progettati per esplorare un grafo o un albero.
BFS esplora un grafo livello per livello, visitando tutti i nodi alla profondità corrente prima di passare alla successiva. Al contrario, DFS dà priorità all’esplorazione di un ramo quanto più a fondo possibile prima di tornare indietro per investigare rami alternativi.
La BFS è particolarmente utile quando l’obiettivo è trovare il percorso più breve in un grafo non pesato. Tuttavia, la BFS può usare molta memoria, soprattutto in grafi molto ampi, perché deve tenere traccia di tutti i nodi a ogni livello. La BFS è un’ottima scelta per l’analisi delle reti sociali o problemi semplici di instradamento.
DFS, invece, è utile quando l’obiettivo è esplorare tutti i possibili percorsi o soluzioni, come nella risoluzione di puzzle o nell’individuazione di cicli in un grafo. A differenza della BFS, la DFS non garantisce il percorso più breve. Tuttavia, è più efficiente in termini di memoria, poiché tiene traccia solo del percorso corrente.
Puoi saperne di più su questi algoritmi nella nostra guida alla Breadth-First Search e nella guida alla Depth-First Search.
Merge sort funziona dividendo ricorsivamente l’array di input in sottoarray più piccoli e ordinando tali sottoarray, per poi fonderli di nuovo per ottenere l’output ordinato. Ha una complessità temporale linearitmica, indicata come O(N log(N)).
In notazione Big O, il tempo linearitmico si comporta in modo simile al tempo lineare, il che significa che se la quantità di dati in input raddoppia, anche il tempo necessario a merge sort per elaborare i dati raddoppierà.
L’algoritmo quick sort utilizza una tecnica di partizionamento scegliendo un valore dalla lista chiamato pivot. Tutti gli elementi più piccoli del pivot finiranno a sinistra del pivot, e quelli più grandi a destra. Quick sort verrà chiamato ricorsivamente sugli elementi a sinistra e a destra del pivot.
Quick sort ha una complessità temporale quadratica, indicata come O(N^2), nello scenario peggiore, che si verifica quando la scelta del pivot produce sistematicamente partizioni sbilanciate.
In questo articolo, abbiamo coperto molte domande di colloquio di programmazione che spaziano da argomenti base a intermedi e avanzati. Dalla comprensione dei concetti chiave delle strutture dati come array e liste collegate, fino ad arrivare a tecniche più complesse tratte da OOP, programmazione funzionale e programmazione dinamica, abbiamo esplorato le aree principali su cui i potenziali datori di lavoro potrebbero interrogarti.
Se ti serve ulteriore formazione in programmazione per il colloquio o sei interessato a domande di colloquio per altri ruoli nel campo dei dati e dell’AI, dai un’occhiata alle seguenti risorse:
I migliori corsi DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



