Guida alla notazione Big O e alla complessità temporale: intuizione e matematica
La complessità temporale misura come il tempo di esecuzione di un algoritmo cresce con la dimensione dell'input, spesso espressa tramite la notazione Big-O, che fornisce un limite superiore sul caso peggiore.
L'analisi della complessità temporale offre un modo per analizzare e prevedere l'efficienza degli algoritmi in modo indipendente sia dal linguaggio in cui li implementiamo, sia dall'hardware su cui vengono eseguiti.
L'obiettivo dell'analisi della complessità temporale non è prevedere il tempo di esecuzione esatto di un algoritmo, ma piuttosto poter rispondere a queste domande:
Dati due algoritmi che risolvono lo stesso problema, quale ci si aspetta che sia più veloce a parità di dati forniti?
Se raddoppiassimo i dati forniti all'algoritmo, come verrebbe influenzato il tempo di esecuzione? Scalerebbe linearmente raddoppiando anche lui? Rimarrà lo stesso? O qualcos'altro?
Alla fine di questo articolo, saprai analizzare la complessità temporale di un algoritmo e rispondere a queste domande.
La complessità temporale conta ancora nel 2024?
I computer sono sempre più veloci, quindi si potrebbe pensare che non valga più la pena preoccuparsi della complessità temporale. Di certo oggi un supercomputer può gestire qualsiasi problema a prescindere dall'algoritmo usato per risolverlo, giusto?
Non proprio. Il boom dell'IA è dovuto in gran parte agli enormi progressi nelle prestazioni hardware degli ultimi anni. Tuttavia, anche sull'hardware più avanzato, problemi semplici possono portare a prestazioni catastrofiche se si usa un algoritmo lento.
Per esempio, immagina di usare un algoritmo ingenuo per ordinare una tabella di database con dieci milioni di record. Anche su un computer moderno, questa semplice operazione richiederebbe diversi giorni per completarsi, rendendo il database inutilizzabile in pratica. Al contrario, con un algoritmo efficiente, ci si può aspettare che impieghi meno di un decimo di secondo.
Operazioni di base e istruzioni di base
Analizziamo un algoritmo usando il modello Random Access Machine (RAM o RA-machine). Questo modello assume che le seguenti operazioni richiedano esattamente un passo temporale:
Operazioni aritmetiche
Operazioni logiche (<, >, ==, ecc.)
Istruzioni come ifo return
Accesso a una locazione di memoria, come scrivere o leggere il valore di una variabile
Queste operazioni sono dette operazioni di base. Una riga di codice che esegue un numero costante di operazioni di base è detta istruzione di base.
Poiché il numero di operazioni in un'istruzione di base è costante, non dipende dalla quantità di dati. Dato che ci interessa come cresce il tempo di esecuzione al crescere dei dati, possiamo concentrarci sul conteggio del numero di istruzioni di base eseguite dall'algoritmo.
Le chiamate di funzione e i cicli come for e while si valutano sommando il numero di istruzioni di base al loro interno. Considera il seguente codice che somma gli elementi di una lista.
defsum_list(lst):
total =0# 1 instructionfor value in lst:
total += value # executed len(lst) timesreturn total # 1 instructionOfferto da
Abbiamo aggiunto commenti a ogni riga per aiutare a visualizzare il numero di istruzioni di base. Se N è la lunghezza di lst, allora il numero totale di istruzioni di base è 1 + N + 1 = N + 2.
Notazione Big-O
Immagina di avere due algoritmi di ordinamento. Abbiamo calcolato il numero di istruzioni di base per ciascuno e ottenuto le seguenti espressioni:
Primo algoritmo
Secondo algoritmo
4N2 + 2N + 7
3N2 + 5N + 13
A prima vista, non è ovvio quale dei due scali meglio. La notazione Big-O offre un modo per semplificare ulteriormente queste espressioni applicando queste semplificazioni:
Eliminare i termini con esponenti inferiori
Rimuovere le costanti moltiplicative
Se applichiamo questo processo a entrambe le espressioni, otteniamo N2 in entrambi i casi:
L'espressione che otteniamo dopo la semplificazione è la complessità temporale dell'algoritmo, che indichiamo con O(). In questo caso, possiamo scrivere che 4N2 + 2N + 7 = O(N2) e 3N2 + 5N + 13 = O(N2). Ciò significa che entrambi gli algoritmi hanno la stessa complessità temporale, proporzionale al quadrato del numero di elementi della lista.
Sopra, abbiamo calcolato che l'algoritmo sum_list esegue N + 2 operazioni, dove N è la lunghezza della lista. Applicando le stesse semplificazioni, otteniamo N, quindi la complessità temporale di sum_list è O(N).
Questo significa che il tempo di esecuzione è proporzionale alla dimensione della lista. È prevedibile, perché nel calcolare la somma, raddoppiare il numero di elementi di una lista dovrebbe richiedere il doppio del lavoro, né meno né di più.
Notazione Big-O: spiegazione intuitiva
Possiamo ignorare i termini inferiori perché, all'aumentare di N, il loro impatto sulla somma totale diventa trascurabile rispetto al termine più alto. Il grafico seguente mostra il contributo di ciascuno dei tre termini 4N2, 2N e 7 alla somma totale.
Il termine quadratico 4N2 molto rapidamente rappresenta quasi il 100% del numero totale di operazioni anche per valori piccoli di N. Pertanto, quando si affrontano grandi quantità di dati, il tempo corrispondente ai termini di ordine inferiore sarà trascurabile rispetto ai termini di ordine superiore.
Eliminiamo la costante moltiplicativa perché questo valore è indipendente dalla quantità di dati.
Notazione Big-O: definizione matematica
I passaggi sopra sono sufficienti per la maggior parte degli scopi pratici per derivare con precisione la complessità temporale di un algoritmo. Possiamo contare il numero di istruzioni di base eseguite da un algoritmo e ottenere un'espressione f(N). Dopo aver applicato i due passaggi di semplificazione, otteniamo un'espressione semplificata g(N). Quindi, possiamo scrivere che f(N) = O(g(N)). Si legge “f è big O di g”.
Tuttavia, questa non è una definizione matematica formale e in alcuni casi non è sufficiente.
La definizione matematica è che una funzione positiva f(N) = O(g(N)) se possiamo trovare una costante C tale che per valori grandi di N valga quanto segue:
f(N) ≤ C × g(N)
Possiamo usare la definizione per mostrare che f(N) = 4N2 + 2N + 7 = O(N2). In questo caso, possiamo scegliere C = 5 e vedere che per ogni N > 4, f(N) ≤ 5 × N2:
In pratica, useremo semplicemente le regole di semplificazione sopra.
Tipi di complessità temporale
Ora che abbiamo capito le basi della notazione Big-O, esploriamo le complessità temporali più comuni e le loro implicazioni, partendo dalla più efficiente: tempo costante.
Tempo costante: O(1)
Come suggerisce il nome, gli algoritmi a tempo costante hanno complessità temporale costante, cioè le loro prestazioni non dipendono dalla quantità di dati. In genere coinvolgono calcoli con un numero fisso di input, come il calcolo della distanza tra due punti.
La distanza tra due punti si calcola facendo la radice quadrata della somma dei quadrati delle differenze tra le coordinate x e y dei due punti.
La funzione dist mostrata sotto calcola la distanza tra due punti. Consiste di tre istruzioni di base, che è una costante. In questo caso, scriviamo che la complessità temporale è O(1).
defdist(p, q):
dx =(p[0]- q[0])**2# 1 instruction
dy =(p[1]- q[1])**2# 1 instructionreturn(dx + dy)**0.5# 1 instructionOfferto da
Curiosamente, è del tutto possibile che una funzione presenti complessità temporale costante anche quando elabora grandi dataset. Prendi, per esempio, il calcolo della lunghezza di una lista con la funzione len. Questa operazione è O(1) perché l'implementazione tiene internamente traccia della dimensione della lista, eliminando la necessità di contare gli elementi ogni volta che si richiede la lunghezza.
Tempo lineare: O(N)
Abbiamo già discusso sum_list come esempio di funzione a tempo lineare. In generale, gli algoritmi lineari eseguono compiti che richiedono di ispezionare ogni dato individualmente. Calcolare minimo, massimo o media è un'operazione tipica di questa categoria.
Facciamo pratica analizzando la seguente funzione per calcolare il valore minimo di una lista:
Se la lista ha N elementi, la complessità è 1 + (N - 1) + 1 = N + 1 = O(N).
Il tempo di esecuzione degli algoritmi lineari è direttamente proporzionale alla quantità di dati. Quindi, se i dati raddoppiano, il tempo necessario all'algoritmo per elaborarli dovrebbe raddoppiare anch'esso.
Tempo logaritmico: O(log(N))
Il gioco dell'indovinare il numero consiste nel cercare di indovinare un numero nascosto tra 1 e N, puntando a identificarlo con il minor numero di tentativi possibile. Dopo ogni tentativo, riceviamo un feedback che indica se il numero nascosto è più alto, più basso o uguale al nostro tentativo. Se indoviniamo, vinciamo; altrimenti, continuiamo a provare.
Una strategia efficace per questo gioco è puntare sempre sul punto medio. Supponiamo N = 15. In questo caso, il nostro primo tentativo sarebbe 8. Se il numero segreto è minore di 8, sappiamo che dev'essere tra 1 e 7. Se è maggiore, allora è tra 9 e 15. Continuiamo a indovinare il punto medio dell'intervallo rimanente finché non troviamo la risposta corretta. Il diagramma sotto illustra i possibili percorsi di questa strategia.
Esaminiamo la complessità temporale di questo approccio. A differenza degli esempi precedenti, il numero di passaggi dell'algoritmo non dipende solo dalla dimensione dell'input N, poiché è possibile indovinare correttamente al primo tentativo.
Quando analizziamo questi algoritmi, ci concentriamo sul caso peggiore. Per esempio, con N = 15, nel caso peggiore avremmo bisogno di 4 tentativi. Ogni tentativo, essendo il punto medio, elimina metà delle possibilità rimanenti. Nel caso peggiore, continuiamo finché rimane una sola possibilità. Quindi, la domanda a cui dobbiamo rispondere è:
Quante volte dobbiamo dividere N per 2 per ottenere 1?
La risposta è il logaritmo in base 2 di N, indicato come log2(N). L'algoritmo usato per individuare il numero corretto è noto come ricerca binaria. Dato che il numero massimo di tentativi è log2(N), possiamo esprimere la sua complessità come O(log2(N)) o semplicemente O(log(N)), poiché le costanti sono irrilevanti nella notazione della complessità temporale.
A causa della sua crescita estremamente lenta, la complessità logaritmica è molto ricercata in pratica, comportandosi quasi come il tempo costante. Anche per valori grandi di N, il numero totale di operazioni rimane sorprendentemente basso. Per esempio, anche se N è un miliardo, le operazioni richieste sono solo circa 30.
La ricerca binaria è un algoritmo fondamentale in informatica con numerose applicazioni. Per esempio, nell'elaborazione del linguaggio naturale, i correttori ortografici e i sistemi di autocorrezione possono usare varianti della ricerca binaria per identificare in modo efficiente le parole candidate.
Tempo quadratico: O(N2)
Ordinare i dati è un compito fondamentale che i computer devono svolgere spesso. Un metodo per ordinare una lista di N numeri consiste nell'identificare iterativamente l'elemento minimo della lista.
defselection_sort(lst):
sorted_lst =[]# 1 instructionfor _ inrange(len(lst)):
minimum =min(lst)# executed len(lst) times
lst.remove(minimum)# executed len(lst) times
sorted_lst.append(minimum)# executed len(lst) timesreturn sorted_lst # 1 instructionOfferto da
Per analizzare la complessità di un ciclo for, valutiamo la complessità delle istruzioni al suo interno e poi moltiplichiamo il risultato per il numero di iterazioni del ciclo.
Calcolare il minimo di una lista e rimuovere un elemento da una lista sono entrambe operazioni O(N). L'append avviene in tempo costante, O(1). Quindi, ogni iterazione del ciclo for ha complessità O(N + N + 1) = O(2N + 1), che si semplifica in O(N). Poiché le iterazioni sono N, la complessità è N × O(N) = O(N2). Il resto della funzione selection_sort() consiste in tre semplici istruzioni, quindi la complessità complessiva è O(N2 + 3) = O(N2).
La nostra analisi del ciclo for ha comportato una semplificazione eccessiva. A ogni iterazione, rimuoviamo un elemento dalla lista, il che significa che non tutte le iterazioni eseguono lo stesso numero di istruzioni. La prima iterazione esegue N istruzioni, la seconda N - 1, la terza N - 2, e così via fino all'ultima, che ne esegue solo 1.
Questo implica che la vera complessità del ciclo for è:
N + (N - 1) + (N - 2) + … + 1
Questa somma si può dimostrare uguale a (N2 + N) / 2. Tuttavia,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Anche se abbiamo sovrastimato, la complessità complessiva resta quadratica. La funzione selection_sort() esemplifica un algoritmo di ordinamento più lento a causa della sua complessità quadratica, O(N2).
Le funzioni con complessità quadratica scalano male: sono adatte a liste piccole ma impraticabili per ordinare milioni di punti dati, perché possono richiedere giorni per completarsi. Raddoppiare i dati porta a quadruplicare il tempo di esecuzione.
Tempo loglineare: O(Nlog(N))
È possibile ideare un algoritmo per ordinare una lista con complessità O(N log(N)). Uno di questi algoritmi è detto merge sort. Non entreremo nei dettagli dell'implementazione, ma se vuoi saperne di più, dai un'occhiata a questa breve introduzione a merge sort da questo corso su Strutture dati e algoritmi in Python.
Come detto, la complessità logaritmica in pratica si comporta in modo simile a quella costante. Pertanto, il tempo di esecuzione di un algoritmo O(N log(N)) può essere paragonabile a quello di un algoritmo lineare in applicazioni reali.
Il grafico seguente mostra che N log(N) e N crescono a tassi simili, mentre N2 cresce molto velocemente, diventando rapidamente molto lento.
Tempo cubico: O(N3)
Un algoritmo a tempo cubico ampiamente utilizzato nell'IA è la moltiplicazione di matrici, che svolge un ruolo cruciale nel funzionamento dei large language model come GPT. Questo algoritmo è fondamentale nei calcoli effettuati sia in fase di training che di inferenza.
Per moltiplicare due matrici N per N, A e B, dobbiamo moltiplicare ogni riga della prima matrice A per ogni colonna della seconda matrice B. In particolare, il valore del prodotto in posizione (i, j) è determinato moltiplicando gli elementi della riga i di A per gli elementi corrispondenti della colonna j di B.
Ecco un'implementazione in Python della moltiplicazione di matrici:
defmatrix_mul(A, B):
n =len(A)# 1 instruction
res =[[0for _ inrange(n)]for _ inrange(n)]# N^2 instructionsfor i inrange(n):for j inrange(n):for k inrange(n):
res[i][j]+= A[i][k]* B[k][j]# executed N×N×N = N^3 timesreturn res # 1 instructionOfferto da
In totale, matrix_mul() esegue N3 + N2 + 2 istruzioni, quindi la sua complessità temporale è O(N3).
In alternativa, avremmo potuto analizzare la complessità ragionando sui calcoli. Il risultato della moltiplicazione ha N2 voci. Ogni voce richiede O(N) tempo per essere calcolata, quindi la complessità complessiva è N2 × O(N) = O(N3).
Gli algoritmi a tempo cubico sono piuttosto lenti. Raddoppiare i dati comporta un fattore otto nel tempo di esecuzione, facendo scalare molto male questi algoritmi. Anche per un valore relativamente piccolo di N, il numero di istruzioni esplode molto rapidamente.
La moltiplicazione di matrici è un esempio di sfida computazionale in cui i progressi hardware hanno avuto un impatto significativo. Sebbene esistano algoritmi leggermente più efficienti per la moltiplicazione di matrici, sono soprattutto i progressi nella progettazione dei chip GPU — pensati specificamente per eseguire la moltiplicazione di matrici — ad aver reso notevolmente più agevole l'addestramento di modelli di grandi dimensioni come GPT in tempi ragionevoli.
Più recentemente, i ricercatori hanno proposto di eliminare la moltiplicazione di matrici dai grandi modelli di apprendimento — puoi saperne di più in questo articolo su LLM senza MatMul: concetti chiave spiegati.
Complessità temporale esponenziale: O(2N) e O(N!)
Gli algoritmi a tempo esponenziale tipicamente sorgono quando si risolve un problema esplorando tutte le soluzioni possibili. Considera la pianificazione di un percorso per un camion delle consegne che deve visitare N destinazioni. Un approccio consiste nel valutare ogni possibile ordine di consegna. Il pacchetto itertools di Python offre un metodo semplice per scorrere tutte le permutazioni di una lista.
import itertools
for order in itertools.permutations([1,2,3]):print(order)Offerto da
Il numero di permutazioni di una lista di lunghezza N è indicato con N!, letto "N fattoriale". La funzione fattoriale cresce in modo esponenziale. Per esempio, quando N = 13, il numero di permutazioni supera 1 miliardo.
Supponiamo che le destinazioni siano date come una lista di punti 2D. In tal caso, possiamo determinare la sequenza che minimizza la distanza totale iterando su tutte le sequenze possibili e tenendo traccia della migliore.
defoptimize_route(locations):
minimum_distance =float("inf")# 1 instruction
best_order =None# 1 instructionfor order in itertools.permutations(locations):# N! iterations
distance =0# 1 instruction, N! timesfor i inrange(1,len(order)):
distance += dist(order[i -1], order[i])# N-1 instructions, N! timesif distance < minimum_distance:
distance = minimum_distance # 1 instruction, N! times
best_order = order # 1 instruction, N! timesreturn best_order # 1 instructionOfferto da
Il primo ciclo for viene eseguito N! volte. Pertanto, il numero di operazioni in optimize_route() è N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.
Abbiamo imparato che nel calcolo della complessità temporale ignoriamo i termini con esponente più basso. Tuttavia, in questo scenario incontriamo un termine N!, che non è una potenza di N. Possiamo affinare la nostra strategia di semplificazione scegliendo di omettere i termini con tassi di crescita più lenti. La tabella seguente elenca i termini comunemente presenti nella complessità di un algoritmo, disposti dal tasso di crescita più basso al più alto.
1
log(N)
N
N2
N3
Nk
2N
N!
Così possiamo esprimere la complessità temporale di optimize_route() come N! x N + 2N! + 3 = O(N! x N).
Gli algoritmi a complessità esponenziale sono tipicamente efficienti solo per istanze molto piccole. Anche con sole 13 destinazioni, il numero di permutazioni supera 1 miliardo, rendendo questo algoritmo impraticabile in scenari reali.
Complessità temporale: caso peggiore e caso migliore
Con il gioco dell'indovinare il numero, ci siamo concentrati sulla complessità nel caso peggiore. Concentrandoci sul caso peggiore, garantiamo il tasso di crescita del tempo di esecuzione dell'algoritmo.
Nel caso migliore, indoviniamo al primo colpo, quindi un'analisi del caso migliore restituirebbe complessità O(1). È corretto — nel caso migliore, serve una sola operazione costante. Tuttavia, non è molto utile perché è molto improbabile.
In generale, quando analizziamo la complessità di un algoritmo, ci concentriamo sempre sul caso peggiore perché:
Garanzia di prestazioni: concentrandoci sulla complessità nel caso peggiore, possiamo assicurarci che il nostro algoritmo non si comporterà mai peggio di una certa soglia. Questo è cruciale per applicazioni che richiedono prestazioni affidabili, come i sistemi real-time, dove ritardi possono causare problemi significativi.
Sicurezza e affidabilità: l'analisi del caso peggiore aiuta a progettare algoritmi robusti che possano gestire gli scenari più gravosi. Garantisce che l'algoritmo funzioni comunque entro limiti accettabili anche nelle situazioni peggiori.
Limite superiore: conoscere la complessità nel caso peggiore ci dà un limite superiore sulle prestazioni. È utile per capire le risorse massime (tempo, memoria) che un algoritmo potrebbe richiedere.
Complessità temporale: implicazioni pratiche
La complessità temporale può sembrare un argomento molto teorico, ma può rivelarsi molto utile in pratica.
Per esempio, se una funzione gestisce costantemente un dataset piccolo, un algoritmo O(N2) facile da capire può essere più appropriato di un algoritmo O(N) complesso e difficile da mantenere. Tuttavia, dovrebbe essere una decisione ponderata per evitare di essere colti di sorpresa quando l'applicazione non riesce a gestire un aumento del traffico.
L'analisi della complessità temporale rivela che piccole ottimizzazioni del codice hanno un effetto trascurabile sul tempo di esecuzione di un algoritmo. Miglioramenti significativi si ottengono riducendo alla radice il numero di operazioni di base necessarie per calcolare il risultato. In generale, è preferibile mantenere un codice pulito e comprensibile piuttosto che ottimizzarlo fino a renderlo incomprensibile.
Le parti più lente del codice domineranno le altre. Di solito è inutile ottimizzare la parte più veloce prima di quella più lenta. Per esempio, immagina di avere una funzione che esegue due compiti:
defprocess_data(data):
clean_data(data)
analyze_data(data)Offerto da
Se la funzione clean_data() ha complessità O(N2) e analyze_data() ha complessità O(N3), allora ridurre la complessità di clean_data() non migliorerà la complessità complessiva di process_data(). È meglio concentrarsi sul migliorare la funzione analyze_data().
Inoltre, la complessità temporale può guidare decisioni hardware. Per esempio, un algoritmo O(N3), nonostante la scarsa scalabilità, può comunque essere abbastanza veloce per compiti con dati limitati se eseguito su hardware superiore o con un linguaggio di programmazione più veloce. Al contrario, se un algoritmo ha complessità esponenziale O(2N), nessun upgrade hardware basterà, indicando la necessità di un algoritmo più efficiente.
Conclusione
Nonostante i computer siano sempre più veloci, abbiamo a che fare con più dati che mai. Pensala così: ogni volta che usiamo Internet, smartphone o dispositivi smart home, creiamo enormi quantità di informazioni. Man mano che questa montagna di dati cresce, setacciarla e trovare ciò che conta diventa più difficile. Ecco perché è davvero importante continuare a migliorare i nostri strumenti — in particolare gli algoritmi — nel gestire e comprendere tutte queste informazioni.
L'analisi della complessità temporale offre un quadro semplice per ragionare sul tempo di esecuzione di un algoritmo. Il suo obiettivo principale è fornire indicazioni sul tasso di crescita della complessità temporale, più che prevedere tempi esatti. Nonostante le numerose semplificazioni e assunzioni del modello, si è dimostrata estremamente utile in pratica, cogliendo efficacemente l'essenza dei comportamenti del tempo di esecuzione degli algoritmi.
Come posso conoscere la complessità temporale delle funzioni built-in di Python? ⌄
A volte la documentazione menziona la complessità. Altrimenti, guardare il codice sorgente e analizzarlo è un buon esercizio. La maggior parte dei linguaggi segue implementazioni standard per strutture dati comuni come liste e dizionari, quindi cercare la complessità di queste strutture dati fornisce la risposta corretta. Ti consigliamo di seguire un corso generico su strutture dati e algoritmi per comprendere meglio la complessità delle operazioni comuni.
La complessità della forma O(N^k) è sempre migliore di O(2^N), indipendentemente dal valore di k?⌄
Da un punto di vista teorico, sì. Per N sufficientemente grande, l'algoritmo a tempo esponenziale alla fine diventerà più lento. Tuttavia, l'algoritmo esponenziale può comportarsi molto meglio per valori piccoli di N. In alcuni rari casi, ci interessano solo dataset piccoli, quindi l'algoritmo O(2N) può essere preferibile.
Esistono funzioni di complessità diverse da quelle viste qui?⌄
Sì. Esistono algoritmi con funzioni di complessità molto strane, ma per quasi tutti gli algoritmi la complessità coinvolgerà solo le funzioni che menzioniamo in questo articolo.
Come posso sapere se è possibile trovare un algoritmo migliore?⌄
In generale, è una domanda difficile. Dimostrare che non esiste un algoritmo con complessità migliore implica ragionare sul problema e mostrare che risolverlo con meno operazioni è impossibile. In alcuni casi è facile. Per esempio, per scoprire se una lista contiene un dato valore, è impossibile avere un algoritmo con complessità inferiore a O(N) perché, nel caso peggiore, dobbiamo guardare tutti gli elementi per trovare la risposta.
Come possiamo analizzare la complessità temporale se l'algoritmo coinvolge la casualità?⌄
Anche con la presenza di casualità, spesso è possibile ragionare sul caso peggiore degli esiti casuali e derivarne la complessità. In alternativa, per alcuni algoritmi randomizzati analizziamo la complessità media studiando il numero atteso di operazioni.
Ingegnere full‑stack e fondatore di CheapGPT. Insegnare è sempre stata la mia passione. Fin dai primi anni da studente, cercavo con entusiasmo occasioni per fare da tutor e aiutare altri studenti. Questa passione mi ha portato a intraprendere un dottorato, durante il quale ho anche svolto il ruolo di assistente alla didattica a supporto del mio percorso accademico. In quegli anni ho trovato enorme soddisfazione nell'ambiente tradizionale dell'aula, creando connessioni e facilitando l'apprendimento. Con l'avvento delle piattaforme di apprendimento online, però, ho riconosciuto il potenziale trasformativo dell'educazione digitale. Di fatto, ho partecipato attivamente allo sviluppo di una di queste piattaforme nella nostra università. Sono profondamente impegnato a integrare i principi dell'insegnamento tradizionale con metodologie digitali innovative. La mia passione è creare corsi non solo coinvolgenti e informativi, ma anche accessibili a chi apprende in questa era digitale.
Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.






L'analisi della complessità temporale offre un modo per analizzare e prevedere l'efficienza degli algoritmi in modo indipendente sia dal linguaggio in cui li implementiamo, sia dall'hardware su cui vengono eseguiti.
L'obiettivo dell'analisi della complessità temporale non è prevedere il tempo di esecuzione esatto di un algoritmo, ma piuttosto poter rispondere a queste domande:
Alla fine di questo articolo, saprai analizzare la complessità temporale di un algoritmo e rispondere a queste domande.
La complessità temporale conta ancora nel 2024?
I computer sono sempre più veloci, quindi si potrebbe pensare che non valga più la pena preoccuparsi della complessità temporale. Di certo oggi un supercomputer può gestire qualsiasi problema a prescindere dall'algoritmo usato per risolverlo, giusto?
Non proprio. Il boom dell'IA è dovuto in gran parte agli enormi progressi nelle prestazioni hardware degli ultimi anni. Tuttavia, anche sull'hardware più avanzato, problemi semplici possono portare a prestazioni catastrofiche se si usa un algoritmo lento.
Per esempio, immagina di usare un algoritmo ingenuo per ordinare una tabella di database con dieci milioni di record. Anche su un computer moderno, questa semplice operazione richiederebbe diversi giorni per completarsi, rendendo il database inutilizzabile in pratica. Al contrario, con un algoritmo efficiente, ci si può aspettare che impieghi meno di un decimo di secondo.
Operazioni di base e istruzioni di base
Analizziamo un algoritmo usando il modello Random Access Machine (RAM o RA-machine). Questo modello assume che le seguenti operazioni richiedano esattamente un passo temporale:
iforeturnQueste operazioni sono dette operazioni di base. Una riga di codice che esegue un numero costante di operazioni di base è detta istruzione di base.
Poiché il numero di operazioni in un'istruzione di base è costante, non dipende dalla quantità di dati. Dato che ci interessa come cresce il tempo di esecuzione al crescere dei dati, possiamo concentrarci sul conteggio del numero di istruzioni di base eseguite dall'algoritmo.
Le chiamate di funzione e i cicli come
forewhilesi valutano sommando il numero di istruzioni di base al loro interno. Considera il seguente codice che somma gli elementi di una lista.Abbiamo aggiunto commenti a ogni riga per aiutare a visualizzare il numero di istruzioni di base. Se N è la lunghezza di
lst, allora il numero totale di istruzioni di base è 1 + N + 1 = N + 2.Notazione Big-O
Immagina di avere due algoritmi di ordinamento. Abbiamo calcolato il numero di istruzioni di base per ciascuno e ottenuto le seguenti espressioni:
Primo algoritmo
Secondo algoritmo
4N2 + 2N + 7
3N2 + 5N + 13
A prima vista, non è ovvio quale dei due scali meglio. La notazione Big-O offre un modo per semplificare ulteriormente queste espressioni applicando queste semplificazioni:
Se applichiamo questo processo a entrambe le espressioni, otteniamo N2 in entrambi i casi:
L'espressione che otteniamo dopo la semplificazione è la complessità temporale dell'algoritmo, che indichiamo con O(). In questo caso, possiamo scrivere che 4N2 + 2N + 7 = O(N2) e 3N2 + 5N + 13 = O(N2). Ciò significa che entrambi gli algoritmi hanno la stessa complessità temporale, proporzionale al quadrato del numero di elementi della lista.
Sopra, abbiamo calcolato che l'algoritmo
sum_listesegue N + 2 operazioni, dove N è la lunghezza della lista. Applicando le stesse semplificazioni, otteniamo N, quindi la complessità temporale disum_listè O(N).Questo significa che il tempo di esecuzione è proporzionale alla dimensione della lista. È prevedibile, perché nel calcolare la somma, raddoppiare il numero di elementi di una lista dovrebbe richiedere il doppio del lavoro, né meno né di più.
Notazione Big-O: spiegazione intuitiva
Possiamo ignorare i termini inferiori perché, all'aumentare di N, il loro impatto sulla somma totale diventa trascurabile rispetto al termine più alto. Il grafico seguente mostra il contributo di ciascuno dei tre termini 4N2, 2N e 7 alla somma totale.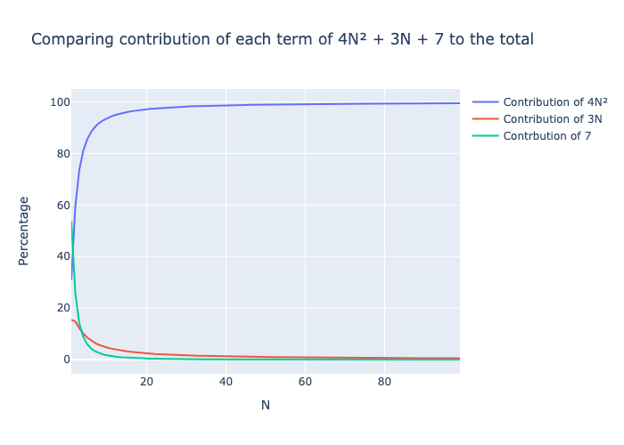
Il termine quadratico 4N2 molto rapidamente rappresenta quasi il 100% del numero totale di operazioni anche per valori piccoli di N. Pertanto, quando si affrontano grandi quantità di dati, il tempo corrispondente ai termini di ordine inferiore sarà trascurabile rispetto ai termini di ordine superiore.
Eliminiamo la costante moltiplicativa perché questo valore è indipendente dalla quantità di dati.
Notazione Big-O: definizione matematica
I passaggi sopra sono sufficienti per la maggior parte degli scopi pratici per derivare con precisione la complessità temporale di un algoritmo. Possiamo contare il numero di istruzioni di base eseguite da un algoritmo e ottenere un'espressione f(N). Dopo aver applicato i due passaggi di semplificazione, otteniamo un'espressione semplificata g(N). Quindi, possiamo scrivere che f(N) = O(g(N)). Si legge “f è big O di g”.
Tuttavia, questa non è una definizione matematica formale e in alcuni casi non è sufficiente.
La definizione matematica è che una funzione positiva f(N) = O(g(N)) se possiamo trovare una costante C tale che per valori grandi di N valga quanto segue:
f(N) ≤ C × g(N)
Possiamo usare la definizione per mostrare che f(N) = 4N2 + 2N + 7 = O(N2). In questo caso, possiamo scegliere C = 5 e vedere che per ogni N > 4, f(N) ≤ 5 × N2:
In pratica, useremo semplicemente le regole di semplificazione sopra.
Tipi di complessità temporale
Ora che abbiamo capito le basi della notazione Big-O, esploriamo le complessità temporali più comuni e le loro implicazioni, partendo dalla più efficiente: tempo costante.
Tempo costante: O(1)
Come suggerisce il nome, gli algoritmi a tempo costante hanno complessità temporale costante, cioè le loro prestazioni non dipendono dalla quantità di dati. In genere coinvolgono calcoli con un numero fisso di input, come il calcolo della distanza tra due punti.
La distanza tra due punti si calcola facendo la radice quadrata della somma dei quadrati delle differenze tra le coordinate x e y dei due punti.
La funzione
distmostrata sotto calcola la distanza tra due punti. Consiste di tre istruzioni di base, che è una costante. In questo caso, scriviamo che la complessità temporale è O(1).Curiosamente, è del tutto possibile che una funzione presenti complessità temporale costante anche quando elabora grandi dataset. Prendi, per esempio, il calcolo della lunghezza di una lista con la funzione len. Questa operazione è O(1) perché l'implementazione tiene internamente traccia della dimensione della lista, eliminando la necessità di contare gli elementi ogni volta che si richiede la lunghezza.
Tempo lineare: O(N)
Abbiamo già discusso
sum_listcome esempio di funzione a tempo lineare. In generale, gli algoritmi lineari eseguono compiti che richiedono di ispezionare ogni dato individualmente. Calcolare minimo, massimo o media è un'operazione tipica di questa categoria.Facciamo pratica analizzando la seguente funzione per calcolare il valore minimo di una lista:
Se la lista ha N elementi, la complessità è 1 + (N - 1) + 1 = N + 1 = O(N).
Il tempo di esecuzione degli algoritmi lineari è direttamente proporzionale alla quantità di dati. Quindi, se i dati raddoppiano, il tempo necessario all'algoritmo per elaborarli dovrebbe raddoppiare anch'esso.
Tempo logaritmico: O(log(N))
Il gioco dell'indovinare il numero consiste nel cercare di indovinare un numero nascosto tra 1 e N, puntando a identificarlo con il minor numero di tentativi possibile. Dopo ogni tentativo, riceviamo un feedback che indica se il numero nascosto è più alto, più basso o uguale al nostro tentativo. Se indoviniamo, vinciamo; altrimenti, continuiamo a provare.
Una strategia efficace per questo gioco è puntare sempre sul punto medio. Supponiamo N = 15. In questo caso, il nostro primo tentativo sarebbe 8. Se il numero segreto è minore di 8, sappiamo che dev'essere tra 1 e 7. Se è maggiore, allora è tra 9 e 15. Continuiamo a indovinare il punto medio dell'intervallo rimanente finché non troviamo la risposta corretta. Il diagramma sotto illustra i possibili percorsi di questa strategia.
Esaminiamo la complessità temporale di questo approccio. A differenza degli esempi precedenti, il numero di passaggi dell'algoritmo non dipende solo dalla dimensione dell'input N, poiché è possibile indovinare correttamente al primo tentativo.
Quando analizziamo questi algoritmi, ci concentriamo sul caso peggiore. Per esempio, con N = 15, nel caso peggiore avremmo bisogno di 4 tentativi. Ogni tentativo, essendo il punto medio, elimina metà delle possibilità rimanenti. Nel caso peggiore, continuiamo finché rimane una sola possibilità. Quindi, la domanda a cui dobbiamo rispondere è:
Quante volte dobbiamo dividere N per 2 per ottenere 1?
La risposta è il logaritmo in base 2 di N, indicato come log2(N). L'algoritmo usato per individuare il numero corretto è noto come ricerca binaria. Dato che il numero massimo di tentativi è log2(N), possiamo esprimere la sua complessità come O(log2(N)) o semplicemente O(log(N)), poiché le costanti sono irrilevanti nella notazione della complessità temporale.
A causa della sua crescita estremamente lenta, la complessità logaritmica è molto ricercata in pratica, comportandosi quasi come il tempo costante. Anche per valori grandi di N, il numero totale di operazioni rimane sorprendentemente basso. Per esempio, anche se N è un miliardo, le operazioni richieste sono solo circa 30.
La ricerca binaria è un algoritmo fondamentale in informatica con numerose applicazioni. Per esempio, nell'elaborazione del linguaggio naturale, i correttori ortografici e i sistemi di autocorrezione possono usare varianti della ricerca binaria per identificare in modo efficiente le parole candidate.
Tempo quadratico: O(N2)
Ordinare i dati è un compito fondamentale che i computer devono svolgere spesso. Un metodo per ordinare una lista di N numeri consiste nell'identificare iterativamente l'elemento minimo della lista.
Per analizzare la complessità di un ciclo
for, valutiamo la complessità delle istruzioni al suo interno e poi moltiplichiamo il risultato per il numero di iterazioni del ciclo.Calcolare il minimo di una lista e rimuovere un elemento da una lista sono entrambe operazioni O(N). L'append avviene in tempo costante, O(1). Quindi, ogni iterazione del ciclo for ha complessità O(N + N + 1) = O(2N + 1), che si semplifica in O(N). Poiché le iterazioni sono N, la complessità è N × O(N) = O(N2). Il resto della funzione
selection_sort()consiste in tre semplici istruzioni, quindi la complessità complessiva è O(N2 + 3) = O(N2).La nostra analisi del ciclo for ha comportato una semplificazione eccessiva. A ogni iterazione, rimuoviamo un elemento dalla lista, il che significa che non tutte le iterazioni eseguono lo stesso numero di istruzioni. La prima iterazione esegue N istruzioni, la seconda N - 1, la terza N - 2, e così via fino all'ultima, che ne esegue solo 1.
Questo implica che la vera complessità del ciclo for è:
N + (N - 1) + (N - 2) + … + 1
Questa somma si può dimostrare uguale a (N2 + N) / 2. Tuttavia,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Anche se abbiamo sovrastimato, la complessità complessiva resta quadratica. La funzione
selection_sort()esemplifica un algoritmo di ordinamento più lento a causa della sua complessità quadratica, O(N2).Le funzioni con complessità quadratica scalano male: sono adatte a liste piccole ma impraticabili per ordinare milioni di punti dati, perché possono richiedere giorni per completarsi. Raddoppiare i dati porta a quadruplicare il tempo di esecuzione.
Tempo loglineare: O(N log(N))
È possibile ideare un algoritmo per ordinare una lista con complessità O(N log(N)). Uno di questi algoritmi è detto merge sort. Non entreremo nei dettagli dell'implementazione, ma se vuoi saperne di più, dai un'occhiata a questa breve introduzione a merge sort da questo corso su Strutture dati e algoritmi in Python.
Come detto, la complessità logaritmica in pratica si comporta in modo simile a quella costante. Pertanto, il tempo di esecuzione di un algoritmo O(N log(N)) può essere paragonabile a quello di un algoritmo lineare in applicazioni reali.
Il grafico seguente mostra che N log(N) e N crescono a tassi simili, mentre N2 cresce molto velocemente, diventando rapidamente molto lento.
Tempo cubico: O(N3)
Un algoritmo a tempo cubico ampiamente utilizzato nell'IA è la moltiplicazione di matrici, che svolge un ruolo cruciale nel funzionamento dei large language model come GPT. Questo algoritmo è fondamentale nei calcoli effettuati sia in fase di training che di inferenza.
Per moltiplicare due matrici N per N, A e B, dobbiamo moltiplicare ogni riga della prima matrice A per ogni colonna della seconda matrice B. In particolare, il valore del prodotto in posizione (i, j) è determinato moltiplicando gli elementi della riga i di A per gli elementi corrispondenti della colonna j di B.
Ecco un'implementazione in Python della moltiplicazione di matrici:
In totale,
matrix_mul()esegue N3 + N2 + 2 istruzioni, quindi la sua complessità temporale è O(N3).In alternativa, avremmo potuto analizzare la complessità ragionando sui calcoli. Il risultato della moltiplicazione ha N2 voci. Ogni voce richiede O(N) tempo per essere calcolata, quindi la complessità complessiva è N2 × O(N) = O(N3).
Gli algoritmi a tempo cubico sono piuttosto lenti. Raddoppiare i dati comporta un fattore otto nel tempo di esecuzione, facendo scalare molto male questi algoritmi. Anche per un valore relativamente piccolo di N, il numero di istruzioni esplode molto rapidamente.
La moltiplicazione di matrici è un esempio di sfida computazionale in cui i progressi hardware hanno avuto un impatto significativo. Sebbene esistano algoritmi leggermente più efficienti per la moltiplicazione di matrici, sono soprattutto i progressi nella progettazione dei chip GPU — pensati specificamente per eseguire la moltiplicazione di matrici — ad aver reso notevolmente più agevole l'addestramento di modelli di grandi dimensioni come GPT in tempi ragionevoli.
Più recentemente, i ricercatori hanno proposto di eliminare la moltiplicazione di matrici dai grandi modelli di apprendimento — puoi saperne di più in questo articolo su LLM senza MatMul: concetti chiave spiegati.
Complessità temporale esponenziale: O(2N) e O(N!)
Gli algoritmi a tempo esponenziale tipicamente sorgono quando si risolve un problema esplorando tutte le soluzioni possibili. Considera la pianificazione di un percorso per un camion delle consegne che deve visitare N destinazioni. Un approccio consiste nel valutare ogni possibile ordine di consegna. Il pacchetto itertools di Python offre un metodo semplice per scorrere tutte le permutazioni di una lista.
Il numero di permutazioni di una lista di lunghezza N è indicato con N!, letto "N fattoriale". La funzione fattoriale cresce in modo esponenziale. Per esempio, quando N = 13, il numero di permutazioni supera 1 miliardo.
Supponiamo che le destinazioni siano date come una lista di punti 2D. In tal caso, possiamo determinare la sequenza che minimizza la distanza totale iterando su tutte le sequenze possibili e tenendo traccia della migliore.
Il primo ciclo
forviene eseguito N! volte. Pertanto, il numero di operazioni inoptimize_route()è N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.Abbiamo imparato che nel calcolo della complessità temporale ignoriamo i termini con esponente più basso. Tuttavia, in questo scenario incontriamo un termine N!, che non è una potenza di N. Possiamo affinare la nostra strategia di semplificazione scegliendo di omettere i termini con tassi di crescita più lenti. La tabella seguente elenca i termini comunemente presenti nella complessità di un algoritmo, disposti dal tasso di crescita più basso al più alto.
1
log(N)
N
N2
N3
Nk
2N
N!
Così possiamo esprimere la complessità temporale di
optimize_route()come N! x N + 2N! + 3 = O(N! x N).Gli algoritmi a complessità esponenziale sono tipicamente efficienti solo per istanze molto piccole. Anche con sole 13 destinazioni, il numero di permutazioni supera 1 miliardo, rendendo questo algoritmo impraticabile in scenari reali.
Complessità temporale: caso peggiore e caso migliore
Con il gioco dell'indovinare il numero, ci siamo concentrati sulla complessità nel caso peggiore. Concentrandoci sul caso peggiore, garantiamo il tasso di crescita del tempo di esecuzione dell'algoritmo.
Nel caso migliore, indoviniamo al primo colpo, quindi un'analisi del caso migliore restituirebbe complessità O(1). È corretto — nel caso migliore, serve una sola operazione costante. Tuttavia, non è molto utile perché è molto improbabile.
In generale, quando analizziamo la complessità di un algoritmo, ci concentriamo sempre sul caso peggiore perché:
Complessità temporale: implicazioni pratiche
La complessità temporale può sembrare un argomento molto teorico, ma può rivelarsi molto utile in pratica.
Per esempio, se una funzione gestisce costantemente un dataset piccolo, un algoritmo O(N2) facile da capire può essere più appropriato di un algoritmo O(N) complesso e difficile da mantenere. Tuttavia, dovrebbe essere una decisione ponderata per evitare di essere colti di sorpresa quando l'applicazione non riesce a gestire un aumento del traffico.
L'analisi della complessità temporale rivela che piccole ottimizzazioni del codice hanno un effetto trascurabile sul tempo di esecuzione di un algoritmo. Miglioramenti significativi si ottengono riducendo alla radice il numero di operazioni di base necessarie per calcolare il risultato. In generale, è preferibile mantenere un codice pulito e comprensibile piuttosto che ottimizzarlo fino a renderlo incomprensibile.
Le parti più lente del codice domineranno le altre. Di solito è inutile ottimizzare la parte più veloce prima di quella più lenta. Per esempio, immagina di avere una funzione che esegue due compiti:
Se la funzione
clean_data()ha complessità O(N2) eanalyze_data()ha complessità O(N3), allora ridurre la complessità diclean_data()non migliorerà la complessità complessiva diprocess_data(). È meglio concentrarsi sul migliorare la funzioneanalyze_data().Inoltre, la complessità temporale può guidare decisioni hardware. Per esempio, un algoritmo O(N3), nonostante la scarsa scalabilità, può comunque essere abbastanza veloce per compiti con dati limitati se eseguito su hardware superiore o con un linguaggio di programmazione più veloce. Al contrario, se un algoritmo ha complessità esponenziale O(2N), nessun upgrade hardware basterà, indicando la necessità di un algoritmo più efficiente.
Conclusione
Nonostante i computer siano sempre più veloci, abbiamo a che fare con più dati che mai. Pensala così: ogni volta che usiamo Internet, smartphone o dispositivi smart home, creiamo enormi quantità di informazioni. Man mano che questa montagna di dati cresce, setacciarla e trovare ciò che conta diventa più difficile. Ecco perché è davvero importante continuare a migliorare i nostri strumenti — in particolare gli algoritmi — nel gestire e comprendere tutte queste informazioni.
L'analisi della complessità temporale offre un quadro semplice per ragionare sul tempo di esecuzione di un algoritmo. Il suo obiettivo principale è fornire indicazioni sul tasso di crescita della complessità temporale, più che prevedere tempi esatti. Nonostante le numerose semplificazioni e assunzioni del modello, si è dimostrata estremamente utile in pratica, cogliendo efficacemente l'essenza dei comportamenti del tempo di esecuzione degli algoritmi.
Se vuoi esplorare altri argomenti di informatica, dai un'occhiata al mio articolo su Strutture dati: una guida completa con esempi in Python.