
Cursus
Objectgeoriënteerd programmeren in Python
4 uur
105.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleOf je nu op zoek bent naar een nieuwe uitdaging in softwareontwikkeling of data-analyse, of een hiring manager bent die een kandidaat gaat bevragen voor een vacature in je bedrijf: het kennen van veelvoorkomende programmeervragen en -antwoorden voor sollicitatiegesprekken is een must.
Je voorbereiden op deze vragen is vaak een lastig en tijdrovend proces, zowel vanuit het perspectief van de werkgever als de kandidaat.
In dit artikel bekijken we 24 essentiële programmeervragen en -antwoorden voor beginnende, gemiddelde en gevorderde professionals. Deze vragen en antwoorden helpen je beter voorbereiden op het gesprek en laten zien wat je kunt verwachten van je interviewer/interviewee.
Laten we beginnen met enkele van de eenvoudigste en meest voorkomende programmeervragen voor sollicitaties.
Variabelen zijn fundamentele elementen in programmeren. Een variabele is in essentie een container die gegevens opslaat, en de waarde ervan kan worden gewijzigd tijdens de uitvoering van een programma. Moderne programmeertalen ondersteunen verschillende soorten variabelen, elk ontworpen voor specifieke gegevenstypen en use-cases.
Wil je alles weten over variabelen? Onze cursus Inleiding tot Python is een prima startpunt.
In programmeren zijn gegevenstypen de soorten waarden die variabelen kunnen opslaan. Elk gegevenstype heeft bijbehorende eigenschappen, die essentieel zijn om te weten welke wiskundige, relationele of logische operaties kunnen worden uitgevoerd.
In Python heb je bijvoorbeeld meerdere numerieke gegevenstypen, waaronder integers, die gehele getallen opslaan, en floats, die waarden met decimalen opslaan. Er zijn ook strings, die geordende reeksen tekens opslaan tussen enkele of dubbele aanhalingstekens.
integer_var = 25
float_var = 10.2
String_var = "Welcome to DataCamp"
Lees ons aparte artikel om de meest voorkomende Python-gegevenstypen te ontdekken.
Het belangrijkste verschil tussen gecompileerde en geïnterpreteerde talen is hoe de instructies, ook wel algoritmen genoemd, worden vertaald naar machinecode (oftewel binaire code). Gecompileerde talen worden vóór uitvoering vertaald, terwijl geïnterpreteerde talen tijdens runtime worden vertaald.
Dat maakt gecompileerde talen geschikter voor complexe taken die snelheid vereisen, zoals realtime verkeersdetectie in autonome auto’s. Gecompileerde talen, zoals C en C++, zijn echter doorgaans moeilijker te begrijpen en mee te werken dan geïnterpreteerde talen zoals Python.
Voorwaardelijke uitspraken, vaak bekend als if-else-statements, worden gebruikt om bepaalde codeblokken uit te voeren op basis van specifieke voorwaarden. Deze uitspraken helpen de stroom van een algoritme te sturen, zodat het zich in verschillende situaties anders gedraagt.
Een loop daarentegen is een codeblok dat herhaaldelijk wordt uitgevoerd totdat een bepaalde voorwaarde is bereikt, waardoor uren werk worden teruggebracht tot seconden. De meest voorkomende lussen zijn for-loops en while-loops. Je kunt er meer over leren in onze aparte tutorial over loops.
Arrays en gelinkte lijsten behoren tot de belangrijkste datastructuren. Het zijn structuren die informatie opslaan met verschillende strategieën.
Een array slaat elementen op in aaneengesloten geheugensecties, d.w.z. elk element wordt opgeslagen in een geheugenlocatie die grenst aan de vorige. Bovendien is de grootte van een array onveranderlijk en wordt deze vooraf gedeclareerd.
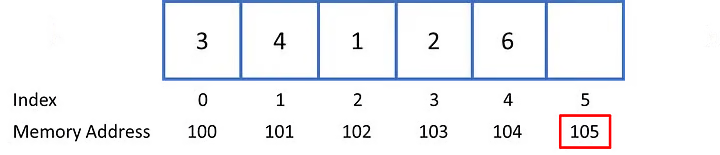
Array. Bron
Gelinkte lijsten daarentegen gebruiken pointers om het geheugenadres van het volgende element op te slaan, zoals hieronder weergegeven.
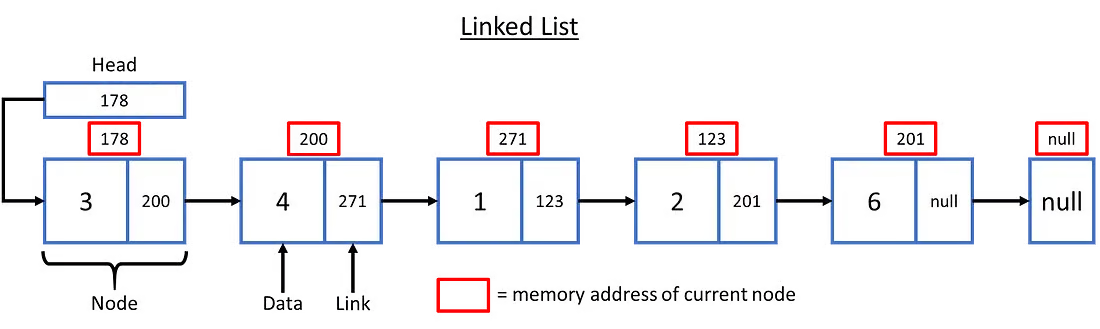
Gelinkte lijst. Bron
Over het algemeen hebben arrays de voorkeur wanneer snelle toegang tot elementen nodig is en geheugen een aandachtspunt is, terwijl gelinkte lijsten beter zijn in situaties met frequente invoegingen en verwijderingen.
In programmeren treedt recursie op wanneer een functie zichzelf aanroept. Een goed voorbeeld van recursie is een functie die de faculteit van een getal berekent. Onthoud dat de faculteit van een niet-negatief geheel getal n het product is van alle positieve gehele getallen kleiner dan of gelijk aan n.
def factorial(n):
    if n < 2:
        return 1
    else:
        return n * factorial(n-1)

factorial(5)
>>> 120
Geïnteresseerd in recursieve functies? Lees onze Gids: Recursieve functies in Python begrijpen om te beginnen.
Een pointer is een variabele die het geheugenadres van een andere variabele als waarde opslaat. Veelgebruikt in datastructuren zoals gelinkte lijsten, geven pointers toegang op laag niveau tot geheugen, dynamische geheugentoewijzing en veel andere functionaliteit.
Big-O-notatie is een wiskundige notatie die wordt gebruikt om de complexiteit van algoritmen te beschrijven. Big-O-notatie meet de worstcasescenario-complexiteit van een algoritme. Het houdt rekening met tijdscomplexiteit, d.w.z. de tijd die een algoritme nodig heeft om volledig te draaien, en ruimtecomplexiteit, de extra geheugencapaciteit die een algoritme vereist. We leggen de basis van Big-O-notatie uit in deze tutorial.
In deze sectie focussen we op veelvoorkomende vragen voor kandidaten die zich voorbereiden op functies op middenniveau met enige ervaring.
Objectgeoriënteerd programmeren is een paradigma dat focust op objecten. OOP is gebaseerd op de volgende vier pijlers:
Er zijn verschillende bronnen om objectgeoriënteerd programmeren te leren, waaronder DataCamp’s OOP in Python-cursus, OOP in R-cursus en OOP in Java-tutorial.
In objectgeoriënteerd programmeren worden data en methoden georganiseerd in objecten die worden gedefinieerd door hun klasse. Klassen zijn ontworpen om te bepalen hoe elk object zich moet gedragen, en vervolgens worden objecten binnen die klasse ontworpen.
Bekijk onze tutorial voor meer details over hoe klassen en objecten werken in Python.
In OOP stelt polymorfisme je in staat dezelfde naam te gebruiken voor verschillende methoden die verschillend gedrag vertonen afhankelijk van de input. Dit wordt vaak gebruikt in combinatie met overerving.
Stel bijvoorbeeld dat we een ouderklasse Shape hebben met een methode om de oppervlakte van de vorm te berekenen. Je kunt twee kindklassen hebben, Circle en Square. Hoewel beide een methode genaamd Area hebben, is de definitie van die methode voor elke vorm anders. Vergelijk de methoden voor de oppervlakte voor de verschillende vormen in het codeblok hieronder.
# Define the parent class Shape
class Shape:
	# Initialize the attributes for the shape
	def __init__(self, name):
    	    self.name = name

	# Define a generic method for calculating the area
	def area(self):
    	    print(f"The area of {self.name} is unknown.")

# Define the child class Circle that inherits from Shape
class Circle(Shape):
	# Initialize the attributes for the circle
	def __init__(self, name, radius):
    	# Call the parent class constructor
    	    super().__init__(name)
    	    self.radius = radius

	# Override the area method for the circle
	def area(self):
    	# Use the formula pi * r^2
    	    area = 3.14 * self.radius ** 2
    	    print(f"The area of {self.name} is {area}.")

# Define the child class Square that inherits from Shape
class Square(Shape):
	# Initialize the attributes for the square
	def __init__(self, name, side):
    	# Call the parent class constructor
    	    super().__init__(name)
    	    self.side = side

	# Override the area method for the square
	def area(self):
    	# Use the formula s^2
    	    area = self.side ** 2
print(f"The area of {self.name} is {area}.")Zowel overerving als compositie zijn technieken in OOP om codehergebruik te vergroten. De eerste is het mechanisme waarbij een nieuwe klasse wordt afgeleid van een bestaande klasse en al diens eigenschappen en methoden erft. De tweede houdt in dat je complexe objecten opbouwt door eenvoudige onderdelen te combineren in plaats van te erven van een basisklasse.
Over het geheel genomen biedt compositie meerdere voordelen ten opzichte van overerving, waaronder meer flexibiliteit, minder complexiteit en betere onderhoudbaarheid.
In de informatica is functioneel programmeren een programmeerparadigma waarbij programma’s worden geconstrueerd door functies toe te passen en te combineren. Het is een subtype van het declaratieve programmeerparadigma.
Functioneel programmeren valt op door zijn traceerbaarheid en voorspelbaarheid. Dit komt doordat de gebruikte functies immutabel zijn, wat betekent dat ze niet kunnen worden gewijzigd. Functies worden gedefinieerd, vaak in een apart gedeelte van de code (of soms in een ander bestand), en vervolgens overal in de code gebruikt waar nodig. Deze eigenschap maakt het eenvoudig om te begrijpen wat er in een stuk code gebeurt, omdat de functie zich overal hetzelfde gedraagt en op dezelfde manier wordt aangeroepen.
Nog steeds verward over de verschillen tussen functioneel programmeren en OOP? Bekijk onze aparte gids om het op te helderen.
Qua programmeerparadigma’s zijn er twee brede categorieën waar veel van de gangbare paradigma’s onder vallen: imperatief en declaratief programmeren.
Op hoog niveau is imperatief programmeren een categorie paradigma’s waarin de programmeur de exacte instructies stap voor stap uitwerkt die het programma moet volgen. De focus ligt op hoe je het programma uitvoert. Deze stijl van programmeren kun je zien als een stroomdiagram, waarbij het programma een bepaald pad volgt op basis van gespecificeerde inputs. De meeste mainstream programmeertalen maken gebruik van imperatief programmeren.
Declaratief programmeren daarentegen is een categorie paradigma’s waarin de programmeur de logica van het programma definieert, maar geen details geeft over de exacte stappen die het programma moet volgen. De focus ligt op wat het programma moet uitvoeren in plaats van precies hoe. Dit type programmeren is minder gebruikelijk, maar kan worden ingezet in situaties waar de regels zijn gespecificeerd en het exacte pad naar de oplossing niet bekend is. Een voorbeeld is het oplossen van een cijferpuzzel zoals Sudoku.
Er valt nog veel meer te zeggen over programmeerparadigma’s. Daarom willen we graag onze Introductiecursus Programmeerparadigma’s aanraden.
Pure functies zijn een kernonderdeel van functioneel programmeren. Simpel gezegd is een pure functie een proces dat inputwaarden neemt en outputwaarden teruggeeft die uitsluitend op de inputwaarden zijn gebaseerd. Pure functies hebben geen "neveneffecten", wat betekent dat ze geen invloed hebben op andere variabelen in het programma, geen bestanden wegschrijven en geen informatie in een database wijzigen.
De aard van pure functies maakt ze de perfecte compagnon voor programmeurs. Ten eerste zijn ze heel makkelijk te debuggen, want elke pure functie met dezelfde set parameters zal altijd dezelfde waarde opleveren.
Om precies dezelfde reden zijn pure functies eenvoudiger te parallelliseren, in tegenstelling tot onzuivere functies, die zo kunnen interfereren dat je bij verschillende uitvoeringen verschillende resultaten krijgt omdat ze muteerbare variabelen in een andere volgorde bijwerken of uitlezen.
In functioneel programmeren is, in tegenstelling tot pure functies, een higher-order functie een functie die ofwel één of meer functies als argumenten neemt (d.w.z. een procedurele parameter, een parameter van een procedure die zelf een procedure is), een functie retourneert, of beide.
Een veelvoorkomend voorbeeld van een higher-order functie is Python’s map(). In veel functionele talen gebruikelijk, neemt map() als argumenten een functie f en een verzameling elementen, en retourneert het een nieuwe verzameling met de functie toegepast op elk element uit de verzameling. Stel bijvoorbeeld dat je een lijst met getallen hebt en je wilt een nieuwe verzameling met de getallen geconverteerd naar floats.
numbers = [1,2,3,4]
res = map(float, numbers)
print(list(numbers))
>>> [1.0, 2.0, 3.0, 4.0]Laten we tot slot enkele van de meest voorkomende vragen bekijken voor ervaren kandidaten die mikken op toptechbedrijven.
Dynamisch programmeren is een methode om complexe problemen op te lossen door ze op te delen in kleinere overlappende subproblemen.
In plaats van elke keer opnieuw te beginnen, houd je de oplossingen voor die kleinere delen bij, wat betekent dat je dezelfde berekeningen niet herhaaldelijk hoeft uit te voeren. Deze methode is erg nuttig om de langste gemeenschappelijke subsequence tussen twee strings te vinden of de minimale kosten om een specifiek punt op een raster te bereiken.
Memoization en tabulation zijn twee krachtige technieken in dynamisch programmeren om de prestaties van algoritmen te optimaliseren, vaak recursieve algoritmen.
Memoization, ook wel caching genoemd, houdt in dat je het resultaat van kostbare functieaanroepen opslaat en de opgeslagen resultaten teruggeeft wanneer dezelfde inputs opnieuw voorkomen. Op die manier worden subproblemen maar één keer berekend. Memoization volgt een top-downbenadering, wat betekent dat we beginnen bij het "topprobleem" en recursief afdalen om meerdere subproblemen op te lossen en te cachen.
Daarentegen houdt tabulation in dat je alle kleinste subproblemen berekent en de resultaten in een tabel opslaat. Het wordt beschouwd als een bottom-upbenadering omdat het begint met het oplossen van de kleinste subproblemen, en zodra we al deze oplossingen hebben, berekenen we de oplossing voor het topprobleem.
De Fibonacci-reeks verloopt als volgt: 0, 1, 1, 2, 3, 5, 8, 13, 21, 34 … waarbij elk getal in de reeks wordt gevonden door de twee voorgaande getallen op te tellen.
De meest intuïtieve manier om het probleem op te lossen is via recursie, zoals hieronder weergegeven.
#  a simple recursive program for Fibonacci numbers
def fib(n):
    if n <= 1:
        return n

    return fib(n - 1) + fib(n - 2)
Dit is echter niet de meest efficiënte manier om de reeks te vinden. Het vorige algoritme heeft een exponentiële tijdscomplexiteit, genoteerd als O(2^N), wat betekent dat het aantal berekeningen exponentieel toeneemt naarmate N toeneemt.
Een andere manier om naar het Fibonacci-probleem te kijken is door het op te splitsen in kleine subproblemen, als volgt:
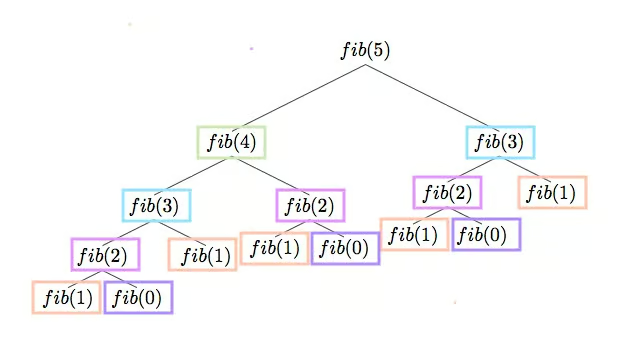
Fibonacci-reeks voor fib(5). Bron
Zoals je ziet, als we onze code zouden uitvoeren voor n=5, berekent de fib()-functie dezelfde bewerking meerdere keren, wat leidt tot verspilling van rekenresources.
Dynamisch programmeren biedt verschillende technieken om de berekening van de Fibonacci-reeks te optimaliseren.
Laten we het probleem analyseren met memoization. Zoals al vermeld, houdt dit in dat je het resultaat van kostbare functieaanroepen opslaat en de opgeslagen resultaten teruggeeft wanneer dezelfde inputs opnieuw voorkomen. Dit wordt bereikt met de volgende code, die de resultaten van de functie fibonacci_memo() opslaat in een dictionary. Met deze optimalisatie wordt elke input slechts één keer berekend, waardoor de tijdscomplexiteit wordt teruggebracht tot lineair, genoteerd als O(N).
cache = {0: 0, 1: 1}

def fibonacci_memo(n):
    if n in cache:  # Base case
        return cache[n]
   # Compute and cache the Fibonacci number
    cache[n] = fibonacci_memo(n - 1) + fibonacci_memo(n - 2)  # Recursive case
    return cache[n]

[fibonacci_memo(n) for n in range(15)]
[0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, 377]In dynamisch programmeren zijn subproblemen kleinere versies van het oorspronkelijke probleem. Een probleem heeft overlappende subproblemen als het vinden van de oplossing inhoudt dat je hetzelfde subprobleem meerdere keren moet oplossen, zoals bij het berekenen van de Fibonacci-reeks hierboven.
Aan de andere kant wordt een probleem geacht een optimale substructuur te hebben als de optimale oplossing voor het gegeven probleem kan worden geconstrueerd uit optimale oplossingen van de subproblemen.
Hashmaps, ook wel hashtables genoemd, vormen een van de meest voorkomende implementaties van hashing. Hashmaps slaan sleutel-waardeparen op (bijv. medewerkers-ID en medewerkersnaam) in een lijst die via de index toegankelijk is. Je zou kunnen zeggen dat een hashmap een datastructuur is die hashingtechnieken benut om gegevens associatief op te slaan.
Het idee achter hashmaps is om de items (sleutel/waardeparen) te verdelen over een array van buckets. Gegeven een sleutel, berekent een hashfunctie een unieke index die aangeeft waar het item te vinden is. Het gebruik van een index in plaats van de oorspronkelijke sleutel maakt hashmaps bijzonder geschikt voor meerdere data-operaties, waaronder invoegen, verwijderen en zoeken.
Een illustratief voorbeeld van hashtables zijn Python-dictionaries. Bekijk onze Gids voor Python Hashmaps om meer te leren over deze krachtige datastructuren.
Threading stelt je in staat om verschillende delen van je proces gelijktijdig uit te voeren. Deze verschillende delen zijn meestal individueel en hebben een afzonderlijke uitvoeringseenheid die bij hetzelfde proces hoort. Het proces is niets anders dan een draaiend programma dat individuele eenheden heeft die gelijktijdig kunnen worden uitgevoerd.
Een deadlock ontstaat wanneer meerdere threads voor onbepaalde tijd worden geblokkeerd terwijl ze wachten op resources die door andere threads worden vastgehouden. Dit scenario leidt tot een onbreekbare cyclus van afhankelijkheden waarbij geen van de betrokken threads voortgang kan boeken.
Lees DataCamp’s Python-threading-tutorial om meer te weten over threads en waarom ze belangrijk zijn voor data-analyse,
Breadth-first search (BFS) en depth-first search (DFS) zijn beide grafdoorloopalgoritmen die zijn ontworpen om een graaf of boom te verkennen.
BFS verkent een graaf niveau voor niveau en bezoekt alle knopen op de huidige diepte voordat het naar de volgende gaat. DFS daarentegen geeft prioriteit aan het zo diep mogelijk verkennen van één tak voordat wordt teruggekeerd om alternatieve takken te onderzoeken.
BFS is bijzonder handig wanneer het doel is om het kortste pad in een ongewogen graaf te vinden. BFS kan echter veel geheugen gebruiken, vooral in brede grafen, omdat het alle knopen op elk niveau moet bijhouden. BFS is een uitstekende keuze voor socialenetwerkanalyse of eenvoudige routeringsproblemen.
DFS is daarentegen nuttig wanneer het doel is om alle mogelijke paden of oplossingen te verkennen, zoals bij het oplossen van puzzels of het vinden van cycli in een graaf. In tegenstelling tot BFS garandeert DFS niet het kortste pad. Het is echter geheugen-efficiënter, omdat het alleen het huidige pad bijhoudt.
Je kunt meer over deze algoritmen leren in onze Gids voor Breadth-First Search en Gids voor Depth-First Search.
Mergesort werkt door de invoerarray recursief op te delen in kleinere subarrays en die subarrays te sorteren, waarna ze weer worden samengevoegd om de gesorteerde output te verkrijgen. Het heeft een lineair-logaritmische tijdscomplexiteit, genoteerd als O(N log(N)).
In Big-O-notatie gedraagt lineair-logaritmische tijd zich vergelijkbaar met lineaire tijd, wat betekent dat als de hoeveelheid invoergegevens verdubbelt, de tijd die mergesort nodig heeft om de gegevens te verwerken ook zal verdubbelen.
Het quicksort-algoritme gebruikt een partitioneringstechniek door een waarde uit de lijst te kiezen, de pivot. Alle items kleiner dan de pivot komen links van de pivot terecht, en grotere elementen rechts. Quicksort wordt vervolgens recursief aangeroepen op de elementen links en rechts van de pivot.
Quicksort heeft een exponentiële tijdscomplexiteit, genoteerd als O(N^2), in het worstcasescenario, dat zich voordoet wanneer de pivotkeuze consequent leidt tot onevenwichtige partities.
In dit artikel hebben we veel programmeervragen voor sollicitatiegesprekken behandeld, variërend van basis- tot gemiddelde en gevorderde onderwerpen. Van het begrijpen van de kernconcepten van datastructuren zoals arrays en gelinkte lijsten tot het verdiepen in complexere technieken uit de disciplines OOP, functioneel programmeren en dynamisch programmeren, we hebben de kerngebieden verkend waar potentiële werkgevers naar kunnen vragen.
Heb je meer programmeertraining nodig voor je gesprek of ben je geïnteresseerd in interviewvragen voor andere rollen op het gebied van data en AI? Bekijk dan de volgende resources:
Topcursussen van DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

