Le immagini sono ovunque. Viviamo in un’epoca in cui immagini e video racchiudono molte informazioni, a volte difficili da ottenere. Per questo l’analisi delle immagini, nota anche come computer vision, è diventata una competenza di grande valore, applicabile in molti casi d’uso.
Questa guida introduce l’affascinante campo della computer vision. Spiega i fondamenti di questa disciplina scientifica, le sue principali applicazioni e come il machine learning e il deep learning stiano rivoluzionando la computer vision, aprendo la strada a nuove, straordinarie possibilità.
Cos’è la Computer Vision?
In parole semplici, la computer vision è un ramo dell’IA che studia come i computer possano vedere e comprendere il contenuto di immagini e video digitali.
L’obiettivo finale della computer vision è replicare nelle macchine le capacità della visione umana. Tuttavia, mentre gli esseri umani usano retine, nervi ottici e aree dedicate del cervello per raccogliere ed elaborare le informazioni visive, questo processo nelle macchine è del tutto diverso. Per insegnare alle macchine a vedere, facciamo invece affidamento su una varietà di componenti tecnologici, tra cui:
- Sensori. Fotocamere e altri dispositivi dotati di sensori specializzati sono fondamentali per catturare i dati visivi che ci circondano.
- Dati. Molti conoscono già i dati di immagini e video e i loro formati tradizionali, come .jpg e .png per le immagini e .mov e .avi per i video. Vale però la pena ricordare che la gamma dei dati d’immagine può assumere molte forme, come viste da più telecamere, dati multidimensionali da uno scanner 3D o dispositivi di diagnostica per immagini.
- Algoritmi. Come in qualunque altra analisi dei dati, prima dell’analisi c’è la preparazione dei dati. I ricercatori di computer vision hanno sviluppato una miriade di tecniche e algoritmi per pulire e preparare i dati d’immagine, tra cui filtraggio, ridimensionamento o normalizzazione delle immagini. Una volta preparati i dati visivi, arriva la parte divertente. Con l’ascesa del deep learning, possiamo addestrare potenti modelli che superano rapidamente le capacità umane in un’ampia gamma di compiti, come vedremo nella prossima sezione.
Applicazioni della Computer Vision
La vista è un senso chiave che molti di noi usano per una varietà di attività quotidiane. In quest’ottica, non dovrebbe sorprenderci la moltitudine di applicazioni reali della computer vision disponibili oggi.
Di seguito trovi un elenco non esaustivo delle applicazioni più rilevanti della computer vision.
Rilevamento di oggetti
Molte applicazioni popolari di computer vision riguardano il riconoscimento di elementi nelle immagini. Un ottimo esempio sono le auto a guida autonoma. I produttori utilizzano più telecamere per acquisire immagini dell’ambiente affinché le auto possano rilevare oggetti, segnaletica orizzontale e cartelli stradali per guidare in sicurezza. Come funziona in pratica l’object detection? Ti consigliamo di leggere il nostro tutorial sul Rilevamento di Oggetti con YOLO.
Riconoscimento facciale
Usato per sicurezza e sorveglianza, il riconoscimento facciale analizza caratteristiche chiave per identificare le persone. Ciò avviene addestrando reti neurali su vasti database biometrici che consentono ai modelli di individuare tratti facciali unici negli esseri umani. Leggi il nostro tutorial dedicato per scoprire come eseguire la Rilevazione del Volto con Python.
Traduzione automatica
Strumenti come Google Translate permettono di puntare la fotocamera dello smartphone su un cartello in un’altra lingua e ottenere quasi immediatamente la traduzione del cartello nella lingua preferita.
Generazione di immagini
Le applicazioni di computer vision non solo comprendono le immagini, ma oggi sono anche in grado di crearne di realistiche usando l’IA generativa. È il caso di DALL-E, un modello genAI che crea immagini a partire da descrizioni testuali, o Sora, che fa lo stesso ma con i video. Un altro esempio sono i deepfake. Un deepfake è un software usato per rappresentare persone in video falsi nei quali non sono mai apparse. Comprendendo la struttura di un volto umano, i deepfake possono generare nuovi volti.
Curioso di altre applicazioni della computer vision? Dai un’occhiata al nostro articolo dedicato per scoprire 19 progetti di Computer Vision, dal livello principiante all’avanzato.
Computer Vision nell’IA
Le applicazioni uniche di computer vision di cui disponiamo oggi non sarebbero possibili senza l’IA, in particolare i modelli di deep learning. Per capire il perché, dobbiamo prima comprendere cos’è un’immagine digitale, l’unità di informazione più basilare nella computer vision.
Un’immagine digitale è composta da centinaia, se non migliaia, di pixel che contengono informazioni su colore e intensità. Nelle immagini in scala di grigi, l’intensità di ciascun pixel può essere rappresentata da un numero tra 0 e 255.
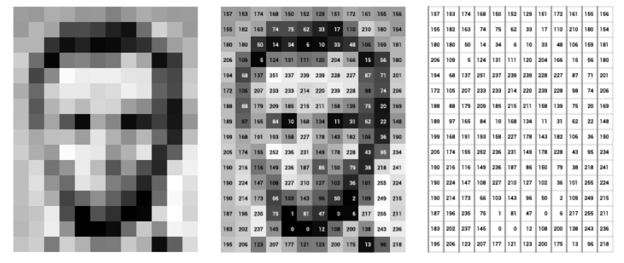
Immagini in scala di grigi. Fonte: DataCamp
Le immagini a colori, invece, sono generalmente memorizzate nel sistema RGB. RGB sta per Red, Green e Blue. Possiamo pensare a ogni immagine come rappresentata da tre raster, uno per ciascun canale colore. Questo significa che serve una quantità di dati tripla per archiviare un’immagine a colori rispetto a una in scala di grigi.
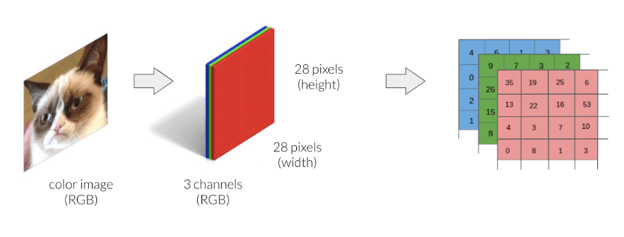
Immagini a colori. Fonte: DataCamp
Dunque, le immagini digitali possono essere viste come un insieme di numeri. Fino a non molto tempo fa, ci mancavano gli strumenti potenti necessari per elaborare ed estrarre informazioni dalle immagini. Questo è cambiato all’inizio degli anni 2010, quando i ricercatori di deep learning sono riusciti a sviluppare nuove reti neurali particolarmente adatte ai compiti di computer vision.
Oggi, grazie ai progressi del deep learning e allo sviluppo di GPU, cloud computing e all’ampia disponibilità di dati d’immagine, i professionisti dei dati possono addestrare potenti reti neurali capaci di affrontare compiti complessi nella computer vision.
Sull’onda dell’IA generativa, i più avanzati vision language model (VLM) sanno comprendere ed elaborare sia dati visivi che testuali, abilitando nuovi compiti come la didascalizzazione delle immagini, il visual question answering e la generazione testo-immagine.
Ti incuriosiscono le reti neurali? Dai un’occhiata al nostro corso introduttivo al Deep Learning con Python per iniziare oggi stesso.
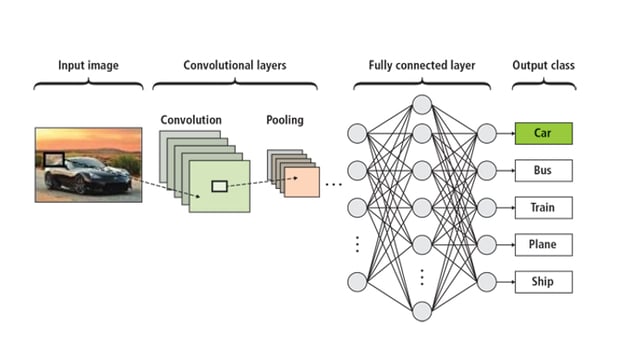
Rete neurale per la computer vision. Fonte: NVIDIA
Differenza tra Machine Vision e Computer Vision
Un’idea sbagliata comune tra chi è alle prime armi riguarda la differenza tra machine vision e computer vision.
Per machine vision si intende l’uso di telecamere, sensori e algoritmi per aiutare computer e robot ad analizzare le immagini e prendere decisioni informate durante i processi di produzione. Le applicazioni della machine vision comprendono attività come ispezione automatica, controllo qualità e guida dei robot.
Il termine è spesso usato in contesti manifatturieri e industriali, quindi il suo ambito è specifico per l’applicazione e più ristretto rispetto alla computer vision, che ha un raggio d’azione più ampio in vari settori. Allo stesso modo, in termini di complessità, la computer vision prevede spesso elaborazioni e interpretazioni più complesse rispetto alla machine vision.
Puoi vedere le differenze tra machine vision e computer vision nella tabella qui sotto:
|
Aspetto
|
Machine Vision
|
Computer Vision
|
|
Definizione
|
Uso di telecamere, sensori e algoritmi per analizzare immagini e prendere decisioni, spesso in contesti industriali.
|
Un campo dell’IA focalizzato nel permettere ai computer di interpretare e comprendere immagini e video digitali.
|
|
Casi d’uso principali
|
Controllo qualità, rilevamento difetti, monitoraggio delle linee di assemblaggio e guida dei robot.
|
Rilevamento di oggetti, riconoscimento facciale, generazione di immagini, veicoli autonomi e imaging medico.
|
|
Complessità
|
Generalmente più semplice e specifica per il compito.
|
Coinvolge elaborazioni complesse, spesso usando modelli di IA e deep learning.
|
|
Ambito
|
Ristretto, specifico per l’applicazione (principalmente produzione e automazione industriale).
|
Ampio, comprende più settori come sanità, retail, automotive ed entertainment.
|
|
Focus tecnologico
|
Telecamere, illuminazione e hardware per la cattura e l’analisi di immagini in ambienti controllati.
|
Algoritmi, reti neurali e grandi dataset per una comprensione avanzata delle immagini.
|
|
Esempi
|
Ispezione automatizzata di schede elettroniche, guida di bracci robotici in fabbrica.
|
Addestramento di auto a guida autonoma, creazione di deepfake o identificazione di malattie in esami diagnostici.
|
Primi passi con la Computer Vision
La computer vision è una delle discipline più interessanti e richieste nell’IA. Se vuoi iniziare in questo campo, DataCamp è qui per aiutarti. Lavoriamo per offrire ai professionisti dei dati corsi e materiali dedicati di valore e sempre aggiornati.
Ti consigliamo di iniziare con il nostro Percorso di Competenze: Image Processing in Python. Questo percorso copre i fondamenti, dal pre-processing delle immagini al deep learning. Inizierai con il miglioramento e il ripristino delle immagini e passerai alle immagini biomediche per analizzare tipologie più complesse, come risonanze magnetiche e radiografie. Il percorso si conclude con un corso sulle reti neurali convoluzionali, dove imparerai a costruire potenti classificatori di immagini basati su deep learning.
Per risorse tecniche, prendi in considerazione quanto segue:
Conclusione
Speriamo ti sia piaciuta questa introduzione accessibile alla computer vision. È un campo in pieno fermento, con nuove applicazioni che arrivano sul mercato ogni giorno. Se vuoi diventare uno specialista di computer vision, il Percorso di Competenze: Image Processing in Python è il punto di partenza ideale.







Le immagini sono ovunque. Viviamo in un’epoca in cui immagini e video racchiudono molte informazioni, a volte difficili da ottenere. Per questo l’analisi delle immagini, nota anche come computer vision, è diventata una competenza di grande valore, applicabile in molti casi d’uso.
Questa guida introduce l’affascinante campo della computer vision. Spiega i fondamenti di questa disciplina scientifica, le sue principali applicazioni e come il machine learning e il deep learning stiano rivoluzionando la computer vision, aprendo la strada a nuove, straordinarie possibilità.
Cos’è la Computer Vision?
In parole semplici, la computer vision è un ramo dell’IA che studia come i computer possano vedere e comprendere il contenuto di immagini e video digitali.
L’obiettivo finale della computer vision è replicare nelle macchine le capacità della visione umana. Tuttavia, mentre gli esseri umani usano retine, nervi ottici e aree dedicate del cervello per raccogliere ed elaborare le informazioni visive, questo processo nelle macchine è del tutto diverso. Per insegnare alle macchine a vedere, facciamo invece affidamento su una varietà di componenti tecnologici, tra cui:
Applicazioni della Computer Vision
La vista è un senso chiave che molti di noi usano per una varietà di attività quotidiane. In quest’ottica, non dovrebbe sorprenderci la moltitudine di applicazioni reali della computer vision disponibili oggi.
Di seguito trovi un elenco non esaustivo delle applicazioni più rilevanti della computer vision.
Rilevamento di oggetti
Molte applicazioni popolari di computer vision riguardano il riconoscimento di elementi nelle immagini. Un ottimo esempio sono le auto a guida autonoma. I produttori utilizzano più telecamere per acquisire immagini dell’ambiente affinché le auto possano rilevare oggetti, segnaletica orizzontale e cartelli stradali per guidare in sicurezza. Come funziona in pratica l’object detection? Ti consigliamo di leggere il nostro tutorial sul Rilevamento di Oggetti con YOLO.
Riconoscimento facciale
Usato per sicurezza e sorveglianza, il riconoscimento facciale analizza caratteristiche chiave per identificare le persone. Ciò avviene addestrando reti neurali su vasti database biometrici che consentono ai modelli di individuare tratti facciali unici negli esseri umani. Leggi il nostro tutorial dedicato per scoprire come eseguire la Rilevazione del Volto con Python.
Traduzione automatica
Strumenti come Google Translate permettono di puntare la fotocamera dello smartphone su un cartello in un’altra lingua e ottenere quasi immediatamente la traduzione del cartello nella lingua preferita.
Generazione di immagini
Le applicazioni di computer vision non solo comprendono le immagini, ma oggi sono anche in grado di crearne di realistiche usando l’IA generativa. È il caso di DALL-E, un modello genAI che crea immagini a partire da descrizioni testuali, o Sora, che fa lo stesso ma con i video. Un altro esempio sono i deepfake. Un deepfake è un software usato per rappresentare persone in video falsi nei quali non sono mai apparse. Comprendendo la struttura di un volto umano, i deepfake possono generare nuovi volti.
Curioso di altre applicazioni della computer vision? Dai un’occhiata al nostro articolo dedicato per scoprire 19 progetti di Computer Vision, dal livello principiante all’avanzato.
Computer Vision nell’IA
Le applicazioni uniche di computer vision di cui disponiamo oggi non sarebbero possibili senza l’IA, in particolare i modelli di deep learning. Per capire il perché, dobbiamo prima comprendere cos’è un’immagine digitale, l’unità di informazione più basilare nella computer vision.
Un’immagine digitale è composta da centinaia, se non migliaia, di pixel che contengono informazioni su colore e intensità. Nelle immagini in scala di grigi, l’intensità di ciascun pixel può essere rappresentata da un numero tra 0 e 255.
Immagini in scala di grigi. Fonte: DataCamp
Le immagini a colori, invece, sono generalmente memorizzate nel sistema RGB. RGB sta per Red, Green e Blue. Possiamo pensare a ogni immagine come rappresentata da tre raster, uno per ciascun canale colore. Questo significa che serve una quantità di dati tripla per archiviare un’immagine a colori rispetto a una in scala di grigi.
Immagini a colori. Fonte: DataCamp
Dunque, le immagini digitali possono essere viste come un insieme di numeri. Fino a non molto tempo fa, ci mancavano gli strumenti potenti necessari per elaborare ed estrarre informazioni dalle immagini. Questo è cambiato all’inizio degli anni 2010, quando i ricercatori di deep learning sono riusciti a sviluppare nuove reti neurali particolarmente adatte ai compiti di computer vision.
Oggi, grazie ai progressi del deep learning e allo sviluppo di GPU, cloud computing e all’ampia disponibilità di dati d’immagine, i professionisti dei dati possono addestrare potenti reti neurali capaci di affrontare compiti complessi nella computer vision.
Sull’onda dell’IA generativa, i più avanzati vision language model (VLM) sanno comprendere ed elaborare sia dati visivi che testuali, abilitando nuovi compiti come la didascalizzazione delle immagini, il visual question answering e la generazione testo-immagine.
Ti incuriosiscono le reti neurali? Dai un’occhiata al nostro corso introduttivo al Deep Learning con Python per iniziare oggi stesso.
Rete neurale per la computer vision. Fonte: NVIDIA
Differenza tra Machine Vision e Computer Vision
Un’idea sbagliata comune tra chi è alle prime armi riguarda la differenza tra machine vision e computer vision.
Per machine vision si intende l’uso di telecamere, sensori e algoritmi per aiutare computer e robot ad analizzare le immagini e prendere decisioni informate durante i processi di produzione. Le applicazioni della machine vision comprendono attività come ispezione automatica, controllo qualità e guida dei robot.
Il termine è spesso usato in contesti manifatturieri e industriali, quindi il suo ambito è specifico per l’applicazione e più ristretto rispetto alla computer vision, che ha un raggio d’azione più ampio in vari settori. Allo stesso modo, in termini di complessità, la computer vision prevede spesso elaborazioni e interpretazioni più complesse rispetto alla machine vision.
Puoi vedere le differenze tra machine vision e computer vision nella tabella qui sotto:
Aspetto
Machine Vision
Computer Vision
Definizione
Uso di telecamere, sensori e algoritmi per analizzare immagini e prendere decisioni, spesso in contesti industriali.
Un campo dell’IA focalizzato nel permettere ai computer di interpretare e comprendere immagini e video digitali.
Casi d’uso principali
Controllo qualità, rilevamento difetti, monitoraggio delle linee di assemblaggio e guida dei robot.
Rilevamento di oggetti, riconoscimento facciale, generazione di immagini, veicoli autonomi e imaging medico.
Complessità
Generalmente più semplice e specifica per il compito.
Coinvolge elaborazioni complesse, spesso usando modelli di IA e deep learning.
Ambito
Ristretto, specifico per l’applicazione (principalmente produzione e automazione industriale).
Ampio, comprende più settori come sanità, retail, automotive ed entertainment.
Focus tecnologico
Telecamere, illuminazione e hardware per la cattura e l’analisi di immagini in ambienti controllati.
Algoritmi, reti neurali e grandi dataset per una comprensione avanzata delle immagini.
Esempi
Ispezione automatizzata di schede elettroniche, guida di bracci robotici in fabbrica.
Addestramento di auto a guida autonoma, creazione di deepfake o identificazione di malattie in esami diagnostici.
Primi passi con la Computer Vision
La computer vision è una delle discipline più interessanti e richieste nell’IA. Se vuoi iniziare in questo campo, DataCamp è qui per aiutarti. Lavoriamo per offrire ai professionisti dei dati corsi e materiali dedicati di valore e sempre aggiornati.
Ti consigliamo di iniziare con il nostro Percorso di Competenze: Image Processing in Python. Questo percorso copre i fondamenti, dal pre-processing delle immagini al deep learning. Inizierai con il miglioramento e il ripristino delle immagini e passerai alle immagini biomediche per analizzare tipologie più complesse, come risonanze magnetiche e radiografie. Il percorso si conclude con un corso sulle reti neurali convoluzionali, dove imparerai a costruire potenti classificatori di immagini basati su deep learning.
Per risorse tecniche, prendi in considerazione quanto segue:
Conclusione
Speriamo ti sia piaciuta questa introduzione accessibile alla computer vision. È un campo in pieno fermento, con nuove applicazioni che arrivano sul mercato ogni giorno. Se vuoi diventare uno specialista di computer vision, il Percorso di Competenze: Image Processing in Python è il punto di partenza ideale.