{count, plural, one {Corso} other {Corsi}}
Elaborazione di immagini in Python
{hours} ore
57K
Al cuore dei vision language models c’è l’integrazione tra computer vision e natural language processing.
La computer vision si concentra nel permettere alle macchine di interpretare e analizzare dati visivi, come immagini e video, riconoscendo oggetti, pattern e altri elementi visivi.
Il natural language processing, invece, riguarda la comprensione e la generazione del linguaggio umano, consentendo alle macchine di comprendere, analizzare e produrre testo.
I VLM colmano il divario tra questi due campi creando modelli in grado di elaborare e comprendere simultaneamente input visivi e testuali. Ciò è possibile grazie ad avanzate architetture di deep learning, in particolare i transformer, fondamentali per il successo dei large language model come GPT-4o, Llama, Gemini e Gemma.
Queste architetture basate su transformer sono state adattate per gestire input multimodali, consentendo ai VLM di cogliere le complesse relazioni tra dati visivi e linguistici.
Il modello transformer, introdotto inizialmente per compiti di NLP, è diventato l’ossatura di molti sistemi di IA avanzati grazie alla sua capacità di gestire dipendenze a lungo raggio e di catturare relazioni contestuali nei dati.
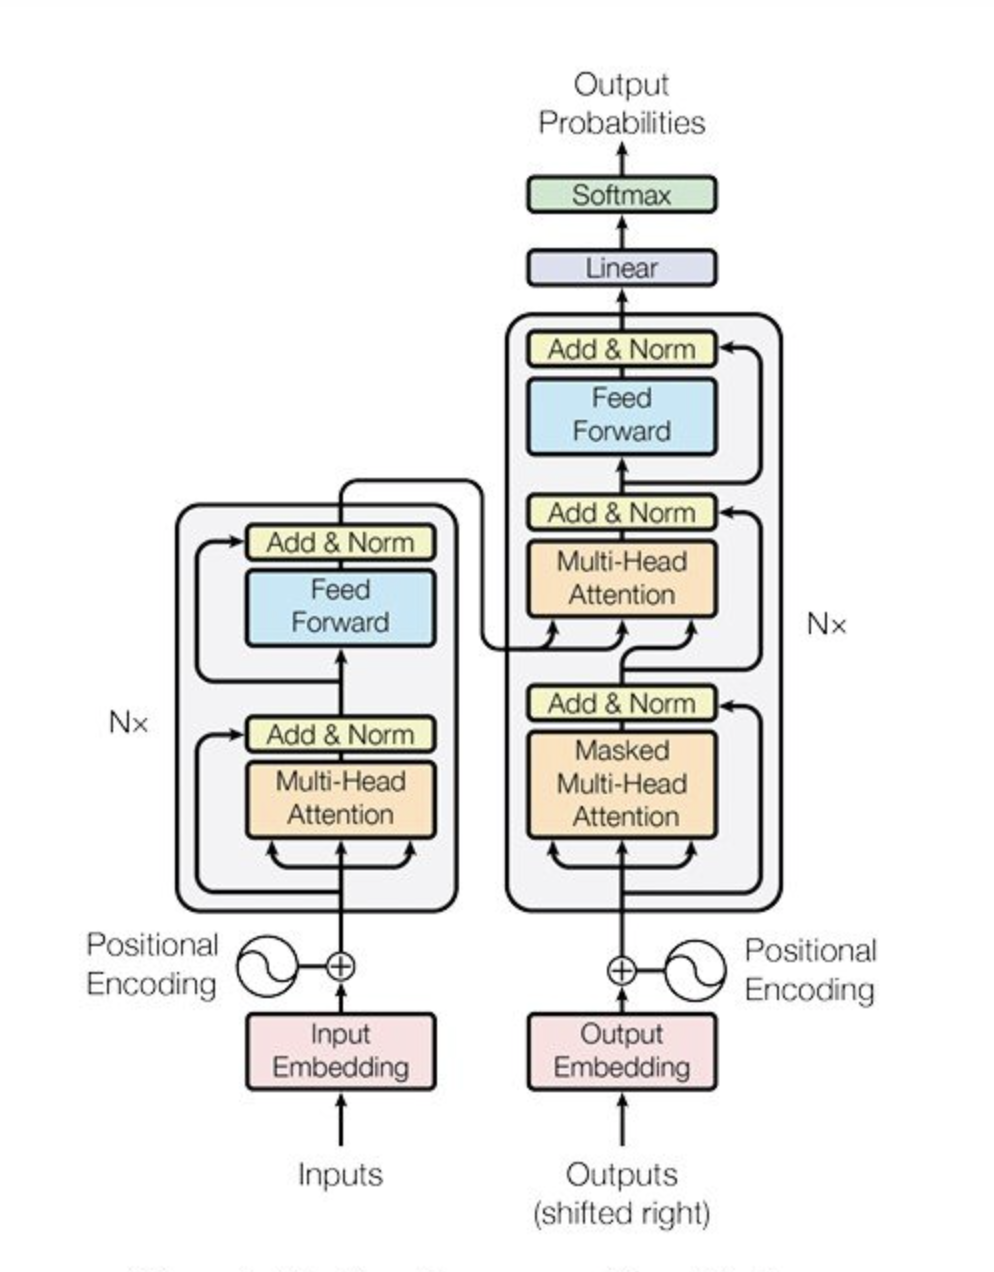
Fonte: Vaswani et al., 2017
Nel contesto dei VLM, i transformer sono stati adattati per elaborare sia immagini che testo, consentendo un’integrazione fluida di queste due modalità.
Un’architettura VLM tipica prevede due componenti principali: un image encoder e un text decoder:
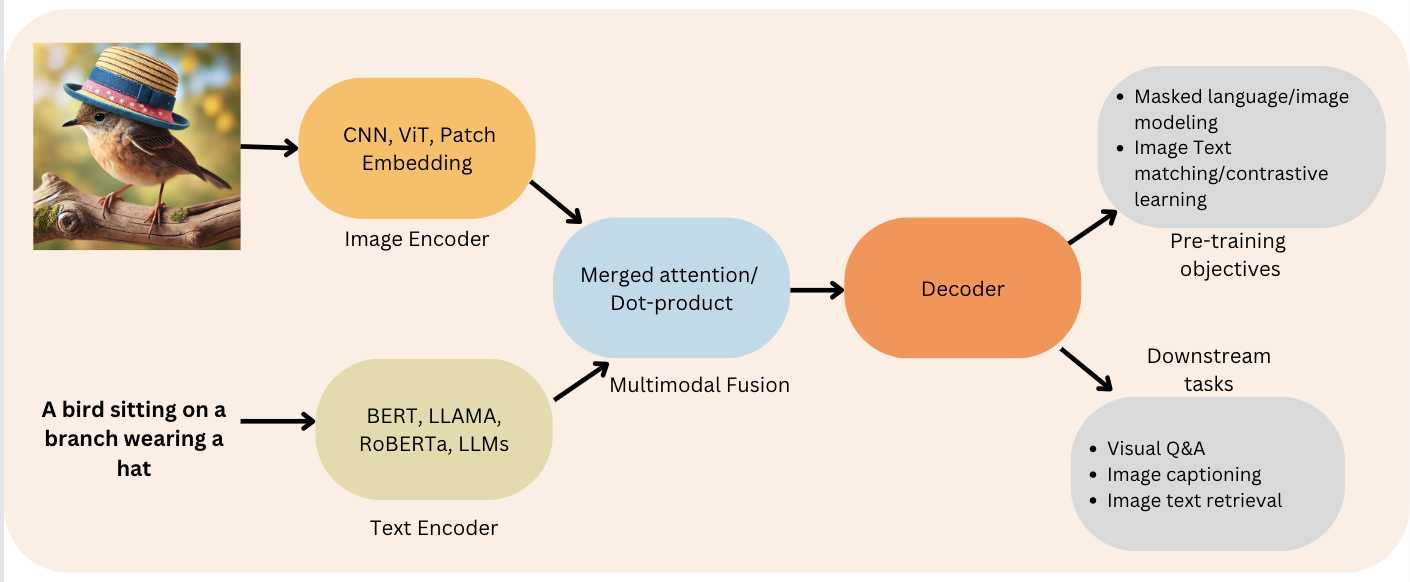
Figura 2: Funzione Encoder-Decoder (Fonte: Viso.ai)
Combinando queste due parti, i VLM possono fare cose straordinarie come descrivere le immagini in dettaglio, rispondere a domande su ciò che vedono e persino generare nuove immagini a partire da descrizioni testuali! Il processo seguito dai VLM prevede i passaggi seguenti:
La maggior parte dei VLM utilizza un Vision Transformer (ViT) come image encoder, pre-addestrato su dataset di immagini su larga scala per catturare efficacemente le caratteristiche visive necessarie ai compiti multimodali.
Il text decoder si basa sul language model, messo a punto (fine-tuning) per gestire le complessità della generazione linguistica nel contesto dei dati visivi. Questa combinazione di capacità avanzate di elaborazione visiva e linguistica rende il VLM estremamente versatile e potente.
Una delle sfide più significative nello sviluppo dei VLM è la necessità di dataset ampi e diversificati che contengano sia informazioni visive che testuali. Questi dataset sono essenziali per addestrare i modelli a comprendere e generare contenuti multimodali.
Il processo di addestramento di un VLM prevede l’alimentazione del modello con coppie di immagini e relative descrizioni testuali, consentendogli di apprendere le relazioni complesse tra elementi visivi ed espressioni linguistiche.
Per gestire questi dati, i VLM utilizzano spesso livelli di embedding che trasformano input visivi e testuali in uno spazio ad alta dimensionalità dove possono essere confrontati e combinati.
Questo processo di embedding consente al modello di comprendere le connessioni tra le due modalità e di generare output coerenti e contestualmente pertinenti.
Il panorama dei vision language models (VLM) è vasto, con numerosi modelli open source disponibili sull’Hugging Face Hub. Questi modelli variano per dimensioni, capacità e licenze, offrendo un ventaglio di opzioni adatte a diverse applicazioni. Di seguito una panoramica di alcuni dei VLM open source più importanti, con le loro caratteristiche chiave:
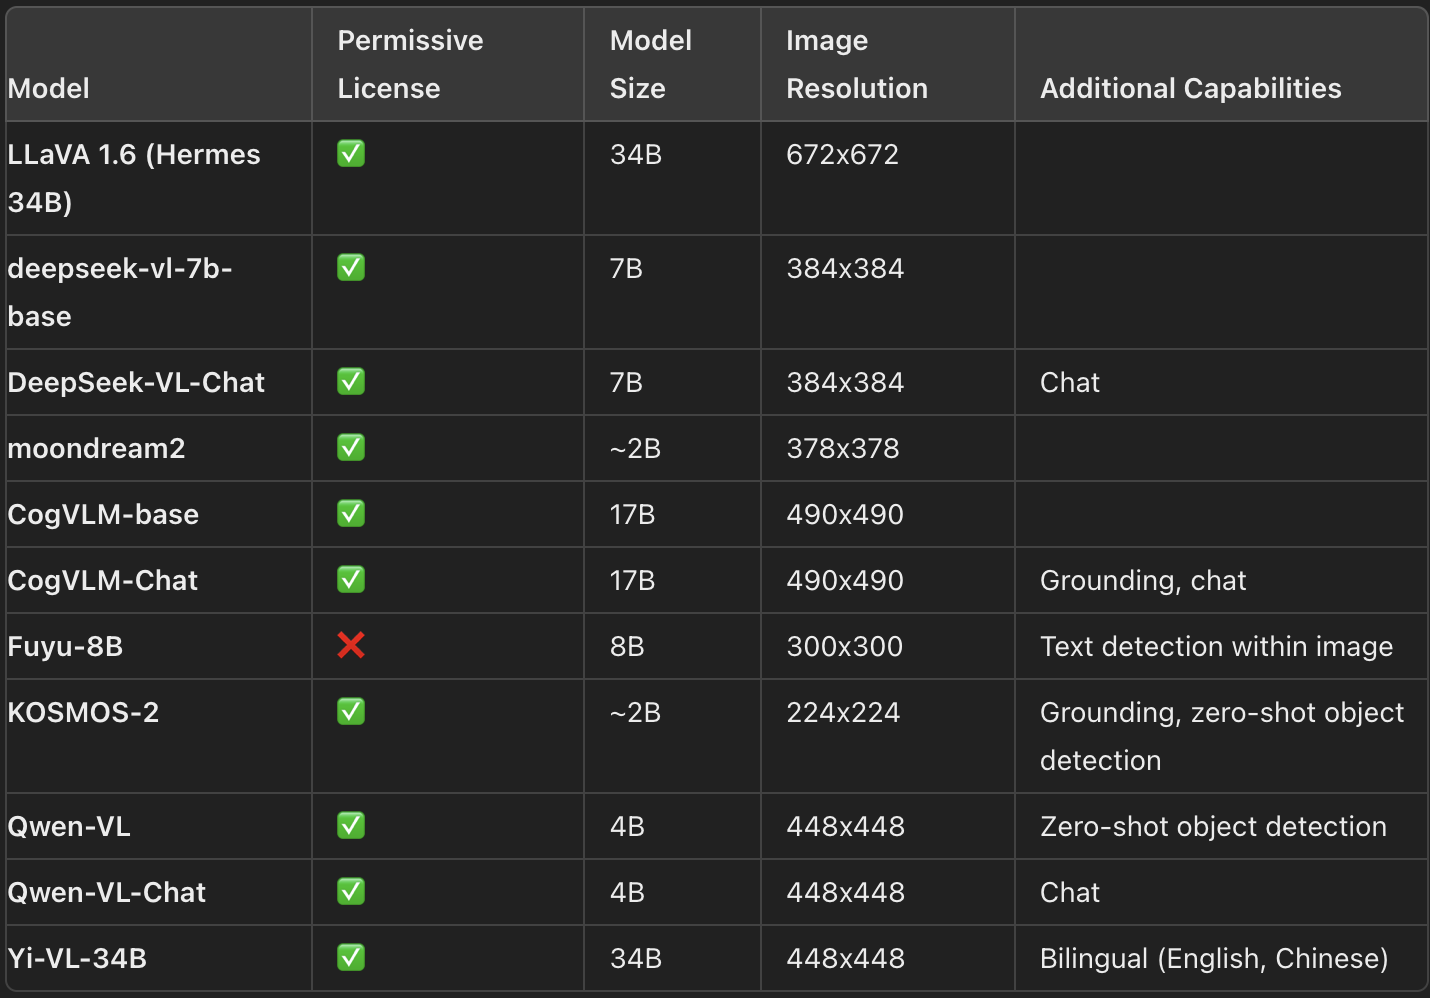
VLM più recenti e loro caratteristiche principali (Fonte: HuggingFace)
Selezionare il VLM più adatto al tuo caso d’uso può essere complesso, dato l’ampio ventaglio di opzioni. Diversi strumenti e risorse possono aiutarti in questa scelta:
Sebbene sia Vision Arena sia l’Open VLM Leaderboard offrano spunti preziosi, sono limitati ai modelli inviati e richiedono aggiornamenti regolari per includere i nuovi modelli.
Esistono diversi benchmark comunemente usati per valutare le prestazioni dei VLM:
Il pretraining dei VLM consiste nell’unificare le rappresentazioni di immagini e testo per alimentarle in un text decoder per la generazione. La struttura include tipicamente un image encoder, un embedding projector per allineare le rappresentazioni di immagini e testo, e un text decoder. Tuttavia, modelli diversi impiegano strategie di pretraining differenti.
In molti casi, il pretraining di un VLM non è nemmeno necessario se puoi fare fine-tuning di modelli esistenti per il tuo caso d’uso specifico. Strumenti come Transformers e SFTTrainer semplificano il processo di messa a punto dei modelli per compiti specifici, rendendolo accessibile anche a chi ha risorse limitate.
Ecco un’implementazione HuggingFace per usare il VLM open source LlavaNext gratuitamente su Colab o in locale con la libreria Transformers di HuggingFace.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)Le capacità dei vision language models vanno ben oltre la generazione di didascalie. I VLM hanno aperto la strada a molte applicazioni che sfruttano la loro abilità di colmare il divario tra informazioni visive e testuali. Esploriamo alcune delle applicazioni più d’impatto in vari settori.
Il visual question answering (VQA) è un compito che prevede di rispondere a domande sul contenuto di un’immagine.
Questa applicazione richiede che il modello comprenda sia gli elementi visivi nell’immagine sia il contesto linguistico della domanda. Ad esempio, data un’immagine di un vivace paesaggio urbano, un VLM può rispondere a domande come "Di che colore è l’edificio più alto?" oppure "Quante persone sono visibili nell’immagine?"
Il VQA ha numerose applicazioni pratiche, soprattutto nei settori in cui i dati visivi giocano un ruolo critico. In sanità, ad esempio, il VQA può essere usato per analizzare immagini mediche e fornire risposte a domande utili per diagnosi e pianificazione terapeutica. Nel retail, il VQA può migliorare l’esperienza d’acquisto consentendo ai clienti di interagire con le immagini dei prodotti in modo più naturale e intuitivo.
Una delle capacità più entusiasmanti dei VLM è la generazione di immagini da testo. Questo compito consiste nel generare una rappresentazione visiva di una scena o di un oggetto a partire da una descrizione testuale. Ad esempio, un VLM può prendere un prompt come "Un tramonto sereno su una catena montuosa con un fiume che scorre nella valle" e generare l’immagine corrispondente.
La generazione di immagini da testo ha un enorme potenziale in ambiti creativi come design e pubblicità. Designer e pubblicitari possono usare questa tecnologia per generare rapidamente idee visive a partire da prompt testuali. Può velocizzare la creazione di contenuti visivi in linea con messaggi di marketing specifici.
L’image retrieval è il processo di trovare immagini pertinenti in base a una query testuale. I VLM eccellono in questo compito grazie alla loro capacità di comprendere sia il contenuto visivo delle immagini sia il contesto linguistico della query.
Questa capacità rende i motori di ricerca più potenti e precisi, permettendo agli utenti di trovare con maggiore facilità esattamente le immagini che cercano.
L’image retrieval trova applicazione in vari domini, dall’e-commerce all’analisi di immagini mediche. Nell’e-commerce, può aiutare i clienti a trovare prodotti che corrispondono alle loro preferenze sulla base di descrizioni visive e testuali. In sanità, può supportare i professionisti nel reperire immagini mediche pertinenti per ricerca o diagnosi.
Sebbene gli esempi sopra si concentrino sulle immagini, i VLM possono essere estesi anche alla comprensione e alla generazione di didascalie per i video. La comprensione dei video implica analizzare il contenuto visivo di un video e generare testo descrittivo che ne colga l’essenza delle scene rappresentate.
La comprensione dei video ha applicazioni nella ricerca di video, nel riassunto e nella moderazione dei contenuti. Nella ricerca, i VLM possono aiutare gli utenti a trovare clip specifiche in base a query testuali. Nei compiti di sintesi, possono generare riassunti concisi di video lunghi, facilitando una rapida comprensione dei contenuti. Nella moderazione, possono contribuire a identificare contenuti inappropriati o dannosi nei video, garantendo ambienti sicuri e a misura di utente.
Consideriamo ora le sfide associate ai VLM, oltre agli aspetti etici.
Addestrare e distribuire VLM richiede risorse computazionali significative, in particolare per modelli di grandi dimensioni come PaliGemma. Ciò può costituire una barriera per le organizzazioni con accesso limitato a infrastrutture di calcolo ad alte prestazioni.
Per affrontare questa sfida, i ricercatori stanno esplorando modi per rendere i VLM più efficienti, ad esempio tramite tecniche di compressione dei modelli, ottimizzazione dell’architettura e uso di acceleratori hardware come GPU e TPU.
Lo sviluppo dei VLM solleva diverse preoccupazioni etiche, in particolare riguardo al potenziale di bias negli output dei modelli. I VLM addestrati su grandi quantità di dati immagine-testo del mondo reale possono riflettere bias socio-culturali presenti nel materiale di training. Questi bias possono manifestarsi negli output del modello, generando contenuti dannosi o offensivi.
Per affrontare queste criticità, i ricercatori stanno implementando varie tecniche di mitigazione dei bias, come l’utilizzo di dataset di training bilanciati, l’adozione di algoritmi attenti all’equità e valutazioni rigorose degli output del modello per identificare e correggere potenziali bias.
Inoltre, organizzazioni come Google stanno implementando filtri di sicurezza dei contenuti per garantire che i dati di training usati per modelli come PaliGemma siano puliti e privi di contenuti dannosi.
Un’altra considerazione importante nello sviluppo dei VLM riguarda privacy e sicurezza dei dati. I VLM richiedono spesso l’accesso a grandi quantità di dati, inclusi potenzialmente informazioni sensibili. Garantire che questi dati siano gestiti in modo sicuro e conforme alle normative sulla privacy è fondamentale per mantenere la fiducia di utenti e stakeholder.
Per affrontare le preoccupazioni sulla privacy, i ricercatori stanno esplorando tecniche come il federated learning, che consente di addestrare i modelli su dati decentralizzati senza trasferire informazioni sensibili su un server centrale.
Inoltre, organizzazioni come Google stanno attuando misure di responsabilità sui dati, come il filtraggio di informazioni personali e dati sensibili dai dataset di training, per proteggere la privacy degli individui.
I vision language models rappresentano un passo avanti significativo nell’intelligenza artificiale, offrendo il potenziale per migliorare varie applicazioni grazie alla capacità di elaborare dati sia visivi che testuali.
Con l’avanzare della ricerca in questo campo, possiamo aspettarci lo sviluppo di VLM sempre più sofisticati, in grado di svolgere compiti complessi e fornire insight di valore.
L’integrazione tra comprensione visiva e testuale apre nuove possibilità di innovazione, rendendo i VLM un ambito promettente di ricerca e sviluppo.
Impara l’IA con questi corsi!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



