
Cursus
Prompt Engineering begrijpen
1 uur
236.8K
Stel je een briljante vriend voor die ongelooflijk goed is in het oplossen van complexe problemen. Maar elke keer dat je deze vriend een nieuwe vraag stelt, moet het proces helemaal opnieuw beginnen en is alles wat bij eerdere problemen is geleerd volledig vergeten.
Best frustrerend, toch? Precies dat is de uitdaging bij grote taalmodellen (LLM’s) als het gaat om complexe redeneertaken. LLM’s blinken uit in het genereren van tekst, maar hebben vaak moeite met complexe redeneringen omdat ze kennis uit eerdere interacties niet kunnen vasthouden.
Stel je nu voor dat je deze LLM’s een "mentaal notitieboek" geeft om waardevolle inzichten op te slaan en opnieuw te gebruiken – dat is de kern van het Buffer of Thoughts (BoT)-raamwerk.
In deze tutorial verkennen we Buffer of Thoughts (BoT), een nieuw raamwerk dat verandert hoe LLM’s complexe problemen oplossen. Ik begin met de basisideeën achter BoT, waaronder de meta-buffer en de buffermanager. Daarna bekijken we hoe BoT stap voor stap werkt, van het begrijpen van het probleem tot het vinden en gebruiken van de juiste denk-sjablonen—je ziet hoe BoT LLM’s nauwkeuriger, efficiënter en betrouwbaarder maakt.
Ik deel ook enkele indrukwekkende experimentele resultaten uit dit paper die laten zien hoe goed BoT presteert op verschillende taken. Aan het eind van deze tutorial snap je waarom BoT op dit moment zo’n grote rol speelt en hoe het in realistische toepassingen kan worden ingezet.
Buffer of Thoughts (BoT) is een nieuw raamwerk dat is ontworpen om de redeneervermogens van LLM’s te verbeteren.
BoT combineert twee hoofdelementen om LLM’s te begeleiden bij complexe redeneertaken:
Laten we deze twee componenten in meer detail bekijken.
De meta-buffer is als een bibliotheek met universele probleemoplossingsstrategieën. Het slaat "denk-sjablonen" op: hoog-niveau benaderingen om problemen op te lossen. Deze sjablonen komen uit verschillende taken die de LLM is tegengekomen.
Zie het als een gereedschapskist vol veelzijdige tools die je op veel verschillende klussen kunt toepassen.
De buffermanager is de dynamische organisator van het BoT-systeem. De rol omvat het bijwerken van de meta-buffer met nieuwe denk-sjablonen naarmate meer taken worden opgelost, het selecteren van de meest relevante denk-sjablonen voor elk nieuw probleem en het verfijnen van bestaande sjablonen op basis van hun effectiviteit.
Het is alsof je een persoonlijke assistent hebt die je aantekeningen voortdurend ordent, de nuttigste informatie markeert en je helpt die toe te passen op nieuwe uitdagingen.
De echte magie gebeurt via thought-augmented reasoning. Bij een nieuw probleem doet het BoT-raamwerk het volgende:
1. Analyseert het probleem om de kernelementen te begrijpen.
2. Haalt relevante denk-sjablonen op uit de meta-buffer.
3. Past deze sjablonen aan om een specifieke redeneerstructuur voor het probleem te maken.
4. Begeleidt de LLM door het probleemoplossingsproces met behulp van deze structuur.
Stel dat je een chef-kok bent. De meta-buffer is je persoonlijke kookboek. Dat kookboek bevat niet alleen specifieke recepten, maar ook allerlei kooktechnieken. Zo zijn er secties over hoe je groenten goed sautéert, de perfecte reductiesaus maakt of smaken in balans brengt. Deze hoog-niveau strategieën kun je toepassen op een breed scala aan gerechten.
Stel je nu voor dat je ook een sous-chef hebt die extreem georganiseerd en deskundig is. Deze sous-chef is je buffermanager. Die helpt door te bepalen welke technieken uit je kookboek het best passen bij het gerecht dat je nu bereidt. Terwijl je kookt, maakt de sous-chef aantekeningen over wat goed werkte en wat niet, en past je technieken en strategieën daarop aan.
Als er een nieuwe bestelling binnenkomt, begin je niet from scratch. Je raadpleegt je kookboek (meta-buffer) voor de beste technieken en vertrouwt op je sous-chef (buffermanager) om je efficiënt door het proces te leiden. De sous-chef onthoudt wat in het verleden het beste werkte voor vergelijkbare gerechten en helpt je je aanpak bij te stellen, zodat de maaltijd snel en op hoog niveau wordt bereid.
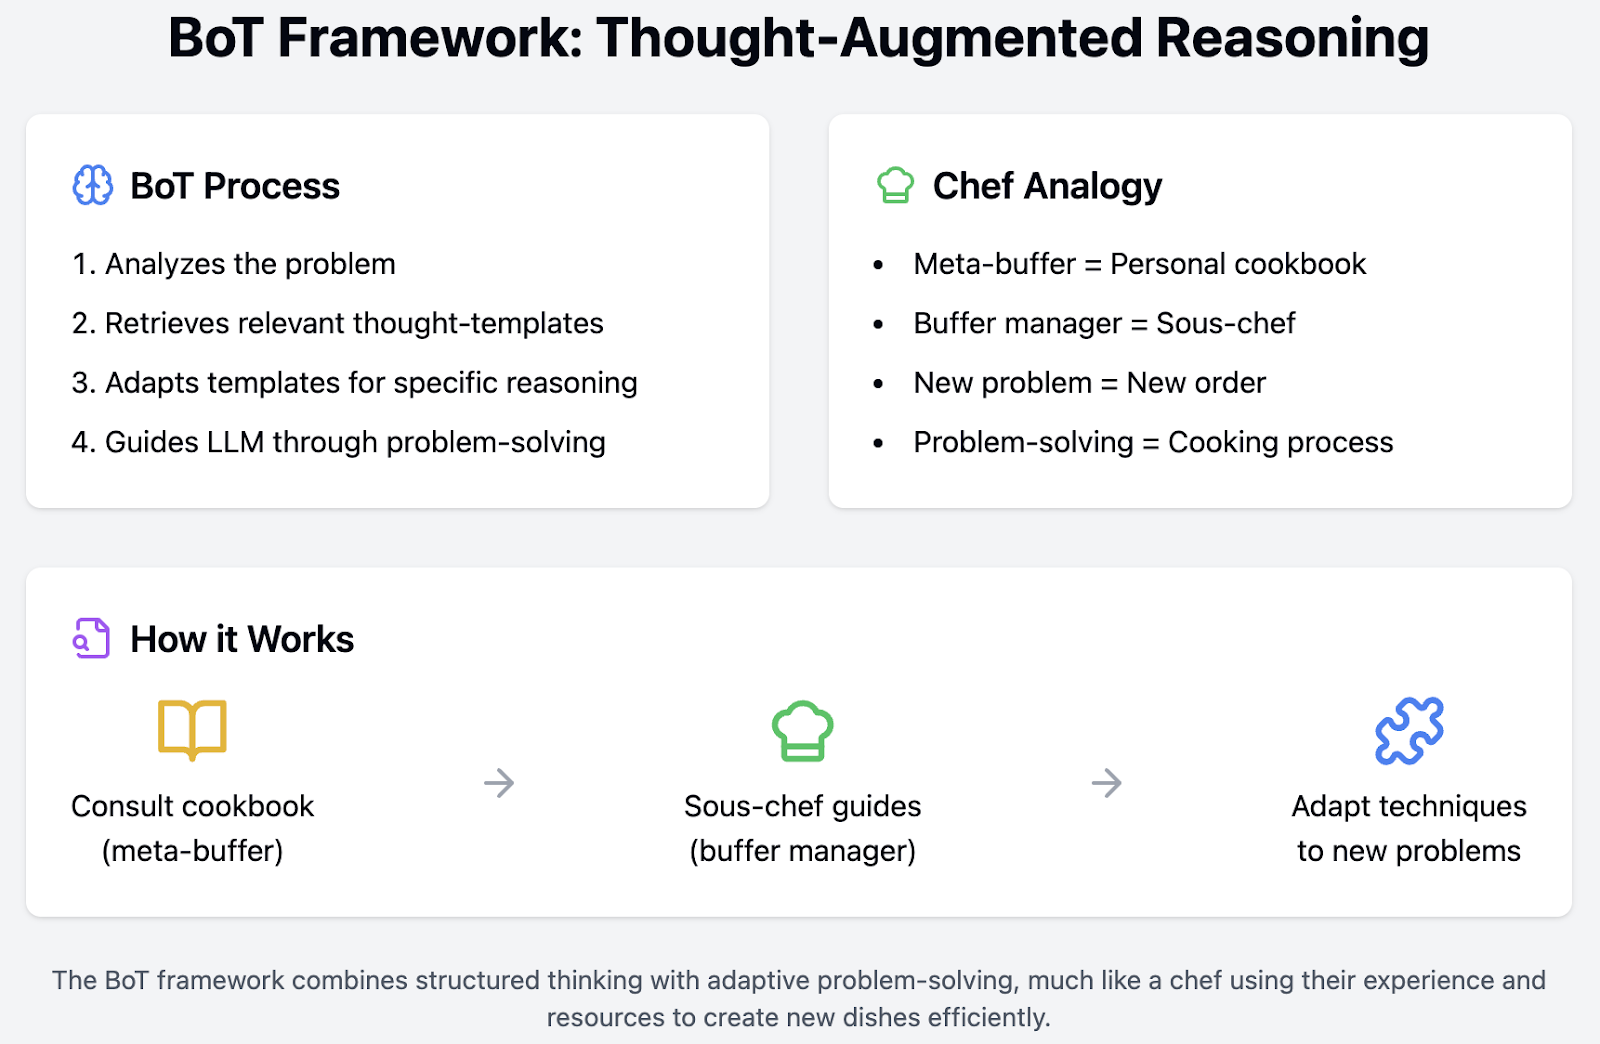
Zo zou het proces in je keuken werken:
Nu we begrijpen wat BoT is en wat de belangrijkste onderdelen zijn, kunnen we kijken hoe het achter de schermen werkt. We delen het op in vier elementen:
De probleemdistilleerder werkt als een vaardige vertaler die complexe problemen omzet in een taal die BoT gemakkelijk kan begrijpen en verwerken.
Zie het als een nauwgezette lezer die cruciale informatie en randvoorwaarden uit het invoerprobleem haalt, vergelijkbaar met het markeren van de belangrijkste passages in een hoofdstuk van een studieboek.
Zodra de probleemdistilleerder deze kernelementen heeft geïdentificeerd, ordent hij ze in hoog-niveau concepten en structuren. Dit kun je vergelijken met het maken van een bondige samenvatting van een lang artikel, met focus op de hoofdgedachten en zonder overbodige details.
Stel bijvoorbeeld dat je een complex probleem over dienstregelingen van treinen krijgt. De probleemdistilleerder zou essentiële elementen zorgvuldig extraheren, zoals "treinsnelheden", "vertrektijden" en "afstand tussen stations". Vervolgens organiseert hij deze elementen in een gestructureerd formaat dat BoT makkelijk kan verwerken en begrijpen.
De meta-buffer is BoT’s kennisbank, waarin denk-sjablonen worden opgeslagen en georganiseerd voor snelle toegang. Hij bevat denk-sjablonen en hun beschrijvingen, gecategoriseerd voor efficiënte opvraging.
Het is als een goed georganiseerde bibliotheek waarin elk boek (denk-sjabloon) een gedetailleerde beschrijving heeft en op de juiste plek staat.
Wanneer BoT een denk-sjabloon moet ophalen, vindt het de meest relevante door het gedestilleerde probleem te vergelijken met de sjabloonbeschrijvingen. Dit lijkt op een bibliothecaris die snel het perfecte boek vindt op basis van jouw beschrijving van wat je nodig hebt.
BoT kan ook herkennen wanneer een taak helemaal nieuw is en een nieuw denk-sjabloon vereist. Dat is alsof je beseft dat je een nieuwe categorie in je persoonlijke bibliotheek moet maken voor een uniek soort boek.
In ons treinvoorbeeld zou BoT verschillende denk-sjablonen in de meta-buffer hebben, elk met een gedetailleerde beschrijving. Sommige sjablonen kunnen bijvoorbeeld te maken hebben met timemanagement, andere met ruimtelijk redeneren en weer andere met optimalisatiestrategieën.
Wanneer BoT het probleem met de treindienstregeling tegenkomt, haalt het het meest relevante denk-sjabloon op door de gedestilleerde elementen van het probleem, zoals "treinsnelheden", "vertrektijden" en "afstand tussen stations", te vergelijken met de beschrijvingen in de meta-buffer. Zo kan BoT bijvoorbeeld een denk-sjabloon selecteren dat gespecialiseerd is in planning en tijdsoptimalisatie om dit probleem effectief aan te pakken.
Stel dat BoT herkent dat het probleem met de treindienstregeling een uniek element bevat dat het nog niet eerder heeft gezien, zoals een ongewoon type randvoorwaarde of een nieuw optimalisatiedoel. Dan kan het vaststellen dat deze taak volledig nieuw is en een nieuw denk-sjabloon vereist.
Als het probleem bijvoorbeeld het coördineren van dienstregelingen over meerdere vervoersmodaliteiten (treinen, bussen, vluchten) omvat, kan BoT een nieuw denk-sjabloon creëren en opslaan dat multimodale planning adresseert, zodat het in de toekomst beter voorbereid is op vergelijkbare problemen.
Zo stelt de meta-buffer BoT in staat om strategieën voor probleemoplossing efficiënt op te slaan, op te vragen en nieuw te creëren, waardoor het beter met complexe taken kan omgaan.
Hier past BoT de geselecteerde denk-sjablonen toe om het specifieke probleem op te lossen.
Bij bestaande sjablonen wordt het opgehaalde denk-sjabloon aangepast aan het huidige probleem. Dat is vergelijkbaar met het gebruiken van een recept, maar dan met aangepaste ingrediënten en hoeveelheden voor een grotere groep. BoT verfijnt het denk-sjabloon zodat het aansluit op de details van het probleem en zo een gerichte, effectieve oplossing biedt.
Als BoT wordt geconfronteerd met een nieuwe taak waarvoor geen bestaande sjablonen beschikbaar zijn, grijpt het terug op vooraf gedefinieerde, algemene sjablonen. Zie het als het gebruiken van basiskooktechnieken om een gerecht te bereiden dat je nog nooit eerder hebt gemaakt. Door te vertrouwen op fundamentele principes kan BoT onbekende problemen verkennen en waar nodig nieuwe strategieën ontwikkelen.
Voor ons probleem met treindienstregelingen zou BoT een denk-sjabloon ophalen dat focust op tijdsoptimalisatie en planning. Om het te laten passen bij het huidige probleem, zou BoT dit sjabloon aanpassen. Als het oorspronkelijke denk-sjabloon bijvoorbeeld een methode bevat voor het optimaliseren van de dienstregeling van één trein, dan past BoT het aan voor meerdere treinen, variërende snelheden en verschillende vertrektijden. Deze op maat gemaakte aanpak zorgt ervoor dat alle treinen efficiënt en op tijd rijden, rekening houdend met de unieke randvoorwaarden van het probleem.
Maar stel dat BoT nu een nieuw aspect van het treinschema tegenkomt, zoals het integreren van treindienstregelingen met bus- en vluchtschema’s om een naadloos multimodaal vervoerssysteem te creëren. Omdat er geen bestaand denk-sjabloon voor dit specifieke scenario is, gebruikt BoT vooraf gedefinieerde, algemene sjablonen. BoT kan dan fundamentele principes van planning en optimalisatie toepassen, zoals het probleem opdelen in kleinere delen, elke vervoersmodus afzonderlijk analyseren en vervolgens de oplossingen integreren. Via dit proces kan BoT nieuwe strategieën en sjablonen ontwikkelen, waardoor het in de toekomst beter soortgelijke multimodale planningsproblemen aankan.
De buffermanager is de leer- en optimalisatiecomponent van het systeem en verbetert voortdurend de kennisbasis van BoT.
Bij sjabloondistillatie vat de buffermanager het probleemoplossingsproces samen in hoog-niveau gedachten. Dat lijkt op het schrijven van een document met "geleerde lessen" na afronding van een project, waarin je de essentie vastlegt van wat effectief was en waarom.
Voor dynamische updates werkt de buffermanager de meta-buffer bij met nieuwe denk-sjablonen. Hij gebruikt similariteitsdrempels om te bepalen of er nieuwe sjablonen moeten worden toegevoegd of bestaande moeten worden bijgewerkt, zodat de meta-buffer lichtgewicht en efficiënt blijft. Dat lijkt op een chef die zijn receptenboek voortdurend verfijnt: nieuwe technieken toevoegen en bestaande verbeteren, terwijl het boek bondig en praktisch blijft.
Stel dat BoT net een complex probleem met treindienstregelingen heeft opgelost met meerdere treinen, verschillende snelheden en uiteenlopende vertrektijden. Na afronding vat de buffermanager het probleemoplossingsproces samen in hoog-niveau gedachten, met de belangrijkste strategieën die goed werkten, zoals specifieke technieken om overlappende dienstregelingen te optimaliseren of piekuren te verwerken.
Stel nu dat BoT in de toekomst een vergelijkbaar maar iets anders treinplanningsprobleem tegenkomt. De buffermanager werkt de meta-buffer bij met nieuwe denk-sjablonen op basis van deze ervaring. Als het nieuwe probleem bijvoorbeeld de integratie van trein- en busschema’s omvat, kan de buffermanager het bestaande treinschema-sjabloon verfijnen met technieken voor multimodale integratie.
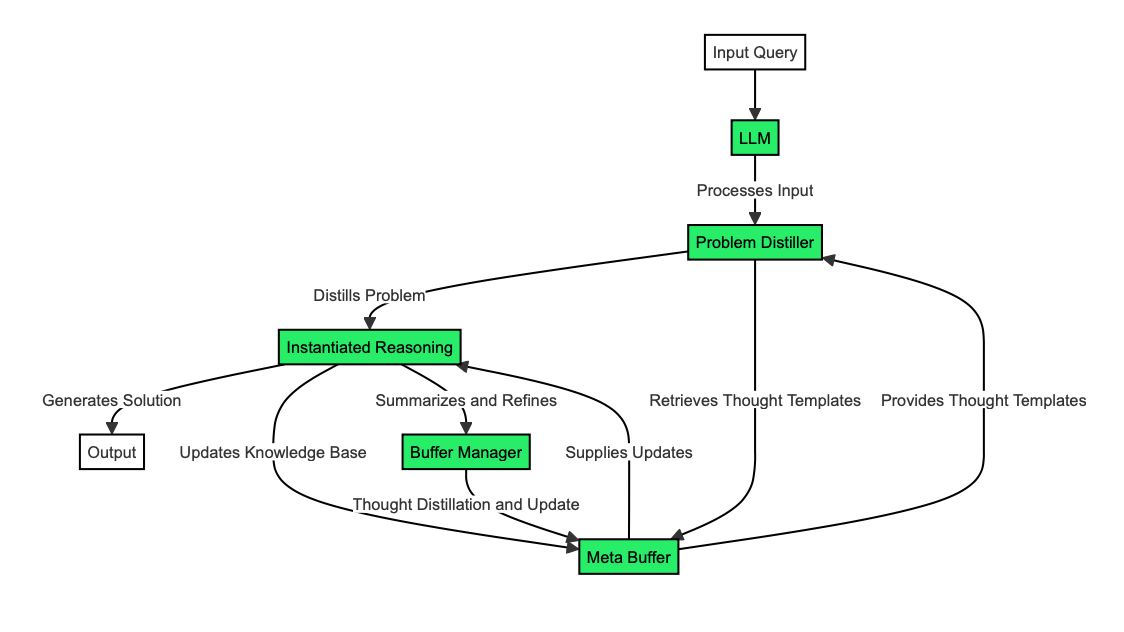
Het Buffer of Thoughts (BoT)-raamwerk biedt verschillende belangrijke voordelen voor het ontwikkelen van LLM-redeneren, zoals betere nauwkeurigheid, redeneerefficiëntie en modelrobuustheid.
BoT verbetert de redeneernauwkeurigheid van LLM’s aanzienlijk dankzij de nieuwe aanpak:
BoT verbetert de efficiëntie van LLM-redeneren drastisch, wat tijd en rekenbronnen bespaart:
BoT verhoogt de robuustheid van LLM’s, waardoor ze betrouwbaarder en consistenter worden over verschillende taken heen:
Het Buffer of Thoughts (BoT)-raamwerk is getest op een breed scala aan taken en leverde indrukwekkende resultaten op. Voor meer details, zie het paper en de GitHub-repository, waar de resultaten uit deze sectie uitgebreider worden gepresenteerd.
BoT is geëvalueerd op 10 veeleisende, redeneerintensieve taken en liet daarmee veelzijdigheid en effectiviteit zien. Deze taken omvatten onder andere:
Deze taken zijn gekozen om uiteenlopende complexe redeneerscenario’s te vertegenwoordigen, van wiskundige probleemoplossing tot strategisch spel en taalmanipulatie.
BoT liet aanzienlijke prestatieverbeteringen zien ten opzichte van eerdere state-of-the-artmethoden:
Wat vooral indrukwekkend is: BoT behaalde deze resultaten terwijl het slechts ongeveer 12% van de rekenkosten van multi-query prompting-methoden nodig had!
Ook bleek dat het implementeren van BoT met kleinere taalmodellen, zoals Llama3-8B, de prestatie van grotere modellen zoals Llama3-70 kan overtreffen. Dit laat zien dat BoT de capaciteiten van compactere en efficiëntere taalmodellen aanzienlijk kan verbeteren.
Deze resultaten tonen aan dat BoT de nauwkeurigheid kan verbeteren terwijl het efficiënt en robuust blijft over verschillende redeneertaken. De consistente uitkomsten benadrukken BoT’s betrouwbare prestatieverbeteringen. Tegelijk is verdere onafhankelijke verificatie en testen op meer diverse taken nodig om BoT’s mogelijkheden en beperkingen volledig te begrijpen.
We hebben vandaag veel besproken, dus laten we afsluiten met een paar kernpunten en een blik op waar BoT naartoe gaat.
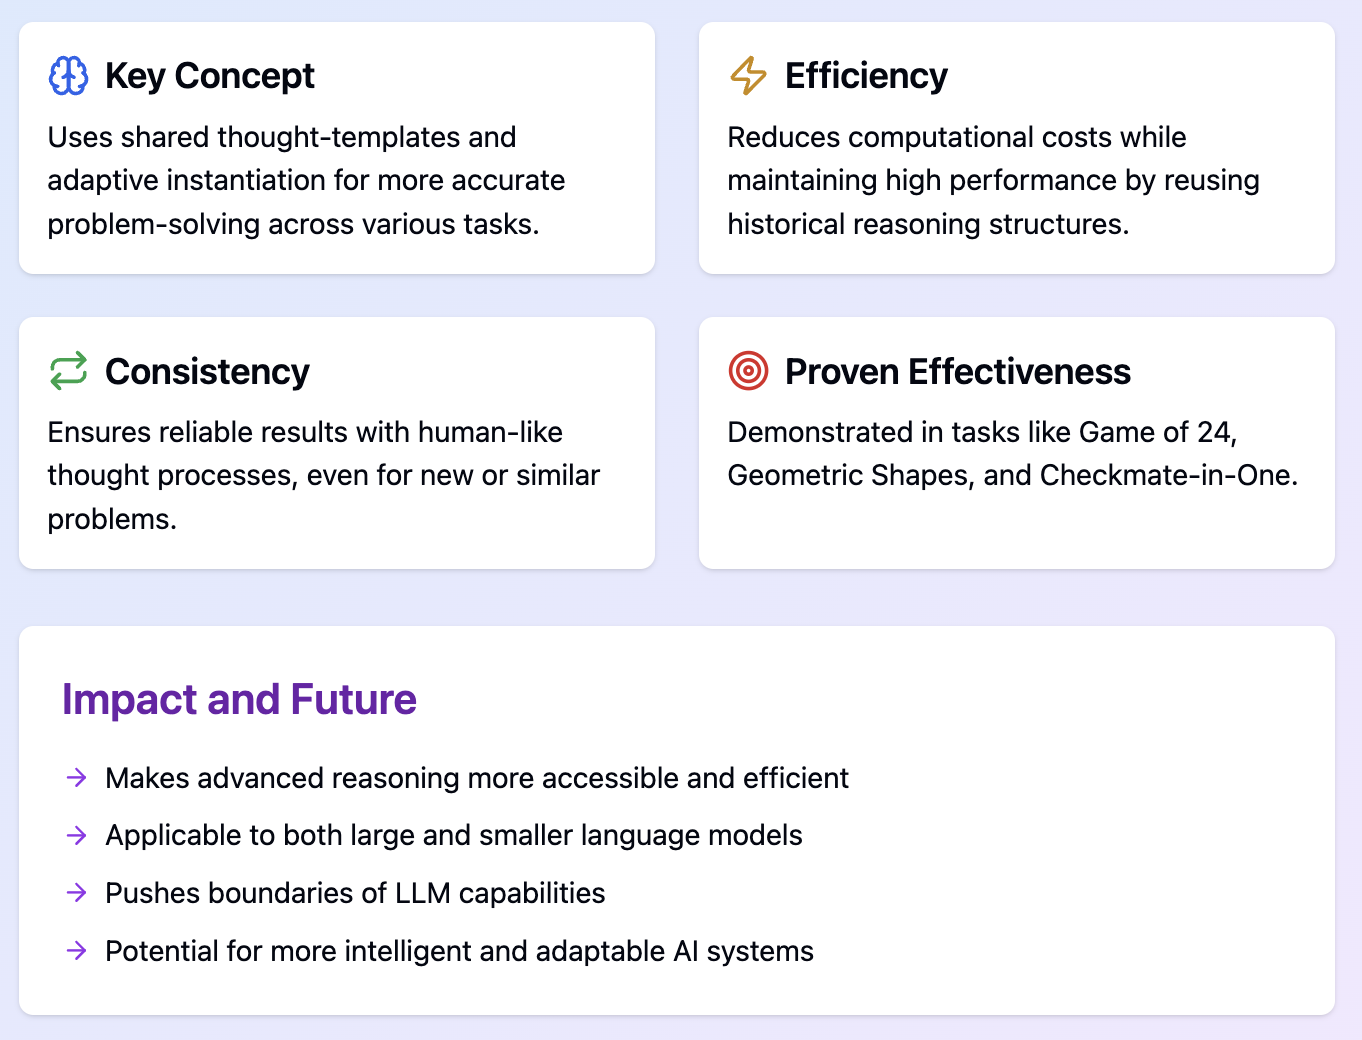
Dit was onze verkenning van Buffer of Thoughts. Ik hoop dat deze tutorial je een helder beeld heeft gegeven van de kernconcepten, werking, voordelen en potentiële impact op AI-redeneren.
Bedankt voor het lezen en tot de volgende keer!
Wil je meer leren over prompt engineering? Dan raad ik deze blogs aan:
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

