Leerpad
AI-basisprincipes
10 uur
In het snel evoluerende veld van large language models (LLM’s) is het cruciaal om op de hoogte te blijven van state-of-the-art benaderingen zoals prompt tuning. Deze techniek, toegepast op al getrainde fundamentele modellen, verbetert de prestaties zonder de hoge rekenkosten die bij traditionele modeltraining horen.
In dit artikel verkennen we de basis van prompt tuning, vergelijken we het met fine-tuning en prompt engineering, en bespreken we de belangrijkste voordelen. We geven ook een praktisch voorbeeld met het platform van Hugging Face, waar we een bloomz-560m-model prompt tunen. Deze gids wil je begrip van prompt tuning verdiepen en je inspireren om het in je projecten te gebruiken.
Prompt tuning is een techniek die is ontworpen om de prestaties van een voorgetraind taalmodel te verbeteren zonder de kernarchitectuur te wijzigen. In plaats van de diepe structurele gewichten van het model aan te passen, past prompt tuning de prompts aan die de respons van het model sturen. Deze methode is gebaseerd op de introductie van "zachte prompts": een set afstembare parameters die aan het begin van de invoersequentie worden ingevoegd.
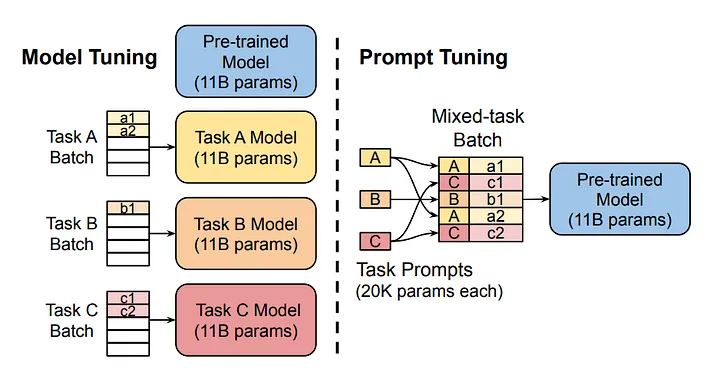
Afbeelding bron
Het diagram vergelijkt de traditionele aanpak van modeltuning met prompt tuning. Merk op dat bij modeltuning elke taak een apart model vereist. Prompt tuning gebruikt daarentegen hetzelfde fundamentele model voor meerdere taken door taakspecifieke prompts aan te passen.
Zachte prompts zijn kunstmatig geconstrueerde tokens die aan de invoersequentie van het model worden toegevoegd. Deze prompts kunnen op verschillende manieren worden geïnitialiseerd. Willekeurige initialisatie komt veel voor, maar ze kunnen ook worden geïnitialiseerd op basis van bepaalde heuristieken. Eenmaal geïnitialiseerd, worden zachte prompts aan het begin van de invoergegevens geplaatst. Wanneer het model deze gegevens verwerkt, houdt het zowel rekening met de zachte prompts als met de feitelijke invoer.
Het trainingsproces lijkt meestal op dat van het trainen van een standaard deep neural network (DNN). Het begint met een forward pass waarbij het model de gecombineerde invoer door zijn lagen verwerkt en een output produceert. Deze output wordt vervolgens vergeleken met de gewenste uitkomst met behulp van een loss-functie, die het verschil meet tussen de output van het model en de daadwerkelijk verwachte waarde.
Tijdens backpropagation worden de fouten terug door het netwerk gepropageerd. In plaats van de gewichten van het netwerk aan te passen, wijzigen we echter alleen de parameters van de zachte prompts. Dit proces wordt over meerdere epochs herhaald, waarbij de zachte prompts geleidelijk leren om de verwerking van invoer door het model zo te sturen dat de fout voor de gegeven taak wordt geminimaliseerd.
Het proces van forward pass, verliesevaluatie en backpropagation wordt over meerdere epochs herhaald. Na verloop van tijd leren deze zachte prompts de invoer zo te vormen dat de loss-score consequent daalt, waardoor de taakspecifieke prestaties van het model verbeteren zonder de onderliggende capaciteiten aan te tasten.
Prompt tuning, fine-tuning en prompt engineering zijn drie verschillende methoden die worden toegepast op voorgetrainde LLM’s om hun prestaties op een specifieke taak te verbeteren. Deze methoden sluiten elkaar niet uit en zijn elk geschikt voor een bepaald gebruiksscenario.
Fine-tuning is het meest intensief qua middelen en houdt een uitgebreide hertraining van het model in op een specifieke dataset voor een specifiek doel. Dit past de gewichten van het voorgetrainde model aan, waardoor het wordt geoptimaliseerd voor de fijne nuances van de data, maar wel aanzienlijke rekenkracht vereist en het risico op overfitting vergroot. Veel LLM’s zoals ChatGPT ondergaan fine-tuning na hun initiële algemene training op de taak van het volgende woord voorspellen. Fine-tuning leert deze modellen hoe ze als digitale assistenten moeten functioneren, waardoor ze veel nuttiger worden dan een algemeen getraind model.
Prompt tuning past een set extra parameters aan, de zogenaamde "zachte prompts", die worden geïntegreerd in de invoerverwerking van het model. Deze methode wijzigt hoe het model invoerprompts interpreteert zonder een volledige herziening van de gewichten, en biedt zo een balans tussen prestatieverbetering en efficiënt gebruik van middelen. Het is vooral waardevol wanneer de rekenmiddelen beperkt zijn of wanneer flexibiliteit over meerdere taken nodig is, omdat na toepassing van de techniek de oorspronkelijke modelgewichten ongewijzigd blijven.
Prompt engineering daarentegen omvat helemaal geen training of hertraining. Het is volledig gebaseerd op de gebruiker die prompts voor het model ontwerpt. Het vereist een genuanceerd begrip van de verwerkingsmogelijkheden van het model en benut de intrinsieke kennis die in het model is ingebed. Prompt engineering vereist geen rekenmiddelen, omdat het uitsluitend berust op de strategische formulering van input om resultaten te behalen. Bekijk DataCamp’s cursus over prompt engineering voor developers om meer te leren.
Elk van deze technieken biedt een andere manier om de mogelijkheden van voorgetrainde modellen te benutten. De keuze hiertussen hangt af van de specifieke behoeften van de toepassing, zoals de beschikbaarheid van rekenmiddelen, de noodzaak van modelaanpassing en het gewenste niveau van interactie met de leerparameters van het model.
|
Methode |
Mate van middelengebruik |
Training vereist |
Beste voor |
|
Fine-tuning |
Hoog |
Ja |
Taken die diepgaande modelaanpassing vereisen |
|
Prompt tuning |
Laag |
Ja |
Behoud van modelintegriteit over taken heen |
|
Prompt engineering |
Geen |
Nee |
Snelle aanpassingen zonder rekenkosten. |
Elke methode heeft zijn plek, afhankelijk van de specifieke behoeften van je project.
Prompt tuning biedt verschillende belangrijke voordelen en is daardoor een onmisbare techniek om large language models te optimaliseren.
Prompt tuning laat de parameters van het voorgetrainde model ongewijzigd, waardoor de benodigde rekenkracht drastisch afneemt. Deze efficiëntie is vooral cruciaal in omgevingen met beperkte middelen en maakt geavanceerd modelgebruik mogelijk zonder hoge kosten. Naarmate de gemiddelde omvang van fundamentele modellen toeneemt, wordt het “bevriezen” van modelparameters nog aantrekkelijker, omdat er niet voor elke taak een apart model uitgerold hoeft te worden.
In tegenstelling tot uitgebreide fine-tuning vereist prompt tuning alleen aanpassingen aan een kleine set parameters van zachte prompts. Dit versnelt het aanpassingsproces, maakt snellere overgang tussen verschillende taken mogelijk en vermindert de downtime.
Door de kernarchitectuur en -gewichten van het model intact te laten, behoudt prompt tuning de oorspronkelijke capaciteiten en kennis die in het voorgetrainde model zijn ingebed. Dit is cruciaal om de betrouwbaarheid en generaliseerbaarheid van het model in verschillende toepassingen te waarborgen.
Prompt tuning maakt het mogelijk om één fundamenteel model voor meerdere taken te gebruiken door simpelweg de zachte prompts te wijzigen. Deze aanpak vermindert de noodzaak om voor elke specifieke taak aparte modellen te trainen en te onderhouden, en vergroot de schaalbaarheid en eenvoud in modelbeheer.
Prompt tuning vereist aanzienlijk minder menselijke interventie dan prompt engineering, waarbij het zorgvuldig formuleren van prompts voor een bepaalde taak foutgevoelig en tijdrovend kan zijn. In plaats daarvan minimaliseert de geautomatiseerde optimalisatie van zachte prompts tijdens training menselijke fouten en maximaliseert ze de efficiëntie.
Onderzoek toont aan dat prompt tuning voor grote modellen prestatieniveaus kan bereiken die vergelijkbaar zijn met die van fine-tuning. Dit voordeel wordt steeds belangrijker naarmate modellen groter worden, omdat hoge efficiëntie wordt gecombineerd met sterke resultaten.
Voor deze gids passen we prompt tuning toe op BigScience’ bloomz-560m-model. We werken binnen het Hugging Face-ecosysteem met de PEFT-bibliotheek (Parameter-Efficient Fine-Tuning).
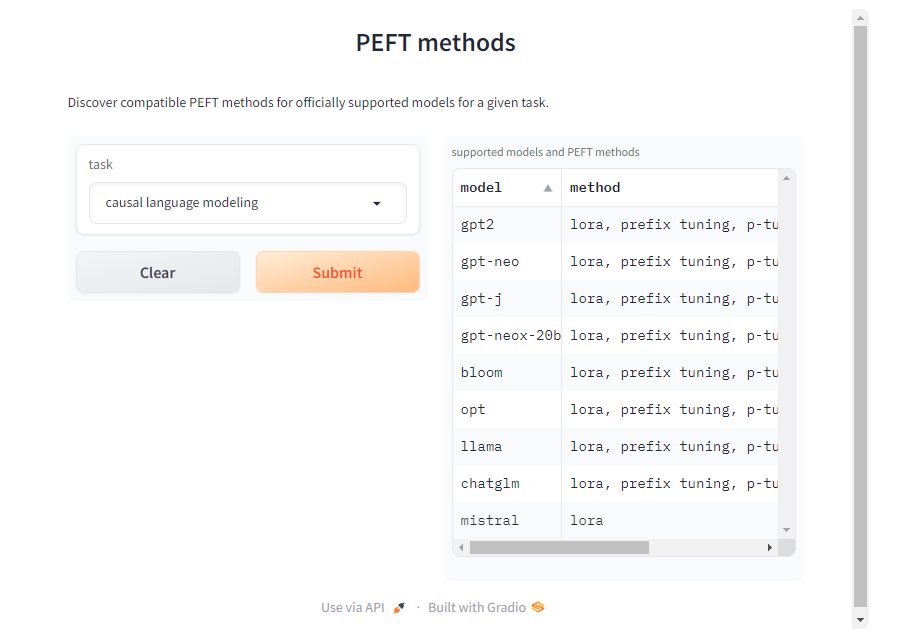
Hoewel we ons hier richten op de taak causal language modeling, ondersteunt de PEFT-bibliotheek verschillende taken, modellen en tuningtechnieken. Op de PEFT-documentatiepagina vind je compatibele PEFT-methoden voor andere modellen en taken.
We beginnen met het laden van het model en de tokenizer van het BigScience bloomz-560m-model. De tokenizer wordt gebruikt om tekstinvoer te verwerken, terwijl het fundamentele model causal language modeling-taken afhandelt. De parameter trust_remote_code=True laat je aangepaste code gebruiken die door de beheerders van het model is geleverd voor specifieke architecturen.
Hoewel dit nuttig is om volledige functionaliteit te krijgen, vertrouw de code van het model alleen als die van een betrouwbare bron komt. Vermijd onbetrouwbare code voor modellen van onbekende of niet-geverifieerde makers, omdat dit veiligheids- of stabiliteitsrisico’s kan opleveren.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "bigscience/bloomz-560m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    trust_remote_code=True
)Voor je gaat tunen is het essentieel om een nulmeting vast te leggen door inference te draaien met het niet-getunede fundamentele model. Met een prompt als "I want you to act as a logistician," kunnen we observeren hoe het model reacties genereert zonder verdere tuning. Zorg dat je een extra spatie na de prompt toevoegt, anders genereert het model mogelijk niets.
Dit dient als referentie om verbeteringen na het tunen te vergelijken.
We gebruiken een aangepaste functie generate_text om het ons makkelijker te maken.
def generate_text(model, tokenizer, prompt_text, max_tokens):
    prompt_text = tokenizer(prompt_text, return_tensors="pt")
    outputs = model.generate(
        input_ids=prompt_text["input_ids"],
        attention_mask=prompt_text["attention_mask"],
        max_length=max_tokens,
        repetition_penalty=1.5,
        eos_token_id=tokenizer.eos_token_id
    )
    return tokenizer.batch_decode(outputs, skip_special_tokens=True)


initial_output = generate_text(model, tokenizer, "I want you to act as a logistician. ", 100)
print("Initial model output:", initial_output)
Dit is de modeluitvoer:
['I want you to act as a logistician. You will be able to: Analyze the data']
Zoals je ziet, is het model niet helemaal zeker van de context.
De dataset is een cruciaal onderdeel van prompt tuning. We gebruiken de dataset `awesome-chatgpt-prompts` voor tuning. Deze dataset biedt motiverende inhoud voor het tunen, zodat het model zijn antwoorden daarop afstemt.
from datasets import load_dataset

dataset_prompt = "fka/awesome-chatgpt-prompts"


data_prompt = load_dataset(dataset_prompt)
data_prompt = data_prompt.map(lambda x: tokenizer(x["prompt"]), batched=True)
train_prompts = data_prompt["train"].select(range(50))
We tokenizen de dataset en bereiden een kleine subset voor training voor.
Nu het interessantste deel: we configureren de prompt tuning met de klasse PromptTuningConfig uit de PEFT-bibliotheek.
from peft import  get_peft_model, PromptTuningConfig, TaskType, PromptTuningInit

tuning_config = PromptTuningConfig(
    task_type=TaskType.CAUSAL_LM, #This type indicates the model will generate text.
    prompt_tuning_init=PromptTuningInit.RANDOM,  #The added virtual tokens are initializad with random numbers
    num_virtual_tokens=4, #Number of virtual tokens to be added and trained.
    tokenizer_name_or_path=model_name
)

peft_model = get_peft_model(model, tuning_config)
De trainingsargumenten worden gespecificeerd met de klasse TrainingArguments.
from transformers import TrainingArguments
training_args = TrainingArguments(
    use_cpu=True, # This is necessary for CPU clusters.
    output_dir = "./",
    auto_find_batch_size=True, # Find a suitable batch size that will fit into memory automatically, you can also use a custom batch size
    learning_rate= 0.005,
    num_train_epochs=5
    )
Een Trainer-object beheert het trainingsproces. Met DataCollatorForLanguageModeling zorgt de data-collator ervoor dat de trainingssamples correct worden geformatteerd. De trainingsfase wordt gestart met de methode train, waarmee het bloomz-560m-model wordt afgestemd op de specifieke prompttaken.
from transformers import Trainer, DataCollatorForLanguageModeling
trainer = Trainer(
    model=peft_model, # We pass in the PEFT version of the foundation model, bloomz-560M
    args=training_args, #The args for the training.
    train_dataset=train_prompts, #The dataset used to train the model.
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False) # mlm=False indicates not to use masked language modeling
    )
trainer.train()Het getunede model is opgeslagen in het trainer-object; we kunnen trainer.model gebruiken om het te benaderen. We gebruiken de functie generate_text om inference te draaien met het getunede model!
tuned_output = generate_text(trainer.model, tokenizer, "I want you to act as a logistician. ", 100)
print("Tuned model output:", tuned_output)
Dit is de uitvoer van het getunede model:
['I want you to act as a logistician. You will be responsible for the logistics of your business.']
Zoals je nu ziet, weet het model wat een logistician doet. Experimenteer gerust met verschillende prompts, modellen en datasets!
Prompt tuning is een krachtig middel om large language models efficiënter te maken voor een specifieke taak. We hebben prompt tuning verkend door eerst uit te leggen wat het is en hoe het werkt. Vervolgens hebben we het vergeleken met andere soortgelijke technieken: fine-tuning en prompt engineering. Tot slot hebben we de voordelen besproken en een stapsgewijze gids doorlopen om prompt tuning toe te passen op een voorgetraind model.
Omdat het vakgebied van generatieve AI blijft evolueren, is het belangrijk om bovenop de nieuwste ontwikkelingen te blijven. Om je vaardigheden en begrip van AI verder te vergroten, biedt Datacamp allerlei diepgaande bronnen. Ik raad je aan deze uitgebreide tutorials te verkennen:
Blijf leren met DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

