Kurs
So funktioniert Prompt Engineering
1 Std.
231.2K
Stell dir eine brilliante Freundin vor, die unglaublich gut darin ist, knifflige Probleme zu lösen. Jedes Mal, wenn du ihr eine neue Frage stellst, muss sie jedoch wieder ganz von vorn anfangen – alles, was sie zuvor gelernt hat, ist wie ausgelöscht.
Ziemlich frustrierend, oder? Genau dieses Problem haben wir bei Large Language Models (LLMs), sobald es um komplexe Denkaufgaben geht. LLMs sind stark in der Textgenerierung, tun sich aber oft mit anspruchsvollem Reasoning schwer, weil sie Wissen aus früheren Interaktionen nicht dauerhaft nutzen können.
Gib diesen LLMs jedoch ein „geistiges Notizbuch“, in dem sie wertvolle Einsichten speichern und wiederverwenden – genau das leistet das Buffer of Thoughts (BoT)-Framework.
In diesem Tutorial schauen wir uns Buffer of Thoughts (BoT) an, ein neues Framework, das verändert, wie LLMs komplexe Probleme angehen. Ich starte mit den Grundideen hinter BoT, inklusive Meta-Puffer und Buffer-Manager. Anschließend siehst du Schritt für Schritt, wie BoT arbeitet – vom Verstehen des Problems über das Finden und Nutzen passender Thought-Templates bis hin zur Lösung. So wird klar, wie BoT LLMs präziser, effizienter und verlässlicher macht.
Außerdem teile ich spannende Ergebnisse aus diesem Paper, die zeigen, wie stark BoT in verschiedenen Aufgaben abschneidet. Am Ende weißt du, warum BoT gerade viel Aufmerksamkeit bekommt und wie es in realen Anwendungen eingesetzt werden kann.
Buffer of Thoughts (BoT) ist ein neues Framework, das die Denk- und Schlussfolgerungsfähigkeiten von LLMs gezielt verbessert.
BoT kombiniert zwei Kernelemente, um LLMs durch komplexe Reasoning-Aufgaben zu führen:
Schauen wir uns beide Komponenten genauer an.
Der Meta-Puffer ist wie eine Bibliothek universeller Problemlösungsstrategien. Er speichert „Thought-Templates“, also hochstufige Herangehensweisen an Probleme. Diese Templates stammen aus unterschiedlichen Aufgaben, denen das LLM begegnet ist.
Denk daran wie an einen Werkzeugkoffer voller vielseitiger Tools, die sich auf viele Jobs anpassen lassen.
Der Buffer-Manager ist der dynamische Organisator des BoT-Systems. Seine Aufgaben: den Meta-Puffer mit neuen Thought-Templates aus gelösten Aufgaben erweitern, für jedes neue Problem die relevantesten Templates auswählen und bestehende Vorlagen anhand ihrer Wirksamkeit verfeinern.
Es ist, als hättest du eine persönliche Assistenz, die deine Notizen laufend sortiert, das Nützlichste markiert und dir hilft, es auf neue Herausforderungen anzuwenden.
Die eigentliche Magie entsteht durch Thought-augmented Reasoning. Bei einer neuen Aufgabe macht BoT Folgendes:
1. Analysiert das Problem und identifiziert die Schlüsselelemente.
2. Ruft passende Thought-Templates aus dem Meta-Puffer ab.
3. Passt diese Vorlagen an und baut daraus eine spezifische Reasoning-Struktur für das Problem.
4. Führt das LLM mithilfe dieser Struktur durch den Problemlösungsprozess.
Stell dir vor, du bist Köchin oder Koch. Der Meta-Puffer ist dein persönliches Kochbuch. Es enthält nicht nur konkrete Rezepte, sondern auch verschiedene Techniken: Gemüse richtig sautieren, eine perfekte Reduktion ansetzen oder Aromen balancieren. Diese übergeordneten Techniken lassen sich für viele Gerichte nutzen.
Dazu hast du eine sehr organisierte, erfahrene Sous-Chefin – deinen Buffer-Manager. Sie entscheidet, welche Techniken aus deinem Kochbuch sich für das aktuelle Gericht eignen. Während des Kochens macht sie Notizen, was gut funktioniert hat und was nicht, und aktualisiert deine Techniken entsprechend.
Kommt eine neue Bestellung rein, startest du nicht bei null. Du schlägst im Kochbuch (Meta-Puffer) die besten Techniken nach und lässt dich vom Sous-Chef (Buffer-Manager) effizient durch den Prozess führen. Er erinnert sich, was bei ähnlichen Gerichten gut lief, und hilft dir, die Herangehensweise zu justieren – so entsteht schnell ein Ergebnis auf Top-Niveau.
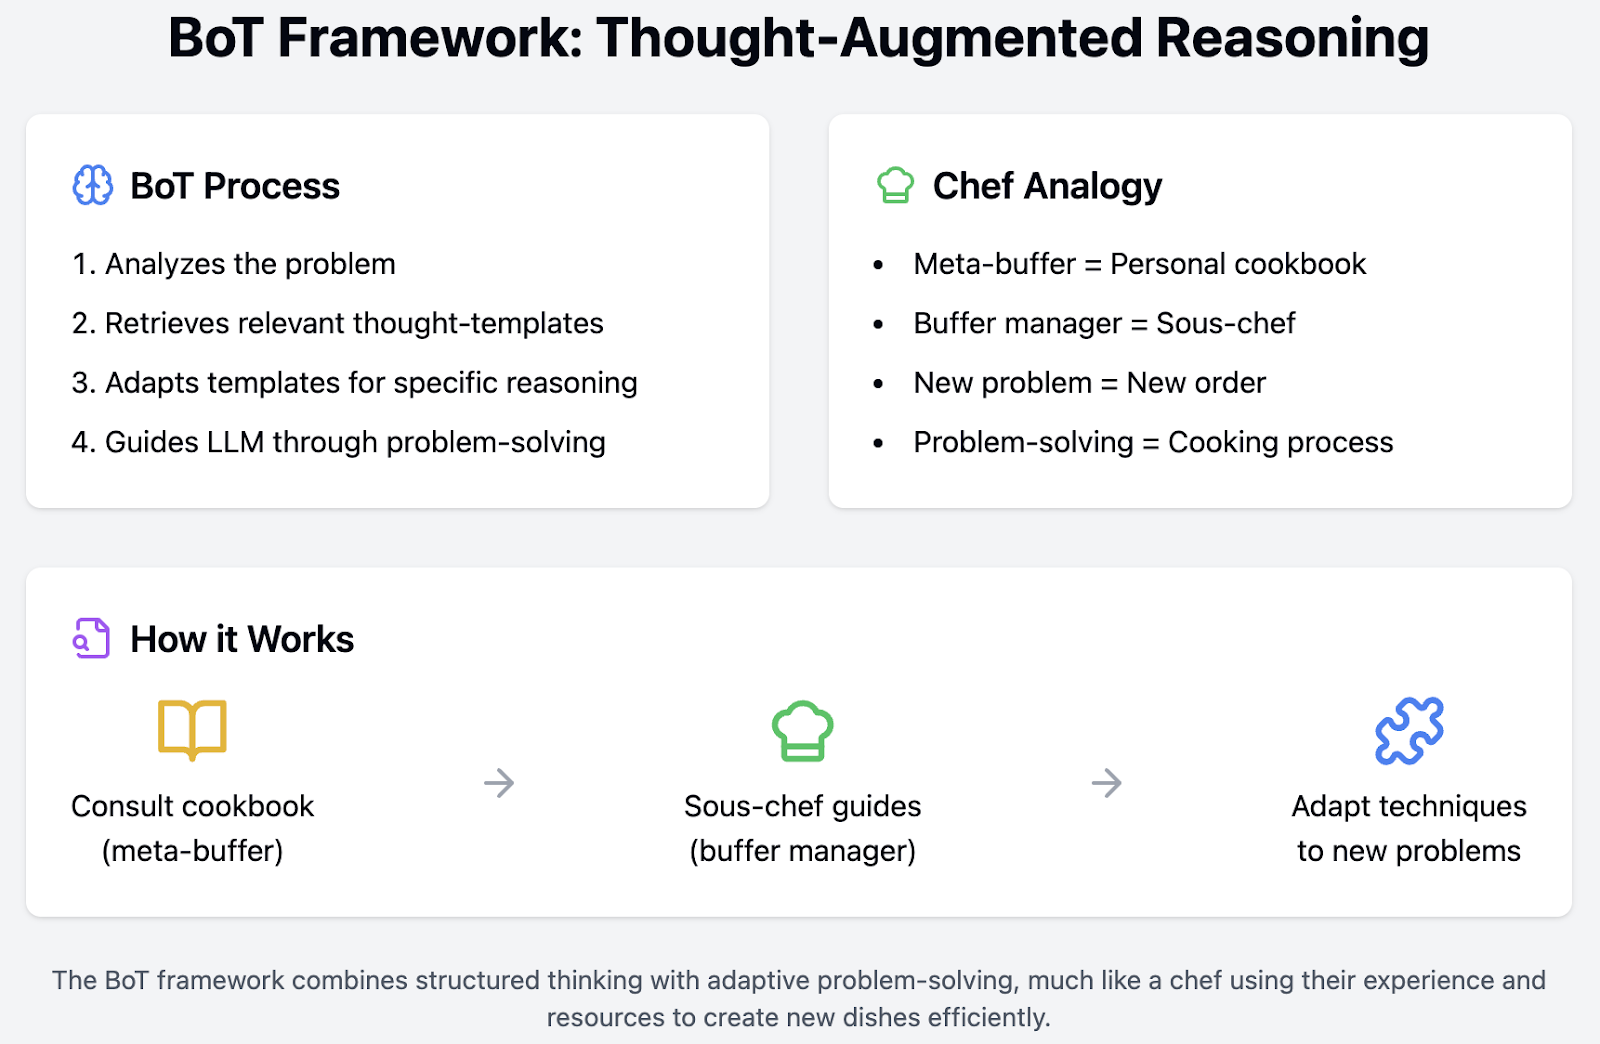
So läuft der Prozess in deiner Küche ab:
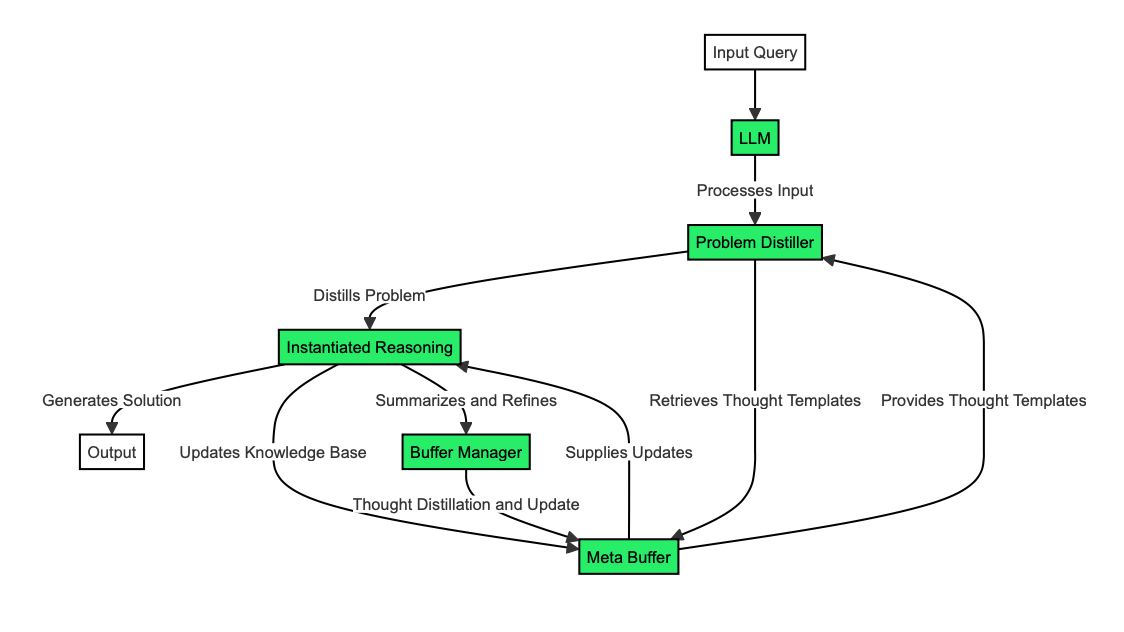
Jetzt, da wir BoT und seine Schlüsselelemente kennen, schauen wir hinter die Kulissen. Wir zerlegen es in vier Bausteine:
Der Problem-Distiller arbeitet wie eine versierte Übersetzerin: Er überführt komplexe Probleme in eine Darstellung, mit der BoT leicht arbeiten kann.
Man kann ihn sich als akribische Leserin vorstellen, die die kritischen Informationen und Randbedingungen aus dem Eingabeproblem extrahiert – wie das Markieren der wichtigsten Passagen in einem Kapitel.
Hat der Distiller diese Schlüsselelemente identifiziert, ordnet er sie zu übergeordneten Konzepten und Strukturen. Das ist wie eine prägnante Zusammenfassung eines langen Artikels: Fokus auf das Wesentliche, ohne Ballast.
Bekommst du etwa ein komplexes Problem zu Fahrplänen, extrahiert der Distiller zentrale Elemente wie „Zuggeschwindigkeiten“, „Abfahrtszeiten“ und „Streckenlängen“ und bringt sie in ein strukturiertes Format, das BoT gut verarbeiten kann.
Der Meta-Puffer ist BoTs Wissensspeicher: Er hält Thought-Templates samt Beschreibungen bereit und kategorisiert sie für den schnellen Zugriff.
Das ist wie eine gut sortierte Bibliothek, in der jedes Buch (Template) eine ausführliche Beschreibung hat und am richtigen Platz steht.
Wenn BoT ein Template benötigt, vergleicht es das destillierte Problem mit den Template-Beschreibungen und findet so das passendste. Wie eine Bibliothekarin, die dir anhand deiner Beschreibung sofort das richtige Buch bringt.
BoT erkennt auch, wenn eine Aufgabe völlig neu ist und ein neues Thought-Template braucht – so, als würdest du in deiner Bibliothek eine neue Kategorie anlegen.
Im Fahrplan-Beispiel hätte BoT verschiedene Thought-Templates im Meta-Puffer, jeweils mit Beschreibung: einige zu Zeitmanagement, andere zu räumlichem Denken oder zu Optimierungsstrategien.
Trifft BoT auf das Fahrplanproblem, wählt es per Abgleich der destillierten Elemente wie „Zuggeschwindigkeiten“, „Abfahrtszeiten“ und „Streckenlängen“ das relevanteste Template aus, etwa eines für Planung und Zeitoptimierung.
Stellt BoT fest, dass ein neuartiges Element vorliegt – z. B. eine ungewohnte Nebenbedingung oder ein neues Optimierungsziel –, erkennt es die Notwendigkeit eines neuen Templates.
Geht es etwa um die Abstimmung über mehrere Verkehrsträger (Zug, Bus, Flug), legt BoT ein neues Template für multimodale Planung an und speichert es – als Vorbereitung auf ähnliche Fälle.
So ermöglicht der Meta-Puffer effizientes Speichern, Abrufen und Erstellen neuer Strategien und stärkt BoTs Fähigkeit, komplexe Aufgaben zu meistern.
Hier setzt BoT die ausgewählten Thought-Templates konkret zur Lösung des aktuellen Problems ein.
Bei bestehenden Vorlagen wird das Template an die Aufgabe angepasst – wie ein Rezept, das du für mehr Personen umrechnest. BoT justiert das Template entlang der Problemspezifika, damit eine passgenaue, wirksame Lösung entsteht.
Gibt es noch kein passendes Template, greift BoT auf vordefinierte, allgemeine Vorlagen zurück. Das ist, als würdest du mit Grundtechniken ein völlig neues Gericht kochen. Auf Basis von Prinzipien kann BoT unbekannte Probleme strukturieren und dabei neue Strategien entwickeln.
Im Fahrplanfall zieht BoT ein Template für Zeitoptimierung und Planung, passt es aber an: Statt eines einzelnen Zuges berücksichtigt es mehrere Züge, unterschiedliche Geschwindigkeiten und Abfahrtszeiten. So laufen alle Züge effizient und pünktlich – unter Berücksichtigung der konkreten Randbedingungen.
Trifft BoT hingegen auf etwas Neues, etwa die nahtlose Integration von Zug-, Bus- und Flugplänen, nutzt es allgemeine Vorlagen: Das Problem wird in Teilprobleme zerlegt, je Verkehrsmittel analysiert und die Teillösungen integriert. Dabei entstehen neue Strategien und Templates – eine Investition in künftige multimodale Planungsaufgaben.
Der Buffer-Manager ist die Lern- und Optimierungskomponente des Systems und verbessert BoTs Wissensbasis kontinuierlich.
Bei der Template-Destillation fasst er den Lösungsweg in hochstufige Gedanken zusammen – ähnlich einem „Lessons Learned“-Dokument nach einem Projekt, das festhält, was warum gut funktioniert hat.
Über dynamische Updates speist der Buffer-Manager neue Thought-Templates ein. Über Ähnlichkeitsschwellen entscheidet er, ob neue Vorlagen angelegt oder bestehende aktualisiert werden, damit der Meta-Puffer leichtgewichtig und effizient bleibt – wie ein Kochbuch, das ständig verfeinert wird, ohne auszuschweifen.
Hat BoT etwa ein komplexes Fahrplanproblem mit mehreren Zügen, variablen Geschwindigkeiten und Abfahrtszeiten gelöst, destilliert der Buffer-Manager wirksame Strategien: z. B. Techniken zur Optimierung überlappender Pläne oder zur Steuerung von Spitzenzeiten.
Trifft BoT später auf ein ähnliches, aber erweitertes Problem, aktualisiert der Buffer-Manager den Meta-Puffer entsprechend. Geht es z. B. um die Integration von Zug- und Busplänen, verfeinert er das bestehende Template um Methoden für multimodale Integration.
Das Buffer-of-Thoughts-(BoT)-Framework bietet mehrere zentrale Vorteile für das Reasoning von LLMs: höhere Genauigkeit, effizientere Schlussfolgerungen und robustere Modelle.
BoT steigert die Reasoning-Genauigkeit von LLMs durch diesen Ansatz spürbar:
BoT steigert die Effizienz des Reasonings deutlich und spart Zeit sowie Rechenressourcen:
BoT macht LLMs robuster – verlässlicher und konsistenter über verschiedene Aufgaben hinweg:
Das Buffer-of-Thoughts-(BoT)-Framework wurde auf eine breite Palette anspruchsvoller Aufgaben getestet – mit beeindruckenden Resultaten. Details findest du im Paper und im GitHub-Repository, auf die sich dieser Abschnitt stützt.
BoT wurde auf 10 anspruchsvollen, reasoning-intensiven Tasks evaluiert und zeigte Vielseitigkeit und Wirksamkeit. Darunter:
Die Auswahl deckt verschiedene komplexe Reasoning-Szenarien ab – von mathematischer Problemlösung über strategische Spiele bis zu sprachlichen Aufgaben.
Gegenüber dem bisherigen Stand der Technik zeigte BoT deutliche Zugewinne:
Besonders bemerkenswert: BoT erreichte diese Werte bei nur rund 12 % der Rechenkosten gegenüber Multi-Query-Prompting-Methoden!
Außerdem zeigte sich, dass BoT mit kleineren Sprachmodellen wie Llama3-8B das Potenzial hat, größere Modelle wie Llama3-70 zu überflügeln. Das unterstreicht, wie stark BoT kompaktere, effizientere Modelle aufwerten kann.
Diese Ergebnisse zeigen: BoT erhöht die Genauigkeit und bleibt zugleich effizient und robust über verschiedene Reasoning-Aufgaben hinweg. Die Konsistenz der Resultate spricht für verlässliche Leistungsgewinne. Dennoch braucht es weitere unabhängige Prüfungen und Tests auf noch breiter gefächerten Aufgaben, um Grenzen und Potenziale vollständig zu verstehen.
Wir haben heute viel abgedeckt. Hier die Quintessenz und ein Ausblick darauf, wohin sich BoT entwickelt.
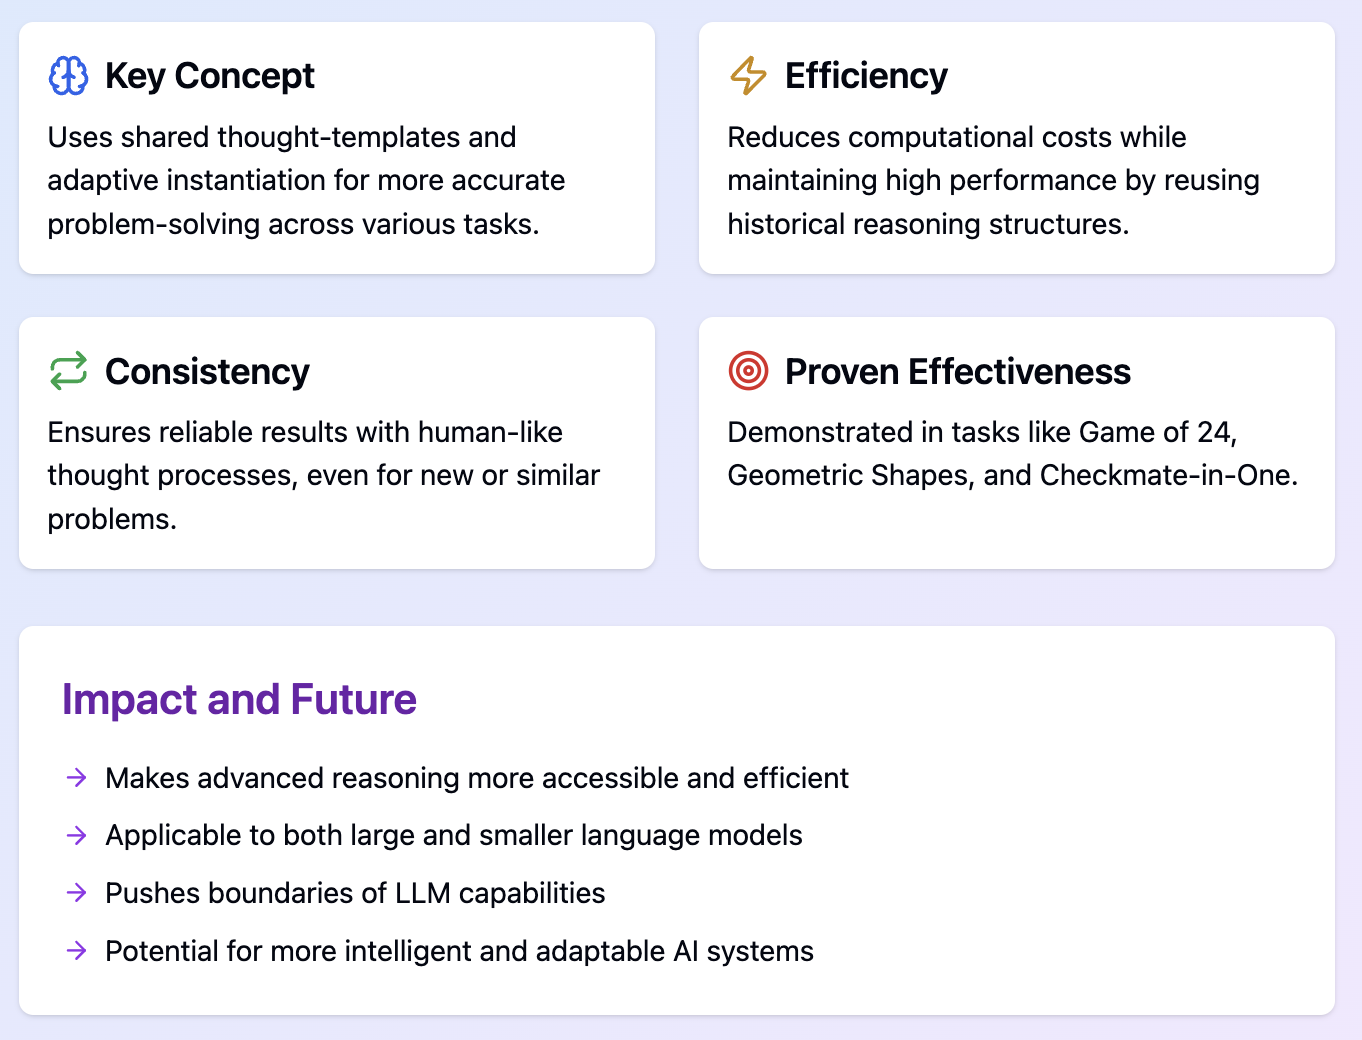
Das war unsere Tour durch Buffer of Thoughts. Ich hoffe, das Tutorial hat dir die Kernideen, die Funktionsweise, die Vorteile und den möglichen Einfluss auf KI-Reasoning klar gemacht.
Danke fürs Lesen – bis zum nächsten Mal!
Wenn du mehr über Prompt Engineering lernen willst, empfehle ich diese Blogartikel:
Lerne KI mit diesen Kursen!
Kurs
Kurs
Kurs