
Cursus
Prompt Engineering begrijpen
1 uur
236.8K
Als je met large language models werkt, weet je dat prompt engineering best een uitdaging kan zijn. Je kunt uren besteden aan het bijschaven van prompts om vervolgens wisselende resultaten te krijgen. Het is frustrerend, kost veel tijd en vereist vaak veel trial-and-error om optimale resultaten te behalen.
Eén oplossing voor dit probleem is DSPy—een nieuw framework dat de manier waarop we prompt engineering kennen verandert. In plaats van te focussen op het perfectioneren van prompts, laat DSPy ons de modellen rechtstreeks programmeren.
In deze tutorial leg ik DSPy uit en waarom het anders is dan oudere methoden. Je leert over de belangrijkste features en voordelen en hoe het werkt. Ik neem je mee door je eerste stappen met DSPy en wijs je op handige resources en communities.
Laten we beginnen!
DSPy is een open-source tool ontwikkeld door Stanford University die "declaratieve aanroepen naar taalmodellen compileert tot zelfverbeterende pipelines". In plaats van tijd te besteden aan perfecte prompts, laat DSPy je de AI-modellen rechtstreeks programmeren.
Dit maakt AI-apps betrouwbaarder en makkelijker te schalen. DSPy scheidt de logica van je app van de tekst die het gebruikt, zodat jij je kunt focussen op wat je AI moet doen. Ondertussen optimaliseert DSPy de prompts achter de schermen.
Laten we enkele kernfeatures verkennen.
Met DSPy definieer je de taak die je wilt uitvoeren en de metrics om succes te meten. Het framework optimaliseert vervolgens het gedrag van het model voor je. Het gebruikt begrijpelijke Python-syntax, zodat je je kunt concentreren op wat je applicatie moet doen in plaats van hoe je het model moet prompten.
Een van de opvallendste features van DSPy is de mogelijkheid om prompts automatisch in de tijd te verbeteren. DSPy verfijnt de prompts continu, zodat je niet steeds handmatig hoeft bij te sturen. Dit gebeurt via feedback en evaluatie, waardoor het model bij elke iteratie beter presteert.
DSPy biedt ook een modulaire architectuur, waardoor je vooraf gebouwde modules kunt combineren voor verschillende natural language processing (NLP)-taken. Deze modulariteit maakt het sterk aanpasbaar aan jouw specifieke behoeften en bevordert flexibiliteit en hergebruik. Het framework bevat handige modules zoals ChainOfThought en ReAct, die je eenvoudig in je applicaties kunt integreren.
In deze sectie behandel ik de belangrijkste onderdelen van DSPy en hoe het werken met LLM's makkelijker wordt.
Met DSPy beginnen gebruikers met het specificeren van het doel van de taak en de te optimaliseren metrics. Dit betekent dat je bepaalt wat je wilt dat het model bereikt en hoe je het succes gaat meten.
DSPy gebruikt voorbeeldinputs, gelabeld of ongelabeld, om het leerproces te sturen. Deze voorbeelden helpen het framework de taak beter te begrijpen en de performance te verbeteren. Bovendien introduceert DSPy het concept van modules, herbruikbare bouwstenen voor diverse NLP-taken. Deze modules kun je combineren en aanpassen aan verschillende behoeften.
Zodra de taak is gedefinieerd, selecteren en configureren gebruikers de juiste modules voor hun specifieke taak. Dit houdt in dat je de modules kiest die passen bij de vereisten en deze overeenkomstig instelt. DSPy laat je deze modules aan elkaar schakelen om complexe pipelines te creëren, wat geavanceerde workflows mogelijk maakt. Elke module heeft signatures die de input- en outputspecificaties vastleggen, zodat de modules naadloos kunnen samenwerken.
DSPy optimaliseert prompts met in-context learning en automatische few-shot voorbeeldgeneratie. Dit betekent dat het framework de prompts voortdurend verfijnt om de prestaties van het model te verbeteren. DSPy kan ook kleinere modellen fine-tunen voor taken die specifiekere afstemming vereisen.
Tot slot compileert DSPy de volledige pipeline naar uitvoerbare Python-code, zodat je die eenvoudig in je applicaties kunt integreren. Dit compilatieproces zorgt ervoor dat de pipeline efficiënt en effectief draait.
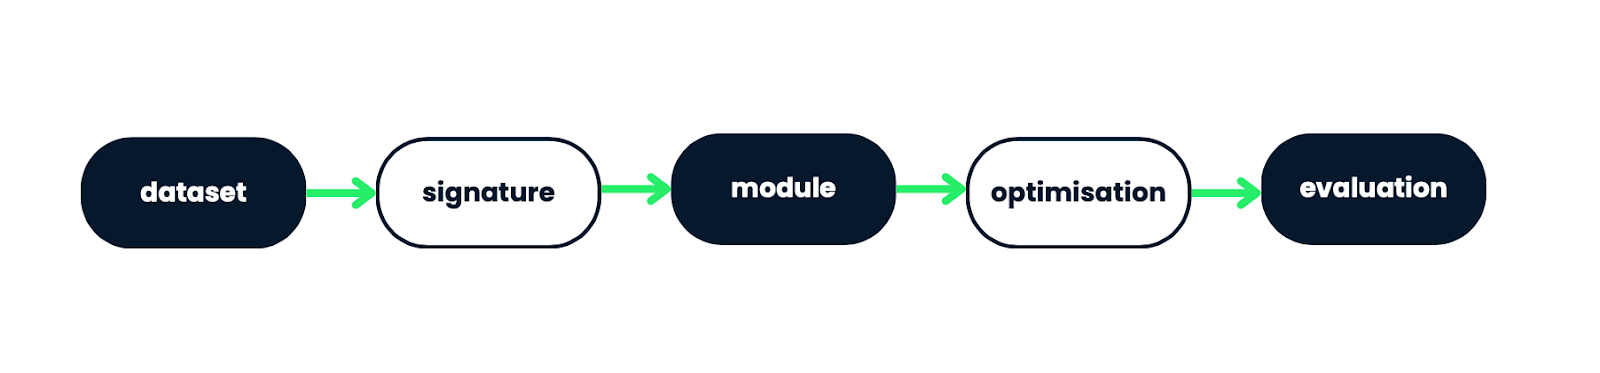
Figuur 1: DSPy-werkstroom: van data naar geoptimaliseerd AI-model
Dit diagram illustreert de kernwerkstroom van DSPy en laat zien hoe ruwe data wordt omgezet in een geoptimaliseerd AI-model. Het proces begint met een dataset, die de signature (de input/output-structuur) informeert. Deze signature wordt gebruikt om een module te maken, die vervolgens wordt geoptimaliseerd met de geavanceerde technieken van DSPy. Tot slot ondergaat de geoptimaliseerde module een evaluatie om te waarborgen dat deze aan de gewenste prestatiecriteria voldoet.
Deze gestroomlijnde aanpak laat jou focussen op het ontwerp op hoog niveau, terwijl DSPy de complexiteit van prompt engineering en modeloptimalisatie afhandelt.
DSPy biedt verschillende belangrijke voordelen die het een krachtig hulpmiddel maken voor het werken met LLM's:
De declaratieve aanpak van DSPy leidt tot betrouwbaarder en voorspelbaarder LLM-gedrag. In plaats van handmatig prompts te schrijven, definieer je wat je wilt dat het model doet. DSPy bedenkt vervolgens hoe dat consequent te realiseren. Dit betekent minder onverwachte outputs en stabielere prestaties over verschillende taken heen.
Stel, je bouwt een klantenservice-chatbot. In plaats van specifieke prompts te schrijven, zou je met DSPy je intentie zo kunnen definiëren:
DSPy zou dan het volgende afhandelen:
Zo kan DSPy bijvoorbeeld leren dat antwoorden beginnen met "Ik begrijp je zorg over..." leidt tot hogere klanttevredenheid in stap 3. Of dat het voor stap 4 een effectieve manier ontwikkelt om het antwoord te vergelijken met de oorspronkelijke vraag.
Het belangrijkste is dat jij je richt op het definiëren van de structuur en doelen op hoog niveau. DSPy verzorgt de details van prompt engineering en optimalisatie, wat leidt tot betrouwbaarder en voorspelbaarder gedrag van de LLM bij uiteenlopende klantvragen.
Deze aanpak betekent dat je het gedrag van de chatbot eenvoudig kunt aanpassen (bijv. formeler maken of een nieuwe stap toevoegen om op gevoelige informatie te checken) zonder al je prompts handmatig te herschrijven. DSPy past zich automatisch aan en optimaliseert voor de nieuwe eisen.
De modulaire architectuur en automatische promptoptimalisatie in DSPy maken LLM-ontwikkeling veel eenvoudiger. Je kunt complexe applicaties bouwen door vooraf gebouwde modules te combineren, alsof je met bouwstenen werkt. DSPy behandelt het lastige deel van het optimaliseren van prompts achter de schermen, zodat jij je kunt focussen op de logica van je applicatie in plaats van eindeloos aan prompts te sleutelen.
Stel je maakt een contentassistent voor een blog. Zonder te coderen zou je je applicatie zo kunnen conceptualiseren:
1. Topic Generator Module
   - Input: Blog niche and target audience
   - Output: List of potential blog topics
2. Outline Creator Module
   - Input: Selected blog topic
   - Output: Detailed outline for the blog post
3. Content Writer Module
   - Input: Blog outline
   - Output: Full blog post draft
4. Editor Module
   - Input: Blog post draft
   - Output: Edited and polished blog post
5. SEO Optimizer Module
   - Input: Edited blog post
   - Output: SEO-optimized version of the post
In dit scenario zou DSPy het volgende doen:
Je hoeft geen code te schrijven of prompts te maken. Je kiest gewoon de modules die je nodig hebt, zet ze in de gewenste volgorde en specificeert je inputs (zoals blogniche en doelgroep).
Als het gaat om aanpassen aan nieuwe taken en domeinen is DSPy sterk. Je past simpelweg de taakdefinitie en metrics aan, en DSPy configureert zichzelf opnieuw om aan deze nieuwe vereisten te voldoen. Deze flexibiliteit betekent dat je je LLM snel kunt toepassen op verschillende use cases zonder telkens vanaf nul te beginnen.
Stel dat je met DSPy een klantenservice-chatbot voor een techbedrijf hebt gebouwd. Aanvankelijk is de taak van de chatbot het beantwoorden van technische supportvragen, met metrics gericht op antwoordnauwkeurigheid en relevantie van oplossingen, binnen het domein van computerhardware en -software.
Nu wil je deze chatbot aanpassen voor een zorgbedrijf. Hiervoor pas je de taakdefinitie aan naar "gezondheidsgerelateerde klantvragen beantwoorden" en wijzig je de metrics naar "medische nauwkeurigheid" en een "empathiescore" voor het omgaan met gevoelige gezondheidskwesties. Je specificeert ook het nieuwe domein, dat nu algemene gezondheidszorg, medische procedures en verzekeringen omvat.
Met deze wijzigingen configureert DSPy zichzelf automatisch opnieuw. Het past interne processen aan om te focussen op medische kennisbronnen, stemt de taalproductie af op meer empathische en medisch nauwkeurige termen en verandert de evaluatiecriteria om medische nauwkeurigheid en empathie te prioriteren.
Vervolgens geef je een kleine set zorggerelateerde Q&A-voorbeelden. DSPy gebruikt deze voorbeelden om zijn aanpak te verfijnen zonder dat je prompts hoeft te herschrijven.
Het resultaat is dat je chatbot nu effectief zorgvragen afhandelt, medisch juiste informatie biedt en communiceert met de juiste empathie voor gezondheidsgerelateerde zorgen.
Zo hoefde je niets nieuws te programmeren. Het herdefiniëren van de taak, het aanpassen van de metrics en het aanleveren van nieuwe voorbeelden was genoeg voor DSPy om de onderliggende LLM-interacties te herconfigureren voor de nieuwe vereisten.
De optimalisatietechnieken van DSPy komen echt tot hun recht bij grootschalige taken. Het framework kan de prestaties van LLM's verbeteren op grote datasets of complexe problemen door prompts automatisch te verfijnen en het gedrag van het model aan te passen. Deze schaalbaarheid zorgt ervoor dat je applicaties kunnen meegroeien en meer uitdagende taken aankunnen wanneer dat nodig is.
Stel dat je een aanbevelingssysteem ontwikkelt voor een e-commerceplatform. Aanvankelijk moet je systeem een grote dataset met gebruikersinteracties en productdetails verwerken om gepersonaliseerde aanbevelingen te genereren.
Zonder DSPy zou je voor elke stap handmatig prompts opstellen, zoals het ophalen van gebruikersgeschiedenis, het analyseren van voorkeuren en het suggereren van producten. Dit proces zou veel trial-and-error vergen om de prompts precies goed te krijgen, vooral naarmate de dataset groeit en de complexiteit toeneemt.
Met DSPy is het proces veel eenvoudiger en efficiënter.
Je begint met het definiëren van de taak: het genereren van gepersonaliseerde productaanbevelingen. Je specificeert de te optimaliseren metrics, zoals aanbevelingsnauwkeurigheid en gebruikerstevredenheid.
Vervolgens voorzie je DSPy van een dataset met gebruikersinteracties en productdetails. Deze dataset helpt DSPy de taak te begrijpen en de prestaties te verbeteren.
DSPy gebruikt daarna zijn modulaire architectuur om de taak op te delen in kleinere, beheersbare modules. Zo kan één module de gebruikersgeschiedenis ophalen, een andere voorkeuren analyseren en een derde productsuggesties genereren.
DSPy optimaliseert de prompts automatisch en past het gedrag van het model aan naarmate je meer data aanlevert en je taakdefinitie verfijnt. Je hoeft niet elke prompt handmatig bij te stellen—DSPy doet dat voor je achter de schermen.
Als de dataset bijvoorbeeld groeit of de complexiteit van gebruikersinteracties toeneemt, zal DSPy zichzelf herconfigureren om de grotere schaal aan te kunnen. Het zal de prompts verfijnen en de parameters van het model aanpassen om consistente en betrouwbare prestaties te waarborgen.
Deze schaalbaarheid zorgt ervoor dat je aanbevelingssysteem kan meegroeien en zwaardere taken aankan zonder dat je elke keer van voren af aan hoeft te beginnen. De optimalisatietechnieken van DSPy maken het mogelijk om grootschalige taken efficiënt te verwerken, zodat jij je kunt richten op de logica op hoog niveau in plaats van op de finesses van prompt engineering.
DSPy is toepasbaar op een breed scala aan natural language processing-taken. Laten we er een paar bekijken.
DSPy is erg goed in het bouwen van robuuste Question Answering (QA)-systemen. Het kan retrieval-augmented generation (RAG) combineren met chain-of-thought prompting om krachtige QA-tools te creëren. Zo kun je systemen bouwen die relevante informatie vinden en stapsgewijs redeneren over complexe vragen, waardoor antwoorden accurater en informatiever worden.
Met DSPy wordt het bouwen van samenvattingspipelines veel eenvoudiger. Je kunt makkelijk systemen opzetten die zich aanpassen aan verschillende inputlengtes en schrijfstijlen. Deze flexibiliteit stelt je in staat om alles van korte artikelen tot lange documenten samen te vatten, met behoud van de kernpunten en een samenvattingsstijl die past bij jouw behoeften.
DSPy kan helpen om codefragmenten te genereren op basis van beschrijvingen. Dit is vooral nuttig voor ontwikkelaars die snel ideeën willen prototypen of voor niet-programmeurs die eenvoudige scripts moeten maken.
DSPy kan machinevertaling aanzienlijk verbeteren. Het helpt slimmere vertaalssystemen te creëren die niet alleen woorden vertalen, maar ook context en cultuur begrijpen.
Met DSPy kun je een vertaler bouwen die idiomen en uitdrukkingen goed weergeeft, de stijl en toon van de brontekst bewaart en goed werkt voor specifieke domeinen zoals recht, geneeskunde of technologie. Het kan zelfs uitleggen waarom bepaalde vertalingen zijn gekozen.
DSPy kan chatbots laten aanvoelen als een echt gesprek. In plaats van vooraf geschreven antwoorden te geven, kan een DSPy-chatbot onthouden waar je het over hebt gehad en heen-en-weer gesprekken voeren die logisch zijn. Het geeft antwoorden die beter bij je vraag passen en kan de manier van spreken aanpassen aan jouw voorkeur. Deze chatbots kunnen zelfs lastige taken uitvoeren die om redeneren en besluitvorming vragen. Deze verbeteringen maken chatbots behulpzamer en prettiger in het gebruik—bijna als praten met een deskundige vriend.
Je kunt DSPy installeren met pip. Open je terminal of opdrachtprompt en voer uit:
pip install dspy-aiDeze opdracht installeert de nieuwste stabiele versie van DSPy.
Als je de features van DSPy met extra integraties wilt verkennen, kun je het met extras installeren. Bijvoorbeeld, om Pinecone-ondersteuning te includeren, gebruik:
pip install "dspy-ai[pinecone]"Vergelijkbare commando's zijn beschikbaar voor andere integraties zoals Qdrant, ChromaDB en Marqo.
Wil je meer leren over het gebruik van DSPy, bekijk dan de officiële documentatie. Deze biedt gedetailleerde tutorials en voorbeelden om je op weg te helpen en het maximale uit de mogelijkheden van het framework te halen.
De officiële GitHub-repo bevat de broncode, issue tracker en extra voorbeelden.
Hoewel DSPy nog relatief nieuw is, groeit de community. Je kunt op GitHub discussies vinden en hulp krijgen, waar je issues kunt openen of meedoen aan gesprekken. Naarmate de community groeit, komen er waarschijnlijk meer resources en gedeelde ervaringen beschikbaar om je traject met DSPy te ondersteunen.
Onthoud dat DSPy actief wordt ontwikkeld, dus houd updates en nieuwe features in de gaten die je projecten kunnen verbeteren.
Deze pagina biedt installatie-instructies en release-informatie voor het DSPy-pakket.
Als je graag in Notebooks werkt, is de DSPy Colab Notebook een interactieve Colab-notebook om snel met DSPy aan de slag te gaan.
Tot slot kun je je aansluiten bij de Discord-server om in contact te komen met andere DSPy-gebruikers, vragen te stellen en ervaringen te delen.
Kortom, DSPy biedt een meer intuïtieve en krachtige manier om met AI te werken: weg van prompt engineering en richting het programmeren van foundation modellen. Laten we samenvatten wat we in dit artikel hebben behandeld:
Blijf tijdens je werk met DSPy de communityresources gebruiken. Blijf ook op de hoogte van wat er nieuw is in dit snel evoluerende veld—ik raad aan deze blogposts te lezen als je meer wilt leren over de nieuwste ontwikkelingen:
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

