
Hoe data lineage de vertrouwenskwestie oplost
Als een vriend je een statistiek vertelt die je niet vertrouwt, kun je vragen naar de bron om de juistheid te verifiëren. Informatie herleiden tot de bron is cruciaal om vertrouwen te creëren. Ditzelfde principe geldt voor data.
Transparantie door zichtbaarheid
Data lineage is een volledige geschiedenis van je data: van de bron, via elke transformatie, tot het uiteindelijke eindpunt. Dit verslag geeft een helder beeld van de reis van de data.
Een data lineage biedt volledige transparantie door elke stap in de datapijplijn te documenteren, van de eerste verzameling tot de uiteindelijke analyse. Deze zichtbaarheid is cruciaal om vertrouwen op te bouwen, omdat belanghebbenden precies kunnen zien hoe je data is verwerkt en getransformeerd.
Je kunt het zien als het laten zien van je tussenstappen bij wiskunde. In de klas laten je tussenstappen de docent elke stap in je oplossingsproces zien en bewijzen ze dat je niet hebt afgekeken. Een data lineage is als het tonen van je tussenstappen voor je pijplijn.
Sneller debuggen en betere kwaliteit
Je tussenstappen tonen bij je wiskundehuiswerk helpt de docent (en jou) ook te begrijpen waar je een fout hebt gemaakt als je op een verkeerd antwoord uitkomt. Dat helpt je de fout te herstellen en je begrip te verbeteren.
Op dezelfde manier helpt het tonen van je werk in een data lineage om fouten in een pijplijn te vinden. Fouten in data naar hun bron herleiden is vaak een flinke klus. Een uitgebreide data lineage vereenvoudigt dit proces doordat je het pad van de data kunt volgen om te vinden waar het misging. Met dit snellere debugproces krijg je betere datakwaliteit, wat vertrouwen bevordert.
Je kunt meer leren over het borgen van datakwaliteit in deze Introductie tot Datakwaliteit-cursus.
Aantonen van dataherkomst
Dataherkomst is een metadataspoor van de afstamming (lineage) van de data. Veel sectoren hebben regels die bewijs van dataherkomst vereisen, vooral sectoren die met gevoelige informatie werken, zoals zorg en financiën.
Bewijs van dataherkomst tonen houdt in dat je laat zien waar data vandaan komt en hoe ermee is omgegaan. Data lineage biedt een audittrail die aan deze vereisten voldoet en de volledige levenscyclus van data laat zien. Naast het bevorderen van vertrouwen kan een audittrail laten zien dat je data voldoet aan privacywetgeving, governancebeleid en andere regels.
Data lineage volgt de datastroom
Een volledige data lineage legt vast welk pad data bij elke stap aflegt. Hier is een voorbeeld van hoe data van de bron naar een visualisatie kan stromen.
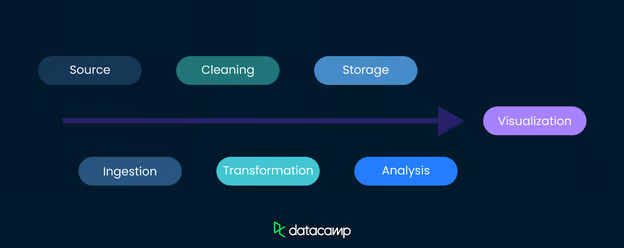
Databron: wat is de context?
Data lineage begint bij de bron. Dat kan een database, API, sensor, enquête of een ander verzamelpunt zijn. Begrijpen waar data vandaan komt is de eerste en belangrijkste stap om de reis te volgen.
De bron van de data geeft context en achtergrond. Ze kan ook een hint geven over eventuele biases en beperkingen in de dataverzameling.
Om het belang van de databron te illustreren, zie deze hypothetische datasets en hun bronnen.
|
Dataset |
Bron |
Mogelijke biases/beperkingen |
|
Hydratiebehoefte |
Bedrijf dat flessenwater verkoopt |
Kan de hydratiebehoefte overschatten om productverkoop te stimuleren. |
|
Bloeddrukdata bij patiënten met verschillende diëten |
Wereldberoemd researchziekenhuis |
Kleiner risico op significante bias, maar mogelijke financieringsbias of selectiebias in patiëntsamples. |
|
Internetgebruik in landelijke gebieden van ontwikkelingslanden |
Kleine NGO met beperkte middelen |
Kan middelen missen voor uitgebreide dataverzameling, wat kan leiden tot steekproefbias of beperkte geografische dekking. |
|
Energieverbruik en milieu-impact van hernieuwbare energie |
Groot oliebedrijf |
Kan de voordelen van hernieuwbare energie bagatelliseren of uitdagingen overdrijven om bestaande belangen te beschermen. |
|
Voorkomen van hart- en vaatziekten |
Centers for Disease Control and Prevention (CDC) |
Gezaghebbende bron, maar mogelijke beperkingen in methoden voor dataverzameling of onderrapportage in bepaalde demografieën. |
|
Veiligheid en efficiëntie van een nieuwe lijn elektrische auto's |
Autofabrikant die de elektrische voertuigen produceert |
Kan veiligheid en efficiëntie overdrijven om verkoop te stimuleren; mogelijke gebrek aan transparantie in testmethoden. |
|
Effectiviteit van een nieuw medicijn |
Onafhankelijke waakhondorganisatie |
Kleiner risico op significante bias, maar kans op financieringsbias of belangenconflicten bij banden met farmaceutische bedrijven. |
|
Klanttevredenheid over een nieuwe smartphone |
Smartphonefabrikant |
Kan tevredenheidscijfers opblazen om verkoop te stimuleren; risico op bevooroordeeld enquête-ontwerp of selectieve sampling. |
Transformaties: hoe is de data gewijzigd?
Toen een vriendin uit de Verenigde Staten Australië bezocht, vertelde ze de locals dat het thuis momenteel meer dan 100° was. Ze waren geschokter dan verwacht, tot iedereen zich realiseerde dat de VS Fahrenheit gebruikt en Australië Celsius. Ze dachten dat ze 100 °C bedoelde, wat 212 °F is! Maar ze bedoelde 100 °F, ongeveer 37 °C.
Gelukkig werd dit misverstand snel ter plekke opgelost, maar stel je een soortgelijk scenario voor in een dataset. Denk aan een dataset waarin temperatuur is omgezet van Fahrenheit naar Celsius, maar het eenheidslabel niet is aangepast en nog steeds Fahrenheit aangeeft. Dan krijg je hele rare resultaten!
Dit laat zien waarom het documenteren van datatransformaties een belangrijk onderdeel is van een data lineage. Als een eindgebruiker van de data, zoals een data-analist, resultaten ziet die niet kloppen (zoals een stad die regelmatig kokende luchttemperaturen ervaart), kan die eenvoudig terugkijken in de data lineage, de transformatie zien die niet is gelabeld en het probleem corrigeren.
Terwijl data van de bron naar de uiteindelijke bestemming gaat, ondergaat ze vaak tal van transformaties, zoals opschonen, filteren en aggregeren om de data geschikt te maken voor het beoogde gebruik. Maar elke transformatie verandert ook de manier waarop je de data interpreteert en moet worden vastgelegd.
Een heldere data lineage documenteert deze transformaties, zodat elke wijziging is vastgelegd en herleidbaar is, wat de transparantie vergroot. Dit verhoogt het vertrouwen in je data en maakt debuggen eenvoudiger.
Bestemming: waar is de data naartoe gegaan?
De laatste fase in je datastroom is waar de data wordt opgeslagen en gebruikt. Dat kan in datawarehouses, reportingtools of andere analytische platforms zijn. Data lineage volgt de data helemaal tot aan deze eindpunten en geeft zo een compleet beeld van de reis, zodat stakeholders de data die ze zien kunnen vertrouwen.
Het documenteren van de bestemming van je data is ook belangrijk voor de beveiliging, omdat het vastlegt wie toegang heeft tot welke data.
Uitdagingen bij het implementeren van data lineage
Data lineage opzetten lijkt misschien eenvoudig—houd gewoon bij waar data vandaan komt en wat ermee gebeurt. Toch zijn er verschillende uitdagingen die dit proces kunnen bemoeilijken. Laten we er een paar bekijken.
Complexe datapijplijnen
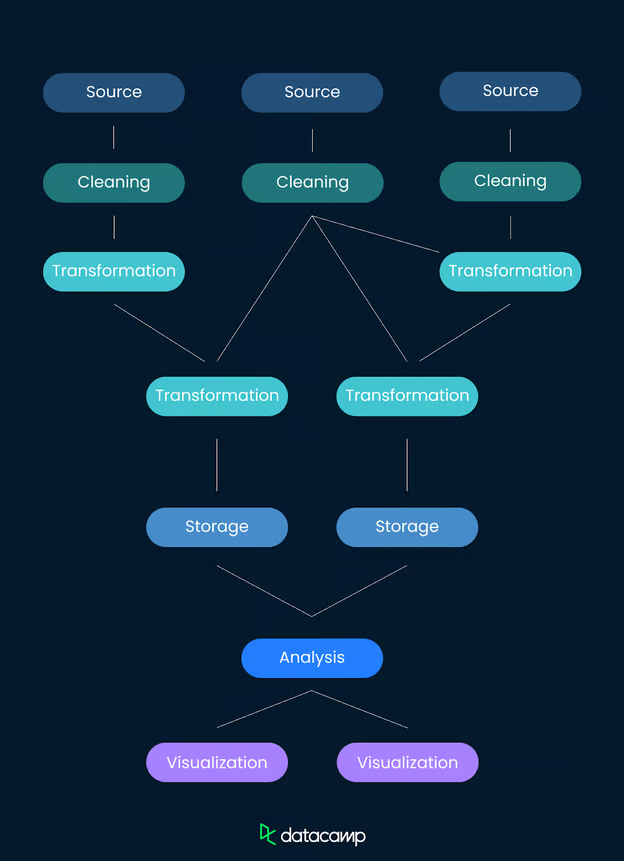
Een van de grootste uitdagingen bij het creëren van een data lineage is de omvang en complexiteit van moderne datapijplijnen. Moderne dataomgevingen omvatten vaak ingewikkelde datastromen over meerdere systemen en platforms. Het bijhouden van deze gedetailleerde paden vereist robuuste tools en zorgvuldige planning.
Een eenvoudige pijplijn met één inputbron en beperkte transformaties is relatief makkelijk vast te leggen. Maar bij een complexe pijplijn met meerdere inputs, veel transformaties en misschien verschillende bestemmingen wordt het bijhouden in een data lineage ingewikkelder. En ook noodzakelijker.
Handmatige documentatie
Data lineage kan handmatig of automatisch worden gedocumenteerd. Handmatig documenteren is tijdrovend en foutgevoelig. Handmatig dataverplaatsingen en transformaties bijhouden, zeker in een grote operatie, is inefficiënt en vergroot de kans op onnauwkeurigheden, wat het vertrouwen dat data lineage juist wil opbouwen ondermijnt.
Voor heel kleine pijplijnen die volledig door één persoon worden beheerd, kan handmatige data lineage volstaan. Maar naarmate het complexer wordt, moet de documentatie meer geautomatiseerd zijn. In de volgende sectie bespreken we enkele hulpmiddelen om dat te doen.
Integratie met bestaande systemen
Als data lineage niet vanaf het begin in een pijplijn is ingebouwd, kan het achteraf integreren tijdrovend en arbeidsintensief zijn. Het aanpassen van je huidige infrastructuur om uitgebreide lineage-tracking te ondersteunen vereist vaak aanzienlijke wijzigingen, wat voor sommige organisaties een drempel is. Dit is een reden om lineage-oplossingen vanaf het begin te integreren.
Hoe bouw je een data lineage?
Als je je data lineage niet handmatig gaat documenteren, heb je een paar kernonderdelen nodig: je moet metadata over je datasets verzamelen en een catalogus voor die metadata hebben.
Verzamelen en beheren van metadata
Metadata is in feite data over data. Het verwijst naar informatie zoals de herkomst, structuur, transformaties en het gebruik van je data. Effectief metadatabeheer omvat het verzamelen van metadata uit verschillende bronnen, het volgen van datatransformaties en het documenteren van dataverplaatsingen. Dit verzamelen en beheren is vaak geautomatiseerd, zodat elke wijziging wordt vastgelegd en herleidbaar is. Dit geeft een compleet beeld van je data lineage.
Datacatalogi
Datacatalogi zijn uitgebreide repositories die metadata opslaan over de data-assets van een organisatie, waaronder herkomst, transformaties en bestemmingen. Ze automatiseren vaak de ontdekking, beschrijving en organisatie van data-assets, waardoor het eenvoudiger wordt om data lineage te beheren, vertrouwen te bevorderen en te voldoen aan datagovernancebeleid.
Tools voor data lineage
Er zijn veel kant-en-klare tools beschikbaar om je te helpen je data lineage te volgen. Hier is een korte lijst met populaire tools.
|
Toolnaam |
Type |
Belangrijkste features |
|
Betaald |
Gecentraliseerd metadatabeheer, visualisatie van datastromen, ondersteunt een breed scala aan databronnen | |
|
Betaald |
Gedetailleerd inzicht in dataverplaatsing en -transformatie, borgt datakwaliteit en compliance | |
|
Betaald |
Geavanceerde lineage-visualisatie, interactieve diagrammen, integratie met datagovernance | |
|
Betaald |
Tools voor dataintegratie en -integriteit, gedetailleerde tracking van datatransformaties | |
|
Open source |
Metadatabeheer, legt data lineage vast, ontworpen voor Hadoop-systemen | |
|
Open source |
Automatiseert datastromen, ingebouwde lineage-tracking, monitort dataverplaatsingen | |
|
Open source |
Metadataservice voor het verzamelen en visualiseren van data lineage, integreert met diverse systemen | |
|
Open source |
Machinelearning-algoritmen voor automatische detectie en documentatie van datastromen |
Data lineage-functies ingebouwd in andere tools
Naast de bovenstaande tools bevatten veel ETL/ELT-tools, datavisualisatietools en datagovernanceplatforms lineage-functies. Deze tools automatiseren de documentatie van extractie-, transformatie- en laadprocessen en helpen datastromen over systemen te visualiseren.
Wist je bijvoorbeeld dat je je data lineage in PowerBI kunt zien? Bekijk de tools die je nu al in je pijplijnen gebruikt en ontdek hoeveel van je data lineage al wordt gevolgd!
Aangepaste oplossingen voor data lineage bouwen
Soms is een kant-en-klare oplossing niet praktisch en heeft een meer maatwerkbenadering de voorkeur. Als dat voor jou geldt, zijn hier enkele opties om een data lineage voor je pijplijn op te zetten.
Handmatige documentatie
Probeer eerst handmatig de datastromen en transformaties in je systeem te documenteren door gedetailleerde verslagen te maken van herkomst, processen en bestemmingen. Deze methode kan volstaan voor kleinere datasets of eenvoudige omgevingen die door één persoon of een klein team worden beheerd.
Als je datalandschap groter of complexer is, kun je ervoor kiezen alleen een high-level overzicht van je pijplijn handmatig te documenteren, zodat je gericht geautomatiseerde lineage-tracking kunt toevoegen. Handmatige documentatie biedt veel maatwerkmogelijkheden, maar is arbeidsintensief voor grote systemen.
Aangepaste scripts
Je kunt aangepaste scripts ontwikkelen in talen zoals Python om datatransformaties en -verplaatsingen vast te leggen en te loggen. Deze scripts kunnen in verwerkingspijplijnen worden geïntegreerd om delen van de documentatie te automatiseren. Deze aanpak is nuttig voor organisaties met specifieke eisen die niet volledig door bestaande tools worden gedekt of met middelgrote datacomplexiteit.
Databasetriggers
Een andere techniek is het implementeren van databasetriggers om wijzigingen en verplaatsingen van data in databases automatisch te loggen. Deze triggers kunnen elke insert-, update- of delete-operatie vastleggen en zo een logboek van de data-evolutie door de tijd bieden. Dit is ideaal voor organisaties met grote, complexe datalandschappen waar realtime tracking van datawijzigingen cruciaal is.
Versiebeheer voor data
Je kent versiebeheer wellicht als manier om de afstamming van codeversies te volgen. Vergelijkbare praktijken zijn ook voor data te gebruiken. Door versies van datasets bij te houden en wijzigingen tussen die versies te documenteren, kun je data lineage door de tijd volgen. Tools zoals Git zijn aan te passen voor dataversiebeheer. Deze methode is vooral nuttig voor organisaties die historische dataintegriteit moeten behouden en wijzigingen over lange perioden willen volgen.
Aangepaste visualisatietools
Je kunt aangepaste visualisaties maken om data lineage in kaart te brengen met netwerkvisualisatiebibliotheken zoals networkx in Python. Met deze bibliotheken kun je diagrammen genereren die datastromen en transformaties weergeven, zodat je de lineage makkelijker begrijpt en volgt. Deze aanpak past bij organisaties die sterk op maat gemaakte visualisaties nodig hebben en de technische expertise hebben om die te ontwikkelen.
Metadatabibliotheken
Als je veel metadata bijhoudt, is het logisch een gecentraliseerde metadatabibliotheek op te zetten om alle metadata over je data-assets op te slaan. Deze repository kan worden gebouwd met relationele databases of NoSQL-oplossingen en moet zo zijn ontworpen dat integratie met verwerkende systemen eenvoudig is om metadata actueel te houden.
Deze aanpak is ideaal voor organisaties met uitgebreide en diverse data-assets die een schaalbare en flexibele oplossing voor metadatabeheer nodig hebben. Begin met OpenMetadata voor enkele open-sourcetools.
Data lineage vs. codedocumentatie
Ik schrijf vaak over het belang van documentatie in code, en met reden. Documentatie is een cruciaal onderdeel van goed programmeerwerk. Data lineage is om veel van dezelfde redenen belangrijk als codedocumentatie. In veel opzichten kun je data lineage zien zoals documentatie—het is een spoor van bewijs dat elke stap vastlegt die je data heeft genomen.
In tegenstelling tot codedocumentatie is de creatie van data lineage vaak afhankelijk van metadata en automatisering. Terwijl documentatie vaak handmatig gebeurt (of tegenwoordig door AI), is data lineage vaak te complex en omvangrijk om handmatig te doen.
Documentatie verschijnt ook vaak als comments in de code, samen met een README-bestand. Data lineage wordt vaak gevisualiseerd via diagrammen en geautomatiseerde rapporten om de datastroom in je systeem te begrijpen.
Data lineage vs. datagovernance
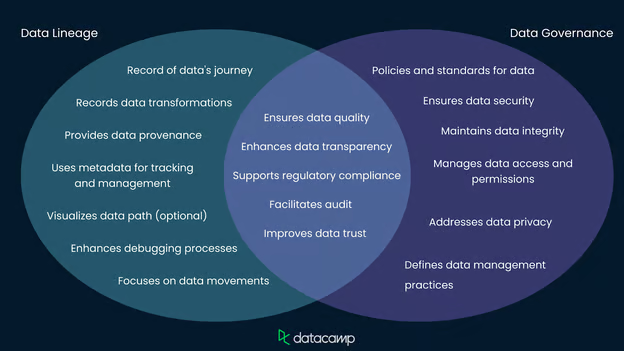
Data lineage en datagovernance zijn nauw verwante concepten in datamanagement. Data lineage volgt de reis van data door transformaties en systemen en levert een historisch verslag dat transparantie en traceerbaarheid garandeert. Datagovernance omvat intussen bredere beleidsregels en standaarden voor datakwaliteit, beveiliging en compliance. Data lineage kan de handhaving van datagovernancebeleid ondersteunen.
Organisaties kunnen governance-inspanningen versterken door tools en technieken voor data lineage te benutten, zodat dataintegriteit en naleving van regelgeving zijn geborgd. Samen vormen data lineage en governance een allesomvattende aanpak voor het beheren en beveiligen van data.
Je kunt meer leren over datagovernance in deze cursus over Data Governance Concepts. Je kunt ook een meer gevorderde kijk nemen op Hoe dataleiders datagovernance prioriteit kunnen geven.
Conclusie
Naarmate datalandschappen complexer worden, wordt data lineage steeds belangrijker. Het bouwt vertrouwen op door transparantie te bieden, sneller debuggen mogelijk te maken en dataherkomst aan te tonen.
Met vooruitgang in automatisering en visualisatie zal het belang van tools voor data lineage alleen maar blijven groeien, ter ondersteuning van robuuste praktijken voor datagovernance en -beheer.
Wil je meer leren, probeer dan deze cursus Understanding Data Engineering. Ik raad je ook aan om Responsible AI Data Management en Making Data Governance Fun te bekijken.

Ik ben gepromoveerd en heb 13 jaar ervaring met het werken met data in een biologische onderzoeksomgeving. Ik maak software in verschillende programmeertalen, waaronder Python, MATLAB en R. Ik deel met plezier mijn liefde voor leren met de wereld.


Heb je ooit een statistiek gelezen en gedacht: “Ik weet niet of ik dat geloof”?
Dat gebrek aan vertrouwen is vervelend als de statistiek onbelangrijk is, maar desastreus wanneer het gaat om cruciale bedrijfsdata, zoals het aantal nieuwe klanten dat je dit jaar hebt binnengehaald.
Vertrouwen in data is essentieel om weloverwogen, datagedreven beslissingen te nemen. De oplossing om het vertrouwen in je data te vergroten is een goed gedocumenteerde data lineage, die de reis van data volgt van herkomst tot eindgebruik.
Wil je meer leren over datamanagement? Lees dan dit artikel over data fabric. Bekijk ook onze webinar over hoe je de data- & AI-volwassenheid van je organisatie opbouwt.