
Come il Data Lineage risolve la sfida della fiducia
Quando un amico ti dice una statistica che non ti convince, puoi chiedere di conoscere la fonte per verificarne l'accuratezza. Risalire all'origine è fondamentale per costruire fiducia. Lo stesso principio vale per i dati.
Trasparenza attraverso la visibilità
Il data lineage è una cronologia completa dei tuoi dati, dalla fonte, attraverso ogni trasformazione, fino al punto di arrivo finale. Questo registro offre un quadro chiaro del viaggio dei dati.
Un data lineage offre piena trasparenza documentando ogni passaggio della pipeline dei dati, dalla raccolta iniziale all'analisi finale. Questa visibilità è cruciale per costruire fiducia, perché consente alle parti interessate di vedere esattamente come i tuoi dati sono stati elaborati e trasformati.
Puoi pensarlo come il "mostrare i passaggi" a lezione di matematica. In classe, mostrare il lavoro permette all'insegnante di vedere ogni step del tuo ragionamento e dimostra che non hai copiato. Un data lineage è come mostrare i passaggi per la tua pipeline.
Debug più rapido e qualità migliorata
Mostrare i passaggi nei compiti di matematica aiuta anche l'insegnante (e te) a capire dove hai commesso un errore se sei arrivato alla risposta sbagliata. Questo ti aiuta a correggere l'errore e a migliorare la comprensione dell'argomento.
Allo stesso modo, mostrare i passaggi in un data lineage può aiutarti a trovare gli errori in una pipeline. Risalire alla fonte di un errore è spesso un compito impegnativo quando si verificano errori nei dati. Un data lineage completo semplifica questo processo permettendoti di seguire il percorso dei dati per individuare dove le cose sono andate storte. Con questo processo di debug più veloce, avrai una qualità dei dati migliore, che a sua volta favorisce la fiducia.
Puoi approfondire come garantire la qualità dei dati in questo corso Introduction to Data Quality.
Dimostrare la provenienza dei dati
La provenienza dei dati è un record di metadati sul lineage dei dati. Molti settori hanno normative che richiedono la prova della provenienza, soprattutto quelli che gestiscono informazioni sensibili, come sanità e finanza.
Dimostrare la provenienza dei dati significa mostrare da dove hanno avuto origine e come sono stati trattati. Il data lineage fornisce una traccia di audit che soddisfa questi requisiti, mostrando l'intero ciclo di vita dei dati. Oltre a favorire la fiducia, una traccia di audit può dimostrare l'aderenza dei tuoi dati alle leggi sulla privacy, alle policy di governance e ad altre normative.
Il Data Lineage traccia il flusso dei dati
Un data lineage completo registra il percorso che i dati seguono a ogni passaggio. Ecco un esempio di come i dati possono fluire dalla sorgente fino a una visualizzazione.
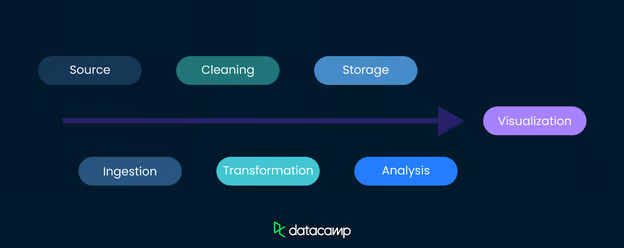
Fonte dei dati: qual è il contesto?
Il data lineage parte dalla fonte, che può includere database, API, sensori, sondaggi o altri punti di raccolta. Capire da dove hanno origine i dati è il primo e più importante passo per tracciarne il percorso.
La fonte dei dati fornisce contesto e background. Può anche suggerire eventuali bias e limitazioni nella raccolta dei dati.
Per dimostrare l'importanza della fonte, considera questi dataset ipotetici e le rispettive origini.
|
Dataset |
Fonte |
Possibili bias/limitazioni |
|
Fabbisogni di idratazione |
Azienda che vende acqua in bottiglia |
Potrebbe sovrastimare i fabbisogni di idratazione per favorire le vendite del prodotto. |
|
Pressione sanguigna in pazienti con diete diverse |
Ospedale di ricerca di fama mondiale |
Meno probabile che presenti bias significativi, ma possibile bias da finanziamenti o bias di selezione nei campioni di pazienti. |
|
Utilizzo di Internet nelle aree rurali dei paesi in via di sviluppo |
Piccola ONG con risorse limitate |
Potrebbe mancare delle risorse per una raccolta dati completa, con possibile bias di campionamento o copertura geografica limitata. |
|
Consumo energetico e impatto ambientale delle rinnovabili |
Grande compagnia petrolifera |
Potrebbe sminuire i benefici delle rinnovabili o enfatizzare le sfide per proteggere gli interessi di business esistenti. |
|
Prevalenza delle malattie cardiovascolari |
Centers for Disease Control and Prevention (CDC) |
Fonte autorevole, ma possibili limitazioni nelle metodologie di raccolta o sottodenuncia in alcune demografie. |
|
Sicurezza ed efficienza di una nuova linea di auto elettriche |
Casa automobilistica che produce i veicoli elettrici |
Potrebbe enfatizzare sicurezza ed efficienza per favorire le vendite, con possibile mancanza di trasparenza nelle metodologie di test. |
|
Efficacia di un nuovo farmaco |
Organizzazione indipendente di vigilanza |
Meno probabile che presenti bias significativi, ma possibile bias da finanziamenti o conflitti di interesse in caso di legami con aziende farmaceutiche. |
|
Tassi di soddisfazione dei clienti per un nuovo smartphone |
Azienda produttrice di smartphone |
Potrebbe gonfiare i tassi di soddisfazione per favorire le vendite, con possibile bias nel design del sondaggio o campionamento selettivo. |
Trasformazioni: come sono stati modificati i dati?
Quando un'amica dagli Stati Uniti ha visitato l'Australia, ha detto ai locali che nella sua città c'erano più di 100°. Erano più sorpresi del previsto finché tutti non si sono resi conto che negli USA si usa Fahrenheit e in Australia Celsius. Pensavano intendesse 100 °C, cioè 212 °F! Ma lei intendeva 100 °F, che sono circa 37 °C.
Per fortuna, questo equivoco è stato risolto rapidamente di persona, ma immagina uno scenario simile in un dataset. Immagina un dataset con temperature convertite da Fahrenheit a Celsius, ma con l'etichetta dell'unità non aggiornata, quindi ancora Fahrenheit. Potresti ottenere risultati davvero strani!
Questo dimostra perché documentare le trasformazioni è una parte importante del data lineage. Se un utilizzatore finale dei dati, come un data analyst, vede risultati nelle analisi che non hanno senso (come una città che sperimenta regolarmente temperature dell'aria d'ebollizione), può tornare facilmente al data lineage, individuare la trasformazione non etichettata e correggere il problema.
Quando i dati si spostano dalla fonte alla destinazione finale, spesso subiscono numerose trasformazioni, tra cui processi di pulizia, filtraggio e aggregazione che li preparano all'uso previsto. Tuttavia, ognuna di queste trasformazioni cambia anche il modo in cui i dati vengono interpretati e va documentata.
Un data lineage chiaro documenta queste trasformazioni, assicurando che ogni modifica sia registrata e tracciabile, migliorando la trasparenza. Questo aumenta la fiducia nei dati e rende il debug più semplice.
Destinazione: dove sono finiti i dati?
La fase finale del flusso dei dati è il luogo in cui i dati vengono archiviati e utilizzati. Può trattarsi di data warehouse, strumenti di reporting o altre piattaforme analitiche. Il data lineage traccia i dati fino a questi endpoint, offrendo un quadro completo del percorso e assicurando che gli stakeholder possano fidarsi dei dati che vedono.
Documentare la destinazione dei dati è importante anche per motivi di sicurezza, perché fornisce un registro di chi ha accesso a quali dati.
Sfide nell'implementazione del Data Lineage
Impostare un data lineage può sembrare semplice: basta tracciare da dove arrivano i dati e cosa viene fatto su di essi. Tuttavia, diverse sfide possono complicare questo processo. Vediamone alcune.
Pipeline di dati complesse
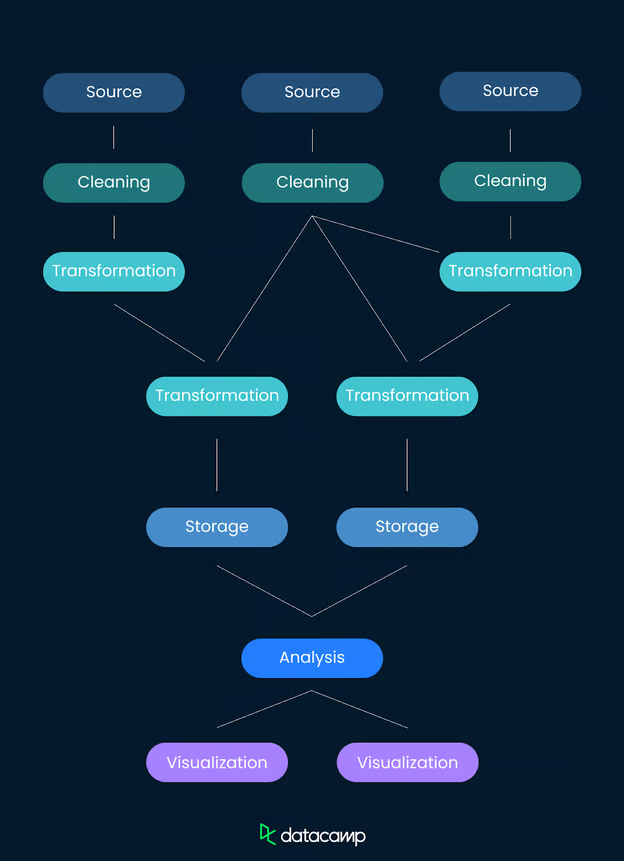
Una delle principali sfide nella creazione di un data lineage è la dimensione e la complessità di molte pipeline di dati moderne. Gli ambienti dati odierni spesso coinvolgono flussi intricati che attraversano più sistemi e piattaforme. Tenere traccia di questi percorsi dettagliati richiede strumenti robusti e un'attenta pianificazione.
Una pipeline semplice con una sola fonte di input e poche trasformazioni può essere relativamente facile da documentare. Ma se hai una pipeline complessa con molteplici input, numerose trasformazioni e magari diverse destinazioni, tenere traccia di tutto in un data lineage diventa più complicato. Ma diventa anche più necessario.
Documentazione manuale
Il data lineage può essere documentato manualmente o automaticamente. La documentazione manuale del data lineage può richiedere molto tempo ed essere soggetta a errori. Tracciare manualmente spostamenti e trasformazioni dei dati, soprattutto in una grande organizzazione, non è solo inefficiente ma aumenta anche il rischio di inesattezze, minando la fiducia che il data lineage mira a costruire.
Per pipeline molto piccole, completamente controllate da una persona, il data lineage manuale può essere sufficiente. Ma man mano che le cose si complicano, la documentazione del data lineage dovrebbe essere più automatizzata. Nella prossima sezione vedremo alcune risorse per aiutarti a farlo.
Integrazione con i sistemi esistenti
Se il data lineage non è stato integrato fin dall'inizio in una pipeline, aggiungerlo in un secondo momento può essere dispendioso in termini di tempo e risorse. Adattare l'infrastruttura attuale per supportare un tracciamento completo del data lineage spesso richiede cambiamenti significativi, che possono rappresentare una barriera per alcune organizzazioni. Questo è uno dei motivi per cui è importante integrare soluzioni di data lineage sin dall'inizio.
Come si costruisce un Data Lineage?
Se non prevedi di documentare manualmente il tuo data lineage, ti serviranno alcuni componenti chiave per crearne uno: dovrai raccogliere metadati sui tuoi dataset e avere un catalogo per quei metadati.
Raccolta e gestione dei metadati
I metadati sono, in sostanza, dati sui dati. Si riferiscono a informazioni come l'origine, la struttura, le trasformazioni e l'utilizzo dei tuoi dati. Una gestione efficace dei metadati implica raccoglierli da varie fonti, tracciare le trasformazioni e documentare gli spostamenti. Questa raccolta e gestione è spesso automatizzata, assicurando che ogni cambiamento sia registrato e tracciabile. Questo fornisce una visione completa del tuo data lineage.
Cataloghi dei dati
I cataloghi dei dati sono repository completi che memorizzano metadati sugli asset informativi di un'organizzazione, incluse origini, trasformazioni e destinazioni. Spesso automatizzano la scoperta, la descrizione e l'organizzazione degli asset, facilitando la gestione del data lineage, favorendo la fiducia e garantendo la conformità alle policy di data governance.
Strumenti per il Data Lineage
Esistono molti strumenti pronti all'uso per aiutarti a tracciare il tuo data lineage. Ecco un breve elenco di strumenti popolari.
|
Nome dello strumento |
Tipo |
Funzionalità principali |
|
A pagamento |
Gestione centralizzata dei metadati, visualizzazione del flusso dei dati, supporta un'ampia gamma di sorgenti | |
|
A pagamento |
Viste dettagliate di movimenti e trasformazioni, garantisce qualità e conformità dei dati | |
|
A pagamento |
Visualizzazione avanzata del lineage, diagrammi interattivi, integrazione con data governance | |
|
A pagamento |
Strumenti per integrazione e integrità dei dati, tracciamento dettagliato delle trasformazioni | |
|
Open source |
Gestione dei metadati, cattura del data lineage, progettato per sistemi Hadoop | |
|
Open source |
Automatizza i flussi di dati, funzionalità integrate di tracciamento del lineage, monitora gli spostamenti | |
|
Open source |
Servizio di metadati per raccogliere e visualizzare il data lineage, si integra con vari sistemi | |
|
Open source |
Algoritmi di machine learning per il rilevamento e la documentazione automatica dei flussi di dati |
Funzionalità di data lineage integrate in altri strumenti
Oltre agli strumenti sopra, molti strumenti ETL/ELT, strumenti di visualizzazione e piattaforme di data governance includono funzionalità di lineage. Questi strumenti automatizzano la documentazione dei processi di estrazione, trasformazione e caricamento e aiutano a visualizzare i flussi tra sistemi.
Per esempio, sapevi che puoi vedere il tuo data lineage in PowerBI? Controlla gli strumenti che già usi nelle tue pipeline e scopri quanto del tuo data lineage è già tracciato!
Costruire soluzioni personalizzate di Data Lineage
A volte, una soluzione pronta all'uso non è pratica e si preferisce una soluzione più personalizzata. Se è il tuo caso, ecco alcune opzioni che puoi esplorare per impostare un data lineage per la tua pipeline.
Documentazione manuale
Per prima cosa, prova a documentare manualmente i flussi e le trasformazioni nel tuo sistema creando registri dettagliati di origini, processi e destinazioni. Questo metodo può bastare per dataset più piccoli o ambienti semplici gestiti da una sola persona o da un piccolo team.
Tuttavia, se il tuo panorama dati è più ampio o complesso, potresti voler documentare manualmente solo una vista ad alto livello della pipeline per uso interno, così da individuare dove aggiungere il tracciamento automatico del lineage. La documentazione manuale consente un alto grado di personalizzazione ma può essere onerosa per sistemi di grandi dimensioni.
Script personalizzati
Puoi sviluppare script personalizzati con linguaggi come Python per catturare e registrare trasformazioni e spostamenti. Questi script possono essere integrati nelle pipeline di elaborazione per automatizzare parti della documentazione. Questo approccio è utile per organizzazioni con requisiti specifici non completamente coperti dagli strumenti esistenti o con una complessità dati moderata.
Trigger di database
Un'altra tecnica è implementare trigger di database per registrare automaticamente modifiche e spostamenti dei dati all'interno dei database. Questi trigger possono registrare operazioni di insert, update o delete eseguite su un database, fornendo un registro dell'evoluzione dei dati nel tempo. Questa tecnica è ideale per organizzazioni con paesaggi dati ampi e complessi, dove il tracciamento in tempo reale è cruciale.
Versionamento dei dati
Probabilmente conosci il controllo di versione come modo per tracciare il lineage delle versioni di codice. Pratiche simili possono essere usate anche per i dati. Tenendo traccia delle versioni dei dataset e documentando le modifiche tra versioni, puoi seguire il data lineage nel tempo. Strumenti come Git possono essere adattati al versionamento dei dati. Questo metodo è particolarmente utile per organizzazioni che devono mantenere l'integrità storica e tracciare i cambiamenti su lunghi periodi.
Strumenti di visualizzazione personalizzati
Puoi creare visualizzazioni personalizzate per mappare il data lineage usando librerie di visualizzazione di reti come networkx in Python. Con queste librerie puoi generare diagrammi che rappresentano flussi e trasformazioni, rendendo più semplice capire e tracciare il lineage. Questo approccio è adatto a organizzazioni che necessitano di visualizzazioni altamente su misura e hanno le competenze tecniche per svilupparle.
Repository di metadati
Se stai tracciando molti metadati, ha senso impostare un repository centralizzato per archiviare tutti i metadati relativi ai tuoi asset informativi. Questo repository può essere costruito usando database relazionali o soluzioni NoSQL e dovrebbe essere progettato per integrarsi facilmente con i sistemi di elaborazione per mantenere i metadati aggiornati.
Questo approccio è ideale per organizzazioni con asset informativi estesi e diversificati che necessitano di una soluzione scalabile e flessibile per la gestione dei metadati. Per iniziare, dai un'occhiata a OpenMetadata per alcuni strumenti open source.
Data Lineage vs. documentazione del codice
Scrivo spesso dell'importanza della documentazione nel codice, e a ragione. La documentazione è una parte fondamentale delle buone pratiche di sviluppo. Il data lineage è importante per molte delle stesse ragioni della documentazione del codice. Sotto molti aspetti, puoi pensare al data lineage come alla documentazione: è una traccia di evidenze che documenta ogni passo compiuto dai tuoi dati.
A differenza della documentazione del codice, però, i data lineage spesso si basano su metadati e automazione per la loro creazione. Mentre la documentazione è spesso manuale (o oggi fatta dall'AI), il data lineage è spesso troppo complesso e voluminoso per essere svolto manualmente.
La documentazione si presenta spesso sotto forma di commenti nel codice e di un file README. Il data lineage è spesso visualizzato tramite diagrammi e report automatizzati per comprendere il flusso dei dati nel sistema.
Data Lineage vs. Data Governance
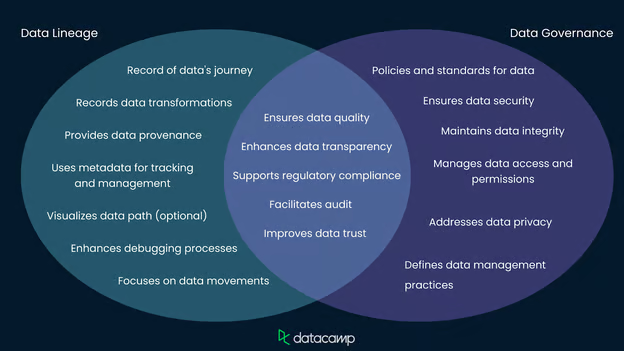
Data lineage e data governance sono concetti strettamente correlati nella gestione dei dati. Il data lineage traccia il viaggio dei dati attraverso trasformazioni e sistemi, fornendo un resoconto storico che assicura trasparenza e tracciabilità. La data governance, invece, comprende policy e standard più ampi per qualità, sicurezza e conformità dei dati. I data lineage possono supportare l'applicazione delle policy di governance.
Le organizzazioni possono migliorare gli sforzi di governance sfruttando strumenti e tecniche di data lineage, garantendo l'integrità dei dati e la conformità ai requisiti normativi. Insieme, data lineage e governance creano un approccio completo alla gestione e alla sicurezza dei dati.
Puoi saperne di più sulla data governance in questo corso su Data Governance Concepts. Puoi anche approfondire con How Data Leaders Can Make Data Governance a Priority.
Conclusione
Con l'aumentare della complessità dei paesaggi dati, i data lineage stanno diventando sempre più vitali. Costruiscono fiducia offrendo trasparenza, abilitando un debug più rapido e dimostrando la provenienza dei dati.
Con i progressi nell'automazione e nella visualizzazione, l'importanza degli strumenti di data lineage continuerà a crescere, supportando pratiche robuste di governance e gestione dei dati.
Se vuoi saperne di più, prova il corso Understanding Data Engineering. Ti consiglio anche di dare un'occhiata a Responsible AI Data Management e Making Data Governance Fun.

Sono un PhD con 13 anni di esperienza nel lavoro con i dati in un contesto di ricerca biologica. Creo software in diversi linguaggi di programmazione, tra cui Python, MATLAB e R. Sono appassionato di condividere con il mondo il mio amore per l’apprendimento.





Ti è mai capitato di leggere una statistica e pensare: "Non sono sicuro che sia vera"?
Questa mancanza di fiducia può essere fastidiosa quando la statistica è banale, ma devastante quando riguarda dati aziendali critici, come il numero di nuovi clienti acquisiti quest'anno.
La fiducia nei dati è fondamentale per prendere decisioni informate e guidate dai dati. La soluzione per aumentare la fiducia nei tuoi dati è un data lineage ben documentato, che traccia il percorso dei dati dall'origine fino all'uso finale.
Se vuoi saperne di più sulla gestione dei dati, dai un'occhiata a questo articolo sul data fabric. Dai un'occhiata anche al nostro webinar su come costruire la maturità in data & AI della tua organizzazione.