
数据血缘如何化解信任难题
当朋友告诉您一项您不太信的统计数据时,您可以要求其提供来源以核实准确性。将信息追溯至来源对于建立信任至关重要。对数据同样如此。
可见性带来透明度
数据血缘记录了数据的完整历史:从来源,经由每一次转换,直到最终落点。这份记录清晰呈现了数据的旅程。
数据血缘通过记录数据管道的每一步——从最初收集到最终分析——实现完全透明。这种可见性对于建立信任至关重要,使相关方能够准确了解数据是如何被处理与转换的。
您可以把它理解为数学课上“写清解题过程”。在课堂上,写出过程让老师看到您解决问题的每一步,并证明您没有抄袭同桌。数据血缘就像为您的数据管道“写清过程”。
更快调试与更优质量
在数学作业中写出过程还能帮助老师(以及您自己)定位出错环节,从而纠正错误并加深理解。
类似地,在数据血缘中“写清过程”有助于发现管道中的错误。数据出错时,回溯错误源头常常很困难。完善的数据血缘通过沿着数据路径回溯问题,简化了这一过程。借助更快速的调试,数据质量将得到提升,进一步增强信任。
您可以在这门数据质量入门课程中了解更多保障数据质量的方法。
证明数据来源(Data Provenance)
数据来源是关于数据血缘的元数据记录。许多行业,尤其是处理敏感信息(如医疗与金融)的行业,都有法规要求提供数据来源的证明。
证明数据来源需要展示数据的起源及其处理方式。数据血缘通过审计追踪满足这些要求,展示数据的完整生命周期。除了增强信任,审计追踪还可展示您的数据如何遵循隐私法、治理政策及其他合规要求。
数据血缘追踪数据流
完整的数据血缘会记录数据在每一步所经历的路径。以下示例展示了数据如何从来源流向可视化。
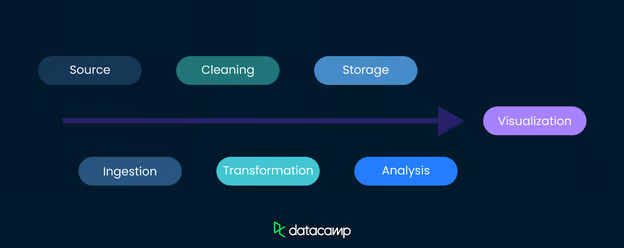
数据来源:背景是什么?
数据血缘从来源开始,来源可能包括数据库、API、传感器、问卷调查或其他采集点。了解数据从何而来,是追踪其旅程的首要且最重要的一步。
数据来源为数据提供了背景与上下文,也可能提示数据采集过程中存在的偏差与局限。
为说明数据来源的重要性,请考虑以下假设数据集及其来源。
|
数据集 |
来源 |
潜在偏差/局限 |
|
补水需求 |
瓶装水销售公司 |
可能高估补水需求以促进产品销售。 |
|
不同饮食下患者的血压数据 |
世界知名研究型医院 |
出现显著偏差的可能性较低,但仍可能存在资金来源偏差或受试者样本选择偏差。 |
|
发展中国家农村地区的互联网使用数据 |
资源有限的小型非政府组织 |
可能缺乏全面采集所需资源,导致抽样偏差或地理覆盖有限。 |
|
可再生能源的能耗与环境影响 |
大型石油公司 |
可能弱化可再生能源的益处或夸大挑战,以保护既有业务利益。 |
|
心血管疾病流行情况 |
美国疾病控制与预防中心(CDC) |
权威来源,但在数据采集方法上可能存在局限,或在某些人群中存在低报。 |
|
新系列电动车的安全性与效率 |
生产该电动车的汽车制造商 |
可能夸大安全性与效率以促进销售,测试方法的透明度可能不足。 |
|
新药的有效性 |
独立监察机构 |
显著偏差的可能性较低,但若与制药公司存在联系,仍可能存在资金来源偏差或利益冲突。 |
|
新款智能手机的客户满意度 |
智能手机制造公司 |
可能夸大满意度以促进销售,问卷设计或抽样方式可能存在偏差。 |
转换:数据发生了哪些变化?
我有位来自美国的朋友去澳大利亚旅游时,告诉当地人她家乡现在气温“超过100°”。对方比她预期更惊讶,直到大家意识到美国使用华氏度,而澳大利亚使用摄氏度。他们以为她说的是100 °C(相当于212 °F)!但她的意思其实是100 °F,约等于37 °C。
所幸,这个误会当面很快就澄清了。但想象一下在数据集中发生类似情形:某个温度数据集从华氏度转换为摄氏度,却没有更改单位标签,仍标记为华氏度。这会导致非常离谱的结果!
这说明为什么记录数据转换是数据血缘的重要组成部分。如果数据的终端使用者(比如数据分析师)在分析中看到不合常理的结果(例如某城市经常出现“沸腾”的气温),他们就能回看数据血缘,发现那个未正确标注的转换,从而修正问题。
数据从来源到最终落点的过程中,通常会经历多次转换,包括清洗、筛选与聚合等,以便满足预期用途。然而,每一步转换都会改变数据的解读方式,因此都需要被记录。
清晰的数据血缘会记录这些转换,确保每一次变更都有据可查,加强透明度,既提升数据信任度,也使调试更轻松。
目的地:数据去了哪里?
数据流的最后阶段是数据的存储与使用之处,可能是数据仓库、报表工具或其他分析平台。数据血缘会一直追踪到这些终点,呈现完整旅程,确保相关方可以信任他们所看到的数据。
记录数据的最终去向对于安全同样重要,因为它能明确哪些人可以访问哪些数据。
实施数据血缘的挑战
建立数据血缘看似简单——只要追踪数据从何而来、经历了什么即可。然而,多个挑战会使这一过程变得复杂。我们来看几个。
复杂的数据管道
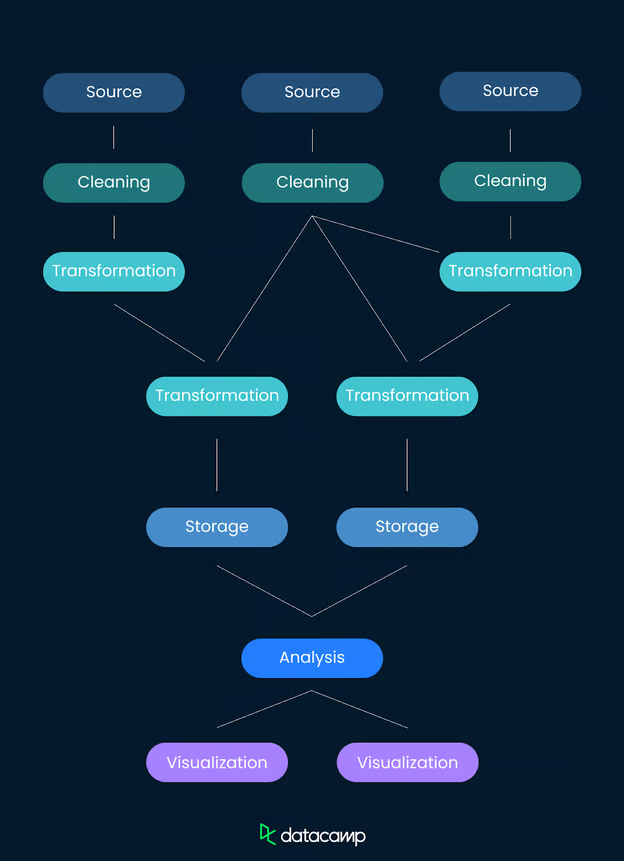
构建数据血缘的主要难点之一在于现代数据管道的规模与复杂性。现代数据环境常包含跨多个系统与平台的复杂数据流。要追踪这些细致路径,需要强大的工具与周密的规划。
若管道只有单一输入、少量转换,建立数据血缘相对容易。但当管道包含多个输入、大量转换,甚至多个目的地时,要在血缘中完整追踪就更复杂,同时也更加必要。
手动文档化
数据血缘可以手动或自动记录。手动记录既耗时又易出错。尤其在大型环境中,手动追踪数据移动与转换效率低且更易不准确,从而削弱数据血缘本应建立的信任。
对于由单人完全掌控的很小型管道,手工数据血缘或许足够。但随着复杂度提升,就应尽量自动化记录。在下一节,我们将介绍一些可用资源。
与现有系统集成
如果数据管道最初未纳入数据血缘,再行补充往往耗时且资源密集。为支持全面的血缘追踪而改造现有基础设施,通常需要较大调整,这可能成为一些组织的阻碍。因此,从一开始就集成数据血缘方案尤为重要。
如何构建数据血缘?
如果您不打算手动记录数据血缘,您需要几项关键组件来构建它:需要收集数据集的元数据,并为这些元数据建立目录。
元数据采集与管理
元数据本质上是“关于数据的数据”,例如数据的来源、结构、转换及使用情况。有效的元数据管理包括从多源采集元数据、追踪数据转换、记录数据流转。这些采集与管理通常自动化进行,确保每次变更都被记录并可追溯,从而提供数据血缘的全景视图。
数据目录
数据目录是用于存储组织数据资产元数据的综合性库,包括其来源、转换与目的地。它们通常会自动化地发现、描述与组织数据资产,便于管理数据血缘、建立信任,并确保遵循数据治理政策。
数据血缘工具
有许多现成工具可用于帮助您追踪数据血缘。以下是一些常用工具的简短清单。
|
工具名称 |
类型 |
关键特性 |
|
付费 |
集中化元数据管理、数据流可视化、支持广泛的数据源 | |
|
付费 |
细粒度的数据移动与转换视图,确保数据质量与合规 | |
|
付费 |
高级血缘可视化、交互式图表、与数据治理集成 | |
|
付费 |
数据集成与数据完整性工具,对数据转换进行细致追踪 | |
|
开源 |
元数据管理、捕获数据血缘、为 Hadoop 系统设计 | |
|
开源 |
自动化数据流、内置血缘追踪功能、监控数据移动 | |
|
开源 |
用于收集与可视化数据血缘的元数据服务,可与多种系统集成 | |
|
开源 |
利用机器学习算法自动检测与记录数据流 |
集成于其他工具的数据血缘功能
除上述工具外,许多ETL/ELT工具、数据可视化工具与数据治理平台也内置血缘功能。这些工具可自动记录数据抽取、转换与加载过程,并帮助可视化跨系统的数据流。
例如,您是否知道可以在PowerBI 中查看数据血缘?不妨检查一下您当前在数据管道中使用的工具,看看已有多少数据血缘被自动追踪!
构建定制化数据血缘方案
有时,现成方案并不实用,定制化方案更为合适。如果您正是这种情况,以下是为管道搭建数据血缘时可探索的几种方式。
手动文档化
首先,尝试手动记录系统中的数据流与转换,建立关于数据来源、处理过程与目的地的详细记录。对于较小数据集或由个人/小团队管理的简单数据环境,这种方法可能已足够。
但若您的数据版图更大或更复杂,您也可以只手动记录管道的高层视图,以便明确应在何处添加自动化血缘追踪。手动文档化可高度自定义,但在大型系统中会较为费力。
自定义脚本
您可以使用 Python 等编程语言开发自定义脚本,以捕获并记录数据转换与移动。这些脚本可集成到数据处理管道中,自动化部分文档化流程。对于现有工具难以完全满足的特定需求,或中等复杂度的数据环境,这是一种实用方法。
数据库触发器
您还可以实现数据库触发器,自动记录数据库内的数据变更与移动。触发器可记录对数据库执行的插入、更新、删除操作,提供数据随时间演变的日志。对于数据版图庞大复杂、且需要实时追踪数据变更的组织,这尤其适用。
数据的版本控制
您也许熟悉代码版本控制用于追踪代码版本血缘。类似的版本控制实践同样适用于数据。通过记录数据集的各个版本并记录版本间的变化,您可以长期追踪数据血缘。Git 等工具可被用于数据版本化。对于需要维护历史数据完整性、并长期追踪变更的组织,这种方法尤为有益。
自定义可视化工具
您可以使用 Python 的networkx等网络可视化库,创建自定义可视化来绘制数据血缘。借助这些库,您可以生成展示数据流与转换的图示,更易于理解与追踪血缘。此方法适合需要高度定制化可视化、且具备相应技术能力的组织。
元数据存储库
如果需要追踪大量元数据,建立集中式元数据存储库很有必要,用于保存与数据资产相关的全部元数据。该存储库可基于关系型数据库或 NoSQL 方案构建,并应便于与数据处理系统集成以保持元数据的实时更新。
此方法适用于数据资产广泛多样、且需要可扩展、灵活元数据管理方案的组织。作为起点,您可以了解开源工具 OpenMetadata。
数据血缘 vs. 代码文档
我经常强调代码文档的重要性,这是有充分理由的:文档是良好编码实践的关键要素。数据血缘之所以重要,与代码文档有许多相似之处。在很多方面,您可以像看待文档一样看待数据血缘——它是记录数据每一步旅程的“证据链”。
不过,与代码文档不同,数据血缘的建立往往依赖元数据与自动化。尽管当下文档常由人工(或由 AI)编写,数据血缘通常过于复杂与庞大,难以完全手工完成。
代码文档常体现为代码内注释与 README;而数据血缘则常通过图示与自动化报告来可视化,以便理解系统中的数据流。
数据血缘 vs. 数据治理
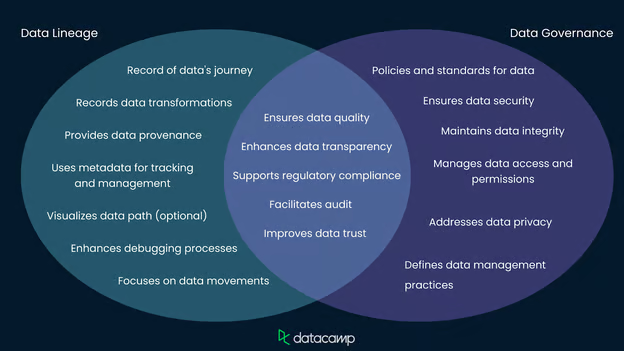
数据血缘与数据治理是数据管理中密切相关的概念。数据血缘追踪数据在各类转换与系统中的旅程,提供确保透明与可追溯的历史记录。与此同时,数据治理涵盖关于数据质量、安全与合规的更广泛政策与标准。数据血缘可用于支持数据治理政策的执行。
组织可借助数据血缘的工具与技术来强化治理工作,确保数据完整性并满足监管要求。二者结合,可形成管理与保护数据的全面方法。
您可以在数据治理概念课程中了解更多数据治理内容。您也可以通过数据领导者如何将数据治理置于优先级获取更深入的见解。
结论
随着数据版图日益复杂,数据血缘的重要性与日俱增。它通过提供透明性、加速调试与证明数据来源来建立信任。
随着自动化与可视化的发展,数据血缘工具的重要性只会继续提升,从而支持健全的数据治理与管理实践。
如果您希望进一步学习,可尝试这门理解数据工程课程。我也建议您看看负责任的 AI 数据管理以及让数据治理变得有趣。

我拥有博士学位,在生物研究环境中从事数据相关工作已有13年。我使用包括 Python、MATLAB 和 R 在内的多种编程语言开发软件。我热衷于与世界分享我对学习的热爱。
您是否曾读到一项统计数据并想过:“我不确定这是否可信”?
当统计数据无关紧要时,这种不信任或许只会令人烦恼;但一旦涉及关键业务数据(例如本年度新增客户数),后果就可能十分严重。
在进行明智、数据驱动的决策时,信任至关重要。提升数据可信度的方案是完善记录的数据血缘,它追踪数据从起点到最终使用的完整旅程。
如果您想进一步了解数据管理,请查看这篇关于数据织网(data fabric)的文章。您也可以观看我们的网络研讨会,探讨如何打造组织的数据与人工智能成熟度。