
Kurs
Grundlagen von Data Engineering
2 Std.
372.2K
Verschaffe deinem Team Zugang zur gesamten DataCamp-Bibliothek mit zentralisierten Berichten, Aufgaben, Projekten und mehr
Wenn dir ein Freund eine Statistik nennt, der du nicht traust, fragst du nach der Quelle, um sie zu überprüfen. Informationen bis zur Quelle zurückzuverfolgen, ist entscheidend für Vertrauen. Dasselbe gilt für Daten.
Data Lineage ist die vollständige Historie deiner Daten – von der Quelle über jede Transformation bis zum Endpunkt. Diese Aufzeichnung zeigt den Weg der Daten klar und nachvollziehbar.
Eine Data Lineage schafft volle Transparenz, indem sie jeden Schritt in der Datenpipeline dokumentiert – von der Erhebung bis zur Analyse. Diese Sichtbarkeit ist zentral, um Vertrauen aufzubauen, weil alle Beteiligten genau sehen, wie Daten verarbeitet und verändert wurden.
Du kannst es dir vorstellen wie das „Rechenweg zeigen“ im Matheunterricht. So erkennt die Lehrkraft jeden Schritt deiner Lösung und weiß, dass du nicht abgeschrieben hast. Eine Data Lineage ist der gezeigte Rechenweg für deine Pipeline.
Der gezeigte Rechenweg hilft auch, Fehler zu finden, wenn das Ergebnis nicht stimmt. So kannst du korrigieren und dein Verständnis verbessern.
Genauso hilft die Data Lineage, Fehler in einer Pipeline zu finden. Fehler bis zur Quelle zurückzuverfolgen, ist oft mühsam. Eine umfassende Data Lineage vereinfacht das, weil du dem Datenpfad folgen kannst, bis du die Ursache findest. Durch schnelleres Debugging steigt die Datenqualität – und damit das Vertrauen.
Mehr über Datenqualität erfährst du im Kurs Introduction to Data Quality.
Datenherkunft (Data Provenance) ist eine Metadaten-Aufzeichnung der Abstammung von Daten. Viele Branchen verlangen regulatorisch den Nachweis der Datenherkunft – besonders dort, wo sensible Informationen verarbeitet werden, etwa im Gesundheitswesen oder in der Finanzbranche.
Der Nachweis umfasst, wo Daten entstanden sind und wie sie verarbeitet wurden. Data Lineage liefert eine Audit-Trail-Historie über den gesamten Datenlebenszyklus. Neben dem Vertrauensaufbau zeigt ein Audit Trail auch die Einhaltung von Datenschutzgesetzen, Governance-Richtlinien und weiteren Vorgaben.
Eine vollständige Data Lineage zeichnet den Pfad der Daten in jedem Schritt auf. So könnte der Weg von der Quelle bis zur Visualisierung aussehen.
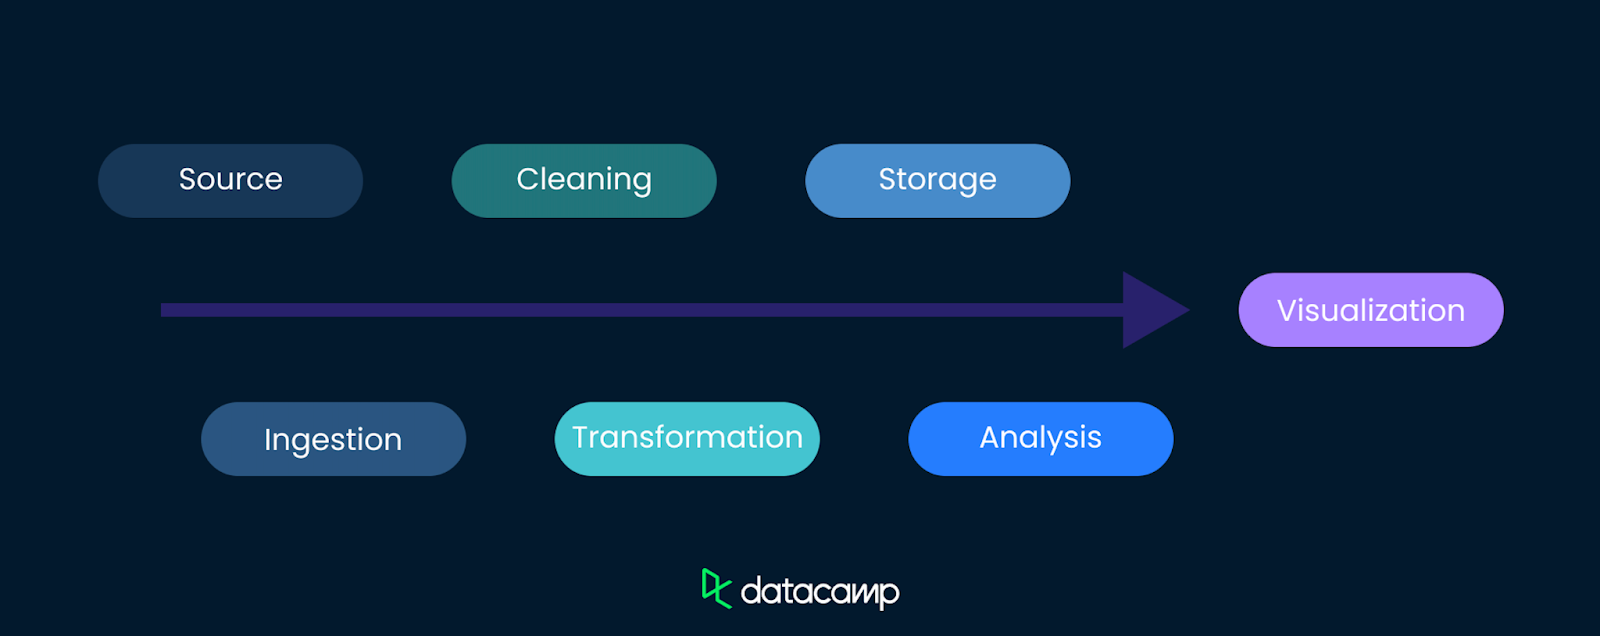
Data Lineage beginnt an der Quelle – etwa Datenbanken, APIs, Sensoren, Umfragen oder anderen Erhebungspunkten. Zu wissen, woher Daten stammen, ist der erste und wichtigste Schritt.
Die Quelle liefert Kontext und Hintergründe und kann Hinweise auf Verzerrungen oder Limitierungen der Datenerhebung geben.
Zur Veranschaulichung findest du hier hypothetische Datensätze mit ihren Quellen.
|
Datensatz |
Quelle |
Mögliche Verzerrungen/Limitierungen |
|
Flüssigkeitsbedarf |
Unternehmen, das abgefülltes Wasser verkauft |
Könnte den Bedarf überschätzen, um den Absatz zu fördern. |
|
Blutdruckdaten von Patientinnen und Patienten mit unterschiedlichen Diäten |
Weltweit renommiertes Forschungskrankenhaus |
Geringere Verzerrungswahrscheinlichkeit, aber mögliches Finanzierungs- oder Auswahlbias bei den Proben. |
|
Internetnutzung in ländlichen Regionen von Entwicklungsländern |
Kleine NGO mit begrenzten Ressourcen |
Begrenzte Mittel können zu Stichprobenverzerrungen oder geringer geografischer Abdeckung führen. |
|
Energieverbrauch und Umweltauswirkungen erneuerbarer Energien |
Großer Ölkonzern |
Könnte Vorteile erneuerbarer Energien kleinreden oder Herausforderungen überbetonen, um bestehende Geschäftsinteressen zu schützen. |
|
Häufigkeit kardiovaskulärer Erkrankungen |
Centers for Disease Control and Prevention (CDC) |
Seriöse Quelle, aber mögliche Limitierungen in der Methodik oder Untererfassung bestimmter Gruppen. |
|
Sicherheit und Effizienz einer neuen E-Auto-Modellreihe |
Der Hersteller der Fahrzeuge |
Könnte Sicherheit und Effizienz überzeichnen; möglicherweise geringe Transparenz in Testverfahren. |
|
Wirksamkeit eines neuen Medikaments |
Unabhängige Watchdog-Organisation |
Geringere Verzerrungswahrscheinlichkeit, aber mögliches Finanzierungsbias oder Interessenkonflikte bei Nähe zu Pharmaunternehmen. |
|
Kundenzufriedenheit mit einem neuen Smartphone |
Der Smartphone-Hersteller |
Könnte Zufriedenheitswerte aufblähen; potenziell voreingenebene Fragebögen oder selektive Stichproben. |
Als eine Freundin aus den USA Australien besuchte, sagte sie den Einheimischen, es seien bei ihr zu Hause gerade über 100°. Die Verwunderung war groß, bis allen klar wurde: In den USA misst man in Fahrenheit, in Australien in Celsius. Sie meinten 100 °C (212 °F), sie aber 100 °F (etwa 37 °C).
Vor Ort ließ sich das Missverständnis schnell klären. Stell dir jedoch ein ähnliches Szenario im Datensatz vor: Temperaturen wurden von Fahrenheit in Celsius umgerechnet, das Einheitenlabel blieb aber auf Fahrenheit. Das führt zu völlig absurden Ergebnissen.
Genau deshalb ist die Dokumentation von Transformationen ein zentraler Bestandteil der Data Lineage. Wenn eine datenverbrauchende Person – etwa eine Data Analystin – merkwürdige Ergebnisse sieht (wie regelmäßig „kochende“ Lufttemperaturen), kann sie in der Lineage die falsch beschriftete Umrechnung finden und den Fehler beheben.
Auf dem Weg von der Quelle bis zum Ziel durchlaufen Daten oft zahlreiche Transformationen – etwa Bereinigung, Filterung oder Aggregation. Jede dieser Änderungen beeinflusst die Interpretation und muss dokumentiert werden.
Eine klare Data Lineage hält all diese Schritte fest, macht Änderungen rückverfolgbar und erhöht die Transparenz. Das stärkt das Vertrauen und vereinfacht das Debugging.
Die letzte Station im Datenfluss ist der Ort, an dem Daten gespeichert und genutzt werden – etwa in Data Warehouses, Reporting-Tools oder anderen Analyseplattformen. Die Data Lineage verfolgt die Daten bis zu diesen Endpunkten und liefert ein vollständiges Bild der Reise, damit Stakeholder den angezeigten Daten vertrauen können.
Auch für die Sicherheit ist die Dokumentation der Zielsysteme wichtig, weil sie festhält, wer auf welche Daten zugreift.
Data Lineage einzurichten klingt einfach: Herkunft und Verarbeitungsschritte nachverfolgen. In der Praxis gibt es jedoch einige Hürden. Hier sind ein paar davon.
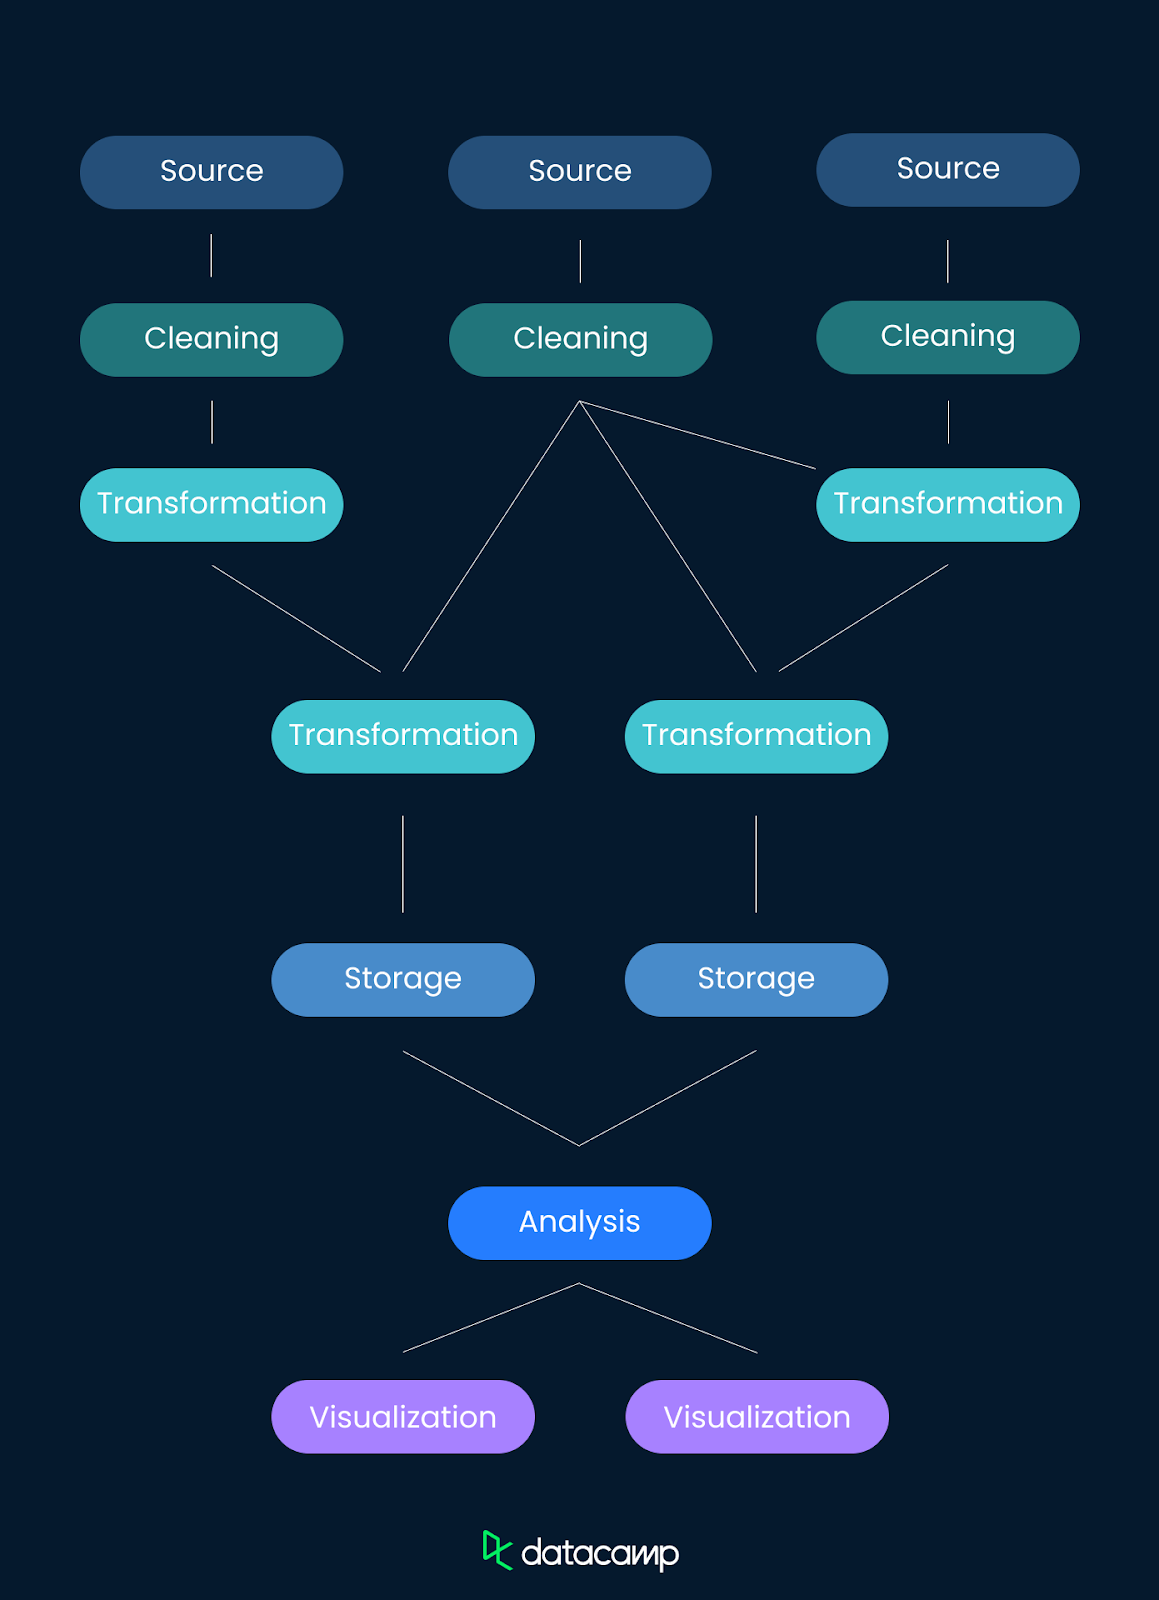
Eine der größten Herausforderungen ist die Größe und Komplexität moderner Datenpipelines. Heutige Datenlandschaften umfassen oft verschachtelte Flüsse über viele Systeme und Plattformen. Diese Pfade im Detail nachzuhalten, erfordert robuste Tools und sorgfältige Planung.
Eine einfache Pipeline mit einer Quelle und wenigen Transformationen lässt sich noch leicht dokumentieren. Bei mehreren Eingängen, vielen Transformationen und verschiedenen Zielen wird die Lineage komplexer – und zugleich umso wichtiger.
Data Lineage lässt sich manuell oder automatisch dokumentieren. Die manuelle Variante ist zeitaufwendig und fehleranfällig – besonders in großen Umgebungen. Das untergräbt genau das Vertrauen, das Lineage eigentlich schaffen soll.
Für sehr kleine, von einer Person kontrollierte Pipelines kann manuelle Lineage genügen. Mit steigender Komplexität sollte die Dokumentation jedoch automatisiert werden. Im nächsten Abschnitt findest du dafür hilfreiche Ressourcen.
Wurde Lineage anfangs nicht eingeplant, ist die nachträgliche Integration oft aufwendig und ressourcenintensiv. Die bestehende Infrastruktur für eine umfassende Nachverfolgung anzupassen, erfordert häufig größere Änderungen – ein Hindernis für manche Organisationen. Umso wichtiger ist es, Data Lineage von Beginn an mitzudenken.
Wenn du deine Data Lineage nicht manuell pflegen willst, brauchst du zwei Grundbausteine: Du musst Metadaten über deine Datensätze erfassen und einen Katalog für diese Metadaten führen.
Metadaten sind Daten über Daten – also Informationen zur Herkunft, Struktur, Transformation und Nutzung deiner Daten. Effektives Metadatenmanagement sammelt Metadaten aus verschiedenen Quellen, verfolgt Transformationen und dokumentiert Bewegungen. Oft geschieht das automatisiert, sodass jede Änderung festgehalten und nachverfolgbar ist. So entsteht ein umfassender Blick auf deine Data Lineage.
Datenkataloge sind zentrale Verzeichnisse für Metadaten zu den Datenbeständen einer Organisation – inklusive Herkunft, Transformationen und Zielen. Sie automatisieren häufig das Auffinden, Beschreiben und Organisieren von Datenassets, erleichtern das Lineage-Management, stärken Vertrauen und helfen bei der Einhaltung von Governance-Richtlinien.
Es gibt viele verfügbare Tools, die dich bei der Nachverfolgung deiner Data Lineage unterstützen. Hier eine kurze Liste beliebter Lösungen.
|
Tool |
Typ |
Zentrale Funktionen |
|
Kostenpflichtig |
Zentralisiertes Metadatenmanagement, Visualisierung von Datenflüssen, unterstützt viele Datenquellen |
|
|
Kostenpflichtig |
Detaillierte Ansichten zu Datenbewegungen und -transformationen, sichert Datenqualität und Compliance |
|
|
Kostenpflichtig |
Erweiterte Lineage-Visualisierung, interaktive Diagramme, Integration in Data Governance |
|
|
Kostenpflichtig |
Tools für Datenintegration und -integrität, detaillierte Nachverfolgung von Transformationen |
|
|
Open Source |
Metadatenmanagement, erfasst Data Lineage, ausgelegt für Hadoop-Systeme |
|
|
Open Source |
Automatisiert Datenflüsse, integriertes Lineage-Tracking, überwacht Datenbewegungen |
|
|
Open Source |
Metadatenservice zum Sammeln und Visualisieren von Data Lineage, integriert mit diversen Systemen |
|
|
Open Source |
Maschinelles Lernen zur automatischen Erkennung und Dokumentation von Datenflüssen |
Neben den genannten Tools bieten viele ETL/ELT-Lösungen, Visualisierungstools und Data-Governance-Plattformen Lineage-Funktionen. Sie automatisieren die Dokumentation von Extraktion, Transformation und Laden und visualisieren Datenflüsse über Systeme hinweg.
Wusstest du zum Beispiel, dass du deine Data Lineage in PowerBI sehen kannst? Prüfe die Tools in deinen Pipelines und finde heraus, wie viel deiner Lineage bereits erfasst wird.
Manchmal ist eine Lösung „von der Stange“ nicht passend, und eine maßgeschneiderte Variante ist sinnvoller. In diesem Fall kannst du folgende Ansätze prüfen.
Dokumentiere zunächst Datenflüsse und Transformationen manuell, indem du Herkunft, Prozesse und Ziele detailliert festhältst. Für kleinere Datensätze oder einfache Umgebungen, die von Einzelpersonen oder kleinen Teams gemanagt werden, kann das ausreichen.
In größeren oder komplexeren Landschaften bietet es sich an, eine manuelle High-Level-Übersicht zu erstellen, um gezielt Stellen für automatisches Tracking zu identifizieren. Manuelle Doku ist flexibel, aber in großen Systemen arbeitsintensiv.
Entwickle eigene Skripte, etwa in Python, um Transformationen und Bewegungen zu erfassen und zu protokollieren. Integriere sie in Verarbeitungs-Pipelines, um Teile der Dokumentation zu automatisieren. Das ist hilfreich, wenn bestehende Tools deine Anforderungen nicht vollständig abdecken oder die Datenkomplexität moderat ist.
Implementiere Datenbank-Trigger, die Änderungen und Bewegungen automatisch protokollieren. So werden Inserts, Updates oder Deletes erfasst und die Datenentwicklung im Zeitverlauf dokumentiert. Ideal bei großen, komplexen Landschaften, in denen Echtzeit-Tracking wichtig ist.
Wie bei Code lässt sich auch für Daten Versionskontrolle nutzen. Indem du Datensatzversionen führst und Änderungen dokumentierst, verfolgst du die Lineage über die Zeit. Tools wie Git können für Datenversionierung adaptiert werden – besonders nützlich, wenn historische Integrität und Langzeitverfolgung wichtig sind.
Erstelle maßgeschneiderte Visualisierungen der Lineage, z. B. mit networkx in Python. Damit lassen sich Diagramme zu Datenflüssen und Transformationen bauen, die das Verständnis erleichtern. Geeignet für Organisationen mit speziellen Visualisierungsanforderungen und der nötigen technischen Expertise.
Wenn du viele Metadaten trackst, lohnt sich ein zentrales Metadaten-Repository. Es kann auf relationalen Datenbanken oder NoSQL basieren und sollte sich leicht mit Verarbeitungssystemen integrieren lassen, um Metadaten aktuell zu halten.
Das ist ideal für Organisationen mit umfangreichen, heterogenen Datenbeständen, die eine skalierbare, flexible Lösung für Metadatenmanagement benötigen. Starte zum Beispiel mit OpenMetadata für Open-Source-Tools.
Ich schreibe oft über die Bedeutung von Dokumentation im Code – aus gutem Grund. Sie ist ein Kern guter Entwicklungspraxis. Data Lineage ist aus ähnlichen Gründen wichtig: Sie ist die Beweisspur, die jeden Schritt der Datenreise dokumentiert.
Im Unterschied zur Code-Dokumentation basieren Lineages häufig auf Metadaten und Automatisierung. Während Doku oft manuell erfolgt (oder heute per KI), ist Data Lineage zu komplex und umfangreich, um sie komplett von Hand zu pflegen.
Code-Dokumentation findet man meist als Kommentare im Code und in einer README. Data Lineage wird häufig über Diagramme und automatisierte Reports visualisiert, um den Datenfluss im System zu verstehen.
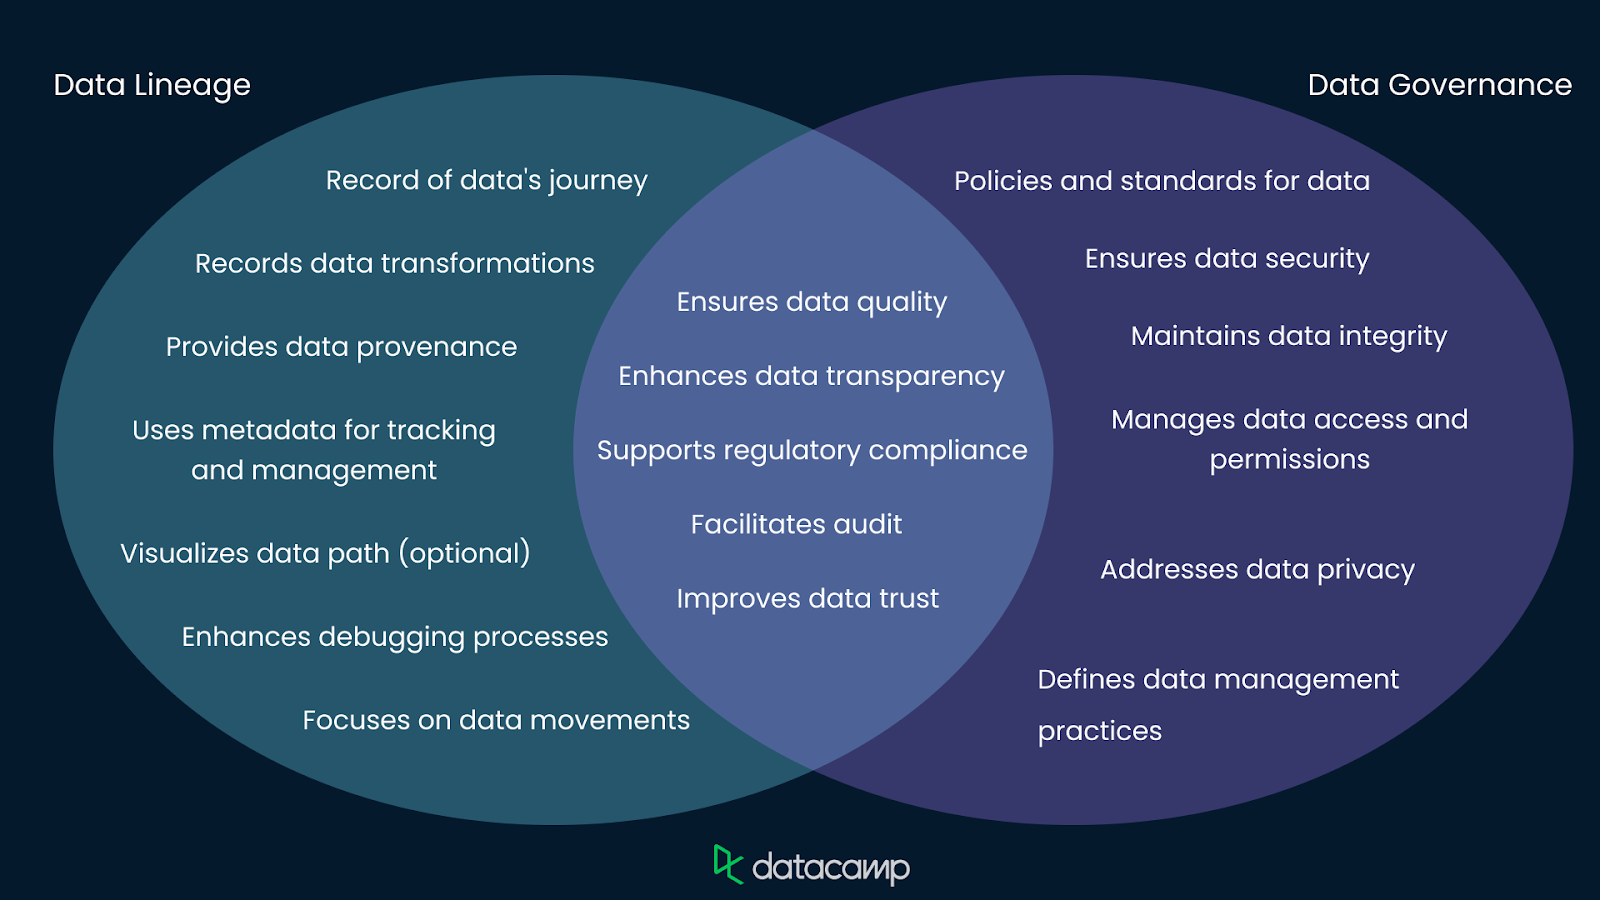
Data Lineage und Data Governance sind eng verwandt. Lineage zeichnet den Weg der Daten durch Systeme und Transformationen nach und schafft Transparenz und Nachvollziehbarkeit. Data Governance umfasst die übergeordneten Richtlinien und Standards für Datenqualität, Sicherheit und Compliance. Lineage kann die Durchsetzung von Governance-Richtlinien unterstützen.
Organisationen können Governance stärken, indem sie Lineage-Tools und -Techniken einsetzen – für Integrität und regulatorische Konformität. Zusammen ergeben Lineage und Governance einen ganzheitlichen Ansatz für Datenmanagement und -sicherheit.
Mehr zu Data Governance lernst du im Kurs Data Governance Concepts. Für einen tieferen Einblick hör dir auch How Data Leaders Can Make Data Governance a Priority an.
Mit der wachsenden Komplexität von Datenlandschaften wird Data Lineage immer wichtiger. Sie schafft Vertrauen durch Transparenz, ermöglicht schnelleres Debugging und weist die Datenherkunft nach.
Mit mehr Automatisierung und besseren Visualisierungen wird die Bedeutung von Lineage-Tools weiter steigen und starke Data-Governance- und Managementpraktiken unterstützen.
Wenn du tiefer einsteigen willst, probiere den Kurs Understanding Data Engineering. Empfehlenswert sind außerdem Responsible AI Data Management und Making Data Governance Fun.
Verschaffe deinem Team Zugang zur gesamten DataCamp-Bibliothek mit zentralisierten Berichten, Aufgaben, Projekten und mehr
Lerne Data Engineering mit diesen Kursen!
Kurs
Lernpfad
Lernpfad