
Cours
Présentation de l’ingénierie des données
2 h
372.7K
Permettez à votre équipe d'accéder à l'ensemble de la bibliothèque DataCamp, avec des rapports centralisés, des missions, des projets et bien d'autres choses encore.
Quand un ami vous cite une statistique douteuse, vous lui demandez sa source pour en vérifier la fiabilité. Remonter à la source est crucial pour établir la confiance. C’est exactement la même chose avec les données.
La traçabilité des données est l’historique complet de vos données : de leur source, à travers chaque transformation, jusqu’à leur point d’arrivée. Cet historique offre une vue claire de leur parcours.
Elle garantit une transparence totale en documentant chaque étape du pipeline, de la collecte initiale à l’analyse finale. Cette visibilité est essentielle pour instaurer la confiance : chacun peut voir précisément comment les données ont été traitées et transformées.
C’est un peu comme « montrer votre raisonnement » en cours de maths. Montrer vos étapes permet d’expliquer votre démarche et prouve que vous n’avez pas copié. La traçabilité, c’est ce « détail des calculs » appliqué à votre pipeline.
Montrer vos étapes aide aussi à repérer où l’erreur s’est glissée si le résultat est faux. Vous pouvez la corriger et progresser.
De la même manière, une traçabilité claire permet d’identifier rapidement l’origine d’une anomalie dans un pipeline. Retracer une erreur jusqu’à sa source est souvent ardu. Une traçabilité complète simplifie ce travail en suivant le chemin des données pour trouver où ça a dérapé. Ce débogage plus rapide améliore la qualité des données et, par ricochet, la confiance.
Pour approfondir le sujet, découvrez notre cours Introduction to Data Quality.
La provenance des données est un enregistrement de métadonnées retraçant leur lignée. De nombreux secteurs, notamment ceux manipulant des informations sensibles comme la santé ou la finance, exigent des preuves de provenance.
Prouver la provenance consiste à montrer l’origine des données et la façon dont elles ont été traitées. La traçabilité fournit une piste d’audit couvrant tout le cycle de vie des données. En plus d’instaurer la confiance, cette piste d’audit permet de démontrer la conformité aux lois sur la protection des données, aux politiques de gouvernance et à d’autres réglementations.
Une traçabilité complète enregistre le chemin des données à chaque étape. Voici un exemple de flux depuis la source jusqu’à la visualisation.
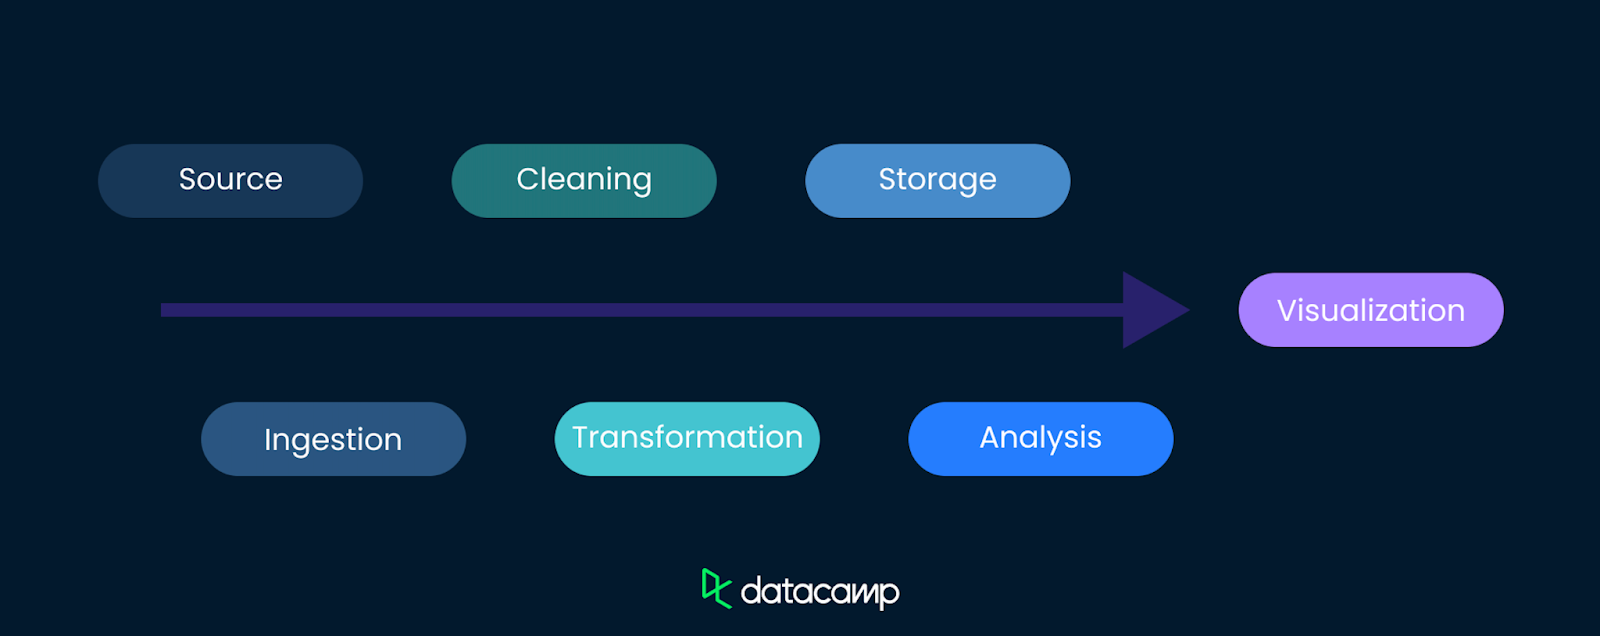
La traçabilité commence à la source : bases de données, API, capteurs, enquêtes ou autres points de collecte. Connaître l’origine est la première étape, la plus importante, pour suivre le parcours des données.
La source apporte le contexte et l’arrière-plan. Elle permet aussi d’anticiper des biais ou des limites liés à la collecte.
Pour illustrer l’importance de la source, voici quelques jeux de données hypothétiques et leurs origines.
|
Jeu de données |
Source |
Biais/limitations potentiels |
|
Besoins d’hydratation |
Entreprise vendant de l’eau en bouteille |
Peut surestimer les besoins d’hydratation pour stimuler les ventes. |
|
Tension artérielle chez des patients suivant différents régimes |
Hôpital de recherche de renommée mondiale |
Moins sujet à de forts biais, mais risque de biais de financement ou de sélection des patients. |
|
Usage d’Internet dans les zones rurales de pays en développement |
Petite ONG disposant de ressources limitées |
Ressources insuffisantes pour une collecte exhaustive, d’où un risque de biais d’échantillonnage ou de couverture géographique réduite. |
|
Consommation d’énergie et impact environnemental des énergies renouvelables |
Grande compagnie pétrolière |
Peut minimiser les bénéfices des renouvelables ou exagérer les défis pour protéger ses intérêts. |
|
Prévalence des maladies cardiovasculaires |
Centers for Disease Control and Prevention (CDC) |
Source réputée, mais limites possibles dans les méthodes de collecte ou sous-déclaration dans certains groupes. |
|
Sécurité et efficacité d’une nouvelle gamme de voitures électriques |
Constructeur des véhicules électriques |
Peut surestimer la sécurité et l’efficacité ; manque possible de transparence sur les protocoles de test. |
|
Efficacité d’un nouveau médicament |
Organisation indépendante de surveillance |
Moins de risques de biais majeurs, mais possibles biais de financement ou conflits d’intérêts en cas de liens avec l’industrie pharmaceutique. |
|
Satisfaction des clients pour un nouveau smartphone |
Fabricant du smartphone |
Peut gonfler les taux de satisfaction ; risque de questionnaires biaisés ou d’échantillonnage sélectif. |
Quand une amie américaine a visité l’Australie, elle a dit aux locaux qu’il faisait plus de 100° chez elle. Stupeur… avant de réaliser que les États-Unis utilisent Fahrenheit et l’Australie Celsius. Ils ont cru 100 °C (212 °F), alors qu’elle parlait de 100 °F, soit environ 37 °C.
Heureusement, l’incompréhension s’est dissipée sur le moment. Mais imaginez le même souci dans un jeu de données : une colonne de températures converties en Celsius, mais restée étiquetée « Fahrenheit ». Attendez-vous à des résultats absurdes !
Voilà pourquoi documenter les transformations est crucial dans une traçabilité. Si un utilisateur final, comme un analyste, obtient des résultats incohérents (une ville aux températures d’ébullition…), il peut remonter la lignée, repérer la transformation mal étiquetée et corriger le tir.
Entre la source et la destination, les données subissent souvent de multiples transformations : nettoyage, filtrage, agrégation, etc., qui conditionnent leur usage. Chacune modifie l’interprétation des données et doit être consignée.
Une traçabilité claire documente ces transformations, enregistre chaque changement et permet de le remonter, renforçant ainsi la transparence, la confiance et la facilité de débogage.
Dernière étape : l’endroit où les données sont stockées et utilisées : entrepôts de données, outils de reporting ou plateformes analytiques. La traçabilité suit les données jusqu’à ces points d’arrivée, offrant une vision complète de leur parcours et garantissant aux parties prenantes la fiabilité des données consultées.
Documenter la destination est aussi essentiel pour la sécurité, en gardant la trace des accès à chaque donnée.
Mettre en place une traçabilité peut sembler simple : suivre l’origine des données et ce qu’on en fait. En pratique, plusieurs défis compliquent la tâche. En voici quelques-uns.
Premier écueil : la taille et la complexité des pipelines modernes. Les environnements actuels impliquent des flux intriqués, sur plusieurs systèmes et plateformes. Les suivre en détail exige des outils robustes et une planification soignée.
Un pipeline simple, avec une seule source et peu de transformations, est relativement facile à tracer. Mais avec de multiples sources, nombreuses transformations et plusieurs destinations, la traçabilité devient plus complexe… et plus indispensable.
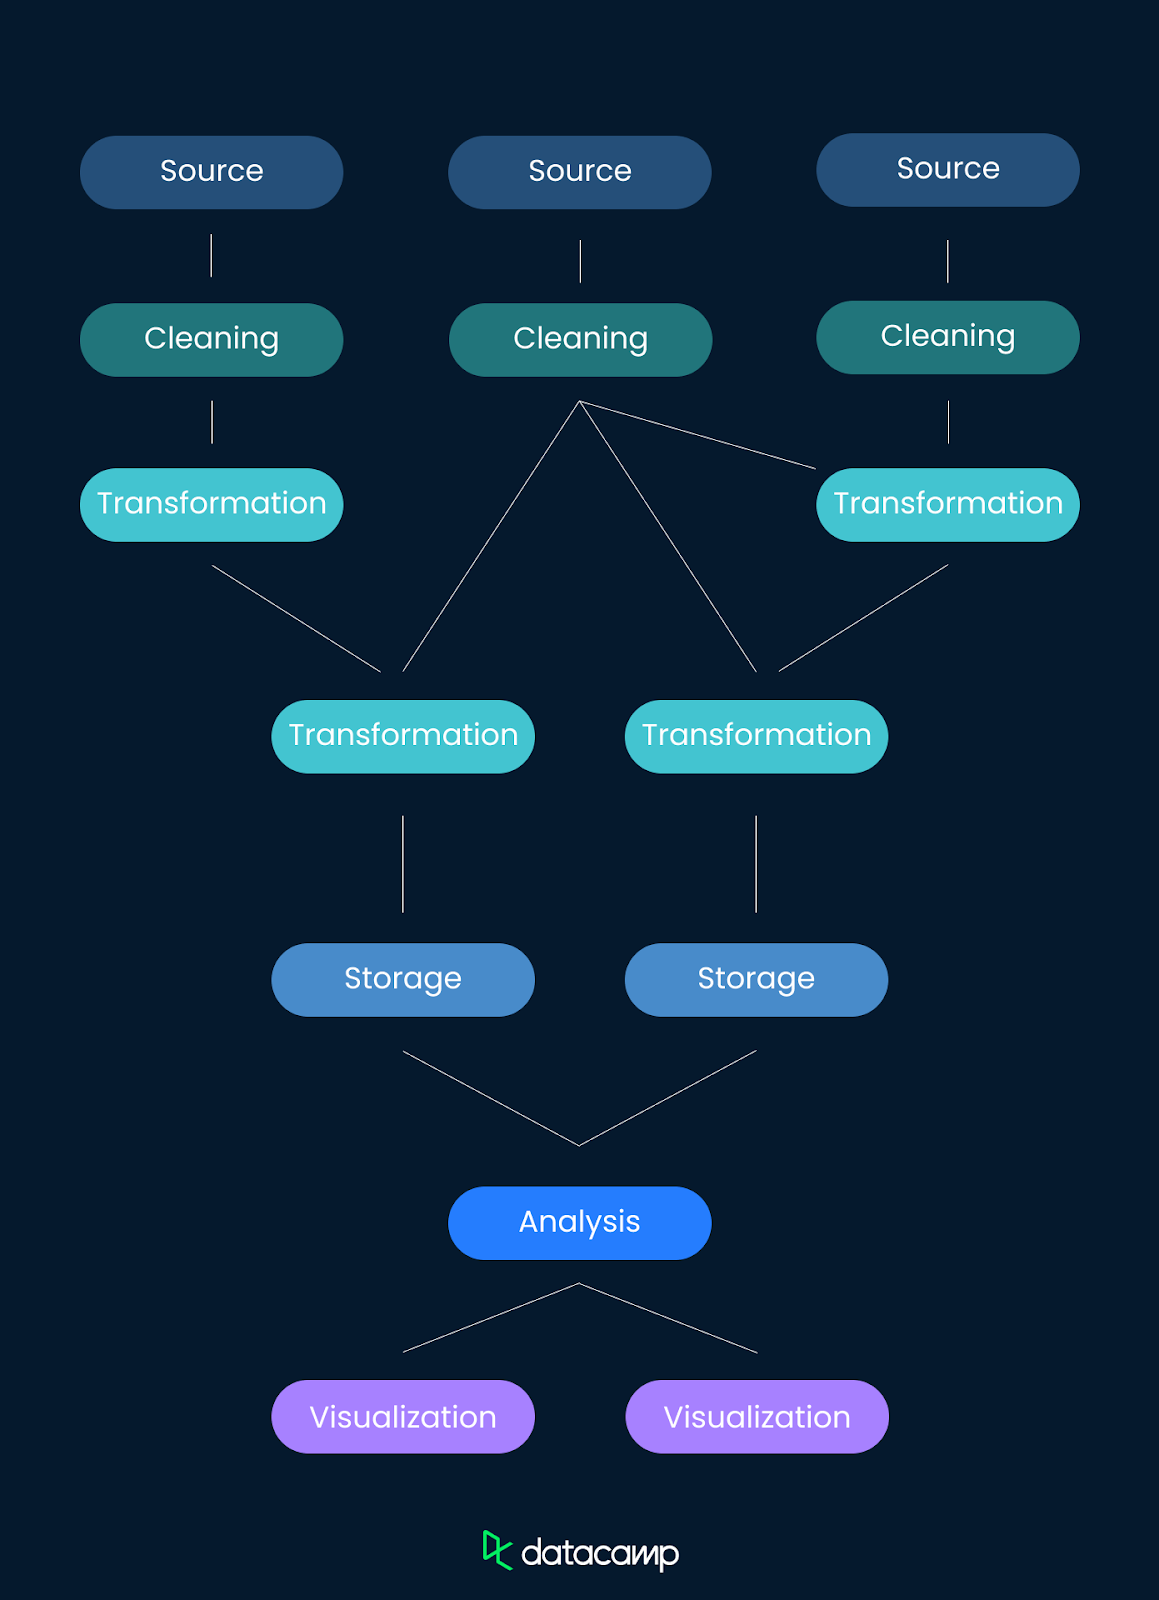
La traçabilité peut être documentée manuellement ou automatiquement. À grande échelle, le manuel est chronophage et source d’erreurs. Suivre à la main les mouvements et transformations dans une organisation importante est inefficace et risque d’introduire des inexactitudes, sapant l’objectif même de la traçabilité.
Pour de très petits pipelines gérés par une seule personne, le manuel peut suffire. Mais dès que la complexité augmente, l’automatisation de la documentation devient nécessaire. La section suivante présente des ressources pour y parvenir.
Si la traçabilité n’a pas été prévue dès la conception, l’ajouter a posteriori peut être coûteux en temps et en ressources. Adapter l’infrastructure pour un suivi complet impose souvent des changements significatifs, pouvant freiner certaines organisations. Raison de plus pour intégrer la traçabilité dès le départ.
Si vous ne comptez pas documenter votre traçabilité à la main, vous aurez besoin de quelques composants clés : collecter des métadonnées sur vos jeux de données et disposer d’un catalogue pour ces métadonnées.
Les métadonnées sont des données sur les données : origine, structure, transformations, usages, etc. Une gestion efficace consiste à collecter ces métadonnées depuis diverses sources, à suivre les transformations et à documenter les mouvements. Cette collecte et cette gestion sont souvent automatisées pour enregistrer chaque changement et le rendre traçable, offrant une vue complète de votre traçabilité.
Les catalogues de données sont des référentiels qui stockent les métadonnées sur les actifs de données d’une organisation : origines, transformations, destinations. Ils automatisent souvent la découverte, la description et l’organisation des actifs, ce qui facilite la gestion de la traçabilité, renforce la confiance et assure la conformité aux politiques de gouvernance.
De nombreux outils prêts à l’emploi permettent de suivre la traçabilité. Voici une courte liste de solutions populaires.
|
Nom de l’outil |
Type |
Fonctionnalités clés |
|
Payant |
Gestion centralisée des métadonnées, visualisation des flux, prise en charge d’une large gamme de sources |
|
|
Payant |
Vues détaillées des mouvements et transformations, garanties de qualité et de conformité |
|
|
Payant |
Visualisation avancée de la traçabilité, diagrammes interactifs, intégration à la gouvernance des données |
|
|
Payant |
Outils d’intégration et de qualité des données, suivi détaillé des transformations |
|
|
Open source |
Gestion des métadonnées, capture de traçabilité, conçu pour les systèmes Hadoop |
|
|
Open source |
Automatisation des flux de données, fonctionnalités intégrées de traçabilité, supervision des mouvements |
|
|
Open source |
Service de métadonnées pour collecter et visualiser la traçabilité, intégrations multiples |
|
|
Open source |
Algorithmes de machine learning pour détecter et documenter automatiquement les flux |
En plus des outils ci-dessus, de nombreux outils ETL/ELT, de visualisation et de gouvernance incluent des fonctions de traçabilité. Ils automatisent la documentation de l’extraction, la transformation et le chargement, et aident à visualiser les flux entre systèmes.
Par exemple, saviez-vous que vous pouvez visualiser votre traçabilité dans PowerBI ? Passez en revue les outils que vous utilisez déjà dans vos pipelines et voyez quelle part de votre traçabilité est automatiquement suivie !
Parfois, une solution prête à l’emploi n’est pas adaptée et un dispositif sur mesure est préférable. Voici quelques pistes pour mettre en place la traçabilité de votre pipeline.
Commencez par documenter manuellement les flux et transformations : enregistrez précisément origines, processus et destinations. Cette approche peut suffire pour de petits jeux de données ou des environnements simples gérés par une personne ou une petite équipe.
Si votre paysage de données est plus vaste ou complexe, contentez-vous peut-être d’une vue d’ensemble manuelle pour repérer où ajouter un suivi automatisé. Le manuel offre une forte personnalisation, mais devient vite lourd sur de grands périmètres.
Développez des scripts sur mesure (par exemple en Python) pour capturer et journaliser transformations et mouvements. Intégrez-les aux pipelines pour automatiser une partie de la documentation. Utile si vos besoins ne sont pas couverts par les outils du marché ou si votre complexité est modérée.
Mettez en place des triggers pour consigner automatiquement les insertions, mises à jour et suppressions. Vous obtenez ainsi un journal de l’évolution des données. Idéal pour des environnements vastes et complexes nécessitant un suivi en temps réel.
Comme pour le code, le versioning peut s’appliquer aux données. En conservant les versions des jeux de données et en documentant les changements, vous suivez la traçabilité dans le temps. Des outils comme Git peuvent être adaptés au versionnement de données. Particulièrement utile pour préserver l’historique et tracer les évolutions sur la durée.
Créez des visualisations sur mesure pour cartographier la traçabilité avec des bibliothèques de graphes comme networkx en Python. Vous générerez des diagrammes représentant flux et transformations, facilitant la compréhension et le suivi. Cette approche convient aux organisations ayant des besoins très spécifiques et les compétences techniques nécessaires.
Si vous suivez un grand volume de métadonnées, mettez en place un référentiel centralisé pour les stocker. Bâti sur des bases relationnelles ou NoSQL, il doit s’intégrer facilement aux systèmes de traitement pour maintenir les métadonnées à jour.
Cette approche est idéale pour des patrimoines de données vastes et hétérogènes nécessitant une gestion des métadonnées évolutive et flexible. Pour démarrer, découvrez OpenMetadata, une boîte à outils open source.
J’écris souvent sur l’importance de documenter le code, et à juste titre. C’est une bonne pratique essentielle. La traçabilité des données est importante pour des raisons similaires : c’est une piste de preuves qui documente chaque étape parcourue par vos données.
À la différence de la documentation du code, la traçabilité s’appuie largement sur les métadonnées et l’automatisation. La documentation est souvent manuelle (ou réalisée par l’IA aujourd’hui), tandis que la traçabilité est souvent trop complexe et volumineuse pour être gérée à la main.
La documentation vit fréquemment dans des commentaires in-code et un fichier README. La traçabilité, elle, se visualise via des diagrammes et des rapports automatisés pour comprendre les flux dans votre système.
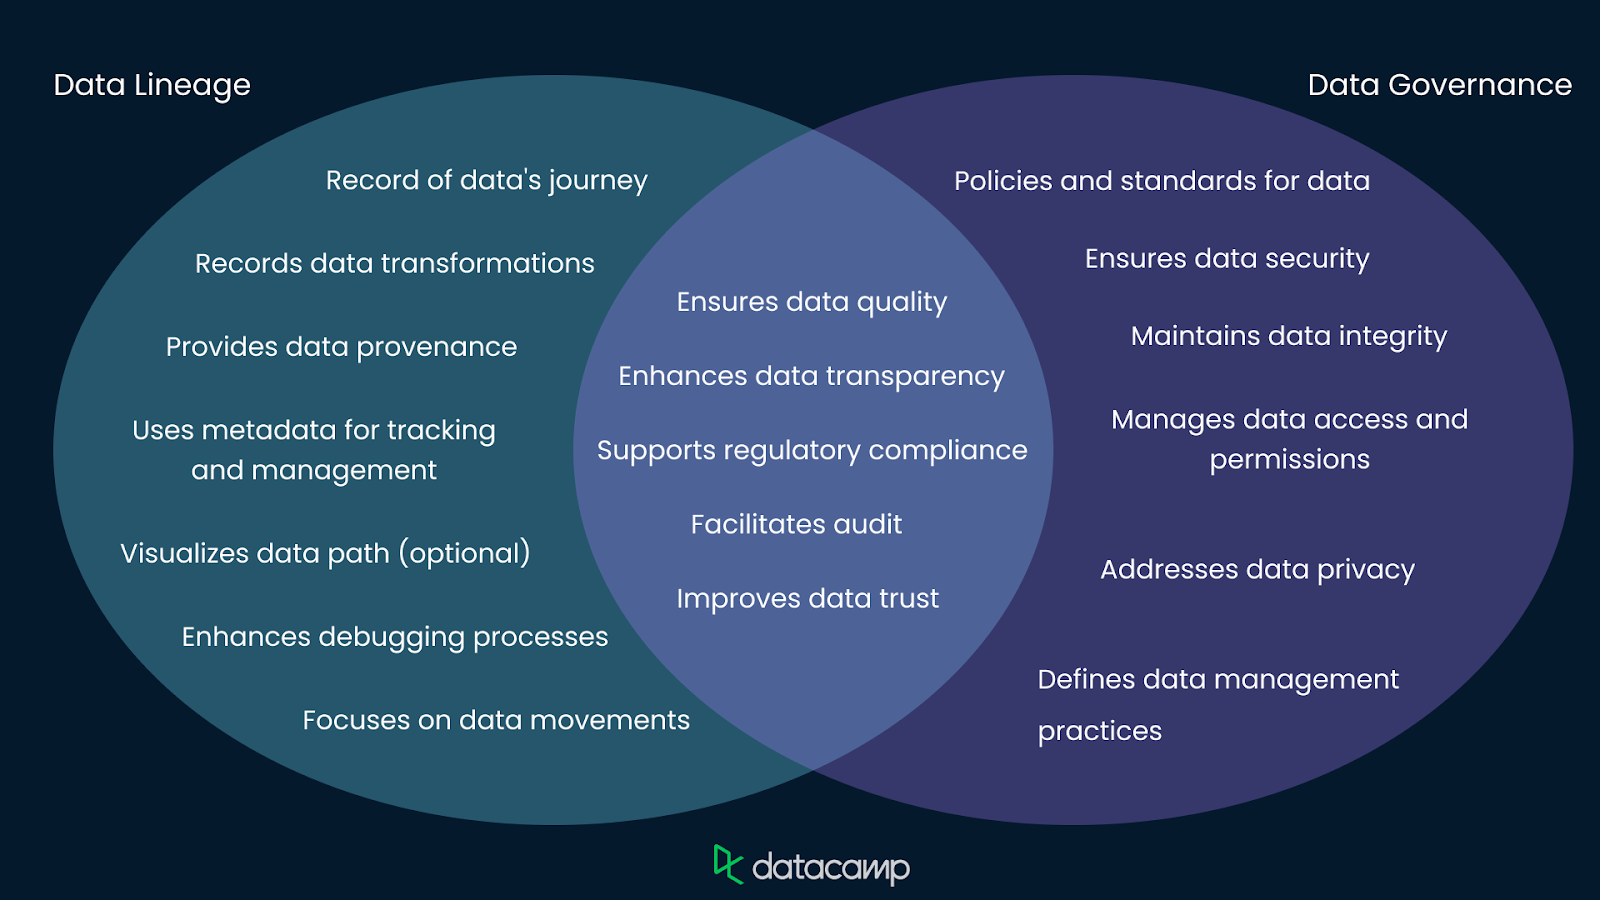
La traçabilité et la gouvernance des données sont étroitement liées. La traçabilité reconstitue le parcours des données à travers transformations et systèmes, offrant un historique garantissant transparence et traçabilité. La gouvernance pose, elle, le cadre plus large : politiques et standards de qualité, sécurité et conformité. La traçabilité soutient l’application de ces politiques.
En s’appuyant sur des outils et techniques de traçabilité, les organisations renforcent leurs efforts de gouvernance, assurant l’intégrité des données et le respect des exigences réglementaires. Ensemble, traçabilité et gouvernance constituent une approche complète pour gérer et sécuriser les données.
Pour en savoir plus, suivez le cours Data Governance Concepts. Et découvrez une perspective avancée avec How Data Leaders Can Make Data Governance a Priority.
À mesure que les environnements de données gagnent en complexité, la traçabilité devient incontournable. Elle renforce la confiance par la transparence, accélère le débogage et prouve la provenance des données.
Avec les progrès de l’automatisation et de la visualisation, l’importance des outils de traçabilité ne fera que croître, au service d’une gouvernance et d’une gestion des données solides.
Pour aller plus loin, suivez le cours Understanding Data Engineering. Nous vous recommandons également Responsible AI Data Management et Making Data Governance Fun.
Permettez à votre équipe d'accéder à l'ensemble de la bibliothèque DataCamp, avec des rapports centralisés, des missions, des projets et bien d'autres choses encore.
Apprenez l’ingénierie des données avec ces cours !
Cours
Cursus
Cursus