
Cursus
Inzicht in Machine Learning
2 uur
311.3K
Machine learning (ML)-modellen zijn computergebaseerde implementaties van statistische en probabilistische methoden. Ze hanteren doorgaans een van twee benaderingen: generatief of discriminatief modelleren.
In dit artikel geven we een overzicht van generatieve en discriminatieve modellen, introduceren we gangbare modellen van elk type, leggen we de wiskundige principes achter beide benaderingen uit en bespreken we praktische voorbeelden van probleemtypen waarvoor elk type model kan worden gebruikt.
Gegeven een set voorbeelddatapunten, D, en hun bijbehorende labels, L, leert een generatief model de gezamenlijke kansverdeling P(D, L). Het gebruikt deze onderliggende verdeling vervolgens om nieuwe data te genereren die lijken op de trainingsvoorbeelden, of om classificatieproblemen aan te pakken.
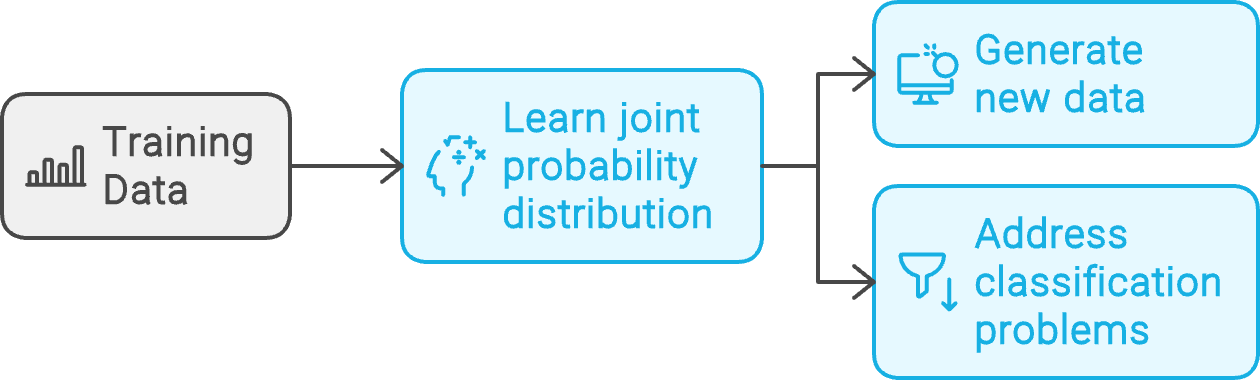
Workflow van een generatief model. Gemaakt met napkin.ai
De volgende secties leggen de basisprincipes van generatieve modellen uit aan de hand van voorbeelden.
Naive Bayes-modellen zijn gebaseerd op de stelling van Bayes. Deze stelling geeft de voorwaardelijke kans P(A | B) van een gebeurtenis A wanneer bekend is dat gebeurtenis B waar is. Dit heet de a-posteriorikans van A gegeven B.
Afzonderlijk heet de kans P(A) van gebeurtenis A de a-priorikans. Naive Bayes-modellen gaan ervan uit dat A en B onafhankelijke gebeurtenissen zijn – vandaar het voorvoegsel “naive”. Als A en B afhankelijk zijn, is de traditionele stelling van Bayes niet meer van toepassing en zijn Naive Bayes-modellen niet de juiste keuze.
Bayesiaanse modellen zijn generatieve modellen omdat ze de gezamenlijke kansverdeling modelleren. Het trainingsproces leert de gezamenlijke kans—P(A, B). Na training kan het worden gebruikt om de waarden van A met de hoogste kans P(A) te voorspellen. Bovendien kunnen Bayesiaanse modellen ook voor classificatie worden gebruikt omdat ze voorwaardelijke kansen kunnen berekenen (met de regel van Bayes).
Wil je in de praktijk met naive Bayes-modellen aan de slag, volg dan de tutorial over Naive Bayes-modellen bouwen met scikit-learn en Python.
Gaussiaanse mengmodellen (GMM) zijn een klasse van mengmodellen. Hun unieke uitgangspunt is dat de onderliggende data een combinatie is van statistische verdelingen in plaats van één enkele verdeling.
In een GMM wordt verondersteld dat de populatie een combinatie is van verschillende subpopulaties, die elk een Gaussische verdeling volgen. Feitelijk wordt de dataverdeling geanalyseerd als een gewogen gemiddelde van een paar individuele Gaussische verdelingen.
GMM’s leggen de kansverdeling van de onderliggende dataset vast. Daarom worden ze gebruikt voor taken zoals outlier-analyse en ongecontroleerde (unsupervised) classificatie. Deze taken houden in dat je een statistisch model van de populatie opbouwt door de trainingsdataset als een aselecte steekproef te behandelen.
De cursus over mengmodellen in R gaat in op de praktische details van GMM’s.
Een generative adversarial network (GAN) is een op neurale netwerken gebaseerd model. Het bestaat uit twee delen: een generator en een discriminator. Het generatornetwerk wordt getraind om vectoren te genereren die lijken op de trainingsvoorbeelden, terwijl de discriminator wordt getraind om het verschil te zien tussen de originele voorbeelden en die welke door de generator zijn gemaakt.
In essentie hebben de generator en de discriminator tegengestelde trainingsdoelen, waardoor ze elkaars tegenstander zijn. Vandaar het woord “adversarial” in de naam.
De generator en de discriminator worden samen getraind in dezelfde traininglus. Naarmate de generator beter wordt in het creëren van realistische voorbeelden, onderscheidt de discriminator de originele voorbeelden van de gegenereerde. De training gaat door totdat de generator voorbeelden kan maken die zo sterk op de trainingsdata lijken dat de discriminator geen onderscheid meer kan maken.
Na training wordt de generator gebruikt om realistische synthetische data te genereren die lijken op de originele voorbeelden.
Een hidden Markov model (HMM) werkt met sequentiële datasets. Markov-processen (of Markov-ketens) worden gebruikt om sequentiële data te modelleren. De aanname van een Markov-model is dat het volgende element, xn+1, in de reeks alleen afhangt van het vorige element, xn, en niet van een van de elementen {x1, x2, ... xn-1} die eraan voorafgaan. Markov-modellen veronderstellen dat sequentiële datasets kunnen worden weergegeven door Markov-processen met verborgen toestanden.
Deze toestanden genereren het volgende element in de reeks:
Markov-modellen worden weergegeven met transitiekansen (overgang van de ene naar de andere toestand) en emissiekansen (het genereren van een specifiek sequentie-element gegeven een bepaalde toestand).
HMM’s modelleren de trainingsdatasets als Markov-processen. Het trainingsdoel is om de transitie- en emissiekansen te bepalen die de kans op het genereren van de reeksen in de voorbeelddatasets maximaliseren. Zo kan een getraind Markov-model, gegeven een sequentie, de opeenvolgende elementen van de reeks genereren.
Voor meer over de praktische implementatie, volg de tutorial over Markov-ketens in Python.
Gegeven een trainingsdataset met datapunten, D, en hun bijbehorende labels, L, leert een discriminatief model de voorwaardelijke kansverdeling P(D | L). Het gebruikt deze voorwaardelijke kansverdeling vervolgens om de klasse van nieuwe datapunten te voorspellen.
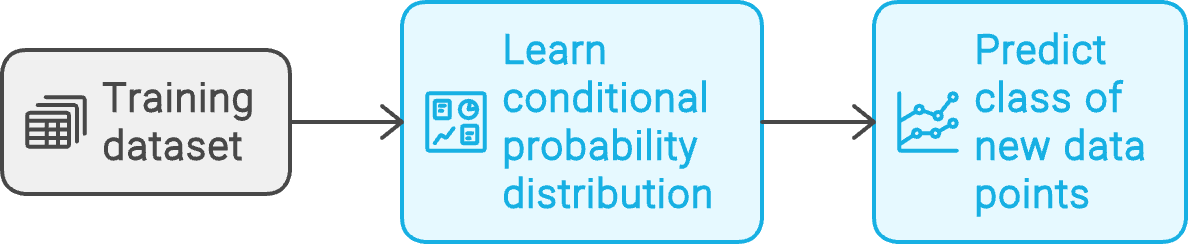
Workflow van een discriminatief model. Gemaakt met napkin.ai
Discriminatieve modellen worden doorgaans gebruikt om classificatieproblemen op te lossen. De volgende voorbeelden laten hun use-cases zien.
K-nearest neighbors (KNN) is een van de oudere machine learning-modellen. Het is gebaseerd op het uitgangspunt dat, gegeven een verdeling van datapunten, vergelijkbare items zich dicht bij elkaar bevinden.
KNN-modellen zijn niet-parametrisch, zonder parameters zoals regressiecoëfficiënten. Ze worden gebruikt voor zowel classificatie- als regressieproblemen.
De categorie van een invoerdatapunt is dezelfde als die van zijn k naaste buren. De voorspelde waarde van een datapunt is de gemiddelde waarde van zijn k naaste buren. k (het aantal te beschouwen naaste buren) kan worden gezien als een hyperparameter van het model. Deze wordt gebruikt om het gedrag van het model af te stemmen, maar beïnvloedt niet direct de output van het model.
Logistische regressie probeert, net als lineaire regressie, de waarde van een afhankelijke variabele te voorspellen op basis van een of meer onafhankelijke variabelen. Bij lineaire regressie neemt de afhankelijke variabele continue waarden aan. Bij logistische regressie neemt de afhankelijke variabele discrete waarden aan, zoals:
Lineaire regressie voorspelt numerieke waarden. Bij logistische regressie is de voorspelde grootheid de logaritme van de odds-ratio.
Voor een gebeurtenis A, met kans P(A), is de odds-ratio P(A) / (1 - P(A)). Het gebruik van de logaritme (van de odds-ratio) zorgt voor soepelere en snellere convergentie tijdens het trainingsproces. Gezien hun vermogen om input in klassen te scheiden, worden logistische modellen voor discriminatieve doeleinden gebruikt.
Voor een meer praktische introductie, raadpleeg de gids over logistische regressie in Python.
Je kunt logistische regressie ook implementeren met R, een op statistiek gerichte programmeertaal, zoals uitgelegd in de tutorial over logistische regressie met R.
Support vector machines bepalen de optimale lijn die datapunten van verschillende klassen scheidt. In het 2-dimensionale X-Y-vlak, gegeven een verzameling datapunten van twee verschillende categorieën, voorspelt de SVM een lijn die (idealiter) punten van de ene categorie schoon scheidt van die van de andere.
Deze lijn is de beslissingsgrens. Voor data met drie of meer dimensies wordt dit een hypervlak. Datapunten (uit beide categorieën) die het dichtst bij deze denkbeeldige lijn liggen, worden de support vectors van het model genoemd. Deze datapunten zijn het moeilijkst te classificeren omdat hun waarden dicht bij elkaar liggen.
De afstand tussen de scheidingslijn en de support vectors heet de marge. SVM-training is erop gericht de beslissingsgrens te vinden die deze marge maximaliseert. In de praktijk hebben datapunten meer dan twee dimensies, en is de scheidingslijn een hypervlak in hogere dimensies.
SVM’s worden ook gebruikt voor classificatieproblemen met meerdere klassen.
Wil je meer leren over SVM’s, volg dan deze gids voor het bouwen van SVM’s met het Python-pakket scikit-learn. Naast Python kun je ook R gebruiken om SVM’s te implementeren, zoals besproken in deze gids over SVM’s in R.
Een beslisboom bestaat uit meerdere beslisknopen die zijn georganiseerd in een boomstructuur.
De bovenste knoop is de wortel. Knooppen die tot einduitvoer leiden, heten bladknopen of terminale knopen. Tussenliggende niet-bladknopen heten interne knopen. De output van de wortelknoop gaat naar de tussenliggende knopen. Het resultaat (de output) van elke knoop is ofwel de einduitvoer, of leidt (vertakt) naar een andere knoop.
Elke knoop van de boom splitst de dataset op basis van een bepaald attribuut. Een beslisboom voor het goedkeuren van leningaanvragen kan bijvoorbeeld knopen hebben die aanvragen scheiden op basis van hun netto-inkomen.
Het trainingsproces bepaalt de juiste drempelwaarde voor elke beslissing. Bijvoorbeeld: aanvragen met een netto-inkomen onder een bepaald bedrag worden direct afgewezen. De rest wordt verder verwerkt in volgende knopen, die andere attributen in beschouwing nemen, zoals het nettovermogen.
Voor een praktische gids voor beslisbomen, volg de tutorial over beslisbomen bouwen met Python, of de volledige cursus over machine learning met boombasede modellen in Python.
Het grootste nadeel van beslisbomen is overfitting, wat leidt tot problemen met out-of-sample data. Beslisbossen proberen dit probleem op te lossen. Een beslisbos bestaat uit veel bomen. In tegenstelling tot zelfstandige beslisbomen, die de volledige feature set moeten bekijken, vindt elke boom in een bos slechts een willekeurige subset van de feature set. Deze willekeur helpt de variantie in noisy datasets aan te pakken.
De bosoutput wordt verkregen door bijvoorbeeld het gemiddelde te nemen van de output van individuele bomen.
Wil je leren hoe je random forests implementeert, raadpleeg dan de gids over scikit-learn gebruiken voor het bouwen van random forest-classificators.
Een neuraal netwerk bestaat uit groepen neuronen. Elk neuron implementeert een lineaire functie die de gewichten van het neuron met de invoervector vermenigvuldigt.
Op de lineaire functie volgt een niet-lineaire activatiefunctie. De activatiefunctie bepaalt de output van elk neuron op basis van de output van de lineaire functie. Conceptueel kun je een simpel neuraal netwerk dus zien als een reeks lineaire vergelijkingen gefilterd door niet-lineaire activaties.
De inputlaag van een neuraal netwerk vermenigvuldigt de input (weergegeven als een vector) met een set gewichten en activatiefuncties. Deze output gaat door naar de volgende laag, die een vergelijkbare operatie uitvoert.
Verborgen lagen bevinden zich tussen de input- en output lagen. De laatste verborgen laag voedt de outputlaag. Complexe problemen vragen om neurale netwerken met veel verborgen lagen, zogenaamde deep neural networks (DNN’s).
Bij een classificatieprobleem is een gangbare aanpak om evenveel outputneuronen te hebben als het aantal klassen. De voorspelde klasse komt overeen met het neuron met de hoogste waarde. Bij een regressieprobleem bevat één enkel outputneuron de voorspelde output. De lineaire relaties van de neuronen modelleren de lineaire regressievergelijking.
Voor een diepere duik in het onderwerp, bekijk de blogpost over neurale netwerken.
Sommige taken, zoals classificatie, kunnen met beide modeltypen worden opgelost. Over het algemeen hebben discriminatieve en generatieve modellen echter vaak unieke use-cases, omdat deze modellen verschillende wiskundige benaderingen hanteren. Het is nodig deze verschillen te begrijpen en hoe ze de geschiktheid van elk van beide categorieën voor diverse problemen beïnvloeden.
Generatieve modellen voorspellen de volgende waarde in een reeks of genereren een afbeelding op basis van tekst (of andersom). Om zulke taken uit te voeren, moet het model leren welke output het moet genereren bij verschillende inputs. Het model gebruikt de gezamenlijke kansverdeling van de input en de output.
Om de onderliggende wiskunde te begrijpen, beginnen we met een eenvoudig voorbeeld. Het gedrag van één willekeurige variabele wordt beschreven door zijn kansdichtheidsfunctie (PDF).
De PDF van de willekeurige variabele X kan worden gebruikt om de kans van X bij verschillende waarden te bepalen. Als bijvoorbeeld de PDF van X gelijk is aan f(x), dan is de kans dat X tussen A en B ligt, gegeven door:

De kans op X over het gehele bereik is 1. Dit wordt uitgedrukt als:

Bovenstaande uitdrukking kan ook worden geschreven als:
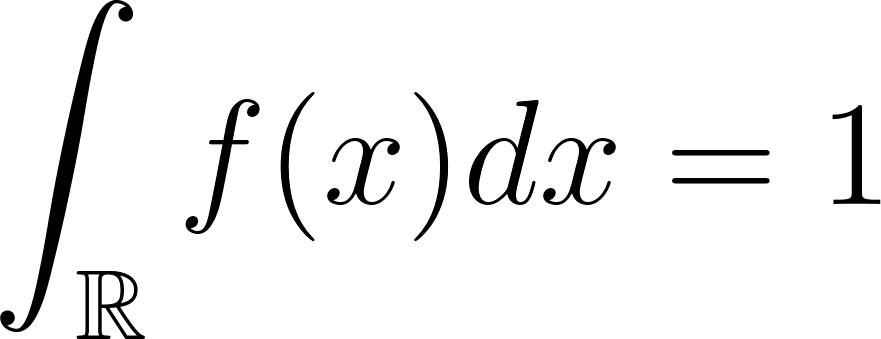
Voor een gezamenlijke PDF van twee variabelen, X en Y, is de integraal over het gehele bereik 1:

De gezamenlijke kansverdeling brengt de gehele kansruimte van zowel X als Y in kaart. Om de kans te evalueren dat de gezamenlijke kans P(X, Y) in een gebied G valt, integreer je de gezamenlijke PDF over G:

Discriminatieve modellen richten zich daarentegen alleen op de voorwaardelijke kansverdeling. Generatieve modellen schatten, indien nodig, de voorwaardelijke kans met behulp van de marginale kansen.
Gegeven een gezamenlijke kansverdeling fXY(x,y), is de marginale kans van de willekeurige variabele Y bij de waarde y (voor alle waarden van X) gegeven door:
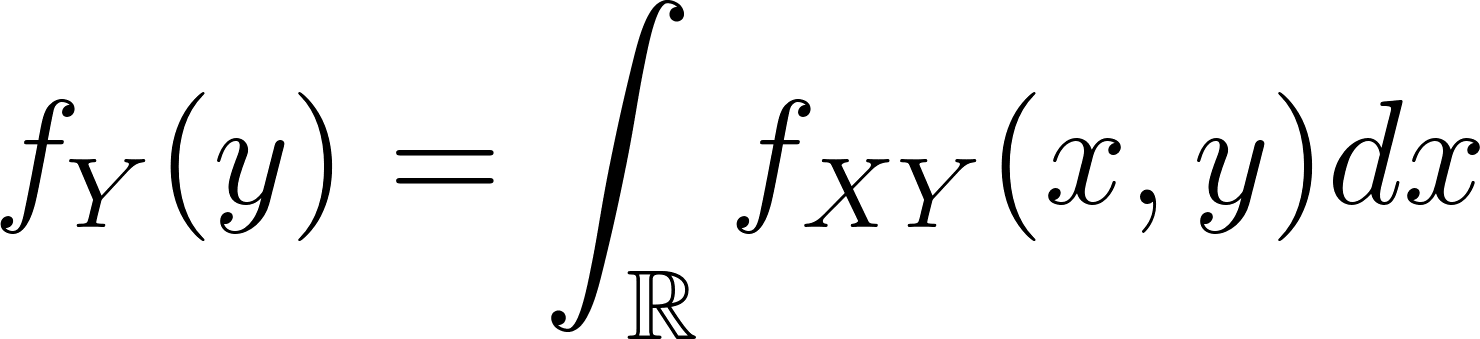
Analoog aan de regel van Bayes wordt de voorwaardelijke PDF van X dan uitgedrukt als:
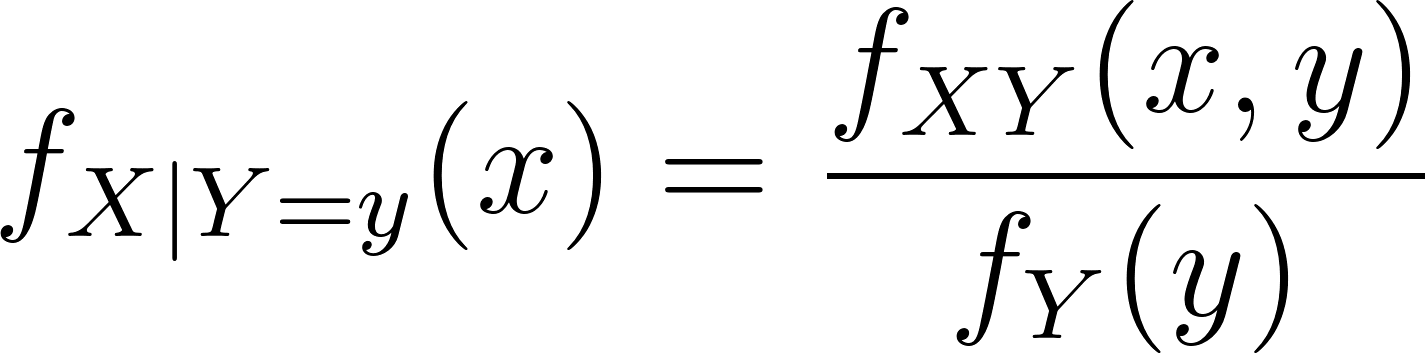
Bovenstaande uitdrukking toont de integraalvariant van de voorwaardelijke kans, die vaker als volgt wordt geschreven:
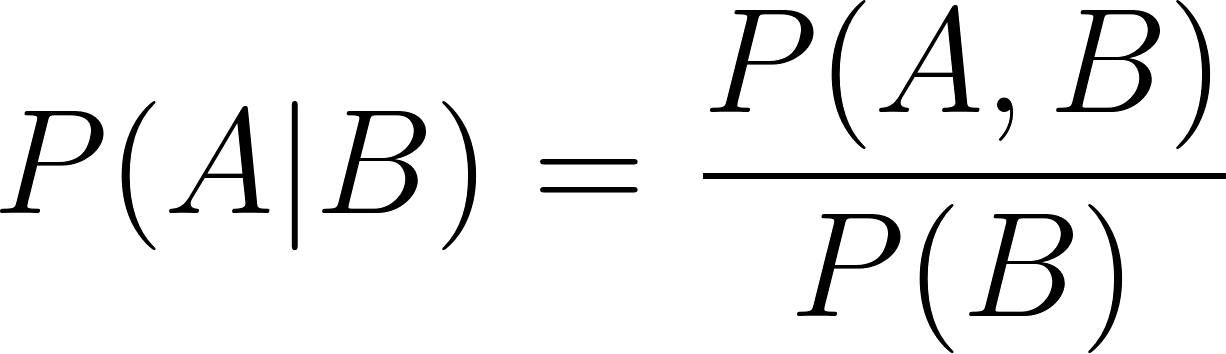
Evenzo,
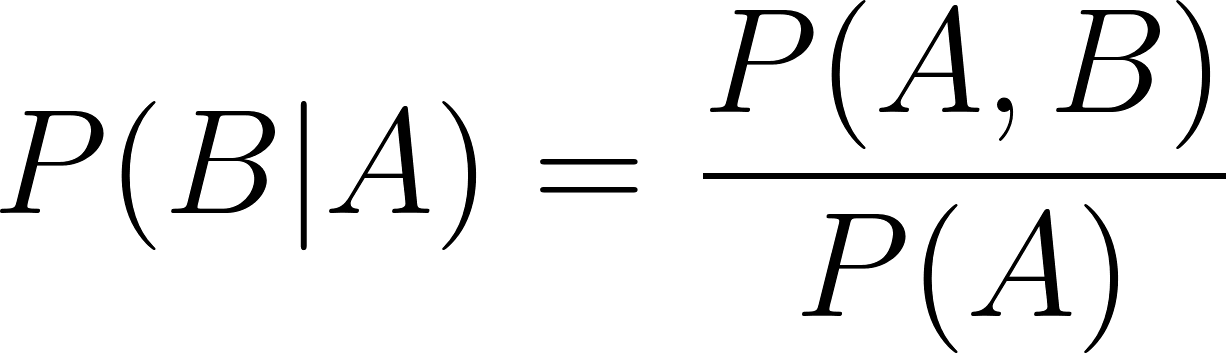
In de twee bovenstaande formules voor voorwaardelijke kansen geldt:
Om een voorwaardelijke kans te berekenen, volgen generatieve modellen twee stappen:
Discriminatieve modellen volgen daarentegen één (en eenvoudigere) stap:
Een generatief model heeft de marginals P(A) en P(B) en de gezamenlijke PDF P(A, B). Daarmee kan het met evenveel gemak P(A | B) of P(B | A) evalueren. Dit is het onderliggende idee achter naive Bayes-classificators. Zo kunnen generatieve modellen taken uitvoeren zoals:
Dit maakt generatieve modellen flexibel en multifunctioneel. Daar staat tegenover dat ze inherent meer complexiteit in de training met zich meebrengen omdat:
Discriminatieve modellen houden zich daarentegen alleen bezig met conditionals. Op basis van de trainingsdataset is het mogelijk de voorwaardelijke kansen direct te schatten zonder de gezamenlijke of marginale kansen te schatten.
Daardoor zijn discriminatieve modellen eenvoudiger te trainen. Een discriminatief model dat de voorwaardelijke kans P(A | B) heeft geleerd, kan echter alleen taken uitvoeren die deze specifieke voorwaardelijke kans gebruiken. Het kan niets anders.
Generatieve modellen zijn flexibel genoeg voor zowel generatieve als discriminatieve taken. Tijdens de training leert het model de gezamenlijke PDF en de marginals. Tijdens inferentie moet het model de voorwaardelijke kans berekenen met behulp van de gezamenlijke verdeling en de juiste marginale kans. Daarom is inferentie bij discriminatieve taken trager.
Discriminatieve modellen daarentegen hebben de voorwaardelijke kansen direct (numeriek) geleerd. Ze schatten tijdens inferentie de voorwaardelijke kans in één stap, op basis van de inputdata.
Bovendien, omdat discriminatieve modellen zich uitsluitend richten op het schatten van één grootheid (de voorwaardelijke kans), blijken ze nauwkeuriger te zijn. Een gezamenlijke PDF bevat meer onzekerheid dan een eenvoudige voorwaardelijke kans. Die extra onzekerheid zie je terug in de relatief lagere nauwkeurigheid van generatieve modellen bij classificatietaken.
Op basis van de bespreking in de vorige secties vat de tabel hieronder de verschillen tussen generatieve en discriminatieve modellen samen.
|
Generatieve modellen |
Discriminatieve modellen |
|
|
Doel |
De gezamenlijke kans en de marginale kans vastleggen. De regel van Bayes gebruiken om de voorwaardelijke kans te berekenen. |
Alleen de voorwaardelijke kans vastleggen. Er is geen informatie over gezamenlijke of marginale kansen. |
|
Datageneratie |
Kan nieuwe datapunten genereren op basis van de trainingsdataset. Een model dat bijvoorbeeld is getraind op handgeschreven cijfers kan nieuwe, fictieve cijfers genereren. |
Kan geen nieuwe datapunten genereren. Richt zich primair op het onderscheiden van verschillende categorieën data. |
|
Primaire use-case |
Kan worden gebruikt voor zowel generatieve taken (bijv. datasynthese) als discriminatieve taken (bijv. classificatie). |
Kan alleen worden gebruikt voor discriminatieve taken zoals classificatie of regressie. |
|
Inferentieprestaties |
Inferentie uitvoeren is trager door de noodzaak van complexe berekeningen. Zelfs eenvoudige taken vereisen het berekenen van marginale en gezamenlijke kansen en het toepassen van de regel van Bayes. |
Snellere inferentie omdat de voorwaardelijke kans direct wordt berekend zonder de regel van Bayes. |
|
Omgaan met missende data |
Beter in het omgaan met ontbrekende data door de onderliggende kansverdeling te modelleren, waardoor het eenvoudiger is om “gaten te vullen”. Lager risico op overfitting. |
Minder effectief in het omgaan met ontbrekende data. Hoger risico op overfitting omdat het model zich richt op het vinden van het scheidende hypervlak tussen klassen. |
|
Convergentie |
Ze neigen sneller te convergeren en met minder trainingsvoorbeelden, maar resulteren over het algemeen in een hogere modelfout, vooral bij classificatietaken, door de indirecte berekening van de voorwaardelijke kans via het modelleren van de gezamenlijke kansverdeling. |
Ze vereisen over het algemeen meer data om te trainen en kunnen langzamer convergeren. Het resultaat is echter een lagere modelfout, vooral bij classificatietaken, omdat ze de voorwaardelijke kans direct modelleren zonder de gezamenlijke kansverdeling te schatten. |
|
Modelcomplexiteit |
Ze zijn doorgaans complexer omdat ze de volledige dataverdeling modelleren, inclusief de interacties tussen features en labels. |
Over het algemeen eenvoudiger omdat ze alleen de beslissingsgrens of het scheidende hypervlak tussen klassen hoeven te modelleren. |
|
Voorbeelden van modellen |
Naive Bayes, Hidden Markov Models (HMM’s), Generative Adversarial Networks (GAN’s), Variational Autoencoders (VAE’s). |
Logistische regressie, Support Vector Machines (SVM’s), neurale netwerken en beslisbomen. |
|
Modelflexibiliteit |
Flexibeler qua toepassing (kan zowel generatieve als discriminatieve taken aan). |
Minder flexibel (beperkt tot discriminatieve taken). |
|
Foutpercentages |
Hogere foutpercentages bij classificatietaken door indirecte schattingsmethoden. |
Lagere foutpercentages bij classificatietaken door directe training op voorwaardelijke kans. |
Zoals de naam al aangeeft, zijn generatieve modellen bij uitstek geschikt voor taken waarbij nieuwe data moet worden gegenereerd die past bij de patronen in de trainingsdata.
Enkele veelvoorkomende use-cases van deze modellen zijn:
Voor veel computervisiemodellen is een grote dataset met trainingsafbeeldingen essentieel. Deze modellen moeten worden getraind op veel varianten van dezelfde afbeelding of feature.
Het is niet altijd realistisch om foto’s van hetzelfde object te maken vanuit verschillende hoeken, achtergronden of kleurtonen. Veel taakspecifieke afbeeldingsdatasets zijn bovendien beperkt van omvang omdat ze domeinspecifieke expertise vereisen om te maken. Zo heb je voor een dataset met röntgenfoto’s van een specifieke longziekte toegang nodig tot longartsen, radiologielabs en toestemming van patiënten en ziekenhuizen.
In zulke gevallen is de meest pragmatische optie om een kleine maar sterk gecureerde en relevante dataset te maken en vervolgens synthetisch nieuwe datapunten te genereren die lijken op de originele dataset.
Nieuwe beelden genereren op basis van een tekstbeschrijving of nieuwe tekst genereren gegeven invoertekst. De enige klasse van modellen die dergelijke taken aankan, zijn generatieve modellen.
Beeldgeneratiemodellen zoals DALL-E, MidJourney en Stable Diffusion worden routinematig gebruikt om afbeeldingen te genereren die bij een specifieke beschrijving passen en geen bestaande auteursrechten schenden.
Evenzo worden LLM’s vaak gebruikt om fictieve verhaallijnen, marketingslogans en -taglines, samenvattingen van documenten en andere vergelijkbare materialen te genereren.
Generatieve modellen worden gebruikt voor taken die gebaseerd zijn op de gezamenlijke kansverdeling van de onderliggende data. Het modelleren van de gezamenlijke verdeling van activarendementen om het verwachte risico- en rendementsprofiel van een beleggingsportefeuille te voorspellen is standaard in finance en risicobeheer.
Een beleggingsmanager wil bijvoorbeeld weten wat de kans is dat de prijzen van twee verschillende aandelen gelijktijdig stijgen of dalen—gezamenlijke PDF’s kunnen zulke vragen beantwoorden.
De financiële sector gebruikt deze statistische methoden al lang voordat de term “generatieve modellen” breed werd gebruikt.
Problemen zoals ongecontroleerde classificatie lenen zich bij uitstek voor Gaussiaanse mengmodellen. Bij deze problemen heb je een grote verzameling datapunten, maar weet je niet hoeveel of welke categorieën er zijn. Het is redelijk om te verwachten dat de data afkomstig is van een combinatie van verdelingen, die een GMM kan modelleren.
Als het aantal en de lijst met categorieën vooraf bekend waren, zouden discriminatieve methoden geschikter zijn geweest.
GMM’s zijn ook nuttig bij outlier-analyse (anomaliedetectie, fraudedetectie, enz.), waar de “gebruikelijke” data, zoals het gedrag van verschillende klantgroepen, kan worden gemodelleerd als een combinatie van verschillende verdelingen. Afwijkende datapunten wijken significant af van elk van de andere patronen.
Problemen waarbij reeksen betrokken zijn, worden vaak opgelost met hidden Markov-modellen. Een alledaagse use-case is het modelleren van genoomsequenties en her-sequencing.
HMM’s worden ook gebruikt bij spraakherkenning, waar ze helpen het volgende lettergreep te voorspellen gegeven de reeks voorafgaande lettergrepen. Sequentiemodellering is ook gebruikelijk voor logistieke toepassingen zoals bezorgschema’s van pakketten. Evenzo worden overdracht en verspreiding van infectieziekten vaak gemodelleerd met Markov-ketens.
Wiskundig gezien worden discriminatieve modellen gebruikt voor toepassingen waar alleen de voorwaardelijke kans relevant is, en niet de gezamenlijke kans. Daarom worden discriminatieve modellen doorgaans gebruikt voor classificatieproblemen en voorspellingsproblemen.
Enkele voorbeelden zijn:
Gecontroleerde classificatieproblemen, waarbij de klassen (categorieën) vooraf bekend zijn. Dit is de typische use-case voor KNN’s en SVM’s.
Je hebt een grote verzameling datapunten, zoals klantgedragsdata, inclusief bestedingspatronen, aankoopbedragen, koopfrequentie, retourgeschiedenis, enzovoort. Je moet deze informatie gebruiken om de lijst met klanten in verschillende categorieën in te delen, zoals grootverbruikers, koopjesjagers, vaste klanten, niet-serieuze klanten, enz. Zet dit af tegen ongecontroleerde classificatieproblemen, waarbij, zoals eerder besproken, GMM’s vaak worden gebruikt.
Bij predictieve taken zoals classificatie en regressie zijn snelheid en nauwkeurigheid vaak prioriteit. In principe kunnen generatieve modellen zulke problemen ook oplossen.
In het bijzonder hebben generatieve modellen de voorkeur wanneer er problemen zijn zoals ontbrekende datapunten, wanneer slechts een beperkte dataset beschikbaar is voor training, of wanneer je verwacht regelmatig nieuwe categorieën toe te voegen.
Voor de meeste standaard use-cases lijden generatieve modellen echter aan hogere foutpercentages en tragere inferentie bij predictieve taken, omdat hun berekening de gezamenlijke kansverdeling omvat. Daarom hebben bij standaard classificatie- en regressieproblemen, waarbij een grote en gezonde dataset beschikbaar is voor training, discriminatieve modellen de voorkeur vanwege hun betere prestatiekenmerken.
Discriminatieve modellen hebben de voorkeur voor taken die zich alleen richten op de uitkomst van de classificatie en niet op het modelleren van de onderliggende data.
Als je bijvoorbeeld audiobestanden in hun respectieve talen wilt categoriseren, heb je geen model nodig dat de taal en grammatica begrijpt. Een spraakherkenningsmodel zou overkill zijn voor een classificatieprobleem. Het is voldoende om te focussen op de beslissingsgrens met een discriminatief model. Je kunt dus een eenvoudig neuraal netwerk gebruiken in plaats van een LLM of logistische regressie in plaats van een Bayesiaans model.
Beslissingen in meerdere stappen, waarbij de afzonderlijke stappen eenduidige keuzes omvatten, zijn goede kandidaten voor beslisbomen. Beslisbomen worden vaak gebruikt als een voorlopige filter om datapunten te selecteren die diepere analyse vereisen.
Neem bijvoorbeeld fraudedetectie, vaak opgelost met complexe modellen zoals GMM’s. Mensen onderzoeken bijna altijd transacties met hoog risico, ongeacht het gebruikte model. Een alternatieve aanpak is dus om een beslisboom te gebruiken om een lijst met mogelijk frauduleuze transacties te markeren voor verdere handmatige controle.
Beslisbomen worden ook in veel bedrijfsprocessen gebruikt. Het doel is het kiezen van de juiste handelwijze op basis van vooraf bepaalde voorwaarden. Zulke taken hebben noch generatieve modellen, noch de complexere discriminatieve modellen zoals neurale netwerken nodig.
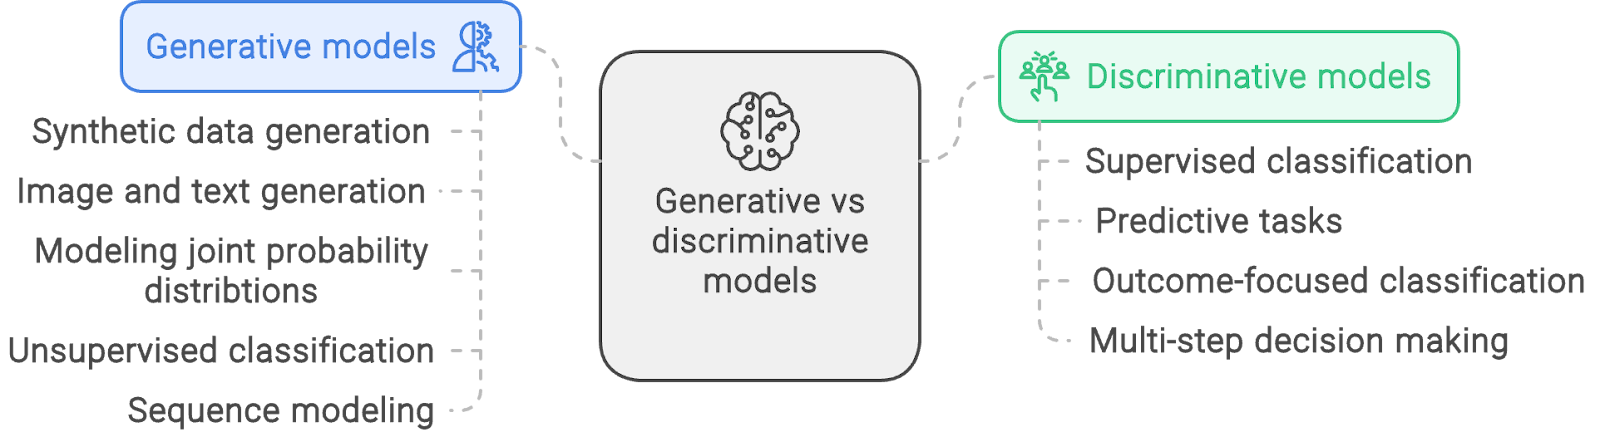
Voorbeeldtoepassingen van generatieve vs. discriminatieve modellen. Gemaakt met napkin.ai
Dit artikel legde de fundamentele principes en belangrijkste verschillen uit tussen generatieve en discriminatieve modellen, de twee belangrijkste benaderingen binnen machine learning-technieken.
Hoewel het meeste machine learning op probabilistische methoden is gebaseerd, zijn generatieve modellen gebaseerd op de gezamenlijke kansverdeling, terwijl discriminatieve modellen alleen voorwaardelijke kansen gebruiken. Daardoor hebben de twee modelklassen verschillende toepassingen en prestatiekenmerken. Gezien de beschikbaarheid van een brede waaier aan modellen, is het essentieel om het juiste gereedschap voor de taak te kiezen.
Naast een conceptueel begrip van modeltypen en hun verschillen is het belangrijker om zelf modellen te bouwen. Begin met de blogpost over gecontroleerde trainingsmethoden en het bouwen van een eenvoudig logistisch regressiemodel.
Leer meer over machine learning met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

