Zes dagen nadat Anthropic Claude Opus 5.5 bovenaan zijn line-up zette, heeft het mid-tier model het grootste deel van de achterstand ingelopen voor de helft van de prijs. Claude Sonnet 5.5 verslaat Opus 5.5 op één benchmark en blijft daarbuiten slechts enkele punten achter, terwijl het de prijs van Sonnet 5 handhaaft.
We hebben dit patroon eerder gezien. Claude Sonnet 5 kwam uit en benaderde de agentische benchmarks van Opus 4.8 voor een fractie van de kosten. Daarvoor kwam Sonnet 4.6 dichtbij Opus 4.6 onder dezelfde voorwaarden. Elke keer verschijnt er dagen of weken na het vlaggenschip een mid-tier model dat het grootste deel van de kloof dicht tegen de halve prijs.
Zo ziet een logaritmische schaalcurve er van buitenaf uit. De prestaties nemen grofweg toe met de log van compute, dus de kosten stijgen grofweg exponentieel met de prestaties. Een vlaggenschipmodel zit bovenaan die curve, waar het flink uitgeeft om de laatste paar punten te kopen. Een goedkoper model dat weken later wordt gebouwd en profiteert van dezelfde onderliggende vooruitgang, hoeft slechts een lager punt op de curve te bereiken om bijna even goed te lijken. Met andere woorden: het grootste deel van de waarde op de curve is nog steeds goedkoop te pakken, en alleen het laatste stuk is duur.
Dat is het uitpluizen waard, want de koplopers doen met PR en branding soms wat tovenarij.
TL;DR
- Sonnet 5.5 is Anthropics nieuwe mid-tier model en vervangt Sonnet 5 voor dezelfde prijs.
- De grootste winst zit in agentisch terminal-coden, waar het nu zelfs nipt voorloopt op Opus 5.5.
- Bij kenniswerk en computergebruik zit het net achter Opus 5.5 voor de helft van de per-tokenprijs.
- Maak het je standaard Claude-model en bewaar Opus 5.5 voor open, oordeel-intensief werk.
Wat is Claude Sonnet 5.5?
Anthropic's modeldocumentatie omschrijft Claude Sonnet 5.5 als "de beste combinatie van snelheid en intelligentie" in de huidige line-up. Het is het mid-tier model in Anthropics Claude 5.5-familie, tussen het vlaggenschip Claude Opus 5.5 en de aankomende Claude Haiku 5.5. (We houden je op de hoogte van Haiku 5.5, al is Haiku 5 nooit verschenen.)
Vergeleken met Sonnet 5 is de sprong groter dan een halve versienummer doet vermoeden. Dat is niet verrassend nadat we zagen dat de sprong tussen Opus 5.5 en Opus 5 ook groter was dan verwacht.
Wat betreft de lanceerpost: Anthropic rapporteert winst op elke gepubliceerde benchmark, met de grootste sprongen in terminal-coden, grafieklezen en evaluaties van kenniswerk.
Interessant is dat Anthropic zegt dat dit Sonnet-model als eerste Pokémon Red verslaat door alleen vanaf screenshots te werken. Het klinkt ongewoon, maar dit is een test die Anthropic gebruikt als proxy voor langetermijnwerk en beeldbegrip.
Opus 5.5 blijft, in de woorden van het bedrijf, duidelijk sterker bij complex, open werk dat aanhoudend oordeel vereist. Maar Sonnet 5.5 is het model voor taken waarbij je weet hoe "klaar" eruitziet, wat een handige vuistregel is.
Belangrijkste functies van Claude Sonnet 5.5
Het meeste nieuws in Sonnet 5.5 draait om hetzelfde werk sneller en met minder tokens doen, plus een paar wijzigingen waar API-gebruikers rekening mee moeten houden.
Bereik bijna-Opus resultaten op alledaagse taken op Sonnet-snelheid
Je kunt Sonnet 5.5 het soort werk geven dat eerder om Opus vroeg en het sneller terugkrijgen. Anthropic zegt dat het genereren van output ruim 30% sneller is dan bij Sonnet 5, en dat het model per taak minder tokens gebruikt - "tot 30% minder per taak" - is de formulering die ze gebruiken.
Vroege testers die in de lanceerpost worden geciteerd, onderschrijven dit met eigen cijfers:
- Base44 rapporteert 3,6 iteraties per app-build met Sonnet 5.5, tegenover 7,7 met Opus 5.
- Box zag workloads 2,4x sneller draaien met 12% minder totale tokens.
- Zendesk mat 20% snellere ticketverwerking.
- Slack meldt ongeveer 14% minder outputtokens.
Dit zijn door de leverancier geselecteerde klantquotes. Toch is er een patroon: minder iteraties en minder tokens, wat naast het per-token tarief scheelt op je rekening.
Draai code-agents in de terminal en op het bureaublad
Sonnet 5.5 is gebouwd om als agent te werken: shell-commando's draaien, bugs in een repo fixen en een desktop bedienen via screenshots. Het is vanaf de lancering live in Claude Code, en Anthropic noemt het computergebruik vergelijkbaar met Opus 5.5.
De praktische uitkomst voor veel mensen is dat Sonnet 5.5 nu een geloofwaardige standaard is voor Claude Code-sessies en voor agentloops die je zelf bouwt met onze Claude API-gids.
Maak verzorgde documenten, slides en interfaces
Anthropic noemt een "scherp oog voor design" als een kracht van Sonnet 5.5. In de praktijk zou dat moeten betekenen: beter ogende gebruikersinterfaces wanneer je het vraagt om front-end code te verfijnen, en meer afgewerkt resultaat bij verzoeken om slides, spreadsheets of lange documenten.
De designclaim is degene die het meest onafhankelijke toetsing nodig heeft. Dit is het lastigst te benchmarken en de lanceerpost staaft het alleen met klantquotes.
Reken op waarborgen bij security- en biologie-werk
Sonnet 5.5 is het eerste Sonnet-model dat wordt gelanceerd met cybersecurity-waarborgen vergelijkbaar met die op Opus 5.5. Wanneer een verzoek als hoger-risico securitywerk wordt geclassificeerd, valt het verzoek terug naar Sonnet 5. Biologie-waarborgen zijn hetzelfde als op Sonnet 5, en Anthropic zegt dat de meeste softwareontwikkeling en life-sciences-werk onaangetast blijven.
Het is ook de eerste Sonnet die wordt geleverd met classifiers die het extraheren van redeneringen blokkeren, en denkblokken zijn nu gekoppeld aan het account en het gesprek waarin ze zijn gemaakt. Als je security-tooling draait, test je prompts dan voordat je een pipeline omschakelt.
Migreer van Sonnet 5 met een paar codewijzigingen
Alleen het model-ID wisselen is net niet genoeg. Anthropics documentatie noemt vijf breaking changes voor code die al op Sonnet 5 draait:
-
Adaptive thinking staat standaard aan, en de laagste instelling is
between_tools, wat voorafgaand denken uitschakelt. -
Geforceerd toolgebruik geeft een foutmelding.
-
Denkblokken zijn gekoppeld aan het model en het gesprek waarin ze zijn gemaakt.
-
De oudere
computer_20251124computer-use tool wordt afgewezen op de Claude API en Google Cloud. -
De advisor-tool accepteert Opus 4.8, Opus 4.7 of Sonnet 5 niet langer als advisors.
Er is ook een stillere wijziging: tekst tussen tool-calls komt nu terug in thinking-blokken. Een app die tekst naar gebruikers streamt, blijft stil tussen tool-calls totdat je de display-instelling bijwerkt. Het instellen van temperature, top_p of top_k op een niet-standaardwaarde geeft ook een 400-fout. Dit zijn specifieke dingen waar je tegenaan kunt lopen.
Hoe presteert Claude Sonnet 5.5 op de benchmarks?
Claude Sonnet 5.5 verslaat Sonnet 5 op elke gepubliceerde benchmark van Anthropic, verslaat Opus 5.5 op terminal-coden en blijft elders enkele punten achter op Opus 5.5. Tegen OpenAI's GPT-6 Sol ligt het voor op de evaluaties van kenniswerk en grafieklezen, maar blijft het achter op FrontierCode. Alle cijfers hieronder komen uit Anthropics lanceerpost.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | Niet gerapporteerd |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | Niet gerapporteerd |
| FrontierCode 1.1 (Main) | 46.2% (max effort) | 42.4% | 54.4% | 49.3% (52.1% bij xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (met tools) | 64.5% | 54.9% | 67.7% | Niet gerapporteerd |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | Niet gerapporteerd |
| Chartography (zonder tools) | 61.6% | 15.6% | 64.4% | 53.6% |
De tabel vertelt een eenvoudig verhaal: een grote generatie-stap boven Sonnet 5 en een bijna-gelijkspel met Opus 5.5. Laten we bekijken wat elk gebied voor jouw werk betekent.
Agentisch coden
Terminal-Bench 4.0 is waar Sonnet 5.5 zich onderscheidt. Het scoort 70,6%, omhoog van Sonnet 5's 10,3% en voor Opus 5.5's 66,4%. De benchmark meet of een model echte taken kan voltooien in een command-line omgeving, zoals meerstaps shell-workflows, en sluit dus nauw aan bij hoe Claude Code wordt gebruikt.
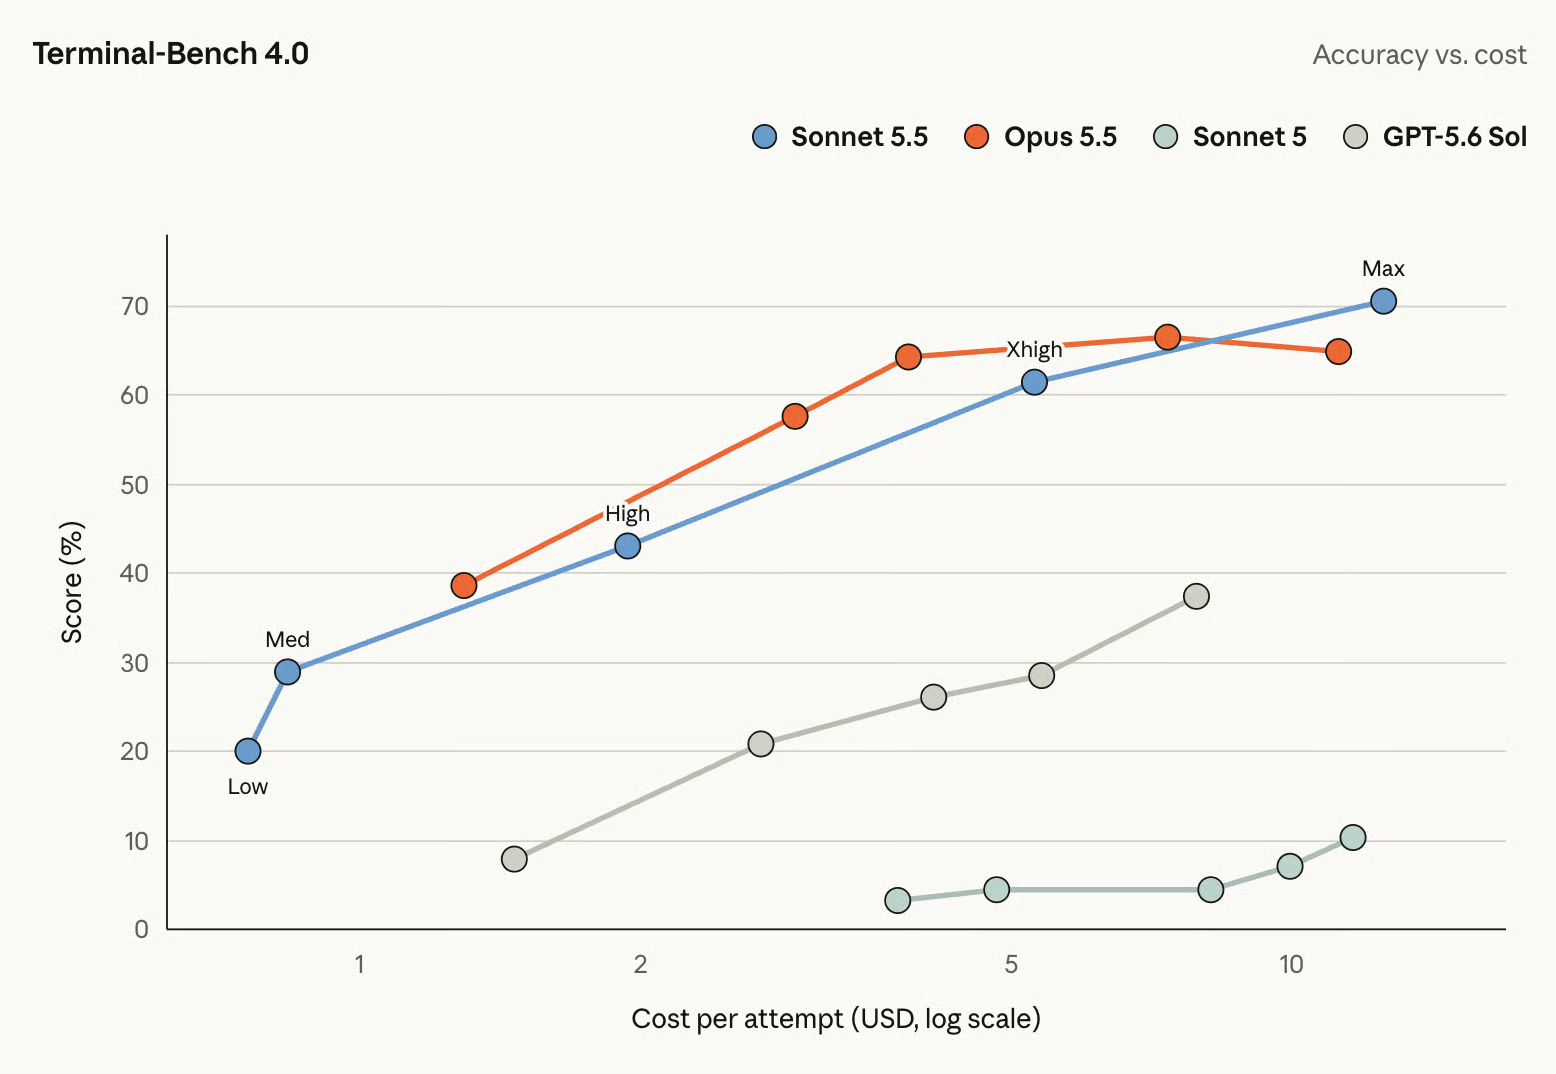
Een sprong van 60 punten in één release is al ongewoon. De rest van het codebeeld is minder dramatisch.
Kenniswerk
Op GDPval-AA v2.1, dat modeloutput beoordeelt op economisch waardevolle taken uit echte beroepen met een Elo-achtige score, scoort Sonnet 5.5 1844. Dat is 2 punten achter Opus 5.5 en bijna 400 boven Sonnet 5.
Voor teams die Claude gebruiken voor rapporten, analyses en zakelijke documenten is dit het nuttigste resultaat in de tabel. Bij dit soort werk koop je met de extra kosten van Opus 5.5 maar weinig bij.
Redeneren en visueel begrip
Chartography, een test van lezen en redeneren over grafieken zonder tools, laat de grootste relatieve winst zien: Sonnet 5.5 scoort 61,6% tegenover 15,6% voor Sonnet 5. Dat sluit aan bij Anthropics claims over beter beeldbegrip.
Computergebruik
Op OSWorld 2.1, dat meet of een model taken kan voltooien door een echt desktopbesturingssysteem te bedienen, haalt Sonnet 5.5 80,1%, omhoog van 57,0% voor Sonnet 5 en binnen 2 punten van Opus 5.5.
Welke tier moet je gebruiken?
Voor de meeste developers zou Sonnet 5.5 nu het standaard Claude-model moeten zijn. Opus 5.5 verdient zijn hogere prijs alleen wanneer de taak zo open is dat oordeel, niet snelheid, de bottleneck is.
De huidige line-up, volgens Anthropics modelvergelijkingstabel, ziet er zo uit. Alle vier de modellen behalve Haiku 4.5 delen een contextvenster van 1M tokens en 128K maximale output.
| Model | Prijs (input / output per 1M tokens) | Latentie | Beste voor |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Langzamer | Top-end werk waar capaciteit zwaarder weegt dan kosten |
| Claude Opus 5.5 | $4 / $20 | Gemiddeld | Complex, open werk dat aanhoudend oordeel vereist |
| Claude Sonnet 5.5 | $2 / $10 | Snel | Goed afgebakend coden, agents en documentwerk |
| Claude Haiku 4.5 | $1 / $5 | Snelst | Groot volume, kostenkritische taken |
Binnen Sonnet 5.5 is de effort-instelling de andere hefboom. Anthropic heeft vijf niveaus opnieuw gekalibreerd: low, medium, high, xhigh en max. Lagere instellingen geven voorrang aan snelheid en kosten, hogere laten het model langer redeneren en zijn eigen werk controleren. De standaard is medium in de Claude-apps en Claude Code, en high op de API.
Één detail uit de lanceerpost verandert hoe ik het zou gebruiken: bij low of medium effort verslaat Sonnet 5.5 op meerdere benchmarks de beste score van Sonnet 5 voor ongeveer een tiende van de kosten per taak. Samengevat:
-
Bugfixes, refactors en Claude Code-sessies: Sonnet 5.5 op de standaard effort.
-
High-throughput agentloops en pipelines: Sonnet 5.5 op
lowofmedium, en verhoog de effort alleen bij failures. -
Moeilijke codeproblemen met een heldere specs: Sonnet 5.5 op
xhighofmaxvoordat je voor Opus betaalt. -
Ambigue projecten van meerdere dagen: Opus 5.5.
Claude Sonnet 5.5 testen: hands-on voorbeelden
De benchmarks hierboven zijn van Anthropic zelf, dus ik draaide één buildtaak tegen Claude Sonnet 5.5 en Claude Sonnet 5 met een identieke prompt en identieke tooling.
De taak: zet FiveThirtyEight's dataset van recent afgestudeerde studenten (173 Amerikaanse majors, CC BY 4.0) om in een single-file HTML-dashboard dat een toekomstige student helpt categorieën te vergelijken op inkomen en werkgelegenheid en de hoogst- en laagstverdienende majors te vinden.
De echte test zit in de data, die een paar kenmerken heeft die de prompt nooit noemt:
- De topper, Petroleum Engineering, heeft slechts 36 enquêterespondenten, en 76 van de 173 majors hebben er minder dan 100
- Inkomen is scheef verdeeld, dus één mediane balk verbergt veel spreiding
- Eén major, Food Science, heeft blanco headcount-velden
- De kolommen met functietypen tellen niet op tot het aantal werkenden
Het opmerken van deze issues is het doel van de test. De test toetst Anthropics claims over een "scherp oog voor design".
De belangrijkste bevindingen:
- Alleen Sonnet 5.5 leverde een werkend dashboard. Sonnet 5 linkte naar een Chart.js-bestand dat niet bestaat op cdnjs (de URL geeft een 404), waardoor de library nooit laadde en elk paneel, inclusief de platte tabellen, leeg weergaf. Sonnet 5.5 controleert ook of zijn grafieklibrary is geladen en houdt zijn tabellen werkend als dat niet zo is.
- Sonnet 5.5 trapte niet in de valkuil van kleine steekproeven, grotendeels. Het markeert majors met minder dan 30 respondenten als "behandel met voorzichtigheid" en voegt een minimum-responsfilter toe. In de standaardweergave staat Petroleum Engineering op #1 zonder waarschuwing.
- Sonnet 5 had het toch gemist. De code leest de kolommen voor steekproefgrootte en salarisbereik, gebruikt ze vervolgens nergens, en rangschikt majors alleen op mediane waarde.
- De kleinere valkuilen trapte niemand in. Beide gingen expliciet om met de lege Food Science-rij, en Sonnet 5.5 berekende zijn aandeel "college jobs" zonder te impliceren dat de jobkolommen optellen tot totale werkgelegenheid.
Hier is het dashboard van Sonnet 5.5 met de filter ingesteld op majors met minstens 100 respondenten.
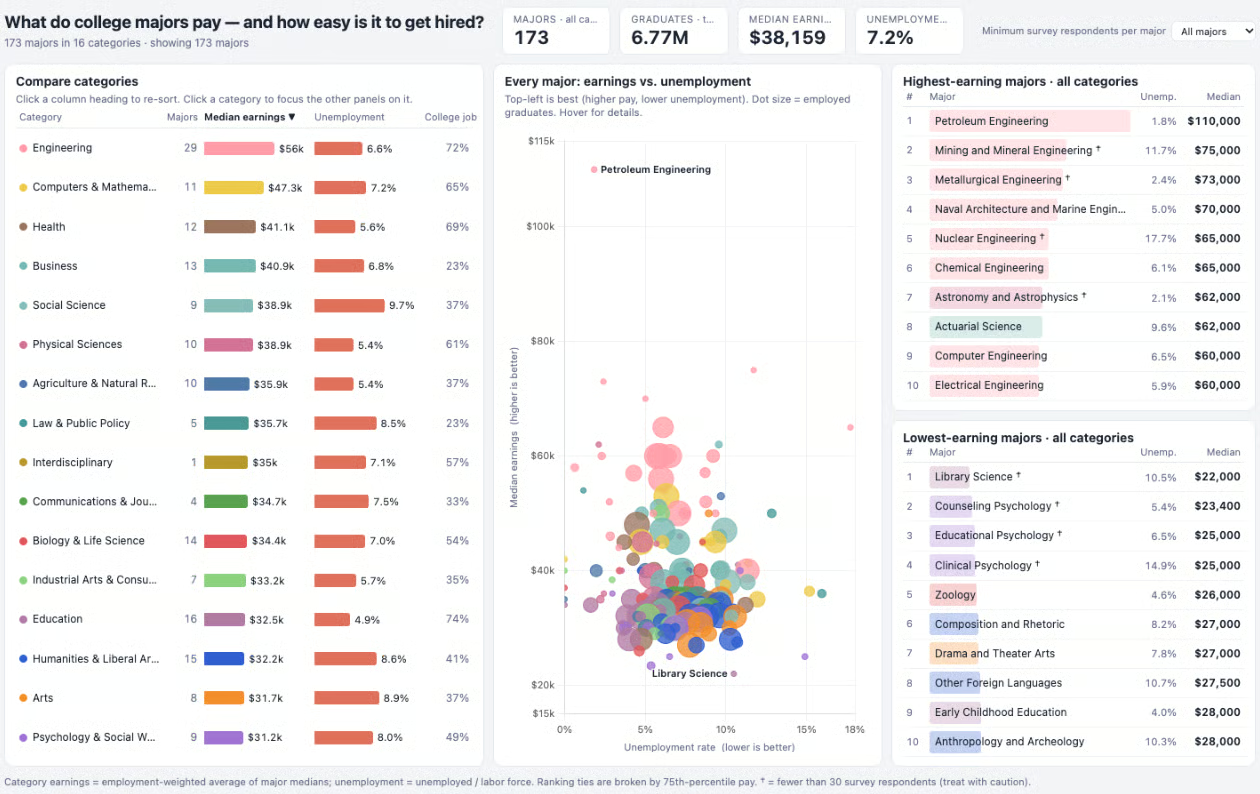
Ik gaf Sonnet 5.5's dashboard een 4 uit 5 voor eerlijke data-afhandeling, 5 voor analytisch nut en 4 voor grafiek- en lay-outkwaliteit. Sonnet 5's lege pagina staat hieronder.
Waarom ging Sonnet 5 de mist in? Het probleem was dat het dashboard een grafieklibrary nodig had. Sonnet 5 vroeg cdnjs om een versie die daar niet gehost wordt. Het kreeg vervolgens een "404"-fout. Zonder de library crashte Sonnet 5's code: "Chart is not defined." Blijkbaar had Sonnet 5 de pagina zo geschreven dat alles, zelfs de platte teksttabellen, pas na die stap draaide, en het kon de fout niet opvangen.
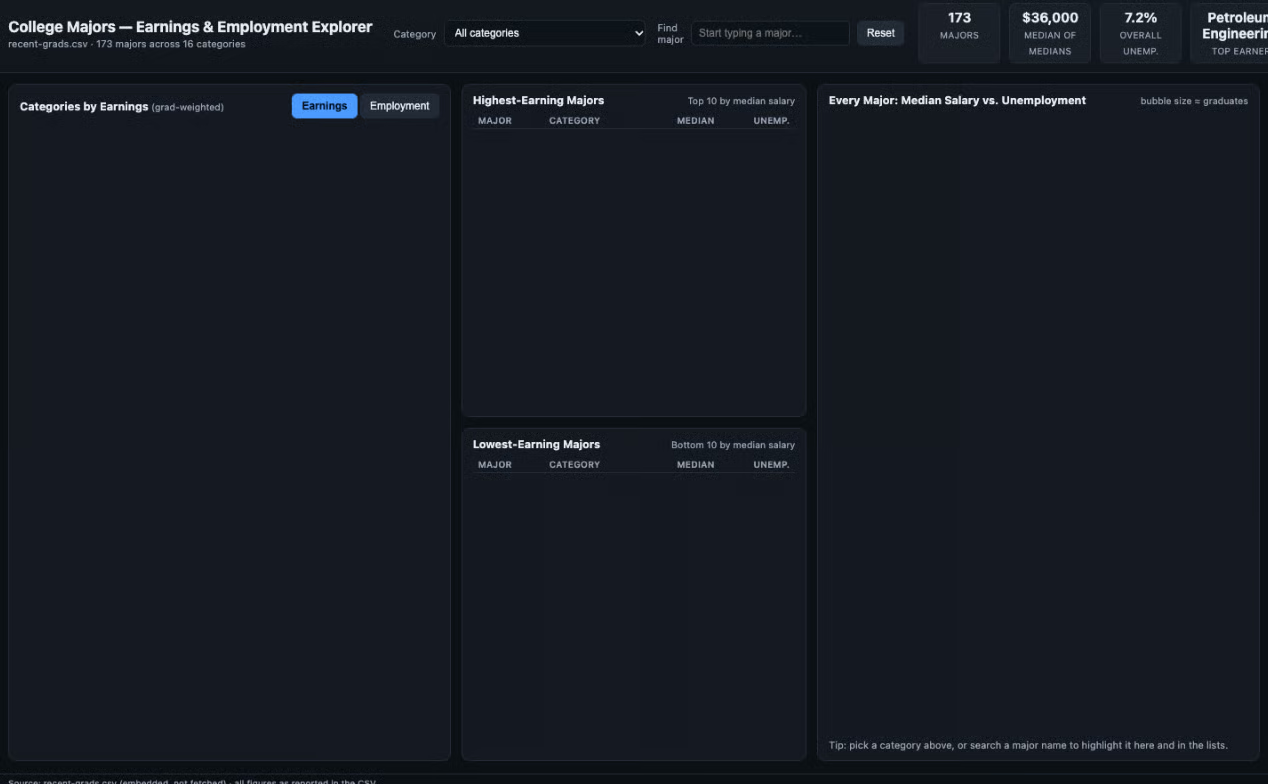
De kosten per run waren in essentie identiek: $0,56 voor Sonnet 5.5 en $0,57 voor Sonnet 5. Ook was Sonnet 5.5 sneller klaar.
Is Sonnet 5.5 dus echt een stap vooruit? Bij deze taak wel. Sonnet 5.5 leverde een dashboard dat werkt en waarschuwt voor dunne data, terwijl Sonnet 5 een lege pagina afleverde.
Prijzen en beschikbaarheid van Claude Sonnet 5.5
Claude Sonnet 5.5 kost $2 per miljoen inputtokens en $10 per miljoen outputtokens op de API, ongewijzigd ten opzichte van Sonnet 5 en de helft van de prijs van Opus 5.5. Anthropic meldt minder tokens per taak, wat de effectieve kosten per job zou verlagen, ook al is het tarief vlak. In onze hands-on test kostten beide modellen echter ongeveer evenveel om de taak te voltooien.
| Tokentype | Prijs per 1M tokens |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache write (5 minuten) | $2.50 |
| Cache write (1 uur) | $4 |
| Cache read | $0.20 |
De Batch API geeft 50% korting op zowel input als output. De minimale cachebare prompt is 512 tokens, en op de Batch API kan het model tot 300K outputtokens teruggeven met de output-300k-2026-03-24 beta-header.
Sonnet 5.5 is algemeen beschikbaar, geen preview, met zero data retention als optie. Anthropic belooft het niet uit te faseren vóór 28 september 2027.
Hoe krijg je toegang tot Claude Sonnet 5.5?
Je kunt Claude Sonnet 5.5 vandaag gebruiken in de Claude-apps, in Claude Code en via de API met het model-ID claude-sonnet-5-5. Het is ook beschikbaar op Amazon Bedrock als anthropic.claude-sonnet-5-5, en op Google Cloud, Microsoft Foundry en Claude Platform op AWS onder claude-sonnet-5-5.
Hier is een minimale Python-call. Adaptive thinking staat standaard aan, dus de respons kan denkblokken bevatten voor de tekst:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Voor een echte walkthrough van keys, kosten en je eerste project, zie onze complete gids voor de Claude API. Als je agents bouwt, is onze tutorial over Claude Managed Agents bouwen een goede volgende stap. We publiceren binnenkort een Claude Sonnet 5.5 API-tutorial.
Slotgedachten
Anthropic gokt erop dat het meeste betaalde werk, inclusief het meeste werk van code-agents, op dit nieuwe mid-tier model draait. Dat zet ook directe druk op OpenAI's GPT-6 Sol, dat hierop achterblijft in Anthropics cijfers voor kenniswerk.
Ik zou nu overstappen als je op Sonnet 5 zit, maar update jezelf wel over de API-wijzigingen. Bewaar Opus 5.5 voor projecten waarbij het model moet beslissen wat er gebouwd moet worden.
Als je graag meer wilt leren over bouwen met Anthropics modellen, raad ik onze cursus Introduction to Claude Models aan.