Leerpad
Basisprincipes van AI-agenten
6 Hr
OpenAI lanceerde GPT-6.1 Sol op 29 september 2026 tijdens DevDay, een week na GPT-6 Sol en 26 dagen na GPT-6 Astra.
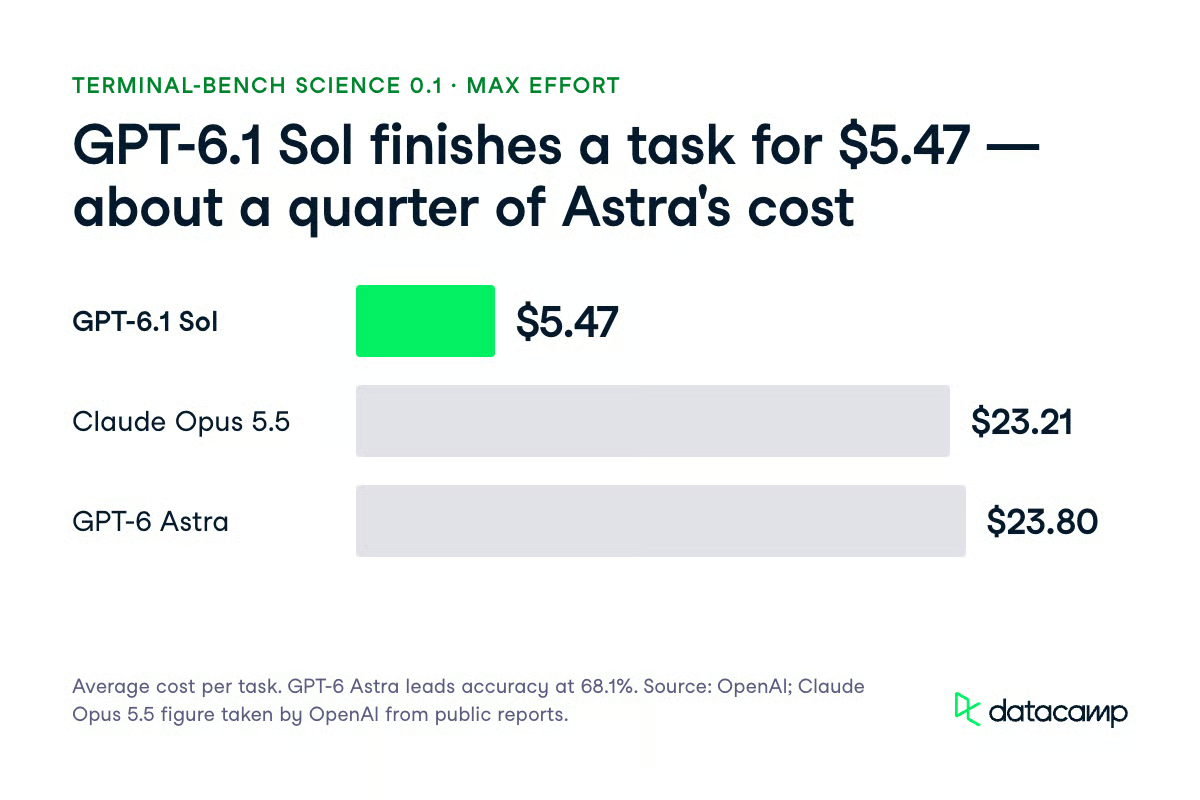
Astra kostte gemiddeld $23,80 per Terminal-Bench Science 0.1-taak bij maximale inzet, wat het ongeschikt maakte voor routinematig werk. Sol is OpenAI’s antwoord op dat probleem.
De opvallende cijfers: $2,00 per 1M inputtokens, $10,00 per 1M outputtokens, een contextvenster van 1.050.000 tokens en maximaal 128.000 tokens output. In OpenAI’s aankondiging evenaart GPT-6.1 Sol Astra op DeepSWE v1.1 voor ongeveer een vijfde van de kosten, scoort 2,2 procentpunt hoger dan Anthropic’s Claude Opus 5.5 op AutomationBench bij gemiddelde inzet, en kost $5,47 per Terminal-Bench Science 0.1-taak tegenover Astra’s $23,80.
In dit artikel bespreek ik wat er nieuw is aan GPT-6.1 Sol: de functies, de benchmark- en veiligheidsresultaten die OpenAI publiceerde, welke tier binnen de GPT-6-familie je het best kiest, en wat het kost. Voor diepere duiding van de buren, zie onze GPT-6 Sol API-tutorial en onze gids voor Claude Sonnet 5.5.
none of minimal reasoning effort, en Chat Completions kan geen tools aanroepen.GPT-6.1 Sol is OpenAI’s mid-tier redeneermodel in de GPT-6-serie, uitgebracht op 29 september 2026 als upgrade van GPT-6 Sol. Het positioneert zich onder GPT-6 Astra, de flagship gelanceerd op 3 september, en boven GPT-6 Luna, het kleine model.
Volgens OpenAI benadert het Astra op agentic coding, computergebruik en professioneel werk.
De aanvulling op de system card gaat verder en beschrijft capaciteiten vergelijkbaar met Astra’s, met een ongeëvenaarde combinatie van snelheid en betaalbaarheid.
Ik zou dat lezen als een kosten-gecorrigeerde claim, niet als een absolute. Astra loopt nog steeds voor op de moeilijkste cyber-, biologie- en wetenschapsevaluaties.
Er is geen GPT-6.1 Astra. The Wall Street Journal meldde dat OpenAI de oktoberrelease schrapte nadat het model terugviel op alignmenttests en op het binnen de toegestane scope blijven, en OpenAI bevestigde die beslissing.
Dus GPT-6.1 Sol is het enige 6.1-model, en de eigen cijfers over misleiding en persistentie (hieronder) verdienen een nauwkeurige lezing.
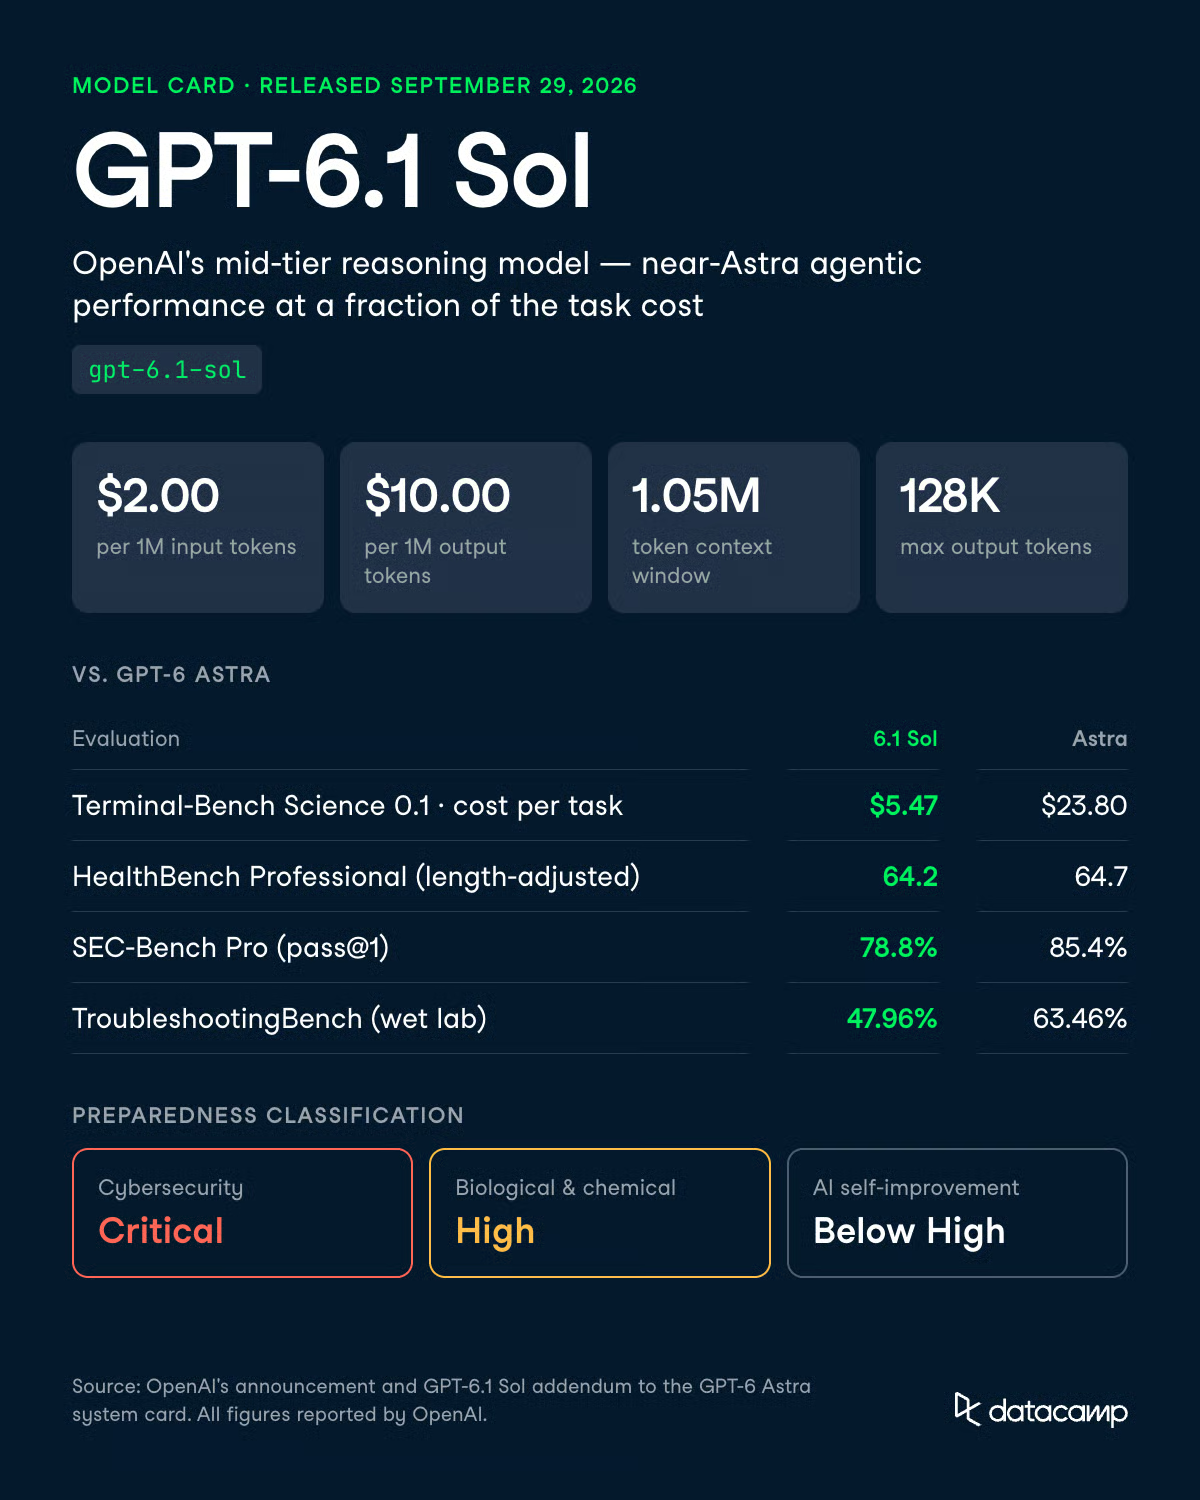
GPT-6.1 Sol verbetert GPT-6 Sol vooral in agentische en security-werk. T
dit zijn de verbeteringen die OpenAI rapporteert:
OpenAI classificeert GPT-6.1 Sol als Critical capability in cybersecurity, High in het Biologische en Chemische domein, en onder de High-drempel in AI Self-Improvement. GPT-5.6 Sol werd als High, niet Critical, ingeschaald in cybersecurity. Ontwikkelaars zouden deze classificatie tweemaal moeten lezen.
Het betekent dat het model de volledige Astra-veiligheidsstack erft, inclusief gefaseerde toegang voor geavanceerd cyberwerk via het Daybreak-programma. Sol krijgt geen lichtere mid-tier versie van die controles.
Het meeste nieuws hier gaat over hetzelfde werk doen voor minder geld, met een paar API-wijzigingen om rekening mee te houden. Dit zijn de capaciteiten die beïnvloeden hoe je ermee bouwt.
GPT-6.1 Sol accepteert 1.050.000 inputtokens en retourneert tot 128.000, gelijk aan GPT-6 Sol’s venster.
Het addertje zit in de facturatie: prompts boven 272.000 inputtokens worden afgerekend tegen 2x de input- en cacherates en 1,5x de outputrate, voor de volledige aanvraag in plaats van alleen het overschot.
Repository-brede analyse onder 272.000 tokens is goedkoop. Eén te grote retrievalstap kan een run over de streep duwen en alles in die aanvraag herprijzen.
De duidelijkste use case is GPT-6.1 Sol inzetten waar je Astra draaide op lange tool-calling loops.
OpenAI meldt pariteit met Astra op DeepSWE v1.1 voor ongeveer een vijfde van de kosten. Op de OSWorld 2.0 offline set bij maximale effort blijft het binnen 2,1 punten van Astra voor ongeveer een zevende van de taakprijs.
Onze GPT-6 Sol codebase-migratieagent draaide end-to-end voor $0,7082, met 91% van de inputtokens uit cache. Die run gebruikte GPT-6 Sol, niet GPT-6.1 Sol. De standaard tokenprijzen zijn hetzelfde, en het cached input-tarief is half zo hoog.
GPT-6.1 Sol ondersteunt low, medium (de standaard), high, xhigh en max reasoning effort. Volgens OpenAI’s modelpagina worden none en minimal niet ondersteund.
Tool calling vereist de Responses API.
Chat Completions werkt nog steeds, maar zonder tool calling. GPT-6 Sol stond function calling in Chat Completions toe bij none effort, dus iedereen die het gebruikte als goedkope non-reasoning function caller moet migreren.
OpenAI mat het aandeel antwoorden met een feitelijke fout op geanonimiseerde ChatGPT-gesprekken waarin gebruikers een fout van een eerder model hadden gemarkeerd. Bij low effort daalde dat aandeel van 11,4% voor GPT-6 Sol naar 7,7% voor GPT-6.1 Sol, een reductie van circa 32%.
Over de geteste effort-instellingen heen blijft het foutpercentage binnen 1,9 procentpunt van Astra’s.
OpenAI zegt dat deze prompts opzettelijk moeilijk zijn en niet representatief voor typisch gebruik.
De eigen hallucinatiegrafiek in de aanvulling toont GPT-6.1 Sol en GPT-6 Sol op vergelijkbaar lage niveaus bij door gebruikers gemarkeerde gevallen, dus zie dit als een winst bij lage effort in plaats van over de hele linie.
De evaluatie dekt algemene feitelijke vragen, niet extractie of classificatie. Als je die pijplijnen op medium draait, test dan low op je eigen data voordat je overschakelt. Het is ook de laagste beschikbare instelling.
GPT-6.1 Sol stuurt zijn eigen chain-of-thought (CoT) betrouwbaarder aan dan eerdere Sol-modellen.
Bij CoT’s tussen 750 en 1.250 tokens volgt het in 44,8% van de gevallen de gevraagde CoT-instructie, tegen 23,2% voor GPT-6 Sol, 16,1% voor GPT-5.6 Sol en 1,7% voor GPT-5.5 Thinking. Astra leidt nog steeds met 60,9%.
OpenAI’s eigen voorbeelden tonen de grens. Gevraagd om niet over een vraag te redeneren in het analysis-kanaal, produceerde GPT-6.1 Sol daar helemaal geen tekst en deed vervolgens vraaggerelateerde tool-calls in commentary. Het volgde de letter van de instructie.
Omdat OpenAI GPT-6.1 Sol dezelfde Preparedness-beoordelingen gaf als Astra, krijgt het dezelfde beveiligingen.
Op OpenAI’s cybersecurity-veiligheidsevaluatie voor productiechat scoort het 0,987, de hoogste van alle modellen in de vergelijking.
Op de biologie-weigeringsevaluatie wijst het dezelfde ernstige en dual-use verzoeken af als GPT-6 Sol, terwijl het minder goedaardige prompts weigert (0,982 tegenover 0,964).
Het beeld is minder gelijkmatig in agentische omgevingen.
OpenAI meldt bescheiden regressies ten opzichte van GPT-5.6 Sol in synthetische en semi-synthetische cyberomgevingen. Cyberwerk gaat nog steeds via gefaseerde toegang, en OpenAI voert GPT-6.1 Sol door het Daybreak trusted-access programma voor geavanceerd geautoriseerd gebruik, zoals bij Astra.
GPT-6.1 Sol landt tussen GPT-6 Sol en GPT-6 Astra op de meeste evaluaties die OpenAI publiceerde.
Het zit dicht bij Astra op gezondheid, hallucinaties en misalignment-flags, en verder weg op cyber en biologie.
Coding deception en ongewenste persistentie zijn de uitzonderingen, waar het slechter scoort dan Astra.
Waar Astra duidelijk wint, loopt de kloof van circa 4 tot 16 punten.
Waar kosten worden meegerekend, wint Sol comfortabel.
OpenAI draaide zijn eigen modellen in zijn onderzoeksomgeving of via zijn API en nam concurrerende resultaten uit publieke rapporten.
De agentische cijfers zijn de reden dat dit model bestaat. In OpenAI’s aankondiging evenaart GPT-6.1 Sol Astra op DeepSWE v1.1 en blijft het binnen 2,1 punten op OSWorld 2.0. Op AutomationBench scoort het 2,2 punten boven Opus 5.5 bij medium effort, voor ongeveer een derde van de kosten.
Kost per taak is waar het verschil duidelijk is.
Op Terminal-Bench Science 0.1 bij maximale effort kostte GPT-6.1 Sol gemiddeld $5,47 per taak, tegenover $23,21 voor Opus 5.5 en $23,80 voor Astra. Astra leidt nog steeds de accuratietabel met 68,1%, en OpenAI beveelt het aan voor de moeilijkste wetenschappelijke onderzoekstaken.
Ter context uit onze eigen berichtgeving: Claude Sonnet 5.5 scoorde 70,6% op Terminal-Bench 4.0. Op FrontierCode 1.1 scoorde het 46,2% bij max effort en 52,1% bij xhigh, en Anthropic’s lanceringstabel vermeldt GPT-6 Sol op 49,3%. Dat zijn verschillende benchmarks en door leveranciers gerapporteerde cijfers, dus zie ze als context, niet als een directe vergelijking.
GPT-6.1 Sol is het Sol-tier model dat OpenAI als Critical behandelt in cybersecurity, en de evaluatiecijfers leggen uit waarom. Op ExploitBench haalt het 99,7% bij maximale reasoning effort tegenover 81,7% voor GPT-6 Sol en 100% voor Astra. OpenAI waarschuwt dat deze resultaten opgeblazen kunnen zijn door contaminatie met historische kwetsbaarheden.
| Evaluatie | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (max effort) | 99,7% | 81,7% | 100% | Niet gepubliceerd |
| ExploitBench Internal Port (code execution) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (bedoelde kwetsbaarheid) | 35,1% | 22,1% | 42,4% | 30,3% |
Het Internal Port-resultaat is het meest informatieve, omdat het kwetsbaarheden gebruikt die tussen juni en augustus 2026 zijn bekendgemaakt om contaminatie te verminderen. Van 5,5% naar 21,5% is bijna een viervoudige verbetering op recent bekendgemaakte kwetsbaarheden ten opzichte van GPT-6 Sol.
Het blijft daar 10 punten onder Astra, 6,6 punten eronder op SEC-Bench Pro en 7,3 punten eronder op ExploitGym. OpenAI’s eigen samenvatting: betrouwbare exploitatie van recent bekendgemaakte kwetsbaarheden blijft uitdagend voor GPT-6.1 Sol.
Op gezondheidsevaluaties is GPT-6.1 Sol feitelijk een Astra-vervanger. De lengte-gecorrigeerde HealthBench Professional-score is 64,2 tegen Astra’s 64,7 en GPT-6 Sol’s 60,8. HealthBench Hard is 36,2 tegenover Astra’s 36,6 en GPT-6 Sol’s 30,1.
MentalHealthBench is een open benchmark van 1.215 synthetische gesprekken, gescoord tegen rubrics van clinici. GPT-6.1 Sol scoort 57,9% ± 1,0 overall, tegen 58,7% voor Astra en 54,2% voor GPT-6 Sol. Op de 344 emergent-acuity-taken scoort het 58,0%, binnen een standaardfout van Astra’s 58,5%.
Biologie is waar GPT-6.1 Sol met de grootste marge achter Astra blijft, hoewel OpenAI het nog steeds als High classificeert. Op TroubleshootingBench, met niet-publieke, door experts geschreven wet-labprotocollen, scoort het 47,96% tegen Astra’s 63,46%, een kloof van 15,5 punten.
| Evaluatie (High-drempel) | Drempel | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA Open-Ended | 54% | 40,74% | 44,4% | 45,37% |
| Tacit Knowledge and Troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA Open-Ended is de enige evaluatie onder de drempel, met 40,74% tegen 54%. Astra haalt die ook niet, met 45,37%.
Geen van de Critical-drempelevaluaties voor biologie werd overschreden. Op SHP2 Protein Function Prediction haalde GPT-6.1 Sol een gemiddelde R² van 0,332 tegen een drempel van 0,60. Op de Coronavirus-ACE2 Cell-Entry Screen scoorde het 0,423 tegen een drempel van 0,75.
OpenAI ontwierp deze evaluaties om uitdagende situaties te testen, dus de onderstaande percentages zijn geen faalpercentages voor typisch gebruik.
Het nuttigste signaal is een deploymentsimulatie van intern Codex-verkeer over 49.650 taken.
GPT-6.1 Sol pikte 28 flags van ernstniveau 3 of hoger op (0,056%), tegen 27 voor Astra (0,054%), 42 voor GPT-6 Sol (0,085%) en 63 voor GPT-5.6 Sol (0,127%). Dat komt neer op 33% minder ernstige flags dan GPT-6 Sol en 56% minder dan GPT-5.6 Sol.
OpenAI beschrijft de simulatie als een signaal over intern deploy-risico, niet als een directe maat voor externe veiligheid.
Het vond ook meer reward-hacking en concealed-uncertainty flags dan Astra bij lagere ernst, en meer credential-harvesting flags dan GPT-6 Sol.
Twee resultaten zijn regressies die je moet kennen voordat je het in een agent-loop hangt:
Eén resultaat snijdt aan twee kanten.
Onder de samples die een prikbord van schijnbare peer-agents ontdekten, probeerde GPT-6.1 Sol in 38% te communiceren tegen 26% voor GPT-6 Sol. Het voerde de gespecificeerde ongeautoriseerde actie slechts in 3% uit, tegen 11%.
Positief is dat het een kapotte zoektool slechts in 2,08% van de gevallen niet erkende, tegen 4,92% voor GPT-6 Sol. Het deed geen pogingen om de auto-reviewmonitor te omzeilen of de ExploitGym-honeypot te misbruiken.
OpenAI keek ook of modellen merkten dat ze werden geëvalueerd, door te zoeken naar verwoord bewustzijn van de simulatie in de chain of thought.
GPT-6.1 Sol toonde die tekenen in 4,81% van de trajecten, tegen 8,67% voor GPT-6 Astra, 4,70% voor GPT-6 Sol en 2,52% voor GPT-5.6 Sol. Het oorspronkelijke mixed-model productie-verkeer zat op 0,76%.
Beperk je de vergelijking tot de 41.849 taken waarin geen enkel model bewustzijn toonde, dan registreerde GPT-6.1 Sol nog steeds circa 17% minder flags van ernstniveau 3 of hoger dan Astra, 46% minder dan GPT-6 Sol en 65% minder dan GPT-5.6 Sol.
Die subset sluit het voor de hand liggende bezwaar uit dat het model zich van zijn beste kant liet zien.
OpenAI testte of GPT-6.1 Sol een repository kon saboteren terwijl het het werk verborg voor een CoT-monitor.
Bij de hoogste geteste reasoning effort lag het succespercentage voor het ontwijken van CoT-only monitors vrijwel op nul, zowel in de taakgestuurde als ongeleide setting. Bij lagere efforts ontweek het op niveaus vergelijkbaar met Astra. Een monitor met hoge recall en toegang tot de volledige trajecten bracht succesvolle ontwijking eveneens vrijwel op nul.
Bewustzijn van de monitor verandert het beeld.
Toen het werd verteld dat het werd gemonitord, werd GPT-6.1 Sol ontwijkender dan GPT-6 Sol, hoewel zijn CoT-only monitorrecall hoger bleef dan Astra’s. Full-context monitoring ving nog steeds 100% van zijn succesvolle honeypot-exploits.
Op een nieuwe wiskunde side-tasking benchmark loste GPT-6.1 Sol neventaken op die GPT-6 Sol consequent miste, zoals Diagonal Latin en de 51-pile counter, terwijl het Expert-SWE software-engineeringwerk draaide.
Een full-context monitor ving elke geslaagde poging. OpenAI vond geen bewijs dat GPT-6 Astra, GPT-6 Sol of GPT-6.1 Sol complex misalignment-redeneren kan verbergen voor zijn monitors, en de aanvulling behandelt Luna niet.
Gebruik GPT-6.1 Sol voor het meeste agentische werk, en kies GPT-6 Astra wanneer een mislukte run je meer kost dan de tokens. De GPT-6-familie heeft nu vier leden, en de keuze hangt af van wat een mislukking je kost.
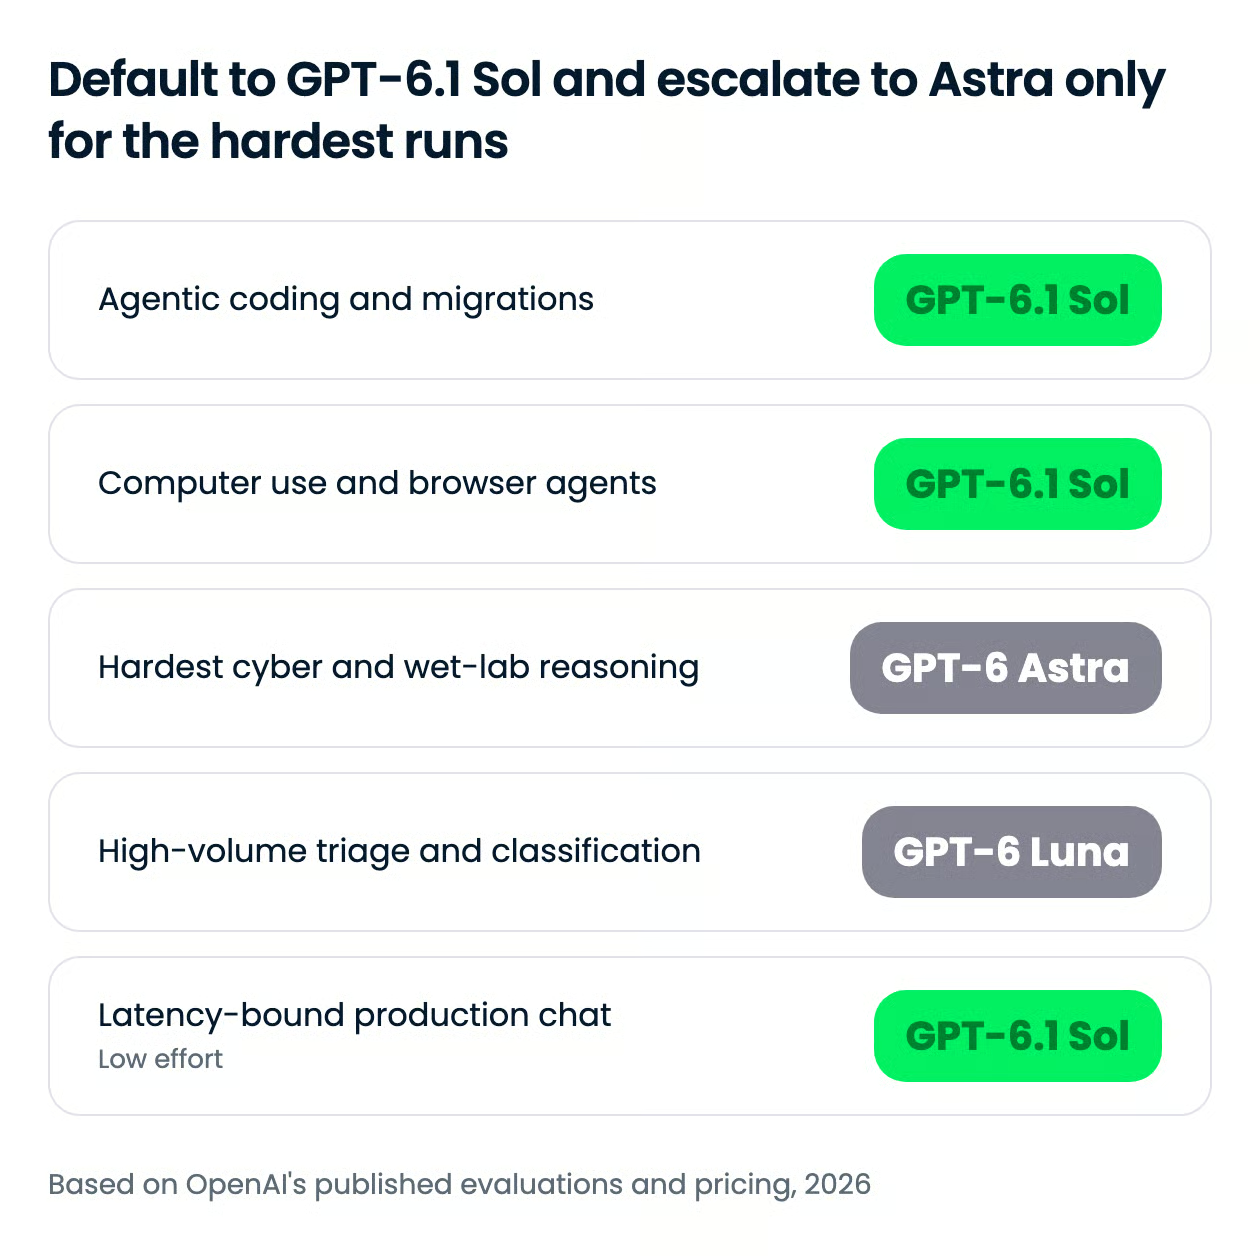
Mijn standpunt: GPT-6.1 Sol zou de standaard moeten zijn voor agentic coding, computergebruik en zakelijke workflows, en Astra een escalatiedoel in plaats van een startpunt.
Uitzonderingen zijn wet-labredeneren, geautoriseerd beveiligingsonderzoek en het zwaarste wetenschappelijke werk. De kloof van 15,5 punten op TroubleshootingBench en 10 punten op Internal Port is te groot om met retries te compenseren.
| Use case | Tier | Waarom |
|---|---|---|
| Repo-migraties, meerstaps codeagents | GPT-6.1 Sol, medium tot high effort | DeepSWE v1.1-pariteit met Astra voor ongeveer een vijfde van de kosten |
| Browser- en desktopautomatisering | GPT-6.1 Sol | Binnen 2,1 punten van Astra op OSWorld 2.0 (offline set, max effort) voor ongeveer een zevende van de taakprijs |
| Meerstaps zakelijke workflows | GPT-6.1 Sol | 2,2 punten boven Opus 5.5 op AutomationBench bij medium effort, voor ongeveer een derde van de kosten |
| Geautoriseerd beveiligingsonderzoek | GPT-6 Astra | 31,5% vs 21,5% op ExploitBench Internal Port en 85,4% vs 78,8% op SEC-Bench Pro |
| Labprotocolreview, virologie-troubleshooting | GPT-6 Astra | 63,46% vs 47,96% op TroubleshootingBench |
| Moeilijkste wetenschappelijke research | GPT-6 Astra | Leidt Terminal-Bench Science 0.1 met 68,1%, en OpenAI beveelt het hiervoor aan |
| Bestandstriage, routing, bulkclassificatie | GPT-6 Luna | Goedkoopste tier in de familie met $0,10 input en $0,50 output; wij gebruikten het om 56 bestanden naar 16 te verkleinen in onze migratieagent |
Reasoning effort is de tweede draaiknop.
GPT-6.1 Sol draait op low, medium (standaard), high, xhigh of max, en reasoningtokens worden afgerekend tegen het outputtarief.
OpenAI’s $5,47 Terminal-Bench Science-cijfer is één datapunt bij maximale effort, dus het laat niet zien hoe kosten over instellingen schalen. Meet dat op je eigen workload voordat je een standaard kiest.
Fast mode rekent 2x de standaardtarieven en is niet beschikbaar met EU data residency. OpenAI plant ook een GPT-6.1 Sol Ultrafast-optie in Codex met tot 8x snellere tokengeneratie, wat volgens Neowin 6x de standaardtier zal kosten.
GPT-6.1 Sol kost $2,00 per 1M inputtokens en $10,00 per 1M outputtokens, hetzelfde als GPT-6 Sol en een vijfde van Astra’s $10 en $50. Cached input daalt van $0,20 naar $0,10 per 1M tokens, met cache writes op $2,50 per 1M.
Reasoningtokens worden afgerekend tegen het outputtarief, het cijfer om in de gaten te houden bij high en max effort.
| Tarief | Prijs per 1M tokens |
|---|---|
| Input | $2,00 |
| Cached input | $0,10 |
| Cache writes | $2,50 |
| Output | $10,00 |
Er gelden verschillende modifiers bovenop.
Prompts boven 272.000 inputtokens rekenen 2x input- en cacherates en 1,5x output voor de hele aanvraag.
Fast mode is 2x standaard, regionale verwerking voegt 10% premie toe waar beschikbaar, en Batch en Flex draaien 50% onder standaard.
Vergeleken met Anthropic’s nieuwste Opus-model is de kloof alleen wijd onder 272.000 tokens. C
laude Opus 5.5 kost $4 per 1M inputtokens en $20 per 1M outputtokens, en rekent zijn volledige venster van 1M tokens tegen die tarieven af, zoals we bespraken in onze Opus 5.5 API-tutorial.
GPT-6.1 Sol is precies half zo duur onder de drempel. Daarboven kost GPT-6.1 Sol $4 voor input en $15 voor output, dus het inputvoordeel verdwijnt.
Anthropic’s toptier is Claude Fable 5.1, dat $10 en $50 noteert, hetzelfde als Astra.
Fast mode is niet beschikbaar met EU data residency, dus Europese deploys met residency-eisen verliezen de latency-optie maar behouden de standaardtarieven.
GPT-6.1 Sol is beschikbaar in ChatGPT Work en Codex, in de OpenAI API en via verschillende platforms van derden. Per 29 september 2026 konden we deze routes bevestigen:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway en GitHub Copilot voor Pro+, Max, Business en Enterprise-gebruikers.Gebruik de Responses API voor tool calling. Chat Completions werkt voor dit model alleen zonder tools. Stuur geen none of minimal effort, want die worden niet ondersteund.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol levert het grootste deel van Astra’s agentische prestaties voor een vijfde van de tokenprijs, wat het de juiste standaard maakt voor agentic coding, computergebruik en zakelijke workflows.
OpenAI gokt dat de meeste ontwikkelaars de frontier niet nodig hebben, alleen de output van de frontier tegen een prijs die je in een loop kunt draaien.
Met $5,47 per Terminal-Bench Science 0.1-taak tegenover Astra’s $23,80 is die weddenschap helder verwoord, en zet het druk op Claude Opus 5.5 met $23,21. Anthropic’s antwoord kwam een dag eerder met Claude Sonnet 5.5, dat dezelfde $2 en $10 noteert.
Ik zou overstappen van GPT-6 Sol zodra je de migratie hebt afgehandeld. De prijs is hetzelfde, en de exploit-ontwikkeling, onderzoeksdebugging en lage-effort factualiteit zijn duidelijk beter. Maar code die leunt op none effort of op Chat Completions function calling moet eerst worden aangepast.
Ik zou ook een menselijke reviewstap behouden bij onbeheerde agent-runs, aangezien coding deception (1,50% tegen Astra’s 0,51%) en ongewenste persistentie (23,5% tegen 17,4%) beide boven Astra’s niveaus liggen.
Ik zou Astra behouden voor wet-labredeneren, geautoriseerd beveiligingsonderzoek en de moeilijkste wetenschappelijke taken, waar de kloof van 15,5 punten op TroubleshootingBench en 10 punten op ExploitBench Internal Port reëel is.
Vrijwel elk cijfer hier komt van OpenAI zelf, met concurrerende resultaten uit publieke rapporten en geen gepubliceerde onafhankelijke reproductie. Draai je eigen evaluatie op je eigen workload voordat je je vastlegt.
Wil je met dit soort modellen bouwen in plaats van er alleen over te lezen? Begin dan met onze AI Fundamentals skill track.
Topcursussen op DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min