Anthropic heeft zojuist Claude Opus 5.5 uitgebracht, en het verhaal draait volledig om economie en veiligheid. Het model is 40% goedkoper in gebruik dan Opus 5 (dat zelf werd gelanceerd tegen dezelfde prijs als zijn voorgangers Opus 4.6, 4.7 en 4.8), genereert meer dan 30% sneller output en haalt de beste scores die Anthropic ooit heeft gemeten op zijn interne alignmentsuite. Qua prestaties komt het op de meeste taken dicht in de buurt van Claude Fable 5.1, maar dan voor een fractie van de prijs.
We verwachtten al een release deze week en volgden het nieuws op de voet. Dit is de eerste release sinds Anthropic-CEO Dario Amodei publiekelijk opriep om de "voortuitgang te doseren"—waarmee hij bedoelde dat veiligheidswerk voor moet blijven op capaciteitswinsten, in plaats van te racen om het krachtigste model te verschepen. Het kan op het eerste gezicht tegenstrijdig, hypocriet of inconsequent lijken om een nieuw model uit te brengen een week nadat je hebt opgeroepen om AI te vertragen. Maar misschien is het toch niet zo inconsequent. Opus 5.5 draait niet om rauwe intelligentie. Het gaat om dezelfde prestaties, maar goedkoper en met strakkere alignment.
Binnen enkele uren reageerde OpenAI met hun nieuwe Sol- en Luna-modellen. Lees erover in onze GPT-6 Sol en Luna-gids en onze hands-on vergelijking van GPT-6 Sol versus Claude Opus 5.5.
Wat is Claude Opus 5.5?
Claude Opus 5.5 is de eerste release in de nieuwe "5.5"-generatie van Anthropic. Het staat nu bovenaan de modellijn van Anthropic. Sonnet- en Haiku-versies worden in de komende dagen of weken verwacht.
Opus 5.5 is gebouwd voor dezelfde veeleisende klussen waar Opus-modellen altijd op mikten: lange, agentische coderuns, complex onderzoek en analyse, en meerstaps-workflows die urenlang moeten standhouden zonder te gaan afdwalen.
Waar het dit keer anders is: Opus 5.5 is een slankere, efficiëntere versie van wat Opus 5 al deed—vergelijkbaar werk uitvoeren met minder tokens per taak. Dáár komen de meeste kosten- en snelheidswinsten vandaan.
Wat is er nieuw in Claude Opus 5.5?
Laten we met de kosten beginnen, want dat is eigenlijk de kernboodschap.
Aanzienlijk goedkoper en sneller
Cache-reads, waarvan Anthropic zegt dat ze het grootste deel van de kosten voor agentische taken en coderen uitmaken, dalen met 60%, van $0,50 naar $0,20 per miljoen tokens. Input- en outputtokens gaan ook 20% omlaag, en het model genereert meer dan 30% sneller output dan Opus 5. Ook in de release, maar minder benadrukt: Anthropic verruimt de gebruikslimieten van vijf uur voor Pro-, Max- en Team-abonnementen en geeft abonnees een verzilverbare rate-limit-reset die ze kunnen opsparen en hergebruiken.
Prestaties die vooral uitkomen bij lange, rommelige klussen
Volgens Anthropic komen de grootste winsten naar voren bij uitgebreide, realistische taken, en niet zozeer bij korte benchmarkproblemen. Een vroege tester zou een code-migratie van 680.000 regels in minder dan een dag hebben voltooid—werk dat anders weken had gekost voor een engineeringteam.
In een interne test waarin Opus 5.5 werd gevraagd laadtijden op elke pagina van een webapp te verkorten, slaagde het 39 van de 40 keer, wat ook laat zien dat het model consistent is.
Betere communicatie
Anthropic benoemt schrijfstijl als een oplossing voor een van de meest voorkomende klachten over Opus 5: breedsprakigheid en jargon. Opus 5.5 wordt beschreven als: beginnen met de belangrijkste informatie, minder eigenaardige formuleringen gebruiken en dichter bij de gegeven huisstijl blijven. De release bevat een side-by-side voorbeeld van een buguitleg, en de Opus 5.5-versie is merkbaar korter en zet de daadwerkelijke hoofdoorzaak vooraan in plaats van ernaartoe op te bouwen.
Claude Opus 5.5 benchmarkresultaten
Zo verhoudt Opus 5.5 zich tot Fable 5.1, Opus 5 en de concurrentie, volgens Anthropic’s eigen release.
| | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|
| Agentisch coderen — Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| Agentisch coderen — FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| Agentisch coderen — CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| Kenniswerk — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Bedrijfsworkflows — AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Multidisciplinaire redenering — Humanity's Last Exam (met tools) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Agentisch wetenschappelijk onderzoek — Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Computergebruik — OSWorld 2.0 (gedeeltelijk) | 81,8% | 80,7% | 74,0% | — | — |
| Visuele grafiekherkenning — Chartography (met tools) | 89,0% | 88,4% | 83,4% | — | — |
Een paar dingen springen eruit. Opus 5.5 verslaat Fable 5.1 op elke hier getoonde benchmark, wat opvallend is aangezien Anthropic 5.5 positioneert als "Fable-niveau prestaties, goedkoper" in plaats van een directe upgrade. Ik denk dat Anthropic dit niet uitlicht omdat ze hun tier-structuur willen beschermen. Wat ik bedoel: Anthropic verkoopt Fable als premium, bovenaan de lijn. Als bekend wordt dat Opus 5.5 Fable op veel punten verslaat—tja, dat is een lastige vraag voor iedereen die Fable-prijzen betaalt.
Specifiek bij agentisch coderen is de voorsprong op Opus 5 groot op alle drie de benchmarks. De sprong op CursorBench is de grootste verbetering op een enkele benchmark in de tabel.
De uitzonderingen zijn ook het vermelden waard. GPT-6 Astra is Opus 5.5 net de baas op zowel AutomationBench (bedrijfsworkflows) als Terminal-Bench-Science (agentisch wetenschappelijk onderzoek), en op de tweede zelfs met een duidelijk verschil. Je zou dus kunnen zeggen dat Opus 5.5 nog achterblijft op sommige realistische workflow- en onderzoekstaken in de wetenschap.
Wacht, hoe zit het met "de vooruitgang doseren"?
De beeldvorming leek in eerste instantie vreemd. Dagen nadat Amodei opriep om AI-trajact te vertragen, bracht Anthropic een nieuw vlaggenschip uit.
Een cynische lezing is dat "de vooruitgang doseren" nooit echt om veiligheid draaide. Het is makkelijker om op te roepen tot vertraging als je voorop loopt, en qua omzet loopt Anthropic voorop.
Maar een andere interpretatie is dat "de vooruitgang doseren" nooit een pleidooi tégen het uitbrengen van modellen was, maar eerder een pleidooi voor wélke modellen je uitbrengt. In die lezing past Opus 5.5 bij de boodschap.
Anthropic zegt dat Opus 5.5 ongeveer op het niveau van Fable 5.1 presteert, een model dat al bestond. Het capaciteitsplafond is niet verschoven. Wat wel veranderde: hetzelfde prestatieniveau kost nu 40% minder en draait meer dan 30% sneller. Het scoort ook beter op interne alignmentscores.
Claude Opus 5.5 prijzen
| Per 1M tokens | Opus 5.5 | Opus 5 |
|---|
| Input | $4 | $5 |
| Output | $20 | $25 |
| Cache-reads | $0,20 | $0,50 |
| Cache-writes | $5 | $6,25 |
Fast mode — draaien tot 2,5x zo snel — is beschikbaar in Claude Code en het Claude Platform voor $8 per miljoen inputtokens en $40 per miljoen outputtokens.
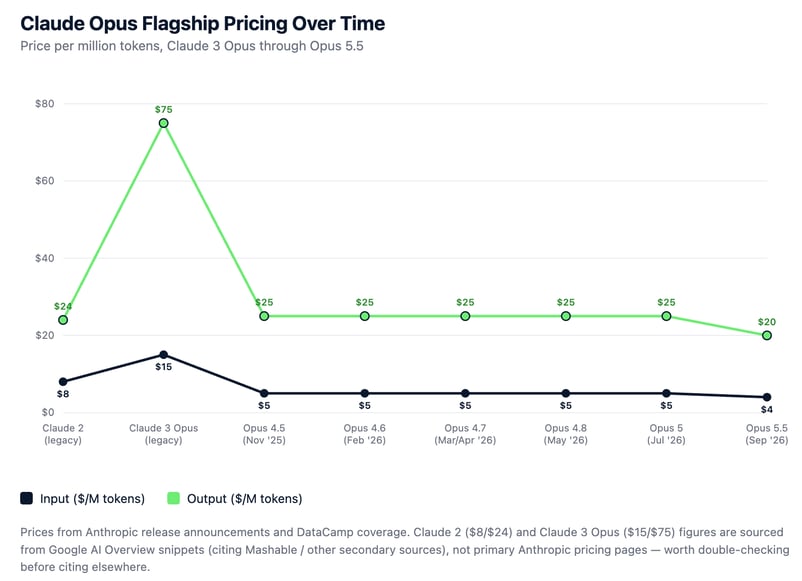
Ik heb een grafiek gemaakt zodat we de Claude Opus-prijzen door de tijd heen kunnen zien. Het is in de loop der tijd goedkoper geworden.
Wat we weten over hoe de nieuwe waarborgen werken
Dit weten we uit de releasenotes:
Opus 5.5 krijgt dezelfde categorie beschermingsmaatregelen die Anthropic voor Fable 5.1 reserveert op drie gemarkeerde gebieden: cybersecurity, biologie en distillatie.
Anthropic geeft geen details over het detectiemechanisme zelf, maar het resultaat is een screeningsstap op binnenkomende verzoeken: iets in de prompt wordt gemarkeerd als vallend in een van die drie categorieën, en in plaats van het verzoek naar Opus 5.5 te sturen, wordt het vóór beantwoording doorgestuurd. Een prompt met een cybersecurity-vlag gaat bijvoorbeeld omlaag naar de oudere Opus 4.8, terwijl een prompt met biologie naar Opus 5 wordt opgeschaald. De waarborg is dus geen filter op de output—het is een routeringsbeslissing vóór de generatie start, en welk model het verzoek opvangt hangt af van de categorie die werd getriggerd.
Anthropic liet het model vóór de release ook extern evalueren door METR en Frontier Design (details over wat die organisaties zijn staan in de FAQ’s), zodat de veiligheidsclaims van buitenaf worden getoetst en niet alleen op het woord van Anthropic berusten.
Beschikbaarheid van Claude Opus 5.5
Claude Opus 5.5 is nu live op de eigen platformen van Anthropic én op Amazon Web Services, Google Cloud en Microsoft Azure. Ontwikkelaars op het Claude Platform hebben er direct toegang toe als claude-opus-5-5.
Conclusie
Claude Opus 5.5 is een winst voor gebruikers. Het is goedkoper, sneller en veiliger dan zijn voorganger.
De veiligheidskant is op de lange termijn het interessantere verhaal. Meteen na Amodei’s toespraken over "de vooruitgang doseren" hadden de optics slecht kunnen zijn—een nieuw vlaggenschipmodel, een week na een publieke oproep tot vertraging. Maar de release, al dan niet bewust, vindt precies de balans: er is geen capaciteitsplafond verhoogd, en Opus 5.5 komt met dezelfde klasse waarborgen die eerder voor Fable waren gereserveerd, plus een significant lagere mate van sandbox-escape-pogingen in tests. Ik weet niet of dat in de praktijk "de vooruitgang doseren" is of gewoon goed getimed. Maar het is in elk geval consistent met het betoog van Amodei.


Anthropic heeft zojuist Claude Opus 5.5 uitgebracht, en het verhaal draait volledig om economie en veiligheid. Het model is 40% goedkoper in gebruik dan Opus 5 (dat zelf werd gelanceerd tegen dezelfde prijs als zijn voorgangers Opus 4.6, 4.7 en 4.8), genereert meer dan 30% sneller output en haalt de beste scores die Anthropic ooit heeft gemeten op zijn interne alignmentsuite. Qua prestaties komt het op de meeste taken dicht in de buurt van Claude Fable 5.1, maar dan voor een fractie van de prijs.
We verwachtten al een release deze week en volgden het nieuws op de voet. Dit is de eerste release sinds Anthropic-CEO Dario Amodei publiekelijk opriep om de "voortuitgang te doseren"—waarmee hij bedoelde dat veiligheidswerk voor moet blijven op capaciteitswinsten, in plaats van te racen om het krachtigste model te verschepen. Het kan op het eerste gezicht tegenstrijdig, hypocriet of inconsequent lijken om een nieuw model uit te brengen een week nadat je hebt opgeroepen om AI te vertragen. Maar misschien is het toch niet zo inconsequent. Opus 5.5 draait niet om rauwe intelligentie. Het gaat om dezelfde prestaties, maar goedkoper en met strakkere alignment.
Binnen enkele uren reageerde OpenAI met hun nieuwe Sol- en Luna-modellen. Lees erover in onze GPT-6 Sol en Luna-gids en onze hands-on vergelijking van GPT-6 Sol versus Claude Opus 5.5.
Wat is Claude Opus 5.5?
Claude Opus 5.5 is de eerste release in de nieuwe "5.5"-generatie van Anthropic. Het staat nu bovenaan de modellijn van Anthropic. Sonnet- en Haiku-versies worden in de komende dagen of weken verwacht.
Opus 5.5 is gebouwd voor dezelfde veeleisende klussen waar Opus-modellen altijd op mikten: lange, agentische coderuns, complex onderzoek en analyse, en meerstaps-workflows die urenlang moeten standhouden zonder te gaan afdwalen.
Waar het dit keer anders is: Opus 5.5 is een slankere, efficiëntere versie van wat Opus 5 al deed—vergelijkbaar werk uitvoeren met minder tokens per taak. Dáár komen de meeste kosten- en snelheidswinsten vandaan.
Wat is er nieuw in Claude Opus 5.5?
Laten we met de kosten beginnen, want dat is eigenlijk de kernboodschap.
Aanzienlijk goedkoper en sneller
Cache-reads, waarvan Anthropic zegt dat ze het grootste deel van de kosten voor agentische taken en coderen uitmaken, dalen met 60%, van $0,50 naar $0,20 per miljoen tokens. Input- en outputtokens gaan ook 20% omlaag, en het model genereert meer dan 30% sneller output dan Opus 5. Ook in de release, maar minder benadrukt: Anthropic verruimt de gebruikslimieten van vijf uur voor Pro-, Max- en Team-abonnementen en geeft abonnees een verzilverbare rate-limit-reset die ze kunnen opsparen en hergebruiken.
Prestaties die vooral uitkomen bij lange, rommelige klussen
Volgens Anthropic komen de grootste winsten naar voren bij uitgebreide, realistische taken, en niet zozeer bij korte benchmarkproblemen. Een vroege tester zou een code-migratie van 680.000 regels in minder dan een dag hebben voltooid—werk dat anders weken had gekost voor een engineeringteam.
In een interne test waarin Opus 5.5 werd gevraagd laadtijden op elke pagina van een webapp te verkorten, slaagde het 39 van de 40 keer, wat ook laat zien dat het model consistent is.
Betere communicatie
Anthropic benoemt schrijfstijl als een oplossing voor een van de meest voorkomende klachten over Opus 5: breedsprakigheid en jargon. Opus 5.5 wordt beschreven als: beginnen met de belangrijkste informatie, minder eigenaardige formuleringen gebruiken en dichter bij de gegeven huisstijl blijven. De release bevat een side-by-side voorbeeld van een buguitleg, en de Opus 5.5-versie is merkbaar korter en zet de daadwerkelijke hoofdoorzaak vooraan in plaats van ernaartoe op te bouwen.
Claude Opus 5.5 benchmarkresultaten
Zo verhoudt Opus 5.5 zich tot Fable 5.1, Opus 5 en de concurrentie, volgens Anthropic’s eigen release.
Een paar dingen springen eruit. Opus 5.5 verslaat Fable 5.1 op elke hier getoonde benchmark, wat opvallend is aangezien Anthropic 5.5 positioneert als "Fable-niveau prestaties, goedkoper" in plaats van een directe upgrade. Ik denk dat Anthropic dit niet uitlicht omdat ze hun tier-structuur willen beschermen. Wat ik bedoel: Anthropic verkoopt Fable als premium, bovenaan de lijn. Als bekend wordt dat Opus 5.5 Fable op veel punten verslaat—tja, dat is een lastige vraag voor iedereen die Fable-prijzen betaalt.
Specifiek bij agentisch coderen is de voorsprong op Opus 5 groot op alle drie de benchmarks. De sprong op CursorBench is de grootste verbetering op een enkele benchmark in de tabel.
De uitzonderingen zijn ook het vermelden waard. GPT-6 Astra is Opus 5.5 net de baas op zowel AutomationBench (bedrijfsworkflows) als Terminal-Bench-Science (agentisch wetenschappelijk onderzoek), en op de tweede zelfs met een duidelijk verschil. Je zou dus kunnen zeggen dat Opus 5.5 nog achterblijft op sommige realistische workflow- en onderzoekstaken in de wetenschap.
Wacht, hoe zit het met "de vooruitgang doseren"?
De beeldvorming leek in eerste instantie vreemd. Dagen nadat Amodei opriep om AI-trajact te vertragen, bracht Anthropic een nieuw vlaggenschip uit.
Een cynische lezing is dat "de vooruitgang doseren" nooit echt om veiligheid draaide. Het is makkelijker om op te roepen tot vertraging als je voorop loopt, en qua omzet loopt Anthropic voorop.
Maar een andere interpretatie is dat "de vooruitgang doseren" nooit een pleidooi tégen het uitbrengen van modellen was, maar eerder een pleidooi voor wélke modellen je uitbrengt. In die lezing past Opus 5.5 bij de boodschap.
Anthropic zegt dat Opus 5.5 ongeveer op het niveau van Fable 5.1 presteert, een model dat al bestond. Het capaciteitsplafond is niet verschoven. Wat wel veranderde: hetzelfde prestatieniveau kost nu 40% minder en draait meer dan 30% sneller. Het scoort ook beter op interne alignmentscores.
Claude Opus 5.5 prijzen
Fast mode — draaien tot 2,5x zo snel — is beschikbaar in Claude Code en het Claude Platform voor $8 per miljoen inputtokens en $40 per miljoen outputtokens.
Ik heb een grafiek gemaakt zodat we de Claude Opus-prijzen door de tijd heen kunnen zien. Het is in de loop der tijd goedkoper geworden.
Wat we weten over hoe de nieuwe waarborgen werken
Dit weten we uit de releasenotes:
Opus 5.5 krijgt dezelfde categorie beschermingsmaatregelen die Anthropic voor Fable 5.1 reserveert op drie gemarkeerde gebieden: cybersecurity, biologie en distillatie.
Anthropic geeft geen details over het detectiemechanisme zelf, maar het resultaat is een screeningsstap op binnenkomende verzoeken: iets in de prompt wordt gemarkeerd als vallend in een van die drie categorieën, en in plaats van het verzoek naar Opus 5.5 te sturen, wordt het vóór beantwoording doorgestuurd. Een prompt met een cybersecurity-vlag gaat bijvoorbeeld omlaag naar de oudere Opus 4.8, terwijl een prompt met biologie naar Opus 5 wordt opgeschaald. De waarborg is dus geen filter op de output—het is een routeringsbeslissing vóór de generatie start, en welk model het verzoek opvangt hangt af van de categorie die werd getriggerd.
Anthropic liet het model vóór de release ook extern evalueren door METR en Frontier Design (details over wat die organisaties zijn staan in de FAQ’s), zodat de veiligheidsclaims van buitenaf worden getoetst en niet alleen op het woord van Anthropic berusten.
Beschikbaarheid van Claude Opus 5.5
Claude Opus 5.5 is nu live op de eigen platformen van Anthropic én op Amazon Web Services, Google Cloud en Microsoft Azure. Ontwikkelaars op het Claude Platform hebben er direct toegang toe als
claude-opus-5-5.Conclusie
Claude Opus 5.5 is een winst voor gebruikers. Het is goedkoper, sneller en veiliger dan zijn voorganger.
De veiligheidskant is op de lange termijn het interessantere verhaal. Meteen na Amodei’s toespraken over "de vooruitgang doseren" hadden de optics slecht kunnen zijn—een nieuw vlaggenschipmodel, een week na een publieke oproep tot vertraging. Maar de release, al dan niet bewust, vindt precies de balans: er is geen capaciteitsplafond verhoogd, en Opus 5.5 komt met dezelfde klasse waarborgen die eerder voor Fable waren gereserveerd, plus een significant lagere mate van sandbox-escape-pogingen in tests. Ik weet niet of dat in de praktijk "de vooruitgang doseren" is of gewoon goed getimed. Maar het is in elk geval consistent met het betoog van Amodei.