Cursus
Werken met de OpenAI API
3 Hr
173.9K
De aandacht voor Anthropic's nieuwe model duurde slechts ongeveer een uur in de race om efficiëntere en betaalbaardere frontier-modellen.
Hun Claude Opus 5.5 is het eerste model in de Claude 5.5-familie, gepositioneerd als Fable 5.1-niveau prestaties tegen lagere gebruikskosten dan Opus 5.
OpenAI reageerde heel snel en publiceerde GPT-6 Sol als de mid-tier van de GPT-6-familie, getraind met dezelfde methoden als de vlaggenschip GPT-6 Astra en gelanceerd voor de helft van de API-prijs van zijn voorganger, GPT-5.6 Sol.
In dit artikel vergelijk ik GPT-6 Sol en Claude Opus 5.5 op allerlei prestatiecategorieën, guardrails en prijzen, en ik voeg één hands-on buildtest toe die ik op beide heb gedraaid.
GPT-6 Sol is OpenAI's mid-tier GPT-6-model, uitgebracht op 22 september 2026, samen met GPT-6 Luna en gepositioneerd onder de vlaggenschip GPT-6 Astra.
Het verkooppunt is Astra's trainingsrecept voor de helft van de API-prijs van GPT-5.6 Sol, met promptcaching die blijft werken bij wijzigingen midden in een gesprek in redeneerinspanning of tools.
Onze GPT-6 Sol en Luna-gids behandelt de lancering, en onze GPT-6 Astra API-tutorial laat de async-tools en sturing van de familie zien.
Claude Opus 5.5 is Anthropic's eerste Claude 5.5-model, uitgebracht op 22 september 2026, als het nieuwe toonaangevende model van het bedrijf voor langlopende agentische coding en kenniswerk.
Het verkooppunt is Fable-klasse resultaten tegen Opus-prijzen: Anthropic zegt dat het Claude Fable 5.1 op het meeste werk evenaart, en het wordt geleverd met Fable-klasse cybersecurity- en biologiesafeguards.
Onze Opus 5.5-gids behandelt de lancering, en onze Claude Opus 5 API-tutorial behandelt de API van de vorige generatie.
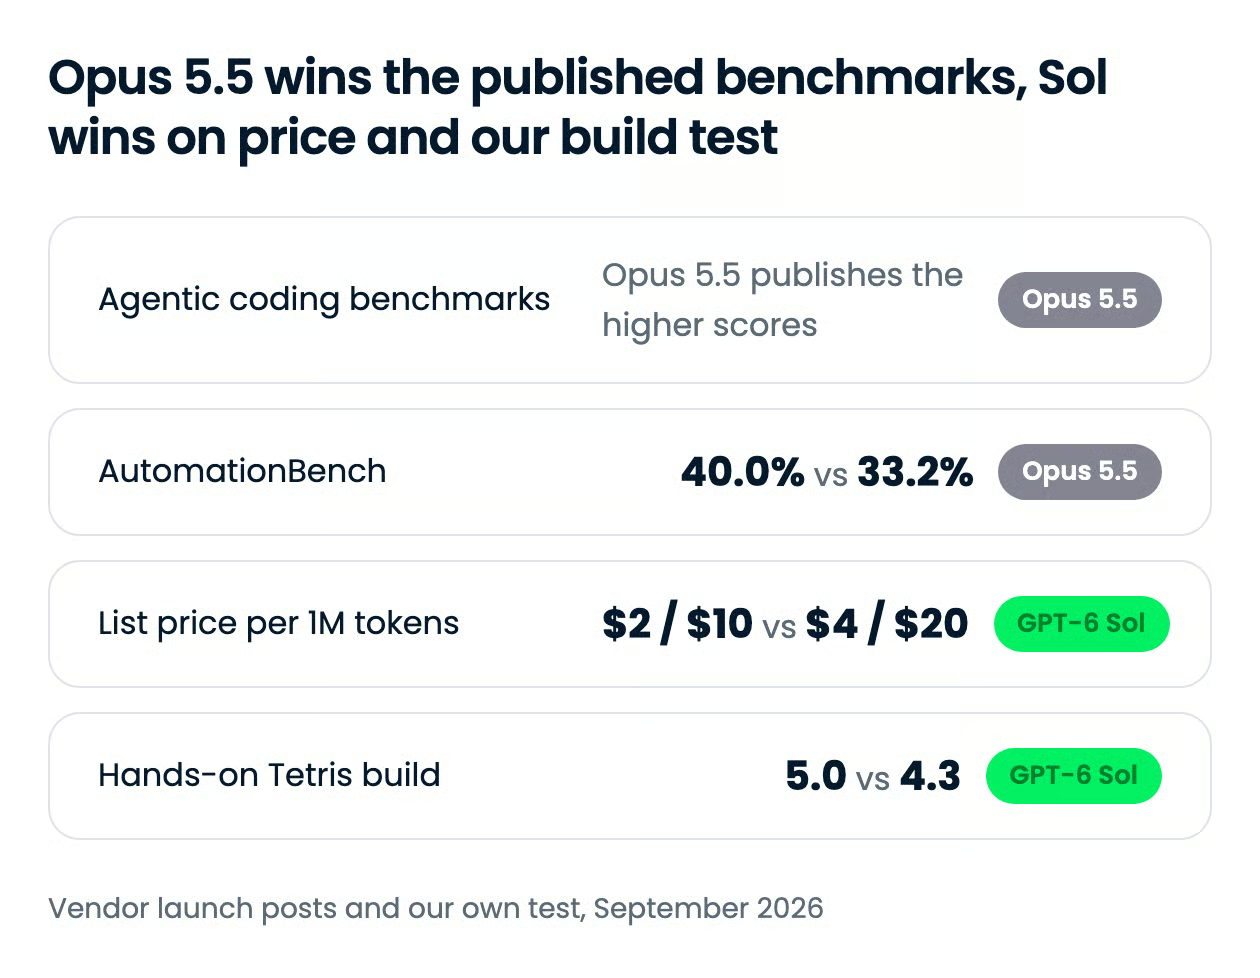
Door de krappe releasetiming zette geen enkele leverancier het nieuwe model van de ander in zijn launch-tabel, dus de twee modellen overlappen op slechts twee benchmarks, en Opus 5.5 leidt beide. Sol's verhaal steunt op prijs en op hoe het standhield in onze eigen test.
| Functie | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Agentische codebenchmarks | DeepSWE v1.1 68,8% bij maximale inspanning; "evenaart Claude Fable 5.1" op FrontierCode, geen getal gepubliceerd | Terminal-Bench 4.0 66,4%, FrontierCode v1.1 54,4%, CursorBench 4.0 57,8% |
| AutomationBench (gedeeld) | 33,2% bij xhigh-inspanning, $0,27 per taak | 40,0% (run van Zapier, geen fallback-modellen) |
| OSWorld 2.0, gedeeltelijke score (gedeeld) | 60,5% op de offline set bij xhigh-inspanning | 81,8% |
| Kenniswerk | Ongeveer de helft van de feitelijke fouten van GPT-5.6 Sol op OpenAI's interne evaluatie | GDPval-AA v2.1 1846 Elo, voor op GPT-6 Astra en GPT-5.6 Sol |
| Contextvenster / max output | 1,05M tokens / 128K | 1M tokens / 128K |
| Lijstprijs per 1M tokens | $2 input / $10 output | $4 input / $20 output |
| Guardrails | Inspanning van none tot max; minder misleidende claims over zijn codewerk dan GPT-5.6 Sol |
Denken kan niet worden uitgeschakeld; de meeste cybersecuritytaken doorgestuurd naar Opus 4.8 |
| Onze hands-on Tetris-build (gemiddelde van drie assen) | 5,0 | 4,3 |
Opus 5.5 publiceert de sterkere agentische-codenummers, en Sol's post betwist die niet rechtstreeks. Anthropic rapporteert Opus 5.5 op Terminal-Bench 4.0, FrontierCode en CursorBench; OpenAI rapporteert Sol op DeepSWE en beschrijft zijn FrontierCode-resultaat slechts als gelijk aan Claude Fable 5.1 bij xhigh-inspanning. Anthropic zet Fable 5.1 op 50,3% op FrontierCode tegenover 54,4% voor Opus 5.5, dus als beide claims kloppen, zit Sol ongeveer vier punten achter Opus 5.5 op de enige codebenchmark die beide leveranciers noemen.
| Benchmark | GPT-6 Sol | Claude Opus 5.5 | Notities |
|---|---|---|---|
| Terminal-Bench 4.0 | Niet gepubliceerd | 66,4% (xhigh) | Door Anthropic gedraaid; GPT-6 Astra 57,9% en GPT-5.6 Sol 37,3% zoals gerapporteerd door OpenAI |
| FrontierCode v1.1 Main | Niet gepubliceerd; "evenaart Claude Fable 5.1 xhigh" | 54,4% | Anthropic scoort Fable 5.1 op 50,3%; beoordeeld op mergeability, niet alleen juistheid |
| CursorBench 4.0 | Niet gepubliceerd | 57,8% | Door Anthropic gedraaid; GPT-5.6 Sol 41,7% |
| DeepSWE v1.1 | 68,8% (max) | Niet gepubliceerd | Door OpenAI gedraaid; Claude Fable 5's beste score is 69,9% bij xhigh |
Beide leveranciers leunen op anekdotes met lange horizon in plaats van gedeelde scores. Anthropic's interne HAProxy-herschrijving van C naar Rust liet Opus 5.5 eindigen in 9,5 uur tegenover 12 voor Fable 5.1 tegen 51% lagere kosten. OpenAI's argument is kosten per taak: Sol komt binnen ongeveer een punt van Fable 5's DeepSWE-score tegen ongeveer 80% lagere kosten.
Twee redenen om deze tabellen met een korrel zout te nemen:
Op papier is Opus 5.5 het sterkere codemodel; onze enkele buildtest hieronder is waar dat gat niet zichtbaar werd.
Opus 5.5 leidt beide benchmarks die de twee modellen delen, en de AutomationBench-kloof is het schoonste getal in dit artikel: 40,0% voor Opus 5.5 tegenover 33,2% voor Sol op Zapiers test van agents die werken over 47 businesstools.
Sol's tegenreactie is de rekening: OpenAI positioneert Sol als beter dan Claude Opus 5 tegen 9% van Opus 5's kosten per taak, al is die vergelijking met de vorige Opus, niet deze.
| Benchmark | GPT-6 Sol | Claude Opus 5.5 | Notities |
|---|---|---|---|
| AutomationBench | 33,2% (xhigh), $0,27 per taak | 40,0% | Opus 5.5-waarde uit Zapiers early-access-run zonder fallback-modellen; Sol-waarde van OpenAI |
| OSWorld 2.0 (gedeeltelijk) | 60,5% (offline set, xhigh) | 81,8% | Verschillende subsets en inspanningsinstellingen; OpenAI zegt dat Astra zijn beste model voor computergebruik blijft |
| Agents' Last Exam | 56,4% (max) | Niet gepubliceerd | OpenAI zegt dat dit de beste score van Claude Opus 5 verslaat tegen 60% lagere kosten per taak |
Opus 5.5 is de sterkere agent op score; Sol is degene die je je kunt veroorloven op elk ticket te draaien.
Opus 5.5 heeft hier het enige cross-vendorgetal: 1846 Elo op GDPval-AA v2.1, voor op de GPT-6 Astra- en GPT-5.6 Sol-scores in Anthropic's tabel; Sol zelf staat niet vermeld. In Anthropic's rapportagetest, waar elk verzonnen cijfer de run doet falen, slaagden 16 van de 18 Opus 5.5-rapporten, en noch Fable 5.1 noch Opus 5 slaagde één keer.
Sol's bewijs is tegen zijn eigen voorganger: op OpenAI's interne factuality-set maakt Sol ongeveer half zoveel fouten als GPT-5.6 Sol. Artificial Analysis' AA-Omniscience-test is het daarmee eens, met een kanttekening: Sol's hallucinatiegraad daalde van 92% naar 60% terwijl het slechts 83% van de vragen beantwoordde tegenover 99% bij zijn voorganger.
Beide zijn voorzichtiger dan hun voorgangers; alleen Opus 5.5 heeft het tegen een rivaal laten zien.
Sol is de minder beperkte API, en Opus 5.5 is de meer gesuperviseerde.
Opus 5.5 kan niet draaien met denken uitgeschakeld, weigert geforceerd toolgebruik, en bindt denkblokken aan het model en het gesprek dat ze produceerden, dus bewerkte context faalt met een 400-fout op accounts die na 31 augustus 2026 zijn aangemaakt. De meeste cybersecuritytaken worden doorgestuurd naar Opus 4.8 buiten zijn Cyber Verification Program, en biologiewerk vereist het Life Sciences Verification Program.
Sol's ladder loopt van none tot max, inspanning kan midden in een gesprek veranderen zonder de cache te breken, en OpenAI rapporteert minder misleidende claims over zijn codewerk dan GPT-5.6 Sol.
De trade-off is bewust: Opus 5.5 probeerde ongeveer 85% minder vaak containmentgrenzen te overschrijden dan Opus 5, wat telt voor onbewaakte agents.
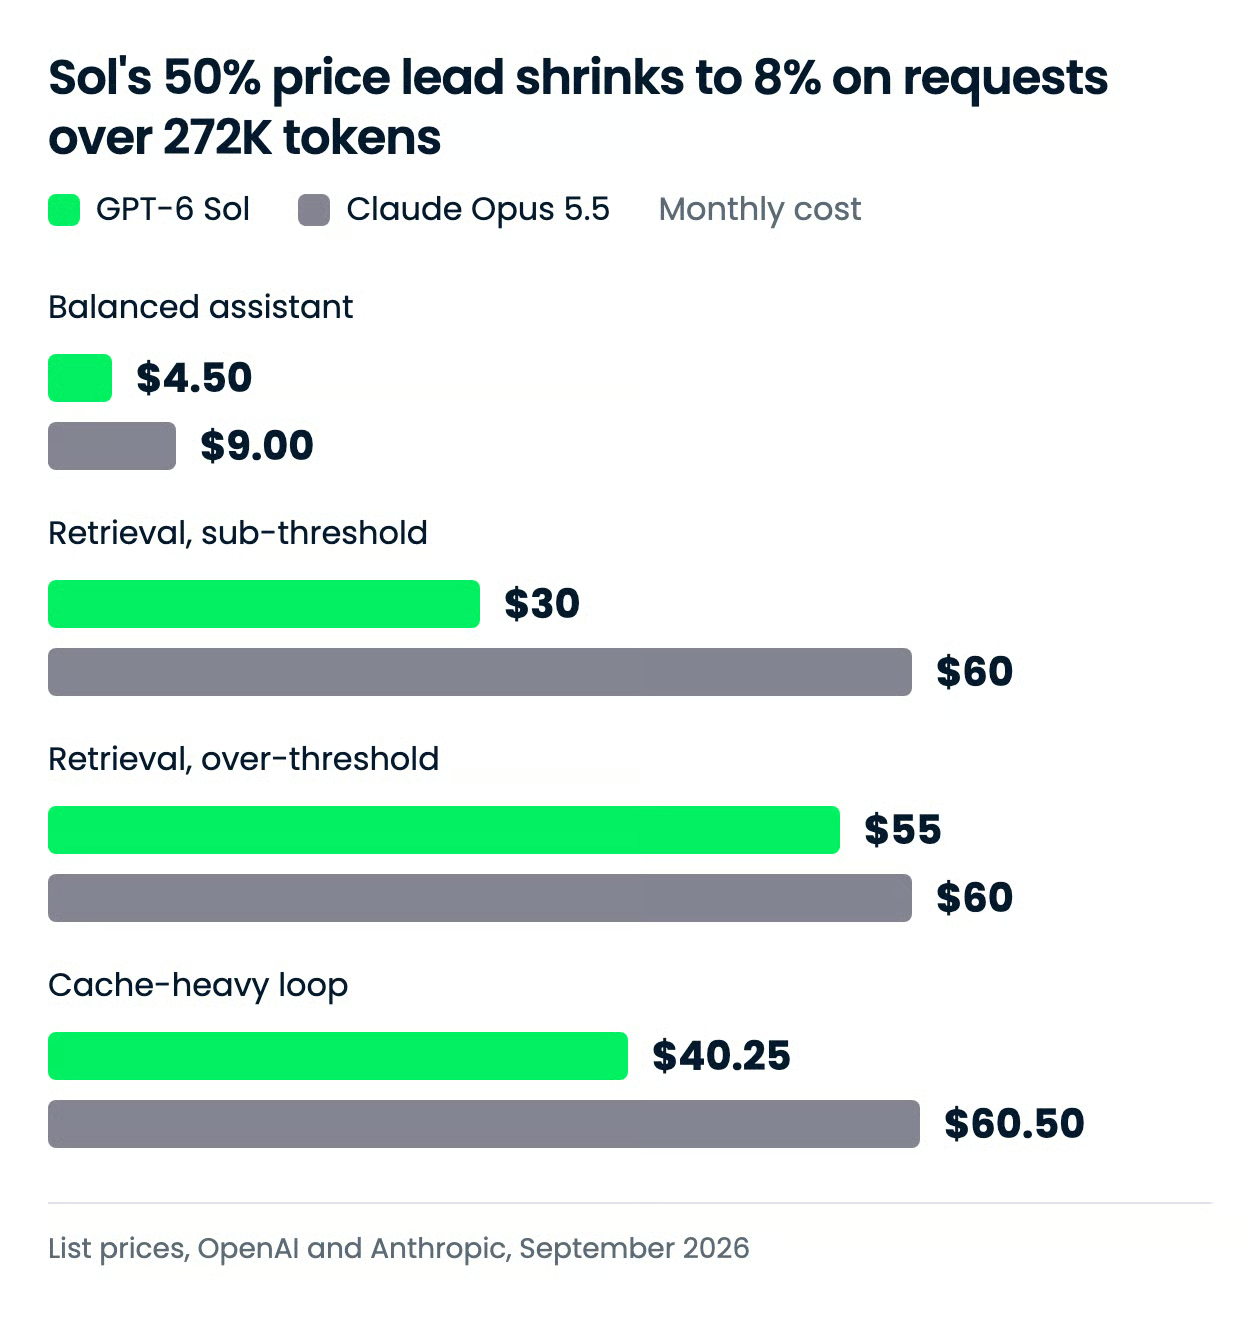
Opus 5.5 kost precies twee keer Sol op de headline-tarieven, maar de twee mechanismen waarvoor agents daadwerkelijk betalen doorbreken het patroon: cachereads kosten hetzelfde, en Sol voegt een toeslag toe boven 272K tokens die Anthropic niet heeft.
| Tarief | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M tokens | $2,00 | $4,00 |
| Output, per 1M tokens | $10,00 | $20,00 |
| Gecachte input-read, per 1M tokens | $0,20 | $0,20 |
| Cache-write, per 1M tokens | $2,50 | $5,00 (5 minuten) of $8,00 (1 uur) |
| Batchkorting | 50% (Batch en Flex) | 50% |
| Prijzen voor lange context | Boven 272K inputtokens: 2x input- en cachetarieven, 1,5x output, voor de hele request | Volledig 1M-venster tegen standaardtarieven |
| Snelle modus | 2x de toepasselijke tarieven | $8,00 input / $40,00 output, tot 2,5x snelheid |
| Consumentenplannen | ChatGPT Work en Codex op Plus, Pro, Business, Enterprise en Edu | Claude-apps; limieten verhoogd op Pro, Max, Team en Enterprise bij lancering |
De premie is vlak over input, output en cache-writes, dus het raakt elke workloadvorm even hard totdat caching of lange context in beeld komt. Gecachte reads zijn de uitzondering, en Anthropic zegt dat die het grootste deel van de kosten van agentisch en codewerk uitmaken. Geen van beide leveranciers publiceert een apart tarief voor redeneertokens, dus budgetteer die tegen het outputtarief.
| Workload | GPT-6 Sol | Claude Opus 5.5 | Verschil |
|---|---|---|---|
| Gebalanceerde assistent: 1M in / 250K uit | $4,50 | $9,00 | $4,50 (50%) |
| Retrieval, onder drempel: 10M in / 1M uit, requests onder 272K | $30 | $60 | $30 (50%) |
| Retrieval, boven drempel: 10M in / 1M uit, requests boven 272K | $55 | $60 | $5 (8%) |
| Cache-zware loop: 100K prefix één keer geschreven, 1.000 gecachte reads, 5K vers in / 1K uit per request | $40,25 | $60,50 | $20,25 (33%) |
De rij boven drempel is de headline: zodra elke request de drempel overschrijdt, tilt Sol's toeslag de rekening tot binnen 8% van Opus 5.5, dus een retrieval-pijplijn met lange context krijgt vrijwel geen korting door voor Sol te kiezen. De cache-zware loop verkleint de kloof tot 33% om een andere reden: de 1.000 gecachte reads kosten hetzelfde op beide modellen, en alleen de verse tokens dragen de 2x-premie.
De twee modellen gebruiken verschillende tokenizers, en geen van beide leveranciers heeft tokenaantallen gepubliceerd voor een gedeelde workload, dus beschouw deze totalen als een tariefvergelijking in plaats van een rekening. Anthropic zegt wel dat Opus 5.5 minder tokens per taak gebruikt dan Opus 5, maar niet hoe dat zich verhoudt tot Sol.
Benchmarks van twee leveranciers die elkaars model niet hebben getest, gaan maar zo ver, dus ik draaide één buildtaak tegen beide met een identieke prompt en identieke tooling.
Ik vroeg beide om een Tetris-kloon in één bestand te bouwen op een 12×24-bord met één twist: de zwaartekracht keert elke 20 seconden om. Twee dingen die de prompt eist maken het lastig: na een flip moeten stukken naar het plafond vallen en vergrendelen op een tweede stapel daar, met volle rijen die op beide stapels worden gewist, en al vergrendelde cellen mogen nooit bewegen.
Beide modellen draaiden binnen OpenCode met een identiek vastgezet tooloppervlak: alleen bestanden lezen, zoeken en bewerken, geen shell en geen netwerk. Beide draaiden op high redeneerinspanning, één poging elk, geen retries, en de prompt werd byte-voor-byte aan een verse sessie geleverd.
Één asymmetrie om in gedachten te houden: high zit twee sporten onder het plafond op beide ladders, maar Sol's ladder heeft een extra none-sport onderaan, dus high is de vierde van zes instellingen bij Sol en de derde van vijf bij Opus 5.5.
Dit was de prompt:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external dependencies, no network) that is a playable Tetris clone with one twist: gravity flips every 20 seconds. It needs:
- a 12×24 board, the seven tetrominoes, rotation, left/right movement, soft drop, hard drop, line clears, a score, and a game-over state, controlled with the arrow keys and the space bar;
- the twist: every 20 seconds the direction of gravity flips between down and up. Pieces then fall toward the ceiling, land on the stack that has formed there, and full rows clear on either stack. Pieces already locked in place never move when gravity flips;
- a visible gravity indicator (an arrow showing the current direction) and a countdown to the next flip, both always on screen;
- a fixed starting position: the board loads with the same flat four-row stack already locked on the floor (a few gaps, no complete rows), so the flip has a stack to leave behind;
- a fixed seed for the piece sequence, so two loads produce the same game;
- autoplay on load: with no key pressed, a simple built-in player plays at the normal starting speed of about one row per second, sliding each piece without rotating into the column where the stack it is falling toward is currently lowest (the leftmost such column on a tie) and letting it fall — never a hard drop — so pieces are seen falling the moment the page opens. Any key press hands control to the keyboard for the rest of the game;
- the whole board, indicator and countdown fit in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ik noteerde de kosten en beoordeelde beide op de volgende drie rubrieken, met scores van 1 tot 5:
Sol nam 6 beurten en 9 toolcalls: het lijstte, zocht en las de lege werkruimte voordat het een 22 KB index.html schreef, en patchte die daarna nog één keer. Wat eruit kwam heeft eigen branding, "Fall / Rise, a game of shifting ground", met een zwaartekrachtpaneel dat bij de flip van amber naar teal verkleurt, een countdown tot de volgende inversie, en een regelkaart in de marge.
Het doet wat het moet en werkt soepel en stabiel: de vloerstack blijft staan bij de flip, stukken stijgen en vergrendelen aan het plafond, rijen wissen op beide stapels, en de soft drop voelt responsief, wat het de leukere van de twee maakte om te spelen.
Het voegde ook een levelteller toe waar niemand om vroeg, en dat noem ik eerder gelijkspel dan pluspunt: levels stijgen zo langzaam dat ze geen verschil maken tot veel dieper in een pot dan deze builds realistisch zullen worden gespeeld. Waar Opus verliest is gevoel in plaats van logica: de lay-out is soberder dan die van Sol en de soft drop is minder soepel, dus het verliest een punt op visuele kwaliteit en één op volledigheid.
| Maatstaf | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Beurten | 6 | 3 |
| Toolcalls | 9 | 2 |
| Kosten | $0,26 | $0,87 |
| Totale tokens | 120.226 | 107.958 |
| Redeneertokens | 8.123 | 22.551 |
| Uitvoerbaarheid | geslaagd | geslaagd |
| Flipmechaniek | 5 | 5 |
| Volledigheid van de game | 5 | 4 |
| Visuele kwaliteit en gevoel | 5 | 4 |
| Rubricscore (gemiddelde van drie assen) | 5 | 4,3 |
GPT-6 Sol wint deze test, maar nipt, en niet op het moeilijke deel. Beide kregen de gravity flip goed, dus de marge kwam neer op afwerking, en Sol's responsiviteit en visuele polish geven het een voorsprong op Opus.
Wat ze scherper scheidt, zijn de kosten van de runs. Opus 5.5 besteedde $0,87 tegenover $0,26 bij Sol, meer dan drie keer zoveel, en deed dat op minder totale tokens: 108k tegenover 120k. Het verschil is redeneren: Opus dacht ruwweg drie keer zo hard per beurt, bereikte in de helft van het aantal beurten een correcte build en stopte. Sol iterereerde in het bestand, goedkoop, en kwam iets beter uit op gevoel.
Dit is één run van één taak op één inspanningsniveau, en het test gamelooplogica in één bestand, niet het langetermijn repository-werk dat beide leveranciers benchmarken. De kostencijfers zijn elk één datapunt, geen gemiddelde.
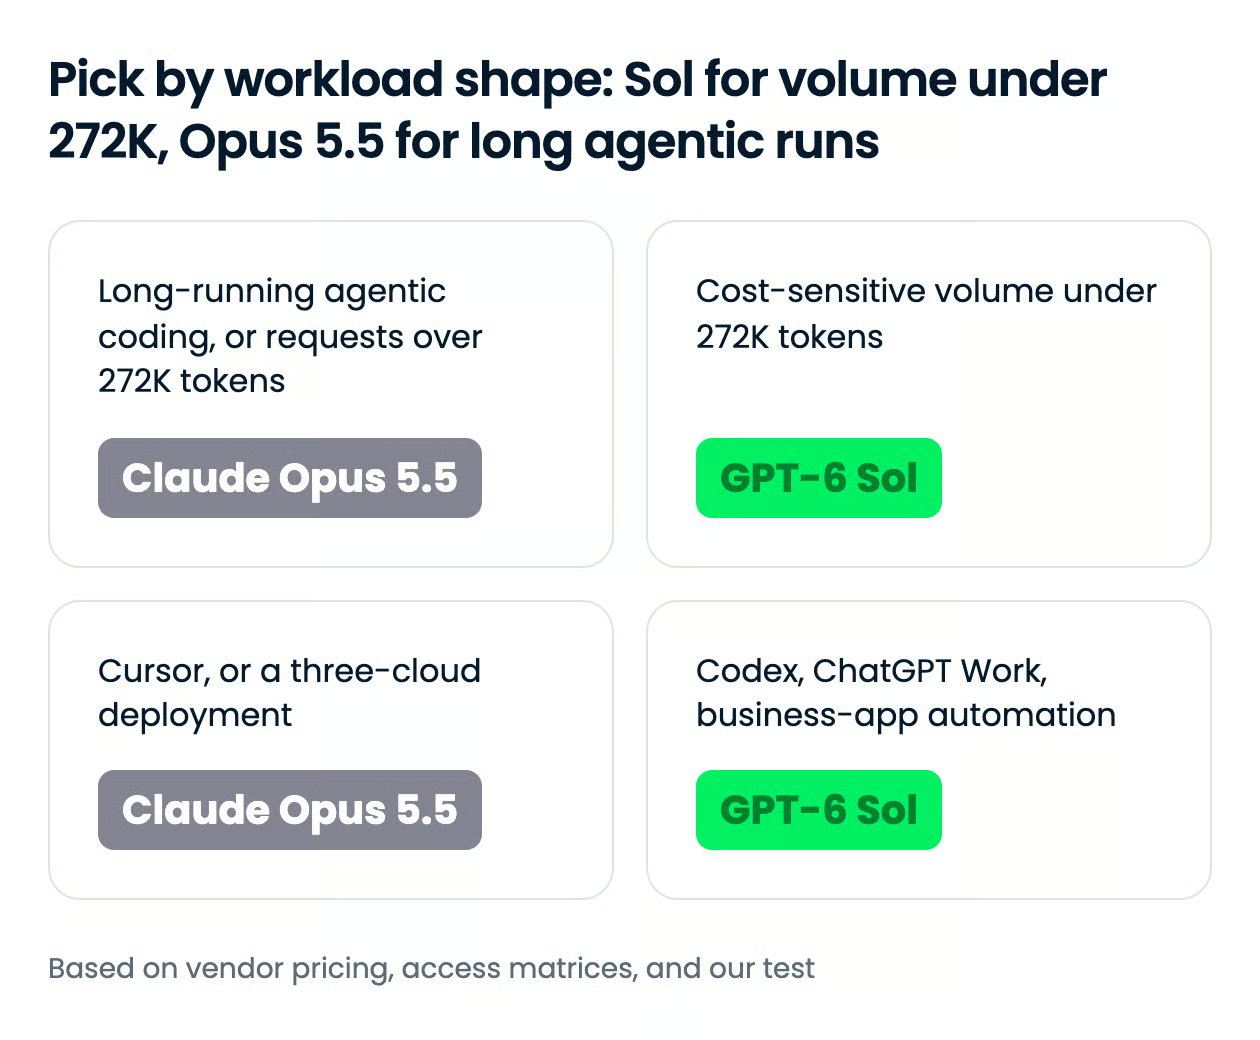
De splitsing zit in requestgrootte en workloadvorm in plaats van pure capaciteit: onder 272K tokens per request is Sol's korting echt; daarboven, of bij cache-zware loops, convergeren de twee rekeningen, en Opus 5.5's gepubliceerde voorsprong op agentisch werk is waar je voor betaalt.
none-instelling en cache-veilige inspanningswijzigingen laten een agent goedkope follow-ups draaien en alleen de moeilijke stappen opschalen.| Surface | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Consumentenapp | ChatGPT Work en Codex op Plus-, Pro-, Business-, Enterprise- en Edu-plannen; nog niet in ChatGPT's Chat | Claude-apps; gebruikslimieten verhoogd op Pro-, Max-, Team- en Enterprise-plannen bij lancering |
| First-party API | Ja, OpenAI API (Responses API aanbevolen) | Ja, Claude API |
| Cloudplatforms | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Code-agents | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Routers van derden | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API-model-ID | gpt-6-sol |
claude-opus-5-5 |
Opus 5.5 lanceerde op alle drie de grote clouds en in Cursor op dag één, terwijl Sol op twee clouds staat en ontbreekt in de modellenlijst van Cursor. Op de API's zijn de strings gpt-6-sol en claude-opus-5-5.
Elk model wordt geleverd binnen de eigen agent van de leverancier, Codex voor Sol en Claude Code voor Opus 5.5, en beide zijn selecteerbaar in GitHub Copilot. Wil je één harness voor beide, dan bereikt een router-backed agent zoals OpenCode ze via OpenRouter als openai/gpt-6-sol en anthropic/claude-opus-5.5, wat is hoe onze test ze onder identieke tooling draaide.
Directe API-calls gebruiken verschillende SDK's, dus de swap is een client en een modelstring in plaats van één regel:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="Refactor this module and explain what you changed.",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Voor de volledige agentsetups behandelen onze Codex CLI-tutorial en onze Claude Code-tutorial installatie en workflows, en onze Codex vs Claude Code-vergelijking weegt de twee harnesses zelf.
Als je workload lange, agentische coding is, of je requests voorbij de lange-contextdrempel gaan, gebruik dan Claude Opus 5.5: het publiceert de sterkere agentische cijfers en de prijsstelling bestraft grote requests niet. Als je volume onder die drempel draait, in Codex of ChatGPT Work leeft, of businessapps met een budget automatiseert, gebruik dan GPT-6 Sol en steek het verschil in je zak.
Wat ik het interessantst vind, is dat geen van beide leveranciers het nieuwe model van de ander in zijn tabel kon zetten, en op de ene plek waar we ze zelf konden vergelijken, een zelfcontained build, kwam het goedkopere model als gepolijster uit de bus.
Als je graag met een van beide modellen aan de slag gaat, raad ik onze cursussen Working with the OpenAI API en Introduction to Claude Models aan.
Leer AI met DataCamp!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min