Cursus
Werken met de OpenAI API
3 Hr
175.5K
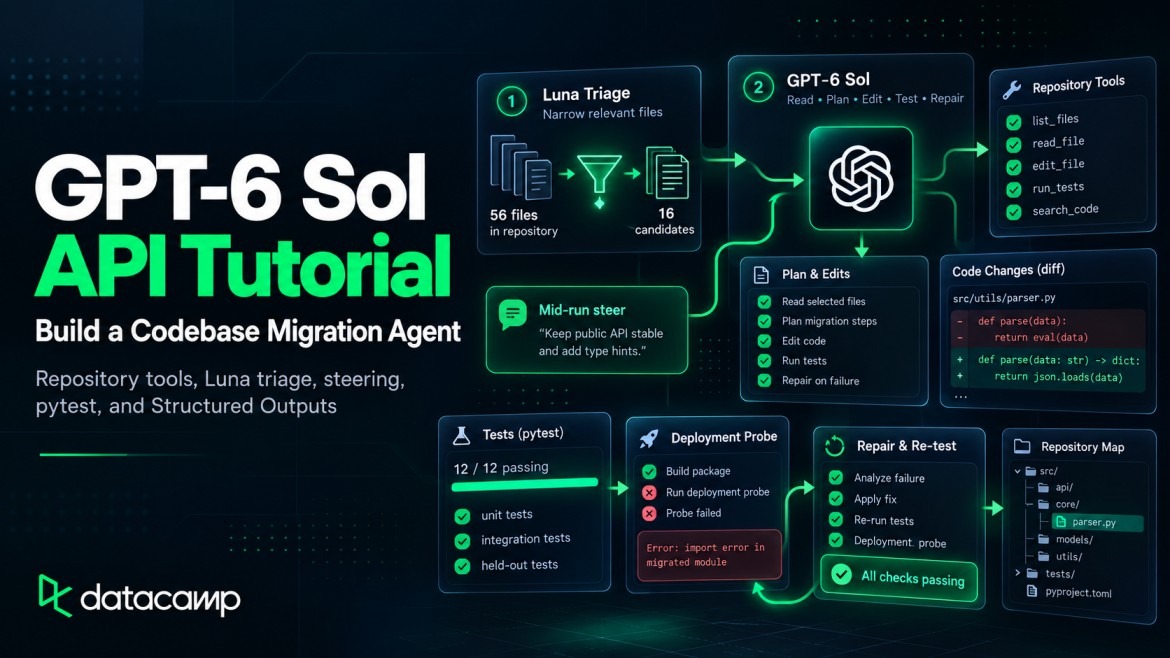
Hier gebruiken we GPT-6 Sol om Northstar Checkout, een kleine fictieve Python-checkoutservice, te migreren van een lokale v1-betaaladapter naar v2.
Specifieker laten we zien hoe je:
Je eerste GPT-6 Sol API-call maakt en de gebruiksvelden uitleest
Het migratiecontract definieert voordat het model de repository ziet
GPT-6 Sol beperkte bestands- en testtools geeft en de toegang in fases opbouwt met allowed_tools
GPT-6 Luna gebruikt voor triage en GPT-6 Sol de shortlist laat verifiëren
Een gestructureerd migratieplan retourneert en het checkt tegen bestanden die GPT-6 Sol al heeft gelezen
De migratie via WebSocket draait en bijstuurt nadat het bewerken is gestart
De redeneerinspanning verhoogt nadat een onafhankelijke deploymentprobe faalt
De geregistreerde kosten berekent op basis van API-gebruik
Vier bevindingen veranderen hoe ik de volgende versie zou bouwen:
GPT-6 Sol is de middencategorie van OpenAI's GPT-6-familie, en zijn API-model-ID is gpt-6-sol. Onze gids voor de GPT-6-modellagen behandelt de lancering en benchmarks. OpenAI's GPT-6-richtlijnen plaatsen GPT-6 Astra bovenaan, GPT-6 Sol in het midden en GPT-6 Luna als meest betaalbaar.
GPT-6 Sol heeft een contextvenster van 1.050.000 tokens en retourneert tot 128.000 outputtokens. Redeneerinspanning loopt van none tot en met max en staat standaard op medium. Chat Completions ondersteunt GPT-6 Sol's function calling alleen bij none, dus elk verzoek hier gebruikt de Responses API.
Prijzen en API-ondersteuning bepalen hoe de harness elk verzoek verzendt.
GPT-6 Sol kost $2 per miljoen inputtokens en $10 per miljoen outputtokens voor verzoeken tot 272.000 inputtokens, volgens OpenAI's prijspagina. Gecachte input kost $0,20 per miljoen, en cachewrites kosten $2,50. GPT-6 Luna's tarieven voor dezelfde vier categorieën zijn $0,10, $0,01, $0,125 en $0,50.
Boven 272.000 inputtokens wordt het hele verzoek tegen 2x de input- en cacherates en 1,5x de outputrate gefactureerd. Geen enkel verzoek in dit project kwam daarbij in de buurt.
De harness, oftewel de Python-code rondom het model, gebruikt deze GPT-6-regelaars:
Sturen halverwege een beurt werkt een antwoord bij terwijl het loopt
configuration_update verandert de redeneerinspanning zonder de gecachte prefix te herschrijven
allowed_tools stelt de subset in die aanroepbaar is voor een verzoek
Structured Outputs bepaalt de velden in het plan en het rapport
Alle vier blijven binnen dezelfde Responses API-responsetrain.
We bouwen een agent die Northstar Checkout van Payments Adapter v1 naar v2 verplaatst. Beide adapters zijn lokale stand-ins die ik voor dit experiment schreef, geen echte betaal-SDK's. De complete code, fixtures en opgenomen run staan in deze GitHub-repository.
De repository mixt betaalcode met niet-gerelateerde modules, dus GPT-6 Sol moet zelf de getroffen bestanden vinden. V2 breekt vier adaptercontracten:
Betalingen aanmaken verhuist van client.charge(...) naar client.payments.create(...)
Resultaat-dicts worden getypeerde objecten met Money-bedragen
Geweigerde kaarten geven een status terug in plaats van een exceptie te gooien
Webhooks veranderen hun namen, envelop en handtekeningheader
Zoek-en-vervang kan de methodenaam wijzigen. Het dekt geen van de gedragswijzigingen.
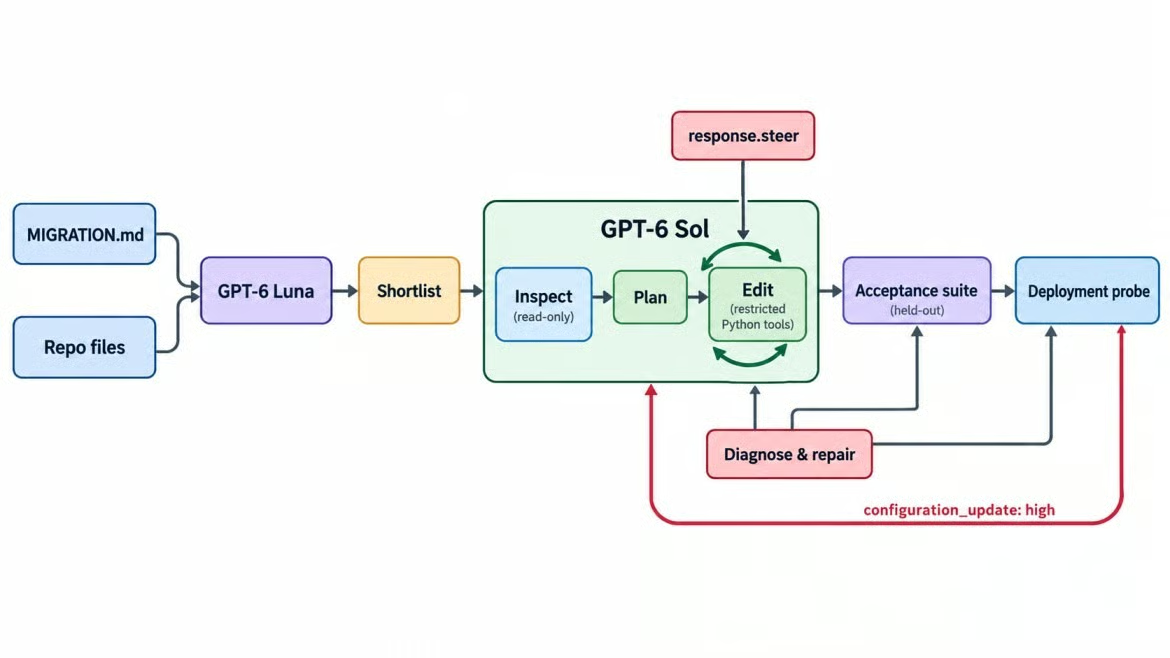
Eén migratielus, twee GPT-6-modellen. Afbeelding door de auteur.
GPT-6 Sol krijgt de specificatie, de boomstructuur van bestanden en beperkte tools die in fases aanroepbaar worden. Het weet niet welke bestanden wijzigingen nodig hebben of dat er een eis zal veranderen.
Twee delen van de specificatie zijn valkuilen. Geen ervan is een geplante bug; beide ontstaan waar v2-gedrag de bestaande code raakt:
Idempotency. v2 vergelijkt parameters bij een herhaalde request_id, maar checkout zet bij elke poging een nieuwe order_id in de metadata, waardoor een naïeve retry wordt afgewezen in plaats van gededupliceerd.
Refundtotalen. v2's payment.refunded-webhook rapporteert het totaal tot nu toe, terwijl de oude handler elke waarde optelt met +=.
Beide overleven een typechecker. Je vindt ze alleen door checkout en refunds end-to-end te draaien.
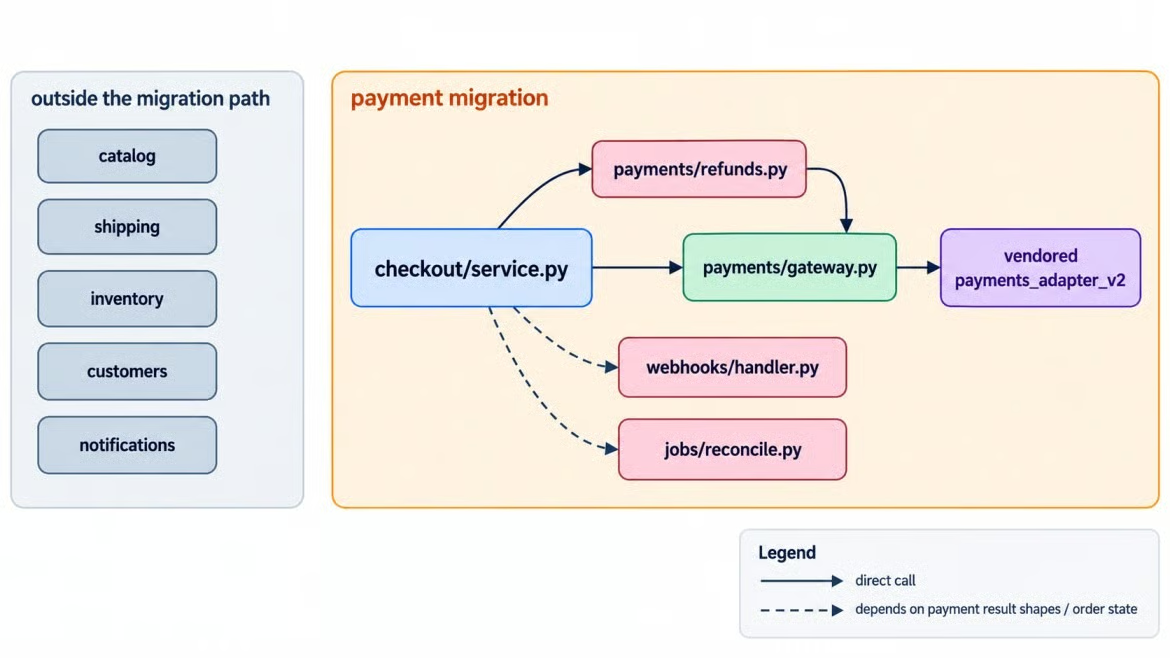
Betalingswijzigingen raken meerdere Northstar-modules. Afbeelding door de auteur.
De kaart scheidt directe adapterimports van modules die van betaalgedrag afhangen. Die indirecte koppelingen zijn waarom een antwoordtoets voor de hele repository ertoe doet.
Een achtergehouden acceptatiesuite, geschreven vóór elke modelcall, bepaalt het resultaat. GPT-6 Sol ziet hem nooit; de harness draait hem met pytest tegen de gemigreerde kopie. Hij checkt dat:
Checkout via v2 slaagt, en een retry met dezelfde idempotency key maar één keer afschrijft
Een geweigerde kaart nog steeds de publieke CheckoutDeclined-fout gooit
Een volledige refund, twee gedeeltelijke refunds en een opnieuw bezorgde webhook allemaal correcte totalen achterlaten
CheckoutClient-methodesignatures ongewijzigd zijn
Er geen v1-verwijzingen meer zijn, vendor/ en MIGRATION.md onaangeroerd blijven, en de zichtbare tests slagen
De oorspronkelijke code haalde al checks voor ongewijzigde interfaces en beschermde bestanden; de overige checks meten de migratie. Een aparte antwoordtoets somt de vereiste wijzigingen op, maar alleen de harness leest die.
De mappen acceptance/ en probes/ staan buiten de gekopieerde repository die beide modellen zien. De antwoordtoets leeft onder acceptance/, dus kan niet in GPT-6 Luna's input, de bestandsboom of een repositorytool terechtkomen.
De read-gate kan paden retourneren uit GPT-6 Sol's eigen plan. Het resultaat van de antwoordtoets-dekking wordt alleen voor evaluatie vastgelegd; het stuurt nooit ontbrekende grondwaarheidspaden terug naar GPT-6 Sol.
Na die suite draait een deploymentprobe. Geen van beide checks accepteert het "klaar"-bericht van het model als bewijs.
Je hebt Python 3.10 of nieuwer nodig en een API-sleutel met toegang tot beide modellen. De requirements bevatten de realtime extra die nodig is voor sturen:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Op macOS of Linux gebruik je source .venv/bin/activate en cp .env.example .env, en zet dan OPENAI_API_KEY=... in .env.
Als je sleutel al werkt met de Responses API, sla de volgende subsectie over.
Het kleinst nuttige verzoek bevestigt de sleutel, de model-ID en de gebruiksvelden die de kostensectie nodig heeft:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
De response meldt medium inspanning, en usage bevat cached_tokens en cache_write_tokens. Laat temperature en top_p weg. Beide geven een 400 terug zodra de inspanning niet none is.
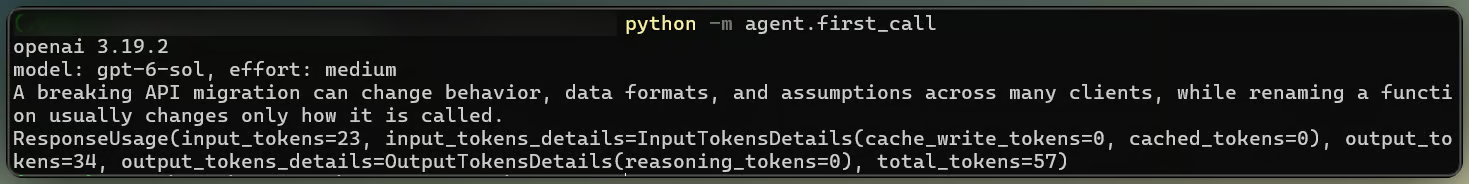
Eerste GPT-6 Sol-verzoek retourneert usage. Afbeelding door de auteur.
Begin op medium, de standaard, en laat de instelling op request-niveau de hele run zo. De meeste migratiebeurten zijn reads en kleine edits. De deploymentprobe later geeft een reden om de inspanning te verhogen.
De toollaag beheert de permissies van de agent. GPT-6 Sol krijgt deze function tools met strict: true:
list_files en search_code lokaliseren relevante code
read_file retourneert één repositorybestand
edit_file verandert één exacte voorkomensplaats
run_tests voert een toegestane pytest-target uit
Strikte schema's checken de argumentvorm, niet de padveiligheid, dus Python handhaaft de schrijflimiet:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
Het pad wordt eerst opgelost, dus ../ en absolute paden falen. edit_file vervangt één exacte match, en run_tests accepteert alleen targets onder tests/.
De harness retourneert een geblokkeerde call als een ERROR: tooluitvoer, en de lus gaat door. Onze gids voor agent-harness-engineering legt uit waarom deze checks thuishoren in de harness en niet in de prompt.
Roep elke tool aan met invoer die hij moet weigeren:
Een pad met ..
Een absoluut pad
Een write onder vendor/
Een testtarget met een shell-opdracht
Geen ervan mag erdoor komen. Een edit die op meer dan één plek matcht moet om meer context vragen, en door de regels in aangepaste functies te houden staan ze op één testbare plek.
Repository-triage is een smalle classificatietaak: beoordeel de relevantie van elk bestand en citeer v1-verwijzingen. GPT-6 Luna krijgt deze taak en niets anders, en draait eerst, voordat GPT-6 Sol iets heeft gezocht.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
De input is de spec plus elk Python-bestand onder northstar/ en tests/. Alles met high of medium gaat op de shortlist die GPT-6 Sol hierna krijgt.
Check de shortlist tegen de eerdere antwoordtoets, en kijk eerst naar recall. GPT-6 Luna behield elk getroffen bestand en voegde er een paar toe die geen wijzigingen nodig hadden.
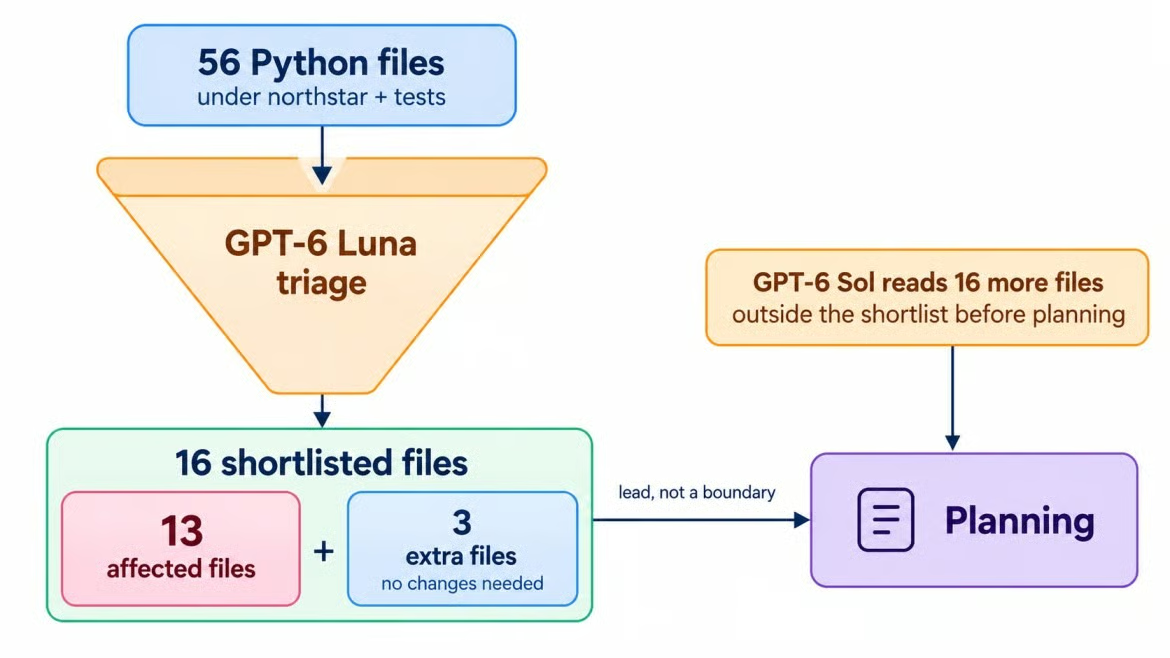
GPT-6 Luna brengt 56 terug tot 16. Afbeelding door de auteur.
Een shortlist is een aanwijzing, geen grens.
allowed_tools voor gefaseerde permissiesallowed_tools is een tool_choice-modus die beperkt welke tools het model kan aanroepen terwijl de volledige toollijst blijft staan. Zo blijft GPT-6 Sol's eerste pass read-only: de volledige lijst staat op elk verzoek, maar alleen listing en searching zijn aanroepbaar.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Het veranderen van tools tussen fases herschrijft de gecachte prefix. De functieaanroepgids raadt allowed_tools aan wanneer alleen de aanroepbare subset moet veranderen.
Een read-only pass scheidt diagnose van actie. GPT-6 Sol kreeg de shortlist van GPT-6 Luna met een duidelijke waarschuwing dat die fout kon zijn, en zijn zoekacties naar v1-imports, charge-calls en webhooknamen brachten alle getroffen bestanden al naar voren.
Het ging ook voorbij de lijst en markeerde ordermodellen, de orderstore, serializers en de grootboekexport als downstream-afhankelijkheden om te checken. Geen ervan bleek wijzigingen te vereisen, maar door ze te lezen kom je daar achter. Ik zou allowed_tools aanhouden voor elke agent die bestanden bewerkt.
Een migratieplan is waar de agent zich vastlegt op specifieke bestanden voordat hij schrijfrechten krijgt. Plannen voegt read_file toe, en het plan komt terug via Structured Outputs met tools uitgeschakeld:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
Het plan dekte elke vereiste wijziging en waarschuwde dat een nieuw order-ID v2-metadata bij een retry zou veranderen. Die waarschuwing komt later terug.
Voor je schrijfrechten verleent, checkt de harness de structuur, het bewijs en de dekking van het plan.
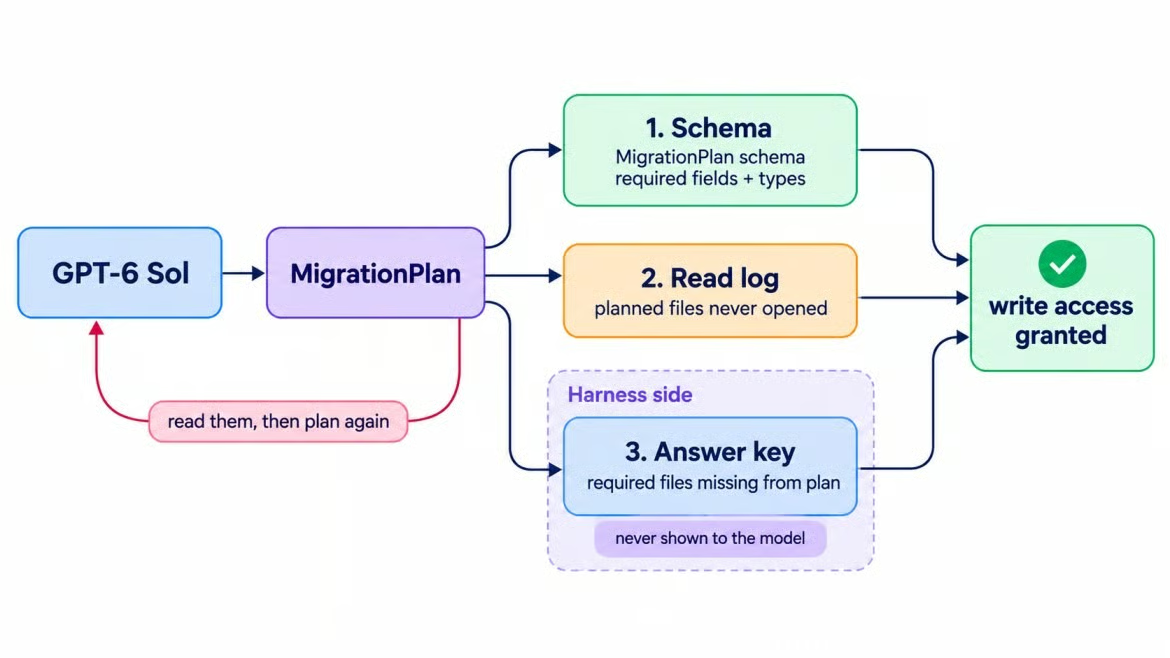
Drie checks toetsen één migratieplan. Afbeelding door de auteur.
Het plan haalde elke poort. Het stelde ook voor om een publieke parameter in client.py te hernoemen om te matchen met de v2-benaming, wat de opschoonsectie van de spec suggereerde. Dat voorstel wordt de stuurtest.
Een GPT-6 Sol code-agent gebruikt een toollus: wacht op een response, voer zijn functieaanroepen uit en retourneer de outputs. Onze gids voor de OpenAI Responses API legt de request- en toolresultaatformaten uit. Deze migratie houdt de lus op één WebSocket-verbinding omdat sturen dat nodig heeft.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base houdt het model, de instructies, tools en medium inspanning vast voor promptcaching. GPT-6 Sol draaide de zichtbare tests terwijl het werkte, maar schreef ook het merendeel van de nieuwe tests, dus die kunnen niet dienen als onafhankelijke check.
Mid-turn steering voegt een instructie toe aan een response die nog loopt, zonder die te annuleren. Na response.created stuur je response.steer op dezelfde verbinding met de ID van die response, en de server past de instructie toe in een opvolgerresponse.
De nieuwe eis kwam van het storefront-team: CheckoutClient-signatures "moeten precies blijven zoals ze nu zijn," omdat een andere service ze aanroept. Ik wilde niet dat een timer bepaalt wanneer dat binnenkomt, dus de harness kijkt in plaats daarvan naar de repository. Na elke batch toolcalls vergelijkt hij de publieke signatures op schijf met de originelen, en het eerste verschil bewapent de stuuractie:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
Dat garandeert dat de stuuractie landt nadat de hernoeming die hij tegenspreekt al is gedaan, en dat is de situatie die het waard is om te testen. Eerder verzonden is het slechts een langere prompt.
De server rapporteerde vervolgens de stuurlevenscyclus:
response.steer.accepted betekende dat de update in de wachtrij stond, niet toegepast was
response.incomplete beëindigde de oorspronkelijke response met reden steered
Een opvolgende response.created ging verder met de nieuwe eis
Als de response wacht op een toolresultaat, stuurt de server response.steer.pending en houdt de stuuractie vast tot de harness het terugstuurt. Blijf toolcalls beantwoorden terwijl een stuuractie in behandeling is.
Sturen verandert wat het model hierna doet. OpenAI's gids is duidelijk over de rest: een stuuractie herschrijft geen al verzonden output, maakt eerdere acties niet ongedaan en annuleert geen tools die al zijn gestart.
Toen de stuuractie aankwam, stond de hernoeming al op schijf in client.py. GPT-6 Sol draaide die terug, en een achtergehouden signaturecheck bevestigde later de uiteindelijke interface.
Een edit kan worden teruggedraaid. Een tool die al een extern systeem had aangeroepen zou niets te herstellen achterlaten, dus leg de repositorytoestand vast wanneer elke stuuractie arriveert.
In deze repository wel, al niet in één keer. De eerste migratie voldeed aan het oorspronkelijke contract, daarna legde de deploymentprobe een ontbrekend geval bloot.
Toen GPT-6 Sol meldde dat de migratie klaar was, haalde de achtergehouden suite het zonder reparatieronde. Voor refunds verving GPT-6 Sol de optelling door een cumulatieve read die ook out-of-order webhooks negeert:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Voor idempotency behield GPT-6 Sol een nieuw order_id per poging en voegde het een requestcache toe in de orderstore die herhaalde verzoeken beantwoordt voordat ze v2 bereiken. Die cache leeft in het geheugenvan het proces, wat zo dadelijk relevant is.
Ja. Het eerste rapport noemde een bijgewerkte webhooktest een regressie en liet het risico van retries over servers weg, hoewel het plan die valkuil had genoemd.
Structured Outputs valideert het schema, niet die beweringen. Check rapportvelden tegen vastgelegd bewijs, en beschouw een lege risicolijst niet als bewijs dat er geen risico meer is.
De suite miste een retry die naar een andere appinstantie werd gerouteerd. Ik voegde een deploymentprobe toe met twee clients die één betaalprocessor delen maar niet elkaars procesgeheugen.
De probe faalde. De retry op de tweede instantie gooide payments_adapter_v2.IdempotencyConflict, een adapter-exceptie die de storefront nooit mocht zien.
Alleen een deployment met meer dan één proces legt deze fout bloot, wat de redeneerverhoging triggert.
Een configuration_update-inputitem verandert de redeneerinspanning voor de volgende response en alle daaropvolgende, tot een volgende update. Inspanning op request-niveau blijft staan, dus de gecachte prefix overleeft. Toen de probe faalde, stuurde de harness dit verzoek, volgens de redeneergids:
De migratieverzoeken gebruiken store=True, dus nadat de WebSocket sluit kan de harness de opgeslagen responsetrain vervolgen met een gewone Responses API-call.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol ontvangt de mislukking en de deploymentvorm, maar geen hint over de fix. DIAGNOSE_TOOLS staat lezen en testen toe, geen edits. Door tools en text.format gelijk te houden blijft de gecachte prefix behouden.
Eén API-detail is onhandig: response.reasoning.effort meldt nog steeds de instelling op request-niveau na een update. De harness kan de actieve inspanning niet uit de response teruglezen, dus registreert zelf de waarde bij het sturen van de update en tagt elke latere response ermee.
high inspanning?Ja. GPT-6 Sol herleidde de fout naar de lokale store van de tweede server en volgde daarna het nieuwe order-ID naar de betaalmetadata. De gedeelde processor zag verschillende parameters voor dezelfde request_id.
De fix maakte het order-ID een functie van de request-ID, zodat elke server dezelfde berekent:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol voegde ook een zichtbare test toe voor het geval. De probe en de acceptatiesuite slaagden, daarna bracht een configuration_update de inspanning terug naar medium. Het eindrapport beschreef de echte mislukking dit keer nauwkeurig.
De Streamlit-app van het project speelt de opgeslagen run af zonder API-calls te doen. De video gaat van het overzicht naar de stuurgebeurtenissen en daarna de resultaten van acceptatie en probe.
Learn withi DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min