
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
De race om frontier-modellen heeft een patroon gekregen waarin de interessante verschillen minder gaan over ruwe capaciteiten en meer over wat je ervoor betaalt.
Claude Fable 5.1 zit op $10 input en $50 output per miljoen tokens, en de praktische vraag voor de meeste teams is of die premie iets oplevert wat een goedkoper model niet kan.
SpaceXAI bracht op 21 september 2026 Grok 4.7 uit en positioneert het als het meest capabele model voor coderen en kenniswerk.
Het draait voor $2 per miljoen inputtokens en $6 per miljoen outputtokens, ongewijzigd ten opzichte van Grok 4.6, en noteert 46,3% op CursorBench 4.0 voor langlopende coderingstaken, net achter Fable 5.1.
In dit artikel behandel ik alles wat nieuw is in Grok 4.7: de nieuwe features, hoe het scoort tegenover GPT-5.6 Sol en Fable 5.1, en welke toegangsmogelijkheden er zijn.
Voor meer over het concurrentielandschap, zie onze vergelijking van Claude Fable 5.1 en GPT-6 Astra en onze kijk op Claude Opus 5 vs GPT-5.6 Sol. Ik raad ook aan om TypeSafe's Jev te lezen.
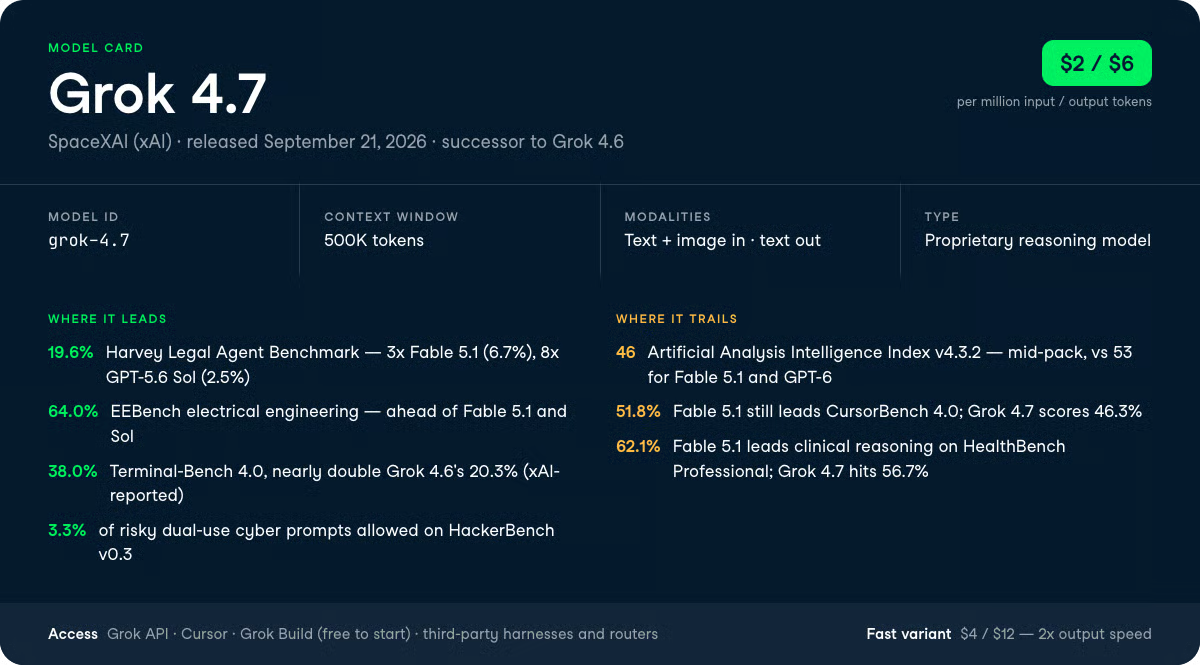
Grok 4.7 is SpaceXAI's vlaggenschipmodel voor coderen en kenniswerk, uitgebracht op 21 september 2026 als opvolger van Grok 4.6.
Het gebruikt een nieuw, groter basismodel en is getraind met een langere reinforcement learning-run op een zwaardere mix van taken, met nadruk op problemen die vele uren duren. SpaceXAI trainde het om langer aan moeilijke taken te werken en zijn eigen werk zorgvuldiger te controleren.
De generatie-sprong ten opzichte van Grok 4.6 komt vooral naar voren bij langlopende taken. Op Terminal-Bench 4.0, dat meeruurse terminaltaken meet, verdubbelt Grok 4.7 bijna zijn voorganger op SpaceXAI's interne harness, van 20,3% naar 38,0%. CursorBench 4.0 gaat van 40,4% naar 46,3%, en de AA Briefcase v1.1 office-work-score stijgt van 1.546 naar 1.657.
De kop die voor praktijkgebruikers telt, is de Harvey Legal Agent Benchmark, waar Grok 4.7 19,6% noteert. Dat is meer dan 7x GPT-5.6 Sol's 2,5% en bijna 3x Fable 5.1's 6,7%—een kloof groot genoeg om juridisch georiënteerd agentwerk een echte reden te maken om voor dit model te kiezen boven de duurdere frontier-opties.
De verbeteringen van Grok 4.7 clusteren rond drie dingen: doorwerken aan lange taken, professionele documentcreatie en een nieuwe safeguard-stack.
Dit is wat je er daadwerkelijk mee kunt doen.
Grok 4.7 is specifiek getraind op problemen die uren in plaats van minuten duren, dus het houdt beter stand bij long-horizon coderen en terminalwerk.
In de praktijk betekent dat dat het een samenhangende lijn kan vasthouden door een meerstaps debugsessie of een lange migratie zonder halverwege de draad kwijt te raken.
Het model beheert langere context en controleert zijn eigen output zorgvuldiger dan Grok 4.6 deed.
Als je een model ooit vol vertrouwen een taak hebt zien afronden terwijl de helft van de tests faalde, dan is dit het gebied waarop SpaceXAI mikt.
Grok 4.7 is beter in het produceren van de soort deliverables die professionals daadwerkelijk opleveren: rapporten, memo's en slidedecks.
SpaceXAI benchmarkt dit op GDPval en AA Briefcase, die het model taken geven die normaal door juristen, verpleegkundigen en financieel analisten worden gedaan.
Voor een datateam is dit belangrijk als je wil dat een model een analyse omzet in een geschreven samenvatting of een presentatie voor stakeholders, in plaats van alleen ruwe output terug te geven.
Grok 4.7 verbetert ten opzichte van Grok 4.6 op beide benchmarks en presteert vergelijkbaar met andere frontier-modellen, dus documentgeneratie is niet langer een reden om een premie voor Fable te betalen.
SpaceXAI heeft Grok 4.7 getraind om het Grok Bot-harnas native te begrijpen, waardoor het sterker is in conversationele taken en algemeen kenniswerk.
Als je een chat-achtige assistent bouwt bovenop de Grok API, gedraagt het model zich voorspelbaarder binnen die conversatielus.
Dit is een smallere feature dan de codeerwinsten, maar het geeft aan dat SpaceXAI conversationele inzet als volwaardige use case ziet, in plaats van een bijzaak die op een codeermodel is geschroefd.
Grok 4.7 wordt geleverd met een volledig nieuwe safeguard-stack en SpaceXAI noemt het het sterkste model dat het heeft getest op weigeringen en jailbreak-resistentie.
Het interessante voor praktijkgebruikers is dat het dit doet zonder legitiem werk overdreven te weigeren.
Op HackerBench v0.3, SpaceXAI's benchmark voor riskante en kwaadaardige cyberopdrachten, laat Grok 4.7 slechts 3,3% van risicovolle dual-use prompts door, terwijl het zelden legitiem securitywerk blokkeert.
Het staat ook bovenaan LatchBio's biosafety-benchmark met 62,4%.
De aanpak van Grok 4.7 is om onschuldige van gevaarlijke gevallen te onderscheiden in plaats van het hele domein te weigeren.
Kijk je naar onafhankelijke aggregaten, dan eindigt Grok 4.7 solide in de middenmoot.
Op de Artificial Analysis Intelligence Index v4.3.2, die tien benchmarks combineert, scoort Grok 4.7 een 46.
Dat plaatst het duidelijk achter de huidige koplopers, Claude Fable 5.1 en GPT-6, die beide een 53 scoren. Uiteindelijk is Grok 4.7 een leider in prijs-prestatie, geen onbetwiste leider in absolute capaciteit.
Het verslaat GPT-5.6 Sol op de meeste codeer- en kennisbenchmarks, terwijl het minder dan een derde van Sol's outputprijs rekent, maar Fable 5.1 blijft het net voor op absolute codeerscores.
De ene benchmark waar Grok 4.7 iedereen ruimschoots aanvoert, is juridisch agentwerk.
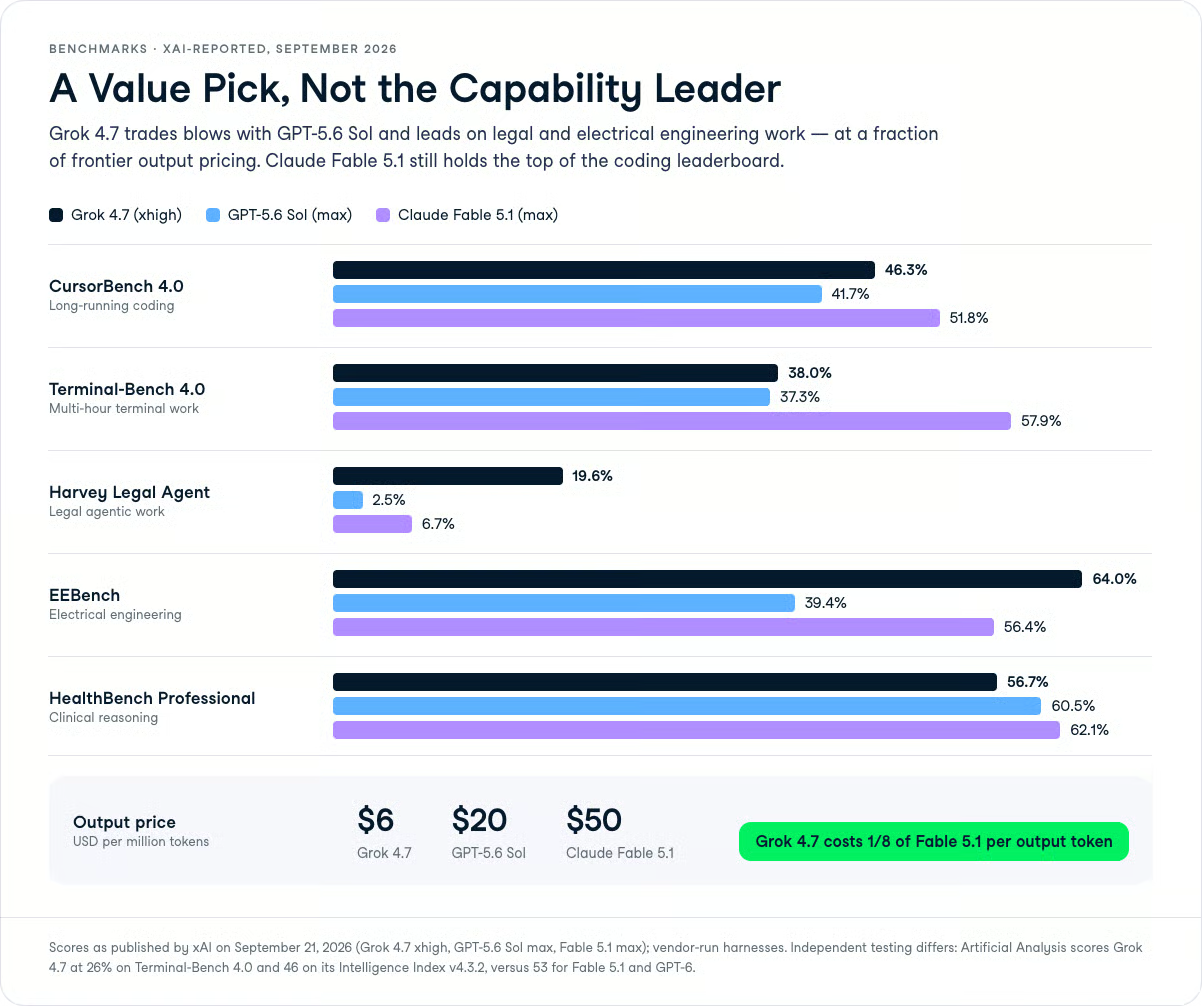
Op CursorBench 4.0, dat langerlopende coderingstaken belast, scoort Grok 4.7 46,3%. Dat is beter dan GPT-5.6 Sol's 41,7% en zijn eigen voorganger's 40,4%, al leidt Fable 5.1 met 51,8%. Op DeepSWE v1.1 noteert Grok 4.7 71,0% bij high effort, dicht bij Sol's 72,7% en Fable 5.1's 70,0%.
Voor terminal-agentwerk is er een opvallende discrepantie. Terwijl SpaceXAI's interne harness laat zien dat Grok 4.7 naar 38,0% springt op Terminal-Bench 4.0, meet Artificial Analysis Grok 4.7 op slechts 26% op dezelfde benchmark. Dit plaatst het ver achter GPT-6 Astra (60%) en Claude Fable 5.1 (55%), en zelfs net achter de goedkopere DeepSeek V4.1 Flash (27%). Als terminal-agentwerk je kernworkload is, winnen de frontier-modellen nog steeds overtuigend op ruwe capaciteit.
De conclusie: op coderen wisselt Grok 4.7 klappen uit met GPT-5.6 Sol voor een fractie van de kosten, maar Fable 5.1 blijft de keuze als je absolute topposities op het leaderboard nodig hebt.
Grok 4.7 voert alle genoemde concurrenten aan op juridisch werk.
Zijn 19,6% op de Harvey Legal Agent Benchmark torent boven GPT-5.6 Sol's 2,5% en Fable 5.1's 6,7% uit, en verbetert op Grok 4.6's 15,8%. Als je workflow juridisch documentanalyse of contractreview raakt, is dit gat moeilijk te negeren.
Op meeruurse kantoortaken gemeten door AA Briefcase v1.1 scoort Grok 4.7 1.657, waarmee het voor GPT-5.6 Sol (1.487) ligt en net achter Fable 5.1 (1.678).
Voor klinische redenering op HealthBench Professional haalt Grok 4.7 56,7%, achter Sol's 60,5% en Fable 5.1's 62,1% maar boven zijn eigen voorganger's 48,5%.
Op elektrotechnische taken gemeten door EEBench noteert Grok 4.7 een sterke 64,0%, een sprong voorbij zijn voorganger (53,0%), Fable 5.1 (56,4%) en GPT-5.6 Sol (39,4%).
Alles bij elkaar is het patroon consistent; Grok 4.7 presteert zeer goed op gespecialiseerde professionele benchmarks (juridisch, elektrotechniek) en evenaart of verslaat Sol op algemeen coderen, terwijl Fable 5.1 de top van het pure codeer-leaderboard vasthoudt. Voor een model op $2/$6 is dat een sterke positie.
Grok 4.7 wordt geleverd in effort-varianten en een snelle variant, dus de keuze komt neer op hoeveel je wil uitgeven aan latency en denkdiepte.
De standaardaanbeveling is de standaardvariant voor $2/$6. De snelle variant levert output met dubbele snelheid voor de dubbele prijs, dus die heeft alleen zin wanneer responstijd direct je product beïnvloedt.
SpaceXAI's gepubliceerde benchmarks gebruiken de xhigh-effortinstelling voor Grok 4.7, met de kanttekening dat de DeepSWE v1.1-score van 71,0% een high-effortresultaat is.
Meer effort betekent dat het model langer werkt en meer outputtokens besteedt aan verificatie—daar betaalt de training op meeruurse taken zich uit, maar daar groeit ook je rekening.
| Use case | Variant | Waarom |
|---|---|---|
| Pijplijnen voor coderen met hoog volume | Standard xhigh | Beste prijs-prestatie; outputkosten domineren dus vermijd de fast-premie |
| Juridische of elektrotechnische agents | Standard xhigh | Hier liggen Grok 4.7's benchmarkvoorsprongen; effort helpt verificatie |
| Latentiegevoelige chatproducten | Fast variant | 2x outputsnelheid telt wanneer gebruikers op reacties wachten |
| Batchgewijze document- en slidegeneratie | Standard | Geen latentie-eis, dus de goedkopere laag wint |
Grok 4.7 kost vanaf $2 per miljoen inputtokens en $6 per miljoen outputtokens, ongewijzigd ten opzichte van Grok 4.6.
SpaceXAI levert ook een snelle variant met dubbele outputsnelheid voor de dubbele prijs, dus $4 input en $12 output.
Dat basistarief is een achtste van wat Claude Fable 5.1 rekent voor output ($10 input en $50 output per miljoen tokens). Meta's Muse Spark 1.3 stable-tier onderbiedt Grok op input met $1,25 maar zit dicht bij op output met $4,25, terwijl Meta's Contributor-tier op $0,10/$0,20 veel goedkoper is in ruil voor het toestaan dat Meta traint op je prompts.
Grok 4.7 is per vandaag algemeen beschikbaar.
Er is geen gratis API-laag, maar je kunt het kosteloos uitproberen via Grok Build.
Artificial Analysis vermeldt dat Grok 4.7 een context window van 500.000 tokens heeft, al wordt dit opmerkelijk genoeg niet genoemd in SpaceXAI's launchpost. Dit is een terugkerend hiaat in Grok-documentatie vergeleken met de ~1M-tokenvensters die concurrenten zoals Muse Spark publiceren.
Grok 4.7 is een propriëtair model dat via meerdere kanalen bereikbaar is:
Om het via de API aan te roepen, gebruik je de model-ID als exacte string in je request. Hier is een minimaal voorbeeld met de OpenAI-compatibele client gericht op het SpaceXAI-endpoint:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_XAI_KEY",
    base_url="https://api.x.ai/v1",
)
response = client.chat.completions.create(
    model="grok-4.7",
    messages=[{"role": "user", "content": "Refactor this SQL query for readability..."}],
)
print(response.choices[0].message.content)Grok 4.7 is SpaceXAI dat duidelijk op waarde inzet in een markt waar Fable erop gokt dat frontier-capaciteit $50 per miljoen output rechtvaardigt. Dit lijkt op wat we zagen bij de recente golf aan Flash-modellen (zie onze vergelijking van DeepSeek V4.1 Flash vs Gemini 3.8 Flash).
Door de $2/$6-tarieven van Grok 4.6 vast te houden en frontier-achtige scores neer te zetten, concurreert SpaceXAI op kosten-per-resultaat in plaats van op leaderboardpositie.
Ik zou overstappen voor grootschalig coderen, juridisch agentwerk of elektrotechnische taken, waar de benchmarkvoorsprong en lage prijs samenkomen.
Als je de absolute top van het codeer-leaderboard nodig hebt, wint Fable 5.1 nog steeds, en Grok's magere documentatie over het contextvenster blijft een ergernis.
Wil je praktisch aan de slag met het bouwen van agentische workflows op modellen als deze, dan raad ik onze AI Agent Fundamentals skill track aan om eerst de basis te leggen.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

