
Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
10.5K
Persaingan model frontier kini mengikuti pola di mana perbedaan menarik bukan lagi soal kemampuan mentah, melainkan soal apa yang Anda bayarkan untuk itu.
Claude Fable 5.1 dipatok $10 untuk input dan $50 untuk output per satu juta token, dan pertanyaan praktis bagi sebagian besar tim adalah apakah premi tersebut benar-benar memberi sesuatu yang tidak bisa ditandingi model yang lebih murah.
SpaceXAI merilis Grok 4.7 pada 21 September 2026, memposisikannya sebagai model paling mumpuni untuk pengodean dan pekerjaan berbasis pengetahuan.
Harganya $2 per satu juta token input dan $6 per satu juta token output, tidak berubah dari Grok 4.6, dan mencatat 46,3% pada CursorBench 4.0 untuk tugas pengodean jangka panjang, sedikit di belakang Fable 5.1.
Dalam artikel ini, saya akan membahas semua hal baru di Grok 4.7: fitur-fitur barunya, hasil tolok ukur dibandingkan GPT-5.6 Sol dan Fable 5.1, serta opsi aksesnya.
Untuk melihat lanskap persaingan, baca juga perbandingan Claude Fable 5.1 dan GPT-6 Astra serta ulasan kami tentang Claude Opus 5 vs GPT-5.6 Sol. Saya juga menyarankan membaca tentang Jev dari TypeSafe.
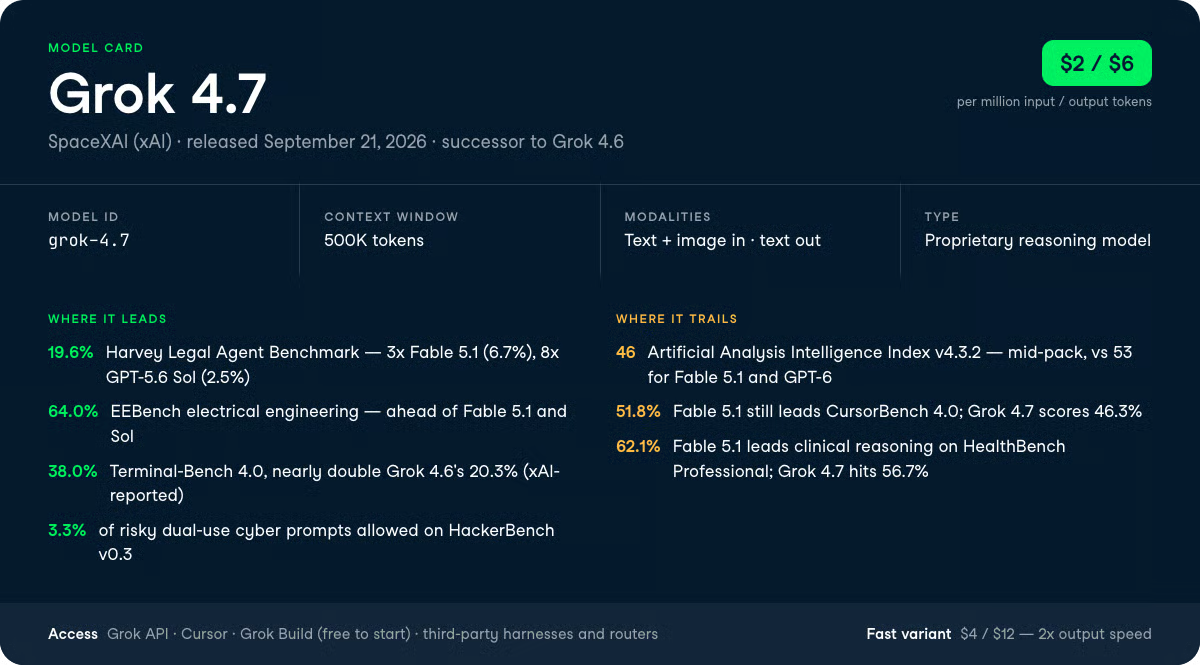
Grok 4.7 adalah model andalan SpaceXAI untuk pengodean dan pekerjaan berbasis pengetahuan, dirilis 21 September 2026 sebagai penerus Grok 4.6.
Model ini menggunakan model dasar baru yang lebih besar dan dilatih dengan sesi reinforcement learning yang lebih panjang pada campuran tugas yang lebih sulit, diberi bobot pada masalah yang memakan waktu berjam-jam untuk diselesaikan. SpaceXAI melatihnya untuk bekerja lebih lama pada tugas-tugas sulit dan memeriksa hasil kerjanya sendiri dengan lebih cermat.
Lompatan generasi atas Grok 4.6 paling terlihat pada pekerjaan jangka panjang. Pada Terminal-Bench 4.0, yang mengukur tugas terminal multi-jam, Grok 4.7 hampir menggandakan pendahulunya pada harness internal SpaceXAI, dari 20,3% menjadi 38,0%. CursorBench 4.0 naik dari 40,4% menjadi 46,3%, dan skor AA Briefcase v1.1 untuk kerja perkantoran naik dari 1.546 menjadi 1.657.
Judul yang paling penting bagi praktisi adalah Harvey Legal Agent Benchmark, di mana Grok 4.7 mencatat 19,6%. Itu lebih dari 7x GPT-5.6 Sol yang 2,5% dan hampir 3x Fable 5.1 yang 6,7%, selisih yang cukup lebar sehingga pekerjaan agen terkait hukum menjadi alasan nyata untuk memilih model ini dibanding opsi frontier yang lebih mahal.
Peningkatan Grok 4.7 berfokus pada tiga hal: ketahanan pada tugas panjang, pembuatan dokumen profesional, dan tumpukan pengaman baru.
Berikut yang benar-benar bisa Anda lakukan dengannya.
Grok 4.7 dilatih khusus pada masalah yang memakan waktu berjam-jam, bukan menit, sehingga lebih tangguh pada pengodean berjangka panjang dan pekerjaan terminal.
Dalam praktiknya, ini berarti ia dapat menjaga alur yang koheren sepanjang sesi debugging multi-langkah atau migrasi panjang tanpa kehilangan arah di tengah jalan.
Model ini mengelola konteks yang lebih panjang dan memverifikasi keluarannya sendiri dengan lebih cermat dibanding Grok 4.6.
Jika Anda pernah mengalami model yang dengan yakin menyatakan tugas selesai sementara separuh pengujian masih gagal, inilah area yang dibidik SpaceXAI.
Grok 4.7 lebih baik dalam menghasilkan deliverable yang benar-benar diserahkan profesional: laporan, memo ringkas, dan set slide.
SpaceXAI mengukur ini pada GDPval dan AA Briefcase, yang menugaskan model dengan pekerjaan yang biasa dilakukan pengacara, perawat, dan analis keuangan.
Bagi tim data, ini penting saat Anda ingin model mengubah analisis menjadi ringkasan tertulis atau presentasi siap pemangku kepentingan alih-alih hanya mengembalikan keluaran mentah.
Grok 4.7 membaik dibanding Grok 4.6 pada kedua tolok ukur dan tampil sebanding dengan model frontier lain, sehingga pembuatan dokumen bukan lagi alasan membayar premi untuk Fable.
SpaceXAI melatih Grok 4.7 untuk secara native memahami harness Grok Bot, yang membuatnya lebih kuat pada tugas percakapan dan pekerjaan pengetahuan umum.
Jika Anda membangun asisten bergaya chat di atas API Grok, model ini berperilaku lebih prediktif di dalam loop percakapan tersebut.
Ini fitur yang lebih sempit dibanding peningkatan pengodean, tetapi menandakan SpaceXAI memperlakukan penerapan percakapan sebagai kasus penggunaan kelas satu, bukan tempelan di atas model pengodean.
Grok 4.7 hadir dengan tumpukan pengaman yang sepenuhnya baru, dan SpaceXAI menyebutnya sebagai model terkuat yang pernah mereka uji dalam hal penolakan dan ketahanan terhadap jailbreak.
Bagian menarik bagi praktisi adalah ia melakukannya tanpa terlalu sering menolak pekerjaan yang sah.
Pada HackerBench v0.3, tolok ukur SpaceXAI untuk tugas siber berisiko dan berbahaya, Grok 4.7 hanya mengizinkan 3,3% prompt dual-use berisiko lolos sambil jarang memblokir pekerjaan keamanan yang sah.
Model ini juga memimpin tolok ukur biosafety dari LatchBio pada 62,4%.
Pendekatan Grok 4.7 adalah membedakan yang jinak dari yang berbahaya alih-alih menolak seluruh domain.
Melihat agregat independen, Grok 4.7 berada solid di tengah kelompok.
Pada Artificial Analysis Intelligence Index v4.3.2, yang menggabungkan sepuluh tolok ukur, Grok 4.7 mencetak 46.
Ini menempatkannya cukup jauh di belakang para pemimpin saat ini, Claude Fable 5.1 dan GPT-6, yang keduanya mencetak 53. Pada akhirnya, Grok 4.7 adalah pemimpin harga-performa, bukan pemimpin kemampuan mutlak.
Model ini mengalahkan GPT-5.6 Sol pada sebagian besar tolok ukur pengodean dan pengetahuan sambil mengenakan biaya kurang dari sepertiga harga output Sol, tetapi Fable 5.1 masih unggul pada skor pengodean absolut.
Satu tolok ukur di mana Grok 4.7 memimpin semua pesaing dengan margin lebar adalah pekerjaan agen hukum.
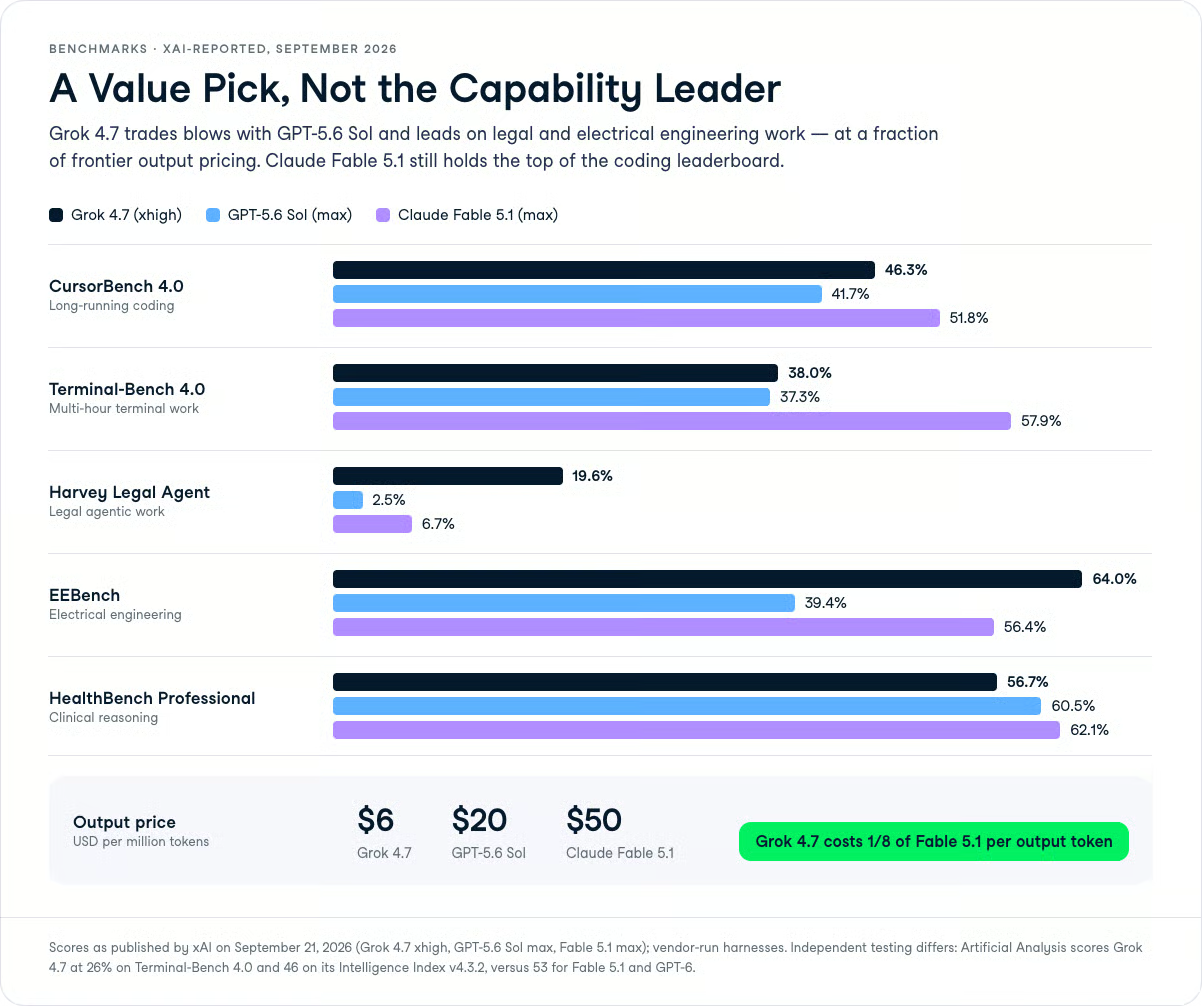
Pada CursorBench 4.0, yang menekankan tugas pengodean jangka panjang, Grok 4.7 mencetak 46,3%. Itu mengalahkan GPT-5.6 Sol yang 41,7% dan pendahulunya sendiri yang 40,4%, meski Fable 5.1 memimpin di 51,8%. Pada DeepSWE v1.1, Grok 4.7 mencatat 71,0% pada upaya tinggi, mendekati Sol yang 72,7% dan Fable 5.1 yang 70,0%.
Untuk pekerjaan agen terminal, ada perbedaan mencolok. Sementara harness internal SpaceXAI menunjukkan Grok 4.7 melonjak ke 38,0% pada Terminal-Bench 4.0, Artificial Analysis mengukur Grok 4.7 hanya 26% pada tolok ukur yang sama. Ini menempatkannya jauh di belakang GPT-6 Astra (60%) dan Claude Fable 5.1 (55%), bahkan sedikit di belakang DeepSeek V4.1 Flash yang lebih murah (27%). Jika pekerjaan agen terminal adalah beban kerja inti Anda, model frontier masih menang telak pada kemampuan mentah.
Intinya: pada pengodean, Grok 4.7 saling beradu dengan GPT-5.6 Sol dengan biaya yang jauh lebih kecil, tetapi Fable 5.1 tetap pilihan jika Anda membutuhkan posisi teratas di papan peringkat.
Grok 4.7 memimpin semua pesaing yang tercantum pada pekerjaan hukum.
Skornya 19,6% pada Harvey Legal Agent Benchmark jauh di atas GPT-5.6 Sol yang 2,5% dan Fable 5.1 yang 6,7%, dan meningkat dari Grok 4.6 yang 15,8%. Jika alur kerja Anda menyentuh analisis dokumen hukum atau telaah kontrak, selisih ini sulit diabaikan.
Pada pekerjaan perkantoran multi-jam yang diukur AA Briefcase v1.1, Grok 4.7 mencetak 1.657, menempatkannya di depan GPT-5.6 Sol (1.487) dan tepat di belakang Fable 5.1 (1.678).
Untuk penalaran klinis pada HealthBench Professional, Grok 4.7 mencapai 56,7%, tertinggal dari Sol yang 60,5% dan Fable 5.1 yang 62,1% namun mengalahkan pendahulunya sendiri yang 48,5%.
Pada tugas teknik elektro yang diukur EEBench, Grok 4.7 mencatat 64,0% yang kuat, melompat melewati pendahulunya (53,0%), Fable 5.1 (56,4%), dan GPT-5.6 Sol (39,4%).
Secara keseluruhan, polanya konsisten; Grok 4.7 tampil sangat baik pada tolok ukur profesional khusus (hukum, teknik elektro) dan menyamai atau mengalahkan Sol pada pengodean umum, sementara Fable 5.1 memegang puncak papan peringkat pengodean murni. Untuk model seharga $2/$6, itu posisi yang kuat.
Grok 4.7 hadir dalam varian effort dan varian cepat, jadi pilihan bergantung pada seberapa banyak Anda bersedia membayar untuk latensi dan kedalaman penalaran.
Rekomendasi default adalah varian standar di $2/$6. Varian cepat menyajikan output dua kali lebih cepat dengan harga dua kali lipat, jadi hanya masuk akal ketika latensi respons berdampak langsung pada produk Anda.
Tolok ukur yang dipublikasikan SpaceXAI menggunakan pengaturan xhigh effort untuk Grok 4.7, dengan catatan bahwa skor DeepSWE v1.1 sebesar 71,0% adalah hasil upaya tinggi.
Effort yang lebih tinggi berarti model bekerja lebih lama dan menghabiskan lebih banyak token output untuk verifikasi, di sinilah pelatihan tugas multi-jam membuahkan hasil, namun juga di sinilah tagihan Anda bertambah.
| Kasus penggunaan | Varian | Alasan |
|---|---|---|
| Pipa pengodean volume tinggi | Standard xhigh | Harga-performa terbaik; biaya output mendominasi jadi hindari premi fast |
| Agen hukum atau teknik elektro | Standard xhigh | Di sinilah keunggulan tolok ukur Grok 4.7; effort membantu verifikasi |
| Produk chat sensitif terhadap latensi | Varian fast | Kecepatan output 2x penting saat pengguna menunggu respons |
| Pembuatan dokumen dan slide batch | Standard | Tidak ada kendala latensi, jadi tier yang lebih murah menang |
Grok 4.7 dihargai mulai $2 per satu juta token input dan $6 per satu juta token output, tidak berubah dari Grok 4.6.
SpaceXAI juga menyediakan varian cepat dengan kecepatan output dua kali lipat pada harga dua kali lipat, jadi $4 untuk input dan $12 untuk output.
Tarif dasar tersebut adalah seperdelapan dari biaya output Claude Fable 5.1 ($10 input dan $50 output per satu juta token). Tier stable Meta Muse Spark 1.3 menyalip Grok pada input di $1,25 tetapi mendekati pada output di $4,25, sementara tier Contributor Meta di $0,10/$0,20 jauh lebih murah dengan imbalan mengizinkan Meta melatih dari prompt Anda.
Grok 4.7 tersedia secara umum mulai hari ini.
Tidak ada tier API gratis, tetapi Anda dapat mencobanya tanpa biaya melalui Grok Build.
Artificial Analysis mencantumkan Grok 4.7 memiliki jendela konteks 500.000 token, meski ini tidak disebutkan dalam posting peluncuran SpaceXAI. Ini adalah celah berulang dalam dokumentasi Grok dibanding jendela ~1M token yang dipublikasikan kompetitor seperti Muse Spark.
Grok 4.7 adalah model proprietari yang dapat diakses melalui beberapa permukaan:
Untuk memanggilnya dari API, gunakan ID model sebagai string persis dalam permintaan Anda. Berikut contoh minimal menggunakan klien yang kompatibel dengan OpenAI yang diarahkan ke endpoint SpaceXAI:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_XAI_KEY",
    base_url="https://api.x.ai/v1",
)
response = client.chat.completions.create(
    model="grok-4.7",
    messages=[{"role": "user", "content": "Refactor this SQL query for readability..."}],
)
print(response.choices[0].message.content)Grok 4.7 menunjukkan langkah nilai yang jelas dari SpaceXAI di pasar di mana Fable bertaruh bahwa kemampuan frontier membenarkan harga $50 per satu juta output. Ini mirip dengan gelombang model Flash terbaru (lihat perbandingan kami DeepSeek V4.1 Flash vs Gemini 3.8 Flash).
Dengan mempertahankan tarif $2/$6 dari Grok 4.6 sambil mencatat skor setara frontier, SpaceXAI bersaing pada biaya-per-hasil alih-alih posisi papan peringkat.
Saya akan beralih ke model ini untuk pengodean volume tinggi, pekerjaan agen hukum, atau tugas teknik elektro, di mana keunggulan tolok ukurnya dan harganya yang rendah bertemu.
Jika Anda butuh puncak papan peringkat pengodean absolut, Fable 5.1 masih menang, dan dokumentasi jendela konteks Grok yang tipis tetap mengganggu.
Jika Anda ingin langsung membangun alur kerja agen pada model seperti ini, saya merekomendasikan skill track AI Agent Fundamentals kami untuk membangun fondasinya terlebih dahulu.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



