
Last chance! 50% off DataCamp Premium
Sale ends in
फ्रंटियर मॉडल की दौड़ अब उस पैटर्न में स्थिर हो गई है जहाँ दिलचस्प अंतर कच्ची क्षमता से कम और कीमत के बदले मिलने वाली वैल्यू से ज्यादा तय हो रहे हैं।
Claude Fable 5.1 प्रति मिलियन टोकन $10 इनपुट और $50 आउटपुट पर आता है, और ज्यादातर टीमों के लिए व्यावहारिक सवाल यह होता है कि क्या वह प्रीमियम ऐसी कोई चीज देता है जो सस्ते मॉडल नहीं दे पाते।
SpaceXAI ने 21 सितंबर, 2026 को Grok 4.7 जारी किया, इसे कोडिंग और नॉलेज वर्क के लिए अपना सबसे सक्षम मॉडल बताया।
यह प्रति मिलियन इनपुट टोकन $2 और आउटपुट टोकन $6 पर चलता है, जो Grok 4.6 जैसा ही है, और लंबे समय तक चलने वाले कोडिंग कार्यों के लिए CursorBench 4.0 पर 46.3% स्कोर करता है, जो Fable 5.1 से थोड़ा पीछे है।
इस लेख में, मैं Grok 4.7 की नई विशेषताओं, GPT-5.6 Sol और Fable 5.1 के मुकाबले इसके बेंचमार्क्स, और एक्सेस विकल्पों पर चर्चा करूँगा।
प्रतिस्पर्धी परिदृश्य पर अधिक जानकारी के लिए, हमारा Claude Fable 5.1 और GPT-6 Astra का तुलना लेख और Claude Opus 5 बनाम GPT-5.6 Sol देखें। मैं TypeSafe के Jev के बारे में पढ़ने की भी सलाह देता हूँ।
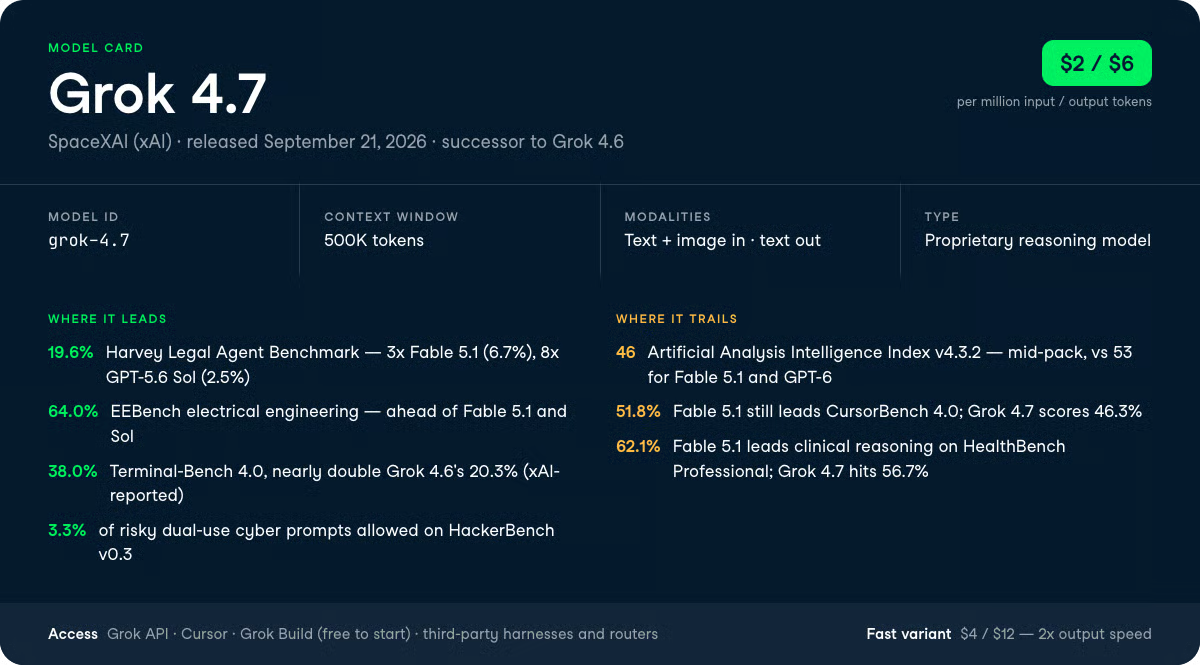
Grok 4.7 कोडिंग और नॉलेज वर्क के लिए SpaceXAI का फ्लैगशिप मॉडल है, जिसे 21 सितंबर, 2026 को Grok 4.6 के उत्तराधिकारी के रूप में जारी किया गया।
यह नया, बड़ा बेस मॉडल उपयोग करता है और इसे कठिन टास्क्स के मिश्रण पर लंबे रिइनफोर्समेंट लर्निंग रन के साथ प्रशिक्षित किया गया है, जिनका वजन उन समस्याओं की ओर था जिन्हें पूरा करने में कई घंटे लगते हैं। SpaceXAI ने इसे कठिन कार्यों पर अधिक देर तक काम करने और अपने कार्य की अधिक सावधानी से जाँच करने के लिए प्रशिक्षित किया।
Grok 4.6 पर पीढ़ीगत उछाल सबसे अधिक लंबे समय तक चलने वाले कार्यों में दिखता है। Terminal-Bench 4.0 पर, जो मल्टी-ऑवर टर्मिनल टास्क्स को मापता है, SpaceXAI के इंटरनल हार्नेस में Grok 4.7 अपने पूर्ववर्ती को लगभग दोगुना करते हुए 20.3% से 38.0% पर पहुँचता है। CursorBench 4.0 40.4% से 46.3% तक जाता है, और AA Briefcase v1.1 ऑफिस-वर्क स्कोर 1,546 से 1,657 तक बढ़ता है।
व्यावहारिक रूप से सबसे महत्वपूर्ण सुर्खी Harvey Legal Agent Benchmark है, जहाँ Grok 4.7 19.6% स्कोर करता है। यह GPT-5.6 Sol के 2.5% से 7 गुना से अधिक और Fable 5.1 के 6.7% से लगभग 3 गुना है—इतना बड़ा अंतर कि कानूनी-सम्बंधित एजेंटिक वर्क इस मॉडल को महंगे फ्रंटियर विकल्पों पर चुनने का ठोस कारण बन जाता है।
Grok 4.7 के सुधार तीन बातों के इर्द-गिर्द केंद्रित हैं: लंबे कार्यों पर सतत काम, प्रोफ़ेशनल डॉक्यूमेंट निर्माण, और नया सेफगार्ड स्टैक।
देखें, आप इनके साथ व्यावहारिक रूप से क्या कर सकते हैं।
Grok 4.7 को खासतौर पर उन समस्याओं पर प्रशिक्षित किया गया है जिन्हें मिनटों की बजाय घंटों की जरूरत होती है, इसलिए यह लंबी-अवधि के कोडिंग और टर्मिनल कार्य में बेहतर टिका रहता है।
व्यवहार में, इसका मतलब है कि यह मल्टी-स्टेप डिबगिंग सेशन या लंबी माइग्रेशन के दौरान बिना बीच में धागा खोए एक सुसंगत लाइन बनाए रख सकता है।
मॉडल लंबा कॉन्टेक्स्ट संभालता है और अपने आउटपुट को Grok 4.6 की तुलना में अधिक सावधानी से सत्यापित करता है।
यदि आपने किसी मॉडल को आत्मविश्वास से कार्य पूरा घोषित करते देखा है जबकि आधे टेस्ट असफल रह गए हों, तो SpaceXAI का लक्ष्य यही क्षेत्र है।
Grok 4.7 उन डिलिवरेबल्स को बेहतर बनाता है जो पेशेवर वास्तव में सौंपते हैं: रिपोर्ट्स, ब्रीफ्स, और स्लाइड डेक्स।
SpaceXAI इसे GDPval और AA Briefcase पर बेंचमार्क करता है, जो मॉडल को वकीलों, नर्सों और फाइनेंशियल एनालिस्ट्स द्वारा किए जाने वाले काम से जोड़ते हैं।
डेटा टीम के लिए, यह तब मायने रखता है जब आप चाहते हैं कि मॉडल विश्लेषण को सिर्फ कच्चे आउटपुट लौटाने की बजाय एक लिखित सारांश या स्टेकहोल्डर-तैयार प्रस्तुति में बदल दे।
Grok 4.7 दोनों बेंचमार्क्स पर Grok 4.6 से बेहतर है और अन्य फ्रंटियर मॉडलों के तुलनीय प्रदर्शन करता है, इसलिए डॉक्यूमेंट जेनरेशन अब Fable के लिए प्रीमियम चुकाने का कारण नहीं रहा।
SpaceXAI ने Grok 4.7 को Grok Bot हार्नेस को नैटिव रूप से समझने के लिए प्रशिक्षित किया, जिससे यह वार्तालाप-सम्बंधी कार्यों और सामान्य नॉलेज वर्क पर मजबूत हो जाता है।
यदि आप Grok API पर चैट-स्टाइल असिस्टेंट बना रहे हैं, तो मॉडल उस संवादात्मक लूप के भीतर अधिक अनुमानित व्यवहार करता है।
यह फीचर कोडिंग लाभों की तुलना में संकरा है, लेकिन यह संकेत देता है कि SpaceXAI ने वार्तालाप-आधारित डिप्लॉयमेंट को बाद में जोड़ा गया विचार नहीं, बल्कि प्रथम-स्तरीय उपयोग केस माना है।
Grok 4.7 पूरी तरह नए सेफगार्ड स्टैक के साथ आता है, और SpaceXAI इसे रिफ्यूज़ल्स और जेलब्रेक प्रतिरोध पर अपने द्वारा परीक्षण किए गए सबसे मजबूत मॉडल के रूप में बताता है।
व्यावहारिक रूप से दिलचस्प बात यह है कि यह वैध कार्यों को अधिक मात्रा में अस्वीकार किए बिना ऐसा करता है।
HackerBench v0.3 पर, जो जोखिमपूर्ण और दुर्भावनापूर्ण साइबर टास्क्स के लिए SpaceXAI का बेंचमार्क है, Grok 4.7 केवल 3.3% जोखिमपूर्ण द्वि-उपयोग प्रॉम्प्ट्स को अनुमति देता है, जबकि वैध सुरक्षा कार्य को शायद ही कभी ब्लॉक करता है।
यह LatchBio के बायोसafety बेंचमार्क में भी 62.4% के साथ शीर्ष पर है।
Grok 4.7 का दृष्टिकोण पूरे डोमेन को अस्वीकार करने की बजाय हानिरहित और खतरनाक के बीच फर्क करना है।
स्वतंत्र एग्रीगेट्स को देखें, तो Grok 4.7 मजबूती से मिड-पैक में आता है।
Artificial Analysis Intelligence Index v4.3.2 पर, जो दस बेंचमार्क्स को जोड़ता है, Grok 4.7 का स्कोर 46 है।
यह मौजूदा लीडर्स Claude Fable 5.1 और GPT-6 (दोनों 53) से काफी पीछे रखता है। अंततः, Grok 4.7 सीधी क्षमता का लीडर नहीं, बल्कि प्राइस-परफॉर्मेंस का लीडर है।
यह ज्यादातर कोडिंग और नॉलेज बेंचमार्क्स पर GPT-5.6 Sol को मात देता है, जबकि Sol के आउटपुट प्राइस के एक-तिहाई से भी कम चार्ज करता है, लेकिन एब्सोल्यूट कोडिंग स्कोर्स में Fable 5.1 अब भी थोड़ा आगे है।
एक बेंचमार्क जहाँ Grok 4.7 सभी से बहुत आगे है, वह है लीगल एजेंट वर्क।
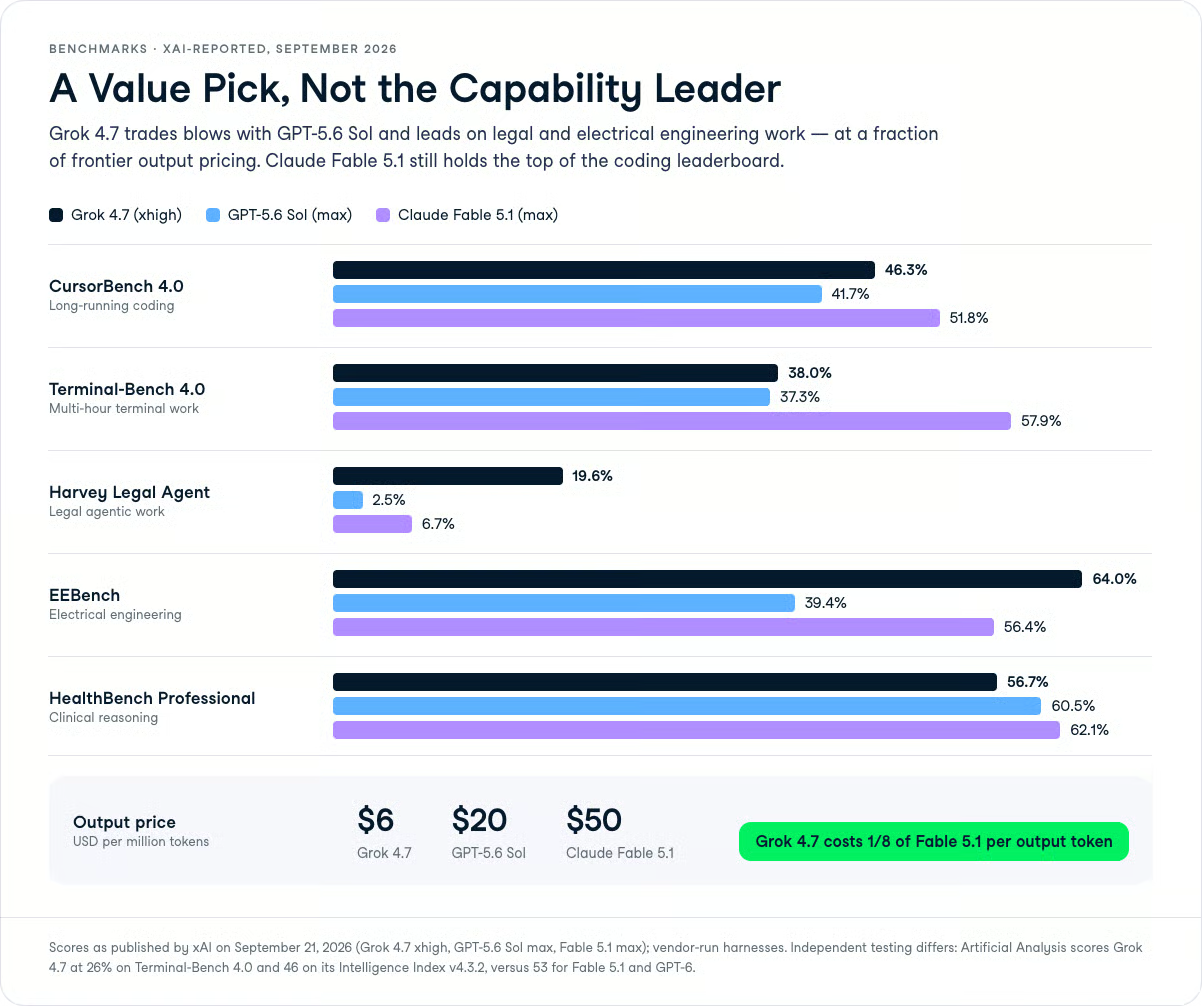
CursorBench 4.0 पर, जो लंबे समय तक चलने वाले कोडिंग कार्यों को तनाव देता है, Grok 4.7 46.3% स्कोर करता है। यह GPT-5.6 Sol के 41.7% और अपने पूर्ववर्ती के 40.4% से बेहतर है, हालाँकि Fable 5.1 51.8% के साथ आगे है। DeepSWE v1.1 पर, Grok 4.7 हाई-एफ़र्ट पर 71.0% पोस्ट करता है, जो Sol के 72.7% और Fable 5.1 के 70.0% के करीब है।
टर्मिनल एजेंट वर्क के लिए, एक उल्लेखनीय असंगति है। जहाँ SpaceXAI के इंटरनल हार्नेस में Grok 4.7 Terminal-Bench 4.0 पर 38.0% तक उछलता दिखता है, वहीं Artificial Analysis Grok 4.7 को इसी बेंचमार्क पर केवल 26% मापता है। यह इसे GPT-6 Astra (60%) और Claude Fable 5.1 (55%) से काफी पीछे रखता है, और सस्ते DeepSeek V4.1 Flash (27%) से भी थोड़ा पीछे। यदि टर्मिनल एजेंट वर्क आपका कोर वर्कलोड है, तो कच्ची क्षमता में फ्रंटियर मॉडल अब भी निर्णायक रूप से जीतते हैं।
निष्कर्ष: कोडिंग पर, Grok 4.7 लागत के एक अंश पर GPT-5.6 Sol से टक्कर लेता है, लेकिन यदि आपको लीडरबोर्ड के शीर्ष पर पहुँचना है, तो Fable 5.1 अब भी बेहतर पसंद है।
कानूनी कार्यों पर Grok 4.7 सूचीबद्ध सभी प्रतिस्पर्धियों से आगे है।
Harvey Legal Agent Benchmark पर इसका 19.6% स्कोर GPT-5.6 Sol के 2.5% और Fable 5.1 के 6.7% से बहुत ऊपर है, और Grok 4.6 के 15.8% पर सुधार करता है। यदि आपका वर्कफ़्लो कानूनी डॉक्यूमेंट विश्लेषण या कॉन्ट्रैक्ट रिव्यू छूता है, तो इस अंतर को नजरअंदाज करना कठिन है।
AA Briefcase v1.1 द्वारा मापे गए मल्टी-ऑवर ऑफिस वर्क पर, Grok 4.7 का स्कोर 1,657 है, जो GPT-5.6 Sol (1,487) से आगे और Fable 5.1 (1,678) से बस थोड़ा पीछे बैठता है।
HealthBench Professional पर क्लिनिकल रीजनिंग के लिए, Grok 4.7 56.7% तक पहुँचता है, Sol के 60.5% और Fable 5.1 के 62.1% से पीछे, लेकिन अपने पूर्ववर्ती के 48.5% से बेहतर।
EEBench द्वारा मापे गए इलेक्ट्रिकल इंजीनियरिंग कार्यों पर, Grok 4.7 मजबूत 64.0% पोस्ट करता है, अपने पूर्ववर्ती (53.0%), Fable 5.1 (56.4%), और GPT-5.6 Sol (39.4%) को पीछे छोड़ते हुए।
समग्र रूप से, पैटर्न सुसंगत है; Grok 4.7 विशेषज्ञ प्रोफ़ेशनल बेंचमार्क्स (कानूनी, इलेक्ट्रिकल इंजीनियरिंग) पर बहुत अच्छा प्रदर्शन करता है और सामान्य कोडिंग पर Sol से मेल खाता या आगे निकलता है, जबकि Fable 5.1 शुद्ध-कोडिंग लीडरबोर्ड के शीर्ष पर है। $2/$6 पर यह एक मजबूत स्थिति है।
Grok 4.7 इफ़र्ट वेरिएंट्स और एक फास्ट वेरिएंट में आता है, इसलिए चुनाव इस पर निर्भर करता है कि आप लेटेंसी और रीजनिंग डेप्थ पर कितना खर्च करना चाहते हैं।
डिफ़ॉल्ट सिफारिश $2/$6 वाला स्टैंडर्ड वेरिएंट है। फास्ट वेरिएंट दोगुनी गति से आउटपुट सर्व करता है, बदले में दोगुनी कीमत पर, इसलिए यह तभी समझ आता है जब रिस्पॉन्स लेटेंसी आपके प्रोडक्ट को सीधे प्रभावित करती हो।
SpaceXAI के प्रकाशित बेंचमार्क्स Grok 4.7 के लिए xhigh इफ़र्ट सेटिंग उपयोग करते हैं, यह नोट करते हुए कि DeepSWE v1.1 पर 71.0% एक हाई-इफ़र्ट परिणाम है।
उच्च इफ़र्ट का मतलब है कि मॉडल अधिक देर तक काम करता है और वेरिफिकेशन पर अधिक आउटपुट टोकन खर्च करता है—यही वह जगह है जहाँ मल्टी-ऑवर टास्क ट्रेनिंग का लाभ मिलता है, पर आपका बिल भी बढ़ता है।
| उपयोग मामला | वेरिएंट | क्यों |
|---|---|---|
| हाई-वॉल्यूम कोडिंग पाइपलाइंस | स्टैंडर्ड xhigh | सर्वश्रेष्ठ प्राइस-परफॉर्मेंस; आउटपुट लागत हावी रहती है, इसलिए फास्ट प्रीमियम से बचें |
| कानूनी या इलेक्ट्रिकल इंजीनियरिंग एजेंट्स | स्टैंडर्ड xhigh | यहीं Grok 4.7 के बेंचमार्क लीड्स हैं; इफ़र्ट वेरिफिकेशन में मदद करता है |
| लेटेंसी-संवेदनशील चैट प्रोडक्ट्स | फास्ट वेरिएंट | जब उपयोगकर्ता प्रतिक्रियाओं की प्रतीक्षा कर रहे हों, तो 2x आउटपुट गति मायने रखती है |
| बैच डॉक्यूमेंट और स्लाइड जेनरेशन | स्टैंडर्ड | लेटेंसी बाधा नहीं है, इसलिए सस्ता टियर बेहतर है |
Grok 4.7 की कीमत प्रति मिलियन इनपुट टोकन $2 और प्रति मिलियन आउटपुट टोकन $6 से शुरू होती है, जो Grok 4.6 के समान है।
SpaceXAI एक फास्ट वेरिएंट भी देता है, जो दोगुनी आउटपुट गति पर दोगुनी कीमत लेता है, यानी $4 इनपुट और $12 आउटपुट।
यह बेस रेट आउटपुट पर Claude Fable 5.1 की कीमत का आठवां हिस्सा है ($10 इनपुट और $50 आउटपुट प्रति मिलियन टोकन)। Meta का Muse Spark 1.3 स्टेबल टियर इनपुट पर $1.25 में Grok से कम है लेकिन आउटपुट पर $4.25 के करीब है, जबकि Meta का Contributor टियर $0.10/$0.20 पर कहीं सस्ता है—इसके बदले Meta आपके प्रॉम्प्ट्स पर ट्रेन कर सकता है।
Grok 4.7 आज सामान्य रूप से उपलब्ध है।
फ्री API टियर नहीं है, लेकिन आप Grok Build के जरिए इसे बिना लागत के आज़मा सकते हैं।
Artificial Analysis Grok 4.7 को 500,000-टोकन कॉन्टेक्स्ट विंडो वाला सूचीबद्ध करता है, हालाँकि यह SpaceXAI की लॉन्च पोस्ट से उल्लेखनीय रूप से अनुपस्थित है। यह Grok दस्तावेज़ीकरण में बार-बार दिखने वाली कमी है, जबकि प्रतिस्पर्धी जैसे Muse Spark ~1M टोकन विंडो प्रकाशित करते हैं।
Grok 4.7 एक प्रोपाइटरी मॉडल है, जो कई सतहों के माध्यम से उपलब्ध है:
API से कॉल करने के लिए, अपने रिक्वेस्ट में मॉडल ID को बिल्कुल वही स्ट्रिंग रखें। यहाँ SpaceXAI एंडपॉइंट पर पॉइंट किए गए OpenAI-कम्पैटिबल क्लाइंट का एक मिनिमल उदाहरण है:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_XAI_KEY",
    base_url="https://api.x.ai/v1",
)
response = client.chat.completions.create(
    model="grok-4.7",
    messages=[{"role": "user", "content": "Refactor this SQL query for readability..."}],
)
print(response.choices[0].message.content)Grok 4.7 एक स्पष्ट वैल्यू प्ले है, ऐसे बाजार में जहाँ Fable यह दांव लगा रहा है कि फ्रंटियर क्षमता $50-प्रति-मिलियन आउटपुट प्राइसिंग को सही ठहराती है। यह हालिया Flash मॉडलों के रुझान जैसा ही है (देखें हमारा तुलना लेख DeepSeek V4.1 Flash बनाम Gemini 3.8 Flash).
$2/$6 की दरें बनाए रखते हुए और फ्रंटियर-एजेसेंट स्कोर्स पोस्ट करके, SpaceXAI लीडरबोर्ड पोज़िशन की बजाय प्रति-परिणाम लागत पर प्रतिस्पर्धा कर रहा है।
मैं हाई-वॉल्यूम कोडिंग, लीगल एजेंट वर्क, या इलेक्ट्रिकल इंजीनियरिंग कार्यों के लिए इस पर स्विच करूँगा, जहाँ इसके बेंचमार्क लीड्स और कम कीमत एक साथ मिलते हैं।
यदि आपको कोडिंग लीडरबोर्ड का बिल्कुल शीर्ष चाहिए, तो Fable 5.1 अब भी जीतता है, और Grok का पतला कॉन्टेक्स्ट-विंडो दस्तावेज़ीकरण अब भी खटकता है।
यदि आप ऐसे मॉडलों पर एजेंटिक वर्कफ़्लोज़ बनाकर हाथ गंदे करना चाहते हैं, तो पहले नींव बनाने के लिए हमारा AI Agent Fundamentals स्किल ट्रैक देखें।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
कोर्स
