
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
De meeste AI-aankondigingen in 2026 draaiden om een sprint naar de top in chat en redeneren, zoals te zien bij OpenAI's GPT-6 Astra, Anthropic's Fable 5.1.
TypeSafe kiest een nieuwe aanpak. Op 15 september 2026 kondigde het bedrijf een model aan dat helemaal geen tekst genereert.
Het model heet Jev en valt in een nieuwe categorie AI-modellen die TypeSafe System One-modellen noemt.
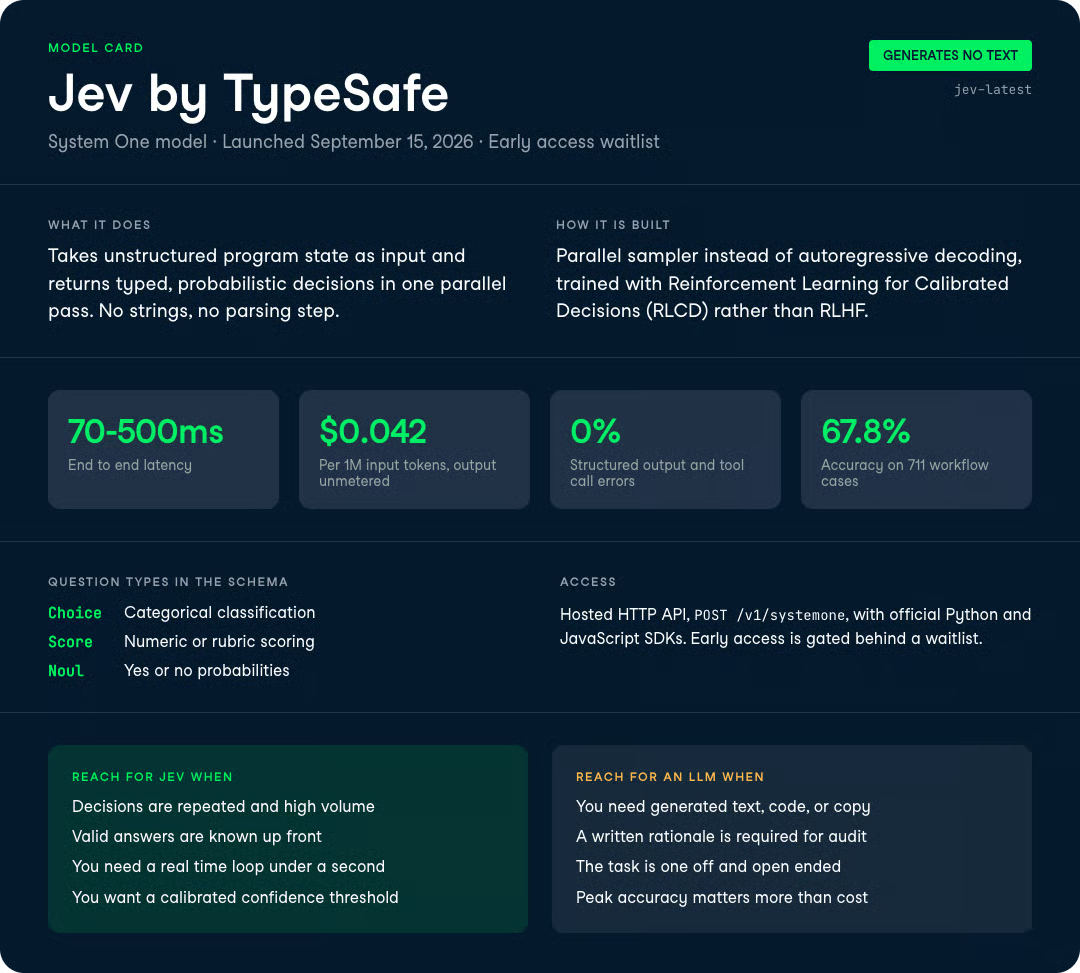
In plaats van tekenreeksen token voor token te produceren, neemt Jev ongestructureerde programmastatus als input en geeft het in één parallelle pass getypeerde, probabilistische beslissingen terug.
TypeSafe's belangrijkste claims: Jev draait 40x-200x sneller dan frontier-LLM's op vergelijkbare taken, kost $0.042 per miljoen inputtokens met gratis output, en kan wiskundig gezien niet hallucineren of typefouten produceren.
In dit artikel behandel ik wat een System One-model precies is, hoe Jev verschilt van een standaard LLM, wat de workflow-benchmarks laten zien ten opzichte van andere modellen, en waar ik het zie passen in een echte stack.
Voor meer achtergrond over de modellen waartegen Jev is afgezet, zie onze vergelijkingen Jev vs GPT-6 Astra, GPT-5.6 Terra vs Claude Sonnet 5 en Claude Opus 5 vs GPT-5.6 Sol. Ik raad ook onze gids met Jev-alternatieven en onze Jev API-tutorial aan.
Een System One-model is een frontier AI-model dat getypeerde probabilistische beslissingen teruggeeft in plaats van tekst.
Je geeft het een blok status en een set getypeerde vragen; het evalueert ze allemaal parallel en retourneert gestructureerde antwoorden met gekalibreerde vertrouwensscores, zonder stringgeneratie en zonder iets te hoeven parsen. TypeSafe muntte de categorienaam met Jev, de eerste publieke release in september 2026.
Jev is een frontier-model dat is gebouwd om snelle, gestructureerde beslissingen te nemen die software direct kan gebruiken, zonder parse- of validatiestap.
Het is de eerste publieke release in TypeSafe's System One-klasse, beschikbaar als early access sinds september 2026 en vernoemd naar econoom William Stanley Jevons.
De naam komt uit Daniel Kahnemans Ons feilbare denken (Thinking, Fast and Slow).
Kahnemans Systeem 1 is snel en intuïtief; Systeem 2 is traag en bedachtzaam.
Bestaande LLM's, met hun chain-of-thought en meer-seconden-denksporen, zitten stevig in Systeem 2-terrein.
TypeSafe-oprichter Diogo Almeida, mede-uitvinder van ChatGPT bij OpenAI, stelt dat de automatiseringskloof ontstaat doordat iedereen Systeem 2-modellen bouwt, terwijl de meeste softwarebeslissingen juist een snel Systeem 1-antwoord willen.
Architectonisch gezien wijkt Jev sterk af van een transformer-LLM.
Het gebruikt een nieuwe modelarchitectuur met een parallelle sampler die alle outputs in één query genereert in plaats van autoregressief, en een trainingsmethode die TypeSafe Reinforcement Learning for Calibrated Decisions (RLCD) noemt.
Waar GPT-5.6 en Opus 5 zijn getraind met RLHF en verifieerbare beloningen om tekst te produceren die mensen prefereren, optimaliseert RLCD voor gekalibreerde waarschijnlijkheden op gestructureerde beslissingen.
Het resultaat, volgens TypeSafe's eigen cijfers, is een gestructureerde outputfout van 0% en end-to-end-latentie van 70-500 ms.
Een detail over de RLCD-trainingsmethode: TypeSafe zet deze direct af tegen RLHF en RLVR. Waar RLHF optimaliseert voor chatantwoorden die menselijke beoordelaars prefereren en RLVR voor outputs die een programma kan verifiëren, optimaliseert RLCD voor epistemisch eerlijke waarschijnlijkheden bij besluitvormingstaken. Daarom is calibratie een first-class eigenschap van Jev en niet iets dat via prompting wordt bijgeplakt.
Hier is het kernverschil in architectuur in één tabel, omdat dat in lopende tekst makkelijk verloren gaat.
| Eigenschap | Frontier LLM (GPT-5.6, Opus 5) | Jev (System One-model) |
|---|---|---|
| Output | Gegenereerde strings, moeten geparset worden | Getypeerde waarden, schema-garantie |
| Sampling | Sequentieel, token voor token | Parallel, enkele query |
| Inputprijs / 1M tokens | $0.20-$10 | $0.042 |
| Outputprijs | ~5x input | Gratis |
| Latentie | 3-329 s | 70-500 ms |
| Hallucinatie / typefouten | Mogelijk | Onmogelijk by design |
| Vertrouwen | Overzelfverzekerd, inconsistent | Gekalibreerd per output |
Alle features volgen uit één ontwerpkeuze: Jev laat stringgeneratie volledig los.
Die weglating levert de snelheid, de prijs en de typegaranties op.
Jev retourneert type-veilige gestructureerde waarden waarvan de mogelijke outputs in je schema zijn gedefinieerd vóór de call.
De API biedt een kleine set vraagtypes:
Zie het als een frontier-intelligente functieaanroep: ongestructureerde status gaat erin, getypeerde probabilistische beslissingen komen eruit.
Als je een supportticket routeert, kun je een Choice definiëren over {billing, technical, sales, spam} en een Score voor urgentie van 0 tot 100, en Jev vult beide in één pass in. Er is geen JSON te parsen en geen risico dat het model afdwaalt en een alinea schrijft.
De voor de hand liggende kanttekening: dit werkt alleen wanneer de ruimte van geldige antwoorden begrensd en vooraf bekend is. Jev is nutteloos voor open-einde-generatie, en het schrijft het schema niet voor je.
Elke Jev-output wordt geleverd met een gekalibreerde waarschijnlijkheid, wat betekent dat hogere zekerheid daadwerkelijk correspondeert met hogere nauwkeurigheid.
Dit is volgens mij in de praktijk het meest bruikbaar.
Standaard LLM's zijn berucht overzelfverzekerd, zelfs als je ze expliciet om een waarschijnlijkheid vraagt.
Als een model iets 95% van de tijd goed kan classificeren maar je niet kan vertellen in welke 5% het onzeker is, kun je er niet veilig omheen automatiseren.
Met Jev's calibratie kun je een drempel instellen en alleen boven die waarde automatisch handelen, en onzekere gevallen naar een mens of een tragere LLM sturen.
De beperking is dat Jev je een getal geeft, geen onderbouwing.
Er is geen natuurlijke-taal-uitleg waarom het een case zo scoorde, wat uitmaakt voor debugging en audits in gereguleerde domeinen.
Omdat Jev's outputs tot het schema beperkt zijn, is het wiskundig onmogelijk om een ongeldige waarde of typefout te produceren.
TypeSafe rapporteert 0% gestructureerde outputfouten en 0% tool-call-fouten.
Ter vergelijking: op TypeSafe's test voor gestructureerde output zaten OpenAI's luna en terra op 0,58%, Anthropic's Opus 5 op 5,73%, en Claude Haiku 4.5 op 45,5%.
Bij tool-calls was GPT-5.6 Sol het slechtst met 17,0%.
Een gehallucineerde tool-call is hinderlijk in een interactieve agent, maar een echt probleem wanneer hij meerdere lagen diep in een afhankelijkheidsketen met latentiegaranties zit.
Jev genereert zijn volledige output in één parallelle query in plaats van token voor token uit te sturen.
Daar komen de 70-500 ms latenties vandaan.
Die snelheid opent use-cases waar token-voor-token LLM's niet aan toekomen.
TypeSafe's eigen demo laat Jev Doom spelen door te reageren op gestructureerde gamestatus (aangeleverd als tekst) ongeveer 10 keer per seconde, voor zo'n $7/uur aan inference.
Het punt is niet dat Jev Doom goed speelt—een gescripte bot wint—but dat het reactieve beslissingen kan nemen binnen een realtimestep waarin een LLM-call van 3-30 seconden onhaalbaar is.
Met een per-case-kost van rond $0.0004 is het haalbaar om een beslissing over elke rij van een grote dataset te laten lopen, iets wat met een frontier-LLM financieel onpraktisch is.
TypeSafe positioneert dit als het omzetten van petabytes ruwe data in features en inzichten door beslissingen erover te map-reducen.
Een concreet voorbeeld is het scoren van elke productreview in een tabel met 50 miljoen rijen op sentiment en beleidsinbreuk, wat ruwweg $20 zou kosten aan decision-calls met Jev tegen het gerapporteerde tarief, tegenover duizenden met een token-geprijsde LLM.
Kort gezegd: Jev eindigt qua nauwkeurigheid ongeveer waar mid-tier frontier-LLM's zitten, terwijl het alles op kosten en latentie met één tot twee ordes van grootte verslaat.
Alle onderstaande cijfers komen uit TypeSafe's eigen evaluatietabellen, en er is nog geen grootschalige onafhankelijke reproductie, dus beschouw ze als leverancierscijfers.
TypeSafe bouwde een aangepaste evaluatie over 4 workflows (respons op beveiligingsincidenten, agent-trace-observability, factuurverwerking en klantenservice), waarbij elk model werd gescoord tegen de gemiddelde voorspellingen van GPT-6 Astra en Anthropic's Fable.
Jev haalt gemiddeld 67,8% overeenstemming met de referentie-antwoorden.
Zo verhoudt dat zich tot de frontier-LLM's op dezelfde workflows:
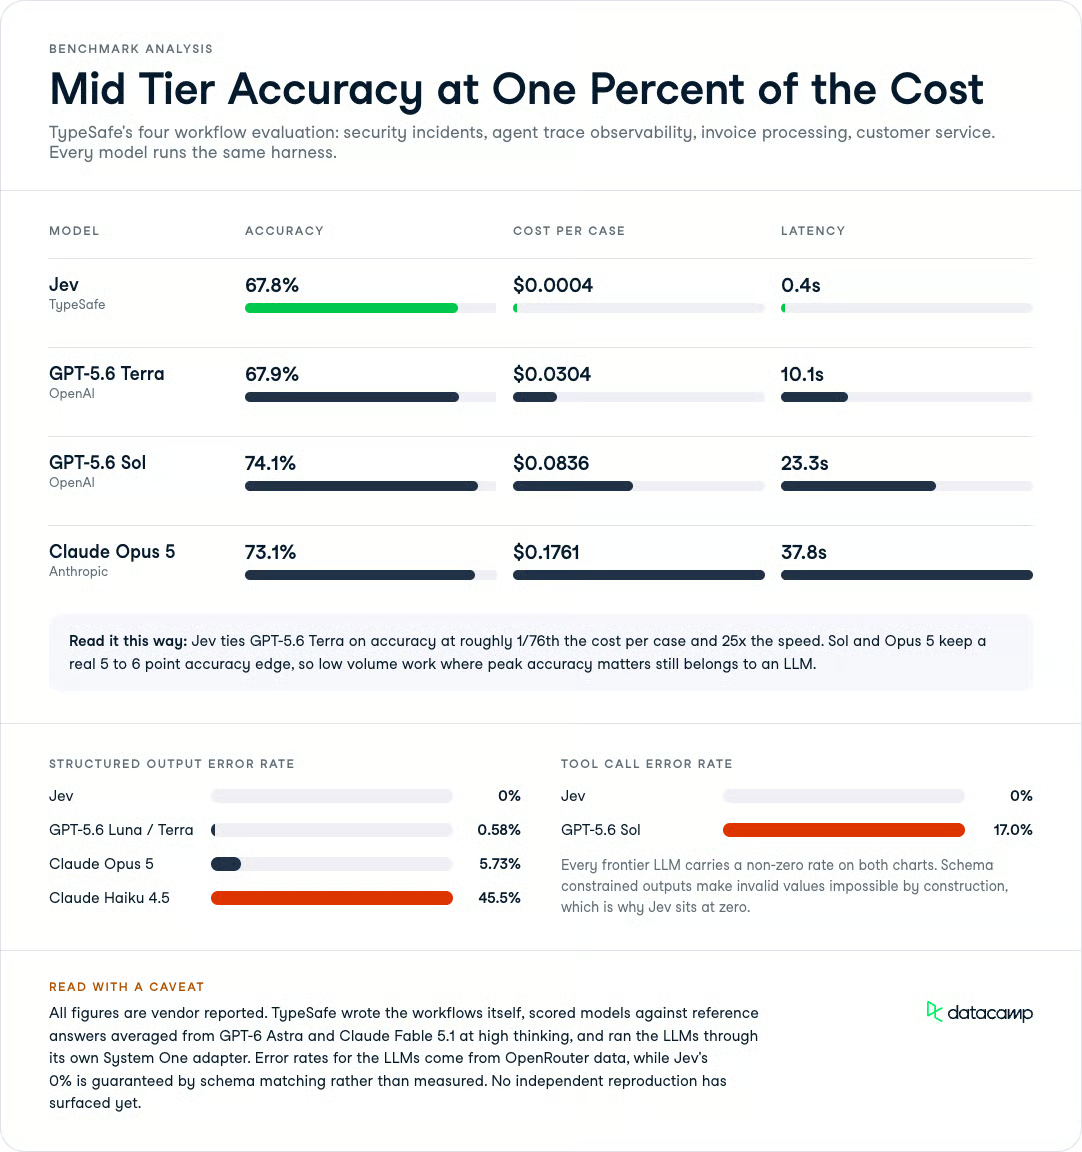
Het patroon is consistent: Jev ruilt een paar punten nauwkeurigheid ten opzichte van de allerbeste modellen in voor enorme kosten- en latentievoordelen.
| Model | Nauwkeurigheid | Kost per case | Latentie |
|---|---|---|---|
| Jev (TypeSafe) | 67,8% | $0.0004 | 0,4 s |
| GPT-5.6 Terra | 67,9% | $0.0304 | 10,1 s |
| GPT-5.6 Sol | 74,1% | $0.0836 | 23,3 s |
| Claude Opus 5 | 73,1% | $0.1761 | 37,8 s |
Jev staat feitelijk gelijk met Terra qua nauwkeurigheid, maar kost ongeveer 1/76e per case en draait 25x sneller.
De topmodellen qua nauwkeurigheid, Sol met 74,1% en Opus 5 met 73,1%, houden een echte voorsprong van 5-6 punten. Als maximale nauwkeurigheid is wat je nodig hebt bij een low-volume taak, wint de LLM nog steeds.
Op de betrouwbaarheidskaarten staat Jev op 0% fout voor zowel gestructureerde output als tool-calls, wat precies het punt is van het schema-beperkte ontwerp.
De frontier-LLM's hebben hier allemaal een niet-nul faalpercentage.
Twee cijfers springen eruit. Claude Haiku 4.5 noteert 45,5% fout voor gestructureerde output, en GPT-5.6 Sol 17,0% fout voor tool-calls.
Dat zijn geen obscure randgevallen; het zijn de soorten fouten die een onbewaakte pipeline meteen breken zodra die op volume draait.
Jev retourneert waarschijnlijkheden maar geen natuurlijke-taal-rationale, wat beoordelaars aanmerken als een echte beperking voor debugging en audits in gereguleerde domeinen.
Als een compliance-team moet weten waarom een leningaanvraag zo is gescoord, voldoet een kale zekerheidswaarde niet.
De praktische oplossing is om Jev te reserveren voor de high-volume routeringslaag en gemarkeerde of laag-zekere gevallen door te zetten naar een model dat een geschreven uitleg kan geven.
Zo behoud je de throughput-voordelen en hou je een auditrail waar dat wettelijk vereist is.
TypeSafe is prijzenswaardig open over de bias in de eigen evaluaties.
De workflows zijn geschreven door het eigen modelcapabiliteitenteam, dus enige bias kan bestaan, en de referentie-antwoorden komen van OpenAI- en Anthropic-modellen, wat Jev's relatieve prestaties en die van DeepSeek's modellen waarschijnlijk onderschat.
De LLM's in deze tests draaien via TypeSafe's open-source System One-adapter, die ze dwingt om gestructureerde beslissingen te geven die compatibel zijn met de API.
TypeSafe zegt dat dit de meest accurate manier is om beslissingen uit een LLM te halen, al is het trager en duurder dan het model zonder waarschijnlijkheden te laten antwoorden.
Totdat een onafhankelijke suite dit reproduceert op een neutraal testharnas, zou ik de nauwkeurigheidspariteit zien als veelbelovend, niet als beslecht.
Jev concurreert niet met GPT-5.6 of Opus 5 voor dezelfde klussen, dus de nuttige vraag is voor welke klasse model je moet kiezen.
Het komt neer op of je taak een begrensde beslissing of een open einde-antwoord nodig heeft.
| Use-case | Kies | Waarom |
|---|---|---|
| Classificeren of routeren van miljoenen tickets | Jev | Begrensde outputs, kosten en throughput domineren |
| LLM-outputs op schaal scoren of guardrailen | Jev | Snelle ja/nee-waarschijnlijkheden, geen hallucinatie-risico |
| Realtime beslissingen binnen een app-loop | Jev | 70-500 ms latentie vs 3-30 s voor een LLM |
| Code, e-mails of samenvattingen schrijven | Frontier-LLM | Jev genereert helemaal geen tekst |
| Eenmalige multi-step redenering met uitleg | Frontier-LLM | Vraagt om een rationale en open-einde-output |
In de praktijk vullen de twee elkaar goed aan: gebruik Jev als snelle beslissingslaag die classificeert, scoort en routeert, en geef de kleine slice lastige of open-einde-gevallen door aan een model zoals Terra of Opus 5. Jev's calibratie maakt die overdracht netjes, omdat je op een zekerheidsdrempel kunt routeren.
Bij Jev's prijsstelling wordt de pitch agressief.
Inputtokens kosten $0.042 per miljoen ($42 per miljard), en outputtokens zijn ongemeten. TypeSafe beschrijft ze als te goedkoop om te meten, omdat het model gestructureerde beslissingen teruggeeft in plaats van lange tekst.
Ter vergelijking: dat inputtarief is ongeveer 1/48e van GPT-5.6 Terra's $2.00 per miljoen inputtokens, en Terra rekent daarbovenop $12.00 per miljoen outputtokens.
Op workflow-niveau zet TypeSafe's interne evaluatie Jev op zo'n $0.0004 per case tegenover $0.0304 voor Terra en $0.0836 voor Sol.
TypeSafe is open dat het niet kan bewijzen dat de prijs niet gesubsidieerd is, en zegt dat de lange termijn de houdbaarheid moet aantonen, al verwacht het dat prijzen dalen in plaats van stijgen.
Jev is sinds 15 september 2026 in early access, achter een wachtlijst waar ontwikkelaars geleidelijk van worden afgehaald. Ik zag geen expliciet programma met gratis tegoed of proef in het launchmateriaal.
Jev is een propriëtair, gehost model dat bereikbaar is via TypeSafe's HTTP API. Echter, om toegang te krijgen, moet je je aanmelden voor de wachtlijst en de community volgen op de TypeSafe AI Blog.
Het endpoint is POST https://api.typesafe.ai/v1/systemone, en de early-access-modelroute wordt aangeduid als jev-latest.
TypeSafe biedt officiële SDK's voor Python en JavaScript naast de ruwe HTTP API.
Je definieert je vraagtypes (Choice, Score, Noul) in het schema en geeft je programmastatus door als input; de respons komt terug als getypeerde waarden met gekalibreerde waarschijnlijkheden.
Hier is de minimale vorm van een request tegen de serverless-route:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())
Voor de volledige schemareferentie en SDK-setup zijn TypeSafe's eigen docs de bron van waarheid.
TypeSafe gokt strategisch dat veel van wat mensen LLM's nu laten doen, in feite gestructureerde besluitvorming is, verpakt als chat.
Als dat klopt, veranderen Jev's 40-400x kostenvoordeel en 0% typefoutgarantie de economie van high-volume automatisering op een manier die GPT-5.6 en Opus 5 qua prijs niet kunnen evenaren.
Mijn eerlijke indruk: Jev lijkt oprecht nuttig als snelle beslis- en guardraillaag, en de calibratie is het onderdeel waar ik echt omheen zou bouwen.
Open vragen zijn of een onafhankelijke benchmark de nauwkeurigheidspariteit bevestigt en of de prijs standhoudt zodra de subsidie wegvalt.
Wil je de besluitproblemen begrijpen waar Jev voor is gebouwd, dan behandelt onze AI Fundamentals-skill track de classificatie- en calibratieconcepten eronder.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

