
Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.5K
La corsa ai modelli di frontiera si è stabilizzata su uno schema in cui le differenze interessanti riguardano meno la pura capacità e più ciò che paghi per ottenerla.
Claude Fable 5.1 costa $10 in input e $50 in output per milione di token, e la domanda pratica per la maggior parte dei team è se quel sovrapprezzo offra davvero qualcosa che un modello più economico non possa eguagliare.
SpaceXAI ha rilasciato Grok 4.7 il 21 settembre 2026, presentandolo come il suo modello più capace per coding e knowledge work.
Ha un costo di $2 per milione di token in input e $6 per milione di token in output, invariato rispetto a Grok 4.6, e registra il 46,3% su CursorBench 4.0 per attività di coding di lunga durata, leggermente dietro Fable 5.1.
In questo articolo, ti racconto tutte le novità di Grok 4.7: le nuove funzionalità, i benchmark a confronto con GPT-5.6 Sol e Fable 5.1, e le opzioni di accesso.
Per un quadro più ampio della concorrenza, vedi il nostro confronto tra Claude Fable 5.1 e GPT-6 Astra e il nostro approfondimento su Claude Opus 5 vs GPT-5.6 Sol. Consiglio anche di leggere Jev di TypeSafe.
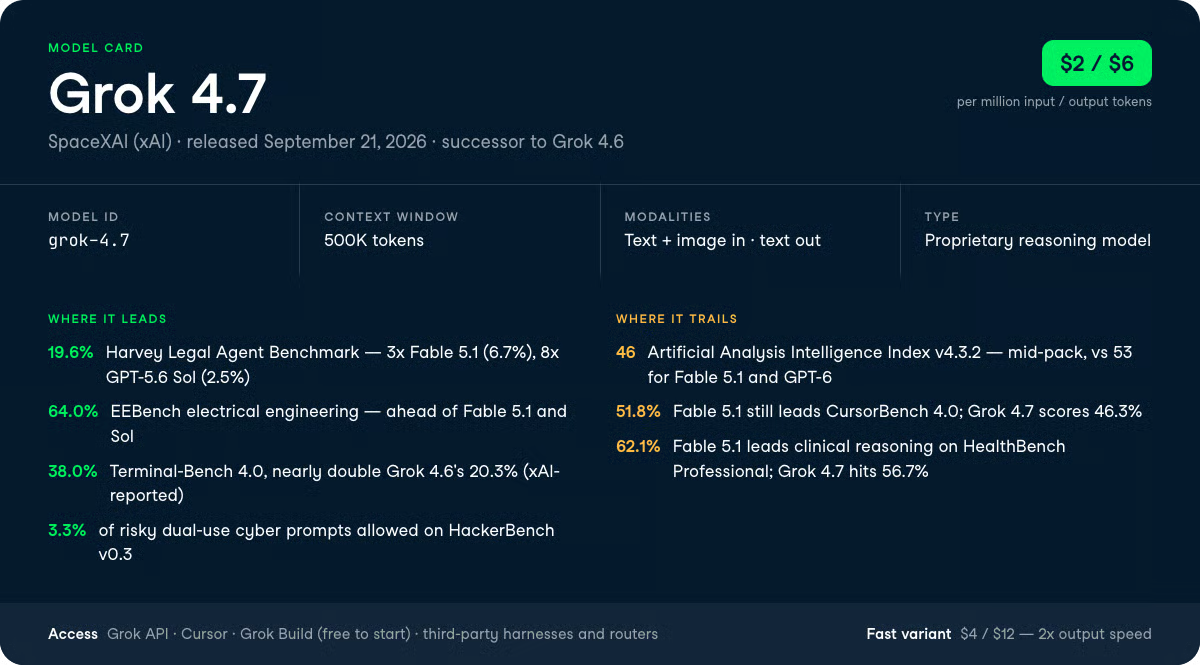
Grok 4.7 è il modello di punta di SpaceXAI per coding e knowledge work, rilasciato il 21 settembre 2026, successore di Grok 4.6.
Usa un nuovo modello di base più grande ed è stato addestrato con un ciclo di reinforcement learning più lungo su un mix di task più impegnativi, pesato verso problemi che richiedono molte ore per essere completati. SpaceXAI l'ha addestrato a lavorare più a lungo su compiti difficili e a controllare il proprio lavoro con maggiore attenzione.
Il salto generazionale rispetto a Grok 4.6 emerge soprattutto sul lavoro di lunga durata. Su Terminal-Bench 4.0, che misura task su terminale di più ore, Grok 4.7 quasi raddoppia il suo predecessore sul framework interno di SpaceXAI, passando dal 20,3% al 38,0%. CursorBench 4.0 sale dal 40,4% al 46,3% e il punteggio AA Briefcase v1.1 per l'office-work cresce da 1.546 a 1.657.
Il titolo che conta per i professionisti è l'Harvey Legal Agent Benchmark, dove Grok 4.7 registra il 19,6%. È più di 7 volte il 2,5% di GPT-5.6 Sol e quasi 3 volte il 6,7% di Fable 5.1, un divario abbastanza ampio da rendere il lavoro agentico in ambito legale un motivo concreto per scegliere questo modello rispetto alle opzioni di frontiera più costose.
I miglioramenti di Grok 4.7 si concentrano su tre aree: lavoro sostenuto su task lunghi, creazione di documenti professionali e un nuovo stack di salvaguardie.
Ecco cosa puoi farci davvero.
Grok 4.7 è stato addestrato specificamente su problemi che richiedono ore, non minuti, quindi regge meglio su coding e lavoro da terminale a lungo raggio.
In pratica, significa che riesce a mantenere un filo coerente attraverso una sessione di debug a più step o una migrazione lunga senza perdere il senso a metà strada.
Il modello gestisce contesti più estesi e verifica il proprio output con più attenzione rispetto a Grok 4.6.
Se ti è capitato che un modello dichiarasse con sicurezza un task completato lasciando però metà dei test falliti, è proprio quest'area che SpaceXAI sta affrontando.
Grok 4.7 è più bravo a produrre i deliverable che i professionisti consegnano davvero: report, memorie e presentazioni.
SpaceXAI lo valuta su GDPval e AA Briefcase, che assegnano al modello lavori tipicamente svolti da avvocati, infermieri e analisti finanziari.
Per un team data, questo conta quando vuoi che un modello trasformi un'analisi in un riassunto scritto o in una presentazione pronta per gli stakeholder, invece di restituire solo output grezzi.
Grok 4.7 migliora rispetto a Grok 4.6 su entrambi i benchmark e si comporta in modo paragonabile ad altri modelli di frontiera, quindi la generazione di documenti non è più un motivo per pagare il premium di Fable.
SpaceXAI ha addestrato Grok 4.7 a comprendere nativamente l'harness del Grok Bot, il che lo rende più solido nei task conversazionali e nel knowledge work generico.
Se stai costruendo un assistente in stile chat sull'API di Grok, il modello si comporta in modo più prevedibile all'interno di quel loop conversazionale.
È una funzione più ristretta rispetto ai guadagni sul coding, ma segnala che SpaceXAI considera la distribuzione conversazionale un caso d'uso di prima classe e non un ripensamento aggiunto a un modello di coding.
Grok 4.7 include un intero nuovo stack di salvaguardie e SpaceXAI lo definisce il suo modello più forte nei rifiuti appropriati e nella resistenza ai jailbreak.
La parte interessante per i professionisti è che lo fa senza rifiutare in eccesso il lavoro legittimo.
Su HackerBench v0.3, il benchmark di SpaceXAI per task cyber rischiosi e malevoli, Grok 4.7 lascia passare solo il 3,3% dei prompt a duplice uso rischiosi, bloccando raramente il lavoro di sicurezza legittimo.
Guida anche il benchmark di biosicurezza di LatchBio con il 62,4%.
L'approccio di Grok 4.7 è distinguere il benigno dal pericoloso invece di rifiutare l'intero dominio.
Guardando agli aggregati indipendenti, Grok 4.7 si piazza solidamente a metà classifica.
Sull'Artificial Analysis Intelligence Index v4.3.2, che combina dieci benchmark, Grok 4.7 ottiene 46.
Questo lo colloca ben dietro gli attuali leader, Claude Fable 5.1 e GPT-6, entrambi a 53. In definitiva, Grok 4.7 è un leader nel rapporto prezzo-prestazioni più che nella capacità assoluta.
Supera GPT-5.6 Sol nella maggior parte dei benchmark di coding e conoscenza pur costando meno di un terzo del prezzo di output di Sol, ma Fable 5.1 lo supera ancora sui punteggi di coding puro.
Il benchmark in cui Grok 4.7 è nettamente davanti a tutti è il lavoro agentico legale.
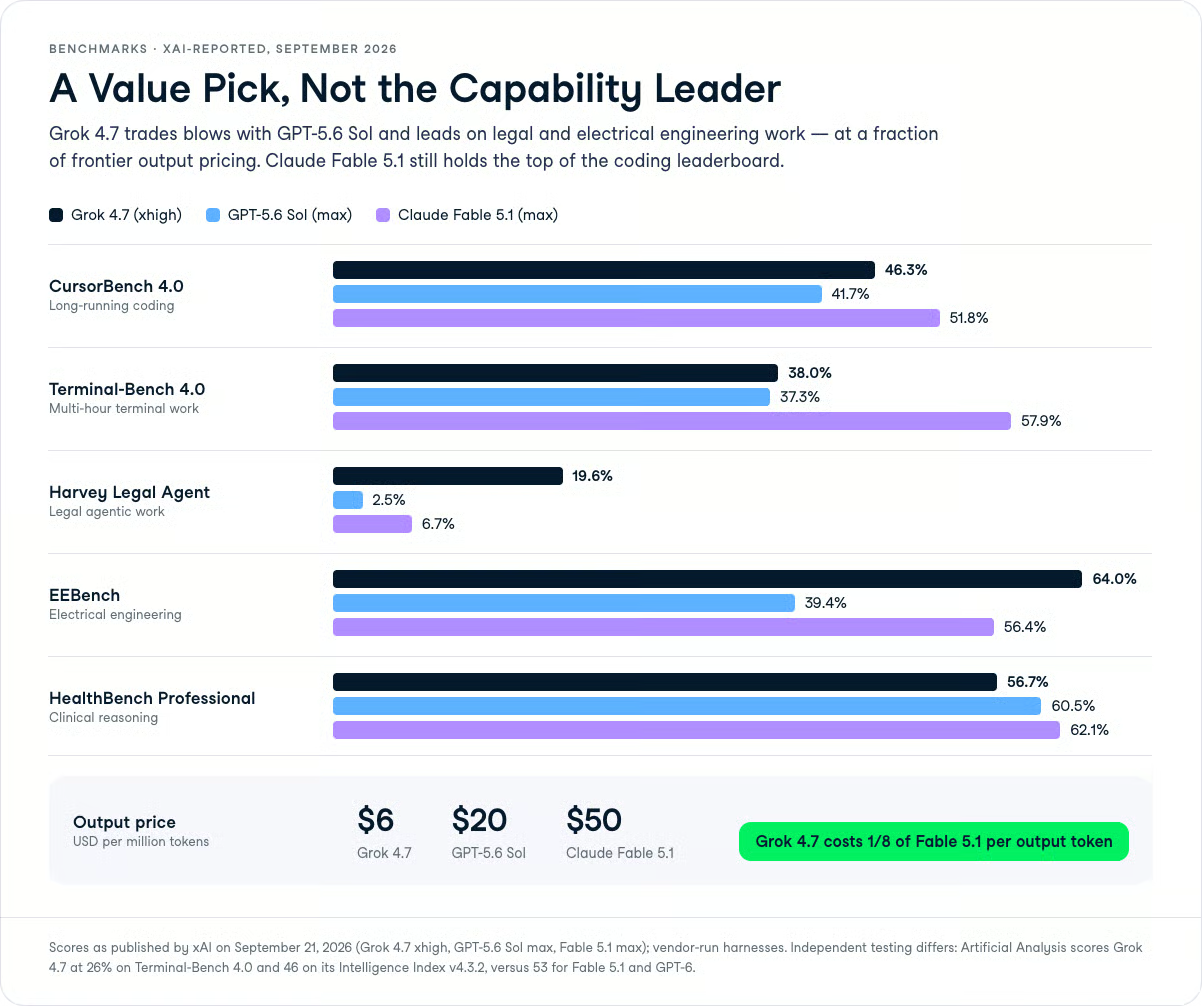
Su CursorBench 4.0, che stressa task di coding di lunga durata, Grok 4.7 segna il 46,3%. Supera il 41,7% di GPT-5.6 Sol e il 40,4% del suo predecessore, anche se Fable 5.1 guida con il 51,8%. Su DeepSWE v1.1, Grok 4.7 registra il 71,0% ad alto sforzo, vicino al 72,7% di Sol e al 70,0% di Fable 5.1.
Per il lavoro agentico da terminale c'è una discrepanza notevole. Mentre il framework interno di SpaceXAI mostra Grok 4.7 in salto al 38,0% su Terminal-Bench 4.0, Artificial Analysis misura Grok 4.7 appena al 26% sullo stesso benchmark. Questo lo pone ben dietro GPT-6 Astra (60%) e Claude Fable 5.1 (55%), e anche leggermente dietro il più economico DeepSeek V4.1 Flash (27%). Se il lavoro agentico da terminale è il tuo carico principale, i modelli di frontiera vincono ancora in modo netto sulla capacità pura.
In sintesi: sul coding, Grok 4.7 se la gioca con GPT-5.6 Sol a una frazione del costo, ma Fable 5.1 resta la scelta se ti serve il vertice assoluto della classifica.
Grok 4.7 guida tutti i concorrenti elencati sul lavoro legale.
Il suo 19,6% sull'Harvey Legal Agent Benchmark svetta sul 2,5% di GPT-5.6 Sol e sul 6,7% di Fable 5.1, e migliora il 15,8% di Grok 4.6. Se il tuo flusso tocca l'analisi di documenti legali o la revisione di contratti, è difficile ignorare questo divario.
Sul lavoro d'ufficio di più ore misurato da AA Briefcase v1.1, Grok 4.7 ottiene 1.657, posizionandosi davanti a GPT-5.6 Sol (1.487) e subito dietro Fable 5.1 (1.678).
Per il ragionamento clinico su HealthBench Professional, Grok 4.7 arriva al 56,7%, dietro al 60,5% di Sol e al 62,1% di Fable 5.1 ma sopra il 48,5% del suo predecessore.
Sui task di ingegneria elettrica misurati da EEBench, Grok 4.7 registra un robusto 64,0%, superando il suo predecessore (53,0%), Fable 5.1 (56,4%) e GPT-5.6 Sol (39,4%).
Nel complesso, lo schema è coerente: Grok 4.7 va molto bene su benchmark professionali specializzati (legale, ingegneria elettrica) e eguaglia o supera Sol sul coding generale, mentre Fable 5.1 mantiene la vetta del coding puro. Per un modello a $2/$6, è una posizione solida.
Grok 4.7 è disponibile in varianti per sforzo e in una variante fast, quindi la scelta dipende da quanto sei disposto a spendere per latenza e profondità di ragionamento.
La raccomandazione predefinita è la variante standard a $2/$6. La variante fast eroga output al doppio della velocità per il doppio del prezzo, quindi ha senso solo quando la latenza di risposta influisce direttamente sul tuo prodotto.
I benchmark pubblicati da SpaceXAI usano l'impostazione xhigh effort per Grok 4.7, con una nota che il suo punteggio di 71,0% su DeepSWE v1.1 è un risultato ad alto sforzo.
Un effort più alto significa che il modello lavora più a lungo e spende più token di output per la verifica: è qui che paga l'addestramento su task di più ore, ma è anche dove cresce la bolletta.
| Caso d'uso | Variante | Perché |
|---|---|---|
| Pipeline di coding ad alto volume | Standard xhigh | Miglior rapporto prezzo-prestazioni; il costo dell'output domina quindi evita il premium fast |
| Agenti legali o di ingegneria elettrica | Standard xhigh | Qui si vedono i vantaggi di Grok 4.7 nei benchmark; l'effort aiuta la verifica |
| Prodotti chat sensibili alla latenza | Variante Fast | La velocità di output 2x conta quando gli utenti attendono le risposte |
| Generazione batch di documenti e slide | Standard | Nessun vincolo di latenza, quindi vince il tier più economico |
Grok 4.7 parte da $2 per milione di token in input e $6 per milione di token in output, invariato rispetto a Grok 4.6.
SpaceXAI offre anche una variante fast con velocità di output doppia al doppio del prezzo, quindi $4 in input e $12 in output.
Questa tariffa base è un ottavo di quanto Claude Fable 5.1 addebita in output ($10 in input e $50 in output per milione di token). Il tier stable di Muse Spark 1.3 di Meta costa meno in input a $1,25 ma è vicino in output a $4,25, mentre il tier Contributor di Meta a $0,10/$0,20 è molto più economico in cambio del consenso ad addestrare Meta sui tuoi prompt.
Grok 4.7 è generalmente disponibile da oggi.
Non esiste un tier API gratuito, ma puoi provarlo senza costi tramite Grok Build.
Artificial Analysis indica per Grok 4.7 una finestra di contesto da 500.000 token, anche se è notevolmente assente dal post di lancio di SpaceXAI. È un vuoto ricorrente nella documentazione di Grok rispetto alle finestre da ~1M di token che concorrenti come Muse Spark pubblicano.
Grok 4.7 è un modello proprietario accessibile attraverso diverse interfacce:
Per chiamarlo dall'API, usa l'ID del modello come stringa esatta nella tua richiesta. Ecco un esempio minimo con il client compatibile OpenAI puntato all'endpoint SpaceXAI:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_XAI_KEY",
    base_url="https://api.x.ai/v1",
)
response = client.chat.completions.create(
    model="grok-4.7",
    messages=[{"role": "user", "content": "Refactor this SQL query for readability..."}],
)
print(response.choices[0].message.content)Grok 4.7 rappresenta per SpaceXAI una scelta di valore chiara in un mercato in cui Fable scommette che la capacità di frontiera giustifichi $50 per milione di token in output. È simile a quanto visto con la recente ondata di modelli Flash (vedi il nostro confronto DeepSeek V4.1 Flash vs Gemini 3.8 Flash).
Mantenendo le tariffe di Grok 4.6 a $2/$6 e ottenendo punteggi vicini alla frontiera, SpaceXAI compete sul costo per risultato invece che sulla posizione in classifica.
Io ci passerei per coding ad alto volume, lavoro agentico legale o task di ingegneria elettrica, dove i suoi vantaggi nei benchmark e il prezzo basso vanno a braccetto.
Se ti serve il vertice assoluto della classifica di coding, Fable 5.1 resta il migliore, e la documentazione di Grok sulla finestra di contesto, piuttosto scarna, continua a essere fastidiosa.
Se vuoi mettere le mani in pasta a costruire workflow agentici su modelli come questo, ti consiglio il nostro percorso di competenze AI Agent Fundamentals per costruire prima le basi.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



