前沿模型之争已进入一种常态:差异更多体现在“性价比”,而非单纯的极限能力。
Claude Fable 5.1 的价格是每百万标记输入 $10、输出 $50。对多数团队而言,现实问题在于这份溢价能否买到更便宜模型无法提供的价值。
SpaceXAI 于 2026 年 9 月 21 日发布 Grok 4.7,将其定位为最强的编码与知识工作模型。
它的计费为每百万输入标记 $2、输出标记 $6,与 Grok 4.6 持平;在用于长时编码任务的 CursorBench 4.0 上得分 46.3%,略低于 Fable 5.1。
本文将梳理 Grok 4.7 的全部新变化,介绍新功能,对比 GPT-5.6 Sol 与 Fable 5.1 的基准表现,并说明获取与使用方式。
想了解更广泛的竞品情况,可参见我们的Claude Fable 5.1 与 GPT-6 Astra 对比,以及Claude Opus 5 vs GPT-5.6 Sol。也推荐了解一下 TypeSafe 的 Jev。
要点速览
- Grok 4.7 是 SpaceXAI 面向编码与知识工作的全新默认模型,基座规模大于 Grok 4.6。
- 核心看点是“价效比”:每百万标记 $2/$6 却取得接近前沿的分数,输出成本仅为 Fable 的八分之一。
- 在 Harvey 法律代理基准上以 19.6% 领跑,远超 GPT-5.6 Sol(2.5%)与 Fable 5.1(6.7%)。
- Fable 5.1 仍在绝对编码与临床推理上领先,因此 Grok 4.7 更像“高性价比之选”而非“绝对能力之王”。
- 若您有高吞吐的编码或代理式工作负载,且账单主要由输出标记驱动,值得切换。
Grok 4.7 是什么?
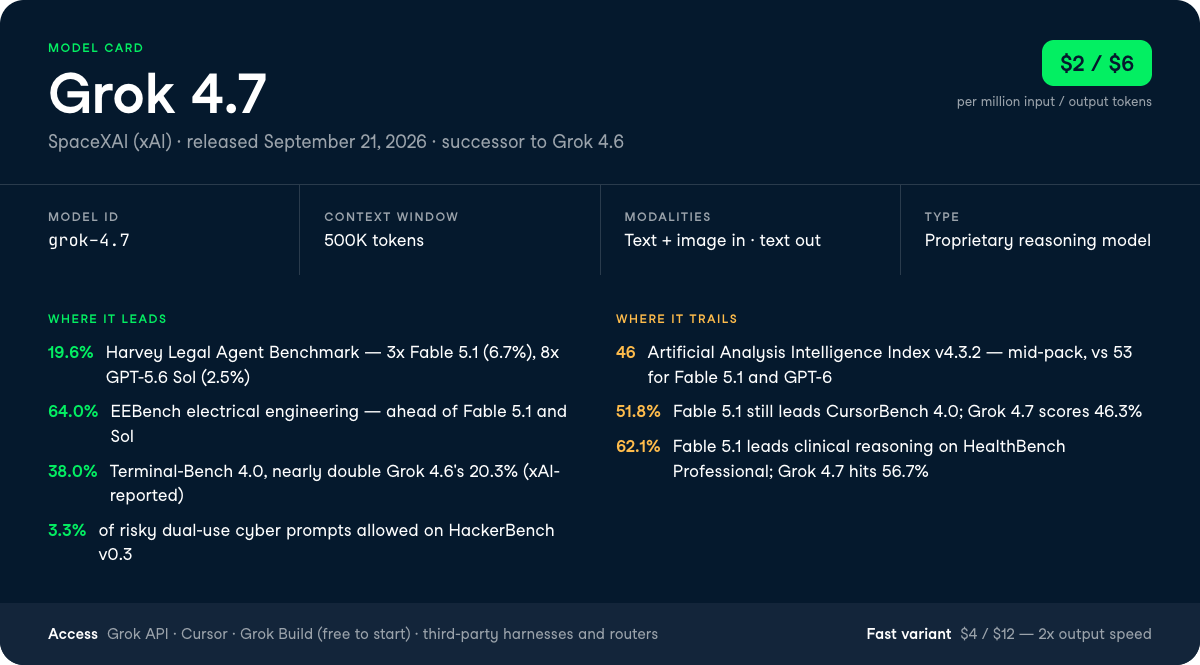
Grok 4.7 是 SpaceXAI 面向编码与知识工作的旗舰模型,于 2026 年 9 月 21 日发布,继任于 Grok 4.6。
它采用更大的新基座模型,并通过更长时间的强化学习在更难的任务组合上训练,尤其偏向需要耗时数小时的问题。SpaceXAI 训练它在困难任务上投入更久,并更细致地自检输出。
与 Grok 4.6 的代际提升主要体现在长时作业上。在衡量多小时终端任务的 Terminal-Bench 4.0 上,Grok 4.7 在 SpaceXAI 的内部基准中从 20.3% 几乎翻倍到 38.0%。CursorBench 4.0 从 40.4% 提升至 46.3%,AA Briefcase v1.1 的办公得分从 1,546 升至 1,657。
对一线使用者而言,最重要的头条是 Harvey 法律代理基准:Grok 4.7 取得 19.6%。这是 GPT-5.6 Sol 的 2.5% 的 7 倍以上,也接近 Fable 5.1 的 6.7% 的 3 倍;差距之大,足以让法律相关的代理式工作选择这一模型,而非更昂贵的前沿选项。
Grok 4.7 关键功能
Grok 4.7 的改进集中在三方面:对长时任务的持续工作能力、专业文档产出、新的安全防护栈。
它们在实践中能带来什么:
在多小时任务上坚持更久
Grok 4.7 专门在需要数小时而非数分钟的问题上训练,因此在长周期的编码与终端工作中更能“稳住阵脚”。
实践上,这意味着它能在多步调试或漫长的迁移过程中维持连贯的上下文,不会中途“丢线”。
与 Grok 4.6 相比,它能管理更长的上下文,并更谨慎地自检输出。
如果您曾遇到模型自信地宣布任务完成,却还有一半测试未通过——这正是 SpaceXAI 要解决的痛点。
生成文档与演示
Grok 4.7 更擅长生成专业人士实际会交付的成果物:报告、简报与幻灯片。
SpaceXAI 用 GDPval 和 AA Briefcase 进行评测,这些基准让模型完成律师、护士和财务分析师常做的工作。
对数据团队而言,当您希望模型把分析转换成书面总结或“可交付给干系人”的演示,而非只返回原始结果时,这一点至关重要。
Grok 4.7 在这两项基准上都优于 Grok 4.6,并与其他前沿模型表现接近,因此“文档生成”不再是为 Fable 付溢价的理由。
原生 Grok Bot 对话处理
SpaceXAI 训练 Grok 4.7 原生理解 Grok Bot 运行环境,使其在对话任务与通用知识工作上更稳健。
如果您在 Grok API 之上构建聊天式助手,模型在该对话循环中的行为会更可预测。
这项能力比编码方面的增益更“窄”,但释放出一个信号:SpaceXAI 正把对话式部署作为一等用例,而非事后在编码模型上“外挂”。
高实用性的全新安全防护栈
Grok 4.7 随附全新的安全防护栈。SpaceXAI 称其在拒答与越狱抵抗方面是其测试过的最强模型。
对使用者而言,亮点在于它并不会过度拒绝正当工作。
在 SpaceXAI 面向高风险与恶意网络任务的 HackerBench v0.3 上,Grok 4.7 仅放行 3.3% 的高风险双重用途提示,同时很少阻拦正当的安全工作。
它还以 62.4% 的成绩位居 LatchBio 的生物安全基准榜首。
Grok 4.7 的方法是区分良性与危险,而非“一刀切”拒绝整个领域。
Grok 4.7 的基准表现如何?
从独立汇总榜单看,Grok 4.7 处于中游水准。
在整合十项基准的 Artificial Analysis Intelligence Index v4.3.2 上,Grok 4.7 得分 46。
这明显落后于当前领跑者 Claude Fable 5.1 与 GPT-6(均为 53)。归根结底,Grok 4.7 是“价效比”领先,而非绝对能力领先。
它在多数编码与知识类基准上击败 GPT-5.6 Sol,同时输出价格不到 Sol 的三分之一,但在绝对编码得分上仍略逊 Fable 5.1。
唯一大幅领先所有对手的基准是法律代理工作。
编码与代理式工作流
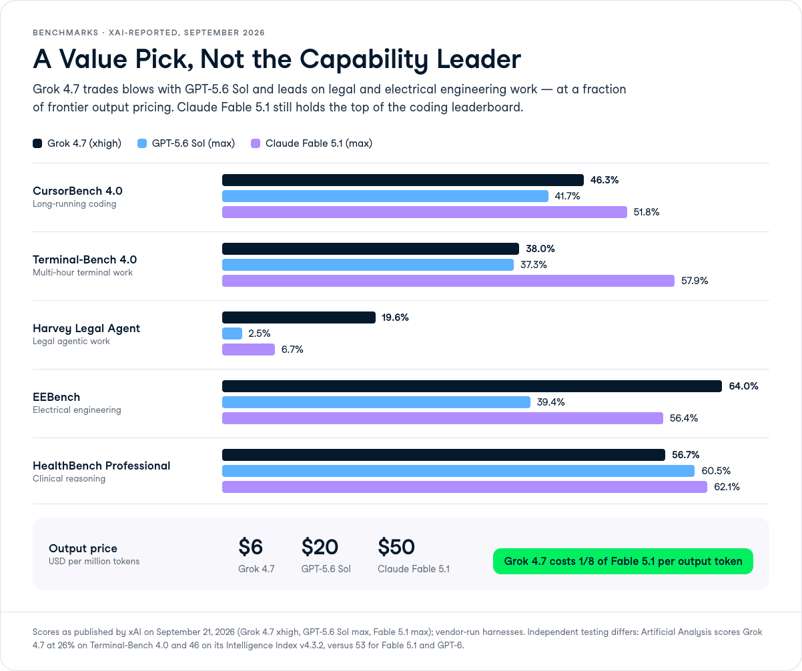
在强调长时编码任务的 CursorBench 4.0 上,Grok 4.7 得分 46.3%。这高于 GPT-5.6 Sol 的 41.7% 与其前代的 40.4%,但 Fable 5.1 以 51.8% 领先。在 DeepSWE v1.1 上,Grok 4.7 在高努力设置下取得 71.0%,接近 Sol 的 72.7% 与 Fable 5.1 的 70.0%。
对于终端代理工作,存在显著差异:虽 SpaceXAI 的内部基准显示 Grok 4.7 在 Terminal-Bench 4.0 上跃升至 38.0%,但 Artificial Analysis 测得的同项分数仅为 26%。这使其明显落后于 GPT-6 Astra(60%)与 Claude Fable 5.1(55%),甚至略低于更便宜的 DeepSeek V4.1 Flash(27%)。若终端代理是您的核心负载,前沿模型在“纯能力”上仍然明显占优。
结论:在编码方面,Grok 4.7 以远低于对手的成本与 GPT-5.6 Sol 分庭抗礼;但若追求绝对榜首,Fable 5.1 仍是首选。
专业知识工作
Grok 4.7 在法律工作上领先所有列出的对手。
其在 Harvey 法律代理基准上取得 19.6%,大幅高于 GPT-5.6 Sol 的 2.5% 与 Fable 5.1 的 6.7%,也优于 Grok 4.6 的 15.8%。若您的流程涉及法律文档分析或合同审阅,这样的差距很难忽视。
在 AA Briefcase v1.1 衡量的多小时办公工作中,Grok 4.7 得分 1,657,高于 GPT-5.6 Sol(1,487),仅略低于 Fable 5.1(1,678)。
在 HealthBench Professional 的临床推理上,Grok 4.7 得分 56.7%,落后于 Sol 的 60.5% 与 Fable 5.1 的 62.1%,但优于自家前代的 48.5%。
技术与工程任务
在 EEBench 衡量的电气工程任务上,Grok 4.7 取得亮眼的 64.0%,超越其前代(53.0%)、Fable 5.1(56.4%)与 GPT-5.6 Sol(39.4%)。
综合来看,结论一致:Grok 4.7 在专业类基准(法律、电气工程)上表现出色,并在通用编码上与 Sol 持平或胜出;而 Fable 5.1 继续占据纯编码榜首。以 $2/$6 的价位,这个位置相当有竞争力。
应选择哪个层级?
Grok 4.7 提供不同“努力”变体与一个“快速”变体,选择取决于您愿意为时延与推理深度付出多少。
默认推荐是标准变体,价格为 $2/$6。快速变体以两倍价格提供两倍输出速度,仅在响应时延直接影响产品体验时才划算。
SpaceXAI 公布的基准均使用 Grok 4.7 的 xhigh 努力设置,并注明其 DeepSWE v1.1 的 71.0% 为高努力结果。
更高的努力意味着模型工作更久、在验证上花费更多输出标记——这正是长时任务训练的价值所在,但也会推高账单。
| 用例 | 变体 | 原因 |
|---|
| 高吞吐编码流水线 | Standard xhigh | 最佳价效比;输出成本占大头,避免为“快”支付溢价 |
| 法律或电气工程代理 | Standard xhigh | Grok 4.7 的领先体现在此;更高努力有助于验证 |
| 对时延敏感的聊天产品 | Fast variant | 当用户等待响应时,2 倍输出速度很重要 |
| 批量文档与幻灯片生成 | Standard | 无时延约束,选择更便宜的层级更划算 |
Grok 4.7 的定价与可用性
Grok 4.7 的基础价格为每百万输入标记 $2、输出标记 $6,与 Grok 4.6 持平。
SpaceXAI 还提供快速变体,输出速度翻倍、价格也翻倍,即输入 $4、输出 $12。
这一基础费率仅为 Claude Fable 5.1 输出价格的八分之一(其为每百万标记输入 $10、输出 $50)。Meta 的 Muse Spark 1.3 稳定层在输入价上以 $1.25 低于 Grok,输出价 $4.25 接近;而 Meta 的 Contributor 层以 $0.10/$0.20 便宜得多,但需要允许 Meta 用您的提示进行训练。
Grok 4.7 今日起全面可用。
没有免费的 API 层,但您可以通过 Grok Build 免费试用。
Artificial Analysis 显示 Grok 4.7 的上下文窗口为 500,000 标记,但这一点在 SpaceXAI 的发布帖中未提及。相较于竞品(如 Muse Spark)公布的约 100 万标记窗口,Grok 文档在此处一贯偏少。
如何访问 Grok 4.7
Grok 4.7 是专有模型,可通过多种界面使用:
- 通过 SpaceXAI 控制台的 Grok API
- Cursor(编辑器内编码)
- Grok Build(免费上手)
- 第三方编码运行环境、模型路由器与云平台
从 API 调用时,请在请求中使用精确的模型 ID。以下是将 OpenAI 兼容客户端指向 SpaceXAI 端点的最小示例:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_XAI_KEY",
    base_url="https://api.x.ai/v1",
)
response = client.chat.completions.create(
    model="grok-4.7",
    messages=[{"role": "user", "content": "Refactor this SQL query for readability..."}],
)
print(response.choices[0].message.content)技术支持
结语
Grok 4.7 代表着 SpaceXAI 在一个由 Fable 以 $50/百万输出定价押注“绝对前沿能力”的市场中,作出的“价值导向”选择。这与近期一批 Flash 模型的策略类似(参见我们的对比:DeepSeek V4.1 Flash vs Gemini 3.8 Flash)。
在保持 Grok 4.6 的 $2/$6 价位同时拿下接近前沿的分数,SpaceXAI 正在以“单位结果成本”而非“榜单名次”展开竞争。
若您从事高吞吐编码、法律代理或电气工程任务——这些正是它领跑的基准领域——且价格敏感,我会选择它。
如果您需要编码榜单的绝对第一,Fable 5.1 仍胜出;同时,Grok 关于上下文窗口的“稀薄”文档仍让人不便。
如果您想亲手搭建这类模型的代理式工作流,推荐先学习我们的 AI Agent Fundamentals 技能路径打好基础。


前沿模型之争已进入一种常态:差异更多体现在“性价比”,而非单纯的极限能力。
Claude Fable 5.1 的价格是每百万标记输入 $10、输出 $50。对多数团队而言,现实问题在于这份溢价能否买到更便宜模型无法提供的价值。
SpaceXAI 于 2026 年 9 月 21 日发布 Grok 4.7,将其定位为最强的编码与知识工作模型。
它的计费为每百万输入标记 $2、输出标记 $6,与 Grok 4.6 持平;在用于长时编码任务的 CursorBench 4.0 上得分 46.3%,略低于 Fable 5.1。
本文将梳理 Grok 4.7 的全部新变化,介绍新功能,对比 GPT-5.6 Sol 与 Fable 5.1 的基准表现,并说明获取与使用方式。
想了解更广泛的竞品情况,可参见我们的Claude Fable 5.1 与 GPT-6 Astra 对比,以及Claude Opus 5 vs GPT-5.6 Sol。也推荐了解一下 TypeSafe 的 Jev。
要点速览
Grok 4.7 是什么?
Grok 4.7 是 SpaceXAI 面向编码与知识工作的旗舰模型,于 2026 年 9 月 21 日发布,继任于 Grok 4.6。
它采用更大的新基座模型,并通过更长时间的强化学习在更难的任务组合上训练,尤其偏向需要耗时数小时的问题。SpaceXAI 训练它在困难任务上投入更久,并更细致地自检输出。
与 Grok 4.6 的代际提升主要体现在长时作业上。在衡量多小时终端任务的 Terminal-Bench 4.0 上,Grok 4.7 在 SpaceXAI 的内部基准中从 20.3% 几乎翻倍到 38.0%。CursorBench 4.0 从 40.4% 提升至 46.3%,AA Briefcase v1.1 的办公得分从 1,546 升至 1,657。
对一线使用者而言,最重要的头条是 Harvey 法律代理基准:Grok 4.7 取得 19.6%。这是 GPT-5.6 Sol 的 2.5% 的 7 倍以上,也接近 Fable 5.1 的 6.7% 的 3 倍;差距之大,足以让法律相关的代理式工作选择这一模型,而非更昂贵的前沿选项。
Grok 4.7 关键功能
Grok 4.7 的改进集中在三方面:对长时任务的持续工作能力、专业文档产出、新的安全防护栈。
它们在实践中能带来什么:
在多小时任务上坚持更久
Grok 4.7 专门在需要数小时而非数分钟的问题上训练,因此在长周期的编码与终端工作中更能“稳住阵脚”。
实践上,这意味着它能在多步调试或漫长的迁移过程中维持连贯的上下文,不会中途“丢线”。
与 Grok 4.6 相比,它能管理更长的上下文,并更谨慎地自检输出。
如果您曾遇到模型自信地宣布任务完成,却还有一半测试未通过——这正是 SpaceXAI 要解决的痛点。
生成文档与演示
Grok 4.7 更擅长生成专业人士实际会交付的成果物:报告、简报与幻灯片。
SpaceXAI 用 GDPval 和 AA Briefcase 进行评测,这些基准让模型完成律师、护士和财务分析师常做的工作。
对数据团队而言,当您希望模型把分析转换成书面总结或“可交付给干系人”的演示,而非只返回原始结果时,这一点至关重要。
Grok 4.7 在这两项基准上都优于 Grok 4.6,并与其他前沿模型表现接近,因此“文档生成”不再是为 Fable 付溢价的理由。
原生 Grok Bot 对话处理
SpaceXAI 训练 Grok 4.7 原生理解 Grok Bot 运行环境,使其在对话任务与通用知识工作上更稳健。
如果您在 Grok API 之上构建聊天式助手,模型在该对话循环中的行为会更可预测。
这项能力比编码方面的增益更“窄”,但释放出一个信号:SpaceXAI 正把对话式部署作为一等用例,而非事后在编码模型上“外挂”。
高实用性的全新安全防护栈
Grok 4.7 随附全新的安全防护栈。SpaceXAI 称其在拒答与越狱抵抗方面是其测试过的最强模型。
对使用者而言,亮点在于它并不会过度拒绝正当工作。
在 SpaceXAI 面向高风险与恶意网络任务的 HackerBench v0.3 上,Grok 4.7 仅放行 3.3% 的高风险双重用途提示,同时很少阻拦正当的安全工作。
它还以 62.4% 的成绩位居 LatchBio 的生物安全基准榜首。
Grok 4.7 的方法是区分良性与危险,而非“一刀切”拒绝整个领域。
Grok 4.7 的基准表现如何?
从独立汇总榜单看,Grok 4.7 处于中游水准。
在整合十项基准的 Artificial Analysis Intelligence Index v4.3.2 上,Grok 4.7 得分 46。
这明显落后于当前领跑者 Claude Fable 5.1 与 GPT-6(均为 53)。归根结底,Grok 4.7 是“价效比”领先,而非绝对能力领先。
它在多数编码与知识类基准上击败 GPT-5.6 Sol,同时输出价格不到 Sol 的三分之一,但在绝对编码得分上仍略逊 Fable 5.1。
唯一大幅领先所有对手的基准是法律代理工作。
编码与代理式工作流
在强调长时编码任务的 CursorBench 4.0 上,Grok 4.7 得分 46.3%。这高于 GPT-5.6 Sol 的 41.7% 与其前代的 40.4%,但 Fable 5.1 以 51.8% 领先。在 DeepSWE v1.1 上,Grok 4.7 在高努力设置下取得 71.0%,接近 Sol 的 72.7% 与 Fable 5.1 的 70.0%。
对于终端代理工作,存在显著差异:虽 SpaceXAI 的内部基准显示 Grok 4.7 在 Terminal-Bench 4.0 上跃升至 38.0%,但 Artificial Analysis 测得的同项分数仅为 26%。这使其明显落后于 GPT-6 Astra(60%)与 Claude Fable 5.1(55%),甚至略低于更便宜的 DeepSeek V4.1 Flash(27%)。若终端代理是您的核心负载,前沿模型在“纯能力”上仍然明显占优。
结论:在编码方面,Grok 4.7 以远低于对手的成本与 GPT-5.6 Sol 分庭抗礼;但若追求绝对榜首,Fable 5.1 仍是首选。
专业知识工作
Grok 4.7 在法律工作上领先所有列出的对手。
其在 Harvey 法律代理基准上取得 19.6%,大幅高于 GPT-5.6 Sol 的 2.5% 与 Fable 5.1 的 6.7%,也优于 Grok 4.6 的 15.8%。若您的流程涉及法律文档分析或合同审阅,这样的差距很难忽视。
在 AA Briefcase v1.1 衡量的多小时办公工作中,Grok 4.7 得分 1,657,高于 GPT-5.6 Sol(1,487),仅略低于 Fable 5.1(1,678)。
在 HealthBench Professional 的临床推理上,Grok 4.7 得分 56.7%,落后于 Sol 的 60.5% 与 Fable 5.1 的 62.1%,但优于自家前代的 48.5%。
技术与工程任务
在 EEBench 衡量的电气工程任务上,Grok 4.7 取得亮眼的 64.0%,超越其前代(53.0%)、Fable 5.1(56.4%)与 GPT-5.6 Sol(39.4%)。
综合来看,结论一致:Grok 4.7 在专业类基准(法律、电气工程)上表现出色,并在通用编码上与 Sol 持平或胜出;而 Fable 5.1 继续占据纯编码榜首。以 $2/$6 的价位,这个位置相当有竞争力。
应选择哪个层级?
Grok 4.7 提供不同“努力”变体与一个“快速”变体,选择取决于您愿意为时延与推理深度付出多少。
默认推荐是标准变体,价格为 $2/$6。快速变体以两倍价格提供两倍输出速度,仅在响应时延直接影响产品体验时才划算。
SpaceXAI 公布的基准均使用 Grok 4.7 的 xhigh 努力设置,并注明其 DeepSWE v1.1 的 71.0% 为高努力结果。
更高的努力意味着模型工作更久、在验证上花费更多输出标记——这正是长时任务训练的价值所在,但也会推高账单。
Grok 4.7 的定价与可用性
Grok 4.7 的基础价格为每百万输入标记 $2、输出标记 $6,与 Grok 4.6 持平。
SpaceXAI 还提供快速变体,输出速度翻倍、价格也翻倍,即输入 $4、输出 $12。
这一基础费率仅为 Claude Fable 5.1 输出价格的八分之一(其为每百万标记输入 $10、输出 $50)。Meta 的 Muse Spark 1.3 稳定层在输入价上以 $1.25 低于 Grok,输出价 $4.25 接近;而 Meta 的 Contributor 层以 $0.10/$0.20 便宜得多,但需要允许 Meta 用您的提示进行训练。
Grok 4.7 今日起全面可用。
没有免费的 API 层,但您可以通过 Grok Build 免费试用。
Artificial Analysis 显示 Grok 4.7 的上下文窗口为 500,000 标记,但这一点在 SpaceXAI 的发布帖中未提及。相较于竞品(如 Muse Spark)公布的约 100 万标记窗口,Grok 文档在此处一贯偏少。
如何访问 Grok 4.7
Grok 4.7 是专有模型,可通过多种界面使用:
从 API 调用时,请在请求中使用精确的模型 ID。以下是将 OpenAI 兼容客户端指向 SpaceXAI 端点的最小示例:
结语
Grok 4.7 代表着 SpaceXAI 在一个由 Fable 以 $50/百万输出定价押注“绝对前沿能力”的市场中,作出的“价值导向”选择。这与近期一批 Flash 模型的策略类似(参见我们的对比:DeepSeek V4.1 Flash vs Gemini 3.8 Flash)。
在保持 Grok 4.6 的 $2/$6 价位同时拿下接近前沿的分数,SpaceXAI 正在以“单位结果成本”而非“榜单名次”展开竞争。
若您从事高吞吐编码、法律代理或电气工程任务——这些正是它领跑的基准领域——且价格敏感,我会选择它。
如果您需要编码榜单的绝对第一,Fable 5.1 仍胜出;同时,Grok 关于上下文窗口的“稀薄”文档仍让人不便。
如果您想亲手搭建这类模型的代理式工作流,推荐先学习我们的 AI Agent Fundamentals 技能路径打好基础。