
Kurs
Geliştiriciler için Yapay Zeka Destekli Kodlama
1 sa 30 dk
10.7K
Öncü model yarışı, farkların ham yetenekten ziyade ödediğiniz bedele dair olduğu bir düzene oturdu.
Claude Fable 5.1 milyon token başına $10 giriş ve $50 çıkış fiyatında konumlanıyor; çoğu ekip için pratik soru, bu primin daha ucuz bir modelin sunamayacağı ne kazandırdığı.
SpaceXAI, Grok 4.7’yi 21 Eylül 2026’da yayınladı ve kodlama ile bilgi-işi için en yetkin modeli olarak konumlandırdı.
Milyon giriş tokenı başına $2 ve milyon çıkış tokenı başına $6’da (Grok 4.6 ile aynı) çalışıyor ve uzun süreli kodlama görevleri için CursorBench 4.0’da %46,3 puanla Fable 5.1’in biraz gerisinde kalıyor.
Bu yazıda, Grok 4.7’deki tüm yenilikleri ele alıyor, yeni özelliklere bakıyor, GPT-5.6 Sol ve Fable 5.1’e karşı kıyaslamaları inceliyor ve erişim seçeneklerini değerlendiriyorum.
Rekabet ortamına dair daha fazlası için Claude Fable 5.1 ve GPT-6 Astra karşılaştırmamıza ve Claude Opus 5 vs GPT-5.6 Sol incelememize bakın. Ayrıca TypeSafe’in Jev modeli hakkında okumanızı da öneririm.
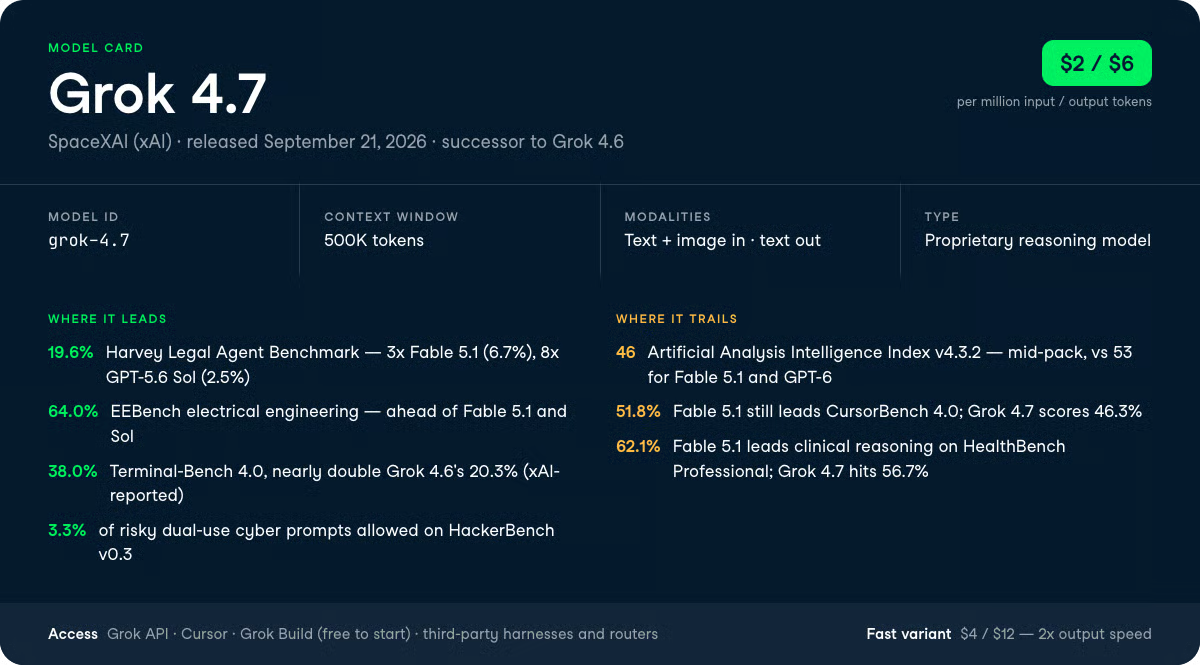
Grok 4.7, SpaceXAI’nin kodlama ve bilgi-işi için amiral gemisi modeli olup, Grok 4.6’nın halefi olarak 21 Eylül 2026’da yayınlandı.
Daha büyük yeni bir temel model kullanıyor ve daha zorlu görevlerin yer aldığı bir karışım üzerinde, daha uzun bir pekiştirmeli öğrenme çalışmasıyla eğitildi; saatler süren problemler lehine ağırlıklandırıldı. SpaceXAI modeli zor görevlerde daha uzun çalışacak ve kendi çıktısını daha dikkatle denetleyecek şekilde eğitti.
Grok 4.6’ya kıyasla nesil atlaması en çok uzun soluklu işlerde ortaya çıkıyor. Çok saatlik terminal görevlerini ölçen Terminal-Bench 4.0’da, Grok 4.7 SpaceXAI’nin dahili ölçümünde selefinin neredeyse iki katına çıkarak %20,3’ten %38,0’a yükseliyor. CursorBench 4.0, %40,4’ten %46,3’e; AA Briefcase v1.1 ofis-iş puanı ise 1.546’dan 1.657’ye çıkıyor.
Uygulayıcılar için asıl manşet Harvey Legal Agent Benchmark; Grok 4.7 burada %19,6 puan alıyor. Bu, GPT-5.6 Sol’un %2,5’inin 7 katından fazla ve Fable 5.1’in %6,7’sinin neredeyse 3 katı; hukukla ilişkili ajan çalışmaları için, daha pahalı öncü seçenekler yerine bu modele yönelmek için gerçek bir neden.
Grok 4.7’nin iyileştirmeleri üç başlıkta toplanıyor: uzun görevlerde sürdürülebilir çalışma, profesyonel belge üretimi ve yeni bir güvenlik katmanı.
Pratikte bunlarla neler yapabilirsiniz:
Grok 4.7, dakikalar yerine saatler süren problemler üzerinde özellikle eğitildi; bu nedenle uzun ufuklu kodlama ve terminal işlerinde daha dayanıklı.
Pratikte bu, çok adımlı bir hata ayıklama oturumu veya uzayan bir geçiş sırasında anlatı bütünlüğünü koruyabildiği, yarı yolda konuyu kaybetmediği anlamına gelir.
Model, daha uzun bağlamı yönetiyor ve kendi çıktısını Grok 4.6’ya kıyasla daha dikkatli doğruluyor.
Eğer bir modelin, testlerin yarısı başarısızken işi bitti diye kendinden emin şekilde ilan ettiğine şahit olduysanız, SpaceXAI’nin hedeflediği alan tam da burası.
Grok 4.7, profesyonellerin gerçekten teslim ettiği türden çıktıların üretiminde daha iyi: raporlar, özetler ve slayt setleri.
SpaceXAI bunu, genelde avukatlar, hemşireler ve finans analistlerinin yaptığı işleri modele yükleyen GDPval ve AA Briefcase üzerinde kıyaslıyor.
Bir veri ekibi için, modelin bir analizi ham çıktı döndürmek yerine yazılı bir özet ya da paydaşlara hazır bir sunuma dönüştürmesini istediğinizde bu önemlidir.
Grok 4.7, her iki kıyaslamada da Grok 4.6’ya göre ilerliyor ve diğer öncü modellerle karşılaştırılabilir performans sergiliyor; dolayısıyla belge üretimi artık Fable için prim ödeme nedeni değil.
SpaceXAI, Grok 4.7’yi Grok Bot düzenini yerel olarak anlayacak şekilde eğitti; bu da onu sohbet görevlerinde ve genel bilgi işlerinde daha güçlü kılıyor.
Grok API’si üzerinde sohbet tarzı bir asistan oluşturuyorsanız, model bu sohbet döngüsü içinde daha öngörülebilir davranır.
Bu, kodlama kazanımlarına kıyasla daha dar bir özellik; ancak SpaceXAI’nin sohbet dağıtımını birinci sınıf kullanım alanı olarak ele aldığının, kodlama modeline sonradan eklenmiş bir düşünce olarak görmediğinin işareti.
Grok 4.7 tamamen yeni bir güvenlik katmanıyla geliyor; SpaceXAI, reddetmeler ve jailbreak direnci konusunda test ettiği en güçlü model olduğunu söylüyor.
Uygulayıcılar için ilginç olan, bunu meşru işleri aşırı reddetmeden yapması.
Riskli ve kötü niyetli siber görevler için SpaceXAI’nin kıyaslaması olan HackerBench v0.3’te, Grok 4.7 riskli çift kullanımlı istemlerin yalnızca %3,3’üne izin verirken meşru güvenlik işlerini nadiren engelliyor.
Ayrıca LatchBio’nun biyogüvenlik kıyaslamasında %62,4 ile zirvede.
Grok 4.7’nin yaklaşımı, tüm alanı reddetmek yerine zararsız olanla tehlikeliyi ayırt etmek.
Bağımsız toplam puanlara baktığımızda Grok 4.7, grubun ortalarında sağlam bir yer ediniyor.
On kıyaslamayı birleştiren Artificial Analysis Intelligence Index v4.3.2’de Grok 4.7, 46 puan alıyor.
Bu, her ikisi de 53 puan alan mevcut liderler Claude Fable 5.1 ve GPT-6’nın hayli gerisinde konumlanıyor. Sonuçta Grok 4.7, mutlak yetenek lideri değil; fiyat-performans lideri.
Çoğu kodlama ve bilgi kıyaslamasında GPT-5.6 Sol’u geçerken Sol’un çıkış fiyatının üçte birinden azını talep ediyor; ancak Fable 5.1 mutlak kodlama skorlarında hâlâ önde.
Grok 4.7’nin herkesi açık farkla geçtiği tek kıyaslama, hukuk ajanı işleri.
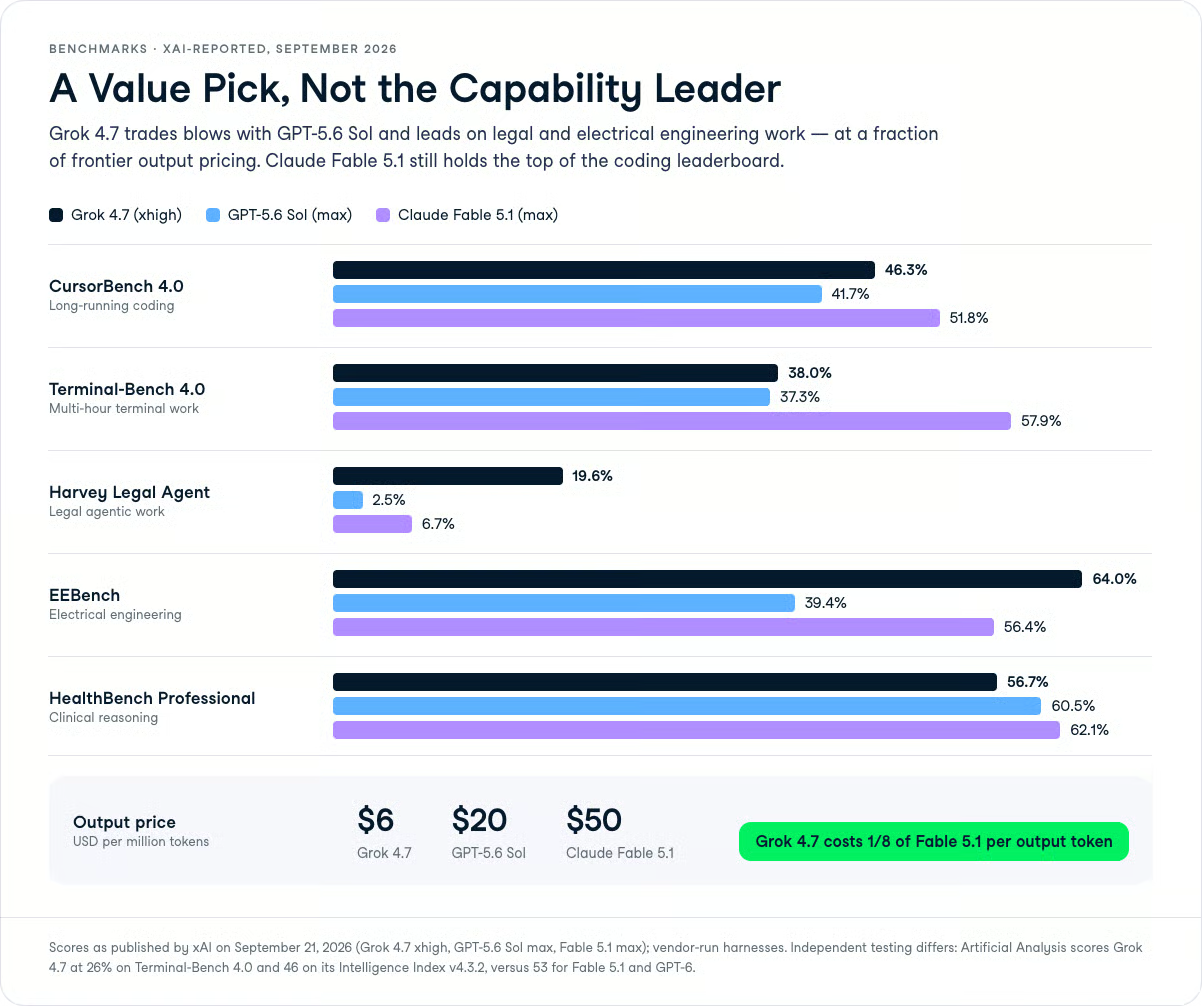
Daha uzun süren kodlama görevlerine yüklenen CursorBench 4.0’da Grok 4.7, %46,3 puan alıyor. Bu, GPT-5.6 Sol’un %41,7’sini ve selefinin %40,4’ünü geçiyor; ancak Fable 5.1 %51,8 ile önde. DeepSWE v1.1’de Grok 4.7, yüksek çabayla %71,0 puan alıyor; Sol’un %72,7’sine ve Fable 5.1’in %70,0’ına yakın.
Terminal ajan işlerinde belirgin bir tutarsızlık var. SpaceXAI’nin dahili ölçümü Grok 4.7’nin Terminal-Bench 4.0’da %38,0’a sıçradığını gösterirken, Artificial Analysis aynı kıyaslamada Grok 4.7’yi yalnızca %26’da ölçüyor. Bu da onu GPT-6 Astra (%60) ve Claude Fable 5.1 (%55) karşısında epey geriye, hatta daha ucuz DeepSeek V4.1 Flash’ın (%27) biraz altına yerleştiriyor. Terminal ajan işleri temel iş yükünüzse, öncü modeller ham yetenekte hâlâ açık ara önde.
Özet: Kodlamada Grok 4.7, maliyetin küçük bir kısmına GPT-5.6 Sol ile başa baş kapışıyor; ancak saf liderlik gerekiyorsa Fable 5.1 hâlâ tercihtir.
Grok 4.7, listelenen tüm rakipleri hukuk işlerinde geride bırakıyor.
Harvey Legal Agent Benchmark’taki %19,6 puanı, GPT-5.6 Sol’un %2,5’i ve Fable 5.1’in %6,7’si karşısında ezici; ayrıca Grok 4.6’nın %15,8’ine göre artış. İş akışınız hukuk dokümanı analizi veya sözleşme incelemesine değiyorsa bu fark görmezden gelinemez.
AA Briefcase v1.1’in ölçtüğü çok saatlik ofis işlerinde Grok 4.7, 1.657 puanla GPT-5.6 Sol’u (1.487) geride bırakıyor ve Fable 5.1’in (1.678) hemen arkasına yerleşiyor.
HealthBench Professional’da klinik akıl yürütmede Grok 4.7, %56,7’ye ulaşıyor; Sol’un %60,5’i ve Fable 5.1’in %62,1’inin gerisinde ancak selefinin %48,5’ini geçiyor.
EEBench’in ölçtüğü elektrik mühendisliği görevlerinde Grok 4.7, güçlü bir %64,0 puan alıyor; selefini (%53,0), Fable 5.1’i (%56,4) ve GPT-5.6 Sol’u (%39,4) geride bırakıyor.
Genel tablo tutarlı: Grok 4.7, uzmanlaşmış profesyonel kıyaslamalarda (hukuk, elektrik mühendisliği) çok iyi performans gösteriyor ve genel kodlamada Sol’u yakalıyor veya geçiyor; Fable 5.1 ise saf kodlama liderliğini koruyor. Milyon token başına $2/$6’lık bir model için bu güçlü bir konum.
Grok 4.7, çaba (effort) varyantlarında ve hızlı bir varyantta sunuluyor; seçim, gecikme ve akıl yürütme derinliği için ne kadar harcamak istediğinize kalıyor.
Varsayılan öneri, milyon token başına $2/$6 fiyatlı standart varyant. Hızlı varyant, iki kat fiyatla iki kat hızda çıktı veriyor; bu nedenle yanıt gecikmesi ürününüzü doğrudan etkilediğinde anlamlı.
SpaceXAI’nin yayımladığı kıyaslamalar, Grok 4.7 için xhigh effort ayarını kullanıyor ve DeepSWE v1.1’deki %71,0 skorunun yüksek çaba sonucu olduğuna dair not düşüyor.
Daha yüksek çaba, modelin daha uzun çalıştığı ve doğrulamaya daha fazla çıkış tokenı harcadığı anlamına gelir; bu da çok saatlik görev eğitiminin karşılığını verir, ancak faturayı da büyütür.
| Kullanım durumu | Varyant | Neden |
|---|---|---|
| Yüksek hacimli kodlama hatları | Standard xhigh | En iyi fiyat-performans; maliyete çıkış tokenı hakim olur, hızlı priminden kaçının |
| Hukuk veya elektrik mühendisliği ajanları | Standard xhigh | Grok 4.7’nin öncülük ettiği kıyaslar burada; çaba doğrulamaya yardımcı olur |
| Gecikmeye hassas sohbet ürünleri | Fast variant | Kullanıcılar yanıt beklerken 2x çıkış hızı önemlidir |
| Toplu belge ve slayt üretimi | Standard | Gecikme kısıtı yok; daha ucuz katman kazanır |
Grok 4.7, milyon giriş tokenı başına $2 ve milyon çıkış tokenı başına $6’dan fiyatlandırılıyor; Grok 4.6 ile aynı.
SpaceXAI ayrıca iki kat fiyatla iki kat çıkış hızı sunan hızlı bir varyant da sunuyor; yani $4 giriş ve $12 çıkış.
Bu taban oran, Claude Fable 5.1’in çıkışta aldığı ücretin sekizde biri (milyon token başına $10 giriş ve $50 çıkış). Meta’nın Muse Spark 1.3 “stable” katmanı girişte $1,25 ile Grok’un altında, çıkışta $4,25 ile yakın; Meta’nın “Contributor” katmanı ise $0,10/$0,20 ile çok daha ucuz fakat istemlerinizin Meta tarafından eğitimde kullanılmasına izin vermenizi gerektiriyor.
Grok 4.7 bugün genel erişime açık.
Ücretsiz bir API katmanı yok; ancak Grok Build üzerinden ücretsiz deneyebilirsiniz.
Artificial Analysis, Grok 4.7’nin 500.000 tokenlık bir bağlam penceresine sahip olduğunu listeliyor; ancak bu, SpaceXAI’nin lansman gönderisinde dikkat çekici şekilde yer almıyor. Bu, Muse Spark gibi rakiplerin yayımladığı ~1M token pencerelerine kıyasla Grok dokümantasyonunda yinelenen bir boşluk.
Grok 4.7, çeşitli yüzeyler üzerinden erişilebilen tescilli bir modeldir:
API’den çağırmak için, isteklerinizde model kimliğini tam dize olarak kullanın. İşte SpaceXAI uç noktasına yönlendirilmiş OpenAI uyumlu istemciyle minimal bir örnek:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_XAI_KEY",
    base_url="https://api.x.ai/v1",
)
response = client.chat.completions.create(
    model="grok-4.7",
    messages=[{"role": "user", "content": "Refactor this SQL query for readability..."}],
)
print(response.choices[0].message.content)Grok 4.7, Fable’ın milyon token başına $50 çıkış fiyatını, öncü yeteneklerin haklı çıkaracağı iddiasına karşı, net bir değer teklifi. Bu, yakın zamanda çıkan Flash modellerinde de gördüğümüz bir eğilime benziyor (bkz. DeepSeek V4.1 Flash vs Gemini 3.8 Flash).
Grok 4.6’nın $2/$6 fiyatını korurken öncüye yakın skorlar sergileyerek, SpaceXAI liderlik tablosundaki konum yerine sonuç başına maliyette yarışıyor.
Ben, yüksek hacimli kodlama, hukuk ajan işleri veya elektrik mühendisliği görevlerinde —ki kıyaslamalarda öne çıktığı ve düşük fiyatla hizalandığı yerler— Grok 4.7’ye geçerdim.
Kodlama liderlik tablosunun mutlak zirvesine ihtiyacınız varsa Fable 5.1 hâlâ kazanıyor ve Grok’un dar bağlam penceresi dokümantasyonu can sıkmaya devam ediyor.
Bu tür modellerle ajan iş akışları kurmayı bizzat denemek istiyorsanız, önce temeli atmak için AI Agent Fundamentals beceri yolumuzu öneririm.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



