
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
11.1K
Slechts enkele uren nadat Google Gemini 3.8 Flash onthulde, heeft Meta Muse Spark 1.3 uitgebracht, een update van zijn vlaggenschipmodelfamilie die zich richt op agent-werkstromen en coderen.
De release komt in een druk veld waar OpenAI's GPT-5.6 Sol, Anthropic's Claude Opus 5 en xAI's Grok 4.6 strijden om dezelfde aandacht van ontwikkelaars.
Muse Spark 1.3 wordt uitgerold in Muse Code en de Meta Model API, met behoud van een contextwindow van 1M tokens.
In vergelijkingen uitgevoerd door Meta-ingenieurs gebruikte het model ongeveer 20% minder toolcalls en 25% minder tokens dan Muse Spark 1.2, en Artificial Analysis scoorde de xhigh-variant op Intelligence Index 61 met een uitvoersnelheid van 182 tokens/sec.
In dit artikel behandel ik alles wat nieuw is in Muse Spark 1.3, met aandacht voor de agentische en codeerfuncties, de benchmarkresultaten en de prijsstelling
Om te vergelijken met de concurrentie, bekijk onze gidsen GPT-5.6 Terra vs Claude Sonnet 5 en Claude Opus 5 vs Claude Sonnet 5. Ik raad ook onze gids voor Meta's Muse Agent aan.
Muse Spark 1.3 is Meta's huidige vlaggenschipmodel, gepositioneerd als een incrementele update ten opzichte van Muse Spark 1.2 in plaats van een volledige herbouw.
Het verschijnt in twee varianten die in het onderzoek voorkomen:
De wijzigingen richten zich op twee hoofdgebieden: het volhouden van agentwerk over langere tijd en het opschonen van codeergedrag.
Meta trainde het model op een reeks harnassen zodat het generaliseert naar verschillende agentomgevingen, en voegde training toe op meer langlopende coderingstaken. Ze positioneren de release als een stap richting het gestelde doel van persoonlijke superintelligentie.
De belangrijkste conclusie die ik uit deze lancering trek, gaat over efficiëntie; Muse Spark 1.3 rondde technische vergelijkingen af met zo'n 20% minder toolcalls en 25% minder tokens dan 1.2.
Voor iedereen die per token betaalt op de Meta Model API is dat een directe kostenverlaging op dezelfde werkbelasting.
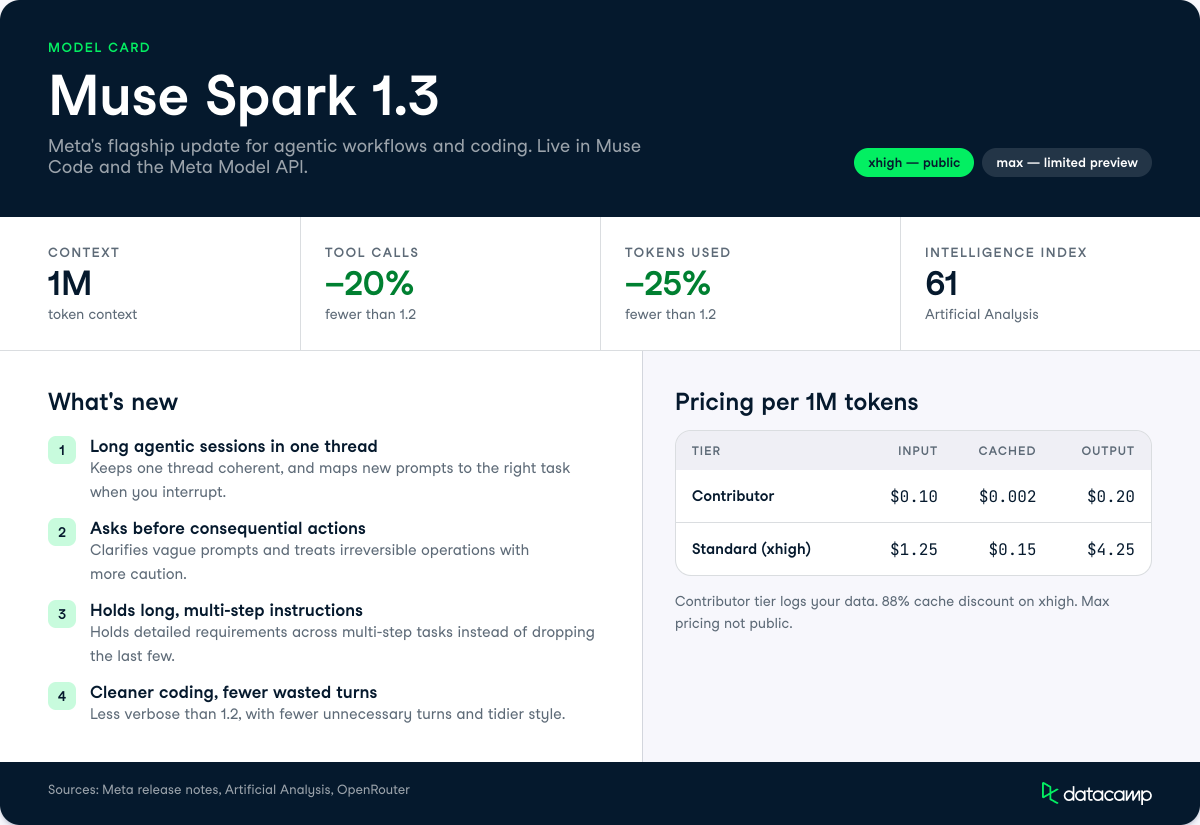
De updates in Muse Spark 1.3 draaien om hoe het model zich gedraagt tijdens lange agent-sessies en hoe het code schrijft en bewerkt.
Dit zijn de mogelijkheden die er voor mij uitspringen.
Muse Spark 1.3 is gebouwd om één lange thread coherent te houden terwijl het meerdere werkstromen tegelijk beheert.
Bij een open doelstelling gebruikt het tools om eigen context op te bouwen uit rommelige en tegenstrijdige bronnen, corrigeert het gaandeweg gaten in zijn plan en volgt het wat het heeft geleerd om een eindresultaat te leveren.
Meta heeft ook multitasking binnen een single-threaded context verbeterd.
Het model koppelt binnenkomende prompts aan de juiste taak, zelfs wanneer je een eerdere aanvraag bijstuurt of die halverwege onderbreekt, wat normaal de faalmodus is die lange agentsessies ontspoort.
Voor wie Muse Spark regelmatig gebruikt, is dit belangrijk omdat het meeste echte agentwerk geen nette, enkele instructie is. Het is een doorlopend gesprek waarin je van gedachten verandert, nieuwe randvoorwaarden toevoegt en taken pauzeert, en een model dat kwijtraakt bij welke taak een bericht hoort, wordt snel onbruikbaar.
Meta stelt dat Muse Spark 1.3 is getraind om met je samen te werken in plaats van door te denderen bij dubbelzinnige instructies. Dit betekent dat het verduidelijkingsvragen stelt wanneer een prompt vaag is, jou betrekt wanneer het vastloopt en bevestiging vraagt voor het uitvoeren van ingrijpende acties.
Bij lange taken past het zich aan jouw voorkeur voor updates aan. Je kunt het vaak laten rapporteren of stil op de achtergrond laten werken tot het een resultaat heeft, wat handig is als je een taak wilt starten en later terugkomt.
Meta verbeterde ook de kalibratie van het model bij onomkeerbare acties, zodat het een destructieve bewerking voorzichtiger behandelt dan een omkeerbare.
Dat kan een zinvolle veiligheidsklep zijn voor agents die bestanden aanraken, berichten versturen of shell-commando's uitvoeren.
Muse Spark 1.3 volgt complexe, langvormige instructies betrouwbaarder dan eerdere Muse Spark-versies.
Bij meerstapstaken meldt Meta dat het beter is in het behouden van gedetailleerde vereisten zonder randvoorwaarden te vergeten of af te dwalen van de gevraagde workflow.
Denk aan een verzoek als: stel een compliance-rapport op, haal cijfers uit een bijgevoegde spreadsheet, formatteer de getallen in twee tabellen, exporteer het als een PDF en orden het onder zes benoemde koppen. Eerdere modellen pakken vaak de eerste drie vereisten goed op en vergeten stilletjes de laatste twee.
Het model heeft ook beter zicht op zijn eigen grenzen.
Meta trainde het om te herkennen wanneer het vastloopt en dat te zeggen, in plaats van een uitkomst te hallucineren om compleet te lijken, al kwantificeert het onderzoek niet hoe vaak dit standhoudt.
Muse Spark 1.3 is getraind op meer langlopende coderingstaken en gedraagt zich beter in gangbare engineeringworkflows.
In vergelijking met Muse Spark 1.2 zegt Meta dat het minder onnodige beurten neemt, minder breedsprakig is en een schonere codeerstijl produceert.
De efficiëntiewinst is het tastbare deel: in vergelijkingen van Meta-ingenieurs gebruikte Muse Spark 1.3 ongeveer 20% minder toolcalls en 25% minder tokens dan 1.2.
Minder toolcalls betekent minder rondes en lagere latentie bij agentisch coderen, en minder tokens betekent lagere kosten per voltooide taak.
Een kanttekening die ik in communityrapporten heb gezien, is dat sommige Reddit-gebruikers het model frustrerend vonden omdat het zijn denkproces niet zichtbaar maakt, wat het debuggen van zijn codeerbeslissingen lastiger maakt dan bij modellen die redeneersporen tonen.
Meta publiceerde benchmarkscores in drie categorieën in de Muse Spark 1.3-release: agenttaken, long-context retrieval en coderen.
De onderstaande resultaten vergelijken de max-variant met Muse Spark 1.2 xhigh, GPT-5.6 Sol (max) en Claude Opus 5 (max).
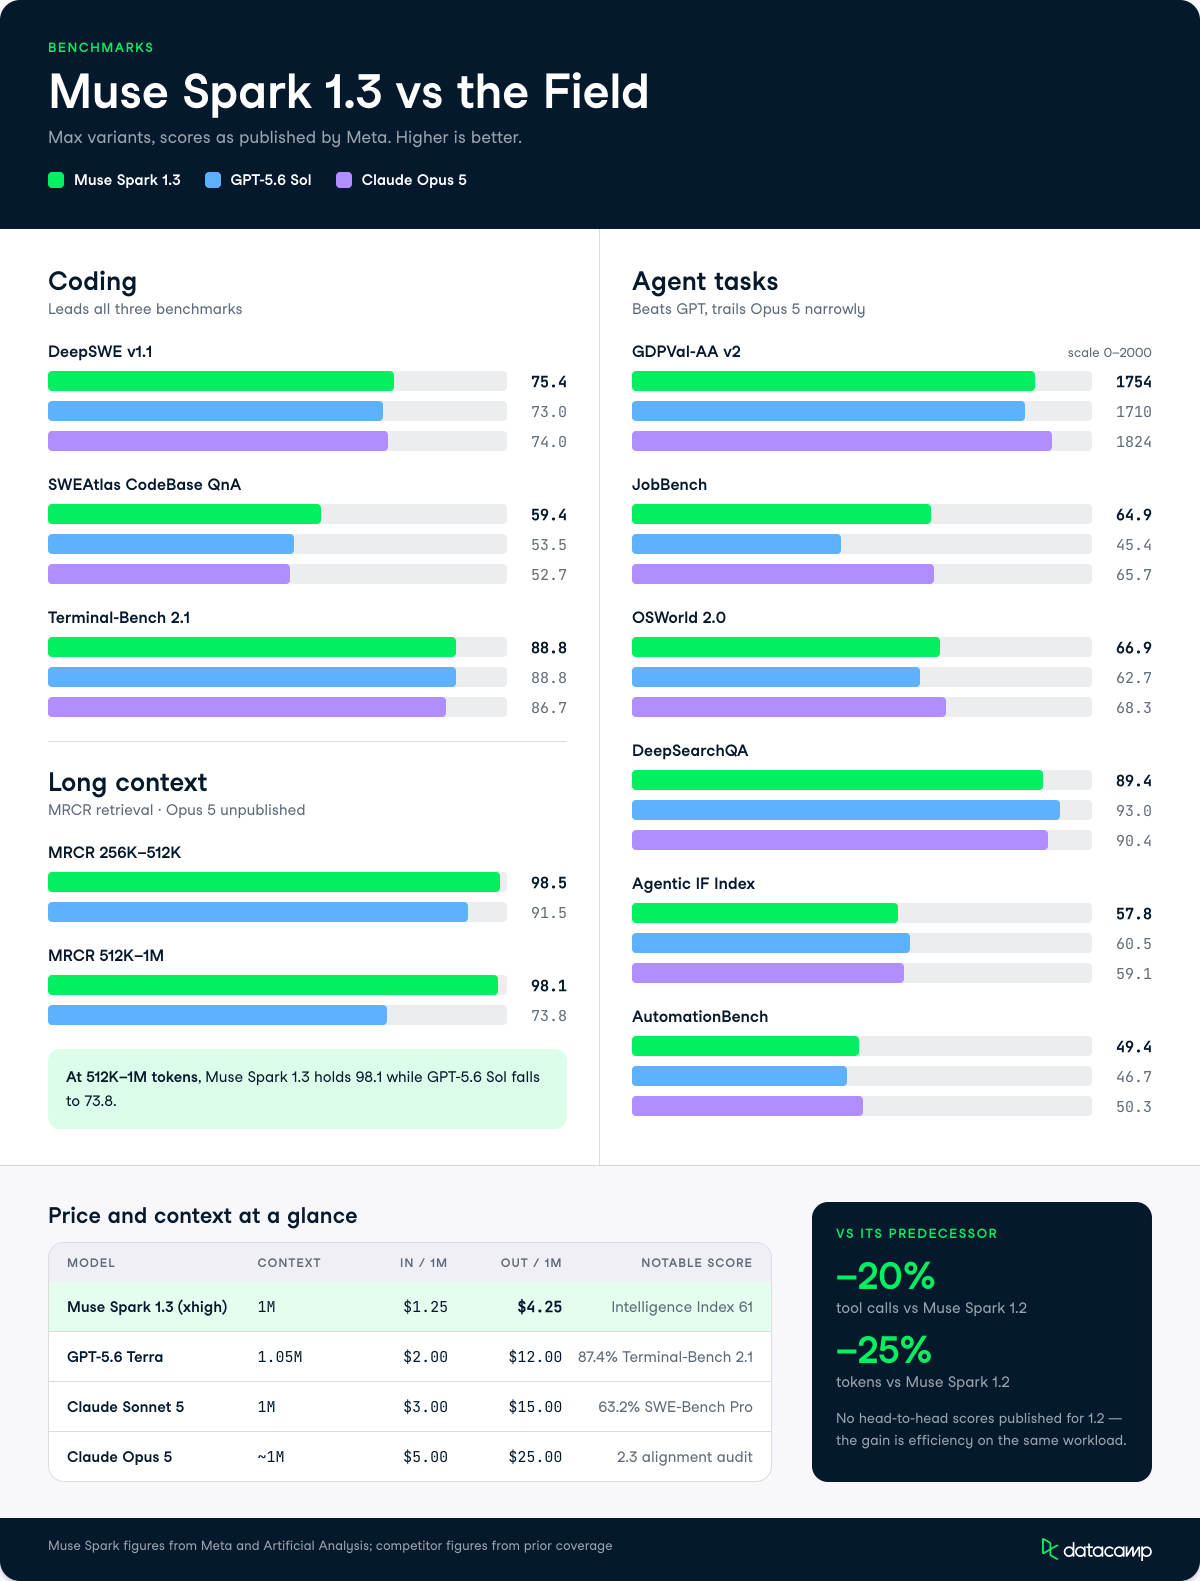
Coderen is waar Muse Spark 1.3 de sterkste case maakt. Het leidt alle drie benchmarks, waaronder een gelijke stand met GPT-5.6 Sol op Terminal-Bench 2.1.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| DeepSWE v1.1 | 75,4 | 73,0 | 74,0 |
| SWEAtlas CodeBase V&A | 59,4 | 53,5 | 52,7 |
| Terminal-Bench 2.1 | 88,8 | 88,8 | 86,7 |
Het DeepSWE v1.1-resultaat (75,4) springt eruit.
Die benchmark meet langlopende agentische codering, waarbij het model echte software-engineeringtaken autonoom moet voltooien.
Beide Opus 5 en GPT-5.6 Sol op die evaluatie verslaan is betekenisvol voor iedereen die codeeragents evalueert. T
De SWEAtlas-score voor begrip van codebases (59,4) vertelt een vergelijkbaar verhaal: Muse Spark 1.3 leest en redeneert beter over grote codebases dan beide directe rivalen hier.
Muse Spark 1.3 heeft een duidelijke voorsprong in long-context retrieval, vooral aan het uiteinde van het contextwindow waar de meeste modellen achteruitgaan.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) |
|---|---|---|
| MRCR 256K–512K | 98,5 | 91,5 |
| MRCR 512K–1M | 98,1 | 73,8 |
Bij 512K tot 1M tokens zakt GPT-5.6 Sol naar 73,8 terwijl Muse Spark 1.3 op 98,1 blijft. Als jouw werk inhoudt dat je volledige codebases, lange documentketens of uitgebreide agenttraces in één context voert, is dit de categorie die het meest telt. Scores voor Opus 5 zijn niet gepubliceerd voor MRCR, dus een directe driewegvergelijking is hier niet mogelijk.
Op agentbenchmarks zit Muse Spark 1.3 tussen GPT-5.6 Sol en Opus 5 in.
Het verslaat GPT op de meeste categorieën, maar blijft net achter op Opus 5 over de hele linie.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| GDPVal-AA v2 | 1754 | 1710 | 1824 |
| JobBench | 64,9 | 45,4 | 65,7 |
| OSWorld 2.0 | 66,9 | 62,7 | 68,3 |
| DeepSearchQA | 89,4 | 93,0 | 90,4 |
| Agentic IF Index | 57,8 | 60,5 | 59,1 |
| AutomationBench | 49,4 | 46,7 | 50,3 |
Het verschil op JobBench ten opzichte van GPT-5.6 Sol (64,9 vs 45,4) is de grootste marge in de agentcategorie en het vermelden waard voor iedereen die AI inzet in professionele workflows.
DeepSearchQA is het ene gebied waar GPT-5.6 Sol leidt (93,0 vs 89,4), en instructievolging (Agentic IF Index) is ook marginaal in het voordeel van GPT.
Bij computertaken (OSWorld 2.0) is Muse Spark 1.3 competitief met 66,9 tegenover 68,3 voor Opus 5.
Het algemene beeld: Muse Spark 1.3 leidt op coderen en long-context retrieval, is competitief op agenttaken en zit net achter Opus 5 op kenniswerk en algemene agentorkestratie.
Hier is een snel overzicht waarin Muse Spark 1.3 wordt vergeleken met de mid-tier- en vlaggenschipmodellen die we hebben beoordeeld.
Cijfers voor Muse Spark komen van Artificial Analysis; cijfers voor concurrenten komen uit onze eerdere verslaggeving.
| Model | Context | Input / 1M | Output / 1M | Opvallende score |
|---|---|---|---|---|
| Muse Spark 1.3 (xhigh) | 1M | $1,25 | $4,25 | Intelligence Index 61 |
| GPT-5.6 Terra | 1,05M | $2,00 | $12,00 | 87,4% Terminal-Bench 2.1 |
| Claude Sonnet 5 | 1M | $3,00 | $15,00 | 63,2% SWE-Bench Pro |
| Claude Opus 5 | ~1M | $5,00 | $25,00 | 2,3 alignment-audit |
Het prijsverschil is hier duidelijk; de outputtokens van Muse Spark 1.3 kosten ruwweg een derde van die van Sonnet 5 en een zesde van die van Opus 5.
Muse Spark 1.3 is per direct beschikbaar in Muse Code en de Meta Model API.
Meta for Developers merkte op dat bestaande gebruikers het model-ID kunnen wijzigen en dezelfde endpoints, SDK's en prijzen kunnen behouden, wat de upgrade laagdrempelig maakt.
De prijs op de Meta Model API hangt af van de laag, met een contributor-laag die je gegevens logt om Meta's producten te verbeteren tegen een lager tarief, en een standaardlaag die dat niet doet.
| Laag | Context | Input / 1M | Gecachte input / 1M | Output / 1M |
|---|---|---|---|---|
| Contributor (gegevens gebruikt om producten te verbeteren) | 1M | $0,10 | $0,002 | $0,20 |
| Standaard (xhigh) | 1M | $1,25 | $0,15 | $4,25 |
Artificial Analysis meldt een cachekorting van 88% op de xhigh-laag, en OpenRouter spiegelt de $1,25 input / $4,25 output-tarieven terwijl het add-ons zoals websearch vermeldt voor $2,50 per 1.000 calls.
Prijzen voor de max-variant waren nog niet publiek ten tijde van de release-analyse.
Er zijn twee beschikbaarheidskanttekeningen uit de community die het vermelden waard zijn op het moment van schrijven:
Muse Spark 1.3 is een gerichte update op efficiëntie en betrouwbaarheid in plaats van een sprong in mogelijkheden, en Meta is daar eerlijk over.
De 20% minder toolcalls en 25% minder tokens ten opzichte van 1.2 zijn de cijfers die het meest tellen voor iedereen die agents op schaal draait, omdat ze zich rechtstreeks vertalen naar lagere kosten en latentie.
Ik denk dat als je al in de Meta Model API of Muse Code zit, de drop-in upgrade met lager tokenverbruik een makkelijke ja is.
Als je een model vers kiest voor productie-agents, zou ik eerst willen zien hoe het model zich in de praktijk houdt en wat de prijs is van de max-variant voordat ik me eraan commit boven een goed gedocumenteerd alternatief.
Wil je de vaardigheden opbouwen om dit soort modellen te evalueren en in je eigen workflows te gebruiken, begin dan met onze AI Agent Fundamentals-skilltrack.
Topcursussen op DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

