Gids voor Big-O-notatie en tijdscomplexiteit: Intuïtie en wiskunde
Tijdscomplexiteit meet hoe de uitvoeringstijd van een algoritme schaalt met de invoergrootte, vaak uitgedrukt met Big-O-notatie, die een bovengrens geeft voor het worstcasescenario.
Analyse van tijdscomplexiteit biedt een manier om de efficiëntie van algoritmen te analyseren en te voorspellen, los van zowel de taal waarin we ze implementeren als de hardware waarop ze worden uitgevoerd.
Het doel van tijdscomplexiteitsanalyse is niet om de exacte runtime van een algoritme te voorspellen, maar om deze vragen te kunnen beantwoorden:
Als we twee algoritmen hebben die hetzelfde probleem oplossen, welke zal dan naar verwachting sneller draaien als ze dezelfde hoeveelheid data krijgen?
Als we de hoeveelheid data die aan het algoritme wordt gegeven verdubbelen, hoe wordt de uitvoeringstijd dan beïnvloed? Schaal het lineair en verdubbelt het ook? Blijft het hetzelfde? Of iets heel anders?
Aan het einde van dit artikel weet je hoe je de tijdscomplexiteit van een algoritme analyseert en deze vragen beantwoordt.
Is tijdscomplexiteit in 2024 nog relevant?
Computers worden steeds sneller, dus je zou je kunnen afvragen of het nog wel nodig is om je druk te maken over tijdscomplexiteit. Een supercomputer kan tegenwoordig toch elk probleem aan, ongeacht het algoritme dat we gebruiken?
Nou, niet helemaal. De AI-boom is grotendeels te danken aan enorme sprongen in hardwareprestaties in de afgelopen jaren. Maar zelfs op de meest geavanceerde hardware kunnen simpele problemen leiden tot rampzalige prestaties als je een traag algoritme gebruikt.
Stel je bijvoorbeeld voor dat je een naïef algoritme gebruikt om een databasetabel met tien miljoen records te sorteren. Zelfs op een moderne computer zou deze simpele bewerking meerdere dagen duren, waardoor de database onbruikbaar wordt voor elke praktische toepassing. Met een efficiënt algoritme duurt het daarentegen minder dan een tiende seconde.
Basisoperaties en basisinstructies
We analyseren een algoritme met behulp van het Random Access Machine-model (RAM of RA-machine). Dit model gaat ervan uit dat de volgende bewerkingen precies één tijdstap kosten:
Rekenkundige bewerkingen
Logische bewerkingen (<, >, ==, enz.)
Statements zoals ifof return
Toegang tot een geheugenlocatie, zoals het schrijven of lezen van een variabele
Deze bewerkingen noemen we basisoperaties. Een code-regel die een constant aantal basisoperaties uitvoert, noemen we een basisinstructie.
Omdat het aantal operaties in een basisinstructie constant is, hangt het niet af van de hoeveelheid data. Aangezien we willen weten hoe de uitvoeringstijd groeit naarmate de hoeveelheid data groeit, kunnen we ons richten op het tellen van het aantal basisinstructies dat het algoritme uitvoert.
Functieaanroepen en lussen zoals for en while beoordelen we door het aantal basisinstructies binnenin op te tellen. Bekijk de volgende code die de elementen van een lijst optelt.
defsum_list(lst):
total =0# 1 instructionfor value in lst:
total += value # executed len(lst) timesreturn total # 1 instructionMogelijk gemaakt door
We hebben commentaar toegevoegd aan elke regel om het aantal basisinstructies te visualiseren. Als N de lengte van lst is, dan is het totale aantal basisinstructies 1 + N + 1 = N + 2.
Big-O-notatie
Stel dat we twee sorteeralgoritmen hebben. We hebben het aantal basisinstructies voor elk berekend en de volgende uitdrukkingen gekregen:
Eerste algoritme
Tweede algoritme
4N2 + 2N + 7
3N2 + 5N + 13
Op het eerste gezicht is het niet duidelijk welke beter schaalt. Big-O-notatie biedt een manier om deze uitdrukkingen verder te vereenvoudigen door deze stappen toe te passen:
Laat de termen met lagere exponenten weg
Verwijder vermenigvuldigingsconstanten
Als we dit proces op beide uitdrukkingen toepassen, krijgen we in beide gevallen N2:
De uitdrukking die we na vereenvoudiging krijgen is de tijdscomplexiteit van het algoritme, die we noteren met O(). In dit geval kunnen we schrijven dat 4N2 + 2N + 7 = O(N2) en 3N2 + 5N + 13 = O(N2). Dit betekent dat beide algoritmen dezelfde tijdscomplexiteit hebben, die evenredig is met het kwadraat van het aantal elementen in de lijst.
Hierboven berekenden we dat het sum_list-algoritme N + 2 operaties uitvoerde, waarbij N de lengte van de lijst is. Toegepast op dezelfde vereenvoudigingen, verkrijgen we N, dus de tijdscomplexiteit van sum_list is O(N).
Dit betekent dat de uitvoeringstijd evenredig is met de lijstgrootte. Dat is te verwachten, want bij het berekenen van de som vereist een verdubbeling van het aantal elementen ongeveer een verdubbeling van het werk: niet minder en niet meer.
Big-O-notatie: intuïtieve uitleg
We kunnen de lagere termen negeren omdat hun invloed op de totale som verwaarloosbaar wordt naarmate N groeit, vergeleken met de hoogste term. De volgende grafiek toont de bijdrage van elk van de drie termen 4N2, 2N en 7 aan de totale som.
De kwadratische term 4N2 bepaalt al snel bijna 100% van het totale aantal operaties, zelfs voor kleine waarden van N. Bij grote hoeveelheden data is de tijd van termen met lagere orde dus te verwaarlozen ten opzichte van die met hogere orde.
We laten de vermenigvuldigingsconstante weg omdat deze waarde onafhankelijk is van de hoeveelheid data.
Big-O-notatie: wiskundige definitie
Bovenstaande stappen zijn voor de meeste praktische doeleinden voldoende om de tijdscomplexiteit van een algoritme correct af te leiden. We tellen het aantal basisinstructies dat een algoritme uitvoert en verkrijgen zo een uitdrukking f(N). Na de twee vereenvoudigingsstappen krijgen we een vereenvoudigde uitdrukking g(N). Dan kunnen we schrijven dat f(N) = O(g(N)). We lezen dit als: “f is big O van g”.
Dit is echter geen formele wiskundige definitie en is in sommige gevallen niet voldoende.
De wiskundige definitie is dat een positieve functie f(N) = O(g(N)) als we een constante C kunnen vinden zodat voor grote waarden van N het volgende geldt:
f(N) ≤ C × g(N)
We kunnen deze definitie gebruiken om te laten zien dat f(N) = 4N2 + 2N + 7 = O(N2). In dit geval kunnen we C = 5 kiezen en zien dat voor elke N > 4, f(N) ≤ 5 × N2:
In de praktijk gebruiken we gewoon de bovenstaande vereenvoudigingsregels.
Soorten tijdscomplexiteit
Nu we de basis van Big-O-notatie begrijpen, bekijken we veelvoorkomende tijdscomplexiteiten en hun gevolgen, te beginnen met de meest efficiënte: constante tijd.
Constante tijd: O(1)
Zoals de naam al aangeeft, hebben algoritmen met constante tijd een constante tijdscomplexiteit: hun prestaties hangen niet af van de hoeveelheid data. Deze algoritmen omvatten doorgaans berekeningen met een vast aantal inputs, zoals het berekenen van de afstand tussen twee punten.
De afstand tussen twee punten wordt berekend door de vierkantswortel te nemen van de verschillen tussen de x- en y-coördinaten van de twee punten.
De functie dist hieronder berekent de afstand tussen twee punten. Ze bestaat uit drie basisinstructies, wat een constante is. In dit geval schrijven we dat de tijdscomplexiteit O(1) is.
defdist(p, q):
dx =(p[0]- q[0])**2# 1 instruction
dy =(p[1]- q[1])**2# 1 instructionreturn(dx + dy)**0.5# 1 instructionMogelijk gemaakt door
Interessant genoeg kan een functie een constante tijdscomplexiteit hebben, zelfs bij het verwerken van grote datasets. Neem bijvoorbeeld het bepalen van de lengte van een lijst met de functie len. Deze bewerking is O(1) omdat de implementatie intern de grootte van de lijst bijhoudt, zodat de elementen niet telkens opnieuw hoeven te worden geteld.
Lineaire tijd: O(N)
We hebben sum_list eerder al besproken als voorbeeld van een functie met lineaire tijd. In het algemeen voeren lineaire-algoritmen taken uit die elk datapunt afzonderlijk moeten inspecteren. Het berekenen van het minimum, maximum of gemiddelde is een typische bewerking in deze categorie.
Laten we oefenen door de volgende functie te analyseren die de minimumwaarde van een lijst berekent:
defminimum(lst):
min_value = lst[0]# 1 instructionfor i inrange(1,len(lst)):
min_value =min(min_value, lst[i])# executed len(lst) - 1 timesreturn min_value # 1 instructionMogelijk gemaakt door
Als de lijst N elementen heeft, is de complexiteit 1 + (N - 1) + 1 = N + 1 = O(N).
De uitvoeringstijd van lineaire algoritmen is recht evenredig met de hoeveelheid data. Als de hoeveelheid data dus verdubbelt, zou de tijd die het algoritme nodig heeft ook ongeveer moeten verdubbelen.
Logaritmische tijd: O(log(N))
Het getallenraadspel draait om het raden van een verborgen getal tussen 1 en N, met zo min mogelijk pogingen. Na elke gok krijg je feedback of het verborgen getal hoger, lager of gelijk is aan je gok. Als de gok klopt, win je; anders ga je door met raden.
Een effectieve strategie voor dit spel is om steeds het midden te raden. Stel N = 15. Dan is onze eerste gok 8. Als het geheime getal kleiner is dan 8, weten we dat het tussen 1 en 7 ligt. Is het groter, dan ligt het tussen 9 en 15. We blijven het midden van het resterende bereik raden totdat we het juiste antwoord vinden. Het onderstaande diagram illustreert de mogelijke paden van deze strategie.
Laten we de tijdscomplexiteit van deze aanpak bekijken. In tegenstelling tot de vorige voorbeelden hangt het aantal stappen niet alleen af van de invoergrootte N, omdat je in theorie al bij de eerste poging goed kunt raden.
Bij het analyseren van dit soort algoritmen concentreren we ons op het worstcasescenario. Bijvoorbeeld, bij N = 15 hebben we in het slechtste geval 4 pogingen nodig. Elke gok, het midden, elimineert de helft van de resterende mogelijkheden. In het worstcasescenario blijven we raden tot er nog maar één mogelijkheid over is. De vraag die we dus moeten beantwoorden is:
Hoe vaak moeten we N door 2 delen om 1 te krijgen?
Het antwoord is de logaritme met grondtal 2 van N, genoteerd als log2(N). Het algoritme dat we gebruiken om het juiste getal te vinden heet binaire zoekopdracht. Aangezien het maximaal aantal gissingen log2(N) is, kunnen we de complexiteit schrijven als O(log2(N)) of simpelweg O(log(N)), omdat constanten in tijdscomplexiteit onbelangrijk zijn.
Vanwege de extreem trage groeisnelheid is logaritmische tijdscomplexiteit in de praktijk zeer gewild en gedraagt het zich bijna als constante tijd. Zelfs voor grote N blijft het aantal operaties opvallend laag. Als N bijvoorbeeld één miljard is, zijn er slechts zo'n 30 operaties nodig.
Binaire zoekopdracht is een fundamenteel algoritme in de informatica met talloze toepassingen. In natural language processing kunnen spellingscontrole en autocorrect varianten van binaire zoekopdracht gebruiken om efficiënt mogelijke kandidaatwoorden te vinden.
Kwadratische tijd: O(N2)
Data sorteren is een kernactiviteit die computers vaak moeten uitvoeren. Eén methode om een lijst van N getallen te sorteren is door herhaaldelijk het minimum van de lijst te nemen.
defselection_sort(lst):
sorted_lst =[]# 1 instructionfor _ inrange(len(lst)):
minimum =min(lst)# executed len(lst) times
lst.remove(minimum)# executed len(lst) times
sorted_lst.append(minimum)# executed len(lst) timesreturn sorted_lst # 1 instructionMogelijk gemaakt door
Om de complexiteit van een for-lus te analyseren, evalueren we de complexiteit van de instructies erin en vermenigvuldigen dat met het aantal iteraties dat de lus wordt uitgevoerd.
Het minimum van een lijst bepalen en een element uit een lijst verwijderen zijn beide O(N)-operaties. Toevoegen gebeurt in constante tijd, O(1). Elke iteratie van de for-lus heeft daarom complexiteit O(N + N + 1) = O(2N + 1), wat vereenvoudigt tot O(N). Aangezien er N iteraties zijn, is de complexiteit N × O(N) = O(N2). De rest van de functie selection_sort() bestaat uit drie eenvoudige instructies, dus de totale complexiteit is O(N2 + 3) = O(N2).
Onze analyse van de for-lus was een vereenvoudiging. In elke iteratie verwijderen we één element uit de lijst, wat betekent dat niet alle iteraties hetzelfde aantal instructies uitvoeren. De eerste iteratie voert N instructies uit, de tweede N - 1, de derde N - 2, enzovoort, tot de laatste iteratie, die er nog maar 1 uitvoert.
Dit impliceert dat de werkelijke complexiteit van de for-lus is:
N + (N - 1) + (N - 2) + … + 1
Deze som is gelijk aan (N2 + N) / 2. Maar,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Hoewel we te veel telden, blijft de totale complexiteit kwadratisch. De functie selection_sort() is een voorbeeld van een langzamer sorteeralgoritme vanwege de kwadratische complexiteit, O(N2).
Functies met kwadratische complexiteit schalen slecht. Ze zijn geschikt voor kleine lijsten, maar onpraktisch om miljoenen datapunten te sorteren: dat kan dagen duren. Een verdubbeling van de data zorgt voor een verviervoudiging van de uitvoeringstijd.
Loglineaire tijd: O(Nlog(N))
Het is mogelijk om een algoritme te bedenken dat een lijst sorteert met een tijdscomplexiteit van O(N log(N)). Zo'n algoritme heet mergesort. We gaan niet in op de implementatiedetails, maar als je er meer over wilt leren, bekijk dan deze korte introductie tot mergesort uit deze cursus over Data Structures and Algorithms in Python.
Zoals eerder genoemd gedraagt logaritmische complexiteit zich in de praktijk vergelijkbaar met constante complexiteit. Daarom kan de uitvoeringstijd van een O(N log(N))-algoritme in de echte wereld vergelijkbaar zijn met die van een lineair algoritme.
De onderstaande grafiek laat zien dat N log(N) en N met vergelijkbare snelheid groeien, terwijl N2 heel snel groeit en daardoor snel heel traag wordt.
Kubische tijd: O(N3)
Een veelgebruikt algoritme met kubische tijdscomplexiteit in AI is matrixvermenigvuldiging, dat een cruciale rol speelt in de werking van grote taalmodellen zoals GPT. Dit algoritme is bepalend voor de berekeningen tijdens zowel training als inferentie.
Om twee N bij N-matrices, A en B, te vermenigvuldigen, moeten we elke rij van de eerste matrix A vermenigvuldigen met elke kolom van de tweede matrix B. Concreet: de waarde van het product op positie (i, j) wordt bepaald door de elementen in rij i van A te vermenigvuldigen met de overeenkomstige elementen in kolom j van B.
Hier is een Python-implementatie van matrixvermenigvuldiging:
defmatrix_mul(A, B):
n =len(A)# 1 instruction
res =[[0for _ inrange(n)]for _ inrange(n)]# N^2 instructionsfor i inrange(n):for j inrange(n):for k inrange(n):
res[i][j]+= A[i][k]* B[k][j]# executed N×N×N = N^3 timesreturn res # 1 instructionMogelijk gemaakt door
In totaal voert matrix_mul() N3 + N2 + 2 instructies uit, dus de tijdscomplexiteit is O(N3).
We hadden de complexiteit ook kunnen analyseren door te redeneren over de berekeningen. Het resultaat van de matrixvermenigvuldiging heeft N2 elementen. Elk element kost O(N) tijd om te berekenen, dus de totale complexiteit is N2 × O(N) = O(N3).
Algoritmen met kubische tijd zijn erg traag. Een verdubbeling van de hoeveelheid data leidt tot een factor acht in de uitvoeringstijd, waardoor zulke algoritmen erg slecht schalen. Zelfs voor relatief kleine N explodeert het aantal instructies al snel.
Matrixvermenigvuldiging is een voorbeeld van een computationele uitdaging waarbij hardware-ontwikkelingen veel impact hebben gehad. Hoewel er iets efficiëntere algoritmen bestaan voor matrixvermenigvuldiging, zijn het vooral de innovaties in het ontwerp van GPU-chips — specifiek afgestemd op matrixvermenigvuldiging — die het trainen van grote modellen zoals GPT binnen redelijke tijd sterk hebben vergemakkelijkt.
Recentelijk hebben onderzoekers voorgesteld om matrixvermenigvuldiging uit grote leermodellen te schrappen — je leest hier meer over in dit artikel over MatMul-Free LLM’s: kernconcepten uitgelegd.
Exponentiële tijdscomplexiteit: O(2N) en O(N!)
Exponentiële algoritmen ontstaan vaak wanneer een probleem wordt opgelost door alle mogelijke oplossingen te verkennen. Stel dat je een route moet plannen voor een bezorgwagen die N afleverlocaties moet bezoeken. Eén aanpak is om elke mogelijke volgorde te evalueren. Het Python-pakket itertoolsbiedt een eenvoudige manier om alle permutaties van een lijst te doorlopen.
import itertools
for order in itertools.permutations([1,2,3]):print(order)Mogelijk gemaakt door
Het aantal permutaties van een lijst van lengte N noteren we als N!, uitgesproken als “N faculteit”. De faculteitsfunctie groeit exponentieel. Bijvoorbeeld, bij N = 13 is het aantal permutaties meer dan 1 miljard.
Stel dat de afleverlocaties worden gegeven als een lijst van 2D-punten. Dan kunnen we de volgorde bepalen die de totale afstand minimaliseert door alle mogelijke volgordes te doorlopen en de beste bij te houden.
defoptimize_route(locations):
minimum_distance =float("inf")# 1 instruction
best_order =None# 1 instructionfor order in itertools.permutations(locations):# N! iterations
distance =0# 1 instruction, N! timesfor i inrange(1,len(order)):
distance += dist(order[i -1], order[i])# N-1 instructions, N! timesif distance < minimum_distance:
distance = minimum_distance # 1 instruction, N! times
best_order = order # 1 instruction, N! timesreturn best_order # 1 instructionMogelijk gemaakt door
De eerste for-lus wordt N! keer uitgevoerd. Het aantal operaties in optimize_route() is dus N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.
We hebben geleerd dat we bij het berekenen van tijdscomplexiteit termen met lagere exponenten negeren. In dit scenario komen we echter een N!-term tegen, die geen macht van N is. We kunnen onze vereenvoudiging verfijnen door de termen met een tragere groei weg te laten. De onderstaande tabel geeft termen die vaak voorkomen in tijdscomplexiteit, gerangschikt van laagste naar hoogste groeisnelheid.
1
log(N)
N
N2
N3
Nk
2N
N!
We kunnen de tijdscomplexiteit van optimize_route() dus schrijven als N! x N + 2N! + 3 = O(N! x N).
Exponentiële algoritmen zijn doorgaans alleen efficiënt voor zeer kleine gevallen. Zelfs met slechts 13 locaties is het aantal permutaties meer dan 1 miljard, wat dit algoritme onpraktisch maakt voor echte scenario’s.
Tijdscomplexiteit: worst case en best case
Bij het getallenraadspel focusten we op de worstcase-complexiteit. Door op de worst case te focussen, garanderen we de groeisnelheid van de uitvoeringstijd van het algoritme.
In het beste geval raden we in één keer goed, dus een bestcase-analyse levert O(1) op. Dat klopt — in het beste geval is er één constante bewerking nodig. Maar dat is niet erg nuttig, want de kans daarop is klein.
In het algemeen richten we ons bij de analyse van een algoritme altijd op de worst case omdat:
Prestatiegarantie: Door op de worstcase-complexiteit te focussen, kunnen we waarborgen dat ons algoritme nooit slechter presteert dan een bepaalde drempel. Dit is cruciaal voor toepassingen die betrouwbare prestaties vereisen, zoals realtime systemen, waar vertragingen grote problemen kunnen veroorzaken.
Veiligheid en betrouwbaarheid: Worstcase-analyse helpt bij het ontwerpen van robuuste algoritmen die de meest veeleisende scenario’s aankunnen. Het zorgt ervoor dat het algoritme binnen aanvaardbare grenzen blijft functioneren, zelfs in de slechtst mogelijke situaties.
Bovengrens: Kennis van de worstcase-complexiteit geeft ons een bovengrens op de prestaties. Dit is nuttig om te begrijpen welke maximale resources (tijd, geheugen) een algoritme kan vereisen.
Tijdscomplexiteit: praktische implicaties
Tijdscomplexiteit lijkt misschien erg theoretisch, maar kan in de praktijk heel nuttig zijn.
Als een functie bijvoorbeeld consequent een kleine dataset verwerkt, kan een eenvoudig te begrijpen O(N2)-algoritme geschikter zijn dan een complex en lastig te onderhouden O(N)-algoritme. Dit moet echter een bewuste keuze zijn, om te voorkomen dat je voor verrassingen komt te staan wanneer de applicatie groeiend verkeer niet aankan.
Tijdscomplexiteitsanalyse laat zien dat kleine code-optimalisaties nauwelijks effect hebben op de uitvoeringstijd van een algoritme. Grote verbeteringen bereik je door het aantal basisoperaties dat nodig is om het resultaat te berekenen fundamenteel te verlagen. Over het algemeen is het beter om schone en begrijpelijke code te behouden dan te optimaliseren tot het onbegrijpelijk wordt.
Langzamere delen van de code zullen de rest domineren. Het is meestal zinloos om het snellere deel te optimaliseren voordat je het tragere deel hebt verbeterd. Stel bijvoorbeeld dat we een functie hebben die twee taken uitvoert:
Als de functie clean_data() complexiteit O(N2) heeft en analyze_data() complexiteit O(N3), dan zal het terugbrengen van de complexiteit van clean_data() de totale complexiteit van process_data() niet verbeteren. Het is beter om je te richten op het verbeteren van analyze_data().
Daarnaast kan tijdscomplexiteit hardwarekeuzes informeren. Een O(N3)-algoritme kan, ondanks de slechte schaalbaarheid, toch snel genoeg zijn voor taken met beperkte data als het draait op betere hardware of in een snellere programmeertaal. Als een algoritme daarentegen exponentiële tijdscomplexiteit O(2N) heeft, is geen hardware-upgrade voldoende en is een efficiënter algoritme nodig.
Conclusie
Hoewel computers sneller worden, hebben we met meer data dan ooit te maken. Zie het zo: elke keer dat we het internet, smartphones of slimme apparaten gebruiken, creëren we bergen informatie. Naarmate deze berg groeit, wordt het lastiger om erdoorheen te sorteren en het relevante te vinden. Daarom is het belangrijk om onze tools — en vooral algoritmen — steeds beter te maken in het verwerken en begrijpen van al die informatie.
Tijdscomplexiteitsanalyse biedt een eenvoudige kapstok om na te denken over de uitvoeringstijd van een algoritme. Het primaire doel is inzicht geven in de groeisnelheid van de tijdscomplexiteit, niet het voorspellen van exacte tijden. Ondanks de vele vereenvoudigingen en aannames is het in de praktijk enorm nuttig gebleken en dekt het goed de essentie van het uitvoeringsgedrag van algoritmen.
Hoe weet ik de tijdscomplexiteit van ingebouwde Python-functies? ⌄
Soms vermeldt de documentatie de complexiteit. Anders is het bekijken en analyseren van de broncode een goede oefening. De meeste talen hanteren standaardimplementaties voor veelgebruikte datastructuren zoals lijsten en woordenboeken, dus het opzoeken van de complexiteit van deze datastructuren levert het juiste antwoord op. We raden aan een algemene cursus datastructuren en algoritmen te volgen om de complexiteit van veelvoorkomende operaties beter te begrijpen.
Is een complexiteit van de vorm O(N^k) altijd beter dan O(2^N), ongeacht de waarde van k?⌄
Theoretisch gezien wel. Voor voldoende grote N wordt het algoritme met exponentiële tijd uiteindelijk trager. Het exponentiële algoritme kan echter veel beter presteren voor kleine waarden van N. In enkele zeldzame gevallen werken we alleen met kleine datasets, en dan kan het O(2N)-algoritme de voorkeur hebben.
Bestaan er andere complexiteitsfuncties dan die we hier hebben geleerd?⌄
Ja. Er bestaan algoritmen met heel vreemde complexiteitsfuncties, maar voor vrijwel alle algoritmen zal de complexiteit alleen de functies omvatten die we in dit artikel noemen.
Hoe weet ik of het mogelijk is om een beter algoritme te vinden?⌄
Dit is in het algemeen een lastige vraag. Bewijzen dat er geen algoritme met een betere tijdscomplexiteit bestaat, vereist redeneren over het probleem en aantonen dat het onmogelijk is om het met minder operaties op te lossen. Soms is het eenvoudig. Zo is het bijvoorbeeld onmogelijk om een algoritme te hebben met een lagere complexiteit dan O(N) om te bepalen of een lijst een bepaalde waarde bevat, omdat we in het worstcasescenario alle elementen moeten bekijken om het antwoord te vinden.
Hoe analyseren we de tijdscomplexiteit als het algoritme willekeur bevat?⌄
Zelfs met willekeurigheid is het vaak mogelijk om te redeneren over het slechtst mogelijke geval van de uitkomsten en daaruit de complexiteit af te leiden. Alternatief analyseren we voor sommige gerandomiseerde algoritmen de gemiddelde complexiteit door het verwachte aantal operaties te bestuderen.
Full-stack engineer & oprichter bij CheapGPT. Lesgeven is altijd mijn passie geweest. Al vanaf mijn studententijd zocht ik actief naar kansen om bijles te geven en andere studenten te helpen. Die passie bracht me ertoe om te promoveren, waarbij ik ook als onderwijsassistent werkte ter ondersteuning van mijn academische werk. In die jaren vond ik veel voldoening in de traditionele klasomgeving, waar ik verbindingen kon leggen en leren kon begeleiden. Met de opkomst van online leerplatforms zag ik echter het transformerende potentieel van digitaal onderwijs. Sterker nog, ik was actief betrokken bij de ontwikkeling van zo’n platform op onze universiteit. Ik zet me sterk in om traditionele didactische principes te combineren met innovatieve digitale methoden. Mijn passie is om cursussen te maken die niet alleen boeiend en informatief zijn, maar ook toegankelijk voor lerenden in dit digitale tijdperk.




Analyse van tijdscomplexiteit biedt een manier om de efficiëntie van algoritmen te analyseren en te voorspellen, los van zowel de taal waarin we ze implementeren als de hardware waarop ze worden uitgevoerd.
Het doel van tijdscomplexiteitsanalyse is niet om de exacte runtime van een algoritme te voorspellen, maar om deze vragen te kunnen beantwoorden:
Aan het einde van dit artikel weet je hoe je de tijdscomplexiteit van een algoritme analyseert en deze vragen beantwoordt.
Is tijdscomplexiteit in 2024 nog relevant?
Computers worden steeds sneller, dus je zou je kunnen afvragen of het nog wel nodig is om je druk te maken over tijdscomplexiteit. Een supercomputer kan tegenwoordig toch elk probleem aan, ongeacht het algoritme dat we gebruiken?
Nou, niet helemaal. De AI-boom is grotendeels te danken aan enorme sprongen in hardwareprestaties in de afgelopen jaren. Maar zelfs op de meest geavanceerde hardware kunnen simpele problemen leiden tot rampzalige prestaties als je een traag algoritme gebruikt.
Stel je bijvoorbeeld voor dat je een naïef algoritme gebruikt om een databasetabel met tien miljoen records te sorteren. Zelfs op een moderne computer zou deze simpele bewerking meerdere dagen duren, waardoor de database onbruikbaar wordt voor elke praktische toepassing. Met een efficiënt algoritme duurt het daarentegen minder dan een tiende seconde.
Basisoperaties en basisinstructies
We analyseren een algoritme met behulp van het Random Access Machine-model (RAM of RA-machine). Dit model gaat ervan uit dat de volgende bewerkingen precies één tijdstap kosten:
ifofreturnDeze bewerkingen noemen we basisoperaties. Een code-regel die een constant aantal basisoperaties uitvoert, noemen we een basisinstructie.
Omdat het aantal operaties in een basisinstructie constant is, hangt het niet af van de hoeveelheid data. Aangezien we willen weten hoe de uitvoeringstijd groeit naarmate de hoeveelheid data groeit, kunnen we ons richten op het tellen van het aantal basisinstructies dat het algoritme uitvoert.
Functieaanroepen en lussen zoals
forenwhilebeoordelen we door het aantal basisinstructies binnenin op te tellen. Bekijk de volgende code die de elementen van een lijst optelt.We hebben commentaar toegevoegd aan elke regel om het aantal basisinstructies te visualiseren. Als N de lengte van
lstis, dan is het totale aantal basisinstructies 1 + N + 1 = N + 2.Big-O-notatie
Stel dat we twee sorteeralgoritmen hebben. We hebben het aantal basisinstructies voor elk berekend en de volgende uitdrukkingen gekregen:
Eerste algoritme
Tweede algoritme
4N2 + 2N + 7
3N2 + 5N + 13
Op het eerste gezicht is het niet duidelijk welke beter schaalt. Big-O-notatie biedt een manier om deze uitdrukkingen verder te vereenvoudigen door deze stappen toe te passen:
Als we dit proces op beide uitdrukkingen toepassen, krijgen we in beide gevallen N2:
De uitdrukking die we na vereenvoudiging krijgen is de tijdscomplexiteit van het algoritme, die we noteren met O(). In dit geval kunnen we schrijven dat 4N2 + 2N + 7 = O(N2) en 3N2 + 5N + 13 = O(N2). Dit betekent dat beide algoritmen dezelfde tijdscomplexiteit hebben, die evenredig is met het kwadraat van het aantal elementen in de lijst.
Hierboven berekenden we dat het
sum_list-algoritme N + 2 operaties uitvoerde, waarbij N de lengte van de lijst is. Toegepast op dezelfde vereenvoudigingen, verkrijgen we N, dus de tijdscomplexiteit vansum_listis O(N).Dit betekent dat de uitvoeringstijd evenredig is met de lijstgrootte. Dat is te verwachten, want bij het berekenen van de som vereist een verdubbeling van het aantal elementen ongeveer een verdubbeling van het werk: niet minder en niet meer.
Big-O-notatie: intuïtieve uitleg
We kunnen de lagere termen negeren omdat hun invloed op de totale som verwaarloosbaar wordt naarmate N groeit, vergeleken met de hoogste term. De volgende grafiek toont de bijdrage van elk van de drie termen 4N2, 2N en 7 aan de totale som.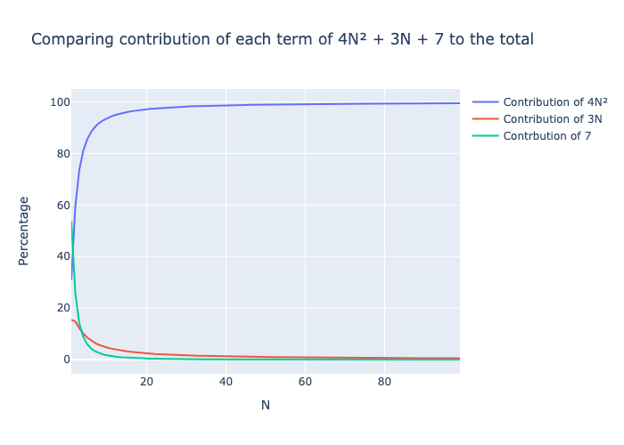
De kwadratische term 4N2 bepaalt al snel bijna 100% van het totale aantal operaties, zelfs voor kleine waarden van N. Bij grote hoeveelheden data is de tijd van termen met lagere orde dus te verwaarlozen ten opzichte van die met hogere orde.
We laten de vermenigvuldigingsconstante weg omdat deze waarde onafhankelijk is van de hoeveelheid data.
Big-O-notatie: wiskundige definitie
Bovenstaande stappen zijn voor de meeste praktische doeleinden voldoende om de tijdscomplexiteit van een algoritme correct af te leiden. We tellen het aantal basisinstructies dat een algoritme uitvoert en verkrijgen zo een uitdrukking f(N). Na de twee vereenvoudigingsstappen krijgen we een vereenvoudigde uitdrukking g(N). Dan kunnen we schrijven dat f(N) = O(g(N)). We lezen dit als: “f is big O van g”.
Dit is echter geen formele wiskundige definitie en is in sommige gevallen niet voldoende.
De wiskundige definitie is dat een positieve functie f(N) = O(g(N)) als we een constante C kunnen vinden zodat voor grote waarden van N het volgende geldt:
f(N) ≤ C × g(N)
We kunnen deze definitie gebruiken om te laten zien dat f(N) = 4N2 + 2N + 7 = O(N2). In dit geval kunnen we C = 5 kiezen en zien dat voor elke N > 4, f(N) ≤ 5 × N2:
In de praktijk gebruiken we gewoon de bovenstaande vereenvoudigingsregels.
Soorten tijdscomplexiteit
Nu we de basis van Big-O-notatie begrijpen, bekijken we veelvoorkomende tijdscomplexiteiten en hun gevolgen, te beginnen met de meest efficiënte: constante tijd.
Constante tijd: O(1)
Zoals de naam al aangeeft, hebben algoritmen met constante tijd een constante tijdscomplexiteit: hun prestaties hangen niet af van de hoeveelheid data. Deze algoritmen omvatten doorgaans berekeningen met een vast aantal inputs, zoals het berekenen van de afstand tussen twee punten.
De afstand tussen twee punten wordt berekend door de vierkantswortel te nemen van de verschillen tussen de x- en y-coördinaten van de twee punten.
De functie
disthieronder berekent de afstand tussen twee punten. Ze bestaat uit drie basisinstructies, wat een constante is. In dit geval schrijven we dat de tijdscomplexiteit O(1) is.Interessant genoeg kan een functie een constante tijdscomplexiteit hebben, zelfs bij het verwerken van grote datasets. Neem bijvoorbeeld het bepalen van de lengte van een lijst met de functie len. Deze bewerking is O(1) omdat de implementatie intern de grootte van de lijst bijhoudt, zodat de elementen niet telkens opnieuw hoeven te worden geteld.
Lineaire tijd: O(N)
We hebben
sum_listeerder al besproken als voorbeeld van een functie met lineaire tijd. In het algemeen voeren lineaire-algoritmen taken uit die elk datapunt afzonderlijk moeten inspecteren. Het berekenen van het minimum, maximum of gemiddelde is een typische bewerking in deze categorie.Laten we oefenen door de volgende functie te analyseren die de minimumwaarde van een lijst berekent:
Als de lijst N elementen heeft, is de complexiteit 1 + (N - 1) + 1 = N + 1 = O(N).
De uitvoeringstijd van lineaire algoritmen is recht evenredig met de hoeveelheid data. Als de hoeveelheid data dus verdubbelt, zou de tijd die het algoritme nodig heeft ook ongeveer moeten verdubbelen.
Logaritmische tijd: O(log(N))
Het getallenraadspel draait om het raden van een verborgen getal tussen 1 en N, met zo min mogelijk pogingen. Na elke gok krijg je feedback of het verborgen getal hoger, lager of gelijk is aan je gok. Als de gok klopt, win je; anders ga je door met raden.
Een effectieve strategie voor dit spel is om steeds het midden te raden. Stel N = 15. Dan is onze eerste gok 8. Als het geheime getal kleiner is dan 8, weten we dat het tussen 1 en 7 ligt. Is het groter, dan ligt het tussen 9 en 15. We blijven het midden van het resterende bereik raden totdat we het juiste antwoord vinden. Het onderstaande diagram illustreert de mogelijke paden van deze strategie.
Laten we de tijdscomplexiteit van deze aanpak bekijken. In tegenstelling tot de vorige voorbeelden hangt het aantal stappen niet alleen af van de invoergrootte N, omdat je in theorie al bij de eerste poging goed kunt raden.
Bij het analyseren van dit soort algoritmen concentreren we ons op het worstcasescenario. Bijvoorbeeld, bij N = 15 hebben we in het slechtste geval 4 pogingen nodig. Elke gok, het midden, elimineert de helft van de resterende mogelijkheden. In het worstcasescenario blijven we raden tot er nog maar één mogelijkheid over is. De vraag die we dus moeten beantwoorden is:
Hoe vaak moeten we N door 2 delen om 1 te krijgen?
Het antwoord is de logaritme met grondtal 2 van N, genoteerd als log2(N). Het algoritme dat we gebruiken om het juiste getal te vinden heet binaire zoekopdracht. Aangezien het maximaal aantal gissingen log2(N) is, kunnen we de complexiteit schrijven als O(log2(N)) of simpelweg O(log(N)), omdat constanten in tijdscomplexiteit onbelangrijk zijn.
Vanwege de extreem trage groeisnelheid is logaritmische tijdscomplexiteit in de praktijk zeer gewild en gedraagt het zich bijna als constante tijd. Zelfs voor grote N blijft het aantal operaties opvallend laag. Als N bijvoorbeeld één miljard is, zijn er slechts zo'n 30 operaties nodig.
Binaire zoekopdracht is een fundamenteel algoritme in de informatica met talloze toepassingen. In natural language processing kunnen spellingscontrole en autocorrect varianten van binaire zoekopdracht gebruiken om efficiënt mogelijke kandidaatwoorden te vinden.
Kwadratische tijd: O(N2)
Data sorteren is een kernactiviteit die computers vaak moeten uitvoeren. Eén methode om een lijst van N getallen te sorteren is door herhaaldelijk het minimum van de lijst te nemen.
Om de complexiteit van een
for-lus te analyseren, evalueren we de complexiteit van de instructies erin en vermenigvuldigen dat met het aantal iteraties dat de lus wordt uitgevoerd.Het minimum van een lijst bepalen en een element uit een lijst verwijderen zijn beide O(N)-operaties. Toevoegen gebeurt in constante tijd, O(1). Elke iteratie van de for-lus heeft daarom complexiteit O(N + N + 1) = O(2N + 1), wat vereenvoudigt tot O(N). Aangezien er N iteraties zijn, is de complexiteit N × O(N) = O(N2). De rest van de functie
selection_sort()bestaat uit drie eenvoudige instructies, dus de totale complexiteit is O(N2 + 3) = O(N2).Onze analyse van de for-lus was een vereenvoudiging. In elke iteratie verwijderen we één element uit de lijst, wat betekent dat niet alle iteraties hetzelfde aantal instructies uitvoeren. De eerste iteratie voert N instructies uit, de tweede N - 1, de derde N - 2, enzovoort, tot de laatste iteratie, die er nog maar 1 uitvoert.
Dit impliceert dat de werkelijke complexiteit van de for-lus is:
N + (N - 1) + (N - 2) + … + 1
Deze som is gelijk aan (N2 + N) / 2. Maar,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Hoewel we te veel telden, blijft de totale complexiteit kwadratisch. De functie
selection_sort()is een voorbeeld van een langzamer sorteeralgoritme vanwege de kwadratische complexiteit, O(N2).Functies met kwadratische complexiteit schalen slecht. Ze zijn geschikt voor kleine lijsten, maar onpraktisch om miljoenen datapunten te sorteren: dat kan dagen duren. Een verdubbeling van de data zorgt voor een verviervoudiging van de uitvoeringstijd.
Loglineaire tijd: O(N log(N))
Het is mogelijk om een algoritme te bedenken dat een lijst sorteert met een tijdscomplexiteit van O(N log(N)). Zo'n algoritme heet mergesort. We gaan niet in op de implementatiedetails, maar als je er meer over wilt leren, bekijk dan deze korte introductie tot mergesort uit deze cursus over Data Structures and Algorithms in Python.
Zoals eerder genoemd gedraagt logaritmische complexiteit zich in de praktijk vergelijkbaar met constante complexiteit. Daarom kan de uitvoeringstijd van een O(N log(N))-algoritme in de echte wereld vergelijkbaar zijn met die van een lineair algoritme.
De onderstaande grafiek laat zien dat N log(N) en N met vergelijkbare snelheid groeien, terwijl N2 heel snel groeit en daardoor snel heel traag wordt.
Kubische tijd: O(N3)
Een veelgebruikt algoritme met kubische tijdscomplexiteit in AI is matrixvermenigvuldiging, dat een cruciale rol speelt in de werking van grote taalmodellen zoals GPT. Dit algoritme is bepalend voor de berekeningen tijdens zowel training als inferentie.
Om twee N bij N-matrices, A en B, te vermenigvuldigen, moeten we elke rij van de eerste matrix A vermenigvuldigen met elke kolom van de tweede matrix B. Concreet: de waarde van het product op positie (i, j) wordt bepaald door de elementen in rij i van A te vermenigvuldigen met de overeenkomstige elementen in kolom j van B.
Hier is een Python-implementatie van matrixvermenigvuldiging:
In totaal voert
matrix_mul()N3 + N2 + 2 instructies uit, dus de tijdscomplexiteit is O(N3).We hadden de complexiteit ook kunnen analyseren door te redeneren over de berekeningen. Het resultaat van de matrixvermenigvuldiging heeft N2 elementen. Elk element kost O(N) tijd om te berekenen, dus de totale complexiteit is N2 × O(N) = O(N3).
Algoritmen met kubische tijd zijn erg traag. Een verdubbeling van de hoeveelheid data leidt tot een factor acht in de uitvoeringstijd, waardoor zulke algoritmen erg slecht schalen. Zelfs voor relatief kleine N explodeert het aantal instructies al snel.
Matrixvermenigvuldiging is een voorbeeld van een computationele uitdaging waarbij hardware-ontwikkelingen veel impact hebben gehad. Hoewel er iets efficiëntere algoritmen bestaan voor matrixvermenigvuldiging, zijn het vooral de innovaties in het ontwerp van GPU-chips — specifiek afgestemd op matrixvermenigvuldiging — die het trainen van grote modellen zoals GPT binnen redelijke tijd sterk hebben vergemakkelijkt.
Recentelijk hebben onderzoekers voorgesteld om matrixvermenigvuldiging uit grote leermodellen te schrappen — je leest hier meer over in dit artikel over MatMul-Free LLM’s: kernconcepten uitgelegd.
Exponentiële tijdscomplexiteit: O(2N) en O(N!)
Exponentiële algoritmen ontstaan vaak wanneer een probleem wordt opgelost door alle mogelijke oplossingen te verkennen. Stel dat je een route moet plannen voor een bezorgwagen die N afleverlocaties moet bezoeken. Eén aanpak is om elke mogelijke volgorde te evalueren. Het Python-pakket itertools biedt een eenvoudige manier om alle permutaties van een lijst te doorlopen.
Het aantal permutaties van een lijst van lengte N noteren we als N!, uitgesproken als “N faculteit”. De faculteitsfunctie groeit exponentieel. Bijvoorbeeld, bij N = 13 is het aantal permutaties meer dan 1 miljard.
Stel dat de afleverlocaties worden gegeven als een lijst van 2D-punten. Dan kunnen we de volgorde bepalen die de totale afstand minimaliseert door alle mogelijke volgordes te doorlopen en de beste bij te houden.
De eerste
for-lus wordt N! keer uitgevoerd. Het aantal operaties inoptimize_route()is dus N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.We hebben geleerd dat we bij het berekenen van tijdscomplexiteit termen met lagere exponenten negeren. In dit scenario komen we echter een N!-term tegen, die geen macht van N is. We kunnen onze vereenvoudiging verfijnen door de termen met een tragere groei weg te laten. De onderstaande tabel geeft termen die vaak voorkomen in tijdscomplexiteit, gerangschikt van laagste naar hoogste groeisnelheid.
1
log(N)
N
N2
N3
Nk
2N
N!
We kunnen de tijdscomplexiteit van
optimize_route()dus schrijven als N! x N + 2N! + 3 = O(N! x N).Exponentiële algoritmen zijn doorgaans alleen efficiënt voor zeer kleine gevallen. Zelfs met slechts 13 locaties is het aantal permutaties meer dan 1 miljard, wat dit algoritme onpraktisch maakt voor echte scenario’s.
Tijdscomplexiteit: worst case en best case
Bij het getallenraadspel focusten we op de worstcase-complexiteit. Door op de worst case te focussen, garanderen we de groeisnelheid van de uitvoeringstijd van het algoritme.
In het beste geval raden we in één keer goed, dus een bestcase-analyse levert O(1) op. Dat klopt — in het beste geval is er één constante bewerking nodig. Maar dat is niet erg nuttig, want de kans daarop is klein.
In het algemeen richten we ons bij de analyse van een algoritme altijd op de worst case omdat:
Tijdscomplexiteit: praktische implicaties
Tijdscomplexiteit lijkt misschien erg theoretisch, maar kan in de praktijk heel nuttig zijn.
Als een functie bijvoorbeeld consequent een kleine dataset verwerkt, kan een eenvoudig te begrijpen O(N2)-algoritme geschikter zijn dan een complex en lastig te onderhouden O(N)-algoritme. Dit moet echter een bewuste keuze zijn, om te voorkomen dat je voor verrassingen komt te staan wanneer de applicatie groeiend verkeer niet aankan.
Tijdscomplexiteitsanalyse laat zien dat kleine code-optimalisaties nauwelijks effect hebben op de uitvoeringstijd van een algoritme. Grote verbeteringen bereik je door het aantal basisoperaties dat nodig is om het resultaat te berekenen fundamenteel te verlagen. Over het algemeen is het beter om schone en begrijpelijke code te behouden dan te optimaliseren tot het onbegrijpelijk wordt.
Langzamere delen van de code zullen de rest domineren. Het is meestal zinloos om het snellere deel te optimaliseren voordat je het tragere deel hebt verbeterd. Stel bijvoorbeeld dat we een functie hebben die twee taken uitvoert:
Als de functie
clean_data()complexiteit O(N2) heeft enanalyze_data()complexiteit O(N3), dan zal het terugbrengen van de complexiteit vanclean_data()de totale complexiteit vanprocess_data()niet verbeteren. Het is beter om je te richten op het verbeteren vananalyze_data().Daarnaast kan tijdscomplexiteit hardwarekeuzes informeren. Een O(N3)-algoritme kan, ondanks de slechte schaalbaarheid, toch snel genoeg zijn voor taken met beperkte data als het draait op betere hardware of in een snellere programmeertaal. Als een algoritme daarentegen exponentiële tijdscomplexiteit O(2N) heeft, is geen hardware-upgrade voldoende en is een efficiënter algoritme nodig.
Conclusie
Hoewel computers sneller worden, hebben we met meer data dan ooit te maken. Zie het zo: elke keer dat we het internet, smartphones of slimme apparaten gebruiken, creëren we bergen informatie. Naarmate deze berg groeit, wordt het lastiger om erdoorheen te sorteren en het relevante te vinden. Daarom is het belangrijk om onze tools — en vooral algoritmen — steeds beter te maken in het verwerken en begrijpen van al die informatie.
Tijdscomplexiteitsanalyse biedt een eenvoudige kapstok om na te denken over de uitvoeringstijd van een algoritme. Het primaire doel is inzicht geven in de groeisnelheid van de tijdscomplexiteit, niet het voorspellen van exacte tijden. Ondanks de vele vereenvoudigingen en aannames is het in de praktijk enorm nuttig gebleken en dekt het goed de essentie van het uitvoeringsgedrag van algoritmen.
Wil je meer informaticathema’s verkennen? Bekijk dan mijn artikel over Datastructuren: een uitgebreide gids met Python-voorbeelden.