Cursus
Retrieval Augmented Generation (RAG) met LangChain
3 uur
21.3K
Qwen’s Wan2.1 is een open-source model voor videogeneratie dat is ontworpen om zowel krachtig als toegankelijk te zijn, omdat het kan draaien op consumentengpu's.
Dankzij de sterke prestaties concurreert Wan2.1 met open-source modellen zoals HunyuanVideo en SkyReels en met commerciële oplossingen zoals Sora en Runway.
In dit artikel bespreek ik wat Wan2.1 is, de belangrijkste functies en hoe het werkt. Ook laat ik je zien hoe je er toegang toe krijgt en het gebruikt om video's te genereren op basis van verschillende prompts, zodat je de mogelijkheden in actie ziet.
Wan 2.1 is een geavanceerd model voor videogeneratie, ontwikkeld door Qwen. Het behoort tot een familie van grootschalige videofoundationmodellen, wat betekent dat het hoogwaardige video's kan maken op basis van verschillende soorten input, in dit geval tekstbeschrijvingen en afbeeldingen.
Wan 2.1 combineert krachtige videogeneratie met toegankelijkheid. Het draait op consumentengpu's, in tegenstelling tot veel andere AI-videomodellen die dure hardware vereisen, waardoor het praktischer is. Bovendien is het open source.
Het is gebaseerd op diffusion transformer-technologie, een aanpak waarmee het vloeiende, realistische video's kan genereren met indrukwekkende bewegingskwaliteit. Wan 2.1 introduceert ook een unieke Video Variational Autoencoder (VAE), die helpt de consistentie en details van video's te behouden, zelfs bij hogere resoluties zoals 1080p.
Dit zijn de belangrijkste features:
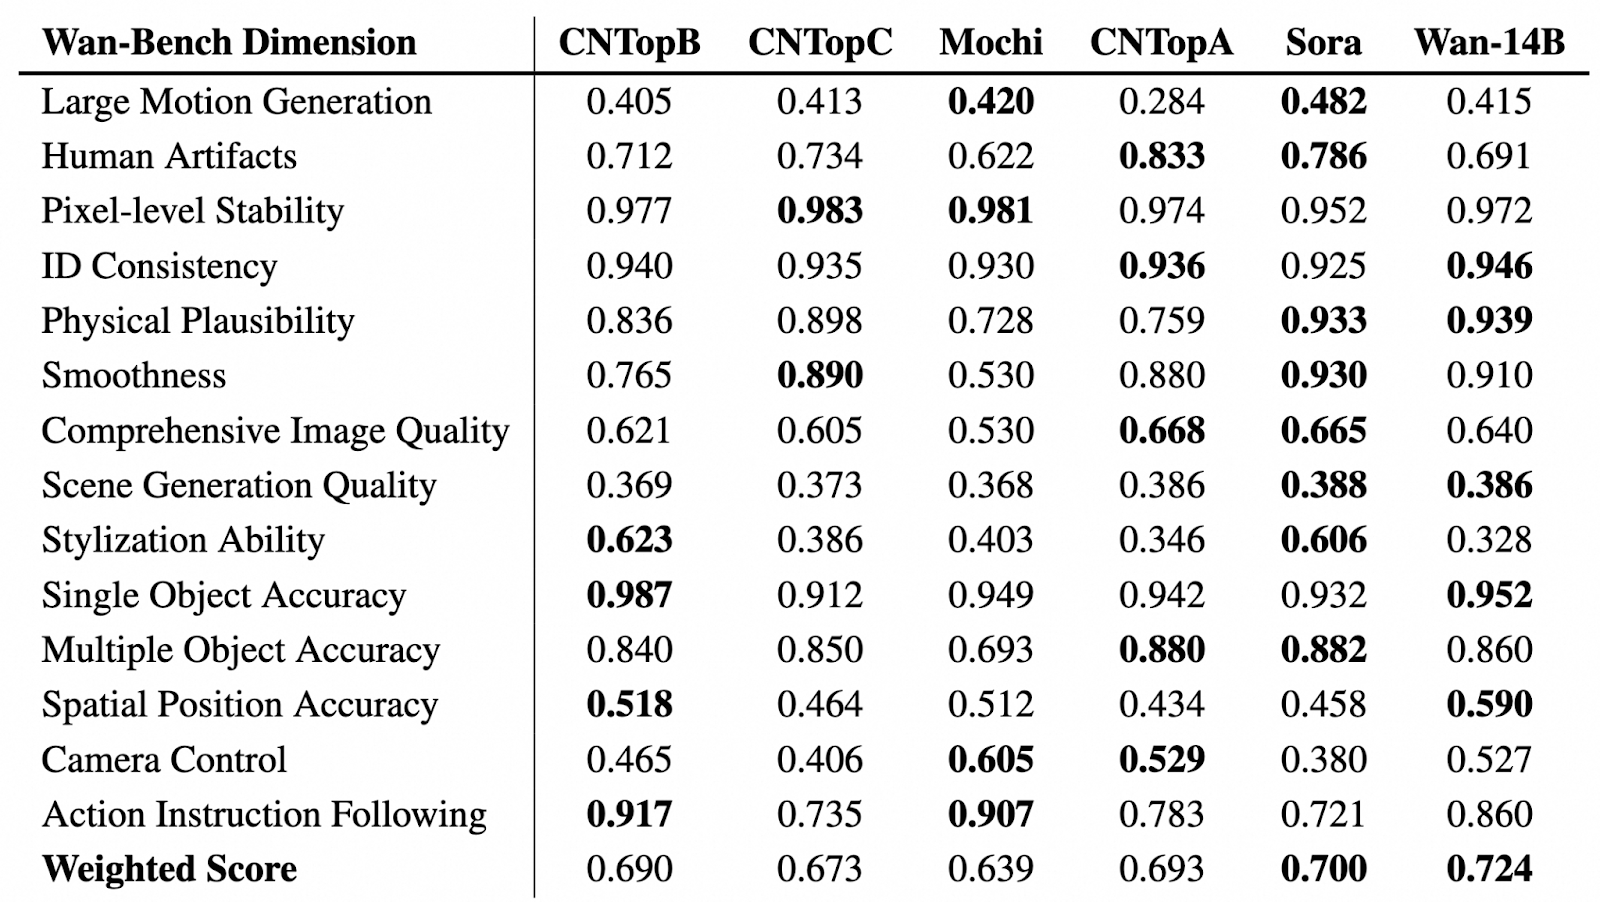
Wan 2.1 presteert beter dan zowel open-source als commerciële AI-videomodellen op meerdere benchmarks, wat betekent dat het realistischer, hoogwaardigere video's produceert dan veel alternatieven.
Bron: GitHub (Wan-Video/Wan2.1)
In de bovenstaande tabel zien we een vergelijkende evaluatie van videogeneratiemodellen over verschillende Wan-Bench-dimensies, waarbij hun prestaties worden beoordeeld op kernaspecten zoals bewegingsgeneratie, visuele stabiliteit, objectnauwkeurigheid en het opvolgen van instructies. Het best presterende model in elke categorie is vetgedrukt gemarkeerd.
Wan-14B behaalt de hoogste gewogen totaalscore (0,724) en toont daarmee sterke capaciteiten op meerdere benchmarks.
Vergeleken met de meeste high-end AI-videomodellen die dure hardware vereisen, heeft Wan 2.1’s T2V-1.3B-model slechts 8,19 GB VRAM nodig. Dit betekent dat je met een gewone GPU, zoals een RTX 4090, in slechts een paar minuten video's kunt genereren zonder een supercomputer nodig te hebben.
Met Wan kun je meer dan alleen Text-to-Video (T2V). Het biedt geavanceerde functies om de videogeneratie en maatwerk te verbeteren, waaronder:
Daarnaast ondersteunt Wan Image-to-Video (I2V), zodat je stilstaande afbeeldingen kunt omzetten in geanimeerde video’s. Je kunt optionele tekstprompts toevoegen voor meer controle over de videogeneratie en het eerste en laatste frame definiëren om de compositie en flow van de video te sturen.
Wan 2.1 is het eerste AI-videomodel dat leesbare tekst in video’s kan genereren in zowel het Engels als het Chinees. Dit is ideaal voor het maken van ondertitels, geanimeerde tekst en grafische overlays binnen videocontent.
Wan 2.1 gebruikt een geavanceerde Video Variational Auto Encoder (Wan-VAE) waarmee het:
Er zijn meerdere manieren om te starten—je kunt het online uitproberen of lokaal op je computer draaien.
Als je met Wan 2.1 wilt experimenteren zonder iets te installeren, kun je er toegang toe krijgen via:
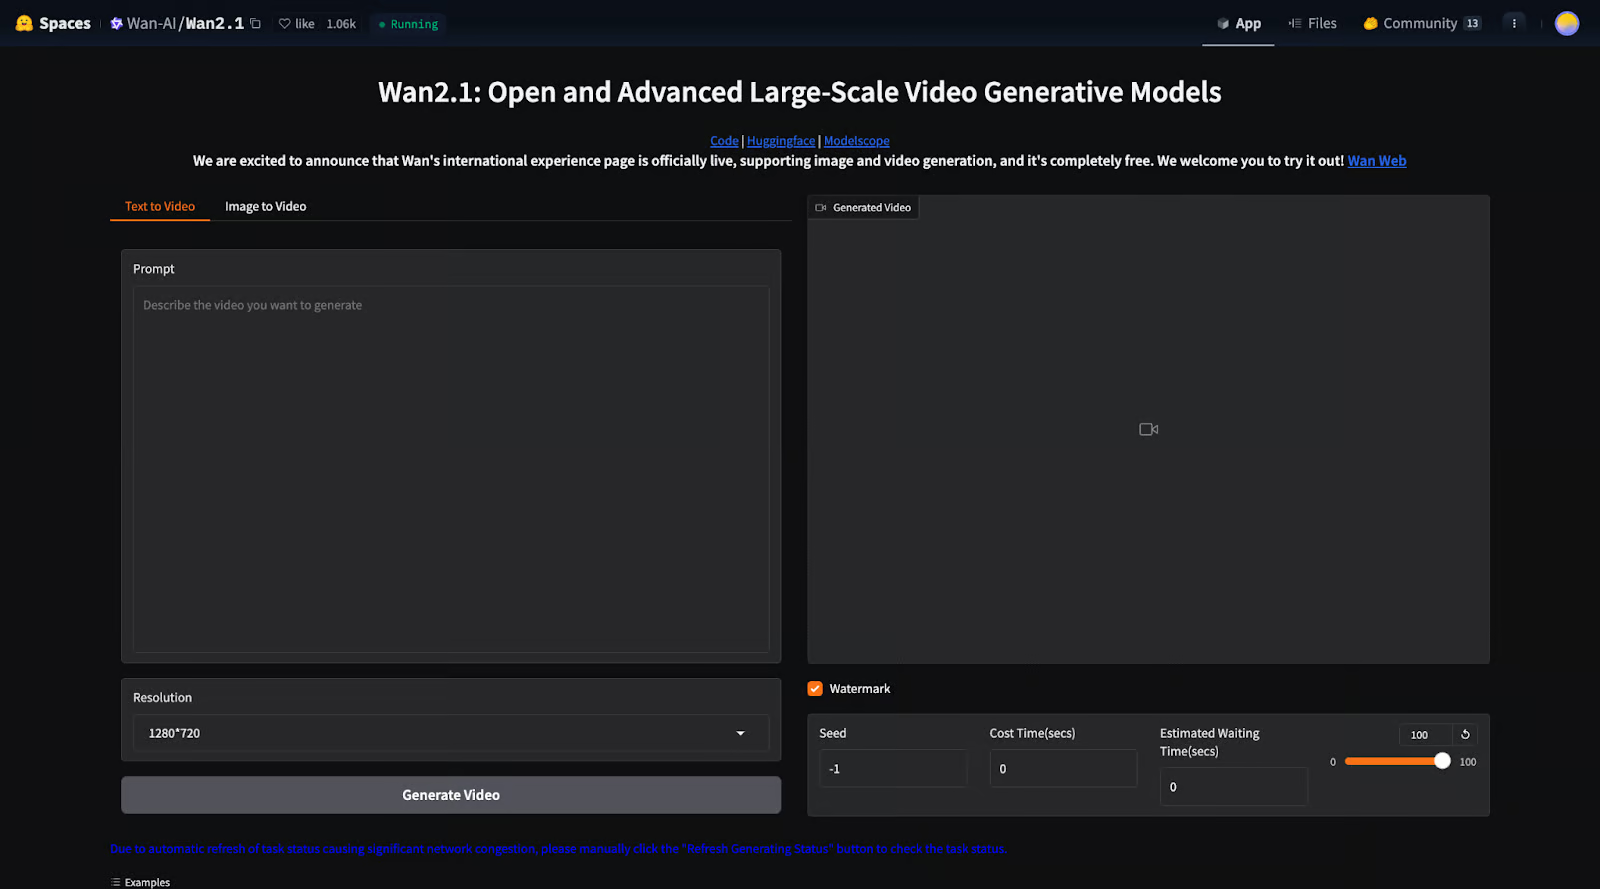
1. Hugging Face-space: Je kunt het model rechtstreeks in een webinterface draaien.
2. WanVideo-website: Hier kun je meer dan alleen video’s genereren. Op de officiële website kun je ook afbeeldingen maken en een collectie verkennen van video’s en afbeeldingen die door andere gebruikers zijn gegenereerd, inclusief de prompts die ze gebruikten.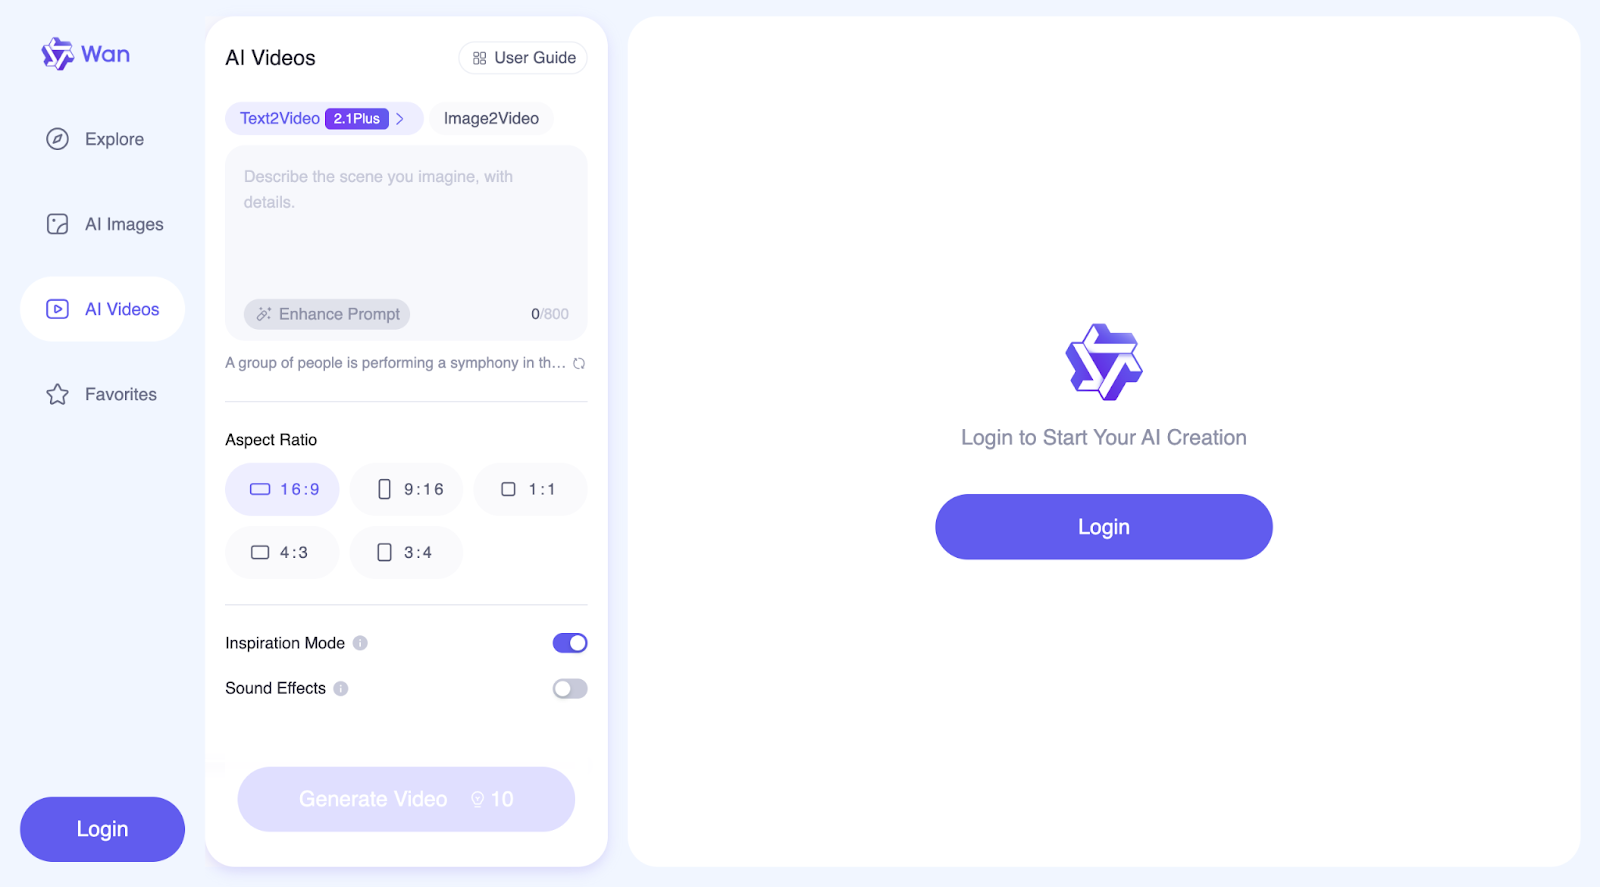
Met deze opties kun je het model snel testen zonder je zorgen te maken over installatie of hardware.
Als je volledige controle en maatwerk wilt, kun je Wan 2.1 op je eigen machine installeren. Laten we stap voor stap bekijken hoe je dit doet:
Download eerst de code van Wan 2.1 van GitHub:
git clone https://github.com/Wan-Video/Wan2.1.git
cd Wan2.1Zorg dat je Python en PyTorch (versie 2.4.0 of hoger) hebt geïnstalleerd en installeer daarna de benodigde libraries:
pip install -r requirements.txtJe moet de voorgetrainde modelbestanden downloaden van Hugging Face (zie meer info hier) of ModelScope (zie meer info hier).Er zijn verschillende modellen die je kunt downloaden:
|
Modellen |
Downloadlink |
Opmerkingen |
|
T2V-14B |
Ondersteunt zowel 480P als 720P |
|
|
I2V-14B-720P |
Ondersteunt 720P |
|
|
I2V-14B-480P |
Ondersteunt 480P |
|
|
T2V-1.3B |
Ondersteunt 480P |
Het 1.3B-model kan video’s genereren in 720P-resolutie, maar omdat het op deze kwaliteit minder training heeft gehad, kunnen de resultaten minder stabiel zijn dan bij 480P. Voor de beste prestaties wordt 480P aanbevolen.
Met Wan 2.1 kun je video’s genereren op basis van tekstbeschrijvingen met twee modelversies:
Als je snel een video wilt genereren, kun je de volgende commando’s gebruiken, waarbij promptverbetering niet is ingeschakeld.
Voor het T2V-14B-model (hogere kwaliteit, groter model):
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights."Voor het T2V-1.3B-model (kleiner, draait op minder krachtige GPU’s):
python generate.py --task t2v-1.3B --size 832*480 --ckpt_dir ./Wan2.1-T2V-1.3B --prompt "A futuristic city with flying cars and neon lights."Als je computer zonder geheugen komt te zitten (OOM-fout), kun je --offload_model True en --t5_cpu gebruiken om het geheugengebruik te verlagen.
Als je meerdere GPU’s hebt, kun je de videogeneratie versnellen door dit commando uit te voeren:
torchrun --nproc_per_node=8 generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --dit_fsdp --t5_fsdp --ulysses_size 8 --prompt "A futuristic city with flying cars and neon lights.`Hiermee wordt de werklast over meerdere GPU’s verdeeld, waardoor het proces sneller gaat.
Wan 2.1 kan je prompt automatisch verbeteren, zodat je de video gedetailleerder en visueel aantrekkelijker kunt maken.
Er zijn twee manieren om de prompt uit te breiden:
Dashscope API gebruiken:
DASH_API_KEY=your_key python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'dashscope'Je eigen lokale model gebruiken:
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'local_qwen'Als je de Diffusers-bibliotheek van Hugging Face wilt gebruiken in plaats van losse scripts te draaien, kun je een video genereren met Python:
import torch
from diffusers.utils import export_to_video
from diffusers import AutoencoderKLWan, WanPipeline
from diffusers.schedulers.scheduling_unipc_multistep import UniPCMultistepScheduler
# Available models: Wan-AI/Wan2.1-T2V-14B-Diffusers, Wan-AI/Wan2.1-T2V-1.3B-Diffusers
model_id = "Wan-AI/Wan2.1-T2V-14B-Diffusers"
# Load the autoencoder for video generation
vae = AutoencoderKLWan.from_pretrained(model_id, subfolder="vae", torch_dtype=torch.float32)
# Define the scheduler for controlling video motion flow
flow_shift = 5.0  # 5.0 for 720P, 3.0 for 480P
scheduler = UniPCMultistepScheduler(
    prediction_type='flow_prediction',
    use_flow_sigmas=True,
    num_train_timesteps=1000,
    flow_shift=flow_shift
)
# Load the video generation pipeline with the model
pipe = WanPipeline.from_pretrained(model_id, vae=vae, torch_dtype=torch.bfloat16)
pipe.scheduler = scheduler
pipe.to("cuda")
# New prompt
prompt = "A futuristic city at sunset, filled with flying cars and neon lights. The buildings have a sleek, cyberpunk design, and people walk on glowing sidewalks. The scene is full of vibrant colors, reflections, and dynamic movement."
# New negative prompt
negative_prompt = "Dull colors, grainy texture, washed-out details, static frames, incorrect lighting, unnatural shadows, distorted faces, artifacts, low-resolution elements, flickering, blurry motion, repetitive patterns, unrealistic reflections, overly simplistic backgrounds, three legged people, walking backwards."
# Generate the video frames
output = pipe(
     prompt=prompt,
     negative_prompt=negative_prompt,
     height=720,
     width=1280,
     num_frames=81,
     guidance_scale=5.0,
).frames[0]
# Export the generated frames as a video
export_to_video(output, "output.mp4", fps=16)
Het script begint met het laden van het Wan2.1-T2V-14B-Diffusers-model, dat wordt gebruikt om video’s te maken. Het laadt ook een VAE (Autoencoder), die helpt bij het verwerken en verbeteren van de videoframes. Om te bepalen hoe soepel beweging in de video verschijnt, gebruikt het script een scheduler (UniPCMultistepScheduler). De instelling flow_shift regelt hoe beweging wordt behandeld, waarbij 5,0 beter is voor hogere resolutie (720P) en 3,0 voor lagere resolutie (480P).
Vervolgens zet het script de videogeneratiepipeline (WanPipeline) op en past de scheduler toe om soepelere overgangen tussen frames te garanderen. De prompt beschrijft een futuristische stad met vliegende auto’s en gloeiende neonlichten, terwijl de negatieve prompt helpt ongewenste effecten te vermijden, zoals vage details, fletse kleuren en flikkerende frames.
Het model maakt vervolgens 81 frames, wat neerkomt op ongeveer 5 seconden video bij 16 frames per seconde (FPS). De guidance_scale is ingesteld op 5,0, wat het model helpt de prompt te volgen en toch wat creativiteit toelaat. Zodra de video is gegenereerd, worden de frames samengevoegd en opgeslagen als "output.mp4" op 16 FPS.
De negatieve prompt speelt een belangrijke rol bij het verbeteren van de uiteindelijke video door het model te vertellen wat het moet vermijden. Zo raak je dingen kwijt als slechte beeldkwaliteit, vreemde vervormingen of alles wat de video onrealistisch kan maken. In dit geval zorgt het ervoor dat de futuristische scène er schoon, scherp en visueel aantrekkelijk uitziet.
Als je liever een interactieve webinterface gebruikt om video’s te genereren in plaats van code, kun je Wan 2.1 draaien met Gradio:
Voor Dashscope-promptuitbreiding:
DASH_API_KEY=your_key python t2v_14B_singleGPU.py --prompt_extend_method 'dashscope' --ckpt_dir ./Wan2.1-T2V-14BVoor lokale promptuitbreiding:
python t2v_14B_singleGPU.py --prompt_extend_method 'local_qwen' --ckpt_dir ./Wan2.1-T2V-14BNet als bij tekst-naar-video is image-to-video ook op te delen in processen met en zonder de stap voor promptuitbreiding. Voor meer details over de implementatie kun je de officiële GitHub bezoeken. Je kunt ook hun Discord-kanaal joinen om over Wan2.1 te praten, je creaties te delen, updates over nieuwe features en ontwikkelingen te krijgen, en de officiële website te bezoeken om gegenereerde voorbeelden te verkennen.
Wan 2.1 is gebouwd met geavanceerde AI-technieken om hoogwaardige, realistische video’s te genereren. Het volgt een op diffusie gebaseerde aanpak en integreert transformers om ervoor te zorgen dat bewegingen vloeiend, consistent en gedetailleerd zijn over de frames heen.
Wan 2.1 gebruikt een techniek die diffusion models heet, die in twee stappen werken:
Het lijkt een beetje op het ontwikkelen van een foto in een donkere kamer—het beeld begint wazig en korrelig, maar wordt bij elke bewerkingsstap helderder.
Wan 2.1 verbetert deze aanpak met een Diffusion Transformer (DiT), wat helpt om scherpe details en vloeiende beweging te behouden tijdens het genereren van meerdere videoframes.
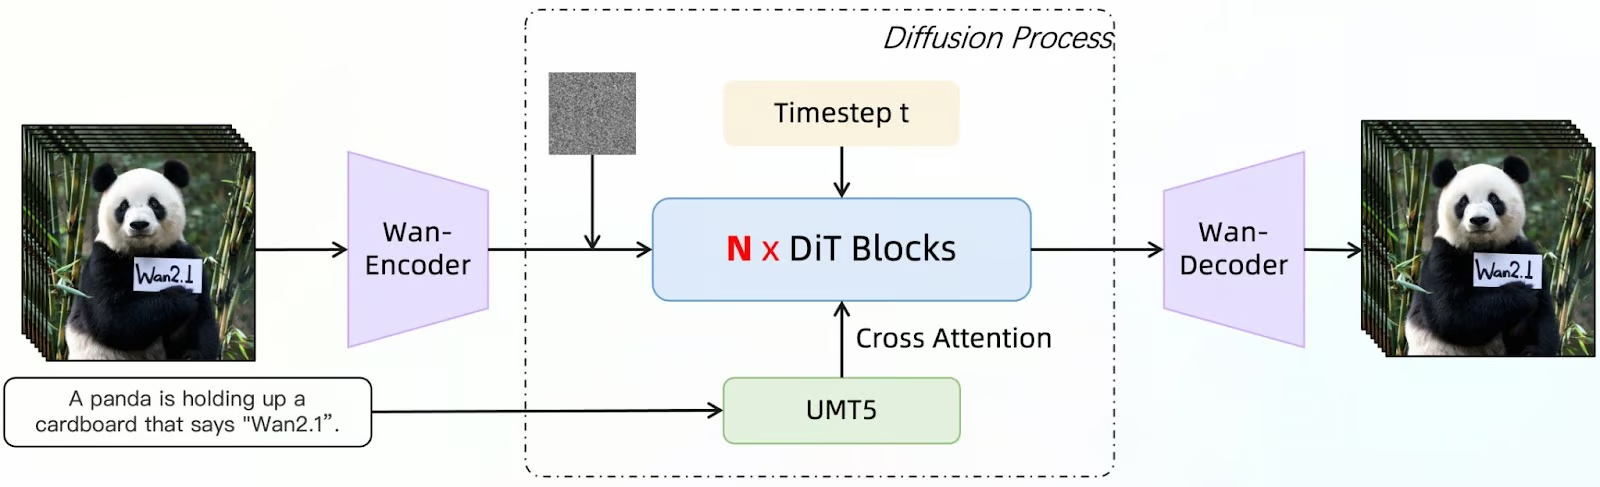
Bron: GitHub (Wan-Video/Wan2.1)
Dit diagram laat zien hoe Wan 2.1 videoframes genereert met een diffusiemodel dat is versterkt met een Diffusion Transformer (DiT). Het proces begint met een invoerbeschrijving (bijv. "A panda is holding up a cardboard that says 'Wan2.1'"). Deze tekst wordt verwerkt door UMT5, een taalmodel dat helpt de prompt te begrijpen en te verfijnen.
Tegelijkertijd wordt een aanvankelijke ruisafbeelding als startpunt ingevoerd. De Wan-Encoder verwerkt vervolgens deze inputs en encodeert ze in een vorm die het model kan manipuleren. N x DiT Blocks verfijnen het beeld iteratief.
Het diffusiemodel verwijdert ruis stap voor stap uit de frames en gebruikt cross-attention om de output af te stemmen op de gegeven prompt. De timestep (t) geeft de voortschrijdende denoising-stappen aan, zodat de video geleidelijk en soepel ontstaat.
Na meerdere verfijningsstappen reconstrueert de Wan-Decoder de uiteindelijke videoframes uit de verwerkte data. De output is een reeks frames die aansluit bij de oorspronkelijke invoerbeschrijving, met behoud van scherpe details, vloeiende beweging en consistentie.
Wan 2.1 beschikt over Wan-VAE, een krachtig compressietool dat het model helpt om:
Het is net als het zippen van videobestanden: het comprimeert en slaat kerndetails op en reconstrueert die nauwkeurig bij het genereren van de video.
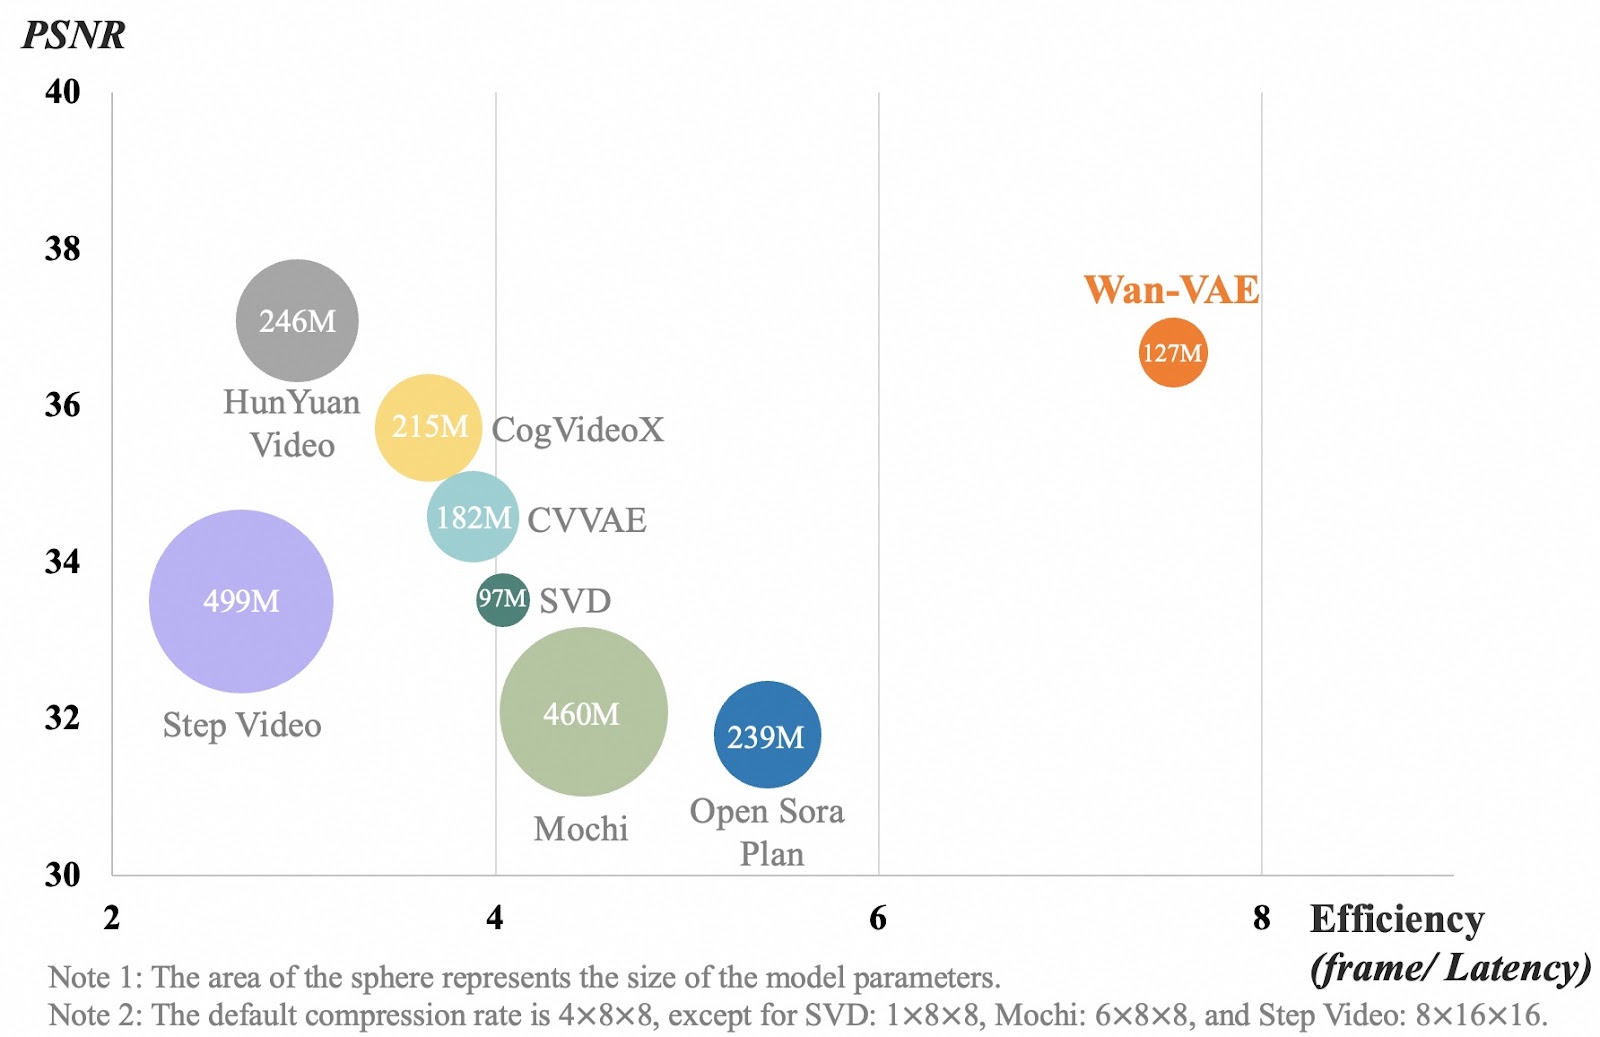
Bron: GitHub (Wan-Video/Wan2.1)
De grafiek vergelijkt verschillende videocompressiemodellen op basis van videokwaliteit (PSNR) en efficiëntie (hoe snel ze frames verwerken). Elke bubbel vertegenwoordigt een model en de grootte ervan toont hoe groot het model is. De x-as meet hoe efficiënt een model videoframes verwerkt. Een hoger getal betekent dat het model sneller werkt. De y-as toont de videokwaliteit, waarbij een hoger getal betekent dat de video’s scherper en gedetailleerder zijn.
Wan-VAE, weergegeven in oranje, presteert beter dan andere modellen door hoge videokwaliteit te combineren met snelle verwerking, terwijl het relatief klein blijft (127M parameters). Andere modellen, zoals Step Video en Mochi, zijn veel groter maar verwerken frames minder efficiënt. Dit betekent dat Wan-VAE lange, hoogwaardige video’s kan genereren met scherpe details en vloeiende beweging, zonder vertraging.
Wan 2.1 is een veelzijdig AI-videogeneratiemodel dat in veel sectoren kan worden gebruikt. In deze sectie probeer ik een paar voorbeelden voor verschillende use-cases.
Wan 2.1 kan je helpen unieke videocontent te genereren zonder dure apparatuur of lange montagesessies. Stel, ik ben een lifestyle-influencer en ik wil content maken over een knusse dag uit mijn leven.Ik ga de volgende prompt gebruiken om een clip voor mijn video te maken:
Een time-lapse-animatie van een knus café van ochtend tot avond, waarin te zien is hoe mensen komen en gaan, koffie wordt gezet en de zonsondergang op de ramen weerkaatst.
Omdat ik het zo realistisch mogelijk wilde, heb ik ook de inspiratiemodus gebruikt. Dit is het resultaat dat ik kreeg:
Toen de video was gegenereerd, was ik op het eerste gezicht erg onder de indruk. Maar bij nader inzien merkte ik een paar dingen. Ten eerste verdwijnt iemand op de achtergrond. Daarnaast is dit geen time-lapse, en wordt er geen koffie gezet. Dus hoewel de video er vrij realistisch uitziet, weerspiegelt hij de prompt niet nauwkeurig.
Stel nu dat je gameontwikkelaar bent. Je zou Wan 2.1 kunnen gebruiken om realistische cutscenes, achtergronanimaties of concept art voor je projecten te genereren. Als je bijvoorbeeld al een karakterconcept hebt en het creatieve team wat designs heeft aangeleverd, kun je het tot leven brengen met de image-to-video-feature van Wan.
Naast karakteranimatie kan Wan 2.1 ook helpen bij het creëren van dynamische omgevingen, zoals veranderende weerseffecten, bruisende stadsgezichten of mystieke landschappen, zonder dat je elk frame handmatig hoeft te animeren.
Met de controle over de beeldverhouding kun je er bovendien voor zorgen dat je animaties perfect passen in verschillende gamescènes, zoals breedbeeldcinematics (16:9), mobiele verticale shots (9:16) of vierkante composities (1:1) voor social media-teasers.
Je kunt zelfs de feature voor geluidseffecten gebruiken om achtergrondambiance te genereren, zoals ritselende bladeren, het gezoem van een futuristische stad of slagveldsoundscapes.
Laten we iets proberen!Ik heb deze schets van een middeleeuwse ridder gegenereerd met DALL-E:
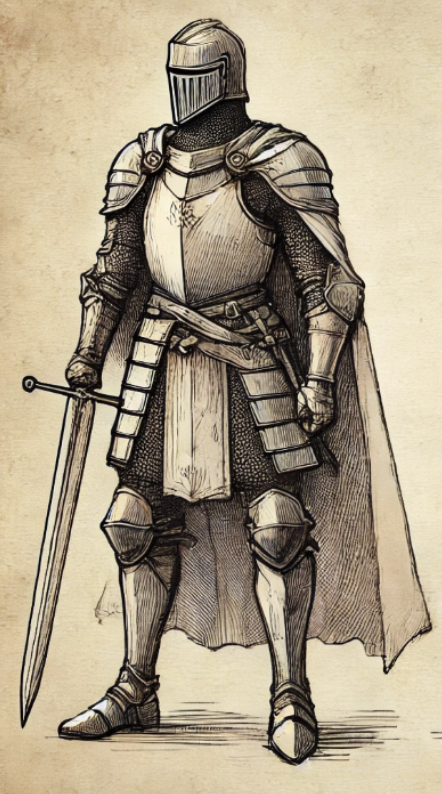
Met Wan heb ik de volgende prompt ingevoerd met GPT-4o-mini:
Een middeleeuwse ridder staat in een heldhaftige houding, met beide handen een groot zwaard omklemmend. Zijn cape waait in de wind terwijl hij het slagveld overziet. De ridder draait langzaam zijn hoofd en scant de horizon met een vastberaden uitdrukking. De animatie heeft een cinematografische stijl.Maar toen klikte ik op Enhanced Prompt, en dit kreeg ik:
Cinematic Medieval Knight: Een dappere ridder staat standvastig, gehuld in volledige plaatpantsering, en grijpt met beide handen een formidabele breedzwaard. Zijn vizierhelm en schouderstukken glanzen in de zon, terwijl een edel wapen op zijn borststuk prijkt. Een sjerp klemt om zijn middel en houdt zijn uitrusting op zijn plaats. Zijn karmozijnrode mantel wappert dramatisch in de bries en versterkt zijn imposante verschijning. Met een stalen blik draait hij zijn hoofd en overziet het uitgestrekte, zanderige slagveld. De scène ontvouwt zich op papier met perkamentachtige textuur, wat een gevoel van een oud manuscript oproept. Het betreft een grootse, full-body opname die de ridder in een triomfantelijke pose vastlegt, reminiscent aan epische middeleeuwse cinema.
Ik schakelde de Inspiratiemodus uit maar zette Geluidseffecten aan. Dit is het resultaat:
Niet slecht! Al moet ik toegeven dat ik een meer cinematografische versie van de schets verwachtte in plaats van een animatie van de schets zelf. Maar misschien had ik duidelijker moeten zijn in de prompt. De muziek is interessant, en ik denk dat het goed past bij de animatie!
Als je marketeer bent, kun je Wan 2.1 gebruiken om promotievideo’s te maken voor merken, producten en diensten of zelfs om logo’s te animeren.
Stel, je hebt een ijsjesbedrijf en je wilt je logo animeren om het aan het einde van je advertenties of promovideo’s te plaatsen.Om dit idee te testen, heb ik opnieuw deze afbeelding met DALL-E gegenereerd:
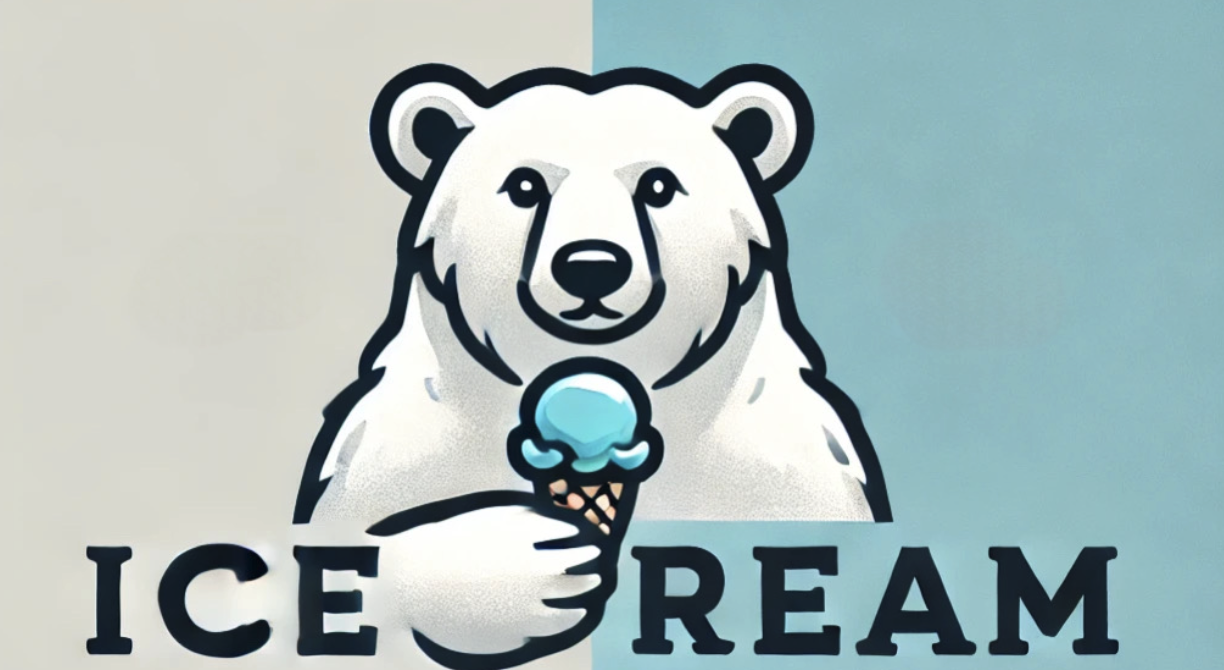
Daarna gebruikte ik deze prompt: De ijsbeer eet het ijsje op. Dit is het resultaat van image-to-video-generatie:
Leer AI met deze cursussen!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

