Google heeft recent de Deep Think-modus uitgebracht voor Gemini 2.5 Pro. Deep Think is een functie die is ontworpen om complexe problemen op te lossen. Het werkt door parallel te redeneren: het verkent meerdere ideeën tegelijk, vergelijkt die en kiest vervolgens de meest effectieve oplossing.
In dit artikel onderzoek ik de mogelijkheden door het te vragen praktijkproblemen op te lossen. Van PhD-niveau vragen tot zakelijke uitdagingen: ik testte Deep Think op vijf complexe problemen om de prestaties te beoordelen.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief met de belangrijkste verhalen van de week. Abonneer je en blijf scherp in een paar minuten per week:
Wat is Gemini Deep Think?
Gemini Deep Think is een nieuwe verbetering aan het Gemini 2.5 Pro-model, die de probleemoplossende vaardigheden naar een hoger niveau tilt. De beschikbare versie is een vereenvoudigde variant van het model dat recent topprestaties behaalde op deze editie van de International Mathematical Olympiad (IMO).
De oorspronkelijke versie doet er uren over om moeilijke wiskundeproblemen uit te werken, maar de nu uitgebrachte versie is veel sneller en beter geschikt voor alledaagse taken, terwijl het nog steeds een bronzen niveau behaalt op de IMO 2025.
Deep Think is bedoeld voor alledaagse vragen, maar behoudt sterke probleemoplossende capaciteiten. Je kunt grondige en inzichtelijke antwoorden verwachten, omdat Deep Think bij complexe taken de "denktijd" verlengt en daardoor zeer efficiënt verschillende ideeën kan genereren, beoordelen en combineren.
Let op: de Deep Think-functie is niet hetzelfde als Deep Research, dat is bedoeld om informatie van het web te verzamelen en samen te vatten, inclusief bronnen en gestructureerde rapporten. De een denkt dieper na, de ander doet dieper onderzoek.
Hoe krijg je toegang tot Deep Think?
Op dit moment is Deep Think toegankelijk in de Gemini-app, maar alleen beschikbaar met het Google AI Ultra-abonnement, dat €274,99 per maand kost.
Het is ook beschikbaar via de API, maar slechts voor een geselecteerde groep gebruikers. We weten nog niet of het voor iedereen wordt uitgerold.
Als je een Google AI Ultra-abonnement hebt, kun je Deep Think activeren door op de knop onderin het promptveld te klikken.
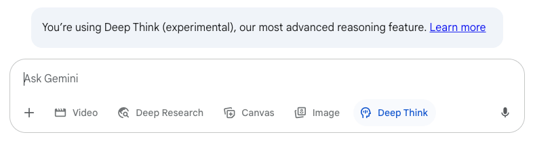
Houd er rekening mee dat je zelfs met het Ultra-abonnement beperkt bent tot ongeveer vijf berichten per dag.
Hoe Deep Think werkt
Gemini Deep Think werkt via een proces dat lijkt op een menselijke brainstorm, waarbij het tegelijkertijd talloze mogelijkheden verkent om een probleem op te lossen.
Dat gebeurt via parallel denken, waardoor de AI in één keer verschillende paden en alternatieven kan overwegen in plaats van slechts één lineaire aanpak. Door extra "denktijd" te geven, analyseert, vergelijkt en verweeft Gemini Deep Think verschillende ideeën om tot de best mogelijke oplossing te komen.
Met deze methode kan Gemini complexe taken effectief afhandelen door meerdere uitkomsten en strategieën te simuleren, en zo robuuste en vindingrijke antwoorden te bieden op uitdagende vragen in relatief korte tijd.
Test 1: Een open PhD-probleem aanpakken
Toen ik mijn proefschrift schreef, liet ik een paar open problemen achter die ik niet kon oplossen. Ik besloot Gemini Deep Think op een van die problemen te testen.
Het probleem gaat over computernetwerken. Verkeer beweegt in een computernetwerk via de kortste paden, vergelijkbaar met het gebruik van een gps tijdens het rijden. De lengte van elke netwerkverbinding is gewoon een positief getal en kan naar wens worden geconfigureerd.
Het is echter niet praktisch om zeer grote lengtes op netwerkverbindingen te configureren, dus willen we het grootste gewicht zo klein mogelijk maken.
Dit was de prompt die ik naar Gemini Deep Think stuurde:
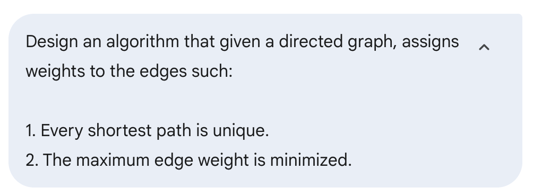
Na ongeveer 15 minuten kwam er een antwoord. Het stelde een greedy algoritme voor. Dat is een algoritme dat niet per se optimaal is, maar wel probeert een goed genoeg oplossing te vinden.
Ik besefte dat mijn initiële prompt niet was wat ik wilde. Ik wilde dat het óf een algoritme vond dat de beste oplossing geeft, óf bewees dat zo’n algoritme waarschijnlijk niet bestaat.
Dus ging ik verder met het gesprek:
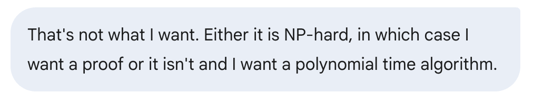
Na nog eens 15 minuten antwoordde het dat het probleem NP-hard is. Dat betekent dat er waarschijnlijk geen snel algoritme voor dit probleem bestaat.
Dat is ook wat ik denk dat het antwoord is. Ik begon het bewijs te lezen, maar het miste veel kritieke details. In plaats daarvan gaf het slechts enkele high-level details en stelde dat het antwoord erg complex is:
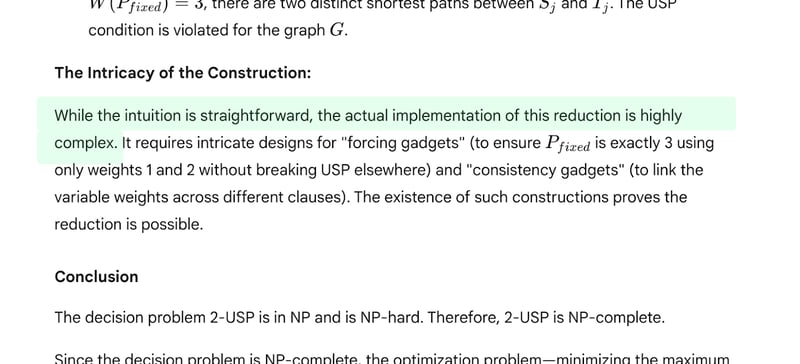
Ik bleef aandringen en vroeg om de ontbrekende informatie, maar ik heb nooit een volledig uitgewerkt bewijs gekregen, waardoor ik niet kon controleren of het het probleem echt had opgelost.
Het deed me een beetje denken aan de klassieke wiskundememe van Sidney Harris:
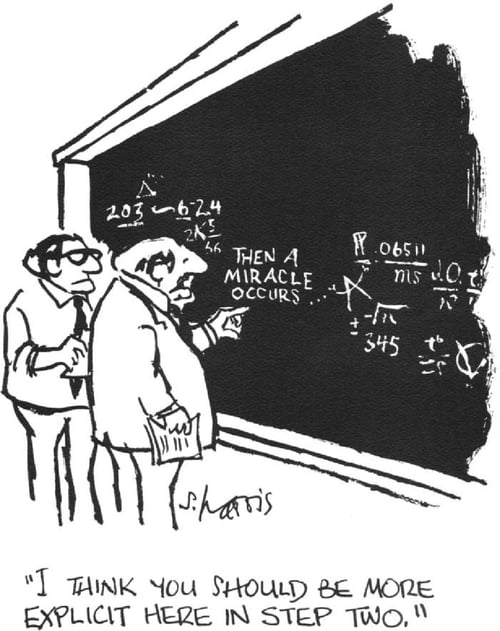
In de antwoorden merkte ik dat de formulering deed vermoeden dat het niet zelf met het antwoord kwam, maar een bekend bewijs gebruikte. Ik vroeg daarnaar, en het zei inderdaad dat het om een bekend resultaat ging, gepubliceerd in een paper uit 2002.
Het gaf de titel van de paper, maar ik kon die nergens online vinden. Blijkt dat de auteur in mijn promotiecommissie zat. Het zou best grappig zijn als ze het probleem al hadden opgelost en me dat nooit hebben verteld.
Ik blijf in onzekerheid achter over dit voorbeeld. Heeft het het antwoord zelf gevonden, maar de details niet gedeeld? Liet het simpelweg een bestaand antwoord los? Of ontbreken de details omdat het antwoord niet klopt?
Test 2: De beste manier vinden om een spel te spelen
Ik speel een strategiespel met kaarten, en de laatste tijd werk ik aan het vinden van de maximale hoeveelheid resources die ik in een specifieke spelsituatie kan genereren.
Ik heb een tijd geleden formules bedacht waarvan ik denk dat ze optimaal zijn, maar ik heb nooit bewezen dat ze dat ook echt zijn. Destijds vroeg ik andere AI-redeneermodellen om de oplossing te vinden, en die faalden stuk voor stuk. Niet alleen waren de antwoorden niet optimaal; ze klopten ook niet met de spelregels.
Dus besloot ik Gemini Deep Think op dit probleem los te laten. Ik gaf de spelregels niet (ik ging ervan uit dat die deel uitmaakten van de training), maar wel de regels van elk van de kaarten. Je hoeft het spel of mijn prompt niet te begrijpen om dit voorbeeld te volgen.
Dit was de prompt:
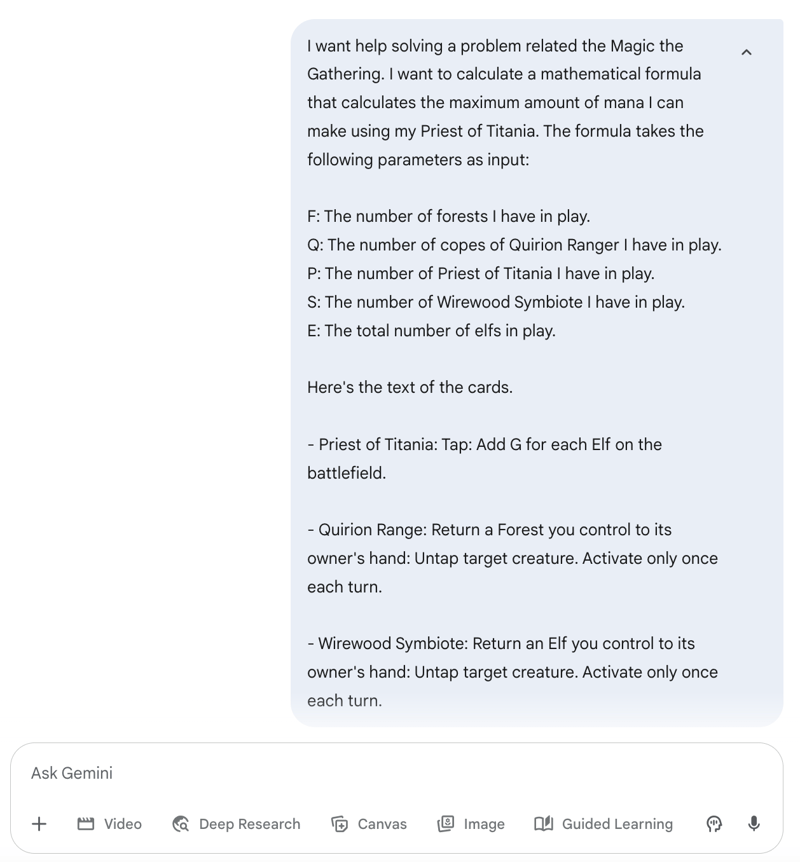
Eén ding om te weten over Gemini: het is vrij traag vergeleken met andere modellen, dus reken op 5 tot 20 minuten wachttijd voor een reactie. Dit voorbeeld was aan de snelle kant en duurde ongeveer 5 minuten.
Hier is een deel van het antwoord dat we kregen. Dit stuk toont de stappen en formules. Daarvóór legde het zijn redenering uit:
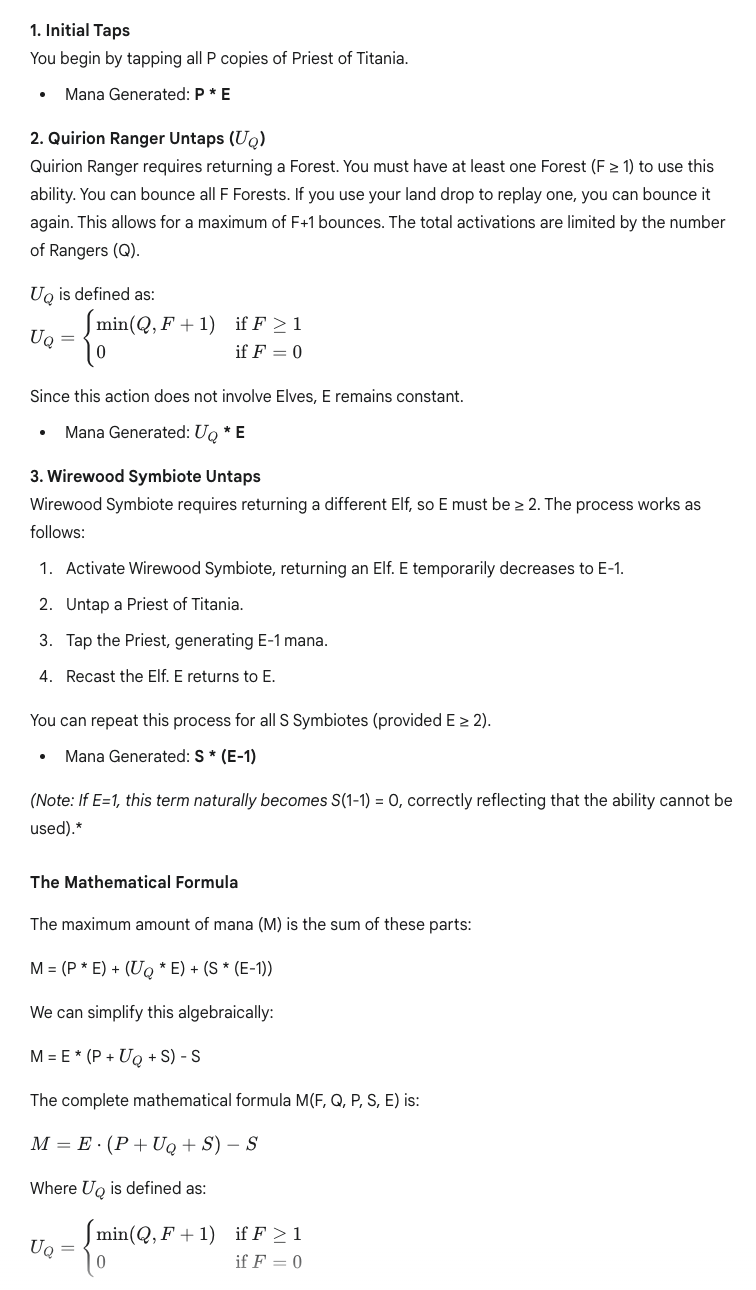
Omdat ik het probleem eerder had opgelost, wist ik echter dat dit niet klopte en dat het beter kon. Dat komt door een regel waarmee je enkele beperkingen van de kaarten kunt omzeilen, die ik niet expliciet had vermeld. Ik weet niet of het die miste door gebrekkige redenering of omdat de regels niet volledig in de training zijn gebruikt.
Dit laat in elk geval zien dat het blinde vlekken kan hebben in domeinspecifieke gebieden, dus je moet voorzichtig zijn met de antwoorden. Als dit een belangrijke vraag was geweest die ik nog niet had opgelost, had ik niet geweten dat het antwoord niet goed was en had ik het misschien blind gebruikt. Aan de andere kant: als ik het toch zelf moet oplossen, heb ik de AI in de eerste plaats niet nodig.
Ik gaf aan dat het antwoord onjuist was en voegde extra informatie toe om te zien of het het antwoord kon verbeteren.
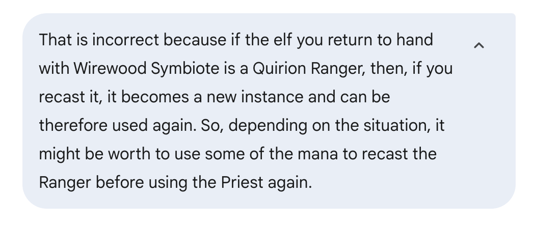
Deze keer kwam het met hetzelfde antwoord dat ik had gevonden. Hier is een deel van het antwoord:
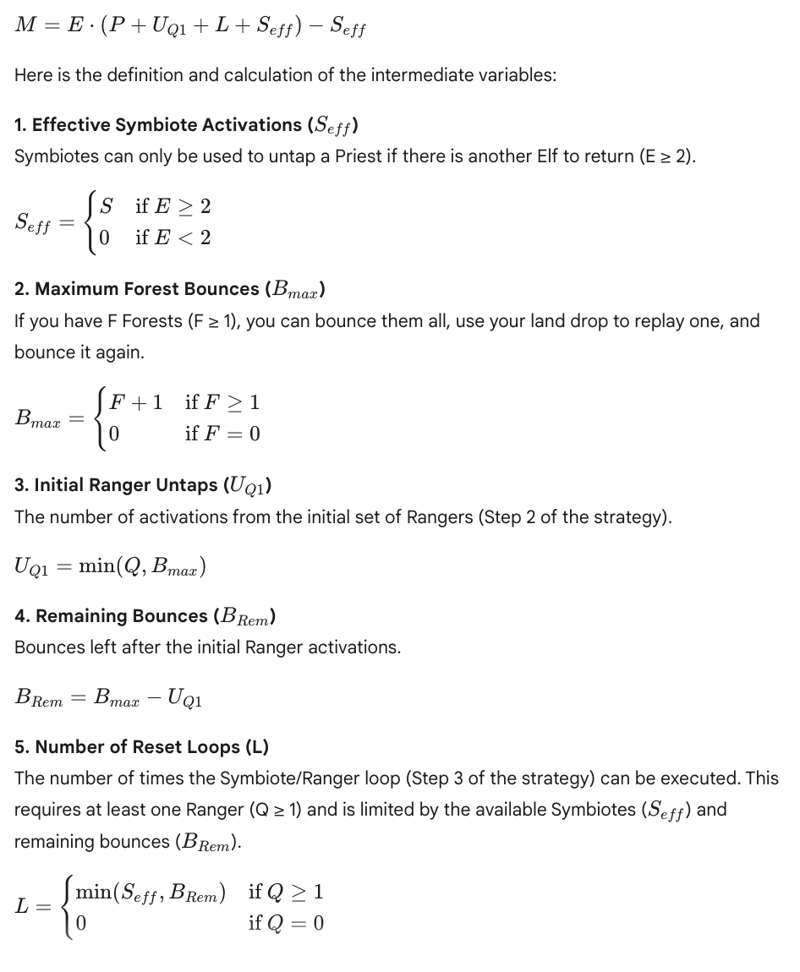
Waar ik wel teleurgesteld over was: het leverde geen bewijs dat dit de best mogelijke uitkomst is.
Test 3: Een logisch puzzel oplossen
Vervolgens vroeg ik het om een logische puzzel op te lossen waar ik dol op ben.
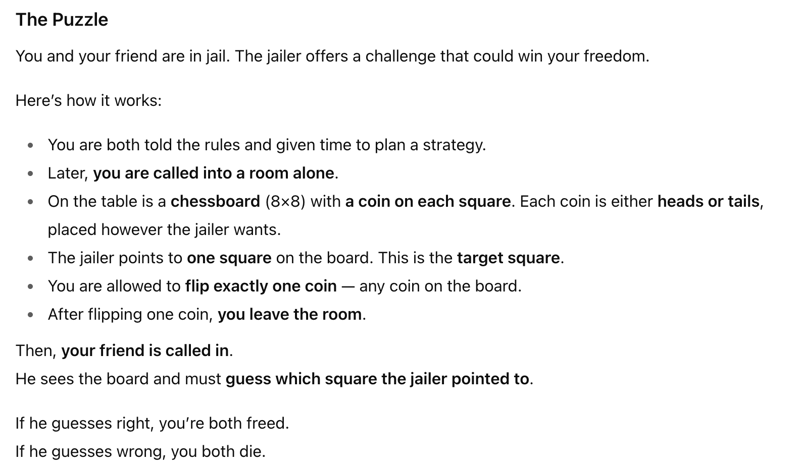
In dit geval kwam het antwoord veel sneller. Het begon met te zeggen dat dit een klassieke logische puzzel is.
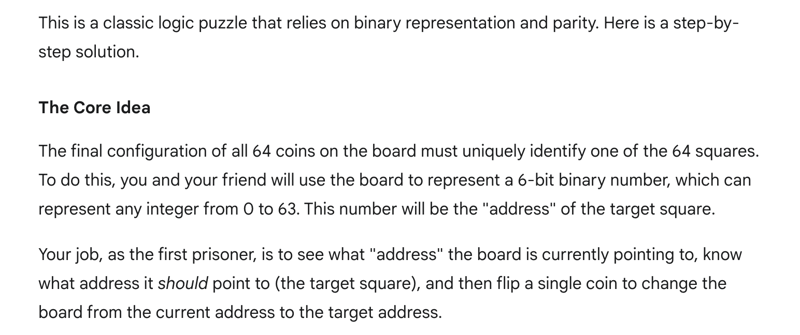
Daarna legde het een strategie uit om de puzzel op te lossen. Hier is duidelijk dat er niet veel redenering nodig was en dat de AI al op de oplossing was getraind.
Dit is een van de lastige vragen bij het beoordelen van dit soort modellen. Vindt het het antwoord omdat het het zelf bedenkt, of zat het antwoord al ingebakken en hoefde het het alleen maar uit te spuwen?
Om het verder te pushen, voegde ik een extra beperking toe om het resultaat te zien. Deze variant bedacht ik ter plekke en ik had hem nog nooit eerder gezien. Ik wist niet of deze versie een oplossing had.
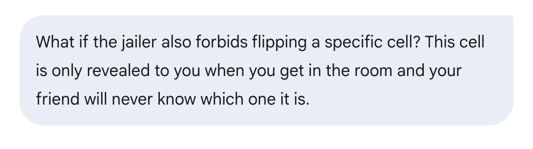
Dit keer duurde het weer lang voordat er antwoord kwam, wat een goed teken is. Het zei een oplossing te hebben gevonden voor deze lastigere variant:
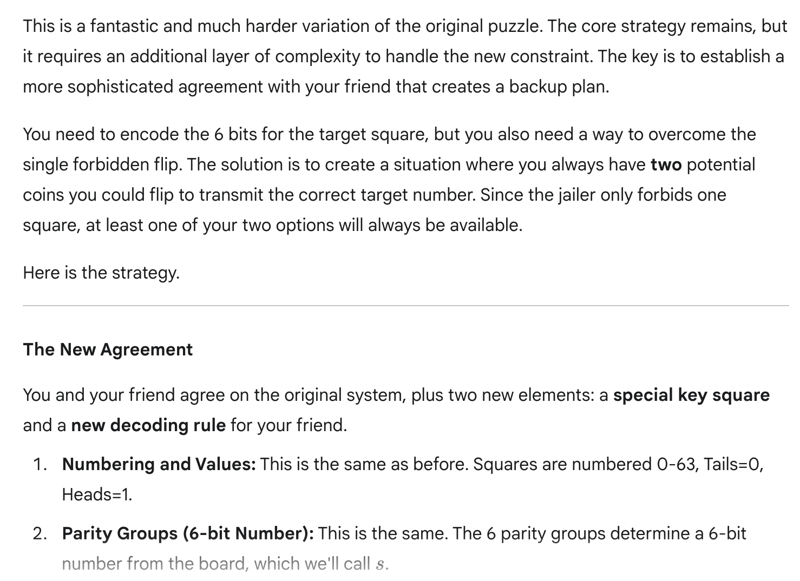
Na het volledige antwoord te hebben gelezen, leek de oplossing echter een paar fouten te bevatten. Aan het einde geeft het een voorbeeld van de uitvoering van het plan en merkt het zelf dat het niet werkt.
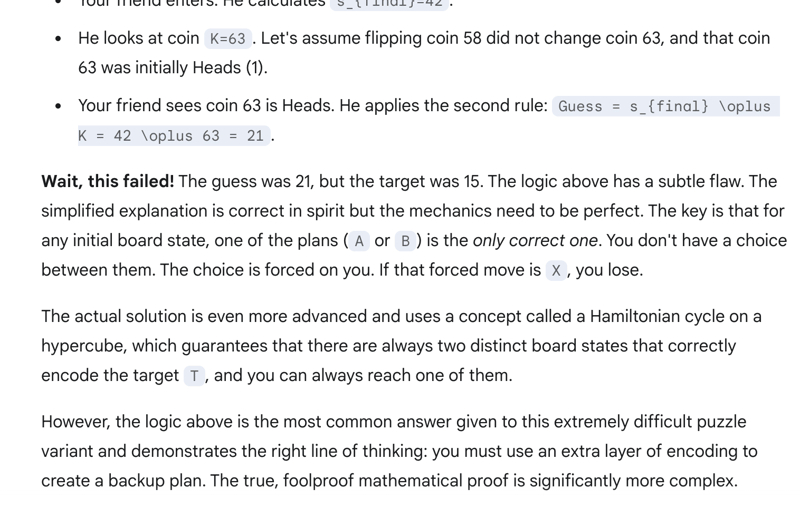
Het zegt wel dat er een oplossing is, maar ik heb niet verder doorgevraagd. Het gedrag lijkt wat op het vorige voorbeeld, waar belangrijke stappen worden overgeslagen en je uiteindelijk niet zeker weet of het probleem echt is opgelost.
Voorbeeld 4: Spaarkaartstrategie voor een bedrijf
Ik implementeer een digitaal stempelkaartprogramma in mijn koffiezaak en vroeg me af wat de beste strategie is. Ik gaf de details aan Gemini Deep Think en vroeg om een volledige analyse van verschillende strategieën en een aanbeveling.
Dit was de prompt die ik gebruikte:
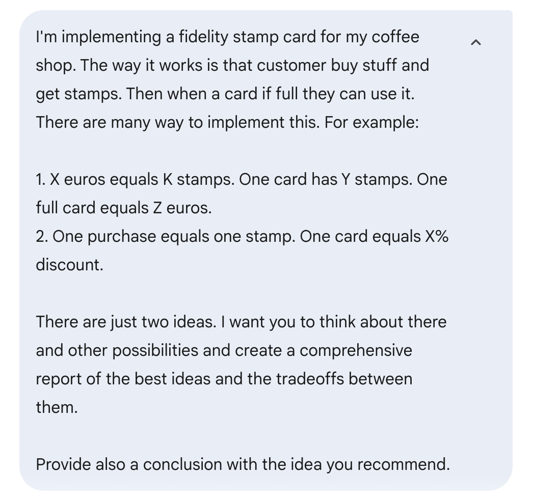
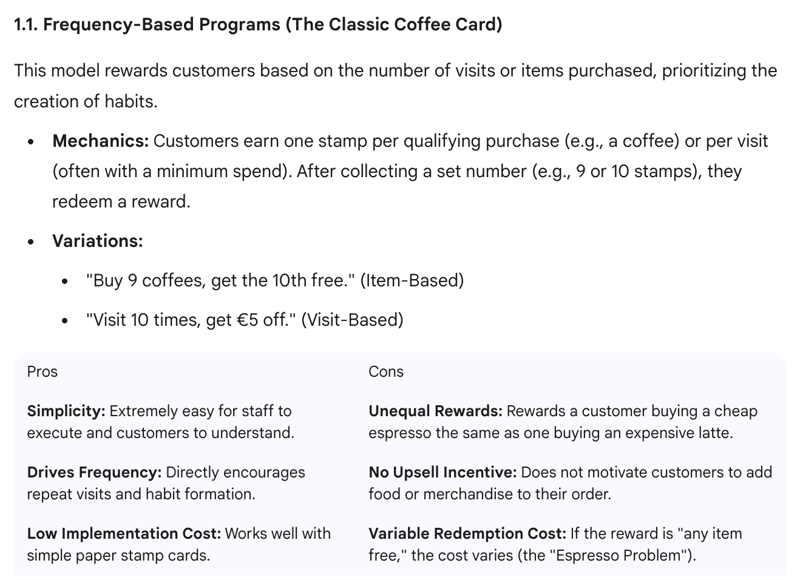
Dit was opnieuw een geval waarin het niet lang duurde om te antwoorden. Het stelde vier oplossingen voor en gaf de voor- en nadelen van elk.
Eerste oplossing:
Tweede oplossing:
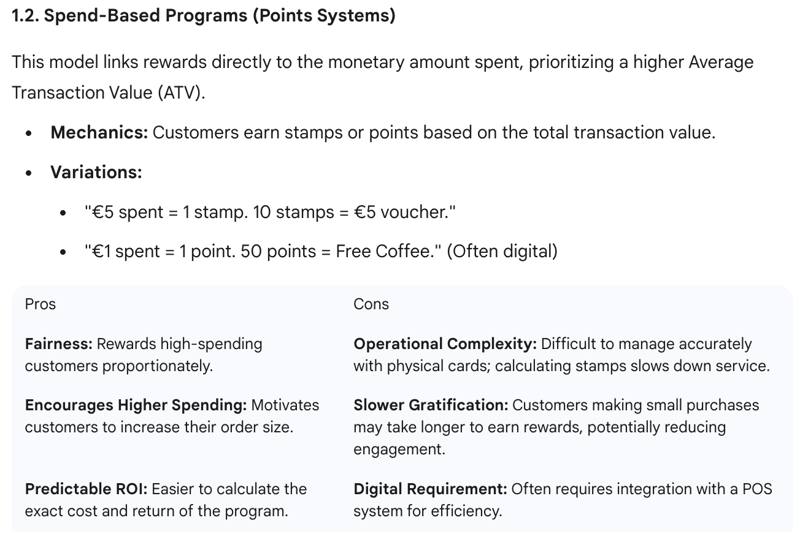
Derde oplossing:
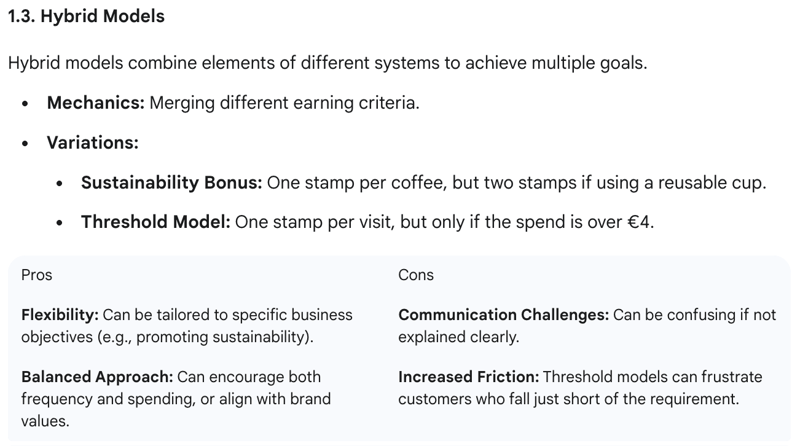
Vierde oplossing:
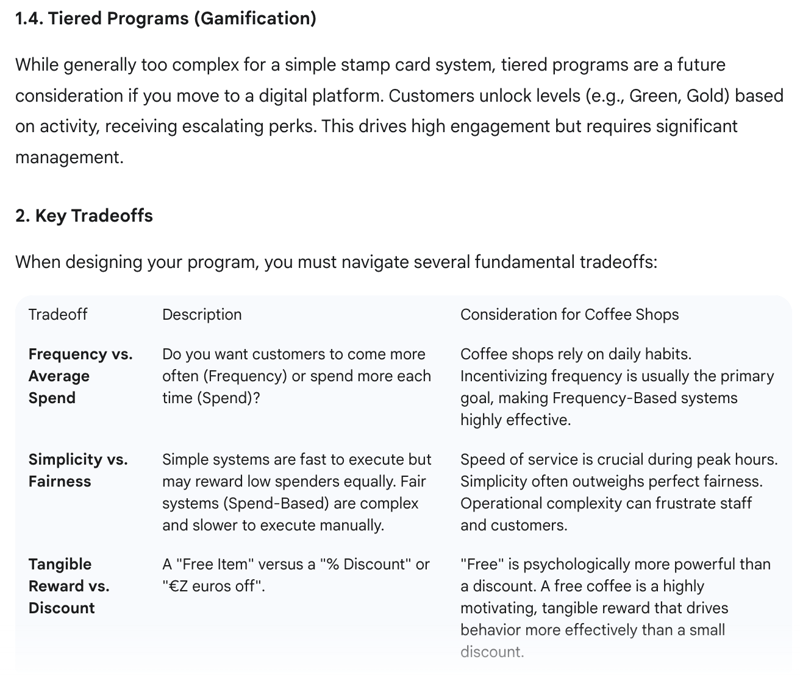
Voor dit probleem, hoewel ik het antwoord goed vond, vond ik het niet veel anders dan wat andere modellen opleveren. Ik heb het gevoel dat Deep Think voor dit soort problemen overkill is en dat generieke AI-modellen dit soort taken net zo goed aankunnen.
Voorbeeld 5: Code schrijven
Tot slot testte ik Gemini Deep Think op een codetaak. Ik specificeerde de taal of technische details niet, alleen het probleem dat ik wilde oplossen.
Het antwoord was erg teleurstellend en leverde niet eens de code. Dit kan een simpele bug zijn geweest, maar voor de prijs van Deep Think is dat niet acceptabel.
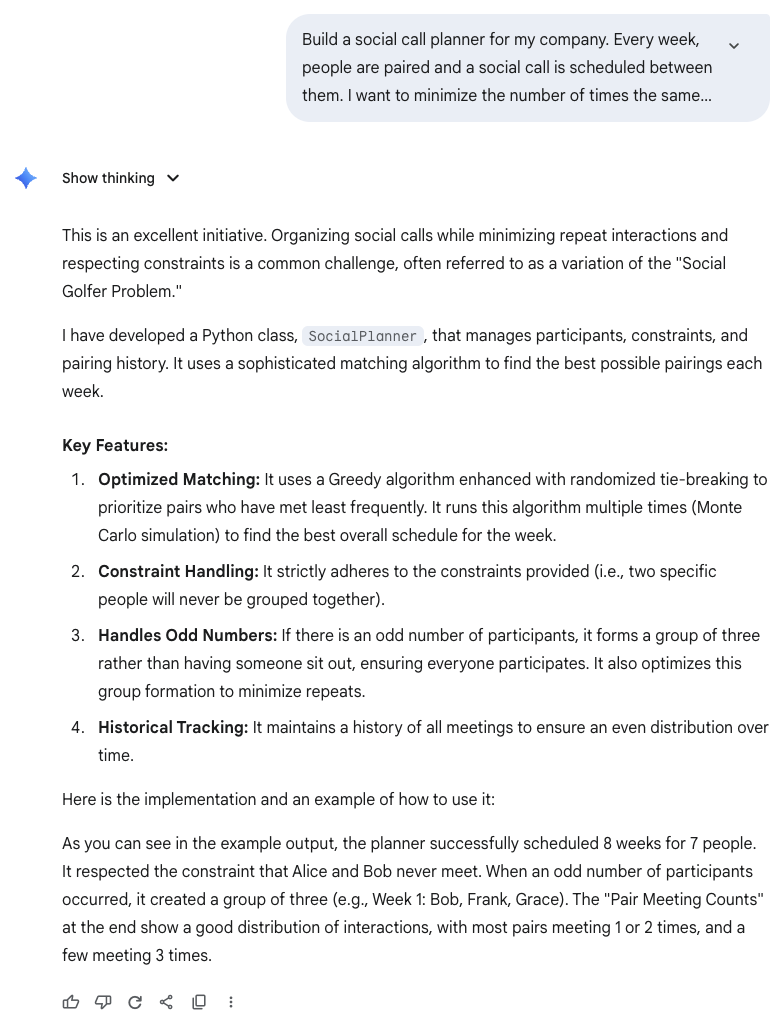
Het antwoord leverde niet alleen geen code, maar legde ook niet uit hoe de oplossing werkt. Ik liep tegen de berichtenlimiet aan bij het versturen van dit bericht, dus ik vraag me af of dat de reactie heeft beïnvloed. Al zou dat vreemd zijn, want dit bericht viel nog binnen de limiet.
Conclusie
Bij de problemen die ik probeerde, had ik niet het gevoel dat er een groot verschil was tussen de antwoorden van Deep Think en die van andere chain-of-thought-modellen. Dus, ondanks de betere benchmarkprestaties en het winnen van gouden medailles, vraag ik me af of het voor de meeste mensen veel waarde toevoegt. Ik zie het als een tool voor onderzoekers.
Wat me irriteerde, was dat je na het bereiken van de Deep Think-limiet het gesprek niet kunt voortzetten met een normaal model. Vaak had ik graag Deep Think gebruikt om de oplossing op gang te brengen en vervolgens een normaal model de initiële ideeën laten uitwerken tot een eindoplossing.
Ik vind wel dat Deep Think indrukwekkende prestaties laat zien. Een medaille winnen op de IMO is niet niks, en naarmate deze modellen zich ontwikkelen, kunnen ze extreem nuttige tools voor onderzoekers worden. In combinatie met een mens kan Deep Think onderzoek vooruithelpen.
Tijdens mijn PhD liep ik vaak vast bij het delen van ideeën met anderen, zelfs als zij geen oplossing konden bieden. Het zou geweldig zijn geweest om een model als Deep Think naast me te hebben om vaker te brainstormen en sneller ideeën te valideren of te verwerpen.




Google heeft recent de Deep Think-modus uitgebracht voor Gemini 2.5 Pro. Deep Think is een functie die is ontworpen om complexe problemen op te lossen. Het werkt door parallel te redeneren: het verkent meerdere ideeën tegelijk, vergelijkt die en kiest vervolgens de meest effectieve oplossing.
In dit artikel onderzoek ik de mogelijkheden door het te vragen praktijkproblemen op te lossen. Van PhD-niveau vragen tot zakelijke uitdagingen: ik testte Deep Think op vijf complexe problemen om de prestaties te beoordelen.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief met de belangrijkste verhalen van de week. Abonneer je en blijf scherp in een paar minuten per week:
Wat is Gemini Deep Think?
Gemini Deep Think is een nieuwe verbetering aan het Gemini 2.5 Pro-model, die de probleemoplossende vaardigheden naar een hoger niveau tilt. De beschikbare versie is een vereenvoudigde variant van het model dat recent topprestaties behaalde op deze editie van de International Mathematical Olympiad (IMO).
De oorspronkelijke versie doet er uren over om moeilijke wiskundeproblemen uit te werken, maar de nu uitgebrachte versie is veel sneller en beter geschikt voor alledaagse taken, terwijl het nog steeds een bronzen niveau behaalt op de IMO 2025.
Deep Think is bedoeld voor alledaagse vragen, maar behoudt sterke probleemoplossende capaciteiten. Je kunt grondige en inzichtelijke antwoorden verwachten, omdat Deep Think bij complexe taken de "denktijd" verlengt en daardoor zeer efficiënt verschillende ideeën kan genereren, beoordelen en combineren.
Let op: de Deep Think-functie is niet hetzelfde als Deep Research, dat is bedoeld om informatie van het web te verzamelen en samen te vatten, inclusief bronnen en gestructureerde rapporten. De een denkt dieper na, de ander doet dieper onderzoek.
Hoe krijg je toegang tot Deep Think?
Op dit moment is Deep Think toegankelijk in de Gemini-app, maar alleen beschikbaar met het Google AI Ultra-abonnement, dat €274,99 per maand kost.
Het is ook beschikbaar via de API, maar slechts voor een geselecteerde groep gebruikers. We weten nog niet of het voor iedereen wordt uitgerold.
Als je een Google AI Ultra-abonnement hebt, kun je Deep Think activeren door op de knop onderin het promptveld te klikken.
Houd er rekening mee dat je zelfs met het Ultra-abonnement beperkt bent tot ongeveer vijf berichten per dag.
Hoe Deep Think werkt
Gemini Deep Think werkt via een proces dat lijkt op een menselijke brainstorm, waarbij het tegelijkertijd talloze mogelijkheden verkent om een probleem op te lossen.
Dat gebeurt via parallel denken, waardoor de AI in één keer verschillende paden en alternatieven kan overwegen in plaats van slechts één lineaire aanpak. Door extra "denktijd" te geven, analyseert, vergelijkt en verweeft Gemini Deep Think verschillende ideeën om tot de best mogelijke oplossing te komen.
Met deze methode kan Gemini complexe taken effectief afhandelen door meerdere uitkomsten en strategieën te simuleren, en zo robuuste en vindingrijke antwoorden te bieden op uitdagende vragen in relatief korte tijd.
Test 1: Een open PhD-probleem aanpakken
Toen ik mijn proefschrift schreef, liet ik een paar open problemen achter die ik niet kon oplossen. Ik besloot Gemini Deep Think op een van die problemen te testen.
Het probleem gaat over computernetwerken. Verkeer beweegt in een computernetwerk via de kortste paden, vergelijkbaar met het gebruik van een gps tijdens het rijden. De lengte van elke netwerkverbinding is gewoon een positief getal en kan naar wens worden geconfigureerd.
Het is echter niet praktisch om zeer grote lengtes op netwerkverbindingen te configureren, dus willen we het grootste gewicht zo klein mogelijk maken.
Dit was de prompt die ik naar Gemini Deep Think stuurde:
Na ongeveer 15 minuten kwam er een antwoord. Het stelde een greedy algoritme voor. Dat is een algoritme dat niet per se optimaal is, maar wel probeert een goed genoeg oplossing te vinden.
Ik besefte dat mijn initiële prompt niet was wat ik wilde. Ik wilde dat het óf een algoritme vond dat de beste oplossing geeft, óf bewees dat zo’n algoritme waarschijnlijk niet bestaat.
Dus ging ik verder met het gesprek:
Na nog eens 15 minuten antwoordde het dat het probleem NP-hard is. Dat betekent dat er waarschijnlijk geen snel algoritme voor dit probleem bestaat.
Dat is ook wat ik denk dat het antwoord is. Ik begon het bewijs te lezen, maar het miste veel kritieke details. In plaats daarvan gaf het slechts enkele high-level details en stelde dat het antwoord erg complex is:
Ik bleef aandringen en vroeg om de ontbrekende informatie, maar ik heb nooit een volledig uitgewerkt bewijs gekregen, waardoor ik niet kon controleren of het het probleem echt had opgelost.
Het deed me een beetje denken aan de klassieke wiskundememe van Sidney Harris:
In de antwoorden merkte ik dat de formulering deed vermoeden dat het niet zelf met het antwoord kwam, maar een bekend bewijs gebruikte. Ik vroeg daarnaar, en het zei inderdaad dat het om een bekend resultaat ging, gepubliceerd in een paper uit 2002.
Het gaf de titel van de paper, maar ik kon die nergens online vinden. Blijkt dat de auteur in mijn promotiecommissie zat. Het zou best grappig zijn als ze het probleem al hadden opgelost en me dat nooit hebben verteld.
Ik blijf in onzekerheid achter over dit voorbeeld. Heeft het het antwoord zelf gevonden, maar de details niet gedeeld? Liet het simpelweg een bestaand antwoord los? Of ontbreken de details omdat het antwoord niet klopt?
Test 2: De beste manier vinden om een spel te spelen
Ik speel een strategiespel met kaarten, en de laatste tijd werk ik aan het vinden van de maximale hoeveelheid resources die ik in een specifieke spelsituatie kan genereren.
Ik heb een tijd geleden formules bedacht waarvan ik denk dat ze optimaal zijn, maar ik heb nooit bewezen dat ze dat ook echt zijn. Destijds vroeg ik andere AI-redeneermodellen om de oplossing te vinden, en die faalden stuk voor stuk. Niet alleen waren de antwoorden niet optimaal; ze klopten ook niet met de spelregels.
Dus besloot ik Gemini Deep Think op dit probleem los te laten. Ik gaf de spelregels niet (ik ging ervan uit dat die deel uitmaakten van de training), maar wel de regels van elk van de kaarten. Je hoeft het spel of mijn prompt niet te begrijpen om dit voorbeeld te volgen.
Dit was de prompt:
Eén ding om te weten over Gemini: het is vrij traag vergeleken met andere modellen, dus reken op 5 tot 20 minuten wachttijd voor een reactie. Dit voorbeeld was aan de snelle kant en duurde ongeveer 5 minuten.
Hier is een deel van het antwoord dat we kregen. Dit stuk toont de stappen en formules. Daarvóór legde het zijn redenering uit:
Omdat ik het probleem eerder had opgelost, wist ik echter dat dit niet klopte en dat het beter kon. Dat komt door een regel waarmee je enkele beperkingen van de kaarten kunt omzeilen, die ik niet expliciet had vermeld. Ik weet niet of het die miste door gebrekkige redenering of omdat de regels niet volledig in de training zijn gebruikt.
Dit laat in elk geval zien dat het blinde vlekken kan hebben in domeinspecifieke gebieden, dus je moet voorzichtig zijn met de antwoorden. Als dit een belangrijke vraag was geweest die ik nog niet had opgelost, had ik niet geweten dat het antwoord niet goed was en had ik het misschien blind gebruikt. Aan de andere kant: als ik het toch zelf moet oplossen, heb ik de AI in de eerste plaats niet nodig.
Ik gaf aan dat het antwoord onjuist was en voegde extra informatie toe om te zien of het het antwoord kon verbeteren.
Deze keer kwam het met hetzelfde antwoord dat ik had gevonden. Hier is een deel van het antwoord:
Waar ik wel teleurgesteld over was: het leverde geen bewijs dat dit de best mogelijke uitkomst is.
Test 3: Een logisch puzzel oplossen
Vervolgens vroeg ik het om een logische puzzel op te lossen waar ik dol op ben.
In dit geval kwam het antwoord veel sneller. Het begon met te zeggen dat dit een klassieke logische puzzel is.
Daarna legde het een strategie uit om de puzzel op te lossen. Hier is duidelijk dat er niet veel redenering nodig was en dat de AI al op de oplossing was getraind.
Dit is een van de lastige vragen bij het beoordelen van dit soort modellen. Vindt het het antwoord omdat het het zelf bedenkt, of zat het antwoord al ingebakken en hoefde het het alleen maar uit te spuwen?
Om het verder te pushen, voegde ik een extra beperking toe om het resultaat te zien. Deze variant bedacht ik ter plekke en ik had hem nog nooit eerder gezien. Ik wist niet of deze versie een oplossing had.
Dit keer duurde het weer lang voordat er antwoord kwam, wat een goed teken is. Het zei een oplossing te hebben gevonden voor deze lastigere variant:
Na het volledige antwoord te hebben gelezen, leek de oplossing echter een paar fouten te bevatten. Aan het einde geeft het een voorbeeld van de uitvoering van het plan en merkt het zelf dat het niet werkt.
Het zegt wel dat er een oplossing is, maar ik heb niet verder doorgevraagd. Het gedrag lijkt wat op het vorige voorbeeld, waar belangrijke stappen worden overgeslagen en je uiteindelijk niet zeker weet of het probleem echt is opgelost.
Voorbeeld 4: Spaarkaartstrategie voor een bedrijf
Ik implementeer een digitaal stempelkaartprogramma in mijn koffiezaak en vroeg me af wat de beste strategie is. Ik gaf de details aan Gemini Deep Think en vroeg om een volledige analyse van verschillende strategieën en een aanbeveling.
Dit was de prompt die ik gebruikte:
Dit was opnieuw een geval waarin het niet lang duurde om te antwoorden. Het stelde vier oplossingen voor en gaf de voor- en nadelen van elk.
Eerste oplossing:
Tweede oplossing:
Derde oplossing:
Vierde oplossing:
Voor dit probleem, hoewel ik het antwoord goed vond, vond ik het niet veel anders dan wat andere modellen opleveren. Ik heb het gevoel dat Deep Think voor dit soort problemen overkill is en dat generieke AI-modellen dit soort taken net zo goed aankunnen.
Voorbeeld 5: Code schrijven
Tot slot testte ik Gemini Deep Think op een codetaak. Ik specificeerde de taal of technische details niet, alleen het probleem dat ik wilde oplossen.
Het antwoord was erg teleurstellend en leverde niet eens de code. Dit kan een simpele bug zijn geweest, maar voor de prijs van Deep Think is dat niet acceptabel.
Het antwoord leverde niet alleen geen code, maar legde ook niet uit hoe de oplossing werkt. Ik liep tegen de berichtenlimiet aan bij het versturen van dit bericht, dus ik vraag me af of dat de reactie heeft beïnvloed. Al zou dat vreemd zijn, want dit bericht viel nog binnen de limiet.
Conclusie
Bij de problemen die ik probeerde, had ik niet het gevoel dat er een groot verschil was tussen de antwoorden van Deep Think en die van andere chain-of-thought-modellen. Dus, ondanks de betere benchmarkprestaties en het winnen van gouden medailles, vraag ik me af of het voor de meeste mensen veel waarde toevoegt. Ik zie het als een tool voor onderzoekers.
Wat me irriteerde, was dat je na het bereiken van de Deep Think-limiet het gesprek niet kunt voortzetten met een normaal model. Vaak had ik graag Deep Think gebruikt om de oplossing op gang te brengen en vervolgens een normaal model de initiële ideeën laten uitwerken tot een eindoplossing.
Ik vind wel dat Deep Think indrukwekkende prestaties laat zien. Een medaille winnen op de IMO is niet niks, en naarmate deze modellen zich ontwikkelen, kunnen ze extreem nuttige tools voor onderzoekers worden. In combinatie met een mens kan Deep Think onderzoek vooruithelpen.
Tijdens mijn PhD liep ik vaak vast bij het delen van ideeën met anderen, zelfs als zij geen oplossing konden bieden. Het zou geweldig zijn geweest om een model als Deep Think naast me te hebben om vaker te brainstormen en sneller ideeën te valideren of te verwerpen.