Beginners met kunstmatige neurale netwerken (ANN's) stellen vaak een paar vragen. Een aantal daarvan zijn: hoeveel verborgen lagen moet je gebruiken? Hoeveel verborgen neuronen per verborgen laag? Wat is het nut van verborgen lagen/neuronen? Leidt meer verborgen lagen/neuronen altijd tot betere resultaten? Goed nieuws: we kunnen zulke vragen beantwoorden. Let wel, het kan erg complex worden als het onderliggende probleem ingewikkeld is. Aan het einde van dit artikel heb je in elk geval een idee hoe je dit soort vragen beantwoordt en kun je jezelf testen aan de hand van simpele voorbeelden.
Introductie
ANN is geïnspireerd op het biologische neurale netwerk. Voor de eenvoud wordt het in de informatica voorgesteld als een reeks lagen. Deze lagen vallen in drie categorieën: input, verborgen en output.
Het aantal input- en outputlagen en hun aantal neuronen bepalen is het makkelijkst. Elk netwerk heeft precies één input- en één outputlaag. Het aantal neuronen in de inputlaag is gelijk aan het aantal inputvariabelen in de te verwerken data. Het aantal neuronen in de outputlaag is gelijk aan het aantal outputs dat bij elke input hoort. De uitdaging zit in het bepalen van het aantal verborgen lagen en hun neuronen.
Hier zijn wat richtlijnen om bij een classificatieprobleem het aantal verborgen lagen en het aantal neuronen per verborgen laag te bepalen:
- Teken, op basis van de data, een verwachte beslissingsgrens om de klassen te scheiden.
- Druk de beslissingsgrens uit als een set lijnen. Let erop dat de combinatie van die lijnen samen de beslissingsgrens moet vormen.
- Het aantal gekozen lijnen staat voor het aantal verborgen neuronen in de eerste verborgen laag.
- Om de lijnen uit de vorige laag met elkaar te verbinden, voeg je een nieuwe verborgen laag toe. Voeg telkens een nieuwe verborgen laag toe wanneer je verbindingen moet leggen tussen de lijnen uit de vorige verborgen laag.
- Het aantal verborgen neuronen in elke nieuwe verborgen laag is gelijk aan het aantal te leggen verbindingen.
Om het concreter te maken, passen we de bovenstaande richtlijnen toe op een aantal voorbeelden.
Voorbeeld één
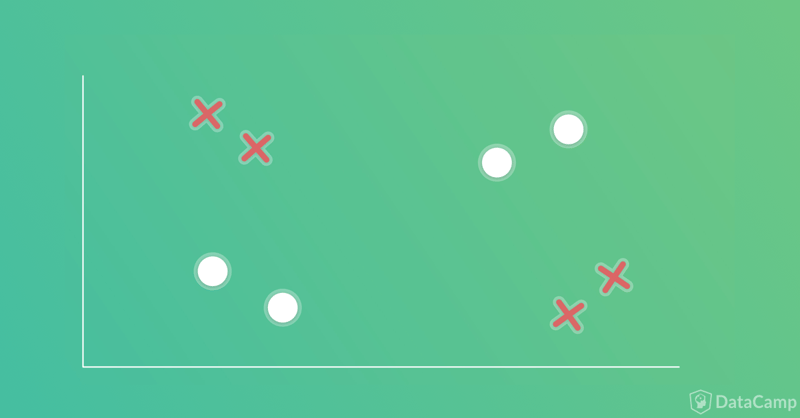
We beginnen met een eenvoudig classificatieprobleem met twee klassen, zoals in de volgende figuur. Elke sample heeft twee inputs en één output die het klassenlabel aangeeft. Het lijkt sterk op het XOR-probleem.
De eerste vraag is of verborgen lagen nodig zijn. Een vuistregel om te bepalen of verborgen lagen nodig zijn, is als volgt:
In kunstmatige neurale netwerken zijn verborgen lagen nodig als en alleen als de data niet-lineair gescheiden moet worden.
Kijkend naar de volgende figuur lijken de klassen niet-lineair te moeten worden gescheiden. Één enkele lijn werkt niet. Daarom moeten we verborgen lagen gebruiken om de beste beslissingsgrens te krijgen. Je kunt in dit geval alsnog zonder verborgen lagen werken, maar dat gaat ten koste van de classificatienauwkeurigheid. Het is dus beter om verborgen lagen te gebruiken.
Nu we weten dat we verborgen lagen nodig hebben, moeten we twee belangrijke vragen beantwoorden:
-
Wat is het vereiste aantal verborgen lagen?
-
Hoeveel verborgen neuronen per verborgen laag?
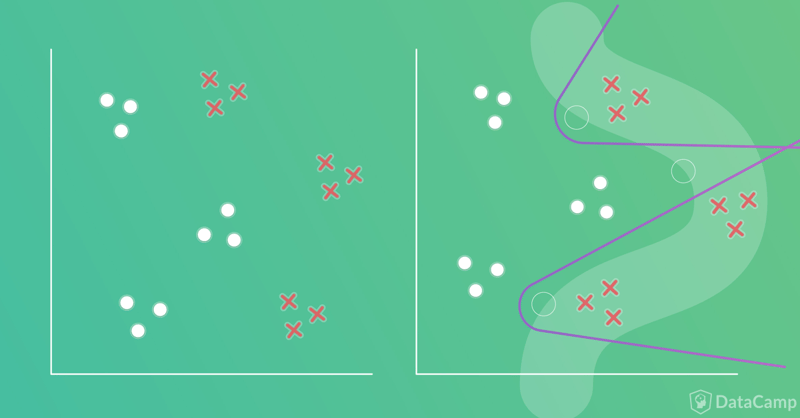
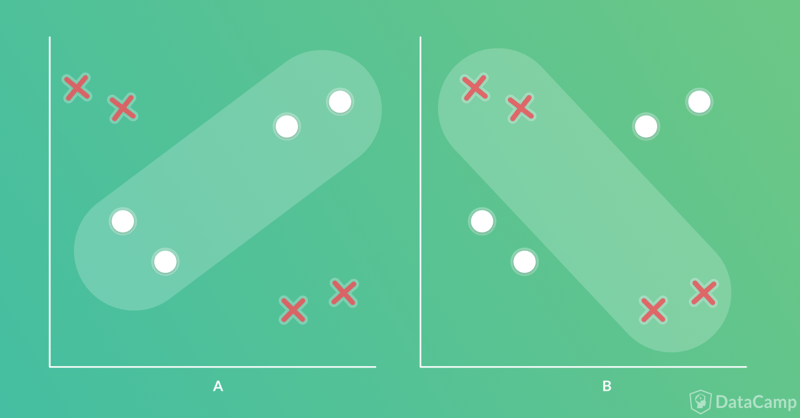
Volgens de procedure is de eerste stap het tekenen van de beslissingsgrens die de twee klassen scheidt. Er zijn meerdere mogelijke beslissingsgrenzen die de data correct splitsen, zoals in de figuur hieronder. De grens die we verder gebruiken is die in het rechterdeel van de figuur (b).
Volgens de richtlijnen is de volgende stap om de beslissingsgrens als een set lijnen uit te drukken.
Het idee om de beslissingsgrens te representeren met een set lijnen komt voort uit het feit dat elke ANN is opgebouwd uit de enkelvoudige perceptronlaag als bouwsteen. De enkelvoudige perceptron is een lineaire classifier die klassen scheidt met een lijn op basis van de volgende vergelijking:
y=w1x1+w2x2+ ⋯ +wixi+b
Waarbij xi de ide input is, wi het gewicht, b de bias en y de output. Omdat elk toegevoegd verborgen neuron het aantal gewichten vergroot, is het aan te raden zo weinig mogelijk verborgen neuronen te gebruiken om de taak te volbrengen. Meer verborgen neuronen dan nodig voegen onnodige complexiteit toe.
Terug naar ons voorbeeld: zeggen dat de ANN is opgebouwd uit meerdere perceptronnetwerken komt neer op zeggen dat het netwerk is opgebouwd uit meerdere lijnen.
In dit voorbeeld vervangen we de beslissingsgrens door een set lijnen. De lijnen beginnen op de punten waar de grenscurve van richting verandert. Op zo'n punt plaats je twee lijnen, elk in een andere richting.
Omdat er maar één punt is waar de grenscurve van richting verandert, aangegeven met een grijze cirkel in de volgende figuur, zijn er slechts twee lijnen nodig. Met andere woorden: er zijn twee enkelvoudige perceptronnetwerken. Elk perceptron levert één lijn op.
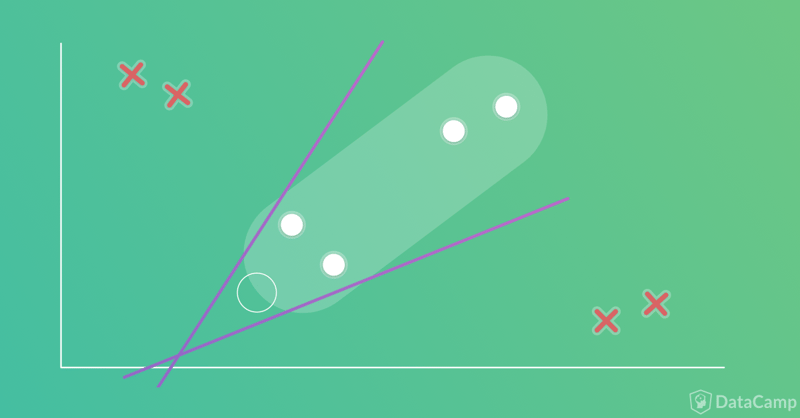
Dat er twee lijnen nodig zijn om de beslissingsgrens te representeren, vertelt ons dat de eerste verborgen laag twee verborgen neuronen krijgt.
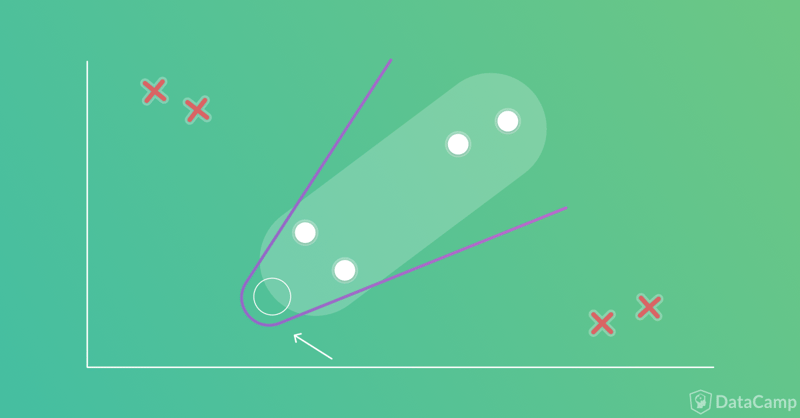
Tot nu toe hebben we één verborgen laag met twee verborgen neuronen. Elk verborgen neuron kun je zien als een lineaire classifier die als een lijn wordt weergegeven, zoals in de vorige figuur. Er zijn dus twee outputs, één per classifier (oftewel verborgen neuron). Maar we willen één classifier met één output die het klassenlabel vertegenwoordigt, niet twee classifiers. Daarom moeten de outputs van de twee verborgen neuronen worden samengevoegd tot één output. Met andere woorden: de twee lijnen moeten worden verbonden door een ander neuron. Het resultaat staat in de volgende figuur.
Gelukkig hoeven we daarvoor geen extra verborgen laag met één neuron toe te voegen. Het neuron in de outputlaag kan die taak uitvoeren. Dat neuron voegt de twee eerder gegenereerde lijnen samen zodat er slechts één output van het netwerk is.
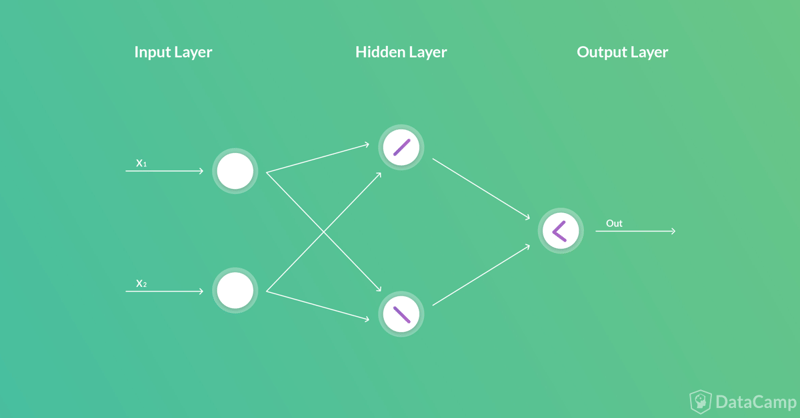
Nu we het aantal verborgen lagen en hun neuronen kennen, is de netwerkarchitectuur compleet, zoals in de volgende figuur.
Voorbeeld twee
Een ander classificatievoorbeeld staat in de volgende figuur. Het lijkt op het vorige voorbeeld met twee klassen, waarbij elke sample twee inputs en één output heeft. Het verschil zit in de beslissingsgrens. De grens in dit voorbeeld is complexer dan in het vorige.
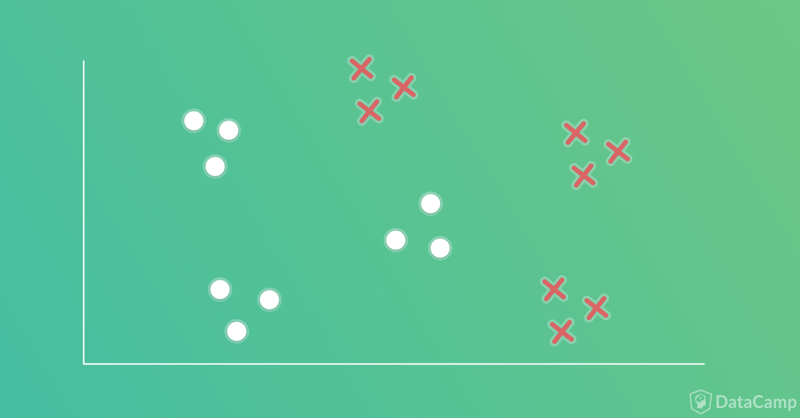
Volgens de richtlijnen is de eerste stap het tekenen van de beslissingsgrens. De beslissingsgrens die we hier gebruiken, staat in het meest linkse deel van de volgende figuur (a).
De volgende stap is om de beslissingsgrens in een set lijnen op te delen, waarbij elke lijn als een perceptron in de ANN wordt gemodelleerd. Voordat je lijnen tekent, markeer je de punten waar de grens van richting verandert, zoals in het meest rechtse deel van de volgende figuur (b).
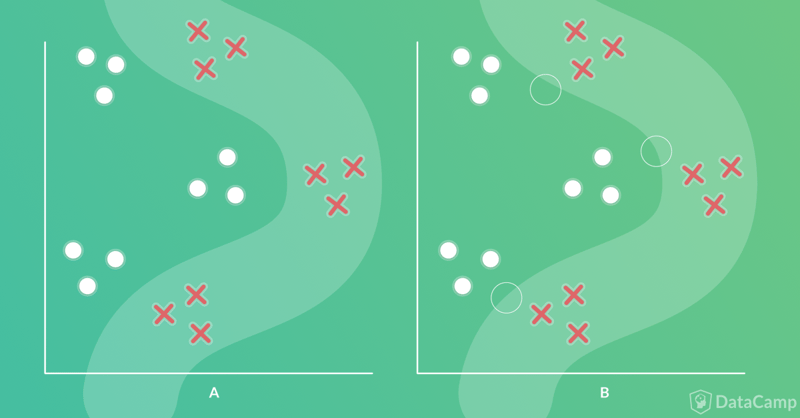
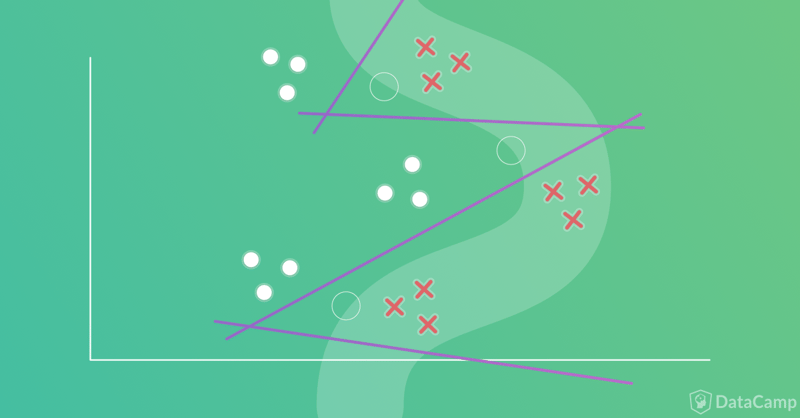
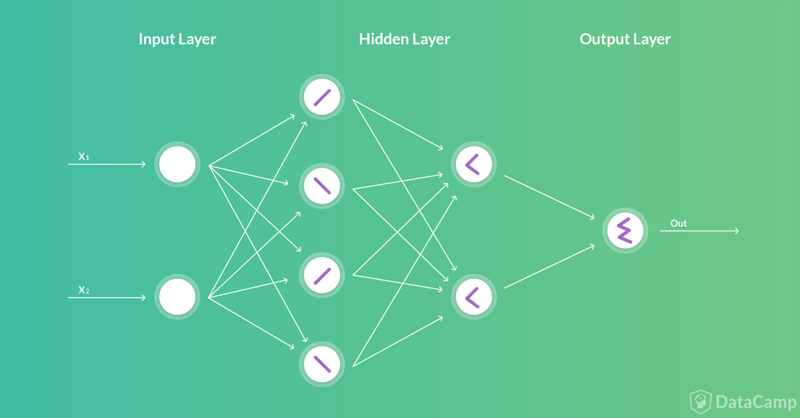
De vraag is: hoeveel lijnen zijn er nodig? Zowel het bovenste als het onderste punt krijgen elk twee bijbehorende lijnen, dus in totaal 4 lijnen. Het tussenliggende punt deelt zijn twee lijnen met de andere punten. De te maken lijnen staan in de onderstaande figuur.
Omdat de eerste verborgen laag evenveel verborgen neuronen krijgt als het aantal lijnen, heeft de eerste verborgen laag 4 neuronen. Met andere woorden: er zijn 4 classifiers, elk gemaakt door een enkelvoudige perceptron. Op dit moment genereert het netwerk 4 outputs, één per classifier. Vervolgens moeten we deze classifiers met elkaar verbinden zodat het netwerk nog maar één output genereert. Met andere woorden: de lijnen moeten door andere verborgen lagen met elkaar verbonden worden tot één enkele curve.
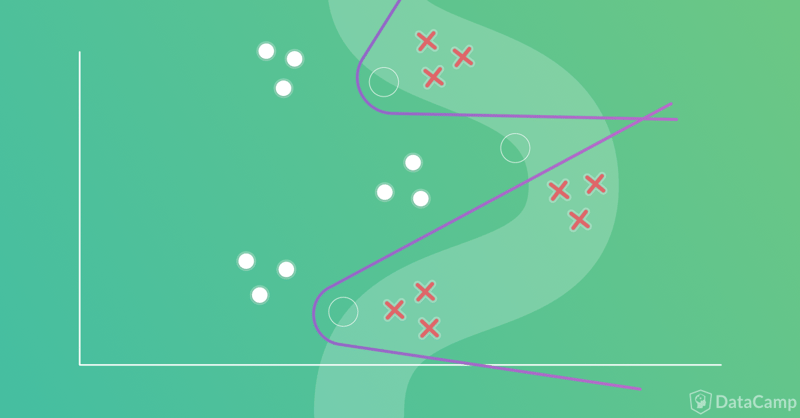
De modelontwerper kiest de lay-out van het netwerk. Een haalbare architectuur is een tweede verborgen laag met twee verborgen neuronen. Het eerste verborgen neuron verbindt de eerste twee lijnen en het tweede verborgen neuron verbindt de laatste twee lijnen. Het resultaat van de tweede verborgen laag. Het resultaat van de tweede laag staat in de onderstaande figuur.
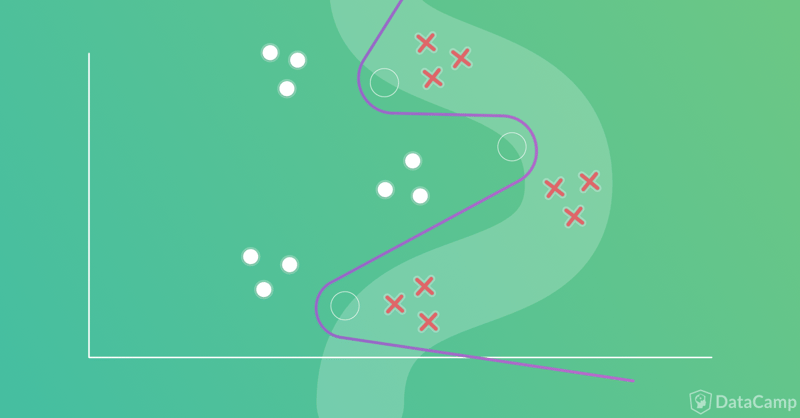
Tot nu toe zijn er twee afzonderlijke curves. Er zijn dus twee outputs van het netwerk. Vervolgens moeten deze curves met elkaar verbonden worden zodat er nog maar één output van het hele netwerk is. In dit geval kan het neuron in de outputlaag de laatste verbinding maken, zonder een nieuwe verborgen laag toe te voegen. Het eindresultaat staat in de volgende figuur.
Als het netwerkontwerp klaar is, ziet de complete netwerkarchitectuur er als volgt uit.
Meer info
SlideShare
YouTube


Beginners met kunstmatige neurale netwerken (ANN's) stellen vaak een paar vragen. Een aantal daarvan zijn: hoeveel verborgen lagen moet je gebruiken? Hoeveel verborgen neuronen per verborgen laag? Wat is het nut van verborgen lagen/neuronen? Leidt meer verborgen lagen/neuronen altijd tot betere resultaten? Goed nieuws: we kunnen zulke vragen beantwoorden. Let wel, het kan erg complex worden als het onderliggende probleem ingewikkeld is. Aan het einde van dit artikel heb je in elk geval een idee hoe je dit soort vragen beantwoordt en kun je jezelf testen aan de hand van simpele voorbeelden.
Introductie
ANN is geïnspireerd op het biologische neurale netwerk. Voor de eenvoud wordt het in de informatica voorgesteld als een reeks lagen. Deze lagen vallen in drie categorieën: input, verborgen en output.
Het aantal input- en outputlagen en hun aantal neuronen bepalen is het makkelijkst. Elk netwerk heeft precies één input- en één outputlaag. Het aantal neuronen in de inputlaag is gelijk aan het aantal inputvariabelen in de te verwerken data. Het aantal neuronen in de outputlaag is gelijk aan het aantal outputs dat bij elke input hoort. De uitdaging zit in het bepalen van het aantal verborgen lagen en hun neuronen.
Hier zijn wat richtlijnen om bij een classificatieprobleem het aantal verborgen lagen en het aantal neuronen per verborgen laag te bepalen:
Om het concreter te maken, passen we de bovenstaande richtlijnen toe op een aantal voorbeelden.
Voorbeeld één
We beginnen met een eenvoudig classificatieprobleem met twee klassen, zoals in de volgende figuur. Elke sample heeft twee inputs en één output die het klassenlabel aangeeft. Het lijkt sterk op het XOR-probleem.
De eerste vraag is of verborgen lagen nodig zijn. Een vuistregel om te bepalen of verborgen lagen nodig zijn, is als volgt:
Kijkend naar de volgende figuur lijken de klassen niet-lineair te moeten worden gescheiden. Één enkele lijn werkt niet. Daarom moeten we verborgen lagen gebruiken om de beste beslissingsgrens te krijgen. Je kunt in dit geval alsnog zonder verborgen lagen werken, maar dat gaat ten koste van de classificatienauwkeurigheid. Het is dus beter om verborgen lagen te gebruiken.
Nu we weten dat we verborgen lagen nodig hebben, moeten we twee belangrijke vragen beantwoorden:
Wat is het vereiste aantal verborgen lagen?
Hoeveel verborgen neuronen per verborgen laag?
Volgens de procedure is de eerste stap het tekenen van de beslissingsgrens die de twee klassen scheidt. Er zijn meerdere mogelijke beslissingsgrenzen die de data correct splitsen, zoals in de figuur hieronder. De grens die we verder gebruiken is die in het rechterdeel van de figuur (b).
Volgens de richtlijnen is de volgende stap om de beslissingsgrens als een set lijnen uit te drukken.
Het idee om de beslissingsgrens te representeren met een set lijnen komt voort uit het feit dat elke ANN is opgebouwd uit de enkelvoudige perceptronlaag als bouwsteen. De enkelvoudige perceptron is een lineaire classifier die klassen scheidt met een lijn op basis van de volgende vergelijking:
y=w1x1+w2x2+ ⋯ +wixi+bWaarbij
xideide input is,wihet gewicht,bde bias enyde output. Omdat elk toegevoegd verborgen neuron het aantal gewichten vergroot, is het aan te raden zo weinig mogelijk verborgen neuronen te gebruiken om de taak te volbrengen. Meer verborgen neuronen dan nodig voegen onnodige complexiteit toe.Terug naar ons voorbeeld: zeggen dat de ANN is opgebouwd uit meerdere perceptronnetwerken komt neer op zeggen dat het netwerk is opgebouwd uit meerdere lijnen.
In dit voorbeeld vervangen we de beslissingsgrens door een set lijnen. De lijnen beginnen op de punten waar de grenscurve van richting verandert. Op zo'n punt plaats je twee lijnen, elk in een andere richting.
Omdat er maar één punt is waar de grenscurve van richting verandert, aangegeven met een grijze cirkel in de volgende figuur, zijn er slechts twee lijnen nodig. Met andere woorden: er zijn twee enkelvoudige perceptronnetwerken. Elk perceptron levert één lijn op.
Dat er twee lijnen nodig zijn om de beslissingsgrens te representeren, vertelt ons dat de eerste verborgen laag twee verborgen neuronen krijgt.
Tot nu toe hebben we één verborgen laag met twee verborgen neuronen. Elk verborgen neuron kun je zien als een lineaire classifier die als een lijn wordt weergegeven, zoals in de vorige figuur. Er zijn dus twee outputs, één per classifier (oftewel verborgen neuron). Maar we willen één classifier met één output die het klassenlabel vertegenwoordigt, niet twee classifiers. Daarom moeten de outputs van de twee verborgen neuronen worden samengevoegd tot één output. Met andere woorden: de twee lijnen moeten worden verbonden door een ander neuron. Het resultaat staat in de volgende figuur.
Gelukkig hoeven we daarvoor geen extra verborgen laag met één neuron toe te voegen. Het neuron in de outputlaag kan die taak uitvoeren. Dat neuron voegt de twee eerder gegenereerde lijnen samen zodat er slechts één output van het netwerk is.
Nu we het aantal verborgen lagen en hun neuronen kennen, is de netwerkarchitectuur compleet, zoals in de volgende figuur.
Voorbeeld twee
Een ander classificatievoorbeeld staat in de volgende figuur. Het lijkt op het vorige voorbeeld met twee klassen, waarbij elke sample twee inputs en één output heeft. Het verschil zit in de beslissingsgrens. De grens in dit voorbeeld is complexer dan in het vorige.
Volgens de richtlijnen is de eerste stap het tekenen van de beslissingsgrens. De beslissingsgrens die we hier gebruiken, staat in het meest linkse deel van de volgende figuur (a).
De volgende stap is om de beslissingsgrens in een set lijnen op te delen, waarbij elke lijn als een perceptron in de ANN wordt gemodelleerd. Voordat je lijnen tekent, markeer je de punten waar de grens van richting verandert, zoals in het meest rechtse deel van de volgende figuur (b).
De vraag is: hoeveel lijnen zijn er nodig? Zowel het bovenste als het onderste punt krijgen elk twee bijbehorende lijnen, dus in totaal 4 lijnen. Het tussenliggende punt deelt zijn twee lijnen met de andere punten. De te maken lijnen staan in de onderstaande figuur.
Omdat de eerste verborgen laag evenveel verborgen neuronen krijgt als het aantal lijnen, heeft de eerste verborgen laag 4 neuronen. Met andere woorden: er zijn 4 classifiers, elk gemaakt door een enkelvoudige perceptron. Op dit moment genereert het netwerk 4 outputs, één per classifier. Vervolgens moeten we deze classifiers met elkaar verbinden zodat het netwerk nog maar één output genereert. Met andere woorden: de lijnen moeten door andere verborgen lagen met elkaar verbonden worden tot één enkele curve.
De modelontwerper kiest de lay-out van het netwerk. Een haalbare architectuur is een tweede verborgen laag met twee verborgen neuronen. Het eerste verborgen neuron verbindt de eerste twee lijnen en het tweede verborgen neuron verbindt de laatste twee lijnen. Het resultaat van de tweede verborgen laag. Het resultaat van de tweede laag staat in de onderstaande figuur.
Tot nu toe zijn er twee afzonderlijke curves. Er zijn dus twee outputs van het netwerk. Vervolgens moeten deze curves met elkaar verbonden worden zodat er nog maar één output van het hele netwerk is. In dit geval kan het neuron in de outputlaag de laatste verbinding maken, zonder een nieuwe verborgen laag toe te voegen. Het eindresultaat staat in de volgende figuur.
Als het netwerkontwerp klaar is, ziet de complete netwerkarchitectuur er als volgt uit.
Meer info
Deep learning - een tutorial voor data scientists
Cursus Introduction to Deep Learning in Python
SlideShare
YouTube