Cours
Introduction au Deep Learning en Python
4 h
264.6K
Les débutants en réseaux de neurones artificiels (RNA) se posent souvent les mêmes questions : combien de couches cachées utiliser ? Combien de neurones par couche cachée ? À quoi servent ces couches/neurones ? Augmenter leur nombre améliore-t-il toujours les résultats ? Bonne nouvelle : nous pouvons y répondre. Soyons clairs : si le problème à résoudre est très complexe, les réponses le seront aussi. Mais à la fin de cet article, vous aurez une méthode pour aborder ces questions et pourrez vous exercer sur des exemples simples.
Les RNA s’inspirent du réseau neuronal biologique. Pour simplifier, en informatique, on les représente comme un empilement de couches. Ces couches se répartissent en trois catégories : entrée, cachées et sortie.
Déterminer le nombre de couches d’entrée et de sortie, ainsi que leurs neurones, est la partie la plus simple. Chaque réseau comporte une seule couche d’entrée et une seule couche de sortie. Le nombre de neurones en entrée correspond au nombre de variables d’entrée dans les données. Le nombre de neurones en sortie correspond au nombre de sorties associées à chaque entrée. Le vrai défi, c’est de fixer le nombre de couches cachées et de neurones qu’elles doivent contenir.
Voici des repères pour estimer le nombre de couches cachées et de neurones par couche dans un problème de classification :
Pour clarifier, appliquons ces principes à quelques exemples.
Commençons par un problème de classification simple à deux classes, illustré ci-dessous. Chaque échantillon possède deux entrées et une sortie représentant l’étiquette de classe. C’est très proche du problème XOR.
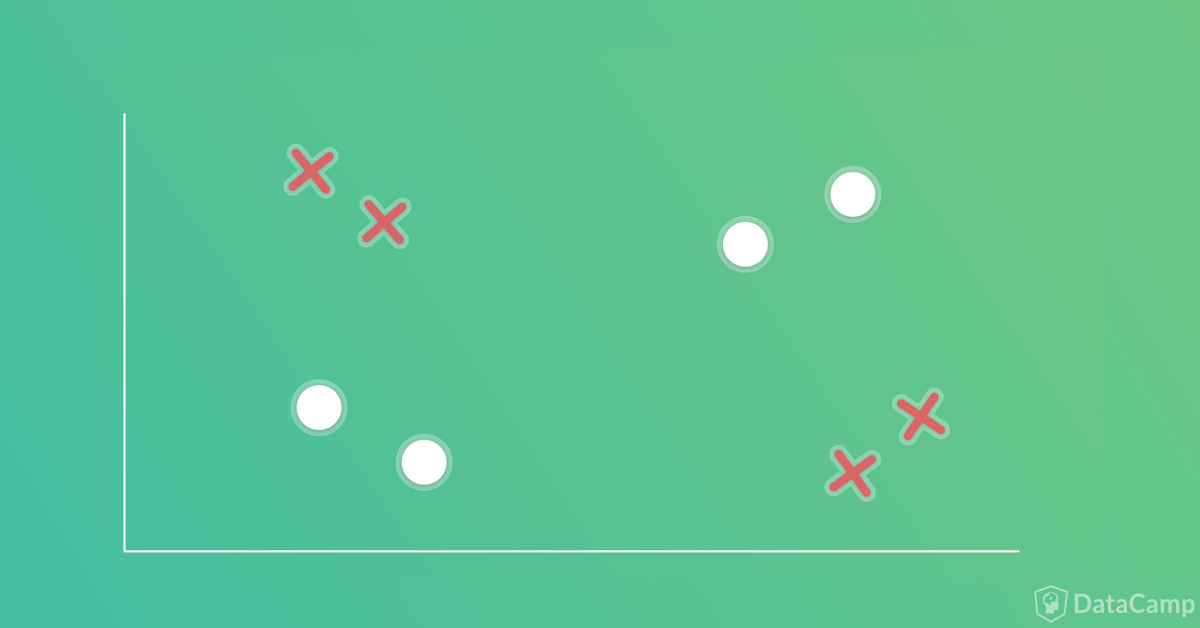
Première question : des couches cachées sont-elles nécessaires ? Une règle simple permet d’en décider :
Dans un réseau de neurones artificiels, des couches cachées sont nécessaires si et seulement si la séparation des données est non linéaire.
En observant la figure suivante, on voit que les classes doivent être séparées de façon non linéaire. Une seule droite ne suffit pas. Nous devons donc recourir à des couches cachées pour obtenir une frontière de décision pertinente. On pourrait tenter sans couches cachées, mais au prix d’une baisse de précision. Mieux vaut donc en utiliser.
Une fois admis que des couches cachées s’imposent, deux questions clés se posent :
Combien de couches cachées sont nécessaires ?
Combien de neurones dans chaque couche cachée ?
Selon la procédure décrite, on commence par tracer une frontière de décision séparant les deux classes. Plusieurs frontières conviennent, comme le montre la figure ci-dessous. Pour la suite, nous retiendrons celle de droite (b).
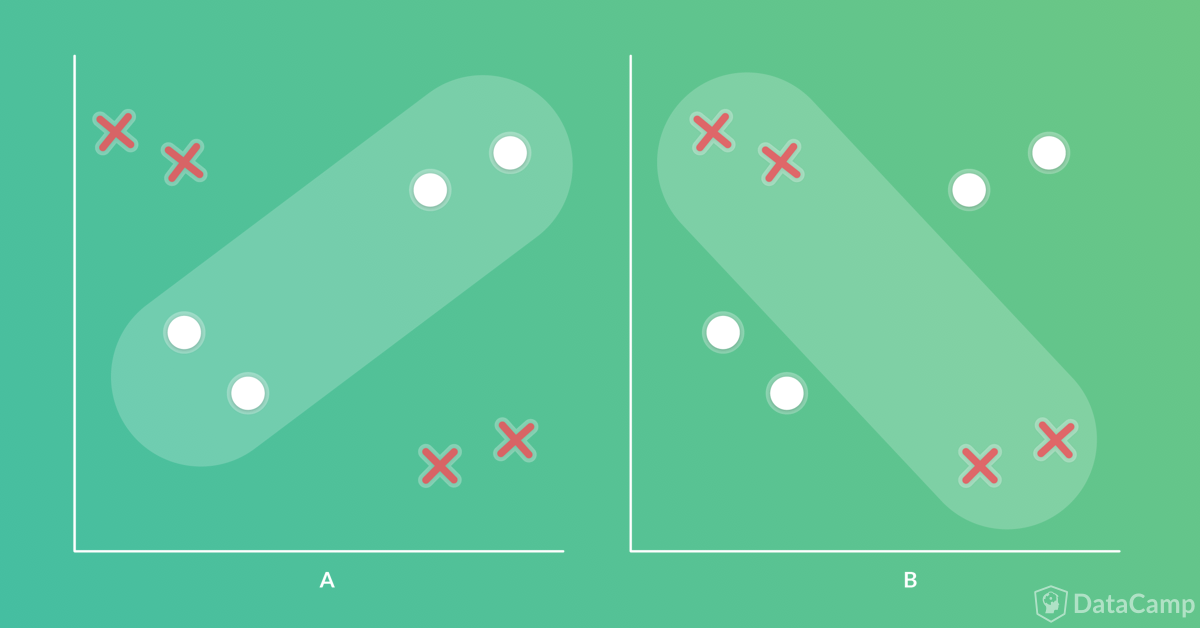
Suivant les repères, on exprime ensuite la frontière comme un ensemble de droites.
L’idée de représenter la frontière par des droites vient du fait que tout RNA est construit à partir du perceptron monocouche comme brique de base. Le perceptron monocouche est un classificateur linéaire qui sépare les classes par une droite définie par :
y=w1x1+w2x2+ ⋯ +wixi+b
où xi est la ie entrée, wi son poids, b le biais, et y la sortie. Chaque neurone caché ajouté augmente le nombre de poids ; il est donc recommandé d’employer le minimum de neurones nécessaires pour accomplir la tâche. En ajouter trop complexifie inutilement le modèle.
Revenons à l’exemple : dire que le RNA est bâti avec plusieurs perceptrons revient à dire qu’il est bâti avec plusieurs droites.
Ici, on remplace la frontière par des segments. On place des segments aux points où la courbe de frontière change de direction ; à ce point, on met deux segments, chacun dans une direction différente.
Comme il n’y a qu’un seul point de changement de direction (cercle gris sur la figure suivante), deux segments suffisent. Autrement dit, deux perceptrons monocouches ; chaque perceptron produit une droite.
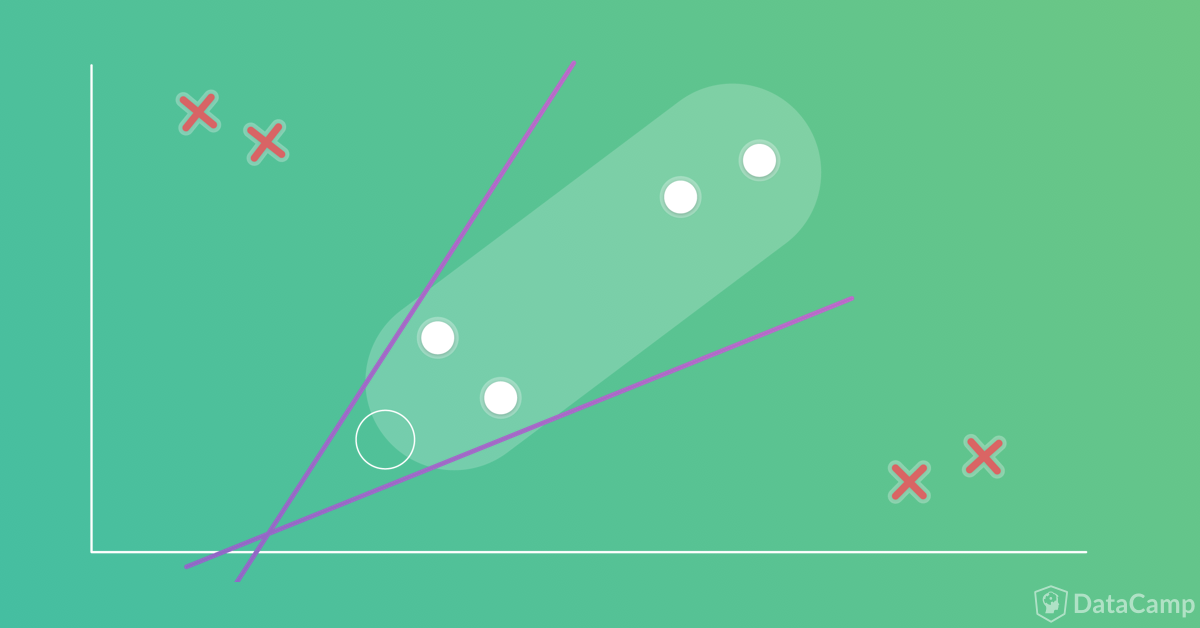
Savoir que deux droites suffisent pour représenter la frontière implique que la première couche cachée comptera deux neurones.
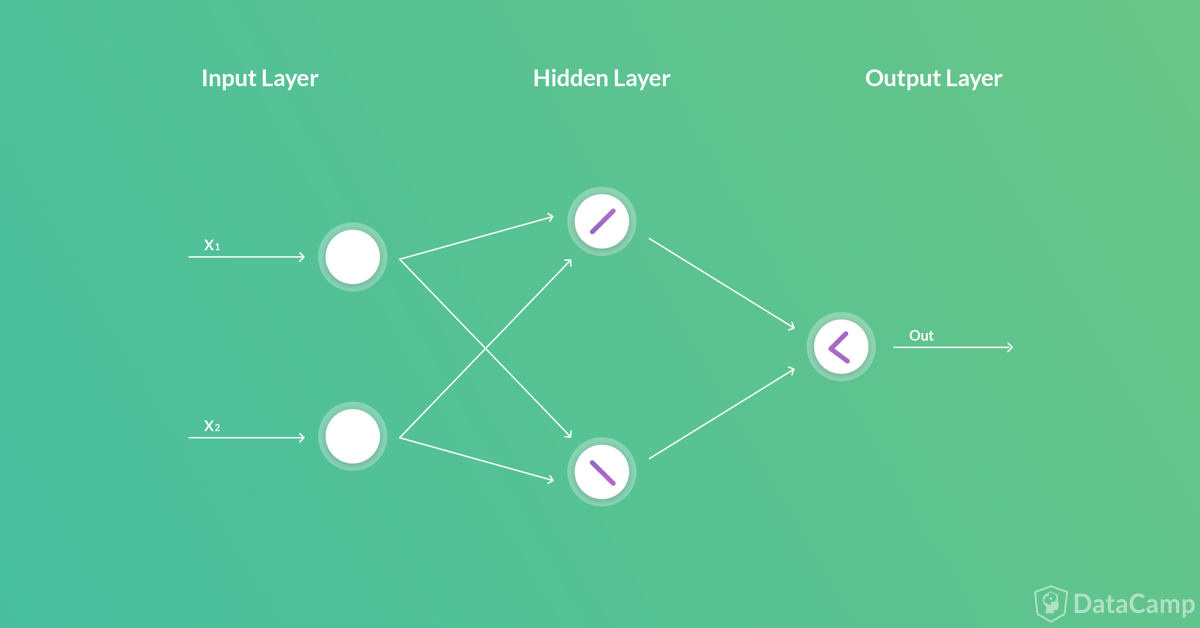
À ce stade, nous avons une couche cachée unique avec deux neurones. Chaque neurone caché agit comme un classificateur linéaire représenté par une droite (voir figure). Il y aura donc deux sorties, une par classificateur (donc par neurone caché). Or nous voulons un classificateur unique avec une seule sortie représentant l’étiquette, pas deux classificateurs. Il faut donc fusionner les sorties des deux neurones cachés en une sortie unique : en d’autres termes, relier les deux droites via un autre neurone. Le résultat est illustré ci-dessous.
Bonne nouvelle : nul besoin d’ajouter une nouvelle couche cachée avec un seul neurone pour cela. Le neurone de la couche de sortie suffit. Il fusionnera les deux droites générées précédemment afin que le réseau ne produise qu’une seule sortie.
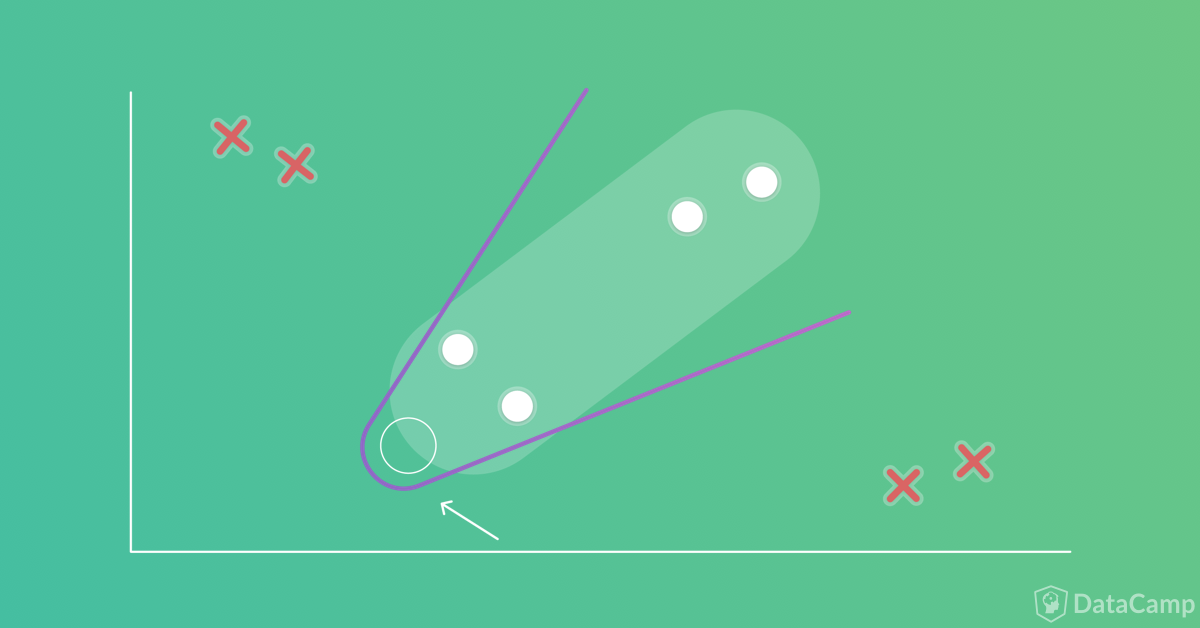
Une fois le nombre de couches cachées et de neurones fixé, l’architecture du réseau est complète, comme ci-dessous.
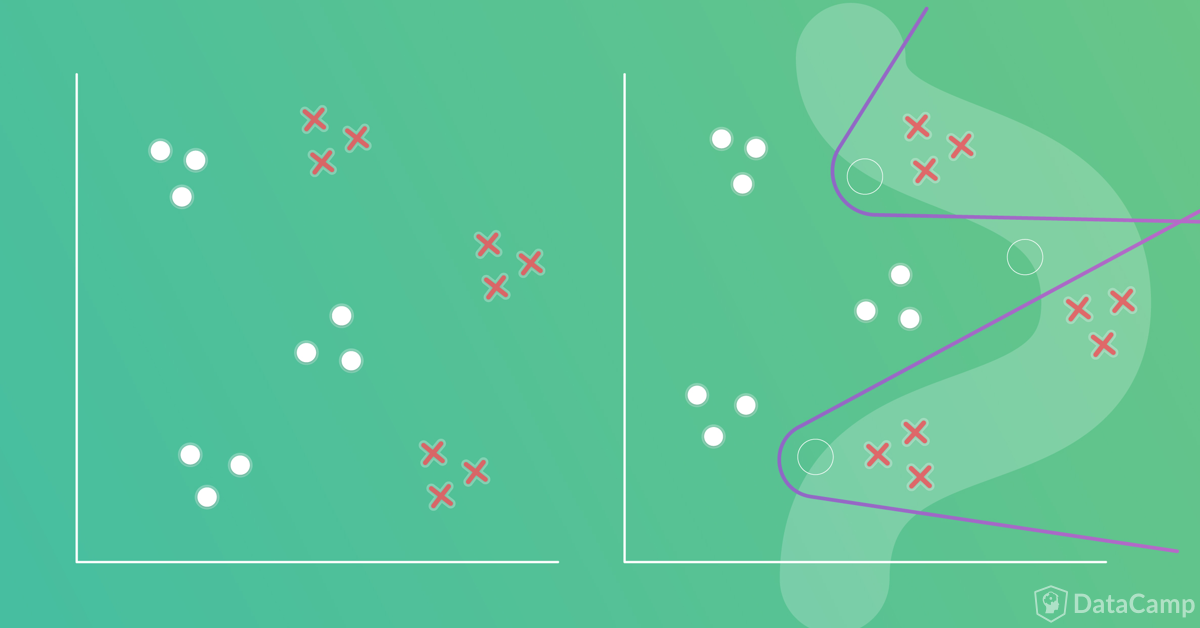
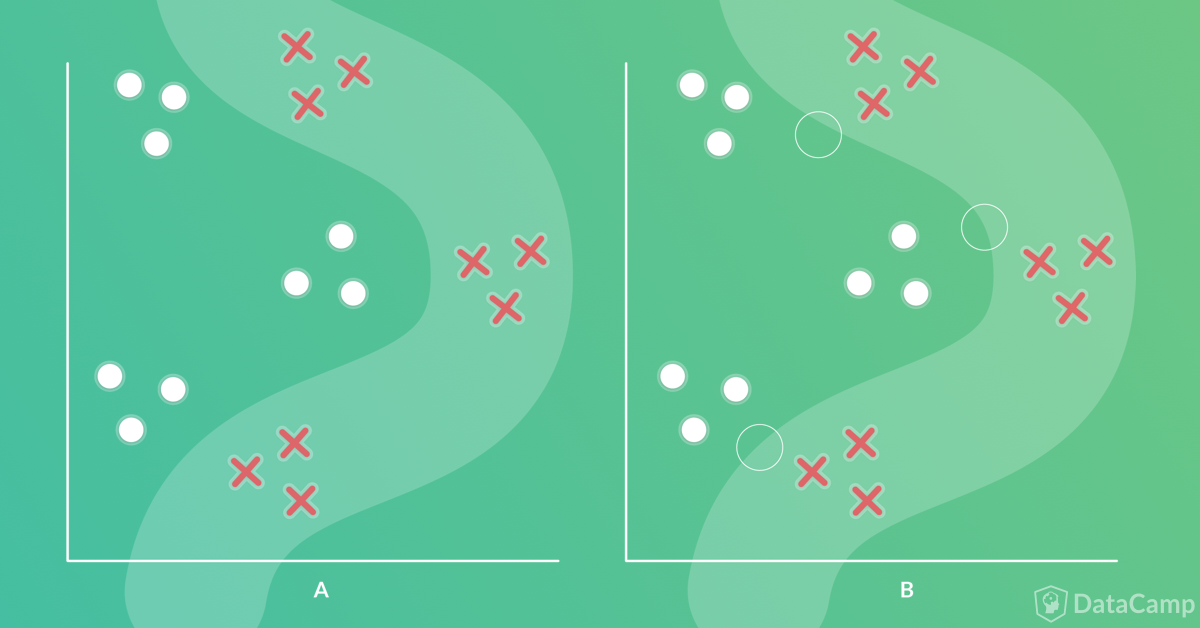
Un autre exemple de classification est présenté ci-dessous. Il ressemble au précédent : deux classes, deux entrées par échantillon et une sortie. La différence tient à la frontière de décision, plus complexe ici.
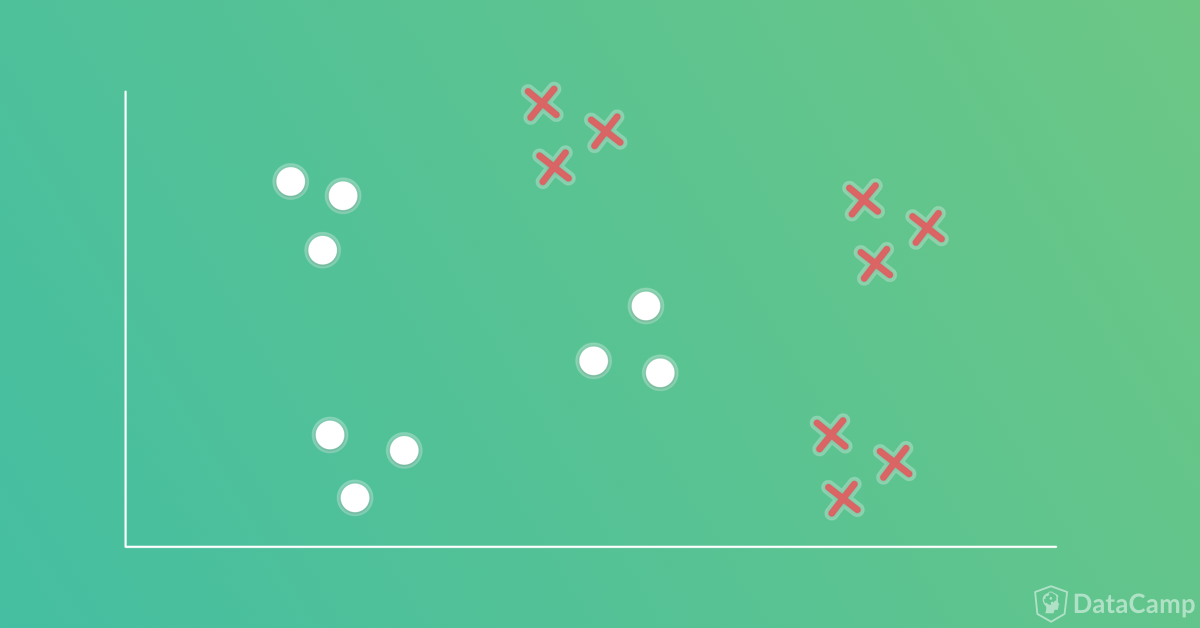
Conformément aux repères, on commence par tracer la frontière de décision. Celle retenue pour la discussion est à l’extrême gauche de la figure suivante (a).
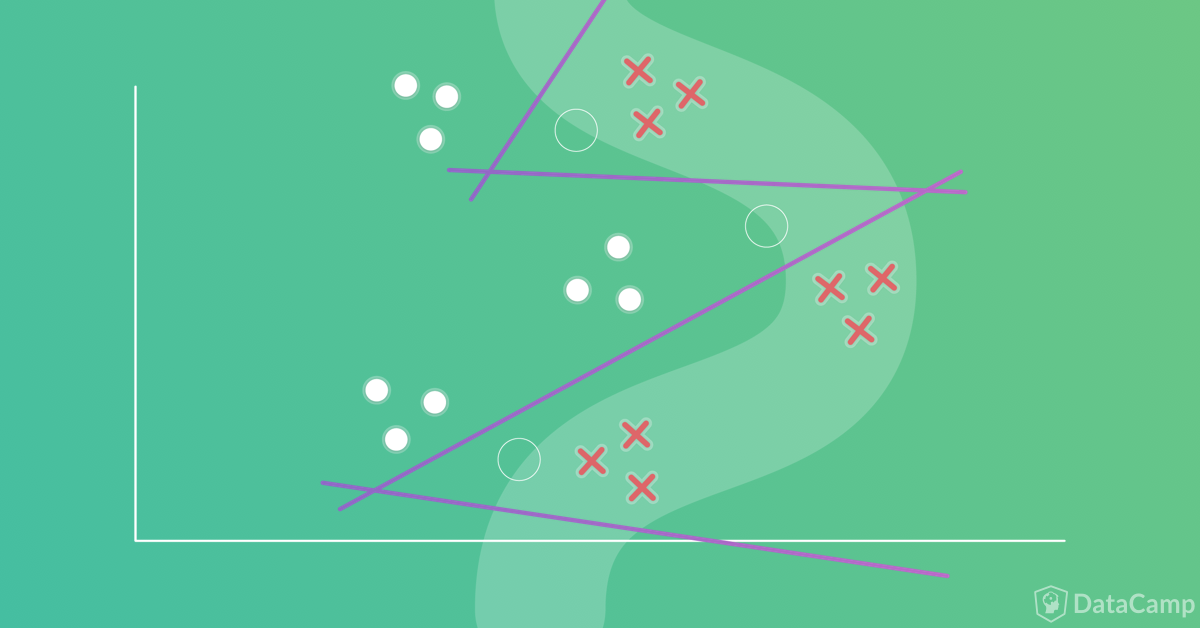
Étape suivante : découper la frontière en un ensemble de droites, chacune modélisée par un perceptron dans le RNA. Avant de tracer, on marque les points de changement de direction, comme à l’extrême droite de la figure (b).
Combien de droites faut-il ? Les points du haut et du bas auront chacun deux segments associés, soit 4 au total. Le point intermédiaire partage ses deux segments avec les autres points. Les droites à créer sont montrées ci-dessous.
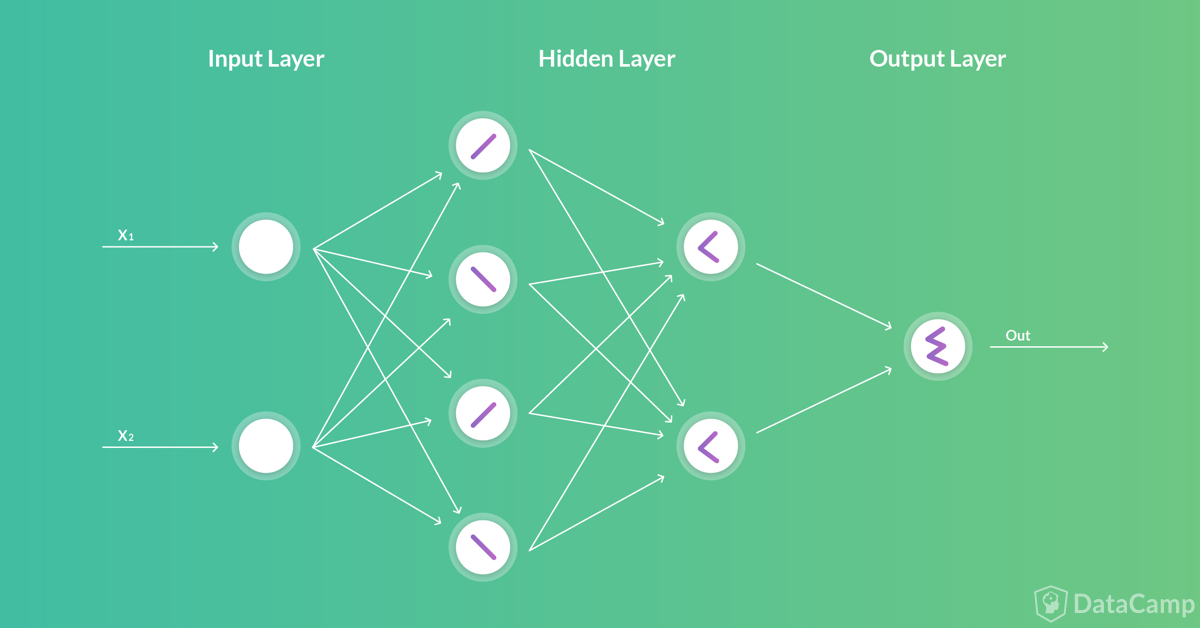
La première couche cachée contiendra donc autant de neurones que de droites : 4 neurones. Autrement dit, 4 classificateurs, chacun construit par un perceptron monocouche. À ce stade, le réseau produit 4 sorties, une par classificateur. Il faut maintenant les relier pour que le réseau ne génère qu’une seule sortie : en d’autres termes, connecter les droites via d’autres couches cachées pour obtenir une seule courbe.
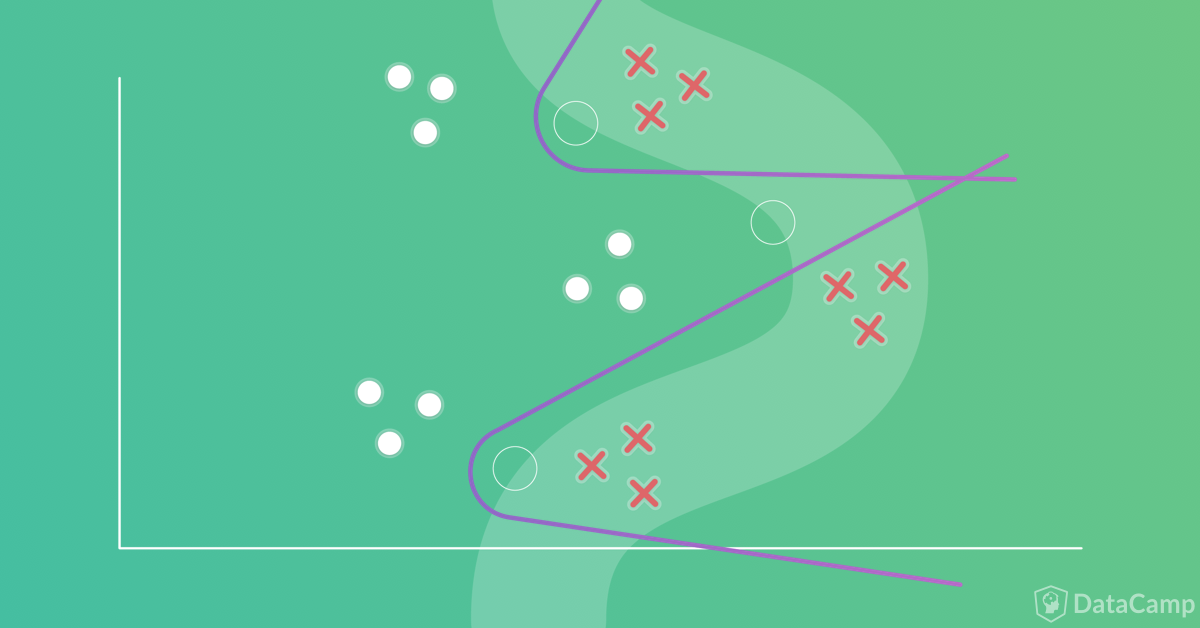
La disposition exacte relève du concepteur du modèle. Une architecture possible consiste à ajouter une deuxième couche cachée avec deux neurones. Le premier reliera les deux premières droites, le second reliera les deux dernières. Voici le résultat après la deuxième couche.
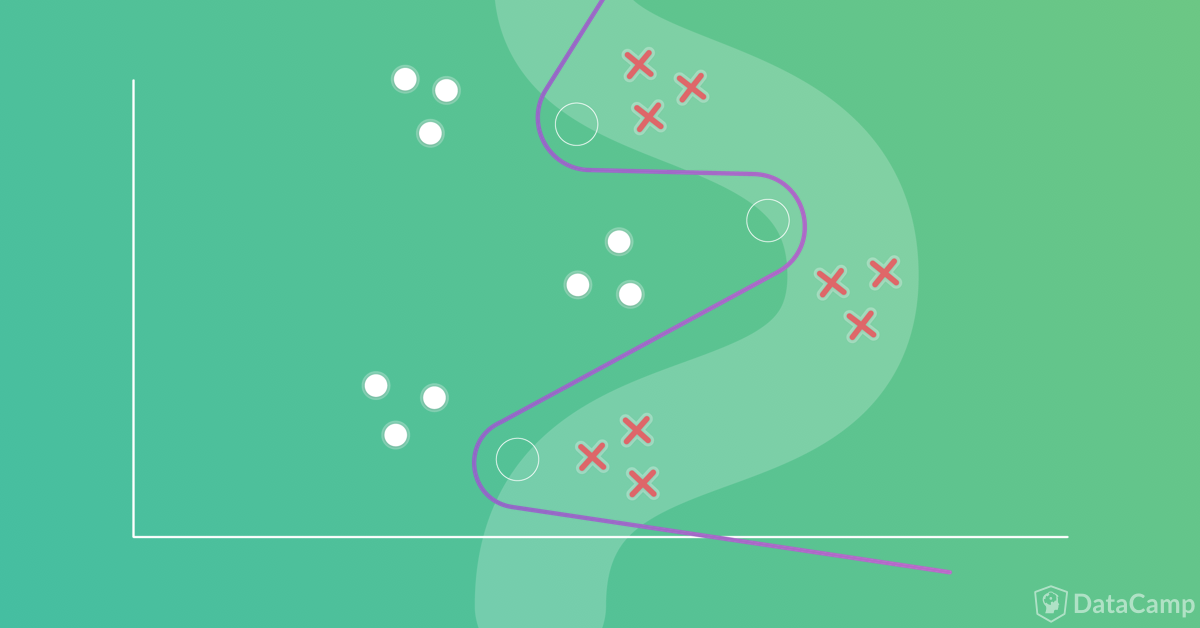
À ce stade, on obtient deux courbes séparées, donc deux sorties. Il reste à relier ces courbes pour n’avoir qu’une seule sortie pour l’ensemble du réseau. Ici encore, le neurone de sortie peut effectuer la connexion finale sans ajouter de nouvelle couche cachée. Le résultat final est montré ci-dessous.
Une fois la conception terminée, l’architecture complète du réseau est la suivante.
En savoir plus sur le deep learning
Cours
Cours
Cours