

Wat zijn Python-generators?
In de kern zijn Python-generators een speciaal soort functie of zelfs een compacte expressie die lui een reeks waarden oplevert. Zie generators als een lopende band in een fabriek: in plaats van alle producten op te stapelen en ruimte tekort te komen, verwerk je elk item zodra het langskomt. Daardoor zijn generators geheugenefficiënt en een natuurlijke uitbreiding van het iterator-protocol van Python, de basis van veel ingebouwde tools zoals for-lussen en comprehensions.
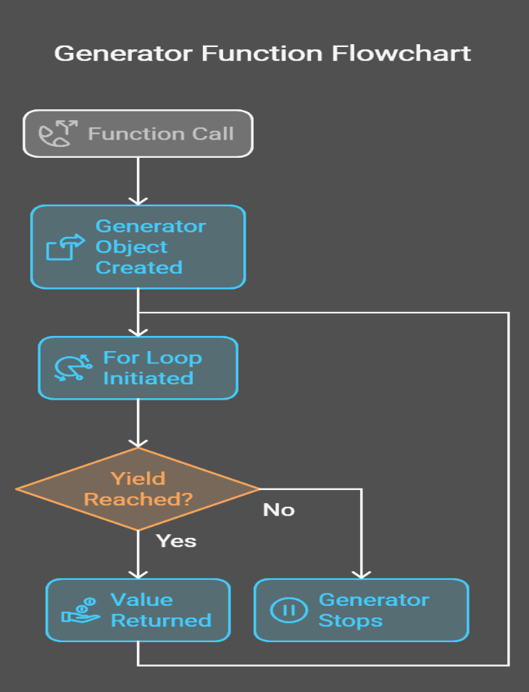
De magie achter generators zit in het sleutelwoord yield. In tegenstelling tot return, dat één waarde teruggeeft en de functie beëindigt, levert yield een waarde op, pauzeert de uitvoering van de functie en slaat zijn toestand op. Wanneer de generator opnieuw wordt aangeroepen, gaat hij verder waar hij gebleven was.
Stel bijvoorbeeld dat je een gigantisch logbestand regel voor regel leest. Een generator kan elke regel verwerken zodra die gelezen is, zonder het hele bestand in het geheugen te laden. Deze "luie evaluatie" onderscheidt generators van traditionele functies en maakt ze een favoriet hulpmiddel voor taken waar performance telt.
Een eenvoudig voorbeeld van een Python-generator
Laten we even oefenen om het idee in de vingers te krijgen. Hier is een generatorfunctie die de eerste n gehele getallen oplevert.
def generate_integers(n):
for i in range(n):
yield i # Pauses here and returns i
# Using the generator
for num in generate_integers(5):
print(num)0
1
2
3
4Ik heb een visual gemaakt om je te laten zien wat er onder de motorkap gebeurt:
Python-generator: syntaxis en patronen
Generators kun je op meerdere manieren implementeren. Er zijn grofweg twee hoofdvormen: generatorfuncties en generatorexpressies.
Generatorfuncties
Een generatorfunctie definieer je zoals een gewone functie, maar je gebruikt het sleutelwoord yield in plaats van return. Bij aanroep geeft ze een generatorobject terug waar je over kunt itereren.
def count_up_to(n):
count = 1
while count <= n:
yield count
count += 1
# Using the generator
counter = count_up_to(5)
for num in counter:
print(num)1
2
3
4
5Zoals je hierboven ziet: wanneer de functie count_up_to wordt aangeroepen, retourneert ze een generatorobject. Telkens wanneer de for-lus om een waarde vraagt, draait de functie tot hij yield raakt, levert de huidige waarde van count op en bewaart zijn toestand tussen iteraties, zodat hij precies verdergaat waar hij gebleven was.
Generatorexpressies
Generatorexpressies zijn een compacte manier om generators te maken. Ze lijken op list comprehensions, maar gebruiken ronde haakjes in plaats van rechte.
# List comprehension (eager evaluation)
squares_list = [x**2 for x in range(5)] # [0, 1, 4, 9, 16]
# Generator expression (lazy evaluation)
squares_gen = (x**2 for x in range(5))
# Using the generator
for square in squares_gen:
print(square)0
1
4
9
16Wat is nu het verschil tussen een list comprehension en een generatorexpressie? De list comprehension maakt de hele lijst in het geheugen aan, terwijl de generatorexpressie waarden één voor één oplevert en zo geheugen bespaart. Als je niet bekend bent met list comprehensions, lees dan onze Python List Comprehension Tutorial.
Python-generator vs. iterator
Traditionele iterators in Python vereisten klassen met expliciete __iter__()- en __next__()-methoden, met veel boilerplate en handmatig toestandsbeheer. Generatorfuncties vereenvoudigen dit door de toestand automatisch te bewaren en de noodzaak voor deze methoden weg te nemen—zoals je ziet in een eenvoudige functie die de kwadraten oplevert tot en met n.
Waarom we Python-generators gebruiken
Bij het uitleggen wat Python-generators zijn, heb ik ook al deels aangegeven waarom je ze gebruikt. In deze sectie ga ik iets dieper. Generators zijn niet zomaar een leuke Python-feature; ze lossen echt problemen op.
Geheugenefficiëntie
In tegenstelling tot lijsten of arrays, die al hun elementen tegelijk in het geheugen opslaan, leveren generators waarden on-the-fly, dus houden ze steeds maar één item in het geheugen.
Neem bijvoorbeeld het verschil tussen range() en xrange() in Python 2:
-
range()maakte een lijst in het geheugen, wat problematisch kon zijn voor grote bereiken. -
xrange()gedroeg zich als een generator en leverde waarden lui op.
Omdat het gedrag van xrange() nuttiger was, werkt range() in Python 3 nu ook als een generator, zodat het geheugenoverhead van het tegelijk opslaan van alle waarden wordt vermeden.
Om het idee te laten zien, vergelijken we het geheugengebruik bij het genereren van een reeks van 10 miljoen getallen:
import sys
# Using a list
numbers_list = [x for x in range(10_000_000)]
print(f"Memory used by list: {sys.getsizeof(numbers_list) / 1_000_000:.2f} MB")
# Using a generator
numbers_gen = (x for x in range(10_000_000))
print(f"Memory used by generator: {sys.getsizeof(numbers_gen)} bytes")Memory used by list: 89.48 MB
Memory used by the generator: 112 bytesZoals je ziet gebruikt de generator vrijwel geen geheugen vergeleken met de lijst, en dat verschil is aanzienlijk.
Performanceverbeteringen
Dankzij luie evaluatie worden waarden alleen berekend wanneer ze nodig zijn. Je kunt dus meteen beginnen met verwerken, zonder te wachten tot de hele reeks is gegenereerd.
Stel bijvoorbeeld dat je de som van de kwadraten van de eerste 1 miljoen getallen berekent:
# Using a list (eager evaluation)
sum_of_squares_list = sum([x**2 for x in range(1_000_000)])
# Using a generator (lazy evaluation)
sum_of_squares_gen = sum(x**2 for x in range(1_000_000))Beide aanpakken geven dezelfde uitkomst, maar de generatorvariant maakt geen enorme lijst aan, waardoor je sneller resultaat krijgt.
Eenvoud en leesbaarheid
Generators vereenvoudigen de implementatie van iterators doordat boilerplate-code verdwijnt. Vergelijk een klassegebaseerde iterator met een generatorfunctie:
Hier is de klassegebaseerde iterator:
class SquaresIterator:
def __init__(self, n):
self.n = n
self.current = 0
def __iter__(self):
return self
def __next__(self):
if self.current >= self.n:
raise StopIteration
result = self.current ** 2
self.current += 1
return result
# Usage
squares = SquaresIterator(5)
for square in squares:
print(square)En hier is de generatorfunctie:
def squares_generator(n):
for i in range(n):
yield i ** 2
# Usage
squares = squares_generator(5)
for square in squares:
print(square)De generatorvariant is korter, makkelijker te lezen en vereist geen boilerplate. Een perfect voorbeeld van Pythons filosofie: simpel is beter.
Oneindige reeksen afhandelen
Tot slot: generators zijn bij uitstek geschikt om oneindige reeksen te representeren—iets wat met lijsten simpelweg onmogelijk is. Neem bijvoorbeeld de Fibonaccireeks:
def fibonacci():
a, b = 0, 1
while True:
yield a
a, b = b, a + b
# Usage
fib = fibonacci()
for _ in range(10):
print(next(fib))0
1
1
2
3
5
8
13
21
34Deze generator kan onbeperkt Fibonaccigetallen opleveren zonder dat het geheugen volloopt. Andere voorbeelden zijn het verwerken van live datastromen of werken met tijdreeksen.
Geavanceerde concepten rond Python-generators
Laten we nu wat lastigere ideeën bekijken. In deze sectie onderzoeken we hoe je generators kunt samenstellen en speciale generator-methoden zoals .send(), .throw() en .close() gebruikt.
Generators aan elkaar koppelen
Generators kun je combineren. Je kunt data modulair transformeren, filteren en verwerken door generators te chainen.
Stel dat je een oneindige getallenreeks hebt en ieder getal wilt kwadrateren en vervolgens de oneven uitkomsten wilt wegfilteren:
def infinite_sequence():
num = 0
while True:
yield num
num += 1
def square_numbers(sequence):
for num in sequence:
yield num ** 2
def filter_evens(sequence):
for num in sequence:
if num % 2 == 0:
yield num
# Compose the generators
numbers = infinite_sequence()
squared = square_numbers(numbers)
evens = filter_evens(squared)
# Print the first 10 even squares
for _ in range(10):
print(next(evens))0
4
16
36
64
100
144
196
256
324Het proces werkt zo: infinite_sequence genereert onbeperkt getallen, square_numbers levert het kwadraat van elk getal op en filter_evens filtert de oneven getallen eruit zodat alleen even kwadraten overblijven. Onze Associate Python Developer-carrièretrack gaat hier dieper op in, zodat je leert hoe je complexe pijplijnen bouwt en debugt met generators, maar ook met iterators en list comprehensions.
Speciale generator-methoden
Generators hebben geavanceerde methoden voor tweerichtingscommunicatie en gecontroleerde beëindiging.
send()
Met .send() kun je waarden terug de generator in sturen, waardoor het een coroutine wordt. Handig voor interactieve of stateful generators.
def accumulator():
total = 0
while True:
value = yield total
if value is not None:
total += value
# Using the generator
acc = accumulator()
next(acc) # Start the generator
print(acc.send(10)) # Output: 10
print(acc.send(5)) # Output: 15
print(acc.send(20)) # Output: 35Zo werkt het:
-
De generator wordt gestart met
next(acc). -
Elke aanroep van
.send(value)stuurt een waarde de generator in, die wordt toegewezen aanvaluein deyield-expressie. -
De generator werkt zijn toestand (
total) bij en levert het nieuwe resultaat op.
throw()
Met .throw() kun je binnen in de generator een uitzondering opwerpen, handig voor foutafhandeling of het signaleren van specifieke condities.
def resilient_generator():
try:
for i in range(5):
yield i
except ValueError:
yield "Error occurred!"
# Using the generator
gen = resilient_generator()
print(next(gen)) # Output: 0
print(next(gen)) # Output: 1
print(gen.throw(ValueError)) # Output: "Error occurred!"Zo werkt deze:
-
De generator draait normaal door tot
.throw()wordt aangeroepen. -
De uitzondering wordt binnen de generator opgeworpen en kan met een
try-except-blok worden afgehandeld.
close()
Met .close() stop je een generator door een GeneratorExit-exceptie op te werpen. Handig om resources op te ruimen of oneindige generators te stoppen.
def infinite_counter():
count = 0
try:
while True:
yield count
count += 1
except GeneratorExit:
print("Generator closed!")
# Using the generator
counter = infinite_counter()
print(next(counter)) # Output: 0
print(next(counter)) # Output: 1
counter.close() # Output: "Generator closed!"En zo werkt dit:
-
De generator draait tot
.close()wordt aangeroepen. -
De
GeneratorExit-exceptie wordt opgegooid, zodat de generator kan opruimen of een bericht loggen vóór beëindiging.
Toepassingen in de praktijk voor data science
Hopelijk zie je inmiddels hoe nuttig generators zijn. In deze sectie wil ik de use-cases laten opvallen zodat je je kunt voorstellen hoe je ze dagelijks inzet.
Grote datasets verwerken
Een van de meest voorkomende uitdagingen in data science is werken met datasets die te groot zijn om in het geheugen te passen. Generators bieden een manier om zulke data regel voor regel te verwerken.
Stel, je hebt een CSV-bestand van 10 GB met verkoopdata en je moet records voor een specifieke regio filteren. Zo kun je een generatorpijplijn gebruiken om dit te doen:
import csv
def read_large_csv(file_path):
""" Generator to read a large CSV file line by line."""
with open(file_path, mode="r") as file:
reader = csv.DictReader(file)
for row in reader:
yield row
def filter_by_region(data, region):
""" Generator to filter rows by a specific region."""
for row in data:
if row["Region"] == region:
yield row
# Generator pipeline
file_path = "sales_data.csv"
region = "North America"
data = read_large_csv(file_path)
filtered_data = filter_by_region(data, region)
# Process the filtered data
for record in filtered_data:
print(record)Dit gebeurt er:
-
read_large_csvleest het bestand regel voor regel en levert elke rij op als dictionary. -
filter_by_regionfiltert rijen op basis van de opgegeven regio. -
De pijplijn verwerkt data incrementeel en voorkomt geheugenoverbelasting.
Deze aanpak is handig voor extract-, transform- en load-workflows, waar data moet worden opgeschoond en getransformeerd vóór analyse. Je ziet dit terug in onze ETL and ELT in Python-cursus.
Streaming en pijplijnen
Data komt soms als een continue stream binnen. Denk aan sensordata, live feeds of sociale media.
Stel, je werkt met IoT-apparaten die elke seconde temperatuurmetingen genereren. Je wilt het gemiddelde over een schuivend venster van 10 metingen berekenen:
def sensor_data_stream():
"""Simulate an infinite stream of sensor data."""
import random
while True:
yield random.uniform(0, 100) # Simulate sensor data
def sliding_window_average(stream, window_size):
""" Calculate the average over a sliding window of readings."""
window = []
for value in stream:
window.append(value)
if len(window) > window_size:
window.pop(0)
if len(window) == window_size:
yield sum(window) / window_size
# Generator pipeline
sensor_stream = sensor_data_stream()
averages = sliding_window_average(sensor_stream, window_size=10)
# Print the average every second
for avg in averages:
print(f"Average temperature: {avg:.2f}")De uitleg:
-
sensor_data_streamsimuleert een oneindige stroom sensorwaarden. -
sliding_window_averagehoudt een schuivend venster van de laatste 10 metingen bij en levert hun gemiddelde op. -
De pijplijn verwerkt data realtime, ideaal voor monitoring en analytics.
Aanvullende use-cases
Generators gebruik je ook wanneer de datasize onvoorspelbaar is of wanneer de data blijft binnenkomen/oneindig is.
Webscraping
Bij het scrapen van websites weet je vaak niet hoeveel pagina's of items je moet verwerken. Generators helpen je die onvoorspelbaarheid elegant af te handelen:
def scrape_website(url):
""" Generator to scrape a website page by page."""
while url:
# Simulate fetching and parsing a page
print(f"Scraping {url}")
data = f"Data from {url}"
yield data
url = get_next_page(url) # Hypothetical function to get the next page
# Usage
scraper = scrape_website("https://example.com/page1")
for data in scraper:
print(data)Simulatietaken
Bij simulaties, zoals Monte Carlo-methoden of game development, kunnen generators oneindige of dynamische reeksen representeren:
def monte_carlo_simulation():
""" Generator to simulate random events for Monte Carlo analysis."""
import random
while True:
yield random.random()
# Usage
simulation = monte_carlo_simulation()
for _ in range(10):
print(next(simulation))Geheugen- en snelheidsbenchmarks
Door hun werking blinken generators uit wanneer geheugenefficiëntie cruciaal is, maar (misschien verrassend) zijn ze niet altijd het snelst. Laten we generators met lijsten vergelijken om de trade-offs te begrijpen.
Eerder lieten we zien dat generators beter scoren qua geheugen. Dat was waar we het geheugengebruik vergeleken bij een reeks van 10 miljoen getallen. Laten we nu iets anders doen: een snelheidsvergelijking:
import time
# List comprehension
start_time = time.time()
sum([x**2 for x in range(1_000_000)])
print(f"List comprehension time: {time.time() - start_time:.4f} seconds")
# Generator expression
start_time = time.time()
sum(x**2 for x in range(1_000_000))
print(f"Generator expression time: {time.time() - start_time:.4f} seconds")List comprehension time: 0.1234 seconds
Generator expression time: 0.1456 secondsHoewel een generator geheugen bespaart, is die hier juist trager dan de lijst. Dat komt doordat er voor kleine datasets overhead is door het pauzeren en hervatten van de uitvoering.
Het prestatiedifferent is verwaarloosbaar bij kleine datasets, maar bij grote datasets weegt de geheugensbesparing van generators vaak zwaarder dan het kleine snelheidsverlies.
Veelvoorkomende valkuilen
Tot slot bekijken we enkele veelvoorkomende fouten of issues:
Generators zijn uitputbaar
Als een generator is uitgeput, kun je hem niet opnieuw gebruiken. Je moet hem opnieuw aanmaken als je nog eens wilt itereren.
gen = (x for x in range(5))
print(list(gen)) # Output: [0, 1, 2, 3, 4]
print(list(gen)) # Output: [] (the generator is exhausted)Luie evaluatie kan lastig zijn
Omdat generators waarden op aanvraag opleveren, kunnen fouten of bijwerkingen pas zichtbaar worden wanneer je erover iterereert.
Je kunt generators overgebruiken
Voor kleine datasets of eenvoudige taken is de overhead van een generator het geheugenvoordeel niet waard. Overweeg dit voorbeeld waarin ik data materialiseer voor meerdere iteraties.
# Generator expression
gen = (x**2 for x in range(10))
# Materialize into a list
squares = list(gen)
# Reuse the list
print(sum(squares)) # Output: 285
print(max(squares)) # Output: 81Kiezen wanneer je generators gebruikt
Tot besluit geef ik een paar algemene regels voor wanneer je generators gebruikt. Gebruik ze voor:
- Grote datasets: Gebruik generators bij datasets die te groot zijn om in het geheugen te passen.
- Oneindige reeksen: Gebruik generators om oneindige reeksen te representeren, zoals live datastromen of simulaties.
- Pijplijnen: Gebruik generators om modulaire datapijplijnen te bouwen die data incrementeel transformeren en filteren.
Wanneer je data juist moet materialiseren (naar een lijst converteren)
- Kleine datasets: Gebruik geen generators als geheugen geen issue is en je snelle toegang tot alle elementen nodig hebt; gebruik dan een lijst.
- Meerdere iteraties: Gebruik geen generators als je meerdere keren over dezelfde data moet itereren; materialiseer die dan in een lijst om te voorkomen dat je de generator telkens moet hercreëren.
Conclusie en belangrijkste inzichten
In dit artikel hebben we gezien hoe generators helpen bij realistische uitdagingen in data science, van het verwerken van grote datasets tot het bouwen van realtime-pijplijnen. Blijf oefenen. De beste manier om generators te beheersen is door ze in je eigen werk toe te passen. Vervang bijvoorbeeld eens een list comprehension door een generatorexpressie of refactor een lus naar een generatorfunctie.
Heb je de basis in de vingers, verken dan nieuwe en meer geavanceerde onderwerpen die voortbouwen op het generatorkoncept:
-
Coroutines: Gebruik
.send()en.throw()om generators te maken die data kunnen ontvangen en verwerken, voor tweerichtingscommunicatie. -
Asynchrone programmering: Combineer generators met Pythons asyncio-bibliotheek om efficiënte, niet-blokkerende applicaties te bouwen.
-
Concurrency: Leer hoe generators coöperatieve multitasking en lichte concurrency kunnen implementeren.
Blijf leren en word expert. Volg onze Python Developer-carrièretrack of onze Python Programming-skilltrack vandaag nog. Klik op de link hieronder om te beginnen.

Techschrijver gespecialiseerd in AI, ML en data science, die complexe ideeën helder en toegankelijk maakt.
Veelgestelde vragen over Python-generators
Wat is precies een Python-generator?
Een Python-generator is een speciaal soort functie die met het yield-sleutelwoord een iterator teruggeeft en waarden één voor één oplevert, waarbij geheugen wordt bespaard omdat de volledige reeks niet in één keer wordt opgeslagen.
Wanneer moet ik generators gebruiken in plaats van list comprehensions?
Generators zijn ideaal voor het verwerken van grote of oneindige reeksen wanneer geheugenefficiëntie belangrijk is, terwijl list comprehensions goed werken als je een volledige lijst nodig hebt voor herhaaldelijke toegang of willekeurige indexing.
Hoe verbeteren generators de performance?
Door één waarde per keer op te leveren (luie evaluatie) berekenen generators waarden on-the-fly, wat het geheugengebruik verlaagt en het verwerken versnelt vergeleken met het opbouwen van volledige datastructuren in het geheugen.
Kan ik meer dan eens over een generator itereren?
Nee, generators zijn uitgeput na een volledige iteratie. Als je opnieuw wilt itereren, moet je een nieuwe generatorinstantie maken.
Wat zijn praktische use-cases voor generators?
Generators zijn nuttig voor het verwerken van grote datasets, het streamen van realtime data, het bouwen van efficiënte pijplijnen en het afhandelen van oneindige reeksen, zoals bij algoritmische en simulatietaken.


Stel, je werkt aan een data science-project en je moet een dataset verwerken die zó groot is dat je computer crasht als je hem in het geheugen laadt. Of je hebt te maken met een oneindige reeks, zoals een live datastroom, die je niet in één keer kunt opslaan. Dit zijn precies de uitdagingen waarbij data scientists naar de koffiepauze grijpen—en soms naar de resetknop.
In dit artikel leer je wat Python-generators zijn en hoe je ze kunt gebruiken om je code te vereenvoudigen. Dit concept vergt wat oefening. Ben je nieuw met Python en raak je onderweg even de draad kwijt, volg dan onze Introduction to Python cursus om een sterke basis op te bouwen.