

Python जनरेटर क्या हैं?
मूल रूप से, Python जनरेटर फ़ंक्शन या कॉम्पैक्ट एक्सप्रेशन का एक विशेष प्रकार हैं जो क्रम से मानों को आलसी तरीके से उत्पन्न करते हैं। जनरेटर को एक फैक्ट्री की कन्वेयर बेल्ट की तरह सोचें: सभी प्रोडक्ट्स को एक जगह ढेर करके जगह खत्म करने के बजाय, आप हर आइटम को लाइन पर आते ही प्रोसेस करते हैं। इससे जनरेटर मेमोरी-कुशल बनते हैं और Python के iterator प्रोटोकॉल का स्वाभाविक विस्तार हैं, जो for लूप्स और कॉम्प्रिहेंशंस जैसे Python के कई बिल्ट-इन टूल्स की नींव है।
जनरेटर का जादू yield कीवर्ड में छिपा है। return के विपरीत, जो एक मान आउटपुट करके फ़ंक्शन से बाहर निकल जाता है, yield एक मान देता है, फ़ंक्शन के निष्पादन को रोक देता है और उसकी स्थिति सहेज लेता है। जब जनरेटर को दोबारा बुलाया जाता है, तो यह वहीं से आगे बढ़ता है जहाँ छोड़ा था।
उदाहरण के लिए, मान लीजिए आप एक बहुत बड़ी लॉग फ़ाइल को लाइन-दर-लाइन पढ़ रहे हैं। जनरेटर हर लाइन को पढ़ते ही प्रोसेस कर सकता है, बिना पूरी फ़ाइल को मेमोरी में लोड किए। यह "लेज़ी इवैल्यूएशन" जनरेटर को पारंपरिक फ़ंक्शंस से अलग करता है और उन्हें प्रदर्शन-संवेदी कार्यों के लिए पसंदीदा बनाता है।
एक बेसिक Python जनरेटर उदाहरण
चलो थोड़ा अभ्यास करें ताकि विचार समझ में आए। यहाँ एक जनरेटर फ़ंक्शन है जो पहले n पूर्णांक उत्पन्न करता है।
def generate_integers(n):
for i in range(n):
yield i # Pauses here and returns i
# Using the generator
for num in generate_integers(5):
print(num)0
1
2
3
4मैंने एक विज़ुअल बनाया है ताकि आप देख सकें कि अंदर क्या हो रहा है:
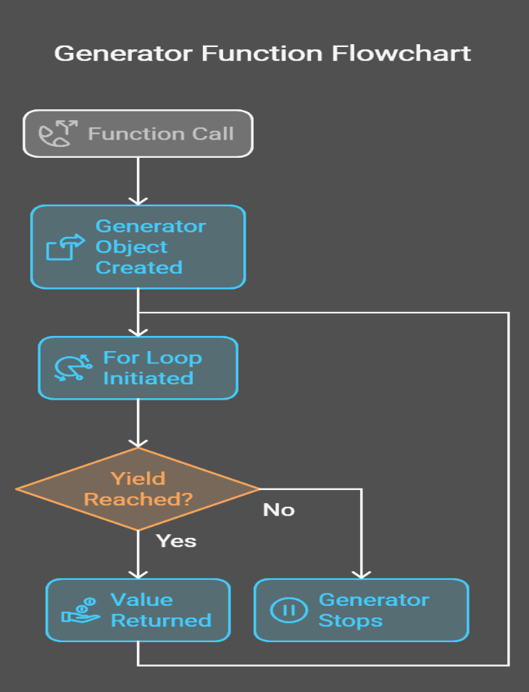
Python जनरेटर का सिंटैक्स और पैटर्न
जनरेटर को कई तरीकों से लागू किया जा सकता है। हालाँकि, दो प्रमुख तरीके हैं: जनरेटर फ़ंक्शंस और जनरेटर एक्सप्रेशंस।
जनरेटर फ़ंक्शंस
जनरेटर फ़ंक्शन एक सामान्य फ़ंक्शन की तरह परिभाषित होता है, लेकिन return की जगह yield का उपयोग करता है। कॉल करने पर यह एक जनरेटर ऑब्जेक्ट लौटाता है जिसे इटरेट किया जा सकता है।
def count_up_to(n):
count = 1
while count <= n:
yield count
count += 1
# Using the generator
counter = count_up_to(5)
for num in counter:
print(num)1
2
3
4
5ऊपर के उदाहरण से हम देखते हैं कि जब count_up_to फ़ंक्शन को कॉल किया जाता है, तो यह एक जनरेटर ऑब्जेक्ट लौटाता है। हर बार जब for लूप एक मान मांगता है, फ़ंक्शन yield तक चलता है, उस समय count का वर्तमान मान देता है और अपनी स्थिति बनाए रखता है ताकि अगली बार वहीं से फिर शुरू हो सके।
जनरेटर एक्सप्रेशंस
जनरेटर एक्सप्रेशंस जनरेटर बनाने का एक कॉम्पैक्ट तरीका हैं। ये लिस्ट कॉम्प्रिहेंशन के समान हैं, लेकिन स्क्वेयर ब्रैकेट्स की जगह पैरेंथेसिस का इस्तेमाल करते हैं।
# List comprehension (eager evaluation)
squares_list = [x**2 for x in range(5)] # [0, 1, 4, 9, 16]
# Generator expression (lazy evaluation)
squares_gen = (x**2 for x in range(5))
# Using the generator
for square in squares_gen:
print(square)0
1
4
9
16तो, लिस्ट कॉम्प्रिहेंशन और जनरेटर एक्सप्रेशन में अंतर क्या है? लिस्ट कॉम्प्रिहेंशन पूरी लिस्ट मेमोरी में बनाती है, जबकि जनरेटर एक्सप्रेशन मानों को एक बार में एक उत्पन्न करता है और मेमोरी बचाता है। यदि आप लिस्ट कॉम्प्रिहेंशन से परिचित नहीं हैं, तो आप हमारे Python List Comprehension Tutorial में इनके बारे में पढ़ सकते हैं।
Python जनरेटर बनाम इटरेटर
Python में पारंपरिक इटरेटर्स के लिए __iter__() और __next__() मेथड्स वाली क्लासेस चाहिए होती थीं, जिसमें बहुत सारा बोयलरप्लेट और मैनुअल स्टेट मैनेजमेंट शामिल था, जबकि जनरेटर फ़ंक्शंस स्टेट को स्वतः संरक्षित करके और इन मेथड्स की ज़रूरत को खत्म करके प्रक्रिया को सरल करते हैं—जैसा कि एक सरल फ़ंक्शन से दिखता है जो n तक प्रत्येक संख्या का वर्ग देता है।
हम Python जनरेटर का उपयोग क्यों करते हैं
Python जनरेटर क्या हैं, यह समझाते हुए मैंने यह भी बताया कि उनका उपयोग क्यों होता है। इस खंड में, मैं थोड़ा और विस्तार में जाऊँगा। क्योंकि जनरेटर सिर्फ एक चमकदार Python फीचर नहीं हैं—ये वाकई वास्तविक समस्याएँ हल करते हैं।
मेमोरी दक्षता
लिस्ट या एरेज़ के विपरीत, जो एक साथ अपने सभी तत्वों को मेमोरी में स्टोर करते हैं, जनरेटर चलते-फिरते मान देते हैं, इसलिए वे एक समय में मेमोरी में केवल एक आइटम रखते हैं।
उदाहरण के लिए, Python 2 के range() और xrange() के बीच के अंतर पर विचार करें:
-
range()मेमोरी में एक लिस्ट बनाता था, जो बड़े रेंज के लिए समस्या पैदा कर सकता था। -
xrange()जनरेटर की तरह व्यवहार करता था और मानों को लेज़ी तरीके से उत्पन्न करता था।
क्योंकि xrange() का व्यवहार अधिक उपयोगी था, अब Python 3 में range() भी जनरेटर जैसा व्यवहार करता है, जिससे सभी मानों को एक साथ स्टोर करने का मेमोरी ओवरहेड बचता है।
विचार दिखाने के लिए, आइए 1 करोड़ संख्याओं का अनुक्रम बनाते समय मेमोरी उपयोग की तुलना करें:
import sys
# Using a list
numbers_list = [x for x in range(10_000_000)]
print(f"Memory used by list: {sys.getsizeof(numbers_list) / 1_000_000:.2f} MB")
# Using a generator
numbers_gen = (x for x in range(10_000_000))
print(f"Memory used by generator: {sys.getsizeof(numbers_gen)} bytes")Memory used by list: 89.48 MB
Memory used by the generator: 112 bytesजैसा कि आप देख सकते हैं, लिस्ट की तुलना में जनरेटर लगभग कोई मेमोरी इस्तेमाल नहीं करता, और यह अंतर महत्वपूर्ण है।
प्रदर्शन में सुधार
लेज़ी इवैल्यूएशन के कारण, मान केवल तभी कम्प्यूट होते हैं जब उनकी ज़रूरत होती है। इसका मतलब है कि आप पूरी सीरीज़ बनने का इंतज़ार किए बिना तुरंत डेटा प्रोसेस करना शुरू कर सकते हैं।
उदाहरण के लिए, पहले 10 लाख संख्याओं के वर्गों का योग करने की कल्पना करें:
# Using a list (eager evaluation)
sum_of_squares_list = sum([x**2 for x in range(1_000_000)])
# Using a generator (lazy evaluation)
sum_of_squares_gen = sum(x**2 for x in range(1_000_000))दोनों तरीके एक ही परिणाम देते हैं, लेकिन जनरेटर वाला संस्करण एक विशाल लिस्ट बनाने से बचता है, इसलिए हमें परिणाम तेज़ी से मिल जाता है।
सरलता और पठनीयता
जनरेटर बोयलरप्लेट कोड हटाकर इटरेटर के इम्प्लीमेंटेशन को सरल बनाते हैं। एक क्लास-आधारित इटरेटर की तुलना एक जनरेटर फ़ंक्शन से करें:
यह रहा क्लास-आधारित इटरेटर:
class SquaresIterator:
def __init__(self, n):
self.n = n
self.current = 0
def __iter__(self):
return self
def __next__(self):
if self.current >= self.n:
raise StopIteration
result = self.current ** 2
self.current += 1
return result
# Usage
squares = SquaresIterator(5)
for square in squares:
print(square)यह रहा जनरेटर फ़ंक्शन:
def squares_generator(n):
for i in range(n):
yield i ** 2
# Usage
squares = squares_generator(5)
for square in squares:
print(square)जनरेटर संस्करण छोटा, पढ़ने में आसान और बिना बोयलरप्लेट के है। यह Python के दर्शन का उत्तम उदाहरण है: सरलता बेहतर है।
अनंत अनुक्रमों को संभालना
अंत में, मैं कहना चाहूँगा कि जनरेटर अनंत अनुक्रमों को दर्शाने के लिए अद्वितीय रूप से उपयुक्त हैं, जो लिस्ट के साथ असंभव है। उदाहरण के लिए, Fibonacci अनुक्रम पर विचार करें:
def fibonacci():
a, b = 0, 1
while True:
yield a
a, b = b, a + b
# Usage
fib = fibonacci()
for _ in range(10):
print(next(fib))0
1
1
2
3
5
8
13
21
34यह जनरेटर मेमोरी खत्म हुए बिना अनिश्चितकाल तक Fibonacci संख्याएँ उत्पन्न कर सकता है। अन्य उदाहरणों में लाइव डेटा स्ट्रीम प्रोसेस करना या टाइम सीरीज़ डेटा के साथ काम करना शामिल है।
उन्नत Python जनरेटर अवधारणाएँ
अब, कुछ और कठिन विचारों पर नज़र डालते हैं। इस खंड में, हम देखेंगे कि जनरेटर को कैसे संयोजित किया जाए और .send(), .throw(), और .close() जैसे विशेष जनरेटर मेथड्स का उपयोग कैसे किया जाए।
जनरेटर को साथ जोड़ना
जनरेटर को जोड़ा जा सकता है। आप जनरेटर को चेन करके डेटा को मॉड्यूलर तरीके से ट्रांसफॉर्म, फ़िल्टर और प्रोसेस कर सकते हैं।
मान लीजिए आपके पास संख्याओं का एक अनंत अनुक्रम है और आप प्रत्येक संख्या का वर्ग करना चाहते हैं और विषम परिणामों को फ़िल्टर करना चाहते हैं:
def infinite_sequence():
num = 0
while True:
yield num
num += 1
def square_numbers(sequence):
for num in sequence:
yield num ** 2
def filter_evens(sequence):
for num in sequence:
if num % 2 == 0:
yield num
# Compose the generators
numbers = infinite_sequence()
squared = square_numbers(numbers)
evens = filter_evens(squared)
# Print the first 10 even squares
for _ in range(10):
print(next(evens))0
4
16
36
64
100
144
196
256
324इस प्रक्रिया में infinite_sequence फ़ंक्शन अनिश्चितकाल तक संख्याएँ उत्पन्न करता है, square_numbers प्रत्येक संख्या का वर्ग देता है, और फिर filter_evens विषम संख्याओं को फ़िल्टर करके केवल सम वर्ग देता है। हमारा Associate Python Developer करियर ट्रैक इस तरह की चीज़ों पर विस्तार से जाता है, जिससे आप जनरेटर के साथ-साथ इटरेटर और लिस्ट कॉम्प्रिहेंशन का उपयोग करके जटिल पाइपलाइंस बनाना और डीबग करना देख सकें।
विशेष जनरेटर मेथड्स
जनरेटर उन्नत मेथड्स के साथ आते हैं जो दो-तरफा संचार और नियंत्रित टर्मिनेशन की अनुमति देते हैं।
send()
.send() मेथड आपको जनरेटर में मान वापस भेजने देता है, जिससे यह एक कोरूटीन बन जाता है। यह इंटरएक्टिव या स्टेटफुल जनरेटर बनाने के लिए उपयोगी है।
def accumulator():
total = 0
while True:
value = yield total
if value is not None:
total += value
# Using the generator
acc = accumulator()
next(acc) # Start the generator
print(acc.send(10)) # Output: 10
print(acc.send(5)) # Output: 15
print(acc.send(20)) # Output: 35यह ऐसे काम करता है:
-
जनरेटर को इनिशियलाइज़ करने के लिए
next(acc)से शुरू किया जाता है। -
हर
.send(value)कॉल एक मान जनरेटर में भेजती है, जोyieldस्टेटमेंट मेंvalueको असाइन हो जाता है। -
जनरेटर अपनी स्थिति (
total) अपडेट करता है और नया परिणाम देता है।
throw()
.throw() मेथड आपको जनरेटर के अंदर एक अपवाद उठाने देता है, जो एरर हैंडलिंग या विशेष परिस्थितियों का संकेत देने के लिए सहायक हो सकता है।
def resilient_generator():
try:
for i in range(5):
yield i
except ValueError:
yield "Error occurred!"
# Using the generator
gen = resilient_generator()
print(next(gen)) # Output: 0
print(next(gen)) # Output: 1
print(gen.throw(ValueError)) # Output: "Error occurred!"यह इस तरह काम करता है:
-
जनरेटर सामान्य रूप से चलता है, जब तक कि
.throw()नहीं बुलाया जाता। -
अपवाद जनरेटर के अंदर उठाया जाता है, जिसे
try-exceptब्लॉक से संभाला जा सकता है।
close()
.close() मेथड GeneratorExit अपवाद उठाकर जनरेटर को रोक देता है। यह संसाधनों को साफ़ करने या अनंत जनरेटर को रोकने के लिए उपयोगी है।
def infinite_counter():
count = 0
try:
while True:
yield count
count += 1
except GeneratorExit:
print("Generator closed!")
# Using the generator
counter = infinite_counter()
print(next(counter)) # Output: 0
print(next(counter)) # Output: 1
counter.close() # Output: "Generator closed!"और यह इस तरह काम कर रहा है:
-
जनरेटर तब तक चलता है जब तक
.close()नहीं बुलाया जाता। -
GeneratorExitअपवाद उठाया जाता है, जिससे जनरेटर समाप्त होने से पहले साफ़-सफ़ाई या लॉगिंग कर सके।
डेटा साइंस में वास्तविक दुनिया के उपयोग
आशा है कि अब तक आप समझ रहे होंगे कि जनरेटर उपयोगी हैं। इस खंड में, मैं उपयोग मामलों को उभारने की कोशिश करूँगा ताकि आप कल्पना कर सकें कि ये आपके रोज़मर्रा के काम में कैसे काम आते हैं।
बड़े डेटासेट प्रोसेस करना
डेटा साइंस में सबसे आम चुनौतियों में से एक है ऐसे डेटासेट के साथ काम करना जो मेमोरी में फिट नहीं होते। जनरेटर ऐसी डेटा को लाइन-दर-लाइन प्रोसेस करने का तरीका देते हैं।
मान लीजिए आपके पास 10 GB का एक CSV फ़ाइल है जिसमें बिक्री डेटा है और आपको किसी विशेष क्षेत्र के लिए रिकॉर्ड्स फ़िल्टर करने हैं। आप जनरेटर पाइपलाइन का उपयोग इस प्रकार कर सकते हैं:
import csv
def read_large_csv(file_path):
""" Generator to read a large CSV file line by line."""
with open(file_path, mode="r") as file:
reader = csv.DictReader(file)
for row in reader:
yield row
def filter_by_region(data, region):
""" Generator to filter rows by a specific region."""
for row in data:
if row["Region"] == region:
yield row
# Generator pipeline
file_path = "sales_data.csv"
region = "North America"
data = read_large_csv(file_path)
filtered_data = filter_by_region(data, region)
# Process the filtered data
for record in filtered_data:
print(record)यहाँ क्या हो रहा है:
-
read_large_csvफ़ाइल को लाइन-दर-लाइन पढ़ता है और हर पंक्ति को डिक्शनरी के रूप में देता है। -
filter_by_regionनिर्दिष्ट क्षेत्र के आधार पर पंक्तियों को फ़िल्टर करता है। -
पाइपलाइन डेटा को क्रमिक रूप से प्रोसेस करती है, मेमोरी ओवरलोड से बचते हुए।
यह दृष्टिकोण एक्सट्रैक्ट, ट्रांसफॉर्म और लोड वर्कफ़्लोज़ के लिए फायदेमंद है, जहाँ विश्लेषण से पहले डेटा को साफ़ और ट्रांसफ़ॉर्म करना होता है। आप इसे हमारे ETL and ELT in Python कोर्स में देखेंगे।
स्ट्रीमिंग और पाइपलाइंस
कभी-कभी डेटा एक सतत स्ट्रीम के रूप में आता है। जैसे सेंसर डेटा, लाइव फीड्स, या सोशल मीडिया।
मान लीजिए आप IoT डिवाइसेज़ के साथ काम कर रहे हैं जो हर सेकंड तापमान रीडिंग बनाती हैं। आप 10 रीडिंग्स की स्लाइडिंग विंडो पर औसत तापमान निकालना चाहते हैं:
def sensor_data_stream():
"""Simulate an infinite stream of sensor data."""
import random
while True:
yield random.uniform(0, 100) # Simulate sensor data
def sliding_window_average(stream, window_size):
""" Calculate the average over a sliding window of readings."""
window = []
for value in stream:
window.append(value)
if len(window) > window_size:
window.pop(0)
if len(window) == window_size:
yield sum(window) / window_size
# Generator pipeline
sensor_stream = sensor_data_stream()
averages = sliding_window_average(sensor_stream, window_size=10)
# Print the average every second
for avg in averages:
print(f"Average temperature: {avg:.2f}")यहाँ व्याख्या है:
-
sensor_data_streamसेंसर रीडिंग्स की एक अनंत स्ट्रीम का सिमुलेशन करता है। -
sliding_window_averageपिछली 10 रीडिंग्स की स्लाइडिंग विंडो बनाए रखता है और उनका औसत देता है। -
पाइपलाइन रीयल-टाइम में डेटा प्रोसेस करती है, जो मॉनिटरिंग और एनालिटिक्स के लिए आदर्श है।
अतिरिक्त उपयोग मामले
जनरेटर उन स्थितियों में भी उपयोग किए जाते हैं जहाँ डेटा का आकार अप्रत्याशित होता है या जब यह लगातार आता रहता है/अनंत होता है।
वेब स्क्रैपिंग
वेबसाइट्स को स्क्रैप करते समय, अक्सर आपको नहीं पता होता कि कितने पेज या आइटम प्रोसेस करने होंगे। जनरेटर आपको इस अनिश्चितता को आसानी से संभालने देते हैं:
def scrape_website(url):
""" Generator to scrape a website page by page."""
while url:
# Simulate fetching and parsing a page
print(f"Scraping {url}")
data = f"Data from {url}"
yield data
url = get_next_page(url) # Hypothetical function to get the next page
# Usage
scraper = scrape_website("https://example.com/page1")
for data in scraper:
print(data)सिमुलेशन कार्य
सिमुलेशंस, जैसे Monte Carlo विधियाँ या गेम डेवलपमेंट में, जनरेटर अनंत या डायनेमिक अनुक्रमों का प्रतिनिधित्व कर सकते हैं:
def monte_carlo_simulation():
""" Generator to simulate random events for Monte Carlo analysis."""
import random
while True:
yield random.random()
# Usage
simulation = monte_carlo_simulation()
for _ in range(10):
print(next(simulation))मेमोरी और स्पीड बेंचमार्क्स
अपने काम करने के तरीके के कारण, जनरेटर ऐसे परिदृश्यों में उत्कृष्ट हैं जहाँ मेमोरी दक्षता महत्वपूर्ण है, लेकिन (आपको यह जानकर आश्चर्य हो सकता है) वे हमेशा सबसे तेज़ विकल्प नहीं होते। आइए जनरेटर को लिस्ट्स से तुलना करके इनके ट्रेड-ऑफ समझते हैं।
पहले, हमने दिखाया था कि मेमोरी के लिहाज़ से जनरेटर लिस्ट्स से बेहतर हैं। यह वही हिस्सा था जहाँ हमने 1 करोड़ संख्याएँ जनरेट करते समय मेमोरी उपयोग की तुलना की थी। अब एक अलग चीज़ करें—स्पीड तुलना:
import time
# List comprehension
start_time = time.time()
sum([x**2 for x in range(1_000_000)])
print(f"List comprehension time: {time.time() - start_time:.4f} seconds")
# Generator expression
start_time = time.time()
sum(x**2 for x in range(1_000_000))
print(f"Generator expression time: {time.time() - start_time:.4f} seconds")List comprehension time: 0.1234 seconds
Generator expression time: 0.1456 secondsहालाँकि जनरेटर मेमोरी बचाते हैं, इस मामले में वे लिस्ट से वास्तव में धीमे हैं। ऐसा इसलिए है क्योंकि इस छोटे डेटासेट के लिए रुकने और फिर शुरू होने का ओवरहेड रहता है।
छोटे डेटासेट के लिए प्रदर्शन का अंतर नगण्य है, लेकिन बड़े डेटासेट के लिए जनरेटर की मेमोरी बचत अक्सर इस हल्के स्पीड पेनल्टी से अधिक मूल्यवान होती है।
उभरने वाली समस्याएँ
अंत में, कुछ आम गलतियों या समस्याओं पर नज़र डालते हैं:
जनरेटर समाप्त हो जाने योग्य होते हैं
एक बार जनरेटर समाप्त हो जाए, तो उसे दोबारा इस्तेमाल नहीं किया जा सकता। यदि आपको फिर से इटरेट करना है, तो आपको उसे फिर से बनाना होगा।
gen = (x for x in range(5))
print(list(gen)) # Output: [0, 1, 2, 3, 4]
print(list(gen)) # Output: [] (the generator is exhausted)लेज़ी इवैल्यूएशन पेचीदा हो सकता है
क्योंकि जनरेटर मांग पर मान उत्पन्न करते हैं, त्रुटियाँ या साइड इफेक्ट्स तब तक नहीं दिख सकते जब तक जनरेटर पर इटरेशन न हो।
आप जनरेटर का अति-उपयोग कर सकते हैं
छोटे डेटासेट या सरल कार्यों के लिए, जनरेटर का ओवरहेड मेमोरी बचत के लायक नहीं हो सकता। इस उदाहरण पर विचार करें जहाँ मैं कई इटरेशंस के लिए डेटा को मैटेरियलाइज़ कर रहा हूँ।
# Generator expression
gen = (x**2 for x in range(10))
# Materialize into a list
squares = list(gen)
# Reuse the list
print(sum(squares)) # Output: 285
print(max(squares)) # Output: 81जनरेटर का उपयोग कब चुनें
पुनरावलोकन के लिए, मैं बहुत सामान्य नियम दूँगा कि जनरेटर कब उपयोग करें। उपयोग करें:
- बड़े डेटासेट: जब ऐसे डेटासेट के साथ काम कर रहे हों जो मेमोरी में फिट न हों, तो जनरेटर का उपयोग करें।
- अनंत अनुक्रम: लाइव डेटा स्ट्रीम या सिमुलेशन जैसे अनंत अनुक्रमों के लिए जनरेटर का उपयोग करें।
- पाइपलाइंस: डेटा प्रोसेसिंग पाइपलाइंस बनाने के लिए जनरेटर का उपयोग करें जो डेटा को क्रमिक रूप से ट्रांसफॉर्म और फ़िल्टर करें।
कब डेटा को मैटेरियलाइज़ करें (लिस्ट में बदलें)
- छोटे डेटासेट: यदि मेमोरी समस्या नहीं है और आपको सभी तत्वों तक तेज़ पहुँच चाहिए, तो जनरेटर का उपयोग न करें; इसके बजाय लिस्ट का उपयोग करें।
- एकाधिक इटरेशंस: यदि आपको उसी डेटा पर कई बार इटरेट करना है, तो जनरेटर का उपयोग न करें; इसके बजाय उसे लिस्ट में मैटेरियलाइज़ करें ताकि जनरेटर को बार-बार बनाना न पड़े।
निष्कर्ष और मुख्य बातें
पूरे लेख में, हमने देखा कि जनरेटर बड़े डेटासेट प्रोसेस करने से लेकर रीयल-टाइम डेटा पाइपलाइंस बनाने तक, डेटा साइंस की वास्तविक दुनिया की चुनौतियों से निपटने में कैसे मदद करते हैं। अभ्यास करते रहें। जनरेटर में महारत हासिल करने का सबसे अच्छा तरीका है इन्हें अपने काम में इस्तेमाल करना। शुरुआत के लिए, किसी लिस्ट कॉम्प्रिहेंशन को जनरेटर एक्सप्रेशन से बदल कर देखें या किसी लूप को जनरेटर फ़ंक्शन में रिफैक्टर करें।
एक बार जब आप मूल बातें सीख लें, तो आप जनरेटर अवधारणा पर आधारित नए और उन्नत विषयों का पता लगा सकते हैं:
-
कोरूटीन: दो-तरफ़ा संचार सक्षम करने के लिए
.send()और.throw()का उपयोग करके ऐसे जनरेटर बनाएँ जो डेटा प्राप्त कर सकें और प्रोसेस कर सकें। -
असिंक्रोनस प्रोग्रामिंग: Python की asyncio लाइब्रेरी के साथ जनरेटर को मिलाकर कुशल, नॉन-ब्लॉकिंग एप्लिकेशन बनाएं।
-
कॉनकरेंसी: जानें कि जनरेटर सहकारी मल्टीटास्किंग और हल्की-फुल्की कॉनकरेंसी को कैसे लागू कर सकते हैं।
सीखते रहें और विशेषज्ञ बनें। हमारा Python Developer करियर ट्रैक या हमारा Python Programming स्किल ट्रैक आज ही लें। शुरू करने के लिए नीचे दिए गए लिंक पर क्लिक करें।

एआई, एमएल और डेटा साइंस में विशेषज्ञ तकनीकी लेखक, जो जटिल विचारों को स्पष्ट और सुगम बनाते हैं।
Python जनरेटर से जुड़े FAQs
Python जनरेटर वास्तव में क्या है?
Python जनरेटर फ़ंक्शन का एक विशेष प्रकार है जो yield कीवर्ड का उपयोग करके एक इटरेटर लौटाता है, जो एक समय में एक मान उत्पन्न करता है और पूरी सीक्वेंस को एक साथ स्टोर न करके मेमोरी बचाता है।
मुझे लिस्ट कॉम्प्रिहेंशन के बजाय जनरेटर कब इस्तेमाल करने चाहिए?
जब मेमोरी दक्षता महत्वपूर्ण हो, तो बड़े या अनंत अनुक्रमों को प्रोसेस करने के लिए जनरेटर आदर्श हैं, जबकि लिस्ट कॉम्प्रिहेंशन तब उपयुक्त हैं जब आपको दोहराए जाने वाले एक्सेस या रैंडम इंडेक्सिंग के लिए पूरी लिस्ट चाहिए।
जनरेटर प्रदर्शन कैसे बढ़ाते हैं?
एक समय में एक मान देकर (लेज़ी इवैल्यूएशन), जनरेटर चलते-फिरते मान कम्प्यूट करते हैं, जिससे मेमोरी उपयोग घटता है और पूरे डेटा स्ट्रक्चर मेमोरी में बनाने की तुलना में प्रोसेसिंग तेज़ होती है।
क्या मैं जनरेटर पर एक से अधिक बार इटरेट कर सकता/सकती हूँ?
नहीं, एक बार पूरी इटरेशन के बाद जनरेटर समाप्त हो जाता है। दोबारा इटरेट करने के लिए आपको नया जनरेटर इंस्टेंस बनाना होगा।
जनरेटर के कुछ व्यावहारिक उपयोग मामले क्या हैं?
जनरेटर बड़े डेटासेट प्रोसेस करने, रीयल-टाइम डेटा स्ट्रीमिंग, कुशल पाइपलाइंस बनाने और एल्गोरिथमिक व सिमुलेशन कार्यों में अनंत अनुक्रमों को संभालने में उपयोगी होते हैं।
मान लीजिए आप एक डेटा साइंस प्रोजेक्ट पर काम कर रहे हैं, और आपका काम इतना बड़ा डेटासेट प्रोसेस करना है कि उसे मेमोरी में लोड करते ही आपकी मशीन क्रैश हो जाती है। या आप एक अनंत अनुक्रम, जैसे लाइव डेटा स्ट्रीम, से निपट रहे हैं जिसे आप एक साथ कभी भी स्टोर नहीं कर सकते। ये वही चुनौतियाँ हैं जो डेटा वैज्ञानिकों को कॉफी पॉट—और कभी-कभी रीसेट बटन—तक ले जाती हैं।
इस लेख में, हम Python जनरेटर के बारे में सीखेंगे और देखेंगे कि आप इन्हें अपने कोड को सरल बनाने के लिए कैसे इस्तेमाल कर सकते हैं। यह विचार कुछ अभ्यास मांगता है, इसलिए यदि आप Python में नए हैं और इस लेख में कहीं उलझ जाएँ, तो हमारी Introduction to Python कोर्स से मज़बूत नींव बनाएं।