
Cursus
Introductie tot Snowflake SQL
2 uur
57.5K
Traditionele machine learning houdt in dat je data uit databases naar de plek brengt waar de modellen staan. Met de recente AI-hausse en de enorme omvang van datasets van vandaag wordt deze aanpak steeds onpraktischer.
Er moeten terabytes aan data van de database naar clientapplicaties worden overgezet voor opschoning, analyse en het trainen van modellen. Deze ogenschijnlijk onschuldige heen-en-weer kost waardevolle resources. Daarom kiezen steeds meer bedrijven voor in-database technologieën om databeweging te minimaliseren en data-operaties soepel te laten verlopen.
Een van de beste in-database technologieën op de markt is Snowpark, aangeboden door Snowflake Cloud. Snowpark is een set libraries en runtimes waarmee je programmeertalen veilig kunt draaien in Snowflake Cloud om datapijplijnen en machinelearningmodellen te ontwikkelen in dezelfde omgeving als je Snowflake-databases.
In deze tutorial bespreken we de basisprincipes van Snowpark en hoe je het in je projecten kunt gebruiken. We gaan ervan uit dat je al bekend bent met SQL en Snowflake—moet je dit eerst nog doornemen, volg dan onze SQL Fundamental Skill Track of lees deze Snowflake-tutorial voor beginners.
Laten we beginnen!
Snowflake Snowpark is een set libraries en runtimes waarmee je programmeertalen zoals Python, Java en Scala veilig kunt gebruiken om data rechtstreeks binnen het cloudplatform van Snowflake te verwerken.
Dit elimineert de noodzaak om data buiten Snowflake te verplaatsen voor verwerking, wat de efficiëntie en beveiliging verbetert. Enkele belangrijke voordelen:
Kortom, Snowpark is een krachtige maar eenvoudige manier voor developers om datapijplijnen, machinelearningsoplossingen en datagedreven applicaties rechtstreeks binnen Snowflake Cloud te bouwen.
Ons einddoel in deze tutorial is om een model te bouwen met afgestemde hyperparameters, getraind op een tabel van een Snowflake-database met behulp van Snowpark. Hiervoor beginnen we met:
Voor deze tutorial gebruiken we een nieuwe conda-omgeving:
$ conda create -n snowpark python==3.10 -y
$ conda activate snowpark
Als je op een nieuw geïnstalleerde conda-omgeving draait, moet je als sidenote eerst $conda init uitvoeren voordat je de snowpark-omgeving activeert.
Na activatie moeten we de volgende libraries installeren:
$ pip install snowflake-snowpark-python #The Snowpark API
$ pip install pandas pyarrow numpy matplotlib seaborn
Als je Jupyter gebruikt, installeer dan ook ipykernel en voer het volgende commando uit zodat de omgeving die we gebruiken wordt toegevoegd als Jupyter-kernel:
$ pip install ipykernel
$ ipython kernel install --user --name=snowpark
Laten we nu wat algemene libraries importeren die we onderweg nodig hebben:
import warnings
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
warnings.filterwarnings("ignore")Voor deze tutorial gebruiken we de Diamonds-dataset van Seaborn—je kunt het CSV-bestand rechtstreeks downloaden van mijn GitHub.
Zodra je bent ingelogd op de Snowflake-app, volg je de GIF hieronder om de dataset in te laden in een nieuwe databasetabel (maak een nieuw account aan als je er nog geen hebt):
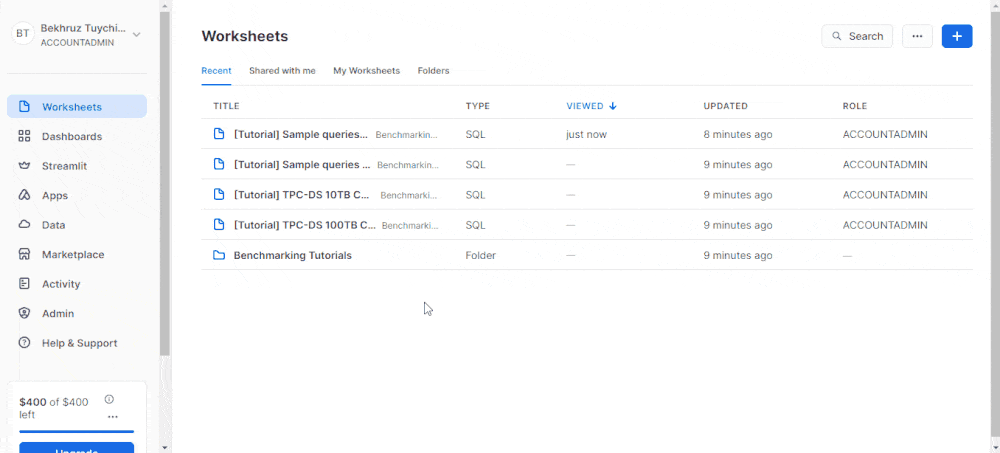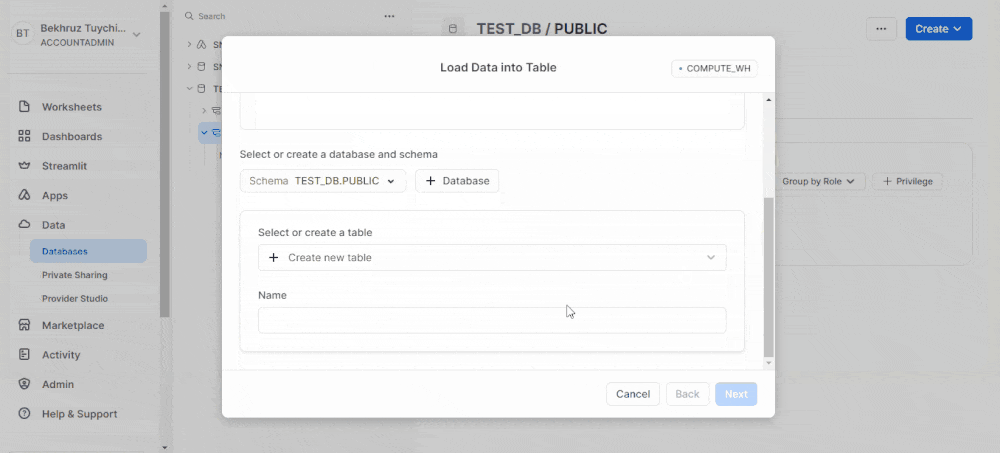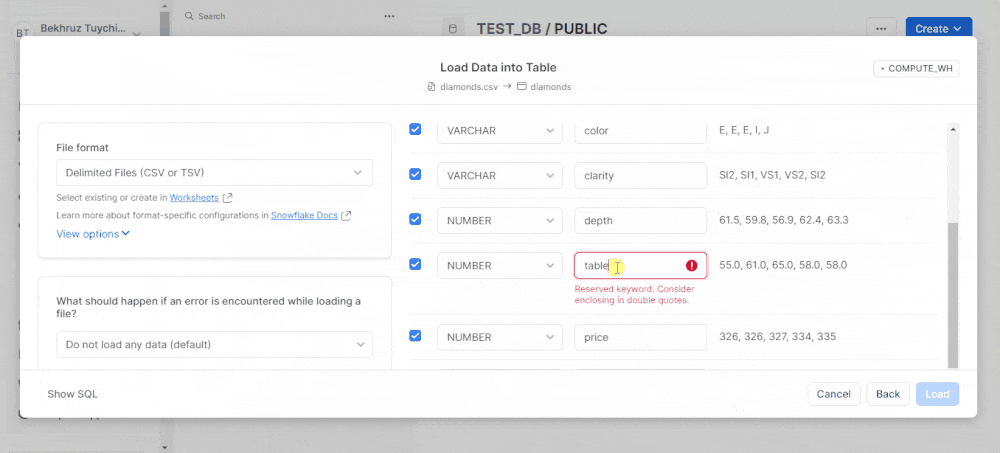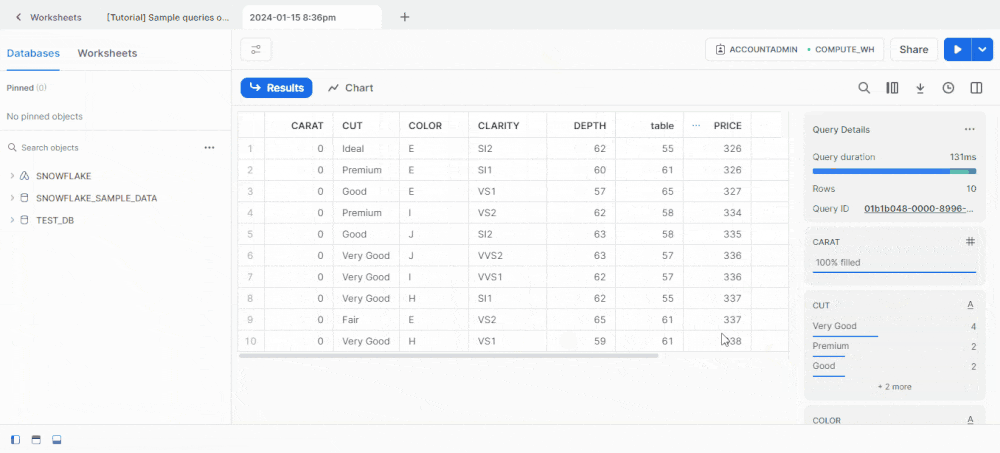
In de praktijk zul je zelden CSV-bestanden als tabellen in je Snowflake-databases importeren. Meestal werk je met bestaande databases met verschillende toegangsniveaus die je krijgt van de databasebeheerders van je bedrijf.
Nu moeten we een verbinding tot stand brengen tussen de API van Snowpark en de cloud van Snowflake om onze database te kunnen bevragen. Deze verbinding vereist de volgende Snowflake-gegevens: accountnaam, gebruikersnaam en wachtwoord.
In de afbeelding hieronder laat ik zien hoe je je gebruikersnaam en accountnaam uit het Snowflake-dashboard kunt halen:
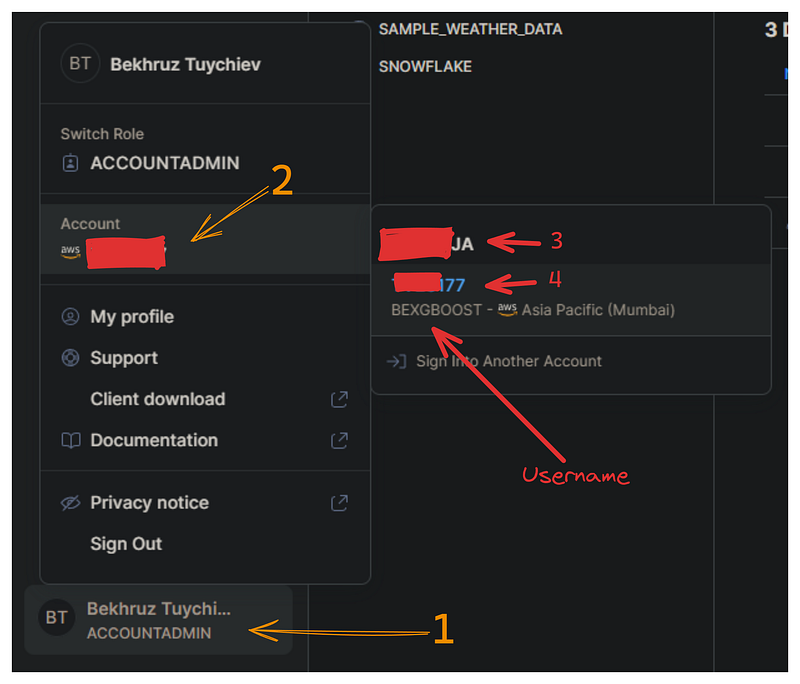
Maak een apart bestand met de naam config.py dat één dictionary bevat met de naam credentials in het volgende formaat:
credentials = (
   {
       "account": "3-4",  # Combine 3 and 4 with a hyphen
       "username": "bexgboost",  # Your username in lowercase
       "password": "your_password",  # Your Snowflake password
   },
)
Om veiligheidsredenen slaan we inloggegevens op in een apart bestand. Door dit bestand toe te voegen aan .gitignore zorg je ervoor dat je Snowflake-gegevens niet per ongeluk uitlekken.
Importeer nu de credentials-dictionary en de Session-klasse van Snowpark:
from config import credentials
from snowflake.snowpark import Session
Om een verbinding te maken gebruiken we de methode Session.builder.configs.create():
connection_parameters = {
   "account": credentials["account"],
   "user": credentials["username"],
   "password": credentials["password"],
}

new_session = Session.builder.configs(connection_parameters).create()
new_session.get_current_user()'"bexgboost"'Als je gebruikersnaam wordt afgedrukt, is je eerste sessie succesvol aangemaakt!
Het object new_session heeft toegang tot alles wat je account in Snowflake bezit (en waartoe je toestemming hebt).
De eerste stap die we zetten voordat we data importeren, is de sessie vertellen dat we de database test_db gebruiken die we in de vorige sectie hebben aangemaakt:
new_session.sql("USE DATABASE test_db;").collect()[Row(status='Statement executed successfully.')]Dit doen we met de .sql-methode, waarmee we elke Snowflake SQL-compatibele query kunnen uitvoeren.
Nu kunnen we de diamonds-tabel van test_db laden met de table-methode van het sessieobject:
diamonds_df = new_session.table("diamonds")
diamonds_df.show(5)
De methode .show() is het equivalent van DataFrame.describe() in Pandas en laat ons zien dat we succesvol met de tabel zijn verbonden.
Klopt — we zijn alleen met de diamonds-tabel verbonden. Het object diamonds_df bevat geen data, zoals blijkt uit de grootte:
import sys
sys.getsizeof(diamonds_df)48Het is slechts 48 bytes, terwijl het meer dan 3 MB zou moeten zijn. Laten we iets meer tijd nemen om te begrijpen waarom dit gebeurt.
Tot nu toe hebben we de volgende stappen behandeld:
Laten we het nu hebben over Snowpark DataFrames!
Pandas DataFrames gebruiken je RAM, wat betekent dat ze op je machine leven. Ter vergelijking: Snowpark DataFrames leven binnen het cloudplatform van Snowflake, ook al zie je hun representatie in je code-omgeving. De data blijft in de cloud en hoeft niet naar je lokale machine te worden gedownload om er bewerkingen op uit te voeren.
Een ander belangrijk aspect van Snowpark DataFrames is dat ze lui werken. Dat betekent dat ze geen bewerkingen op de data uitvoeren totdat je dat expliciet vraagt.
In plaats daarvan bouwen ze een logische representatie van de gewenste bewerkingen die vervolgens worden vertaald naar geoptimaliseerde SQL-queries die Snowflake uitvoert.
Ter vergelijking: Pandas voert bewerkingen meteen uit—met andere woorden, het gebruikt eager execution.
Qua performance is luie evaluatie bijna altijd significant sneller dan eager execution. Omdat luie DataFrames de krachtige, elastische compute-resources van Snowflake gebruiken, kunnen ze bewerkingen doorschuiven naar het databaseniveau en veel sneller draaien.
Om het verschil tussen luie evaluatie en eager execution beter te begrijpen, stel je voor dat onze data in Snowflake een gigantische bibliotheek is. We hebben de volgende twee scenario’s:
Omdat Snowpark kan omzetten naar Pandas DataFrames, wanneer gebruik je de een boven de ander?
pandas_diamonds = diamonds_df.to_pandas()
pandas_diamonds.head()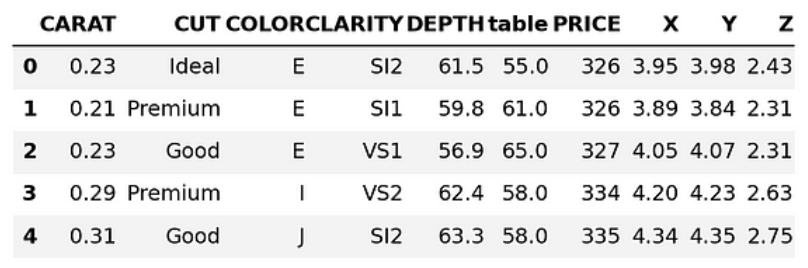
Het antwoord hangt grotendeels af van de grootte van de dataset.
Als je dataset klein is (zoals de Diamonds-dataset), kun je deze lokaal downloaden en zonder problemen in Pandas laden (dat is wat de methode DataFrame.to_pandas() doet).
Maar met de datasets van vandaag kan het snel uit de hand lopen en moeten we misschien uren wachten tot onze database is gedownload. En vergeet niet: het is een retourtje—alle nieuwe data die we willen bewaren, moet ook teruggestuurd worden. En dát maakt het leren van de Snowpark DataFrame API zo waardevol.
Als alternatief kun je met de methode Session.sql() elke SQL-expressie uitvoeren die compatibel is met Snowflake (zie het voorbeeld hieronder). Toch raad ik sterk aan om de Snowpark DataFrame API onder de knie te krijgen, omdat deze veel ingebouwde functies heeft voor meer dan 100 SQL-functies en -expressies.
result = new_session.sql(
   """
   SELECT PRICE, CUT FROM DIAMONDS LIMIT 10
"""
)

type(result)
snowflake.snowpark.dataframe.DataFrameresult.show()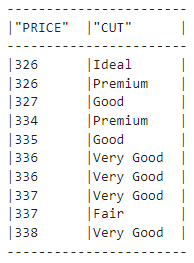
Een groot deel van je tijd in Snowpark besteed je aan de transformatiefuncties. Ze zijn beschikbaar onder de volgende submodule:
# The convention is to import it as F
import snowflake.snowpark.functions as F
Alle functies onder F (die je kunt opvragen met dir(F)) geven aan hoe een DataFrame moet worden getransformeerd. Laten we een voorbeeld bekijken:
F.upper(F.col("CUT"))Hier maakt de functie col een referentie naar de opgegeven kolom en retourneert een Column-object. Vervolgens zet .upper() de waarden van de kolom CUT om naar hoofdletters:
diamonds_df.show(5)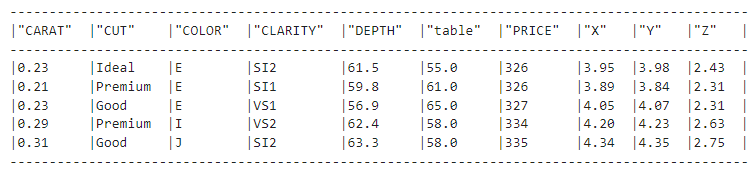
Maar als we naar de diamonds-dataset kijken, zien we dat de waarden in de kolom CUT nog steeds kleine letters bevatten. Hoe kan dat? Nou, de expressie F.upper(F.col("CUT")) is gelijkwaardig aan de volgende SQL-query:
SELECT UPPER(CUT);Wat mist hier?
Natuurlijk, de FROM-clausule die de tabelnaam specificeert waarop de transformatie moet worden toegepast!
Dus moeten we de expressie F.upper(F.col("CUT")) combineren met het diamonds_df-object. Er zijn drie hoofdmanieren om dit te doen:
.select().filter().with_column()Omdat onze expressie een kolom transformeert, geven we deze door aan .select():
our_expression = F.upper(F.col("CUT"))
diamonds_df.select(our_expression).show()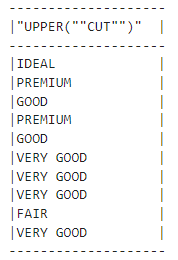
We hebben de waarden succesvol gewijzigd!
Laten we nu een expressie schrijven die rijen filtert:
diamonds_df.filter(F.col("PRICE") > 10000).count()5222We zien dat er meer dan 5000 diamanten in onze dataset zijn die meer dan $10.000 kosten. Laten we ook een kolom aanmaken:
(
diamonds_df.with_column("PRICE_SQUARED", F.col("PRICE") ** 2)
.select("PRICE", "PRICE_SQUARED")
.show(5)
)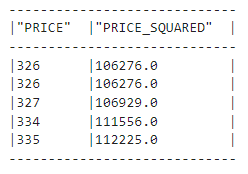
Hierboven laten we ook zien dat chaining van methods is toegestaan—we hebben een nieuwe kolom met de naam “PRICE_SQUARED”. We zien dat de functies van Snowpark DataFrame lijken op die van Pandas.
Samengevat: als je op zoek bent naar een Snowpark-alternatief voor een Pandas-functie, staat het óf onder F óf maakt het deel uit van de methodes van Snowpark DataFrames. Je kunt dit checken met dir(F) of dir(diamonds_df) of door de Snowpark Python-referentie te lezen.
Een belangrijk deel van exploratieve data-analyse (EDA) is het maken van visualisaties. Gelukkig hebben we hiervoor Snowpark niet nodig, omdat we de moderne datastack kunnen blijven gebruiken.
Het idee is dit: omdat EDA draait om het ontdekken van algemene trends en inzichten, kunnen we vaak een steekproef gebruiken in plaats van de hele dataset. Zodra we een representatieve steekproef downloaden, kunnen we die converteren naar een Pandas DataFrame en gewoon Matplotlib of Seaborn gebruiken.
Laten we beginnen met de conversie:
sample = diamonds_df.sample(0.25).to_pandas()
sample.head()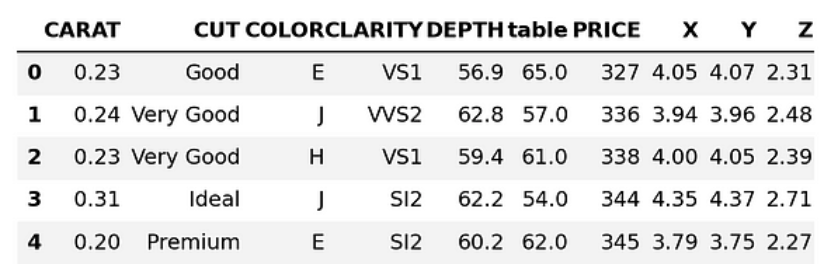
Hierboven downloaden we 25% van de dataset als een Pandas DataFrame. Laten we de kolomnamen naar kleine letters omzetten:
sample.columns = [col.lower() for col in sample.columns]
sample.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y', 'z'], dtype='object')Nu kun je EDA doen zoals je met elke dataset zou doen. Hieronder verkennen we een paar mogelijke ideeën en beginnen we met het genereren van een scatterplot om de relatie tussen prijs en karaat te visualiseren:
#Remember we imported seaborn as sns
sns.scatterplot(data=sample, x="price", y="carat", s=1)
plt.title("Diamond prices vs. carat")
plt.show()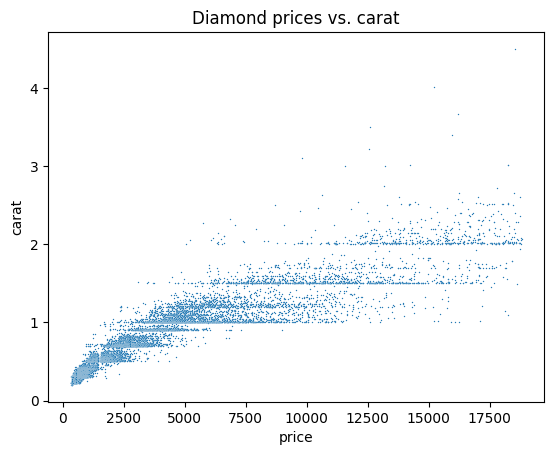
Laten we nu een correlatiematrix plotten om de correlatie tussen elk paar numerieke features te zien:
corr_matrix = sample.corr(numeric_only=True)
sns.heatmap(corr_matrix, center=0, square=True, annot=True
plt.title("The correlation matrix of Diamond numeric features")
plt.show()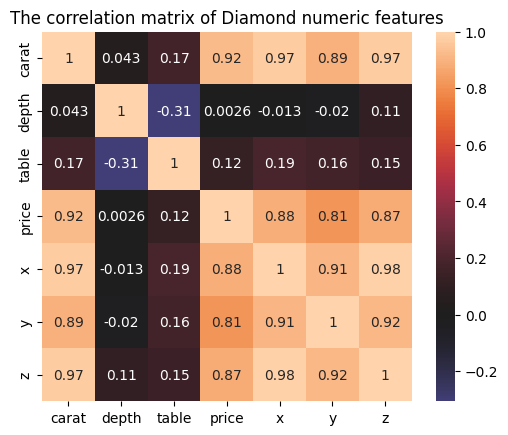
We kunnen ook een staafdiagram maken van de categorieën voor de slijpvorm van diamanten:
cut_counts = sample.groupby("cut")["cut"].count()
cut_counts.plot(kind="bar")
plt.title("Category counts of diamond cuts")
plt.xlabel("Diamond cut")
plt.show()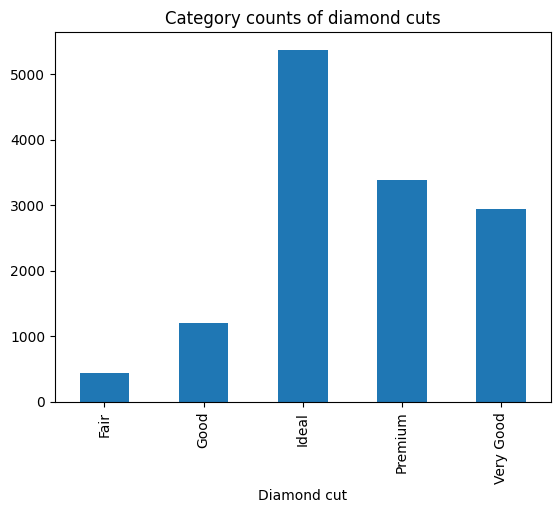
Om te bevestigen dat deze grafieken ongeveer hetzelfde zijn op de volledige dataset, draaien we de SQL-versie van het bovenstaande staafdiagram.
Eerst schrijven we een SQL-expressie om de diamonds-dataset te groeperen op CUT:
result = new_session.sql(
   """
   SELECT cut, COUNT(*) AS count
     FROM diamonds
    GROUP BY cut;
"""
)
Laten we het resultaat nu converteren en downloaden als een Pandas DataFrame:
result_pd = result.to_pandas()
result_pd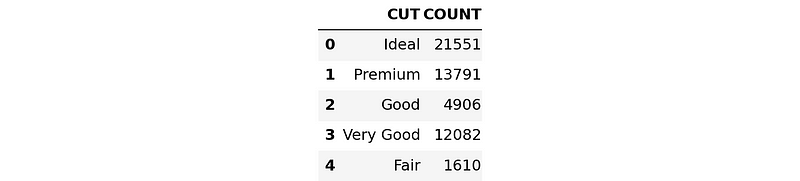
Deze keer gebruiken we de functie plt.bar() om de grafiek te maken:
plt.bar(x=result_pd["CUT"], height=result_pd["COUNT"])
plt.show()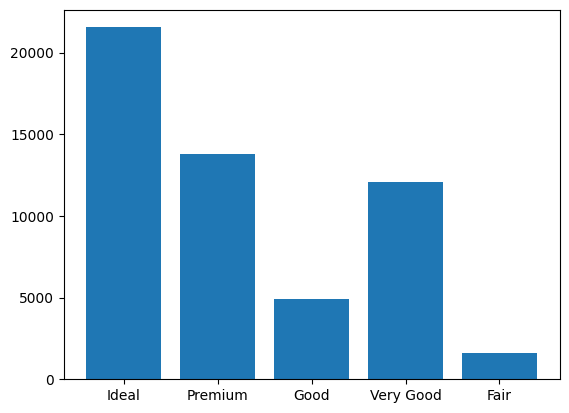
De volgorde van de balken is anders, maar naast elkaar laten ze dezelfde informatie zien.
We zijn nu klaar om te leren hoe je machinelearningmodellen traint in Snowpark!
We beginnen met het opschonen van de dataset.
Laten we eerst controleren of alle kolommen het juiste datatype hebben:
list(diamonds_df.schema)[StructField('CARAT', DecimalType(38, 2), nullable=True),
StructField('CUT', StringType(16777216), nullable=True),
StructField('COLOR', StringType(16777216), nullable=True),
StructField('CLARITY', StringType(16777216), nullable=True),
StructField('DEPTH', DecimalType(38, 1), nullable=True),
StructField('"table"', DecimalType(38, 1), nullable=True),
StructField('PRICE', LongType(), nullable=True),
StructField('X', DecimalType(38, 2), nullable=True),
StructField('Y', DecimalType(38, 2), nullable=True),
StructField('Z', DecimalType(38, 2), nullable=True)]De kolom table heeft een vreemde naam, dus zetten we die om naar hoofdletters TABLE_ (met een trailing underscore zodat dit niet botst met een ingebouwd SQL-trefwoord):
diamonds_df = diamonds_df.with_column_renamed('"table"', "TABLE_")
diamonds_df.columns
['CARAT', 'CUT', 'COLOR', 'CLARITY', 'DEPTH', 'TABLE_', 'PRICE', 'X', 'Y', 'Z']We moeten het datatype van numerieke features wijzigen van DecimalType naar DoubleType, omdat decimals nog niet worden ondersteund in Snowpark.
from snowflake.snowpark.types import DoubleType

numeric_features = ["CARAT", "X", "Y", "Z", "DEPTH", "TABLE_"]
for col in numeric_features:
   diamonds_df = diamonds_df.with_column(col, diamonds_df[col].cast(DoubleType()))

list(diamonds_df.select(*numeric_features))
[Column("CARAT"),
Column("X"),
Column("Y"),
Column("Z"),
Column("DEPTH"),
Column("TABLE_")]In het fragment hierboven gebruiken we opnieuw de methode .with_column(). Een andere nieuwe methode is .cast(), die deel uitmaakt van de methodes van Snowpark DataFrames.
Snowpark vereist ook dat alle tekstfeatures in hoofdletters staan en geen spaties tussen woorden hebben voordat ze worden gecodeerd. Momenteel voldoen de waarden van de feature CUT niet aan deze eis, dus lossen we dat op met functietransformaties:
import snowflake.snowpark.functions as F

def remove_space_and_upper(df):
   df = df.with_column("CUT", F.upper(F.replace(F.col("CUT"), " ", "_")))

   return df

diamonds_df = remove_space_and_upper(diamonds_df)
Onze data is nu vrij van opschoningsproblemen. We kunnen deze als nieuwe tabel terug opslaan in Snowflake:
diamonds_df.write.mode("overwrite").save_as_table("diamonds_cleaned")Zorg ervoor dat je de modus overwrite toevoegt, omdat je mogelijk terug moet om wat opschoonbewerkingen te wijzigen en opnieuw op te slaan.
In deze sectie pakken we resterende preprocessing-issues aan die het trainen van modellen kunnen verhinderen. Laten we de opgeschoonde tabel uit de vorige sectie laden:
clean_df = new_session.table("diamonds_cleaned")
clean_df.show()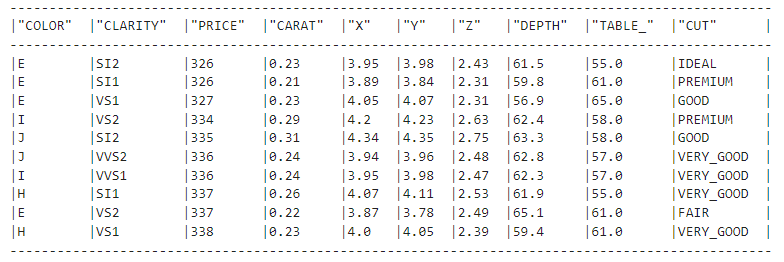
Heel goed!
Vervolgens importeren we de submodules preprocessing en pipeline uit de namespace snowflake.ml.
import snowflake.ml.modeling.preprocessing as snowml
from snowflake.ml.modeling.pipeline import Pipeline
Hoewel de DataFrame-API van Snowpark beschikbaar is onder snowflake.snowpark, staan de Snowpark ML-modules onder snowflake.ml. Dit kan in het begin verwarrend zijn, dus neem de tijd om hieraan te wennen.
In de onderstaande code:
# List all the features for processing
cat_cols = ["CUT", "COLOR", "CLARITY"]
cat_cols_encoded = ["CUT_OE", "COLOR_OE", "CLARITY_OE"]

# We already have numeric_features

# List the correct ordering of categorical features
categories = {
   "CUT": np.array(["IDEAL", "PREMIUM", "VERY_GOOD", "GOOD", "FAIR"]),
   "CLARITY": np.array(
       ["IF", "VVS1", "VVS2", "VS1", "VS2", "SI1", "SI2", "I1", "I2", "I3"]
   ),
   "COLOR": np.array(["D", "E", "F", "G", "H", "I", "J"]),
}
We zijn nu klaar om een pipeline te bouwen die lijkt op een Scikit-learn-pipeline:
# Build the pipeline
preprocessing_pipeline = Pipeline(
   steps=[
       (
           "OE",
           snowml.OrdinalEncoder(
               input_cols=cat_cols, output_cols=cat_cols_encoded, categories=categories
           ),
       ),
       (
           "SS",
           snowml.StandardScaler(
               input_cols=numeric_features, output_cols=numeric_features
           ),
       ),
   ]
)
De klasse Pipeline accepteert een lijst met stappen, elk een preprocessing-klasse. Hier gebruiken we OrdinalEncoder om categorische variabelen te coderen als 0, 1, 3, enz. en StandardScaler om de numerieke features te normaliseren.
Tot slot slaan we de pipeline lokaal op met joblib en testen we hem op de volledige dataset:
import joblib
PIPELINE_FILE = "pipeline.joblib"

# Pickle locally first
joblib.dump(preprocessing_pipeline, PIPELINE_FILE)

transformed_diamonds_df = preprocessing_pipeline.fit(clean_df).transform(clean_df)

# transformed_diamonds_df.show() - commented because of long output
De code draait zonder fouten, dus onze pipeline werkt, wat aangeeft dat we eindelijk een model kunnen trainen.
Om een model te trainen, sommen we opnieuw de featurenamen en doelnamen op:
# Define the columns again
cat_cols_encoded = ["CUT_OE", "COLOR_OE", "CLARITY_OE"]
numeric_features = ["CARAT", "X", "Y", "Z", "DEPTH", "TABLE_"]

label_cols = ["PRICE"]  # Must be a list
output_cols = ["PRICE_PREDICTED"]  # Required in snowpark
We splitsen de data nu met DataFrame.random_split() en geven gewichten om de fractie van train- en testsets aan te geven:
# Split the data
train_df, test_df = diamonds_df.random_split(weights=[0.8, 0.2], seed=42)
Vervolgens laden we de pipeline en passen we fit-transform toe op zowel train- als testsets.
# Load the pre-processing pipeline locally
pipeline = joblib.load("pipeline.joblib")

# Apply it to both dataframes
train_df_transformed = pipeline.fit(train_df).transform(train_df)
test_df_transformed = pipeline.transform(test_df)
Zorg er hierboven voor dat je op de testset alleen .transform() aanroept om datalekken te voorkomen.
Vervolgens initialiseren we een XGBoost-regressormodel uit de ml.modeling.xgboost-submodule:
# Snowpark has models from scikit-learn and lightgbm too
from snowflake.ml.modeling.xgboost import XGBRegressor

# Initialize
regressor = XGBRegressor(
   input_cols=cat_cols_encoded + numeric_features,
   label_cols=label_cols,
   output_cols=output_cols,
)
De klasse XGBRegressor vereist alle inputnamen, alle doelnamen en namen van outputkolommen. Zodra we die invoeren, roepen we .fit() aan om het trainingsproces te starten:
# Train
regressor.fit(train_df_transformed)
De training kan traag verlopen als je een gratis Snowflake-account hebt met beperkte rekenresources en geen GPU.
Zodra de training is voltooid, kunnen we voorspellingen genereren:
# Voorspellen
train_preds = regressor.predict(train_df_transformed)
test_preds = regressor.predict(test_df_transformed)
Laten we naar de voorspellingen kijken:
train_preds.select("PRICE", "PRICE_PREDICTED").show(5)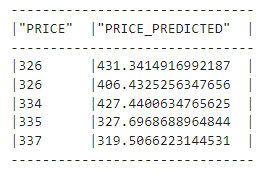
We moeten nu meten hoe goed ons initiële model presteerde. Snowpark bevat tientallen metrics uit Scikit-learn onder de submodule ml.modeling.metrics die we importeren als M:
import snowflake.ml.modeling.metrics as MVervolgens draaien we mean_squared_error twee keer om de root mean squared error (RMSE) te meten op zowel train- als testsets (hieronder geeft squared=False RMSE in plaats van MSE terug):
rmse_train = M.mean_squared_error(
   df=train_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

rmse_test = M.mean_squared_error(
   df=test_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

print(f"Train RMSE score for XGBRegressor: {rmse_train:.4f}")
print(f"Test RMSE score for XGBRegressor: {rmse_test:.4f}")
Train RMSE score for XGBRegressor: 371.9664
Test RMSE score for XGBRegressor: 542.1566Ons model zit er gemiddeld $542 naast en het overfit mogelijk ook een beetje, omdat het verschil tussen train- en test-RMSE groot is.
Laten we de hyperparameters van het model afstemmen om deze problemen aan te pakken.
Momenteel biedt Snowpark twee classes voor hyperparametertuning:
GridSearchCV: uitputtende zoekopdracht over alle hyperparametercombinaties met cross-validatie.RandomizedSearchCV: willekeurige zoekopdracht over gegeven hyperparameterverdelingen met cross-validatie.XGBoost heeft een dozijn hyperparameters die de prestaties kunnen verbeteren (je kunt meer leren in deze tutorial over XGBoost gebruiken in Python). Dit duwt ons richting een randomized search. Persoonlijk geef ik de voorkeur aan Optuna, dat Bayesiaanse zoekstrategie gebruikt, maar die luxe hebben we in Snowpark nog niet.
Laten we de zoekopdracht nu definiëren:
from snowflake.ml.modeling.model_selection import RandomizedSearchCV

rscv = RandomizedSearchCV(
   estimator=XGBRegressor(),
   param_distributions={
       "n_estimators": [2000],
       "max_depth": list(range(3, 13)),
       "learning_rate": np.linspace(0.1, 0.5, num=10),
   },
   n_jobs=-1,
   scoring="neg_mean_squared_error",
   input_cols=numeric_features + cat_cols_encoded,
   label_cols=label_cols,
   output_cols=output_cols,
   n_iter=10,
)

rscv.fit(train_df_transformed)
We fixeren het aantal estimators op 2000 en stemmen alleen de parameters max_depth en learning_rate af. De rscv heeft standaard n_iter=10, wat betekent dat de zoekopdracht 10 keer wordt uitgevoerd, waarbij elke keer een willekeurige parametercombinatie wordt gekozen. Voor nauwkeurigere resultaten kies je het best een groter getal voor deze parameter.
Laten we nu de prestaties meten van het beste gevonden model. De code is hetzelfde als hiervoor, maar in plaats van regressor gebruiken we het object rscv:
# Predict
train_preds = rscv.predict(train_df_transformed)
test_preds = rscv.predict(test_df_transformed)
rmse_train = M.mean_squared_error(
   df=train_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

optimal_rmse_test = M.mean_squared_error(
   df=test_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

print(f"Train RMSE score for optimal model: {rmse_train:.4f}")
print(f"Test RMSE score for optimal model: {rmse_test:.4f}")
Train RMSE score for optimal model: 224.2405
Test RMSE score for optimal model: 572.0517De train-RMSE is gedaald, maar de test-RMSE is nog groter. Dit geeft aan dat we nog steeds overfitten en onze zoekopdracht moeten uitbreiden en andere parameters moeten opnemen om de beslissingsbomen die XGBoost onder de motorkap gebruikt te snoeien.
Dat deel laat ik aan jou over.
Als we de sessie nu sluiten, verliezen we ons afgestemde model. Om het op te slaan gebruiken we de native model registry van Snowpark, een virtuele opslag die je kunt gebruiken om elk model en de bijbehorende metadata op te slaan.
De registry is beschikbaar als de klasse Registry en vereist de database- en schemanaam van de huidige sessie. We moeten het project ook een naam geven, zodat we geen conflicten krijgen met modellen van andere projecten:
# Set up for Registry
from snowflake.ml.registry import Registry

# Get the current db and schema name
db_name = new_session.get_current_database()
schema_name = new_session.get_current_schema()

# Define global model name for the project
model_name = "diamond_prices_regression"

# Initialize a registry to log models
registry = Registry(session=new_session, database_name=db_name, schema_name=schema_name)
We gebruiken de methode Registry.log_model() om onze modellen op te slaan:
# Get sample data to pass into registry for schema
sample = train_df.select(cat_cols_encoded + numeric_features).limit(50)

# Log the first model
v0 = registry.log_model(
   model_name=model_name,
   version_name="v0",
   model=regressor,
   sample_input_data=sample,
)
We kunnen een metric voor het model loggen met de methode .set_metric() (we kunnen zoveel metrics loggen als we willen). We voegen ook een opmerking toe om het model te beschrijven:
# Add the models RMSE score
v0.set_metric(metric_name="RMSE", value=rmse_test)

# Add a description
v0.comment = "The first model to predict diamond prices"
We doen hetzelfde voor het beste model dat met random search is gevonden. Vergeet bij het loggen van de metric niet om de waarde te wijzigen naar optimal_rmse_test.
# Log the optimal model
v1 = registry.log_model(
   model_name=model_name,
   version_name="v1",
   model=regressor,
   sample_input_data=sample,
)

# Add the models RMSE score
v1.set_metric(metric_name="RMSE", value=optimal_rmse_test)

# Add a description
v1.comment = "Optimal model found with RandomizedSearchCV"
Om te bevestigen dat de modellen zijn opgeslagen, kun je .show_models() aanroepen:
# Confirm the models are added
registry.show_models()
Lees meer over het beheren van de registry op deze pagina van de ontwikkelaarsdocumentatie over Snowpark.
Inferentie gebeurt meestal door het beste model uit je registry te kiezen. Dat kunnen we doen door het resultaat van .show_models() te filteren of door het model direct op te halen met zijn versie-tag, zoals we hieronder doen:
# Doing inference with the optimal model
optimal_version = registry.get_model(model_name).version("v1")
results = optimal_version.run(test_df, function_name="predict")

results.columns
De methode get_model() retourneert een generiek model-object, dat verschilt van XGBRegressor. Daarom moet je .run() aanroepen met de functienaam om een inferentie uit te voeren.
In deze tutorial hebben we een end-to-end framework behandeld om machinelearningmodellen te trainen in Snowflake Snowpark. Goed gedaan!
We begonnen met een kale, onopgeschoonde dataset en eindigden met een afgestemd XGBoost-regressormodel. We hebben alle acties uitgevoerd op Snowflake Cloud, wat betekent dat we geen systeemresources hoefden te gebruiken.
We hebben geleerd hoe effectief dit soort in-database operaties zijn wanneer we grote datasets hebben—en dat Snowflake Snowpark een van de beste tools op de markt is om dit proces te faciliteren.
Wil je meer leren over Snowpark of Snowflake, bekijk dan de volgende bronnen:
Bedankt voor het lezen!
Leer meer over Snowflake en big data!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

