
Kurs
Einführung in Snowflake SQL
2 Std.
55.8K
Klassisches Machine Learning holt die Daten aus Datenbanken dorthin, wo die Modelle laufen. Mit dem aktuellen KI-Boom und den schieren Datenmengen wird dieser Ansatz zunehmend unpraktisch.
Terabytes an Daten müssen für Bereinigung, Analyse und Modelltraining aus der Datenbank in Client-Anwendungen verschoben werden. Diese scheinbar harmlose Hin- und Rückfahrt verschwendet wertvolle Ressourcen. Deshalb setzen immer mehr Unternehmen auf In-Database-Technologien, um Datenbewegungen zu minimieren und Abläufe reibungslos im Datenbankumfeld auszuführen.
Eine der besten In-Database-Technologien am Markt ist Snowpark von Snowflake Cloud. Snowpark ist ein Set aus Bibliotheken und Runtimes, mit dem du Programmiersprachen sicher in Snowflake Cloud ausführen kannst, um Datenpipelines und Machine-Learning-Modelle in derselben Umgebung wie deine Snowflake-Datenbanken zu entwickeln.
In diesem Tutorial besprechen wir die Grundlagen von Snowpark und wie du es in deinen Projekten einsetzt. Wir setzen SQL- und Snowflake-Kenntnisse voraus—falls du diese zuerst auffrischen möchtest, starte mit unserem Lernpfad SQL Grundlagen oder lies dieses Snowflake-Tutorial für Einsteiger.
Los geht’s!
Snowflake Snowpark ist ein Set aus Bibliotheken und Runtimes, mit dem du Programmiersprachen wie Python, Java und Scala sicher direkt in Snowflakes Cloud-Plattform zur Datenverarbeitung verwenden kannst.
So entfällt die Notwendigkeit, Daten zur Verarbeitung aus Snowflake herauszubewegen—das steigert Effizienz und Sicherheit. Hier sind die wichtigsten Vorteile:
Kurz gesagt: Snowpark ist ein mächtiger und dennoch einfacher Weg für Entwickler, Datenpipelines, Machine-Learning-Lösungen und datengetriebene Anwendungen direkt in Snowflake Cloud zu bauen.
Unser Ziel in diesem Tutorial ist es, ein hyperparametertuntes Modell zu trainieren, das auf einer Tabelle einer Snowflake-Datenbank basiert—und das mit Snowpark. Dafür starten wir mit:
Für dieses Tutorial verwenden wir eine neue conda-Umgebung:
$ conda create -n snowpark python==3.10 -y
$ conda activate snowpark
Hinweis: In einer frisch installierten conda-Umgebung musst du vor dem Aktivieren von snowpark einmal $conda init ausführen.
Nach der Aktivierung installieren wir folgende Bibliotheken:
$ pip install snowflake-snowpark-python #The Snowpark API
$ pip install pandas pyarrow numpy matplotlib seaborn
Wenn du Jupyter verwendest, installiere zusätzlich ipykernel und führe folgenden Befehl aus, damit die genutzte Umgebung als Jupyter-Kernel verfügbar ist:
$ pip install ipykernel
$ ipython kernel install --user --name=snowpark
Importieren wir nun allgemeine Bibliotheken, die wir unterwegs benötigen:
import warnings
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
warnings.filterwarnings("ignore")Wir verwenden das Diamonds-Dataset von Seaborn—du kannst die CSV-Datei direkt von meinem GitHub herunterladen.
Sobald du dich in der Snowflake-App angemeldet hast, folge dem GIF unten, um das Dataset in eine neue Datenbanktabelle zu laden (erstelle ein neues Konto, falls du noch keines hast):
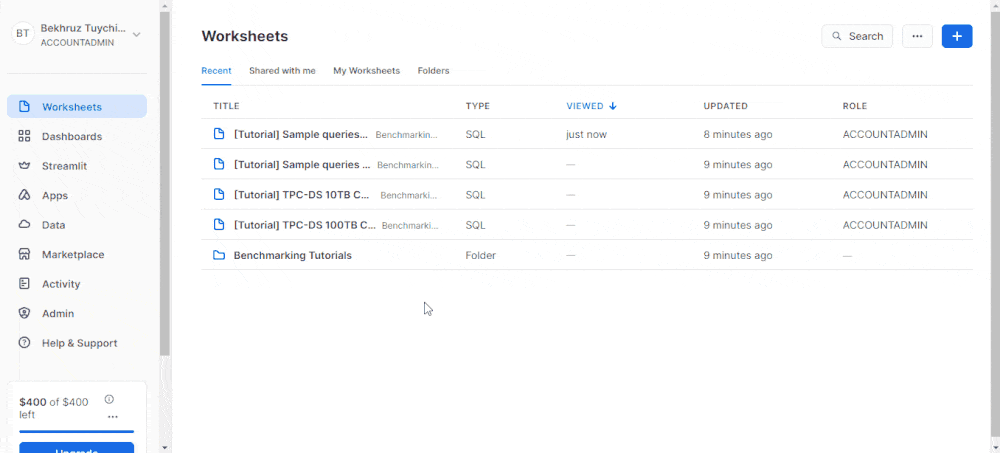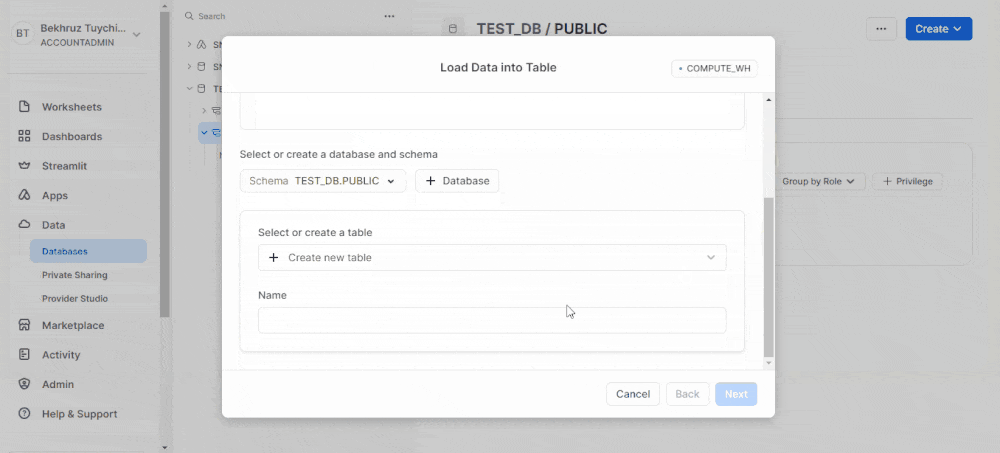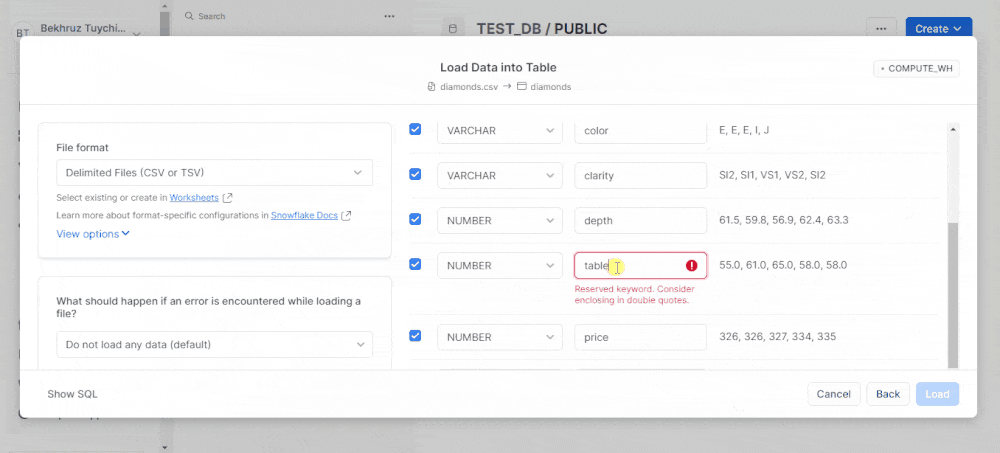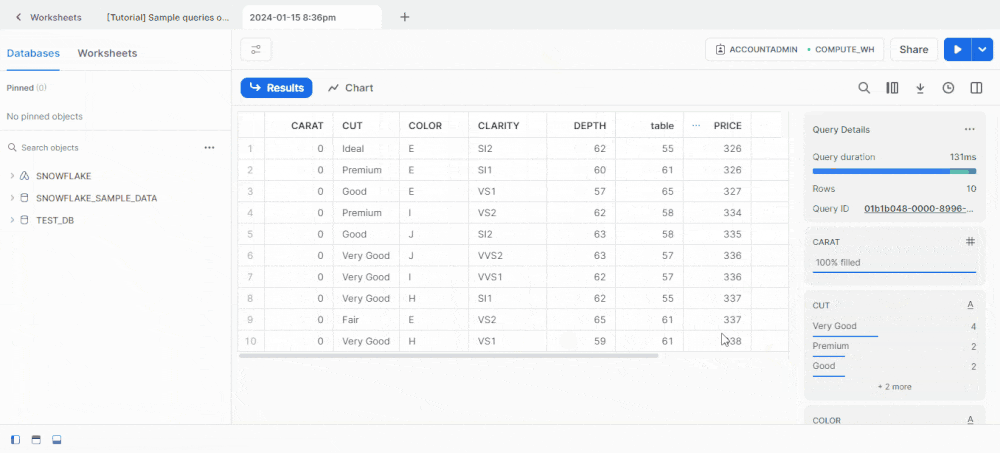
In der Praxis importierst du nur selten CSV-Dateien als Tabellen in deine Snowflake-Datenbanken. Meist arbeitest du mit bestehenden Datenbanken, für die dir die Datenbank-Admins deines Unternehmens unterschiedliche Zugriffsrechte vergeben.
Jetzt müssen wir eine Verbindung zwischen der Snowpark-API und der Snowflake-Cloud herstellen, um unsere Datenbank zu abzufragen. Dafür sind folgende Snowflake-Zugangsdaten erforderlich: Account-Name, Benutzername und Passwort.
Im Bild unten siehst du, wie du Benutzername und Account-Namen im Snowflake-Dashboard findest:
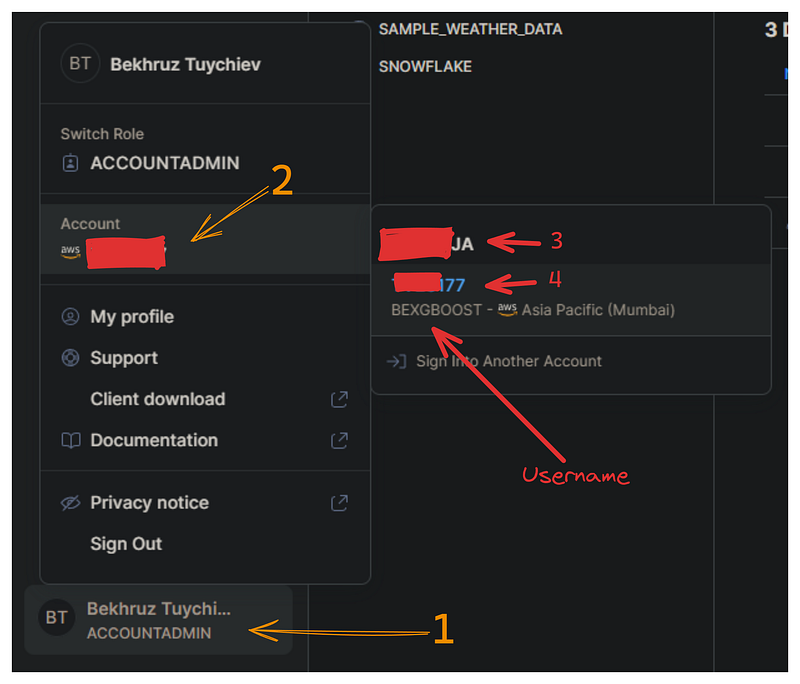
Erstelle eine separate Datei namens config.py, die ein einzelnes Dictionary credentials im folgenden Format enthält:
credentials = (
   {
       "account": "3-4",  # Combine 3 and 4 with a hyphen
       "username": "bexgboost",  # Your username in lowercase
       "password": "your_password",  # Your Snowflake password
   },
)
Aus Sicherheitsgründen speichern wir Zugangsdaten in einer separaten Datei. Wenn du diese Datei in .gitignore aufnimmst, vermeidest du, dass deine Snowflake-Credentials versehentlich veröffentlicht werden.
Nun importieren wir das credentials-Dictionary und die Klasse Session von Snowpark:
from config import credentials
from snowflake.snowpark import Session
Für die Verbindung nutzen wir die Methode Session.builder.configs.create():
connection_parameters = {
   "account": credentials["account"],
   "user": credentials["username"],
   "password": credentials["password"],
}

new_session = Session.builder.configs(connection_parameters).create()
new_session.get_current_user()'"bexgboost"'Wenn dein Benutzername ausgegeben wird, ist deine erste Session erfolgreich erstellt!
Das Objekt new_session hat Zugriff auf alles, was deinem Account in Snowflake gehört (und wofür du Berechtigungen hast).
Bevor wir Daten laden, sagen wir der Session, dass wir die zuvor erstellte Datenbank test_db verwenden:
new_session.sql("USE DATABASE test_db;").collect()[Row(status='Statement executed successfully.')]Dazu verwenden wir die Methode .sql, mit der wir jede Snowflake-SQL-kompatible Abfrage ausführen können.
Nun können wir die Tabelle diamonds aus test_db über die table-Methode des Session-Objekts laden:
diamonds_df = new_session.table("diamonds")
diamonds_df.show(5)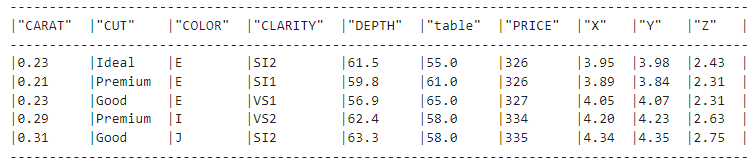
Die Methode .show() entspricht grob DataFrame.describe() in Pandas und zeigt uns, dass die Verbindung zur Tabelle steht.
Genau—wir haben nur eine Verbindung zur Tabelle hergestellt. Das Objekt diamonds_df hält keine Daten, was seine Größe belegt:
import sys
sys.getsizeof(diamonds_df)48Es sind nur 48 Bytes, obwohl es eigentlich über 3 MB sein müssten. Schauen wir uns kurz an, warum das so ist.
Bisher haben wir Folgendes erledigt:
Jetzt sprechen wir über Snowpark DataFrames!
Pandas DataFrames nutzen deinen RAM, sie leben also auf deiner Maschine. Snowpark DataFrames dagegen leben in der Cloud-Plattform von Snowflake, auch wenn du ihre Repräsentation in deiner Entwicklungsumgebung siehst. Die Daten bleiben in der Cloud und müssen für Operationen nicht lokal heruntergeladen werden.
Ein weiterer wichtiger Punkt: Snowpark DataFrames arbeiten lazy. Das heißt, sie führen keine Operationen auf den Daten aus, bis du sie explizit dazu aufforderst.
Stattdessen bauen sie eine logische Darstellung der gewünschten Operationen auf, die dann in optimierte SQL-Queries übersetzt werden, die Snowflake ausführt.
Im Vergleich dazu führt Pandas Operationen sofort aus—also eager.
Leistungstechnisch ist Lazy Evaluation in der Regel deutlich schneller als Eager Execution. Da lazy DataFrames die leistungsfähigen elastischen Compute-Ressourcen von Snowflake nutzen, können sie Operationen bis auf Datenbankebene pushen und wesentlich schneller ausführen.
Um den Unterschied zwischen Lazy Evaluation und Eager Execution greifbar zu machen, stell dir unsere Daten in Snowflake als riesige Bibliothek vor. Es gibt zwei Szenarien:
Da Snowpark in Pandas DataFrames konvertieren kann: Wann nutzt man was?
pandas_diamonds = diamonds_df.to_pandas()
pandas_diamonds.head()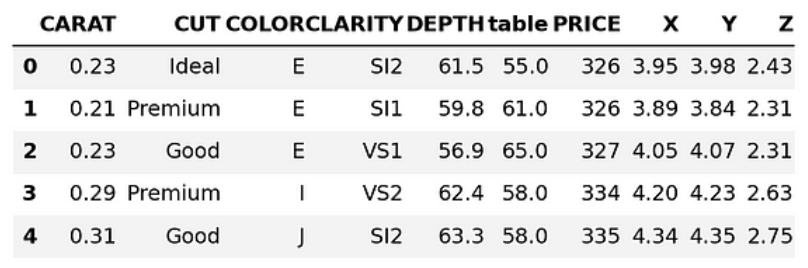
Die Antwort hängt stark von der Datengröße ab.
Ist dein Dataset klein (wie das Diamonds-Dataset), kannst du es problemlos lokal herunterladen und mit Pandas verarbeiten (genau das macht DataFrame.to_pandas()).
Bei heutigen Datengrößen gerät das aber schnell aus dem Ruder, und du wartest im Zweifel Stunden auf den Download. Und denk daran: Es ist ein Hin- und Rückweg—neue Ergebnisse, die du behalten willst, müssen wieder zurück in die Datenbank. Genau deshalb lohnt es sich, die Snowpark-DataFrame-API zu beherrschen.
Alternativ erlaubt dir die Methode Session.sql(), jede mit Snowflake kompatible SQL-Anweisung auszuführen (siehe Beispiel unten). Ich empfehle dir aber klar, die Snowpark-DataFrame-API zu meistern—sie bringt für über 100 SQL-Funktionen eigene Helfer mit.
result = new_session.sql(
   """
   SELECT PRICE, CUT FROM DIAMONDS LIMIT 10
"""
)

type(result)
snowflake.snowpark.dataframe.DataFrameresult.show()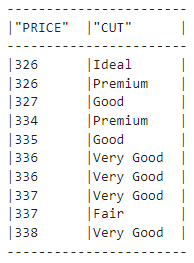
Du wirst viel Zeit mit den Transformationsfunktionen von Snowpark verbringen. Sie sind im folgenden Submodul verfügbar:
# Die gängige Abkürzung ist F
import snowflake.snowpark.functions as F
Alle Funktionen unter F (auflistbar mit dir(F)) beschreiben, wie ein DataFrame transformiert werden soll. Ein Beispiel:
F.upper(F.col("CUT"))Hier erzeugt die Funktion col eine Referenz auf die angegebene Spalte und gibt ein Column-Objekt zurück. Danach wandelt .upper() die Werte der Spalte CUT in Großbuchstaben um:
diamonds_df.show(5)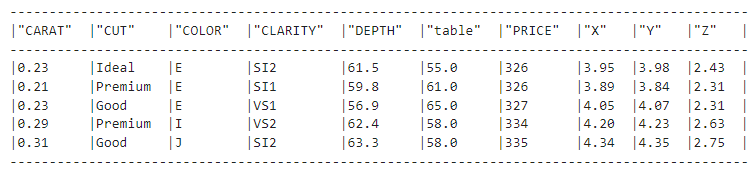
Schauen wir ins Dataset, sehen wir, dass die Werte in CUT immer noch Kleinbuchstaben enthalten. Warum? Nun, der Ausdruck F.upper(F.col("CUT")) entspricht folgender SQL-Abfrage:
SELECT UPPER(CUT);Was fehlt?
Klar, die FROM-Klausel, die die Tabelle angibt, auf die die Transformation angewandt werden soll!
Wir müssen den Ausdruck F.upper(F.col("CUT")) also mit dem Objekt diamonds_df kombinieren. Das geht im Wesentlichen auf drei Arten:
.select() übergeben.filter() übergeben.with_column() übergebenDa unser Ausdruck eine Spalte transformiert, übergeben wir ihn an .select():
our_expression = F.upper(F.col("CUT"))
diamonds_df.select(our_expression).show()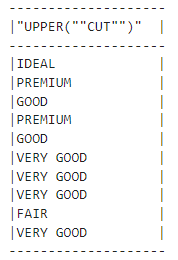
Die Werte sind erfolgreich geändert!
Schreiben wir nun einen Ausdruck, der Zeilen filtert:
diamonds_df.filter(F.col("PRICE") > 10000).count()5222Es gibt also über 5.000 Diamanten im Dataset, die mehr als 10.000 $ kosten. Erstellen wir auch noch eine neue Spalte:
(
diamonds_df.with_column("PRICE_SQUARED", F.col("PRICE") ** 2)
.select("PRICE", "PRICE_SQUARED")
.show(5)
)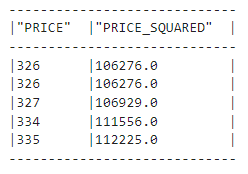
Oben siehst du, dass auch Method Chaining möglich ist—wir haben eine neue Spalte namens „PRICE_SQUARED“. Du merkst: Die Funktionen der Snowpark DataFrames sind denen von Pandas sehr ähnlich.
Kurzum: Suchst du das Snowpark-Pendant zu einer Pandas-Funktion, findest du es entweder unter F oder als Methode der Snowpark DataFrames. Du kannst das mit dir(F) oder dir(diamonds_df) prüfen oder im Snowpark-Python-Referenzhandbuch nachlesen.
Ein großer Teil der explorativen Datenanalyse (EDA) sind Visualisierungen. Zum Glück brauchen wir dafür Snowpark nicht—wir können bei unserem modernen Python-Stack bleiben.
Die Idee: Da EDA vor allem allgemeine Trends und Einsichten aufzeigt, reicht oft eine Stichprobe statt des gesamten Datasets. Eine repräsentative Stichprobe können wir herunterladen, in einen Pandas DataFrame konvertieren und mit Matplotlib oder Seaborn visualisieren.
Starten wir mit der Konvertierung:
sample = diamonds_df.sample(0.25).to_pandas()
sample.head()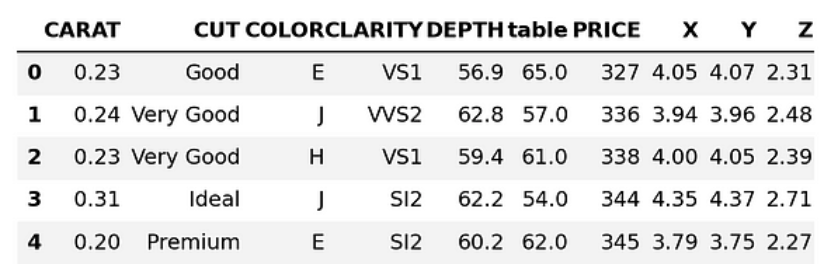
Oben laden wir 25% des Datasets als Pandas DataFrame herunter. Konvertieren wir die Spaltennamen in Kleinbuchstaben:
sample.columns = [col.lower() for col in sample.columns]
sample.columns
Index(['carat', 'cut', 'color', 'clarity', 'depth', 'table', 'price', 'x', 'y', 'z'], dtype='object')Jetzt kannst du EDA wie gewohnt durchführen. Unten einige Ideen—beginnen wir mit einem Scatterplot für den Zusammenhang zwischen Preis und Karat:
#Remember we imported seaborn as sns
sns.scatterplot(data=sample, x="price", y="carat", s=1)
plt.title("Diamond prices vs. carat")
plt.show()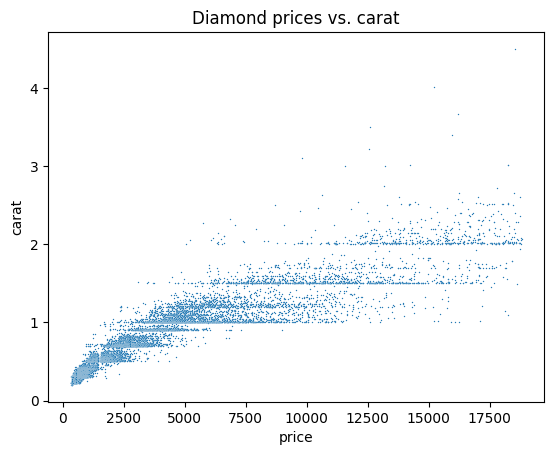
Als Nächstes zeichnen wir eine Korrelationsmatrix, um die Zusammenhänge zwischen allen numerischen Merkmalen zu sehen:
corr_matrix = sample.corr(numeric_only=True)
sns.heatmap(corr_matrix, center=0, square=True, annot=True
plt.title("The correlation matrix of Diamond numeric features")
plt.show()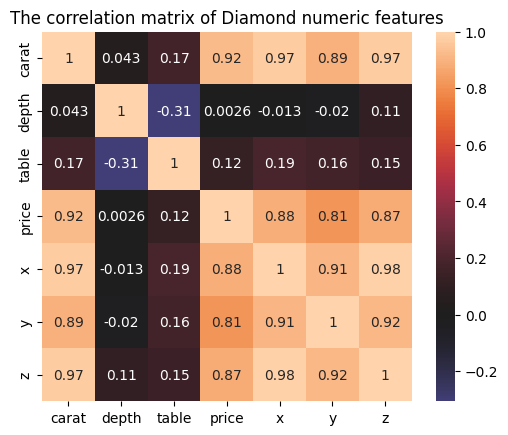
Wir können auch ein Balkendiagramm der Diamant-Schliffkategorien erstellen:
cut_counts = sample.groupby("cut")["cut"].count()
cut_counts.plot(kind="bar")
plt.title("Category counts of diamond cuts")
plt.xlabel("Diamond cut")
plt.show()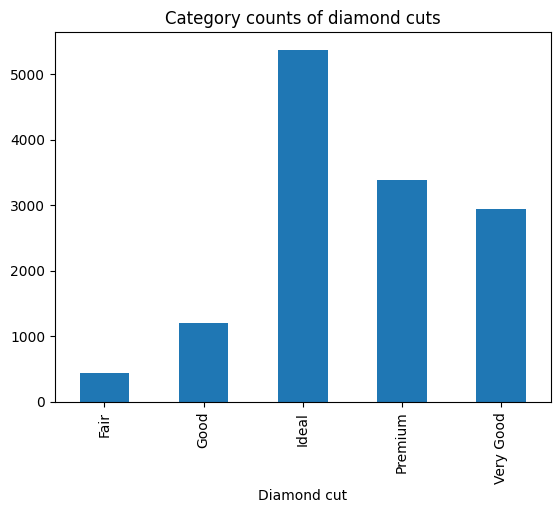
Um zu bestätigen, dass die Plots auf dem Gesamtdatensatz ähnlich aussehen, führen wir die SQL-Variante des obigen Balkendiagramms aus.
Zuerst schreiben wir eine SQL-Abfrage, die das Diamonds-Dataset nach CUT gruppiert:
result = new_session.sql(
   """
   SELECT cut, COUNT(*) AS count
     FROM diamonds
    GROUP BY cut;
"""
)
Konvertieren und laden wir das Ergebnis als Pandas DataFrame herunter:
result_pd = result.to_pandas()
result_pd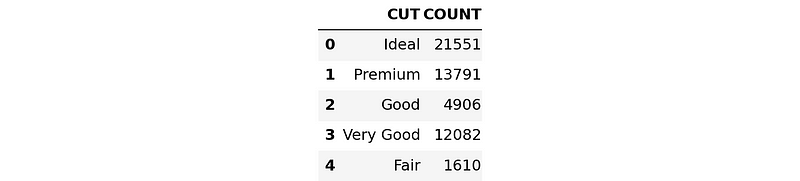
Diesmal verwenden wir plt.bar(), um den Graphen zu zeichnen:
plt.bar(x=result_pd["CUT"], height=result_pd["COUNT"])
plt.show()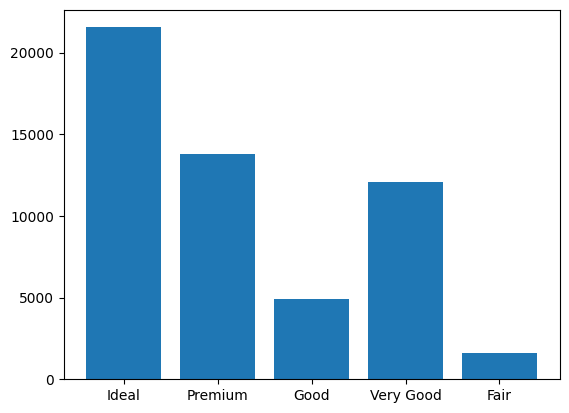
Die Reihenfolge der Balken unterscheidet sich, aber nebeneinander betrachtet vermitteln beide Diagramme dieselbe Aussage.
Jetzt lernen wir, wie man in Snowpark Machine-Learning-Modelle trainiert!
Wir beginnen mit der Datenbereinigung.
Stellen wir zuerst sicher, dass alle Spalten den korrekten Datentyp haben:
list(diamonds_df.schema)[StructField('CARAT', DecimalType(38, 2), nullable=True),
StructField('CUT', StringType(16777216), nullable=True),
StructField('COLOR', StringType(16777216), nullable=True),
StructField('CLARITY', StringType(16777216), nullable=True),
StructField('DEPTH', DecimalType(38, 1), nullable=True),
StructField('"table"', DecimalType(38, 1), nullable=True),
StructField('PRICE', LongType(), nullable=True),
StructField('X', DecimalType(38, 2), nullable=True),
StructField('Y', DecimalType(38, 2), nullable=True),
StructField('Z', DecimalType(38, 2), nullable=True)]Die Spalte table hat einen unglücklichen Namen, daher benennen wir sie in TABLE_ um (mit Unterstrich am Ende, damit es nicht mit einem SQL-Schlüsselwort kollidiert):
diamonds_df = diamonds_df.with_column_renamed('"table"', "TABLE_")
diamonds_df.columns
['CARAT', 'CUT', 'COLOR', 'CLARITY', 'DEPTH', 'TABLE_', 'PRICE', 'X', 'Y', 'Z']Wir müssen die Datentypen der numerischen Merkmale von DecimalType auf DoubleType umstellen, da Dezimalzahlen in Snowpark derzeit noch nicht unterstützt werden.
from snowflake.snowpark.types import DoubleType

numeric_features = ["CARAT", "X", "Y", "Z", "DEPTH", "TABLE_"]
for col in numeric_features:
   diamonds_df = diamonds_df.with_column(col, diamonds_df[col].cast(DoubleType()))

list(diamonds_df.select(*numeric_features))
[Column("CARAT"),
Column("X"),
Column("Y"),
Column("Z"),
Column("DEPTH"),
Column("TABLE_")]Im Snippet oben verwenden wir erneut .with_column(). Neu ist .cast(), eine Methode der Snowpark DataFrames.
Snowpark verlangt außerdem, dass alle Textmerkmale vor dem Encoding in Großbuchstaben stehen und keine Leerzeichen enthalten. Aktuell verletzt das Merkmal CUT diese Anforderung. Wir beheben das mit Funktions-Transformationen:
import snowflake.snowpark.functions as F

def remove_space_and_upper(df):
   df = df.with_column("CUT", F.upper(F.replace(F.col("CUT"), " ", "_")))

   return df

diamonds_df = remove_space_and_upper(diamonds_df)
Unsere Daten sind nun bereinigt. Wir können sie als neue Tabelle in Snowflake speichern:
diamonds_df.write.mode("overwrite").save_as_table("diamonds_cleaned")Stelle den Modus overwrite ein, denn möglicherweise passt du die Bereinigung später an und speicherst erneut.
In diesem Abschnitt kümmern wir uns um verbleibende Vorverarbeitungsschritte, die das Training behindern könnten. Laden wir die bereinigte Tabelle:
clean_df = new_session.table("diamonds_cleaned")
clean_df.show()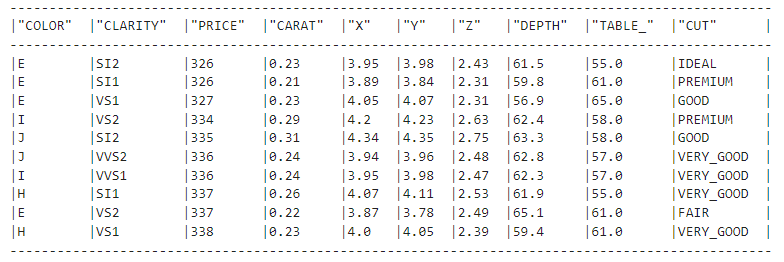
Sehr gut!
Als Nächstes importieren wir die Submodule preprocessing und pipeline aus dem Namespace snowflake.ml.
import snowflake.ml.modeling.preprocessing as snowml
from snowflake.ml.modeling.pipeline import Pipeline
Während die DataFrame-API von Snowpark unter snowflake.snowpark liegt, findest du die Snowpark-ML-Module unter snowflake.ml. Das ist anfangs ungewohnt—nimm dir Zeit, dich daran zu gewöhnen.
Im folgenden Code:
# List all the features for processing
cat_cols = ["CUT", "COLOR", "CLARITY"]
cat_cols_encoded = ["CUT_OE", "COLOR_OE", "CLARITY_OE"]

# We already have numeric_features

# List the correct ordering of categorical features
categories = {
   "CUT": np.array(["IDEAL", "PREMIUM", "VERY_GOOD", "GOOD", "FAIR"]),
   "CLARITY": np.array(
       ["IF", "VVS1", "VVS2", "VS1", "VS2", "SI1", "SI2", "I1", "I2", "I3"]
   ),
   "COLOR": np.array(["D", "E", "F", "G", "H", "I", "J"]),
}
Jetzt bauen wir eine Pipeline, ähnlich zu Scikit-learn:
# Build the pipeline
preprocessing_pipeline = Pipeline(
   steps=[
       (
           "OE",
           snowml.OrdinalEncoder(
               input_cols=cat_cols, output_cols=cat_cols_encoded, categories=categories
           ),
       ),
       (
           "SS",
           snowml.StandardScaler(
               input_cols=numeric_features, output_cols=numeric_features
           ),
       ),
   ]
)
Die Klasse Pipeline akzeptiert eine Liste von Schritten, jeweils eine Preprocessing-Klasse. Hier encodieren wir mit OrdinalEncoder kategoriale Features als 0, 1, 2, … und normalisieren mit StandardScaler die numerischen Features.
Zum Schluss speichern wir die Pipeline lokal mit joblib und testen sie auf dem gesamten Dataset:
import joblib
PIPELINE_FILE = "pipeline.joblib"

# Pickle locally first
joblib.dump(preprocessing_pipeline, PIPELINE_FILE)

transformed_diamonds_df = preprocessing_pipeline.fit(clean_df).transform(clean_df)

# transformed_diamonds_df.show() - commented because of long output
Der Code läuft fehlerfrei—unsere Pipeline funktioniert. Zeit, ein Modell zu trainieren.
Zum Trainieren listen wir noch einmal die Feature- und Zielspalten auf:
# Define the columns again
cat_cols_encoded = ["CUT_OE", "COLOR_OE", "CLARITY_OE"]
numeric_features = ["CARAT", "X", "Y", "Z", "DEPTH", "TABLE_"]

label_cols = ["PRICE"]  # Must be a list
output_cols = ["PRICE_PREDICTED"]  # Required in snowpark
Wir splitten die Daten mit DataFrame.random_split() und geben Gewichte für Trainings- und Testanteil an:
# Split the data
train_df, test_df = diamonds_df.random_split(weights=[0.8, 0.2], seed=42)
Dann laden wir die Pipeline und führen Fit-Transform auf Train und nur Transform auf Test aus.
# Load the pre-processing pipeline locally
pipeline = joblib.load("pipeline.joblib")

# Apply it to both dataframes
train_df_transformed = pipeline.fit(train_df).transform(train_df)
test_df_transformed = pipeline.transform(test_df)
Achte darauf, beim Testset nur .transform() aufzurufen, um Data Leakage zu vermeiden.
Als Nächstes initialisieren wir einen XGBoost-Regressor aus dem ml.modeling.xgboost-Submodul:
# Snowpark has models from scikit-learn and lightgbm too
from snowflake.ml.modeling.xgboost import XGBRegressor

# Initialize
regressor = XGBRegressor(
   input_cols=cat_cols_encoded + numeric_features,
   label_cols=label_cols,
   output_cols=output_cols,
)
Die Klasse XGBRegressor benötigt alle Eingabespalten, die Zielspalten und die Namen der Ausgabespalten. Danach starten wir mit .fit() das Training:
# Train
regressor.fit(train_df_transformed)
Das Training kann auf einem kostenlosen Snowflake-Account ohne GPU etwas dauern.
Nach dem Training generieren wir Vorhersagen:
# Predict
train_preds = regressor.predict(train_df_transformed)
test_preds = regressor.predict(test_df_transformed)
Werfen wir einen Blick auf die Vorhersagen:
train_preds.select("PRICE", "PRICE_PREDICTED").show(5)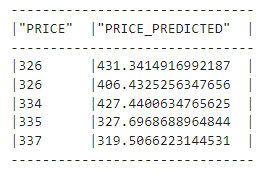
Jetzt messen wir die Qualität unseres ersten Modells. Snowpark bringt dutzende Metriken aus Scikit-learn unter dem Submodul ml.modeling.metrics mit, das wir als M importieren:
import snowflake.ml.modeling.metrics as MDann berechnen wir zweimal mean_squared_error, um die Root Mean Squared Error (RMSE) für Train und Test zu messen (squared=False liefert RMSE statt MSE):
rmse_train = M.mean_squared_error(
   df=train_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

rmse_test = M.mean_squared_error(
   df=test_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

print(f"Train RMSE score for XGBRegressor: {rmse_train:.4f}")
print(f"Test RMSE score for XGBRegressor: {rmse_test:.4f}")
Train RMSE score for XGBRegressor: 371.9664
Test RMSE score for XGBRegressor: 542.1566Unser Modell liegt im Schnitt um 542 $ daneben und überfittet möglicherweise, denn die Differenz zwischen Train- und Test-RMSE ist groß.
Lass uns die Hyperparameter optimieren, um das zu adressieren.
Aktuell bietet Snowpark zwei Klassen für Hyperparameter-Tuning:
GridSearchCV: Exhaustive Search aller Hyperparameter-Kombinationen mit Cross-Validation.RandomizedSearchCV: Zufällige Suche über definierte Verteilungen mit Cross-Validation.XGBoost hat rund ein Dutzend Hyperparameter, die die Performance verbessern können (mehr dazu im Tutorial XGBoost in Python). Daher bietet sich eine Randomized Search an. Persönlich würde ich Optuna für Bayes’sche Optimierung bevorzugen—das steht in Snowpark derzeit noch nicht zur Verfügung.
Definieren wir nun die Suche:
from snowflake.ml.modeling.model_selection import RandomizedSearchCV

rscv = RandomizedSearchCV(
   estimator=XGBRegressor(),
   param_distributions={
       "n_estimators": [2000],
       "max_depth": list(range(3, 13)),
       "learning_rate": np.linspace(0.1, 0.5, num=10),
   },
   n_jobs=-1,
   scoring="neg_mean_squared_error",
   input_cols=numeric_features + cat_cols_encoded,
   label_cols=label_cols,
   output_cols=output_cols,
   n_iter=10,
)

rscv.fit(train_df_transformed)
Wir fixieren die Anzahl der Bäume auf 2000 und tunen nur max_depth und learning_rate. Der Standard für n_iter ist 10, d. h. es werden 10 zufällige Kombinationen getestet. Für genauere Ergebnisse sollte dieser Wert höher sein.
Messen wir nun die Performance des besten Modells. Der Code ist derselbe wie zuvor, nur verwenden wir statt regressor das Objekt rscv:
# Predict
train_preds = rscv.predict(train_df_transformed)
test_preds = rscv.predict(test_df_transformed)
rmse_train = M.mean_squared_error(
   df=train_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

optimal_rmse_test = M.mean_squared_error(
   df=test_preds,
   y_true_col_names=label_cols,
   y_pred_col_names=output_cols,
   squared=False,
)

print(f"Train RMSE score for optimal model: {rmse_train:.4f}")
print(f"Test RMSE score for optimal model: {rmse_test:.4f}")
Train RMSE score for optimal model: 224.2405
Test RMSE score for optimal model: 572.0517Der Trainings-RMSE ist gesunken, der Test-RMSE jedoch gestiegen. Wir überfitten also weiterhin und sollten die Suche ausweiten und zusätzliche Parameter einbeziehen, um die Entscheidungsbäume von XGBoost zu beschneiden.
Diesen Teil übergebe ich an dich.
Wenn wir die Session jetzt schließen, geht unser getuntes Modell verloren. Zum Speichern nutzen wir das native Model Registry von Snowpark—einen virtuellen Speicher für Modelle samt Metadaten.
Das Registry ist als Klasse Registry verfügbar und benötigt den Namen der aktuellen Datenbank und des Schemas der Session. Außerdem braucht es einen Projektnamen, damit es keine Konflikte mit Modellen anderer Projekte gibt:
# Set up for Registry
from snowflake.ml.registry import Registry

# Get the current db and schema name
db_name = new_session.get_current_database()
schema_name = new_session.get_current_schema()

# Define global model name for the project
model_name = "diamond_prices_regression"

# Initialize a registry to log models
registry = Registry(session=new_session, database_name=db_name, schema_name=schema_name)
Zum Speichern verwenden wir die Methode Registry.log_model():
# Get sample data to pass into registry for schema
sample = train_df.select(cat_cols_encoded + numeric_features).limit(50)

# Log the first model
v0 = registry.log_model(
   model_name=model_name,
   version_name="v0",
   model=regressor,
   sample_input_data=sample,
)
Wir können mit .set_metric() eine Metrik für das Modell hinterlegen (beliebig viele). Zudem fügen wir einen Kommentar hinzu:
# Add the models RMSE score
v0.set_metric(metric_name="RMSE", value=rmse_test)

# Add a description
v0.comment = "The first model to predict diamond prices"
Dasselbe machen wir für das beste Modell aus der Randomized Search. Beim Setzen der Metrik nicht vergessen, den Wert auf optimal_rmse_test zu setzen.
# Log the optimal model
v1 = registry.log_model(
   model_name=model_name,
   version_name="v1",
   model=regressor,
   sample_input_data=sample,
)

# Add the models RMSE score
v1.set_metric(metric_name="RMSE", value=optimal_rmse_test)

# Add a description
v1.comment = "Optimal model found with RandomizedSearchCV"
Um zu prüfen, ob die Modelle gespeichert sind, rufe .show_models() auf:
# Confirm the models are added
registry.show_models()
Mehr zur Verwaltung des Registrys findest du in dieser Dokumentation.
Für Inference wählst du üblicherweise das beste Modell aus deinem Registry. Das geht, indem du das Ergebnis von .show_models() filterst oder das Modell direkt über sein Version-Tag holst, wie unten:
# Doing inference with the optimal model
optimal_version = registry.get_model(model_name).version("v1")
results = optimal_version.run(test_df, function_name="predict")

results.columns
Die Methode get_model() gibt ein generisches model-Objekt zurück, das sich von XGBRegressor unterscheidet. Deshalb musst du für Inference .run() mit dem Funktionsnamen aufrufen.
In diesem Tutorial haben wir ein End-to-End-Vorgehen zum Trainieren von Machine-Learning-Modellen in Snowflake Snowpark behandelt. Stark gemacht!
Wir sind mit einem unbereinigten Roh-Dataset gestartet und bei einem getunten XGBoost-Regressor gelandet. Alles lief in Snowflake Cloud—wir mussten keine lokalen Ressourcen einsetzen.
Wir haben gesehen, wie effektiv solche In-Database-Workflows bei großen Datasets sind—und dass Snowflake Snowpark eines der besten Tools ist, um genau das zu ermöglichen.
Wenn du mehr über Snowpark oder Snowflake lernen willst, schau dir diese Ressourcen an:
Danke fürs Lesen!
Erfahre mehr über Snowflake und Big Data!
Kurs
Lernpfad
Kurs