
Last chance! 50% off DataCamp Premium
Sale ends in
Het rekenkundig gemiddelde, vaak gewoon het "gemiddelde" genoemd, is vaak het startpunt in de beschrijvende statistiek. Het biedt een snelle, intuïtieve maat voor centrale tendens, een essentieel onderdeel van het interpreteren van data in elk vakgebied. Hoewel het concept eenvoudig lijkt, kan inzicht in de nuances van het rekenkundig gemiddelde echte inzichten onthullen in complexere datatrends en -patronen.
Dit artikel geeft een overzicht van het rekenkundig gemiddelde, inclusief de formule, toepassingen en vergelijkingen met andere soorten gemiddelden. We bekijken waarom het vaak wordt gebruikt in economie, data science en daarbuiten, en bespreken ook situaties waarin alternatieve maten geschikter kunnen zijn.
Voor wie nieuw is met statistiek of zijn begrip wil versterken, biedt onze cursus Introduction to Statistics een stevige basis. Onze Descriptive Statistics Cheat Sheet bevat ook een handige begrippenlijst bij dit onderwerp.
Het rekenkundig gemiddelde is de som van alle getallen in een dataset gedeeld door het aantal van die getallen. Deze eenvoudige berekening maakt het tot een van de meest intuïtieve en breed toegepaste maten van centrale tendens.
Ter illustratie nemen we een eenvoudig voorbeeld. Stel, we hebben drie getallen: 5, 10 en 15. Zo bereken je het rekenkundig gemiddelde:
Het rekenkundig gemiddelde van 5, 10 en 15 is dus 10.
Het rekenkundig gemiddelde heeft verschillende belangrijke eigenschappen die bij nadere beschouwing nog interessanter worden.
Een fundamentele eigenschap van het rekenkundig gemiddelde is dat de som van de afwijkingen ervan altijd nul is. Met andere woorden: als je van elk datapunt de gemiddelde waarde aftrekt en deze verschillen optelt, is de uitkomst nul. Wiskundig kun je dit als volgt uitdrukken:
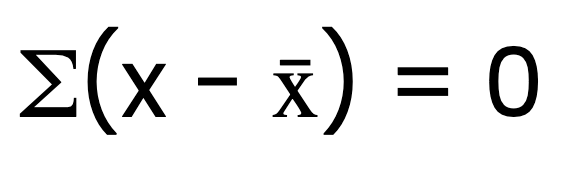
Waarbij x elk waarde in de dataset voorstelt, en x̄ het rekenkundig gemiddelde is.
In datasets met extreme waarden kan het rekenkundig gemiddelde aanzienlijk in de richting van deze uitschieters worden getrokken, wat kan leiden tot misleidende interpretaties, vooral bij scheve verdelingen. Neem bijvoorbeeld een dataset met salarissen in een klein bedrijf: {$30,000, $35,000, $40,000, $45,000, $1,000,000}. Het rekenkundig gemiddelde ($230,000) ligt door de uitschieter van $1,000,000 aanzienlijk hoger dan de meeste salarissen.
Deze gevoeligheid maakt het rekenkundig gemiddelde minder robuust dan maten zoals de mediaan in de aanwezigheid van uitschieters of bij scheve verdelingen. Tegelijk kan het gemiddelde juist nuttig zijn om de aanwezigheid van uitschieters te detecteren of het effect van extreme waarden op een dataset te begrijpen.
Het rekenkundig gemiddelde reageert voorspelbaar op veranderingen in de dataset, wat nuttig kan zijn in uiteenlopende analysecases:
Deze eigenschappen maken het rekenkundig gemiddelde bijzonder nuttig in situaties met uniforme veranderingen in een dataset, zoals het corrigeren voor inflatie in economische data of het schalen van metingen in wetenschappelijke experimenten.
Het rekenkundig gemiddelde is een veelzijdig statistisch hulpmiddel, maar komt vooral tot zijn recht in bepaalde situaties. Allereerst moeten we zeggen dat het rekenkundig gemiddelde bijzonder nuttig is voor datasets met additieve processen. Als je bijvoorbeeld de gemiddelde dagtemperatuur, het gemiddelde salaris in een bedrijf of gemiddelde testscores berekent, geeft het rekenkundig gemiddelde een zinvolle weergave van de centrale waarde.
Daarnaast is het rekenkundig gemiddelde het meest betrouwbaar wanneer de datapunten gelijkmatig verdeeld zijn en er geen extreme uitschieters zijn. Enkele sectorspecifieke voorbeelden:
Hoewel we het basisconcept al hebben behandeld, bekijken we nu hoe je het rekenkundig gemiddelde berekent met hulpmiddelen zoals R, Python en Excel, wat in de praktijk noodzakelijk is voor grotere datasets.
De formule voor het rekenkundig gemiddelde is:
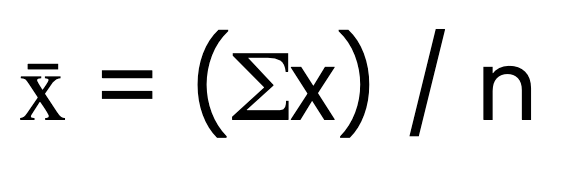
Waarbij x̄ het rekenkundig gemiddelde is, Σx de som van alle waarden, en n het aantal waarden.
Voor grotere datasets maken softwaretools de berekening veel eenvoudiger. Zo bereken je het rekenkundig gemiddelde in Excel, Python en R.
In Excel kun je de functie AVERAGE() gebruiken:
Voer je data in een kolom of rij in.
Typ in een nieuwe cel =AVERAGE().
Selecteer het bereik met je data.
Sluit de haakjes en druk op Enter.
Als je data in de cellen A1:A10 staat, gebruik je: =AVERAGE(A1:A10).
De statistics-module van Python biedt een functie mean():
from statistics import mean

data = [5, 10, 15, 20, 25]

result = mean(data)
print(result)  # Output: 15
Voor grotere datasets geef je misschien de voorkeur aan de efficiëntere mean()-functie van NumPy:
import numpy as np

data = np.array([5, 10, 15])

result = np.mean(data)
print(result) # Output: 10.0In R kun je de ingebouwde functie mean() uit base R gebruiken:
data <- c(5, 10, 15)

result <- mean(data)
print(result)  # Output: [1] 10
Met deze tools bereken je het rekenkundig gemiddelde voor datasets van elke omvang in een handomdraai, zodat je je kunt richten op de interpretatie in plaats van op handmatige berekeningen.
De toepassingen van het rekenkundig gemiddelde in data science en machine learning lopen uiteen van datapreprocessing tot model-evaluatie. We bekijken enkele belangrijke gebieden waar het rekenkundig gemiddelde een grote rol speelt.
Een van de meest voorkomende toepassingen van het rekenkundig gemiddelde in datapreprocessing is feature scaling, met name mean centering:
Mean centering: hierbij trek je het rekenkundig gemiddelde van elk datapunt in een feature af. Het resultaat is een gecentreerde dataset waarbij het gemiddelde van elke feature nul is. Dit kan worden weergegeven als: x_centered = x - x̄ waarbij x de oorspronkelijke waarde is en x̄ het rekenkundig gemiddelde van de feature.
Standaardisatie: Vaak in combinatie met mean centering deel je na het aftrekken van het gemiddelde door de standaarddeviatie: x_standardized = (x - x̄) / σ, waarbij σ de standaarddeviatie van de feature is.
Deze technieken helpen de schaal van features te normaliseren, wat bijzonder belangrijk is voor veel machinelearning-algoritmen. Wil je meer leren over het verschil tussen normalisatie en standaardisatie, bekijk dan de uitgebreide tutorial.
Het rekenkundig gemiddelde vormt de basis van diverse metrics voor model-evaluatie:
In statistische analyses wordt het rekenkundig gemiddelde vaak gebruikt bij hypothesetoetsing. Bijvoorbeeld:
Zoals je wellicht merkt, is het rekenkundig gemiddelde belangrijk zowel voor het interpreteren van de output van de data als vaak ook als een preprocessing-stap die nodig is voor optimale modelprestaties. Wil je deze concepten en hun praktische toepassingen verder uitdiepen, overweeg dan onze Machine Learning Scientist in Python career track, waarin deze onderwerpen grondiger aan bod komen.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


