
Curso
Feature Engineering para NLP em Python
4 h
29.7K
O Processamento de Linguagem Natural (NLP) é um pilar da IA moderna, permitindo que máquinas entendam e respondam à linguagem humana. À medida que as interações digitais se multiplicam, a importância de NLP só cresce. O PyTorch, uma biblioteca open-source popular de machine learning, oferece ferramentas robustas para tarefas de NLP graças à sua flexibilidade e computação eficiente com tensores. Seu grafo computacional dinâmico também facilita modificar e construir modelos complexos, o que o torna ideal para nosso tutorial.
Se você quer aprender mais sobre NLP, confira nossa trilha de habilidades Natural Language Processing in Python; ou, se preferir aprender NLP em R, veja o curso Introduction to Natural Language Processing in R na DataCamp.
Configurar o ambiente do PyTorch pode ser desafiador em alguns casos por fatores como sistema operacional, gerenciador de pacotes, linguagem de programação e plataforma de computação. O processo de instalação pode variar de acordo com esses fatores, exigindo que você execute comandos específicos.
Para obter o comando de instalação adequado, acesse a página oficial de get started do PyTorch, selecione suas preferências e siga as instruções indicadas.

Usaremos o DataLab neste tutorial. O código completo para treinar um modelo de análise de sentimento com PyTorch está disponível neste workbook do DataLab para você acompanhar.

Tensores são estruturas de dados fundamentais em matemática e física que generalizam escalares, vetores e matrizes. Eles são arrays multidimensionais capazes de armazenar e manipular grandes volumes de dados numéricos com eficiência. Tensores têm forma, tamanho e tipo de dado definidos, o que os torna versáteis para diversas operações computacionais.
No contexto do PyTorch, tensores são os blocos básicos e os principais objetos de representação de dados. Eles são semelhantes aos arrays do NumPy, mas contam com funcionalidades e otimizações adicionais, pensadas especificamente para computação de deep learning. As operações com tensores no PyTorch aproveitam aceleração por hardware, como GPUs, para computar redes neurais complexas com eficiência.
Tensores têm papel crítico em tarefas de NLP devido à natureza sequencial e hierárquica dos dados de linguagem.
NLP envolve processar e compreender informações textuais. Tensores permitem representar e manipular texto ao codificar palavras, sentenças ou documentos como vetores numéricos.
Essa representação numérica permite que modelos de deep learning processem e aprendam com dados textuais de forma eficaz. Tensores viabilizam lidar com datasets de linguagem em larga escala, facilitam o treinamento de redes neurais e permitem técnicas avançadas como mecanismos de atenção, resultando em modelos de NLP mais precisos.

Word embeddings são representações densas de palavras em um espaço vetorial contínuo. Eles buscam capturar relações semânticas e sintáticas entre palavras, permitindo melhor entendimento e contextualização de dados textuais. Ao representar palavras como vetores numéricos, embeddings capturam similaridades e diferenças semânticas, possibilitando que algoritmos trabalhem com palavras como entradas numéricas cheias de significado.
Em termos simples, embeddings são uma forma inteligente de representar palavras como números. Esses números têm significados que capturam como as palavras se relacionam entre si. É como um código que ajuda computadores a entender e manipular palavras com mais facilidade.
Word2Vec e GloVe são dois métodos populares para gerar embeddings. Word2Vec é um modelo baseado em rede neural que aprende representações de palavras prevendo as palavras ao redor de uma palavra alvo (continuous bag of words - CBOW) ou prevendo a palavra alvo a partir do contexto (skip-gram).
GloVe (Global Vectors for Word Representation) é um método baseado em contagem que constrói vetores a partir das estatísticas de coocorrência de palavras em um grande corpus. Ele captura relações globais entre palavras e frequentemente apresenta melhor desempenho em tarefas de analogia.

Exemplo de arquitetura de modelo para a tarefa de análise de sentimento.
Análise de sentimento é uma tarefa comum em NLP cujo objetivo é entender o sentimento expresso em um texto, geralmente classificado como positivo, negativo ou neutro. Para resolver essa tarefa, pode-se usar uma rede neural recorrente (RNN) simples ou uma versão mais avançada chamada long short-term memory (LSTM).
A arquitetura RNN processa o texto de forma sequencial, inserindo cada palavra uma após a outra. A rede mantém um estado oculto que muda a cada palavra, capturando as informações da sequência já processada.
Esse estado oculto funciona como a memória da rede. No entanto, RNNs padrão têm dificuldade com sequências longas por causa do chamado problema do gradiente que desaparece, em que a contribuição das informações decai geometricamente ao longo do tempo, fazendo a rede “esquecer” entradas anteriores. Você pode saber mais sobre redes neurais recorrentes no nosso tutorial de RNN.
Para lidar com isso, foi desenvolvida a LSTM, uma variante de RNN. Uma LSTM mantém um contexto ou “memória” por mais tempo graças a uma estrutura interna mais complexa no seu estado oculto. Ela tem uma série de “portas” (entrada, esquecimento e saída) que controlam o fluxo de informação de e para o estado de memória.
A porta de entrada define quanto da informação recebida deve ser armazenada. A porta de esquecimento decide o que deve ser descartado, e a porta de saída determina quanto do estado interno é exposto para a próxima unidade LSTM na sequência.
Um modelo RNN ou LSTM recebe como entrada uma sequência de palavras de uma sentença ou documento. Cada palavra é geralmente representada como um vetor denso, ou embedding, que captura seu significado semântico.
A rede processa a sequência palavra a palavra, atualizando seu estado interno com base na palavra atual e no estado anterior.
O estado final da rede é então utilizado para prever o sentimento. Ele passa por uma camada totalmente conectada, seguida de uma função de ativação softmax para produzir uma distribuição de probabilidade sobre as classes de sentimento (por exemplo, positivo, negativo, neutro).
A classe com maior probabilidade é escolhida como a predição do modelo.
Essa é uma configuração básica, que pode ser aprimorada com técnicas como LSTMs bidirecionais (que processam a sequência nos dois sentidos) e mecanismos de atenção (que permitem ao modelo focar nas partes mais importantes da sequência), entre outras.
Exemplo de código Python de ponta a ponta para construir um modelo de análise de sentimento usando PyTorch
Neste exemplo, usaremos o IMDB dataset of 50K Movie reviews. O objetivo é treinar uma LSTM para prever o sentimento. Há dois valores possíveis: “positive” e “negative”. Portanto, é uma tarefa de classificação binária.
file_name = 'IMDB Dataset.csv'
df = pd.read_csv(file_name)
df.head()

X,y = df['review'].values,df['sentiment'].values
x_train,x_test,y_train,y_test = train_test_split(X,y,stratify=y)
print(f'train data shape: {x_train.shape}')
print(f'test data shape: {x_test.shape}')


dd = pd.Series(y_train).value_counts()
sns.barplot(x=np.array(['negative','positive']),y=dd.values)
plt.show()
Saída:
>>> train data shape: (37500,)

>>> test data shape: (12500,)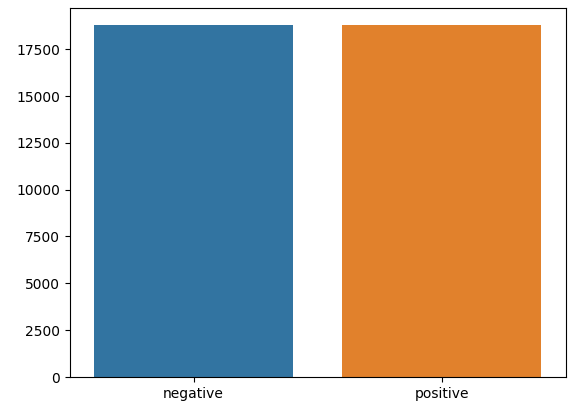
O pré-processamento e a tokenização do texto são um primeiro passo crucial. Primeiro, limpamos o texto removendo pontuação, espaços extras e números.
Depois, transformamos sentenças em palavras individuais, removemos palavras muito comuns (as “stop words”) e acompanhamos as 1000 palavras mais frequentes do conjunto de dados. Em seguida, atribuímos um identificador único a cada uma, formando um dicionário para one-hot encoding.
Em essência, o código converte as sentenças originais em sequências desses identificadores, traduzindo a linguagem humana para um formato que um modelo de machine learning consegue entender.
def preprocess_string(s):
    # Remove all non-word characters (everything except numbers and letters)
    s = re.sub(r"[^\w\s]", '', s)
    # Replace all runs of whitespaces with no space
    s = re.sub(r"\s+", '', s)
    # replace digits with no space
    s = re.sub(r"\d", '', s)
    return s


def tokenize(x_train,y_train,x_val,y_val):
    word_list = []


    stop_words = set(stopwords.words('english'))
    for sent in x_train:
        for word in sent.lower().split():
            word = preprocess_string(word)
            if word not in stop_words and word != '':
                word_list.append(word)

    corpus = Counter(word_list)
    # sorting on the basis of most common words
    corpus_ = sorted(corpus,key=corpus.get,reverse=True)[:1000]
    # creating a dict
    onehot_dict = {w:i+1 for i,w in enumerate(corpus_)}

    # tokenize
    final_list_train,final_list_test = [],[]
    for sent in x_train:
            final_list_train.append([onehot_dict[preprocess_string(word)] for word in sent.lower().split()
                                     if preprocess_string(word) in onehot_dict.keys()])
    for sent in x_val:
            final_list_test.append([onehot_dict[preprocess_string(word)] for word in sent.lower().split()
                                    if preprocess_string(word) in onehot_dict.keys()])

    encoded_train = [1 if label =='positive' else 0 for label in y_train]
    encoded_test = [1 if label =='positive' else 0 for label in y_val]
    return np.array(final_list_train), np.array(encoded_train),np.array(final_list_test), np.array(encoded_test),onehot_dict


x_train,y_train,x_test,y_test,vocab = tokenize(x_train,y_train,x_test,y_test)
Vamos analisar o comprimento dos tokens em x_train.
rev_len = [len(i) for i in x_train]
pd.Series(rev_len).hist()

Como os comprimentos de tokens variam em cada review, é necessário padronizá-los. Como a maioria tem menos de 500 tokens, definiremos 500 como comprimento fixo para todas.
def padding_(sentences, seq_len):
    features = np.zeros((len(sentences), seq_len),dtype=int)
    for ii, review in enumerate(sentences):
        if len(review) != 0:
            features[ii, -len(review):] = np.array(review)[:seq_len]
    return features


x_train_pad = padding_(x_train,500)
x_test_pad = padding_(x_test,500)
Em seguida, usamos a classe DataLoader para criar o dataset final para treinamento.
# create Tensor datasets
train_data = TensorDataset(torch.from_numpy(x_train_pad), torch.from_numpy(y_train))
valid_data = TensorDataset(torch.from_numpy(x_test_pad), torch.from_numpy(y_test))


# dataloaders
batch_size = 50


# make sure to SHUFFLE your data
train_loader = DataLoader(train_data, shuffle=True, batch_size=batch_size)
valid_loader = DataLoader(valid_data, shuffle=True, batch_size=batch_size)


# obtain one batch of training data
dataiter = iter(train_loader)
sample_x, sample_y = next(dataiter)


print('Sample input size: ', sample_x.size()) # batch_size, seq_length
print('Sample input: \n', sample_x)
print('Sample output: \n', sample_y)
Saída:

Esta parte do código define um modelo de análise de sentimento usando uma arquitetura de rede neural recorrente (RNN), especificamente o tipo LSTM (Long Short-Term Memory) mencionado acima. A classe SentimentRNN é um modelo em PyTorch que começa com uma camada de embedding, transformando índices de palavras em representações densas que capturam o significado semântico. Em seguida, vem uma camada LSTM que processa a sequência de embeddings.
O estado oculto da LSTM passa por uma camada de dropout (para regularizar o modelo e evitar overfitting) e por uma camada totalmente conectada, que mapeia as saídas da LSTM para a predição final. A predição passa por uma função de ativação sigmoid, convertendo os valores brutos em probabilidades. O método forward define a passagem direta dos dados pela rede, e o método init_hidden inicializa os estados ocultos da LSTM com zeros.
class SentimentRNN(nn.Module):
    def __init__(self,no_layers,vocab_size,hidden_dim,embedding_dim,drop_prob=0.5):
        super(SentimentRNN,self).__init__()

        self.output_dim = output_dim
        self.hidden_dim = hidden_dim

        self.no_layers = no_layers
        self.vocab_size = vocab_size

        # embedding and LSTM layers
        self.embedding = nn.Embedding(vocab_size, embedding_dim)

        #lstm
        self.lstm = nn.LSTM(input_size=embedding_dim,hidden_size=self.hidden_dim,
                           num_layers=no_layers, batch_first=True)

        # dropout layer
        self.dropout = nn.Dropout(0.3)

        # linear and sigmoid layer
        self.fc = nn.Linear(self.hidden_dim, output_dim)
        self.sig = nn.Sigmoid()

    def forward(self,x,hidden):
        batch_size = x.size(0)
        # embeddings and lstm_out
        embeds = self.embedding(x)  # shape: B x S x Feature   since batch = True
        #print(embeds.shape)  #[50, 500, 1000]
        lstm_out, hidden = self.lstm(embeds, hidden)

        lstm_out = lstm_out.contiguous().view(-1, self.hidden_dim)

        # dropout and fully connected layer
        out = self.dropout(lstm_out)
        out = self.fc(out)

        # sigmoid function
        sig_out = self.sig(out)

        # reshape to be batch_size first
        sig_out = sig_out.view(batch_size, -1)


        sig_out = sig_out[:, -1] # get last batch of labels

        # return last sigmoid output and hidden state
        return sig_out, hidden

    def init_hidden(self, batch_size):
        ''' Initializes hidden state '''
        # Create two new tensors with sizes n_layers x batch_size x hidden_dim,
        # initialized to zero, for hidden state and cell state of LSTM
        h0 = torch.zeros((self.no_layers,batch_size,self.hidden_dim)).to(device)
        c0 = torch.zeros((self.no_layers,batch_size,self.hidden_dim)).to(device)
        hidden = (h0,c0)
        return hidden
Agora vamos inicializar a classe SentimentRNN que definimos acima com os parâmetros necessários.
no_layers = 2
vocab_size = len(vocab) + 1 #extra 1 for padding
embedding_dim = 64
output_dim = 1
hidden_dim = 256


model = SentimentRNN(no_layers,vocab_size,hidden_dim,embedding_dim,drop_prob=0.5)


#moving to gpu
model.to(device)
print(model)
O último passo antes de começar o treinamento é definir as funções de perda e otimização. Aqui, focamos em definir a função de perda, o método de otimização e uma função utilitária para cálculo de acurácia do nosso modelo de análise de sentimento.
Usamos Binary Cross-Entropy Loss (nn.BCELoss), comum em tarefas de classificação binária como esta. O otimizador é Adam (torch.optim.Adam), escolha popular pela eficiência e baixo consumo de memória. A taxa de aprendizado do Adam é 0,001.
A função acc é um helper que calcula a acurácia das predições do modelo. Ela arredonda as probabilidades previstas para o inteiro mais próximo (0 ou 1), compara essas previsões com os rótulos reais e calcula o percentual de acertos.
# loss and optimization functions


lr=0.001


criterion = nn.BCELoss()


optimizer = torch.optim.Adam(model.parameters(), lr=lr)


# function to predict accuracy
def acc(pred,label):
    pred = torch.round(pred.squeeze())
    return torch.sum(pred == label.squeeze()).item()
Aqui acontece o treinamento e a validação do modelo de análise de sentimento. Cada época (iteração) tem uma fase de treino e outra de validação. Durante o treino, o modelo ajusta seus parâmetros para minimizar a perda.
Na validação, avaliamos o desempenho em um conjunto separado para garantir que o modelo esteja aprendendo padrões generalizáveis, e não apenas memorizando os dados de treino.
O loop de treinamento começa inicializando os estados ocultos da LSTM e colocando o modelo em modo de treino. Para cada batch, comparamos as predições com os rótulos reais para calcular a perda, que então é retropropagada para atualizar os parâmetros.
Os gradientes são “clipados” a um valor máximo para evitar que fiquem muito grandes — um problema comum ao treinar RNNs e LSTMs.
No loop de validação, colocamos o modelo em modo de avaliação e medimos seu desempenho nos dados de validação sem atualizar parâmetros. Em ambas as fases, o código acompanha perda e acurácia por época.
Se a perda de validação melhora, salvamos os parâmetros atuais do modelo, registrando a melhor versão encontrada.
Por fim, após cada época, imprimimos as perdas e acurácias médias, dando visibilidade ao progresso do aprendizado.
clip = 5
epochs = 5
valid_loss_min = np.Inf
# train for some number of epochs
epoch_tr_loss,epoch_vl_loss = [],[]
epoch_tr_acc,epoch_vl_acc = [],[]


for epoch in range(epochs):
    train_losses = []
    train_acc = 0.0
    model.train()
    # initialize hidden state
    h = model.init_hidden(batch_size)
    for inputs, labels in train_loader:

        inputs, labels = inputs.to(device), labels.to(device)
        # Creating new variables for the hidden state, otherwise
        # we'd backprop through the entire training history
        h = tuple([each.data for each in h])

        model.zero_grad()
        output,h = model(inputs,h)

        # calculate the loss and perform backprop
        loss = criterion(output.squeeze(), labels.float())
        loss.backward()
        train_losses.append(loss.item())
        # calculating accuracy
        accuracy = acc(output,labels)
        train_acc += accuracy
        #`clip_grad_norm` helps prevent the exploding gradient problem in RNNs / LSTMs.
        nn.utils.clip_grad_norm_(model.parameters(), clip)
        optimizer.step()

    val_h = model.init_hidden(batch_size)
    val_losses = []
    val_acc = 0.0
    model.eval()
    for inputs, labels in valid_loader:
            val_h = tuple([each.data for each in val_h])


            inputs, labels = inputs.to(device), labels.to(device)


            output, val_h = model(inputs, val_h)
            val_loss = criterion(output.squeeze(), labels.float())


            val_losses.append(val_loss.item())

            accuracy = acc(output,labels)
            val_acc += accuracy

    epoch_train_loss = np.mean(train_losses)
    epoch_val_loss = np.mean(val_losses)
    epoch_train_acc = train_acc/len(train_loader.dataset)
    epoch_val_acc = val_acc/len(valid_loader.dataset)
    epoch_tr_loss.append(epoch_train_loss)
    epoch_vl_loss.append(epoch_val_loss)
    epoch_tr_acc.append(epoch_train_acc)
    epoch_vl_acc.append(epoch_val_acc)
    print(f'Epoch {epoch+1}')
    print(f'train_loss : {epoch_train_loss} val_loss : {epoch_val_loss}')
    print(f'train_accuracy : {epoch_train_acc*100} val_accuracy : {epoch_val_acc*100}')
    if epoch_val_loss <= valid_loss_min:
        torch.save(model.state_dict(), 'state_dict.pt')
        print('Validation loss decreased ({:.6f} --> {:.6f}).  Saving model ...'.format(valid_loss_min,epoch_val_loss))
        valid_loss_min = epoch_val_loss
    print(25*'==')
Saída:

Aqui geramos dois gráficos para visualizar a acurácia e a perda de treino e validação ao longo do treinamento. O primeiro subplot mostra a acurácia de treino e validação após cada época — útil para ver como o modelo aprende e generaliza ao longo do tempo.
O segundo subplot mostra a perda de treino e validação, ajudando a identificar overfitting, underfitting ou um ajuste adequado.
fig = plt.figure(figsize = (20, 6))
plt.subplot(1, 2, 1)
plt.plot(epoch_tr_acc, label='Train Acc')
plt.plot(epoch_vl_acc, label='Validation Acc')
plt.title("Accuracy")
plt.legend()
plt.grid()

plt.subplot(1, 2, 2)
plt.plot(epoch_tr_loss, label='Train loss')
plt.plot(epoch_vl_loss, label='Validation loss')
plt.title("Loss")
plt.legend()
plt.grid()


plt.show()
Saída:

Nesta parte, criamos uma função predict_text para prever o sentimento de um texto e mostramos um exemplo de uso. A função recebe uma string, transforma em uma sequência de índices de palavras (conforme um vocabulário pré-definido) e prepara a entrada para o modelo aplicando padding e reshape. Em seguida, inicializa os estados ocultos da LSTM, envia a entrada ao modelo e retorna a probabilidade prevista para o texto bruto.
def predict_text(text):
        word_seq = np.array([vocab[preprocess_string(word)] for word in text.split()
                         if preprocess_string(word) in vocab.keys()])
        word_seq = np.expand_dims(word_seq,axis=0)
        pad =  torch.from_numpy(padding_(word_seq,500))
        inputs = pad.to(device)
        batch_size = 1
        h = model.init_hidden(batch_size)
        h = tuple([each.data for each in h])
        output, h = model(inputs, h)
        return(output.item())


index = 30
print(df['review'][index])
print('='*70)
print(f'Actual sentiment is  : {df["sentiment"][index]}')
print('='*70)
pro = predict_text(df['review'][index])
status = "positive" if pro > 0.5 else "negative"
pro = (1 - pro) if status == "negative" else pro
print(f'Predicted sentiment is {status} with a probability of {pro}')
Saída:

Este notebook completo foi desenvolvido no DataLab e pode ser acessado neste workbook. Lembre-se: executar o código pode levar bastante tempo se você estiver usando CPU. Com GPU, o tempo de treino cai consideravelmente.
Melhorar um modelo de NLP geralmente envolve várias estratégias ajustadas aos requisitos e restrições da tarefa. Ajuste de hiperparâmetros é uma abordagem comum, alterando, por exemplo, taxa de aprendizado, tamanho do batch ou número de camadas da rede.
Esses hiperparâmetros influenciam bastante o desempenho e normalmente são otimizados com técnicas como grid search ou random search.
Transfer learning, especialmente com modelos como BERT ou GPT, tem mostrado grande potencial em tarefas de NLP. Esses modelos são pré-treinados em grandes corpora de texto e depois ajustados para uma tarefa específica, aproveitando o entendimento geral de linguagem adquirido no pré-treinamento. Essa abordagem tem gerado resultados de ponta em diversas tarefas de NLP, inclusive análise de sentimento.
O uso de modelos de Processamento de Linguagem Natural (NLP), especialmente implementados com frameworks como PyTorch, já se espalhou em aplicações reais, transformando vários aspectos da nossa vida digital.
Chatbots tornaram-se parte essencial de plataformas de atendimento, usando modelos de NLP para entender e responder às perguntas dos usuários. Eles processam linguagem natural, inferem intenção e geram respostas próximas às humanas, oferecendo interações fluidas.
Em sistemas de recomendação, modelos de NLP ajudam a analisar avaliações e comentários para entender preferências, tornando as recomendações mais personalizadas.
Ferramentas de análise de sentimento também dependem fortemente de NLP. Elas examinam posts em redes sociais, reviews de clientes ou qualquer texto e inferem o sentimento por trás deles. Empresas usam esses insights em pesquisa de mercado ou para medir a percepção sobre seus produtos e serviços, possibilitando decisões orientadas por dados.
Descubra mais casos de uso reais do Google BERT neste tutorial de Natural Language Processing.
O PyTorch oferece uma plataforma poderosa e flexível para construir modelos de NLP. Neste tutorial, percorremos o desenvolvimento de um modelo de análise de sentimento com arquitetura LSTM, destacando etapas chave como pré-processar textos, construir o modelo, treiná-lo e validá-lo, e por fim fazer predições em dados não vistos.
Isso é só o começo do que é possível com NLP e PyTorch. As aplicações vão de chatbots e sistemas de recomendação a ferramentas de análise de sentimento — e além.
A evolução contínua da área, principalmente com o avanço de modelos de transfer learning como BERT e GPT, abre possibilidades ainda mais empolgantes. Dominar NLP com PyTorch é desafiador, mas recompensador, pois abre uma nova dimensão para entender e interagir com o mundo ao nosso redor.
Se você quer se aprofundar em PyTorch, confira nosso curso Deep Learning with PyTorch. Nele, você começa com uma introdução ao PyTorch, explora a biblioteca e suas aplicações em redes neurais e deep learning. Depois, aprende sobre redes neurais artificiais e como treiná-las com dados reais.
Expanda suas habilidades em NLP hoje mesmo!
Curso
Programa
blog
Matt Crabtree
11 min
blog
Laiba Siddiqui
13 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
13 min
Tutorial
Tutorial
Kurtis Pykes
12 min





