Torne-se um engenheiro de dados
O ecossistema do Apache Hadoop
O Hadoop se tornou o padrão de fato para processamento de dados, assim como o Excel acabou virando o software padrão para análise de dados. Diferente do Excel, o Hadoop foi projetado por desenvolvedores e não por "Business Analysts"; ainda assim, a adoção em larga escala e o sucesso dependem mais dos analistas de negócios do que dos desenvolvedores. Por isso, os problemas de Big Data foram segmentados do ponto de vista funcional e, para cada segmento, foram desenvolvidas tecnologias baseadas em Hadoop para enfrentar esses desafios. Todas essas ferramentas formam o chamado ecossistema Hadoop.
O ecossistema Hadoop enriquece o Hadoop e o torna capaz de resolver uma ampla variedade de problemas de negócio. Hoje, o ecossistema Hadoop é composto por centenas de tecnologias que agrupamos em 14 categorias, de acordo com os segmentos de problema: linguagens de abstração, SQL sobre Hadoop (Hive e Pig), modelos computacionais (MapReduce e Tez), ferramentas de processamento em tempo real (Storm e Spark Streaming), bancos de dados (HBase e Cassandra), ferramentas de ingestão de streaming (Kafka e Flume), ferramentas de integração de dados (Sqoop e Talend), ferramentas de coordenação de workflow (Oozie e Control-M para Hadoop), ferramentas de coordenação de serviços distribuídos (ZooKeeper), ferramentas de administração de cluster (Ranger e Sentry), ferramentas de interface do usuário (Hue e Jupyter), ferramentas de indexação de conteúdo (ElasticSearch e Splunk), sistemas de arquivos distribuídos (HDFS) e gerenciadores de recursos (YARN e MESOS). Nesta seção, vamos revisar a função de cada uma das ferramentas que compõem esse ecossistema de tecnologias de Big Data. Depois, se quiser se aprofundar, recomendamos ler nossos guias sobre os diferentes elementos do ecossistema Hadoop que virão na sequência deste artigo. O mapa mental a seguir apresenta o ecossistema Hadoop de forma global.
Mapa heurístico do ecossistema Hadoop
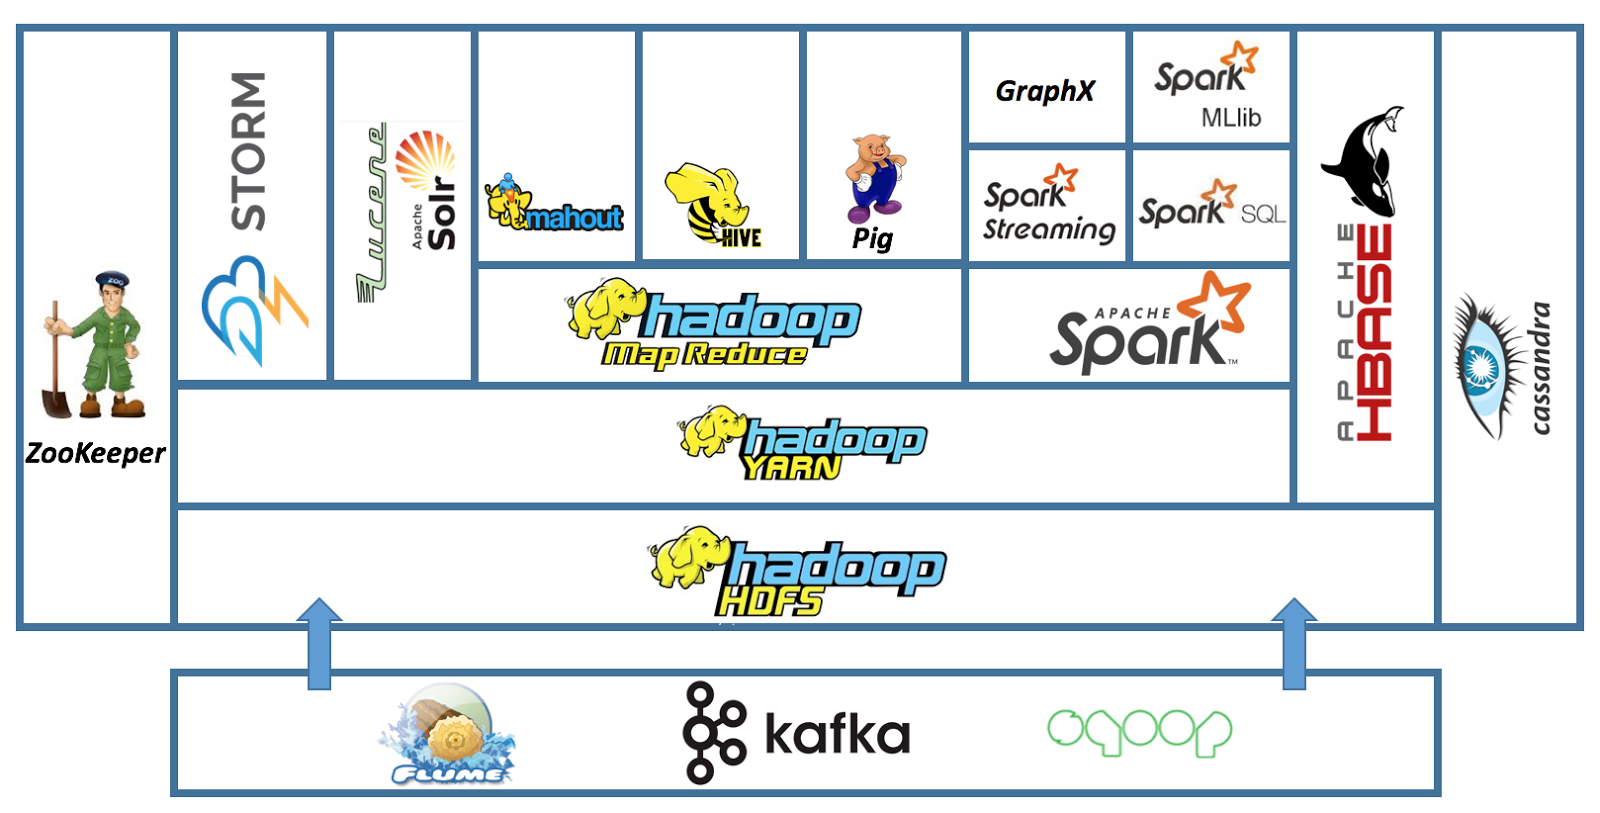
A configuração básica do ecossistema Hadoop inclui as seguintes tecnologias: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie e Kafka.
Spark
Antes de explicar o que é o Spark, vale lembrar que, para um algoritmo ser executado em um cluster multinó no Hadoop, ele precisa ser paralelizável. Assim, dizemos que um algoritmo é "escalável" se ele é paralelizável (e, portanto, consegue aproveitar a escalabilidade de um cluster). O Hadoop é uma implementação do modelo computacional MapReduce. O problema do MapReduce é que ele se baseia em um modelo de grafo acíclico direcionado. Em outras palavras, a sequência de operações do MapReduce roda em três fases sequenciais diretas, sem desvios (Map -> Shuffle -> Reduce); nenhuma fase é iterativa (ou cíclica).
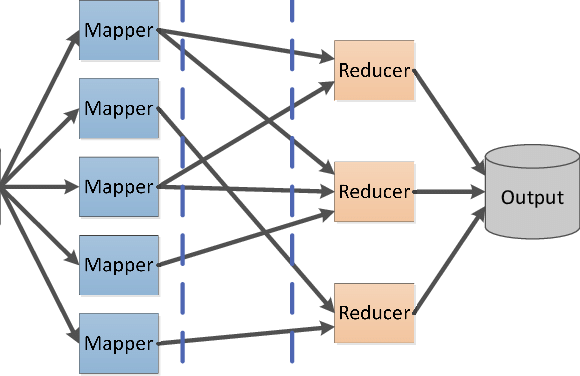
O modelo acíclico direto não é adequado para algumas aplicações, especialmente aquelas que reutilizam dados em várias operações, como a maioria dos algoritmos de aprendizado estatístico, que são iterativos, e consultas de análise de dados interativas. O Spark responde a essas limitações; ele é um mecanismo computacional que realiza processamento distribuído em memória em um cluster. Em outras palavras, é um engine de computação distribuída em memória. Comparado ao MapReduce, que funciona em modo batch, o modelo de computação do Spark trabalha de forma interativa, ou seja, reúne os dados em memória antes de processá-los e, por isso, é muito adequado para processamento de Machine Learning.
Hive
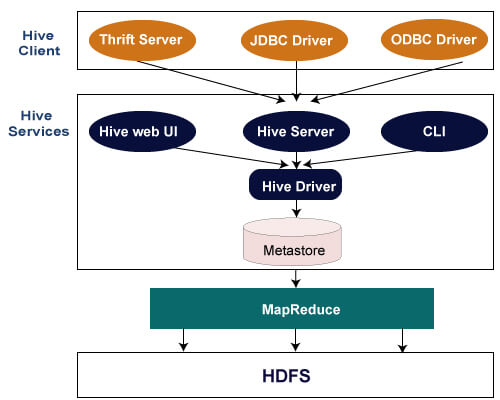
O Hive é uma infraestrutura de computação semelhante a um Data Warehouse que oferece serviços de consulta e agregação para volumes muito grandes de dados armazenados em um sistema de arquivos distribuído como o HDFS. O Hive oferece uma linguagem de consulta baseada em SQL (padrão ANSI-92), chamada HiveQL (Hive Query Language), que executa consultas nos dados armazenados no HDFS. O HiveQL também permite que usuários avançados/desenvolvedores integrem funções Map e Reduce diretamente em suas consultas para cobrir um espectro mais amplo de problemas de gestão de dados. Quando você escreve uma consulta em HiveQL, ela é transformada em um job MapReduce e enviada pelo Hive ao JobTracker para execução.
Pig
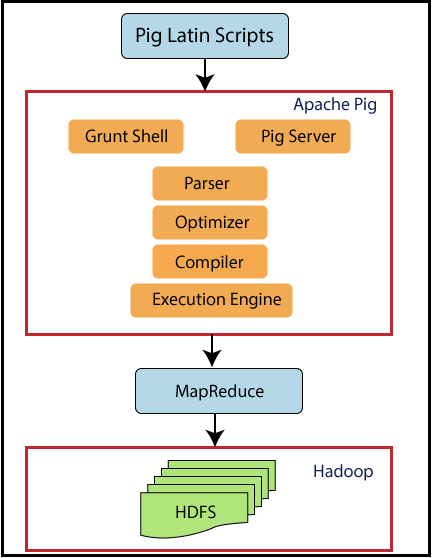
O Pig é um ambiente interativo de execução de fluxos de dados no Hadoop. Ele é composto por 2 elementos: uma linguagem de expressão de fluxo de dados chamada Pig Latin e um ambiente interativo de execução desses fluxos.
A linguagem oferecida pelo Pig, a Pig Latin, é aproximadamente semelhante a linguagens de script como Perl, Python ou Ruby. No entanto, ela é mais específica do que essas e é melhor descrita como uma "linguagem de fluxo de dados". Ela permite escrever consultas em fluxos sequenciais de dados de origem para obter dados "alvo" no Hadoop, no estilo de um ETL. Esses fluxos são então transformados em funções MapReduce que, por fim, são submetidas ao job tracker para execução. Em poucas palavras, o Pig é o ETL do Hadoop. Programar em Pig Latin significa descrever, em fluxos independentes porém encadeados, como os dados são carregados, transformados e agregados usando instruções específicas do Pig chamadas operadores. Dominar esses operadores é a chave para dominar a programação em Pig Latin, sobretudo porque são poucos quando comparados aos do Hive.
HBase
Antes de falar do HBase, vamos lembrar que os SGBDR (RDBMS), usados até então para gestão de dados, mostraram rapidamente seus limites diante do alto volume e da diversidade dos dados. De fato, os SGBDR foram concebidos para gerenciar apenas dados estruturados (tabelas em linhas/colunas); além disso, o aumento de volume eleva a latência das consultas. Essa latência é prejudicial para muitos negócios que exigem respostas quase em tempo real. Novos SGBDs, chamados "NoSQL", foram desenvolvidos para superar essas limitações. Eles não impõem uma estrutura específica aos dados, conseguem distribuir o armazenamento e o gerenciamento em vários nós e são escaláveis. Relembrando: escalabilidade significa que o desempenho do sistema se mantém estável à medida que a carga de processamento cresce. O HBase pertence a essa categoria de SGBDs.
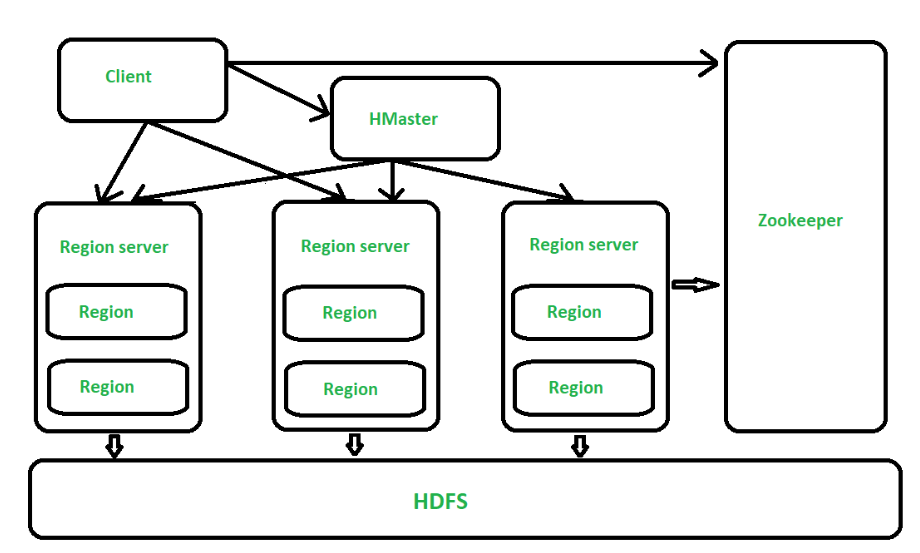
O HBase é um SGBD distribuído, orientado a colunas, que oferece acesso de leitura e escrita em tempo real aos dados armazenados no HDFS. O HDFS oferece acesso sequencial a dados em batch, o que não é adequado para acesso rápido, como em streaming; o HBase cobre essas lacunas e provê acesso veloz aos dados armazenados no HDFS.
O HBase é baseado no SGBD "BigTable" do Google e pode armazenar volumes imensos de dados (bilhões de linhas/colunas). Ele depende do ZooKeeper, um serviço de coordenação distribuída para desenvolvimento de aplicações.
Sqoop
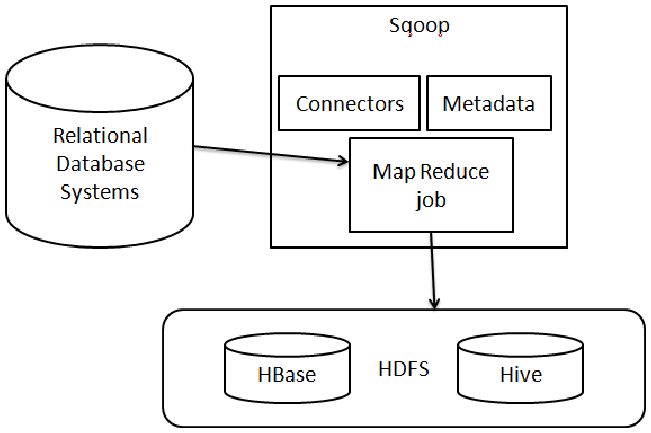
Sqoop, ou SQL-to-Hadoop, é uma ferramenta que transfere dados de um banco de dados relacional para o HDFS do Hadoop e vice-versa. Ele é integrado ao ecossistema Hadoop e atua como o orquestrador de ingestão de dados no Hadoop. Você pode usar o Sqoop para importar dados de SGBDRs como MySQL, Oracle ou SQL Server para o HDFS, transformar os dados no Hadoop via MapReduce ou outro modelo de computação e exportá-los de volta ao SGBDR. Chamamos de orquestrador de ingestão porque, assim como o Oozie, ele automatiza esse processo de importação/exportação e agenda sua execução. Tudo o que você precisa fazer como usuário é escrever as consultas SQL que serão usadas para realizar o movimento de importação/exportação. Além disso, o Sqoop usa MapReduce para importar e exportar dados, o que é eficiente e tolerante a falhas.
Storm
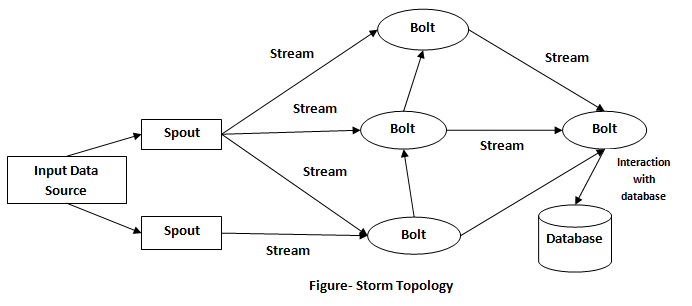
Para entender o Storm, é preciso compreender o conceito de arquiteturas lambda (λ) e por que elas são importantes. Também é essencial entender o conceito de objetos conectados. Os objetos conectados, ou Internet das Coisas (IoT), representam a extensão da internet ao nosso cotidiano. Eles geram dados em streaming e, na maioria dos casos, exigem processamento em tempo real. Os modelos com os quais você está acostumado, como os modelos batch, não se adaptam aos desafios de tempo real trazidos pelo IoT. Mesmo modelos de computação interativos não são adequados para processamentos contínuos em tempo real. Diferente dos dados operacionais produzidos por sistemas de uma empresa, como finanças ou marketing, que mesmo quando produzidos em streaming podem ser historizados para processamento posterior, os dados gerados em fenômenos como IoT ou internet expiram (ou perdem validade) instantes após sua criação e, portanto, requerem processamento imediato. Além de objetos conectados, problemas de negócio como combate à fraude, análise de redes sociais e geolocalização demandam tempos de resposta baixíssimos, quase inferiores a um segundo. Para resolver isso em um contexto de Big Data, foram desenvolvidas as chamadas arquiteturas λ. Essas arquiteturas adicionam duas camadas de processamento ao MapReduce para reduzir a latência. O Storm é uma implementação de software da arquitetura λ. Ele permite aplicações no Hadoop que processam dados em tempo real (ou quase em tempo real).
ZooKeeper
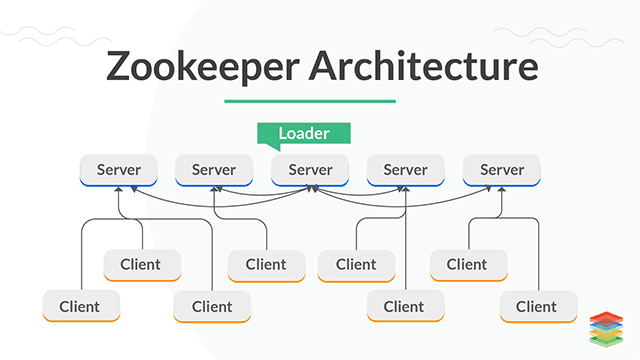
Sincronizar ou coordenar a comunicação entre nós durante a execução de tarefas paralelas é um dos problemas mais difíceis no desenvolvimento de aplicações distribuídas. Para resolver isso, o Hadoop incorporou ao seu ecossistema ferramentas de coordenação de serviços, no caso, o ZooKeeper. O ZooKeeper cuida da complexidade inerente à sincronização da execução de jobs distribuídos no cluster, evitando que outras ferramentas do ecossistema Hadoop precisem lidar com esse problema por conta própria. Ele também permite que usuários desenvolvam aplicações distribuídas sem serem especialistas em programação distribuída. Sem entrar nos detalhes complexos da coordenação de dados entre nós de um cluster Hadoop, o ZooKeeper fornece um serviço de configuração distribuída, um serviço de distribuição e um registro de nomes para aplicações distribuídas. O ZooKeeper é o meio pelo qual o Hadoop coordena jobs distribuídos.
Oozie
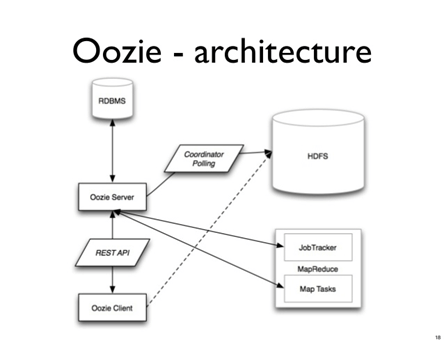
Por padrão, o Hadoop executa jobs conforme eles são submetidos, sem considerar o relacionamento entre eles. No entanto, os problemas para os quais o Hadoop é usado geralmente exigem a escrita de um ou mais jobs complexos. Quando dois jobs são enviados ao JobTracker (ou ao YARN), ele os executará sem prestar atenção ao vínculo entre eles, o que pode causar um erro (exceção) e interromper o código. Como gerenciar a execução de vários jobs relacionados ao mesmo problema? Para esse tipo de situação, a solução mais simples hoje é usar um agendador de jobs, no caso, o Oozie.
O Oozie é um agendador de jobs que roda como um serviço em um cluster Hadoop. Ele é usado para agendar jobs do Hadoop e, de forma geral, para agendar a execução de todos os jobs que podem rodar em um cluster, como um script Hive, um job MapReduce, um job Hama, um job Storm etc. Ele foi projetado para gerenciar automaticamente a execução imediata ou programada de milhares de jobs interdependentes em um cluster Hadoop. Para usar o Oozie, basta configurar 2 arquivos XML: um arquivo de configuração do engine do Oozie e um arquivo de configuração do workflow do job.
Apresentando a Cloudera
A Cloudera é uma empresa americana sediada na Califórnia, dedicada ao desenvolvimento de uma solução de Big Data, historicamente baseada no framework distribuído Hadoop; atualmente, está se reorientando para a nuvem. Há mais de um ano, a Cloudera vem expandindo sua solução nas nuvens públicas AWS, Azure e GCP.
Apresentando o CDP
O Cloudera Data Platform (CDP) é uma plataforma que permite às empresas analisar dados com analytics self-service em ambientes híbridos e multicloud. Ela possibilita que as organizações extraiam mais valor de todos os seus dados criando data lakes na nuvem em poucas horas.
O CDP oferece ferramentas integradas, multifuncionais e self-service para analisar e centralizar dados. Além disso, proporciona segurança e governança em nível corporativo e pode ser implantado em ambientes públicos, privados e multicloud. O CDP é a distribuição que sucede as duas distribuições Hadoop anteriores da Cloudera: Cloudera Distribution of Hadoop (CDH) e Hortonworks Data Platform (HDP).
O acesso self-service aos dados corporativos está no centro desse serviço. Os serviços de nuvem recém-adicionados e integrados à plataforma também oferecem acesso self-service a dados e analytics para analistas, cientistas de dados, profissionais de TI e desenvolvedores. As palavras-chave que diferenciam a plataforma da concorrência são os três serviços Cloud-Native do CDP apresentados pela Cloudera: self-service, multicloud e segurança.
O CDP oferece uma abordagem público-privada única, analytics de dados em tempo real, opções escaláveis de implantação on-premises, em nuvem e híbrida, e uma arquitetura com privacidade em primeiro lugar.
CDP Public Cloud
O CDP Public Cloud é um Platform-as-a-Service (PaaS) compatível com infraestrutura de nuvem e facilmente portável entre diversos provedores, incluindo soluções privadas como OpenShift. O CDP foi projetado para ser totalmente híbrido e multicloud, o que significa que uma única plataforma pode gerenciar todos os casos de uso do ciclo de vida dos dados. A plataforma CDP funciona com dados em vários cenários, incluindo nuvens públicas como AWS, Azure e GCP. Além disso, ela pode dimensionar automaticamente workloads e recursos para cima ou para baixo para melhorar o desempenho e reduzir custos.
Serviços do CDP Public Cloud
Estes são os principais componentes que compõem o CDP Public Cloud:
-
CDP Data Engineering é uma configuração tudo-em-um. Construído sobre o Apache Spark, ele simplifica processos de ETL em times de análise de dados corporativos ao permitir orquestração e automação com Apache Airflow e oferece ferramentas avançadas de monitoramento de pipeline, depuração visual e gestão. Além disso, possui ambientes de trabalho isolados e é conteinerizado, escalável e fácil de portar.
-
CDP Data Hub é um serviço que viabiliza analytics de alto valor do Edge à IA. O Cloudera Data Hub é um serviço cloud-native de gerenciamento e análise de dados. Ele permite que desenvolvedores de TI e de negócio construam aplicações corporativas mais rapidamente para qualquer cenário, de streaming a ETL. Data marts, bancos de dados e Machine Learning estão entre os serviços cobertos no amplo leque de workloads analíticos.
-
CDP Data Warehouse é um serviço que permite à TI oferecer uma experiência de analytics self-service, cloud-native, para analistas de BI. Streaming, engenharia de dados e analytics estão totalmente integrados ao CDP Data Warehouse. Além disso, ele traz um framework unificado para proteger e governar todos os seus dados e metadados em nuvens privadas, múltiplas nuvens públicas ou ambientes híbridos. O serviço Cloudera Data Warehouse facilita a implantação de data warehouses self-service para analistas de dados. Ele se baseia em engines SQL robustas e testadas em ambiente corporativo. Centenas de usuários poderão acessar os dados com um clique, tanto on-premises quanto na nuvem. Os recursos podem ser dimensionados sob demanda e o gerenciamento de workload também é self-service, com ferramentas intuitivas.
-
CDP Machine Learning facilita a criação de workspaces colaborativos de Machine Learning para que cientistas de dados aproveitem os dados da empresa. Ele otimiza fluxos de trabalho de ML com ferramentas nativas e completas para implantar, distribuir e monitorar modelos. Com essa ferramenta, as organizações podem disponibilizar rapidamente novos workspaces de ML com poucos cliques, garantindo acesso self-service às ferramentas e dados necessários aos fluxos de trabalho de aprendizado de máquina. Além disso, a replicação de dados on-premises ou na nuvem pode ser feita rapidamente sem comprometer segurança e governança. Os cientistas de dados também podem escolher suas ferramentas enquanto se beneficiam de recursos elásticos ajustados às suas necessidades. Treinamento de modelos, engenharia de dados, implantação e gestão de modelos são realizados de forma ágil em uma interface tudo-em-um, eliminando a necessidade de alternar entre plataformas.
-
Cloudera Data Visualization permite modelar dados no data warehouse virtual sem remover ou atualizar estruturas ou tabelas subjacentes, além de consultar grandes volumes sem recarregamentos constantes — economizando tempo e dinheiro.
-
Cloudera Operational Database é uma solução gerenciada que sintetiza a instância subjacente do cluster em um banco de dados. Ele escala automaticamente com base na utilização do workload do cluster, melhora o desempenho no mesmo footprint de infraestrutura e resolve automaticamente questões operacionais.
CDP Private Cloud
O CDP Private Cloud é mais indicado para implantações de nuvem híbrida, permitindo que ambientes on-premises se conectem a nuvens públicas mantendo segurança e governança consistentes e integradas. Processamento e armazenamento são desacoplados no CDP Private Cloud, permitindo que ambos os clusters escalem de forma independente. Disponível em um cluster CDP Private Cloud Base, o Cloudera Shared Data Experience (SDX) oferece segurança, governança e gestão de metadados unificadas. Além disso, usuários do CDP Private Cloud podem provisionar e implantar rapidamente os serviços Cloudera Data Warehousing e Cloudera Machine Learning e escalá-los conforme necessário, usando o Management Console.
Serviços do CDP Private Cloud
Alguns componentes do CDP Public Cloud, como Machine Learning e Data Warehouse, estão disponíveis no CDP Private Cloud. Ele utiliza um conjunto de engines analíticas que cobrem streaming, engenharia de dados, data marts, bancos de dados operacionais e data science para dar suporte a workloads tradicionais.
Essenciais de HDFS e MapReduce
O HDFS é o sistema de arquivos distribuído do Hadoop e o elemento central do Hadoop, permitindo armazenar e replicar dados em vários servidores. Em combinação com o YARN, ele amplia as capacidades de gestão de dados do cluster Hadoop com HDFS e, assim, viabiliza um processamento de Big Data eficiente.
Você pode executar o HDFS em hardware comum, o que o torna muito tolerante a falhas. Cada pedaço de dado é armazenado em vários lugares e pode ser recuperado em qualquer circunstância. Além disso, essa replicação ajuda a combater possíveis corrupções de dados.
O HDFS utiliza um NameNode e um DataNode. O DataNode é um servidor padrão no qual os dados são armazenados. O NameNode contém metadados (dados sobre o que está armazenado nos diferentes nós). A aplicação interage apenas com o NameNode, e o NameNode se comunica com os data nodes conforme necessário.
O HDFS também evita congestionamento de rede ao priorizar mover operações em vez de mover dados. Isso significa que as aplicações podem acessar os dados onde eles estão. Sua última força é a portabilidade: ele pode rodar em diferentes tipos de hardware sem problemas de compatibilidade.
O que é MapReduce e como funciona?
O MapReduce é o engine de processamento do Apache Hadoop, derivado diretamente do MapReduce do Google. Aplicações MapReduce são, essencialmente, escritas em Java. Ele permite computar facilmente quantidades enormes de dados aplicando etapas de mapeamento e redução para encontrar a solução do problema em questão. A etapa de mapeamento pega um conjunto de dados e o converte em outro, decompondo os elementos individuais em pares chave/valor, chamados tuplas. A segunda etapa, de redução, pega a saída do mapeamento e combina as tuplas em um conjunto menor de tuplas.
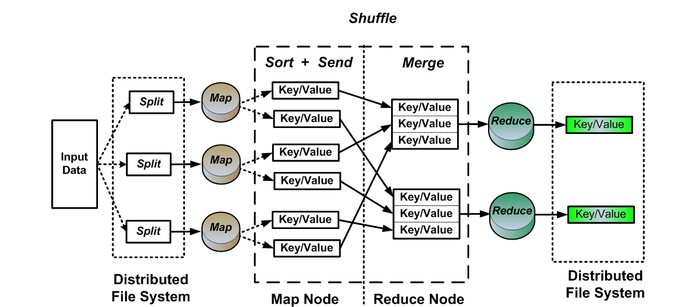
O MapReduce é um framework de processamento altamente paralelo, que pode ser escalado com facilidade sobre grandes quantidades de hardware comum para atender à crescente necessidade de processar grandes volumes de dados. Uma vez que as tarefas de mapeamento e redução estejam fluindo bem, tudo o que é necessário é uma alteração de configuração para rodar em um conjunto de dados maior. Esse tipo de escalabilidade extrema, de um único nó para centenas ou até milhares de nós, é o que faz do MapReduce um favorito entre profissionais de Big Data no mundo todo.
O MapReduce permite uma ampla gama de funcionalidades, incluindo:
- Habilita o processamento paralelo necessário para executar tarefas de Big Data.
- É aplicável a uma grande variedade de aplicações comerciais de processamento de dados.
- É uma solução econômica para frameworks de processamento centralizado.
- Pode ser integrado ao SQL para facilitar capacidades de processamento paralelo.
Cloudera's Distribution Including Apache Hadoop
A Cloudera é uma das pure players históricas do Hadoop, ao lado de Hortonworks e MapR. O grupo, apoiado pela Intel, desenvolve o CDH, uma distribuição do Hadoop que inclui vários outros projetos open source, como o Impala e o Search. A empresa também oferece recursos de segurança e integração.
O framework Impala é um engine de consultas SQL interativas que permite consultas diretas a dados armazenados no HDFS, no Apache HBase ou no AWS S3. Esse engine se apoia em outras tecnologias e componentes do Hive, como sua sintaxe SQL (HiveSQL), o driver Open DataBase Connectivity e a Query UI.
O componente Search é baseado no projeto Apache Solr, um mecanismo de indexação e busca de dados construído sobre o Lucene. A integração dessa tecnologia no CDH dá acesso, por exemplo, a capacidades de indexação em (quase) tempo real e a dados armazenados em um cluster Hadoop ou HBase. A tecnologia Solr permite buscas complexas de texto completo sem necessidade de grandes conhecimentos de SQL. O Solr permite consultar dados do Hadoop sem precisar movê-los antes.
A Cloudera oferece várias edições do CDH, cada uma com diferentes recursos de serviço e gestão de cluster, e níveis variados de suporte:
- Cloudera Express é a versão gratuita do CDH, que inclui os elementos do CDH e as funções centrais do Cloudera Manager. Além disso, oferece acesso a uma versão de avaliação de 30 dias da Enterprise.
- Cloudera Manager é a torre de controle do CDH. A ferramenta fornece um console de administração via web para implantar, gerenciar, monitorar e controlar a saúde das implantações do CDH. Também inclui uma API para configurar o sistema e recuperar métricas e informações sobre a operação de um cluster CDH.
- Cloudera Enterprise é uma versão com licença paga e, portanto, com recursos ampliados. Ela inclui, por exemplo, ferramentas avançadas extraídas do Cloudera Manager e do Navigator.
- Cloudera Manager Advanced Features adiciona recursos-chave ao Cloudera Express: relatórios operacionais, gestão de cotas, logs de configuração, atualizações contínuas, reinícios de serviço, integração com Kerberos, integração com LDAP, suporte a SNMP e recuperação automática de desastres.
- Cloudera Navigator, disponível apenas nas edições Flex e Data Hub, viabiliza a gestão de segurança e governança de dados dentro de uma plataforma CDH. A ferramenta atende às restrições de conformidade das empresas. Com ela, gestores de dados, analistas e administradores podem explorar grandes volumes de dados armazenados no Hadoop e gerenciar com mais facilidade as chaves de criptografia usadas para proteger os dados em um cluster CDH.
Para configurar um ambiente de prova de conceito, você deve primeiro baixar e executar o instalador do Cloudera Manager Server.
- Primeiro, abra Cloudera Manager Downloads no seu navegador. Na caixa do Cloudera Manager, clique em Download Now. Você também pode baixar o instalador para a sua versão do Cloudera Manager. Por exemplo, para o Cloudera Manager 6.3.3:
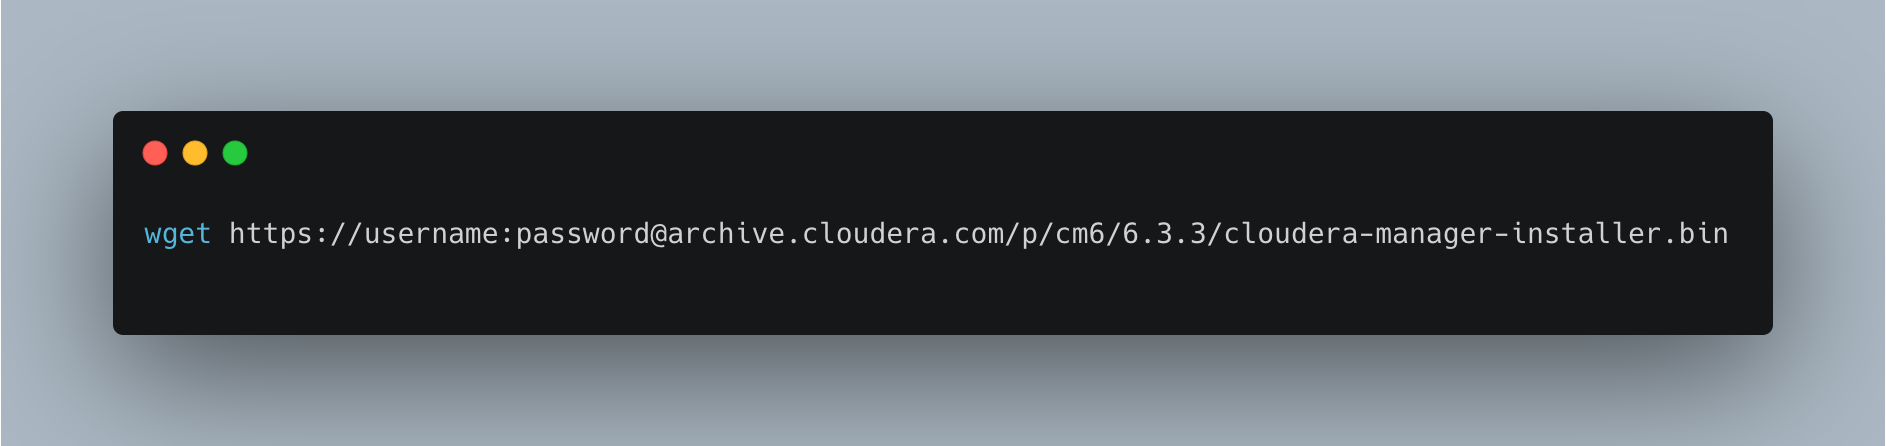
- Em seguida, execute o Cloudera Manager Installer.
Primeiro, altere o Cloudera-manager-installer.bin para ter permissão de execução: chmod u+x Cloudera-manager-installer.bin
Para executar o instalador, use o seguinte comando: sudo ./cloudera-manager-installer.bin --username=username --password=password
- Leia e aceite os contratos de licença associados
O instalador então:
- Instala os arquivos de repositório do Cloudera Manager.
- Instala o Oracle JDK.
- Instala os pacotes do Cloudera Manager Server e do PostgreSQL embutido.
A URL completa do Cloudera Manager Admin Console é exibida ao final da instalação, incluindo o número da porta (7180 por padrão). Primeiro, anote essa URL. Depois, pressione Enter para escolher OK, sair do instalador e confirmar a instalação bem-sucedida.
O próximo passo é instalar o CDH usando o assistente.
- Acesse seu Cloudera Manager Admin Console fazendo login em: HTTP://:7180, onde é o FQDN ou o endereço IP do host em que o Cloudera Manager Server está em execução.
- Entre no Cloudera Manager Admin Console. As credenciais padrão são:
  **Username**: admin
  **Password**: admin
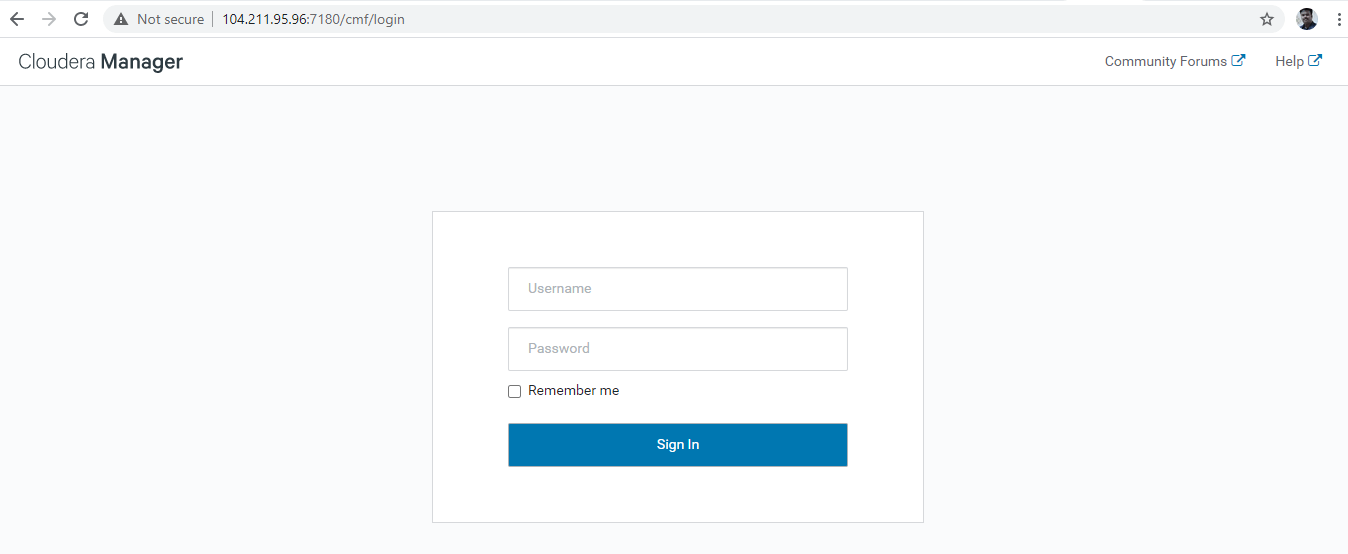
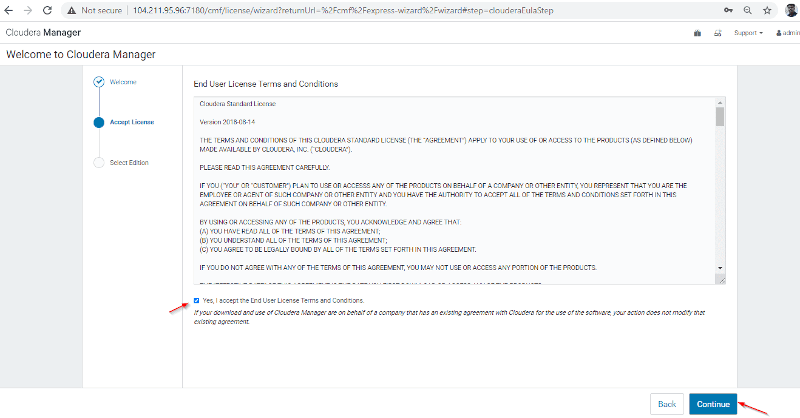
Leia os termos e condições e aceite: clique em Continue e o assistente de instalação será iniciado.
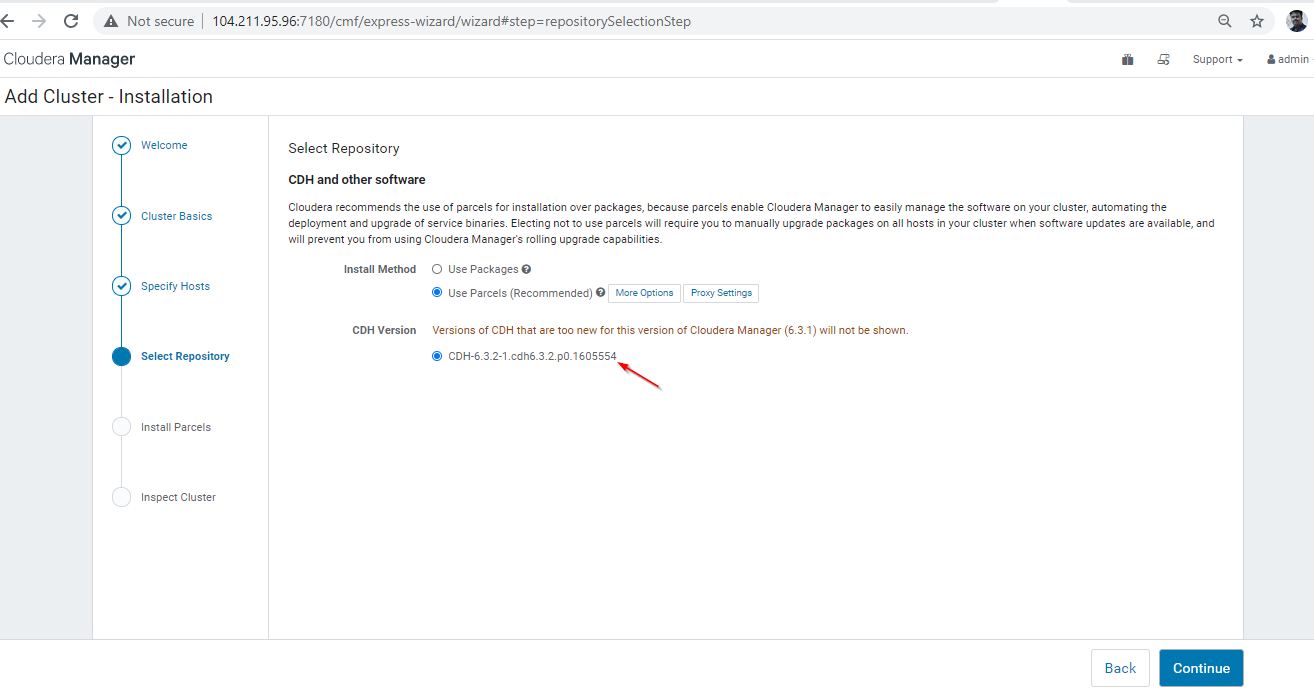
O assistente de instalação do Cloudera Manager vai guiá-lo por uma série de etapas, como: Select Edition Você pode selecionar a edição a ser instalada e, opcionalmente, também instalar uma licença.
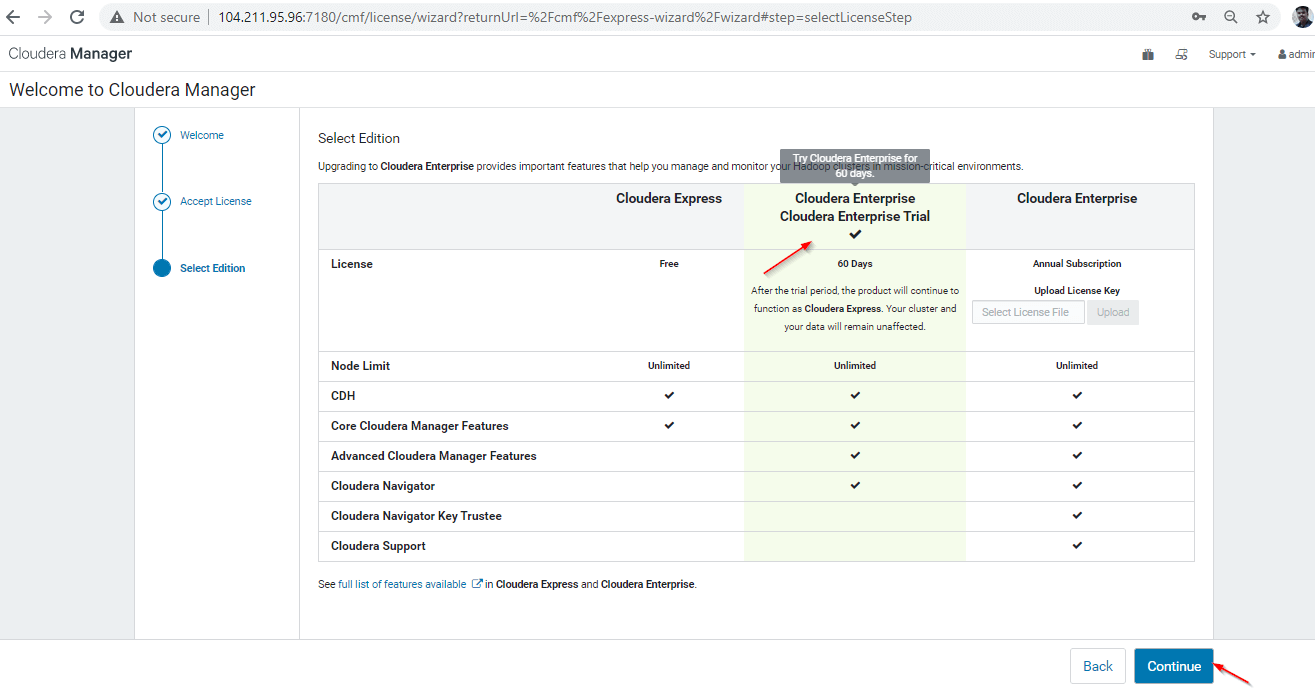
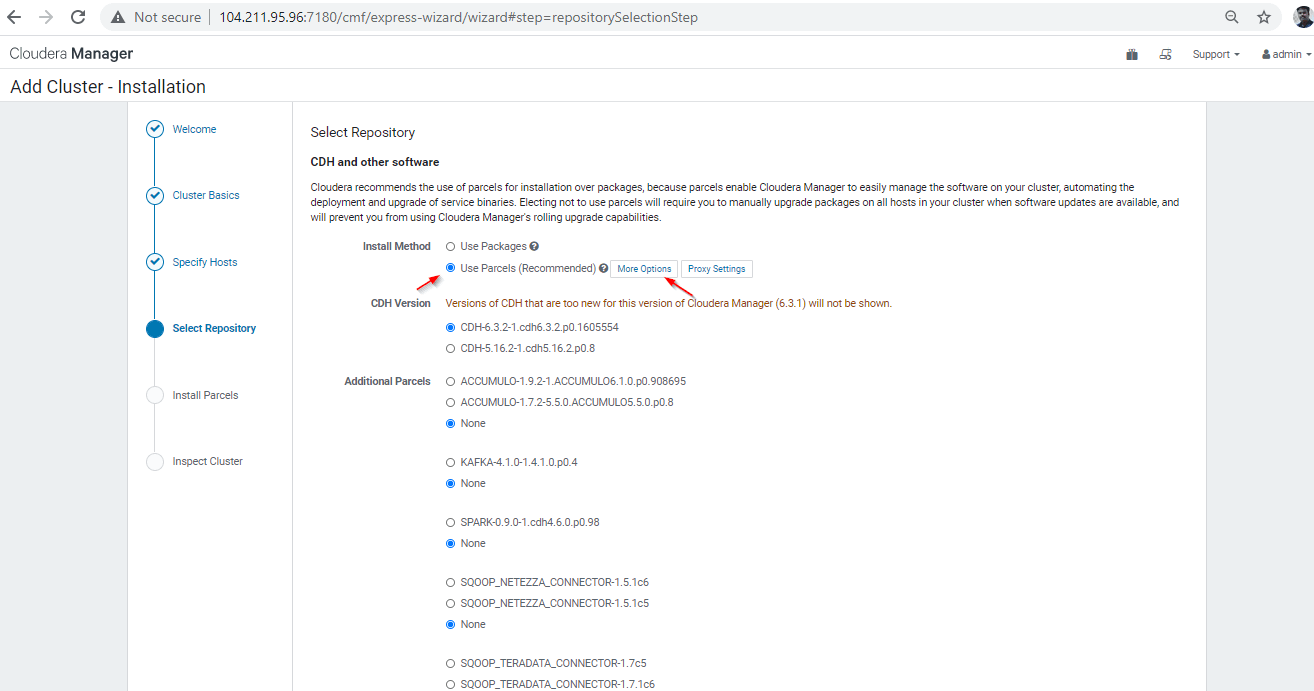
Specify Hosts Escolha quais hosts serão usados para executar o CDH e outros serviços gerenciados. Select Repository Aqui você precisa:
- Primeiro, selecionar o tipo de repositório a ser usado na instalação. Recomenda-se escolher Use Parcels para este cluster de prova de conceito.
- Depois, selecionar a versão do CDH a ser instalada e quaisquer Parcels adicionais que queira incluir.
- Você poderá selecionar a release do Cloudera Manager Agent que deseja instalar.
- Clique em Continue.
Accept JDK License Ao instalar o software JDK, você concorda com o Oracle Binary Code License Agreement. Depois de ler os termos da licença e marcar as caixas aplicáveis, clique em Continue.
Enter Login Credentials Defina uma conta root, nome de usuário, método de autenticação, porta ssh e o número de hosts.
Install Agents A página Install Agents mostra o andamento da instalação. Você pode expandir os detalhes de qualquer host para ver o log da instalação.
Install Parcels A página Install Parcels exibe o progresso da instalação dos parcels selecionados anteriormente. Você pode clicar em qualquer barra de progresso específica para ver detalhes daquele host.
Inspect Hosts A página Inspect Hosts executa o Host Inspector para procurar problemas comuns de configuração. Veja os resultados e resolva quaisquer questões identificadas. Em seguida, clique no botão Run Again para atualizar os resultados após fazer alterações.
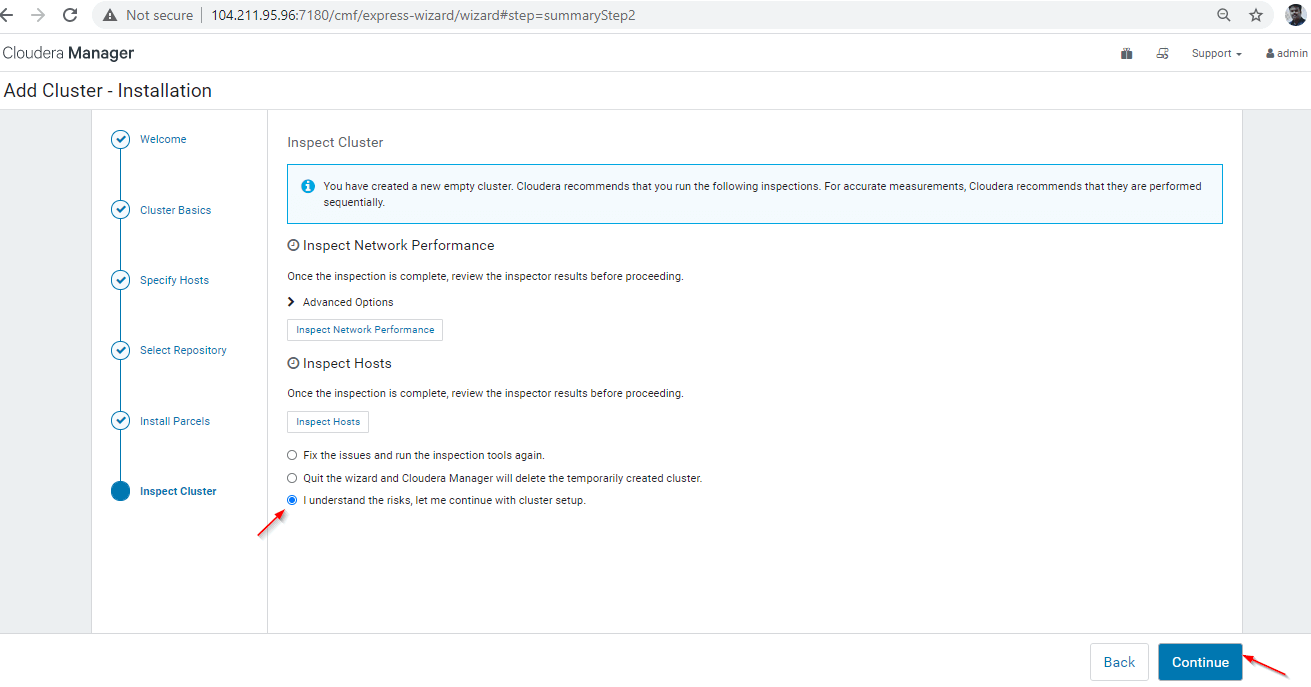
Após concluir todas as etapas acima, o assistente de configuração do cluster será iniciado automaticamente.
Resumo
Os benefícios que o Hadoop traz para as empresas são consideráveis. Graças a esse framework, é viável armazenar e processar grandes quantidades de dados rapidamente, por meio de computação distribuída. Os dados e aplicações em processamento ficam protegidos contra falhas de hardware. Se um nó falhar, os jobs são redirecionados diretamente para outros nós, garantindo que a computação distribuída não pare. Várias cópias de todos os dados são armazenadas automaticamente. Você pode ler mais histórias de sucesso aqui e acompanhar nosso blog para mais novidades sobre data science.
Obtenha a certificação para a função de engenheiro de dados dos seus sonhos
Nossos programas de certificação ajudam você a se destacar e a provar que suas habilidades estão prontas para o trabalho para possíveis empregadores.