Devenez ingénieur en données
L’écosystème d’Apache Hadoop
Hadoop est devenu la norme de facto pour le traitement des données, un peu comme Excel s’est imposé progressivement comme le logiciel de référence pour l’analyse de données. À la différence d’Excel, Hadoop a été conçu par des développeurs et non par des « Business Analysts », alors même que son adoption à grande échelle et son succès reposent largement sur ces derniers. Pour cette raison, les problématiques du Big Data ont été segmentées par fonctions, et pour chaque segment, des technologies basées sur Hadoop ont été développées pour y répondre. L’ensemble de ces outils constitue ce que l’on appelle l’écosystème Hadoop.
L’écosystème Hadoop enrichit Hadoop et lui permet de résoudre une grande variété de cas d’usage métiers. À ce jour, il se compose de centaines de technologies que nous avons choisi de regrouper en 14 catégories selon leurs problématiques : langages d’abstraction, SQL sur Hadoop (Hive et Pig), modèles de calcul (MapReduce et Tez), outils de traitement en temps réel (Storm et Spark Streaming), bases de données (HBase et Cassandra), ingestion en streaming (Kafka et Flume), intégration de données (Sqoop et Talend), orchestration de workflows (Oozie et Control‑M for Hadoop), coordination de services distribués (ZooKeeper), administration de cluster (Ranger et Sentry), interfaces utilisateurs (Hue et Jupyter), indexation de contenus (Elasticsearch et Splunk), systèmes de fichiers distribués (HDFS) et gestionnaires de ressources (YARN et Mesos). Cette section passe en revue la fonction de chacun des outils qui composent cet écosystème de technologies Big Data. Ensuite, si vous souhaitez aller plus loin, nous vous recommandons de lire nos guides sur les différents éléments de l’écosystème Hadoop qui suivront cet article. La carte heuristique ci‑après présente globalement l’écosystème Hadoop.
Carte heuristique de l’écosystème Hadoop
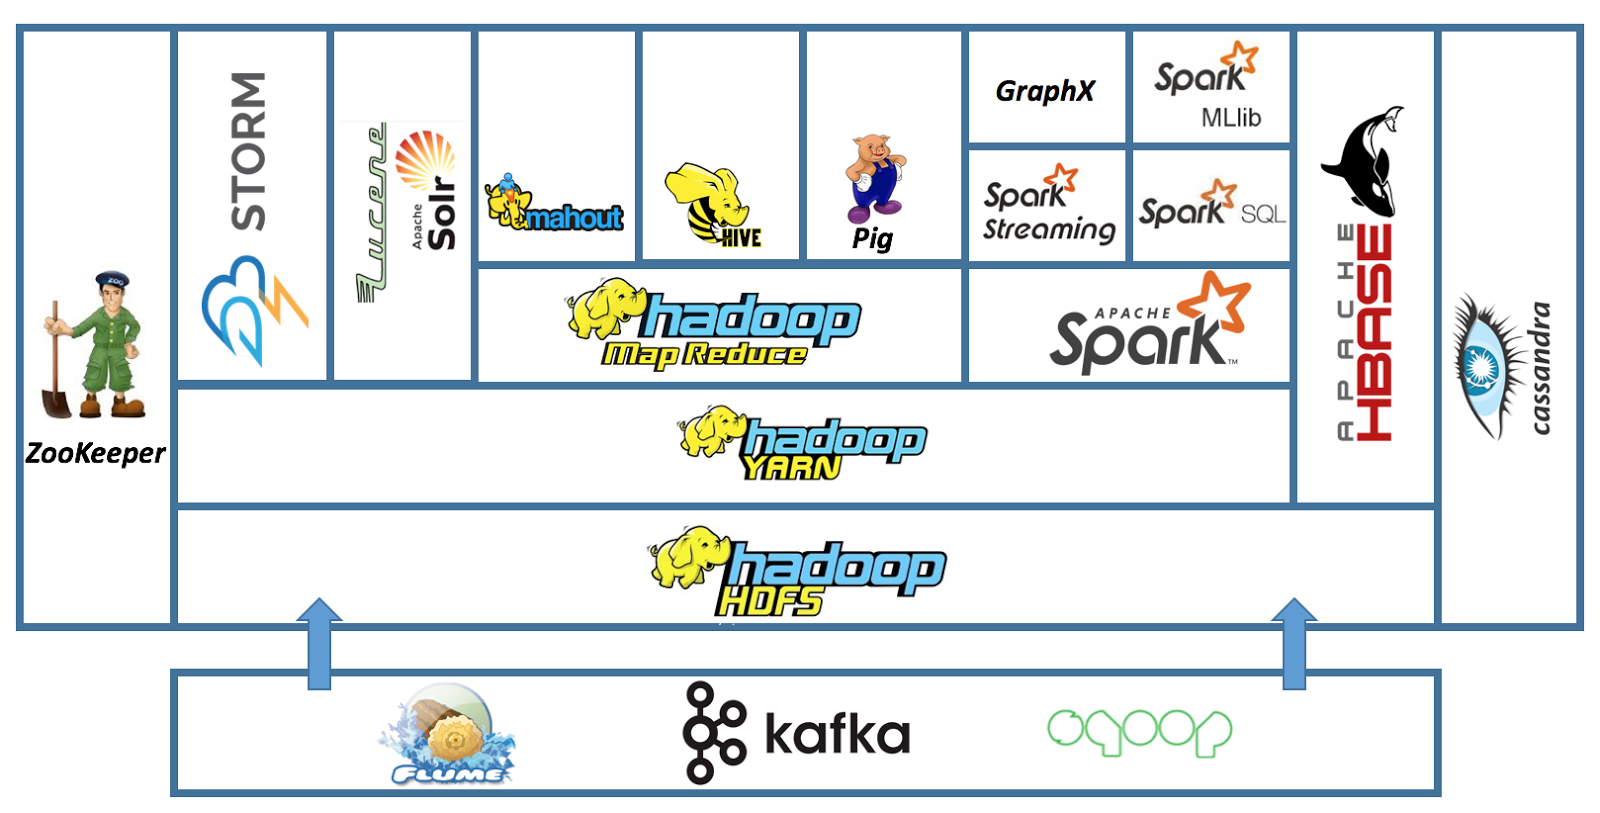
La configuration de base de l’écosystème Hadoop inclut les technologies suivantes : Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie et Kafka.
Spark
Avant d’expliquer ce qu’est Spark, rappelons qu’un algorithme doit être parallélisable pour s’exécuter sur un cluster multi‑nœuds dans Hadoop. Ainsi, un algorithme est dit « scalable » s’il est parallélisable (et peut donc tirer parti de l’évolutivité d’un cluster). Hadoop est une implémentation du modèle de calcul MapReduce. Le problème de MapReduce est qu’il repose sur un graphe orienté acyclique. Autrement dit, la séquence d’opérations MapReduce s’exécute en trois phases séquentielles directes sans détour (Map -> Shuffle -> Reduce) ; aucune phase n’est itérative (ou cyclique).
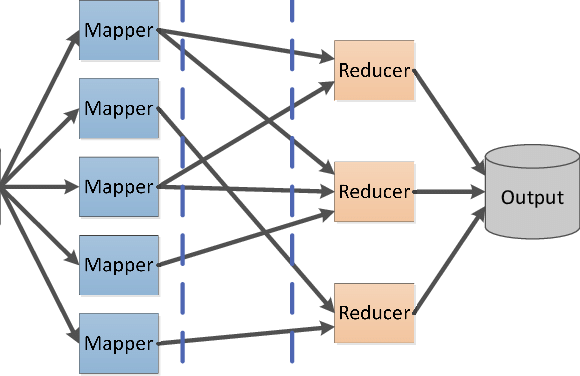
Ce modèle acyclique direct n’est pas adapté à certaines applications, en particulier celles qui réutilisent des données à travers de multiples opérations, comme la plupart des algorithmes d’apprentissage statistique, qui sont itératifs, ainsi que les requêtes d’analyse de données interactives. Spark répond à ces limites : c’est un moteur de calcul qui exécute des traitements distribués en mémoire sur un cluster. En d’autres termes, c’est un moteur de calcul distribué in‑memory. Par rapport à MapReduce, qui fonctionne en mode batch, le modèle de calcul de Spark opère en mode interactif, c’est‑à‑dire qu’il assemble les données en mémoire avant de les traiter ; il est donc particulièrement adapté aux traitements de Machine Learning.
Hive
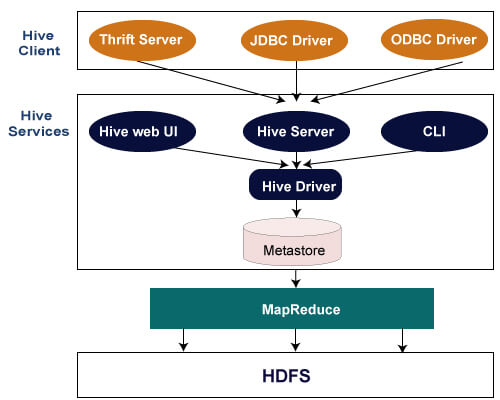
Hive est une infrastructure de calcul proche d’un Data Warehouse qui fournit des services de requête et d’agrégation pour de très grands volumes de données stockées sur un système de fichiers distribué tel que HDFS. Hive propose un langage de requête basé sur SQL (standard ANSI‑92) appelé HiveQL (Hive Query Language), qui cible les données stockées sur HDFS. HiveQL permet également aux utilisateurs avancés/développeurs d’intégrer des fonctions Map et Reduce directement dans leurs requêtes afin de couvrir un spectre plus large de problématiques de gestion des données. Lorsque vous écrivez une requête en HiveQL, celle‑ci est transformée en job MapReduce et soumise au JobTracker pour exécution par Hive.
Pig
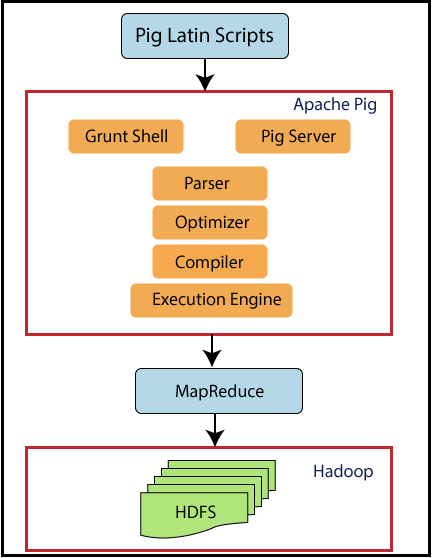
Pig est un environnement interactif d’exécution de flux de données sous Hadoop. Il se compose de deux éléments : un langage d’expression des flux de données appelé Pig Latin, et un environnement interactif d’exécution de ces flux.
Le langage proposé par Pig, Pig Latin, est globalement comparable aux langages de script comme Perl, Python ou Ruby. Il est toutefois plus spécifique et se décrit mieux comme un « langage de flux de données ». Il permet d’écrire des requêtes sous forme de chaînes séquentielles de données sources pour obtenir des données « cibles » sous Hadoop, à la manière d’un ETL. Ces flux sont ensuite transformés en fonctions MapReduce puis soumis au job tracker pour exécution. En résumé, Pig est l’ETL de Hadoop. Programmer en Pig Latin consiste à décrire, dans des flux indépendants mais imbriqués, la façon dont les données sont chargées, transformées et agrégées via des instructions spécifiques à Pig, appelées opérateurs. Maîtriser ces opérateurs est la clé pour bien programmer en Pig Latin, d’autant qu’ils sont moins nombreux que dans Hive.
HBase
Avant d’évoquer HBase, rappelons que les SGBDR, longtemps utilisés pour la gestion des données, ont rapidement montré leurs limites face au volume et à la variété croissants des données. En effet, les SGBDR sont conçus pour gérer uniquement des données structurées (tables en lignes/colonnes) ; de plus, l’augmentation du volume accroît la latence des requêtes. Cette latence est pénalisante pour de nombreux métiers qui exigent des réponses quasi temps réel. De nouveaux SGBD dits « NoSQL » ont été développés pour pallier ces limites. Ils n’imposent pas de structure particulière aux données, peuvent répartir stockage et gestion sur plusieurs nœuds, et sont scalables. Pour mémoire, l’évolutivité signifie que les performances du système restent stables à mesure que la charge augmente. HBase appartient à cette catégorie de SGBD.
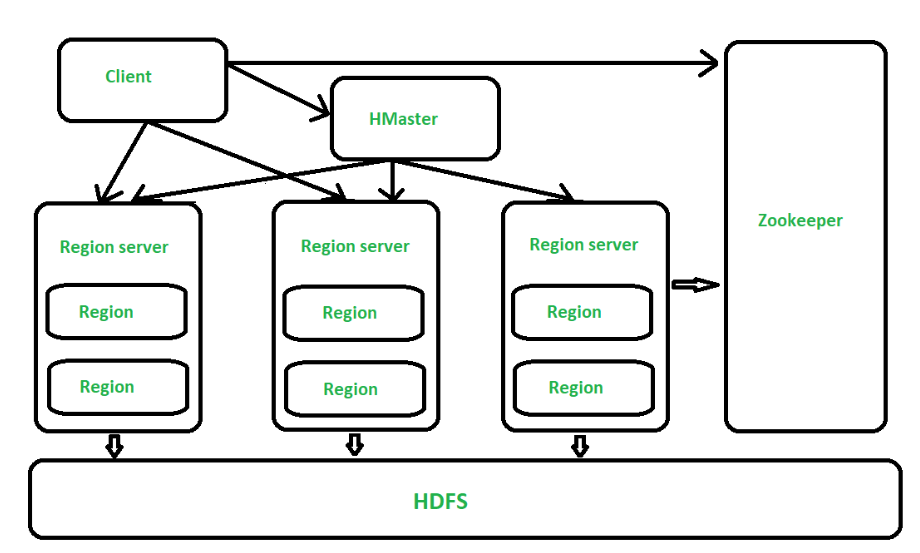
HBase est un SGBD distribué orienté colonnes qui fournit un accès en lecture/écriture en temps réel aux données stockées sur HDFS. HDFS offre un accès séquentiel en mode batch, peu adapté aux besoins d’accès rapide comme le streaming ; HBase comble ces lacunes et fournit un accès rapide aux données stockées sur HDFS.
HBase s’appuie sur le SGBD « Bigtable » de Google et peut stocker des volumes très importants (milliards de lignes/colonnes). Il dépend de ZooKeeper, un service de coordination distribué pour le développement d’applications.
Sqoop
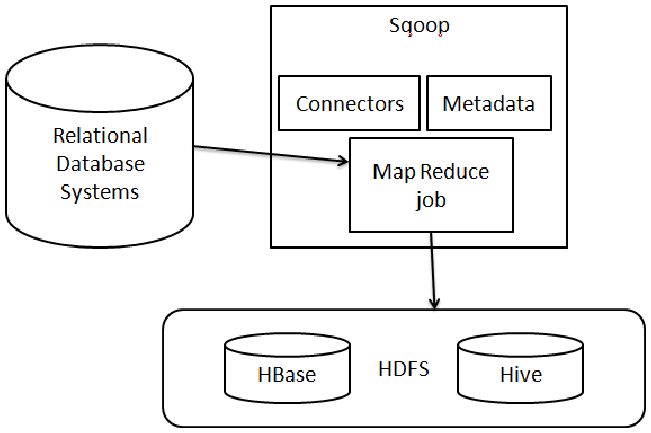
Sqoop, ou SQL‑to‑Hadoop, est un outil qui transfère des données d’une base relationnelle vers HDFS de Hadoop et inversement. Il s’intègre à l’écosystème Hadoop et fait office d’ordonnanceur d’ingestion de données dans Hadoop. Vous pouvez utiliser Sqoop pour importer des données de SGBDR tels que MySQL, Oracle ou SQL Server vers HDFS, transformer les données dans Hadoop via MapReduce ou un autre modèle de calcul, puis les ré‑exporter vers le SGBDR. On parle d’ordonnanceur d’ingestion car, à l’instar d’Oozie, il automatise ce processus d’import/export et en planifie l’exécution. En tant qu’utilisateur, il vous suffit d’écrire les requêtes SQL servant aux mouvements d’import/export. Par ailleurs, Sqoop utilise MapReduce pour importer et exporter les données, ce qui est à la fois performant et tolérant aux pannes.
Storm
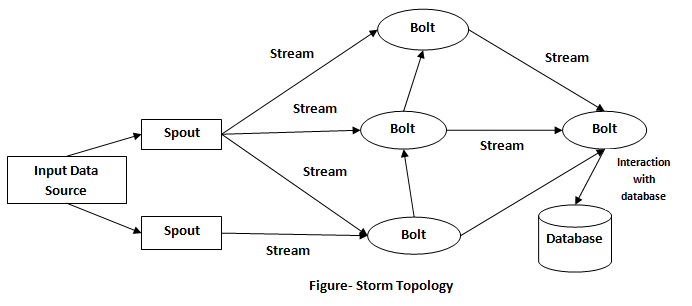
Pour comprendre Storm, il faut appréhender le concept d’architectures lambda (λ) et leur intérêt. Il faut aussi comprendre la notion d’objets connectés. Les objets connectés ou Internet of Things (IoT) représentent l’extension d’Internet à notre quotidien. Ils génèrent des données en flux continu et exigent, dans la plupart des cas, un traitement en temps réel. Les modèles que vous connaissez, comme le batch, ne sont pas adaptés aux enjeux temps réel soulevés par l’IoT. Même les modèles de calcul interactifs ne conviennent pas à un traitement continu en temps réel. À la différence des données opérationnelles produites par les systèmes métiers d’une entreprise (finance, marketing, etc.) qui, même en streaming, peuvent être historisées pour un traitement ultérieur, les données produites en continu par des phénomènes comme l’IoT expirent (ou perdent leur validité) dans les instants qui suivent leur création et nécessitent donc un traitement immédiat. Au‑delà des objets connectés, des problématiques métier comme la lutte contre la fraude, l’analyse des réseaux sociaux ou la géolocalisation requièrent des temps de réponse très faibles, de l’ordre de la seconde. Pour répondre à ces besoins en contexte Big Data, des architectures dites λ ont été développées. Elles ajoutent deux couches de traitement supplémentaires à MapReduce afin de réduire la latence. Storm est une implémentation logicielle de l’architecture λ. Il permet de développer, sous Hadoop, des applications qui traitent les données en temps réel (ou quasi temps réel).
ZooKeeper
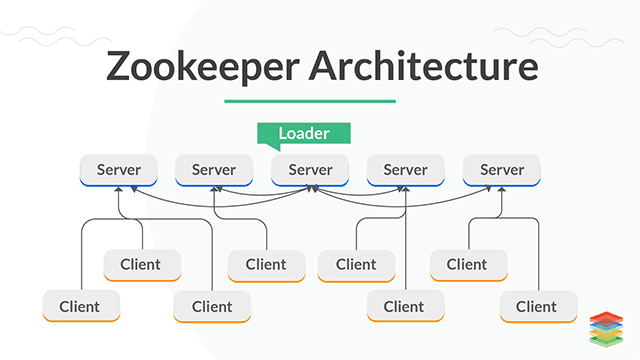
La synchronisation ou la coordination de la communication entre nœuds lors de l’exécution de tâches parallèles est l’un des problèmes les plus complexes du développement d’applications distribuées. Pour y répondre, Hadoop intègre dans son écosystème des outils de coordination de services, en l’occurrence ZooKeeper. ZooKeeper prend en charge la complexité inhérente à la synchronisation de l’exécution de jobs distribués dans le cluster, ce qui évite aux autres outils de l’écosystème Hadoop de gérer eux‑mêmes ce problème. Il permet aussi aux utilisateurs de développer des applications distribuées sans être experts en programmation distribuée. Sans entrer dans les détails complexes de la coordination des données entre nœuds d’un cluster Hadoop, ZooKeeper fournit un service de configuration distribué, un service de distribution et un annuaire de noms pour applications distribuées. ZooKeeper est le mécanisme par lequel Hadoop coordonne les jobs distribués.
Oozie
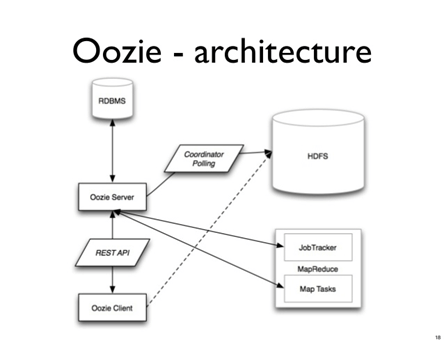
Par défaut, Hadoop exécute les jobs au fur et à mesure de leur soumission sans tenir compte des relations éventuelles entre eux. Or, les problématiques pour lesquelles Hadoop est utilisé nécessitent généralement l’écriture d’un ou plusieurs jobs complexes. Lorsque deux jobs sont soumis au JobTracker (ou à YARN), celui‑ci les exécute sans prêter attention au lien qui les unit, ce qui peut provoquer une erreur (exception) et arrêter le code. Comment gérer l’exécution de plusieurs jobs liés au même problème ? La solution la plus simple aujourd’hui consiste à utiliser un ordonnanceur de jobs, en l’occurrence Oozie.
Oozie est un ordonnanceur qui s’exécute en tant que service sur un cluster Hadoop. Il sert à planifier les jobs Hadoop et, plus généralement, l’exécution de tous les jobs pouvant tourner sur un cluster : script Hive, job MapReduce, job Hama, job Storm, etc. Il a été conçu pour gérer automatiquement l’exécution immédiate ou différée de milliers de jobs interdépendants sur un cluster Hadoop. Pour utiliser Oozie, il suffit de configurer deux fichiers XML : un fichier de configuration du moteur Oozie et un fichier de configuration du workflow de jobs.
Présentation de Cloudera
Cloudera est une entreprise américaine basée en Californie, dédiée au développement d’une solution Big Data historiquement fondée sur le framework distribué Hadoop ; elle se réoriente désormais vers le cloud. Depuis plus d’un an, Cloudera étend sa solution sur les clouds publics AWS, Azure et GCP.
Présentation de CDP
Cloudera Data Platform (CDP) est une plateforme qui permet aux entreprises d’analyser les données en self‑service dans des environnements hybrides et multi‑cloud. Elle permet aux organisations de tirer davantage de valeur de l’ensemble de leurs données en créant des data lakes dans le cloud en quelques heures.
CDP fournit des outils intégrés, multi‑fonctionnels et en self‑service pour analyser et centraliser les données. Elle offre en outre des fonctions de sécurité et de gouvernance à l’échelle de l’entreprise et peut être déployée sur des environnements publics, privés et multi‑cloud. CDP succède aux deux distributions Hadoop précédentes de Cloudera : Cloudera Distribution of Hadoop (CDH) et Hortonworks Data Platform (HDP).
L’accès en self‑service aux données de l’entreprise est au cœur du service. Les nouveaux services cloud intégrés à la plateforme offrent également un accès en self‑service aux données et à l’analytique pour les analystes, data scientists, équipes IT et développeurs. Les trois services Cloud‑Native mis en avant par Cloudera distinguent la plateforme : self‑service, multi‑cloud et sécurité.
CDP propose une approche public‑privé unique, de l’analytique en temps réel, des options de déploiement évolutives sur site, dans le cloud et en mode hybride, ainsi qu’une architecture « privacy‑first ».
CDP Public Cloud
CDP Public Cloud est une offre Platform‑as‑a‑Service (PaaS) compatible avec les infrastructures cloud et facilement portable entre divers fournisseurs, y compris des solutions privées comme OpenShift. CDP a été conçu pour être entièrement hybride et multi‑cloud : une seule plateforme peut gérer l’ensemble des cas d’usage du cycle de vie des données. La plateforme CDP fonctionne avec des données dans de nombreux environnements, notamment les clouds publics comme AWS, Azure et GCP. Elle peut en outre adapter automatiquement les charges et les ressources à la hausse ou à la baisse pour améliorer les performances et réduire les coûts.
Services CDP Public Cloud
Voici les principaux composants qui composent CDP Public Cloud :
-
CDP Data Engineering est une configuration tout‑en‑un. Il est bâti sur Apache Spark. Il rationalise les processus ETL à l’échelle des équipes d’analyse en permettant l’orchestration et l’automatisation avec Apache Airflow, et propose des outils avancés de supervision de pipelines, de débogage visuel et de gestion. Il offre en outre des environnements de travail isolés et est conteneurisé, scalable et facilement portable.
-
CDP Data Hub est un service qui permet des analyses à forte valeur, de l’Edge à l’IA. Cloudera Data Hub est un service cloud‑native de gestion et d’analyse des données. Il permet aux équipes IT et aux développeurs métier de créer plus rapidement des applications pour tous les scénarios, du streaming à l’ETL. Data marts, bases de données et Machine Learning font partie des services couverts au sein d’un large éventail de charges analytiques.
-
CDP Data Warehouse est un service qui permet à l’IT de proposer une expérience analytique en self‑service, cloud‑native, pour les analystes BI. Le streaming, l’ingénierie des données et l’analytique sont pleinement intégrés à CDP Data Warehouse. Il dispose en outre d’un cadre unifié pour sécuriser et gouverner toutes vos données et métadonnées, qu’elles soient sur site, sur plusieurs clouds publics ou en mode hybride. Le service Cloudera Data Warehouse facilite le déploiement d’entrepôts de données en self‑service pour les analystes. Il s’appuie sur des moteurs SQL robustes, éprouvés en entreprise. Des centaines d’utilisateurs peuvent accéder aux données en un clic, sur site comme dans le cloud. Les ressources se dimensionnent à la demande, et la gestion des charges est également en self‑service via des outils intuitifs.
-
CDP Machine Learning simplifie le déploiement d’espaces de travail collaboratifs de Machine Learning afin de permettre aux data scientists d’exploiter les données de l’entreprise. Il optimise les workflows ML grâce à des outils natifs et complets pour déployer, distribuer et superviser les modèles. Avec cet outil, les organisations peuvent déployer rapidement de nouveaux espaces de travail de Machine Learning en quelques clics pour offrir un accès en self‑service aux outils et aux données nécessaires. De plus, la réplication de données sur site ou dans le cloud se fait rapidement sans compromettre sécurité et gouvernance. Les data scientists peuvent également choisir leurs outils tout en profitant de ressources élastiques adaptées à leurs besoins. L’entraînement, l’ingénierie des données, le déploiement et la gestion des modèles se font rapidement via une interface tout‑en‑un, sans changer de plateforme.
-
Cloudera Data Visualization permet de modéliser les données dans l’entrepôt virtuel sans déplacer ni modifier les structures ou tables sous‑jacentes, et d’interroger de grands volumes sans chargements constants, ce qui fait gagner du temps et réduit les coûts.
-
Cloudera Operational Database est une solution managée qui synthétise l’instance de cluster sous‑jacente en une base de données. Elle s’adapte automatiquement en fonction de l’utilisation du cluster, améliore les performances à empreinte identique et résout automatiquement les problèmes opérationnels.
CDP Private Cloud
CDP Private Cloud est particulièrement adapté aux déploiements hybrides, permettant de connecter l’on‑premise aux clouds publics tout en conservant une sécurité et une gouvernance cohérentes et intégrées. Le calcul et le stockage sont découplés dans CDP Private Cloud, ce qui permet à chaque cluster de monter en charge indépendamment. Disponible sur un cluster CDP Private Cloud Base, Cloudera Shared Data Experience (SDX) fournit une sécurité, une gouvernance et une gestion des métadonnées unifiées. En outre, les utilisateurs de CDP Private Cloud peuvent provisionner et déployer rapidement les services Cloudera Data Warehousing et Cloudera Machine Learning, puis les faire évoluer selon les besoins via Management Console.
Services CDP Private Cloud
Certains composants de CDP Public Cloud, tels que Machine Learning et Data Warehouse, sont disponibles sur CDP Private Cloud. Il s’appuie sur un ensemble de moteurs analytiques couvrant le streaming, l’ingénierie des données, les data marts, les bases de données opérationnelles et la data science pour prendre en charge les charges traditionnelles.
Notions essentielles de HDFS et MapReduce
HDFS est le système de fichiers distribué d’Hadoop et l’élément central qui permet de stocker et répliquer les données sur plusieurs serveurs. Combiné à YARN, il accroît les capacités de gestion des données du cluster Hadoop HDFS et permet ainsi un traitement Big Data efficace.
Vous pouvez exécuter HDFS sur du matériel standard, ce qui le rend très tolérant aux pannes. Chaque portion de données est stockée en plusieurs endroits et peut être récupérée en toutes circonstances. Cette réplication permet également de lutter contre la corruption potentielle des données.
HDFS utilise un NameNode et des DataNodes. Le DataNode est un serveur standard sur lequel les données sont stockées. Le NameNode contient les métadonnées (localisation des données sur les différents nœuds). L’application n’interagit qu’avec le NameNode, qui communique avec les nœuds de données selon les besoins.
HDFS évite aussi la congestion réseau en privilégiant les déplacements des opérations plutôt que des données. Cela signifie que les applications accèdent aux données là où elles se trouvent. Dernier atout : sa portabilité. Il fonctionne sur différents types de matériels sans problème de compatibilité.
Qu’est‑ce que MapReduce et comment ça marche ?
MapReduce est le moteur de traitement d’Apache Hadoop, directement dérivé de MapReduce de Google. Les applications MapReduce sont essentiellement écrites en Java. Il permet de traiter aisément d’énormes volumes de données en appliquant des étapes de mappage et de réduction pour résoudre le problème posé. L’étape de mappage prend un jeu de données et le convertit en un autre jeu en décomposant les éléments individuels en paires clé/valeur, appelées tuples. La seconde étape de réduction prend la sortie issue du mappage et combine ces tuples en un ensemble plus restreint.
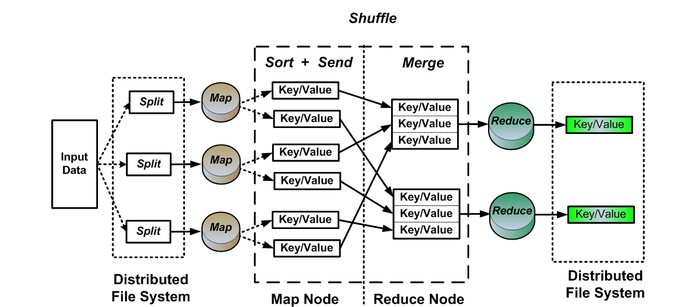
MapReduce est un cadre de traitement hautement parallèle qui peut se dimensionner facilement sur d’immenses parcs de matériel standard pour répondre au besoin croissant de traitement de grands volumes de données. Une fois les tâches de mappage et de réduction stabilisées, une simple modification de configuration suffit pour exécuter sur un jeu de données plus volumineux. Ce type d’évolutivité extrême, d’un seul nœud à des centaines voire des milliers, fait de MapReduce un favori des professionnels du Big Data dans le monde entier.
MapReduce offre un large éventail de fonctionnalités, notamment :
- le traitement parallèle nécessaire aux tâches Big Data ;
- une applicabilité à une grande variété d’applications de traitement de données métiers ;
- une solution économique pour des cadres de traitement centralisés ;
- une intégration possible avec SQL pour faciliter le traitement parallèle.
Cloudera’s Distribution Including Apache Hadoop
Cloudera est l’un des pure players historiques d’Hadoop, aux côtés de Hortonworks et MapR. Le groupe, soutenu par Intel, développe CDH, une distribution d’Hadoop qui inclut plusieurs autres projets open source, tels qu’Impala et Search. Il propose également des fonctionnalités de sécurité et d’intégration.
Le framework Impala est un moteur de requêtes SQL interactif qui permet d’interroger directement les données stockées dans HDFS, Apache HBase ou AWS S3. Ce moteur s’appuie sur d’autres technologies et composants de Hive, comme sa syntaxe SQL (HiveSQL), le pilote ODBC et l’interface de requêtes.
Le composant Search repose sur le projet Apache Solr, un moteur d’indexation et de recherche construit sur Lucene. L’intégration de cette technologie dans CDH donne accès, par exemple, à des capacités d’indexation (quasi) temps réel et à l’accès aux données stockées dans un cluster Hadoop ou HBase. Solr permet d’effectuer des recherches full‑text complexes sans compétences SQL poussées. Solr autorise l’interrogation des données Hadoop, sans avoir à les déplacer au préalable.
Cloudera propose plusieurs éditions de CDH, chacune avec des fonctionnalités de service et de gestion de cluster différentes, et des niveaux de support variés :
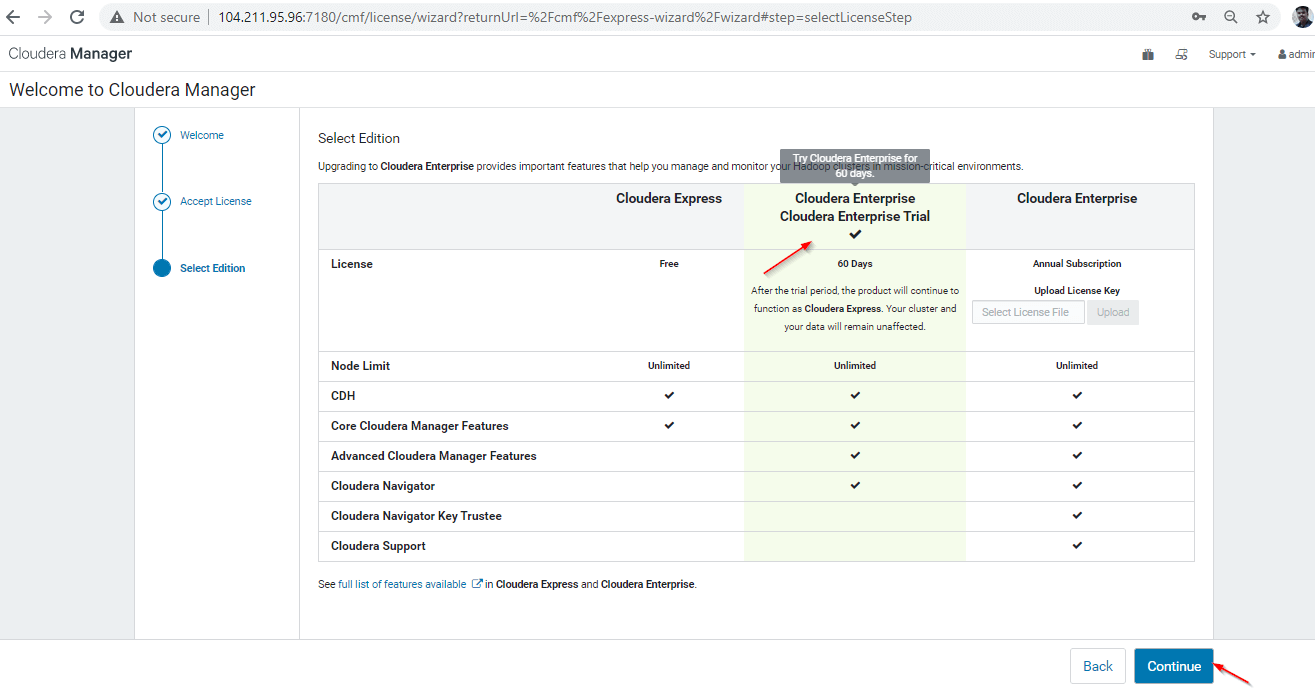
- Cloudera Express est la version gratuite de CDH, qui inclut les éléments de CDH et les fonctions de base de Cloudera Manager. Elle donne aussi accès à une version d’évaluation de 30 jours de l’édition Enterprise.
- Cloudera Manager est la tour de contrôle de CDH. L’outil fournit une console d’administration web pour déployer, gérer, superviser et contrôler l’état de santé des déploiements CDH. Il inclut également une API pour configurer le système et récupérer des métriques et informations sur le fonctionnement d’un cluster CDH.
- Cloudera Enterprise est une version sous licence payante, donc avec des fonctionnalités étendues. Elle inclut par exemple des outils avancés issus de Cloudera Manager et Navigator.
- Cloudera Manager Advanced Features ajoute des fonctionnalités clés à Cloudera Express : rapports opérationnels, gestion des quotas, journaux de configuration, mises à jour continues, redémarrages de services, intégration Kerberos, intégration LDAP, support SNMP et reprise automatique après sinistre.
- Cloudera Navigator, proposé uniquement avec les éditions Flex et Data Hub, permet la gestion de la sécurité et de la gouvernance des données au sein d’une plateforme CDH. L’outil répond aux contraintes de conformité des entreprises. Il aide les responsables de données, analystes et administrateurs à explorer de grands volumes de données stockées dans Hadoop et à gérer plus facilement les clés de chiffrement utilisées pour sécuriser les données d’un cluster CDH.
Pour mettre en place un environnement de preuve de concept, vous devez d’abord télécharger et exécuter l’installateur Cloudera Manager Server.
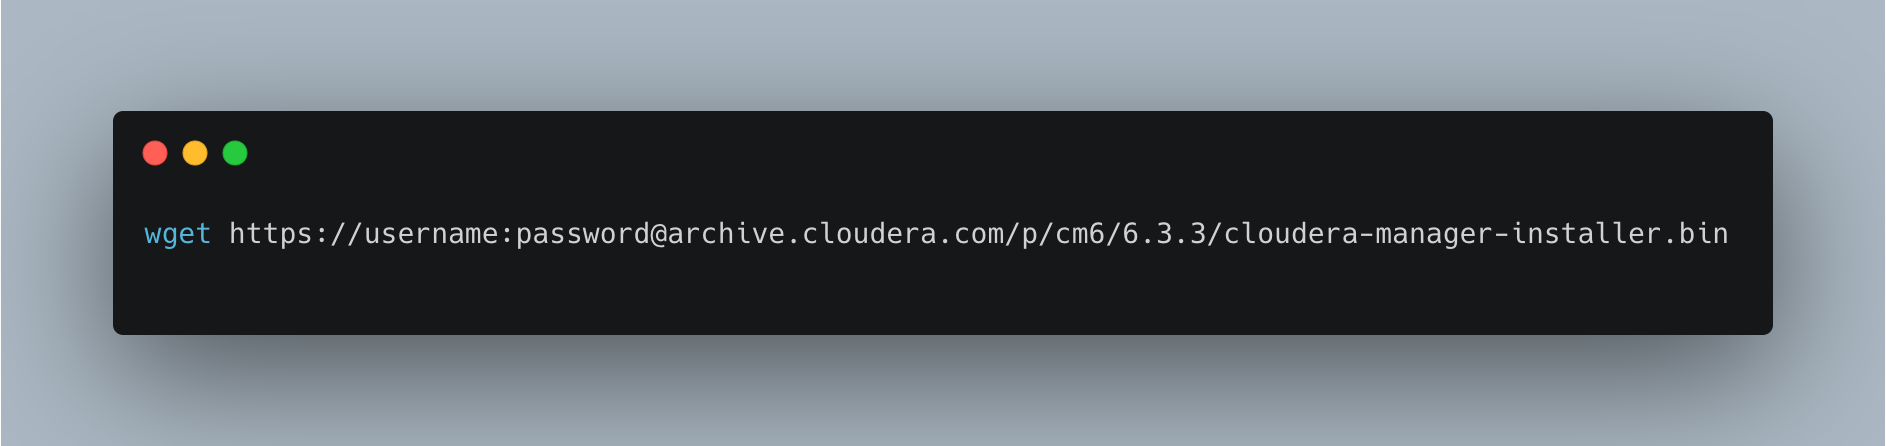
- Commencez par ouvrir Cloudera Manager Downloads dans votre navigateur. Dans l’encadré Cloudera Manager, cliquez sur Download Now. Vous pouvez aussi télécharger l’installateur correspondant à votre version de Cloudera Manager. Par exemple, pour Cloudera Manager 6.3.3 :
- Ensuite, exécutez l’installateur Cloudera Manager.
Tout d’abord, rendez le fichier Cloudera-manager-installer.bin exécutable : chmod u+x Cloudera-manager-installer.bin
Pour lancer l’installateur, utilisez la commande suivante : sudo ./cloudera-manager-installer.bin --username=username --password=password
- Lisez et acceptez les contrats de licence associés
L’installateur :
- installe les fichiers de dépôt Cloudera Manager ;
- installe l’Oracle JDK ;
- installe Cloudera Manager Server et les packages PostgreSQL embarqués.
L’URL complète de la console d’administration Cloudera Manager s’affiche à la fin de l’installation, y compris le port (7180 par défaut). Notez cette URL. Puis appuyez sur Entrée pour valider OK, quitter l’installateur et confirmer la réussite de l’installation.
L’étape suivante consiste à installer CDH via l’assistant.
- Accédez à votre Cloudera Manager Admin Console en vous connectant à : HTTP://:7180, où est le FQDN ou l’adresse IP de l’hôte sur lequel s’exécute Cloudera Manager Server.
- Connectez‑vous à Cloudera Manager Admin Console. Les identifiants par défaut sont :
  **Username**: admin
  **Password**: admin
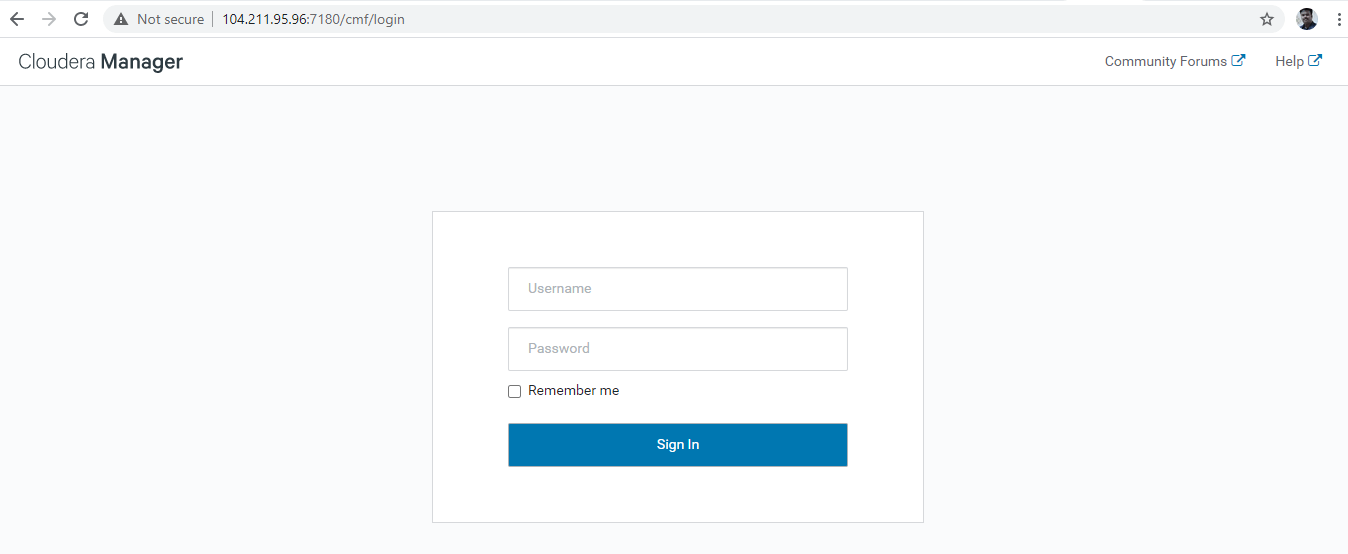
Lisez et acceptez les conditions générales : cliquez sur Continue, l’assistant d’installation démarre.
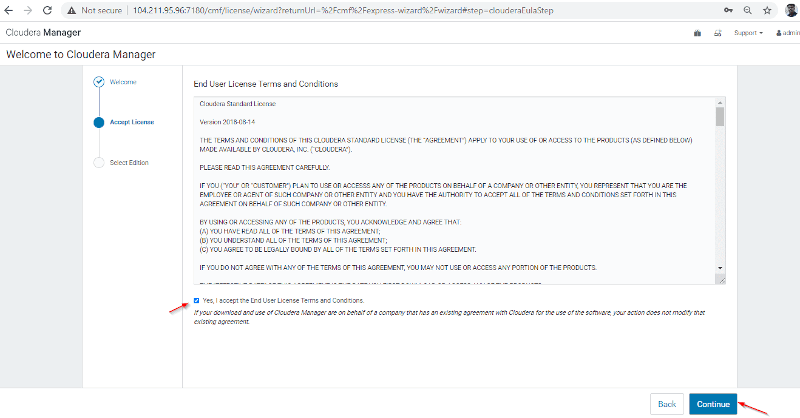
L’assistant d’installation de Cloudera Manager vous guide au travers des étapes suivantes : Select Edition Sélectionnez l’édition à installer et, si vous le souhaitez, installez une licence.
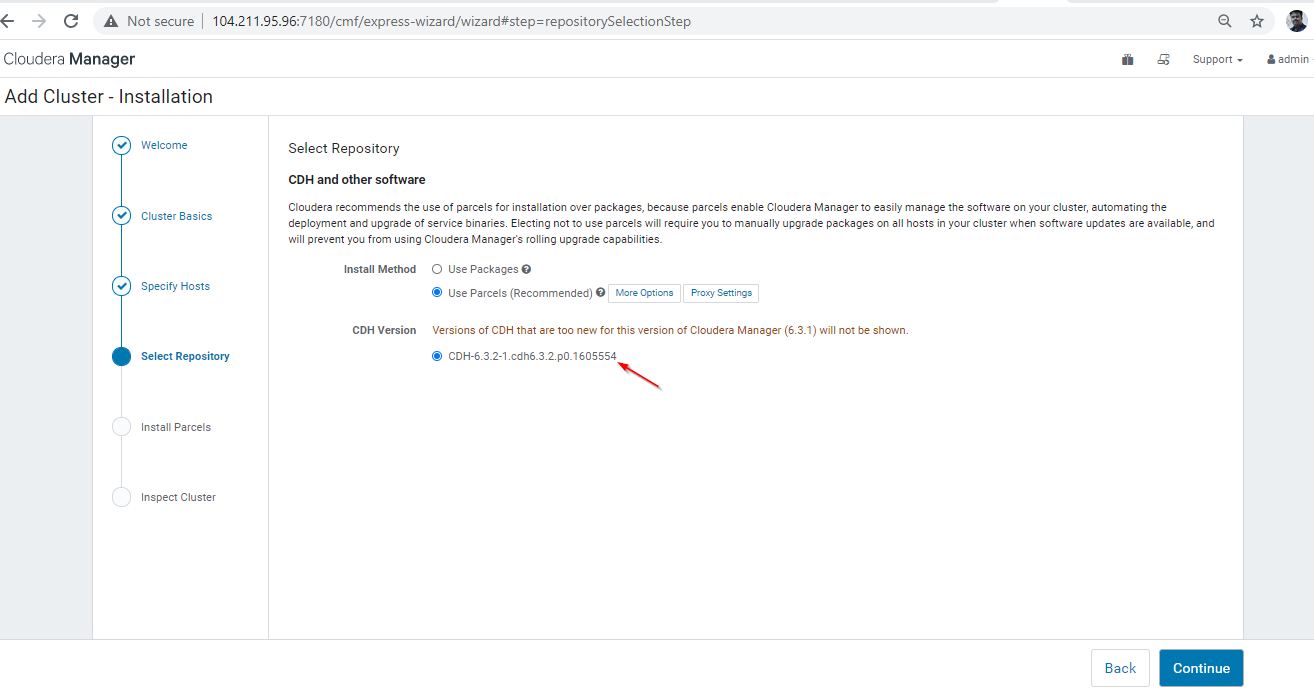
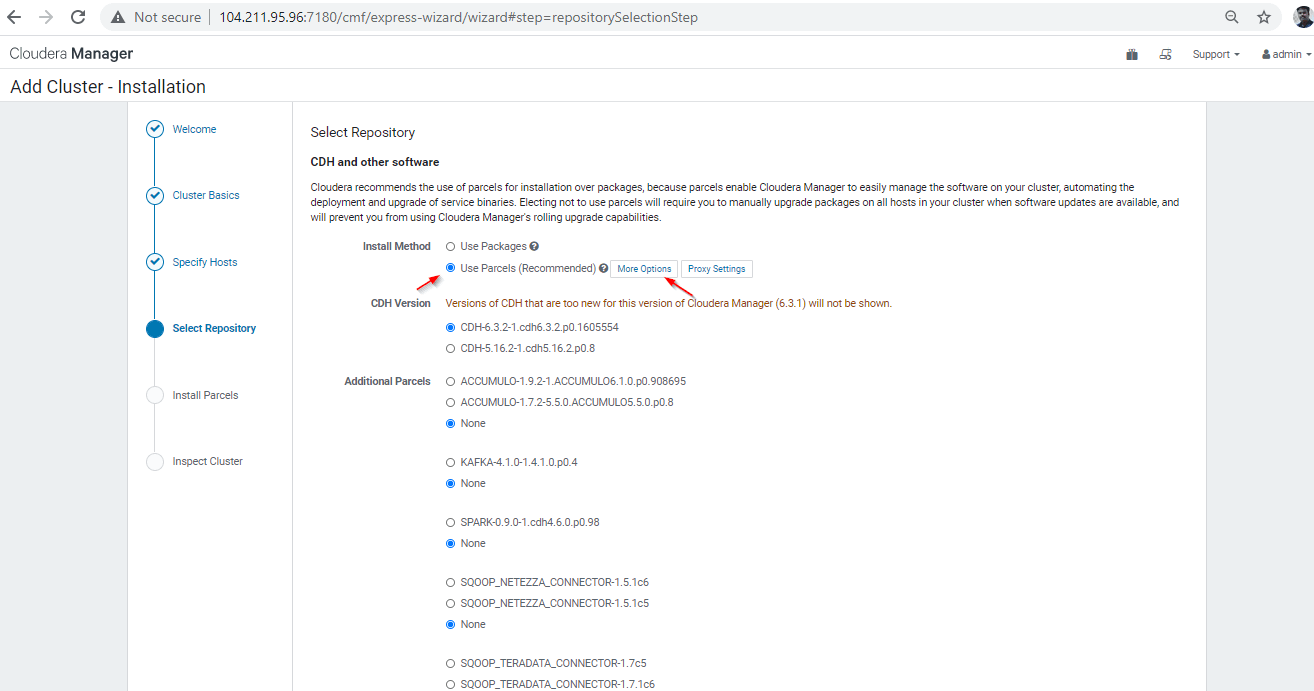
Specify Hosts Choisissez les hôtes qui exécuteront CDH et les autres services managés. Select Repository Ici, vous devez :
- sélectionner le type de dépôt à utiliser pour l’installation. Pour ce cluster de preuve de concept, il est recommandé de choisir Use Parcels ;
- sélectionner la version de CDH à installer et les Parcels additionnels à ajouter ;
- choisir la version de Cloudera Manager Agent à installer ;
- cliquer sur Continue.
Accept JDK License En installant le JDK, vous acceptez d’être lié par l’Oracle Binary Code License Agreement. Après lecture et validation des cases applicables, cliquez sur Continue.
Enter Login Credentials Définissez un compte root, un nom d’utilisateur, une méthode d’authentification, le port SSH et le nombre d’hôtes.
Install Agents La page Install Agents affiche la progression de l’installation. Vous pouvez déplier le détail pour chaque hôte afin de consulter le journal d’installation.
Install Parcels La page Install Parcels affiche la progression d’installation des parcels sélectionnés plus tôt. Vous pouvez cliquer sur une barre de progression pour obtenir des détails sur l’hôte concerné.
Inspect Hosts La page Inspect Hosts exécute le Host Inspector pour rechercher les problèmes de configuration courants. Consultez les résultats et corrigez les problèmes identifiés. Cliquez ensuite sur Run Again pour mettre à jour les résultats après vos modifications.
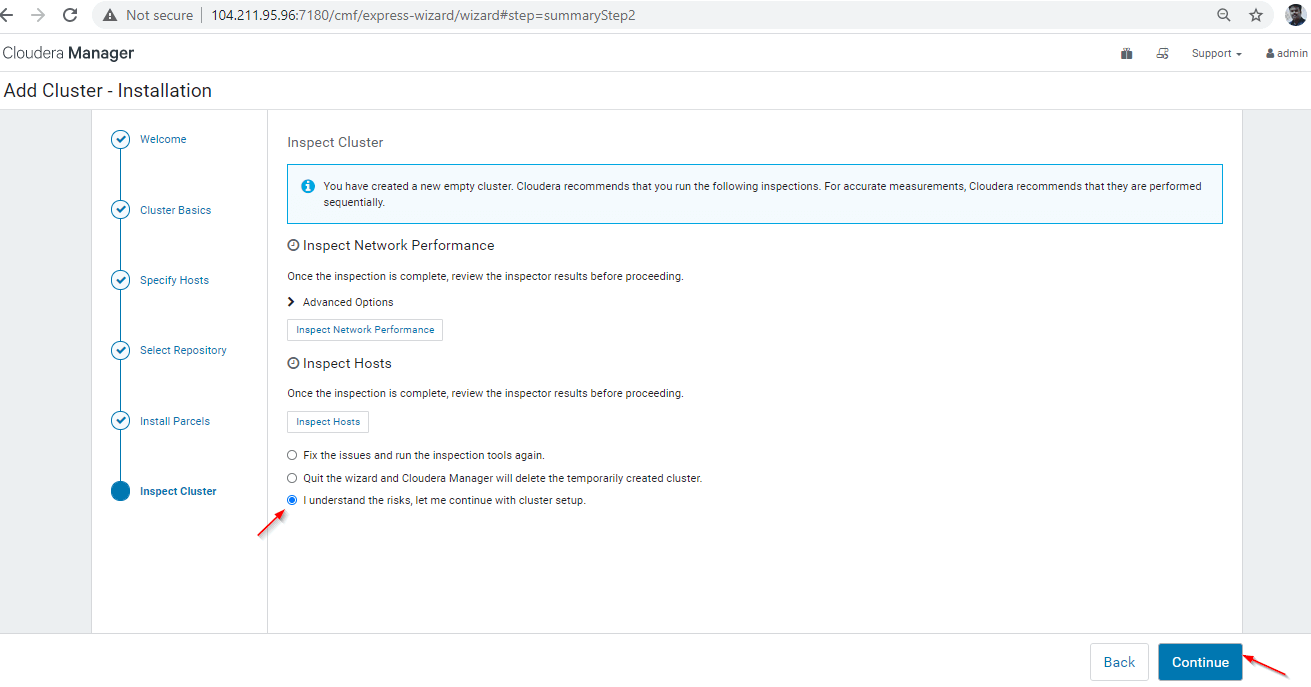
Après avoir terminé toutes les étapes ci‑dessus, l’assistant de configuration du cluster démarre automatiquement.
Résumé
Les bénéfices apportés aux entreprises par Hadoop sont considérables. Grâce à ce framework, il est possible de stocker et de traiter rapidement de grandes quantités de données via le calcul distribué. Les données et applications en cours de traitement sont protégées des pannes matérielles. Si un nœud tombe en panne, les jobs sont redirigés vers d’autres nœuds afin d’assurer la continuité du calcul distribué. Plusieurs copies de toutes les données sont stockées automatiquement. Vous pouvez consulter davantage de retours d’expérience ici, et suivre notre blog pour d’autres actualités data science.
Obtenez une certification pour le poste de Data Engineer de vos rêves
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.
