Conviértete en Ingeniero de Datos
El ecosistema de Apache Hadoop
Hadoop se convirtió en el estándar de facto para el procesamiento de datos, del mismo modo que Excel ha pasado a ser el software por defecto para el análisis de datos. A diferencia de Excel, Hadoop fue diseñado por desarrolladores y no por "analistas de negocio"; sin embargo, su adopción masiva y su éxito dependen más de los analistas que de los desarrolladores. Por eso, los problemas de Big Data se han segmentado funcionalmente y, para cada segmento, se han desarrollado tecnologías basadas en Hadoop que dan respuesta a sus retos. Todas estas herramientas conforman lo que se denomina el ecosistema Hadoop.
El ecosistema Hadoop enriquece Hadoop y lo hace capaz de resolver una gran variedad de problemas de negocio. A día de hoy, el ecosistema Hadoop está compuesto por cientos de tecnologías que hemos agrupado en 14 categorías según su ámbito: lenguajes de abstracción, SQL sobre Hadoop (Hive y Pig), modelos de cómputo (MapReduce y Tez), herramientas de procesamiento en tiempo real (Storm y Spark Streaming), bases de datos (HBase y Cassandra), herramientas de ingesta en streaming (Kafka y Flume), herramientas de integración de datos (Sqoop y Talend), herramientas de orquestación de flujos de trabajo (Oozie y Control M for Hadoop), herramientas de coordinación de servicios distribuidos (ZooKeeper), herramientas de administración de clúster (Ranger y Sentry), herramientas de interfaz de usuario (Hue y Jupyter), herramientas de indexación de contenido (ElasticSearch y Splunk), sistemas de ficheros distribuidos (HDFS) y gestores de recursos (YARN y MESOS). En esta sección repasaremos la función de cada una de las herramientas que componen este ecosistema de tecnologías Big Data. Después, si quieres profundizar, te recomendamos leer nuestras guías sobre los distintos elementos del ecosistema Hadoop que seguirán a este artículo. El siguiente mapa mental presenta globalmente el ecosistema Hadoop.
Mapa heurístico del ecosistema Hadoop
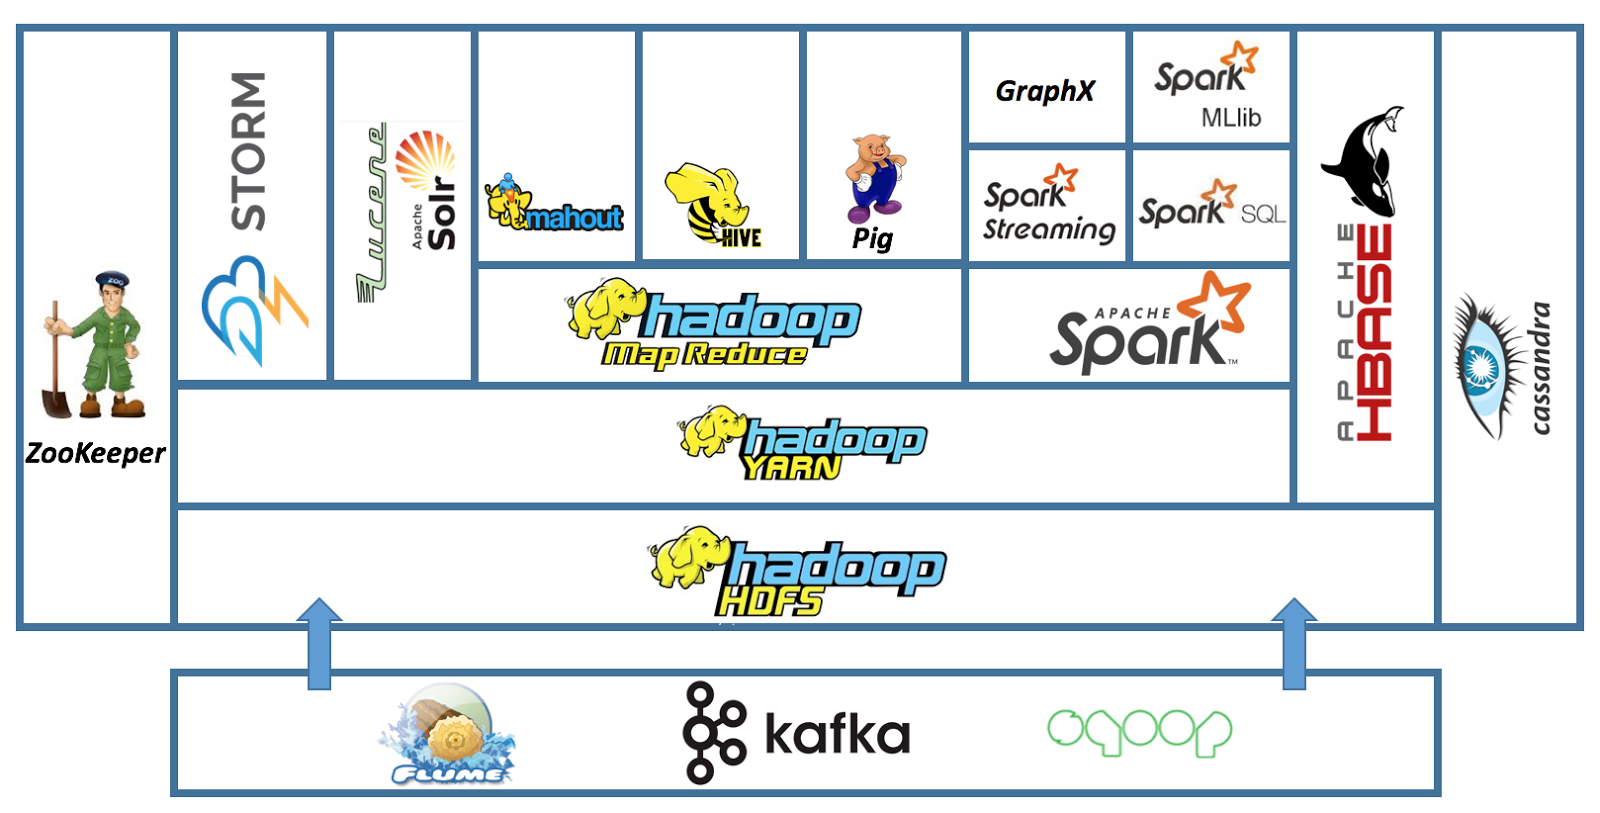
La configuración básica del ecosistema Hadoop contiene las siguientes tecnologías: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie y Kafka.
Spark
Antes de explicar qué es Spark, recordemos que para que un algoritmo se ejecute en un clúster multinodo en Hadoop tiene que ser paralelizable. Así, un algoritmo es "escalable" si es paralelizable (y, por tanto, puede aprovechar la escalabilidad de un clúster). Hadoop es una implementación del modelo de cómputo MapReduce. El problema de MapReduce es que se basa en un modelo de grafo acíclico dirigido. Es decir, la secuencia de operaciones de MapReduce se ejecuta en tres fases secuenciales sin desvíos (Map -> Shuffle -> Reduce); ninguna fase es iterativa (o cíclica).
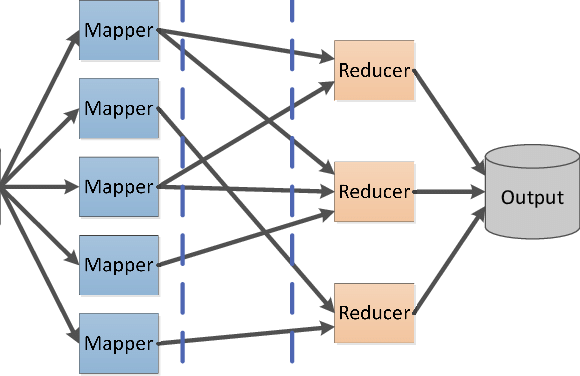
El modelo acíclico directo no es adecuado para ciertas aplicaciones, especialmente aquellas que reutilizan datos a lo largo de múltiples operaciones, como ocurre con la mayoría de algoritmos de aprendizaje estadístico, que son iterativos, y con consultas interactivas de análisis de datos. Spark responde a estas limitaciones; es un motor de cómputo que realiza procesamiento distribuido en memoria sobre un clúster. En otras palabras, es un motor de cómputo distribuido en memoria. Frente a MapReduce, que trabaja en modo batch, el modelo de cómputo de Spark funciona en modo interactivo, es decir, agrupa los datos en memoria antes de procesarlos y, por tanto, es muy adecuado para procesos de Machine Learning.
Hive
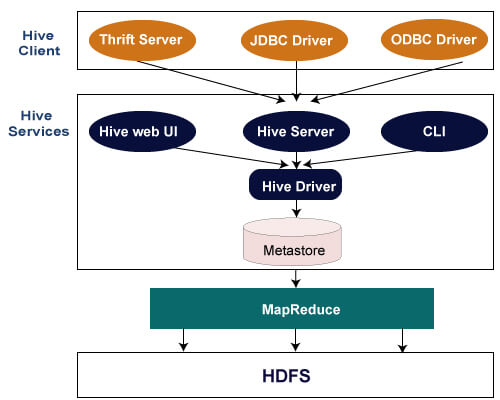
Hive es una infraestructura de cómputo similar a un Data Warehouse que ofrece servicios de consulta y agregación para volúmenes muy grandes de datos almacenados en un sistema de archivos distribuido como HDFS. Hive ofrece un lenguaje de consultas basado en SQL (estándar ANSI-92) llamado HiveQL (Hive Query Language), que ejecuta consultas sobre los datos almacenados en HDFS. HiveQL también permite a usuarios avanzados y desarrolladores integrar funciones Map y Reduce directamente en sus consultas para cubrir un abanico más amplio de problemas de gestión de datos. Cuando escribes una consulta en HiveQL, Hive la transforma en un job MapReduce y la envía al JobTracker para su ejecución.
Pig
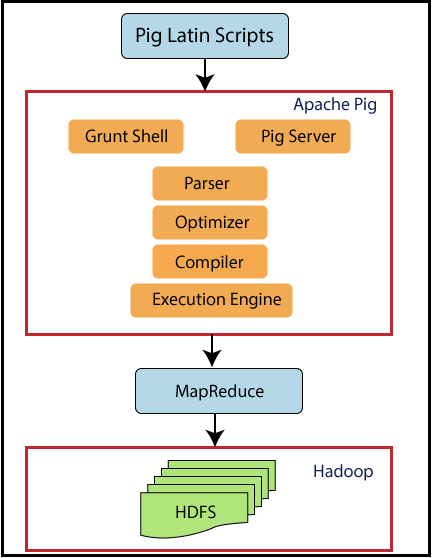
Pig es un entorno interactivo de ejecución de flujos de datos sobre Hadoop. Consta de dos elementos: un lenguaje de expresiones de flujo de datos llamado Pig Latin y un entorno interactivo de ejecución de dichos flujos.
El lenguaje que ofrece Pig, Pig Latin, se parece en líneas generales a lenguajes de scripting como Perl, Python o Ruby. Sin embargo, es más específico y se describe mejor como un "lenguaje de flujo de datos". Te permite escribir consultas en secuencias sobre datos de origen para obtener datos "objetivo" en Hadoop a la manera de un ETL. Estos flujos se transforman en funciones MapReduce que finalmente se envían al job tracker para su ejecución. En pocas palabras, Pig es el ETL de Hadoop. Programar en Pig Latin significa describir, en flujos independientes pero anidados, cómo se cargan, transforman y agregan los datos usando instrucciones específicas de Pig llamadas operadores. Dominar estos operadores es la clave para dominar Pig Latin, máxime cuando son menos numerosos que en Hive.
HBase
Antes de hablar de HBase, recordemos que los RDBMS, utilizados hasta ahora para la gestión de datos, han mostrado rápidamente sus límites ante el gran volumen y la diversidad de los datos. En efecto, los RDBMS están diseñados para gestionar solo datos estructurados (tablas con filas/columnas); además, el aumento de volumen incrementa la latencia de las consultas. Esta latencia es perjudicial para muchos negocios que requieren respuestas casi en tiempo real. Para solventar estas limitaciones se han desarrollado nuevos SGBD llamados "NoSQL". Estos no imponen una estructura particular a los datos, pueden distribuir el almacenamiento y la gestión entre varios nodos y son escalables. Recordemos que escalabilidad significa que el rendimiento del sistema se mantiene estable a medida que aumenta la carga de procesamiento. HBase pertenece a esta categoría de SGBD.
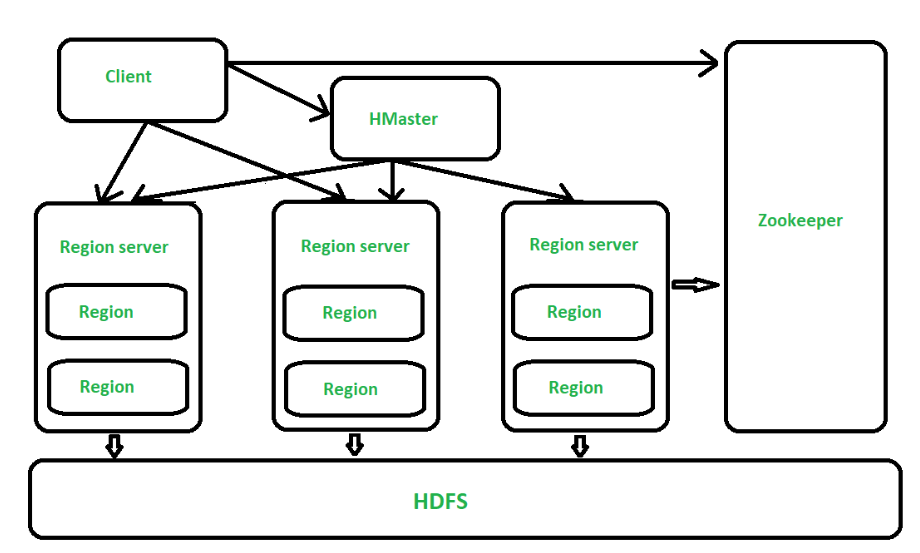
HBase es un SGBD distribuido y orientado a columnas que proporciona acceso en lectura y escritura en tiempo real a los datos almacenados en HDFS. HDFS ofrece acceso secuencial a los datos en batch, lo que no es adecuado para accesos rápidos como los de streaming; HBase cubre estas carencias y proporciona acceso rápido a los datos almacenados en HDFS.
HBase se basa en el SGBD "BigTable" de Google y puede almacenar volúmenes muy grandes de datos (miles de millones de filas/columnas). Depende de ZooKeeper, un servicio de coordinación distribuida para el desarrollo de aplicaciones.
Sqoop
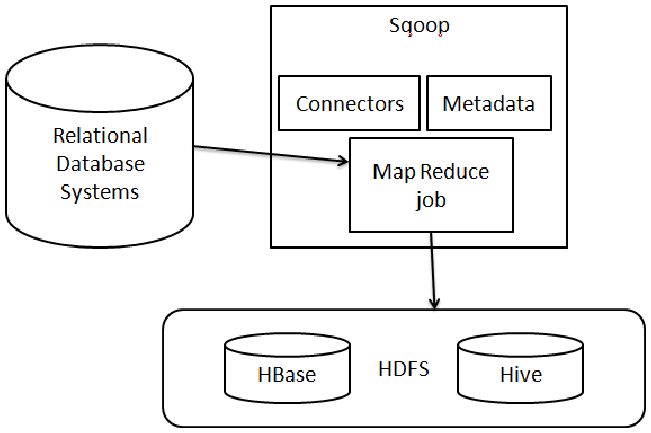
Sqoop, o SQL-to-Hadoop, es una herramienta que transfiere datos desde una base de datos relacional al HDFS de Hadoop y viceversa. Está integrada en el ecosistema Hadoop y actúa como planificador de ingesta de datos en Hadoop. Puedes usar Sqoop para importar datos desde RDBMS como MySQL, Oracle o SQL Server a HDFS, transformar los datos en Hadoop vía MapReduce u otro modelo de cómputo y exportarlos de vuelta al RDBMS. Lo llamamos planificador de ingesta de datos porque, al igual que Oozie, automatiza este proceso de importación/exportación y programa su ejecución. Como usuario, solo tienes que escribir las consultas SQL que se usarán para realizar el movimiento de importación/exportación. Además, Sqoop utiliza MapReduce para importar y exportar datos, lo que lo hace eficiente y tolerante a fallos.
Storm
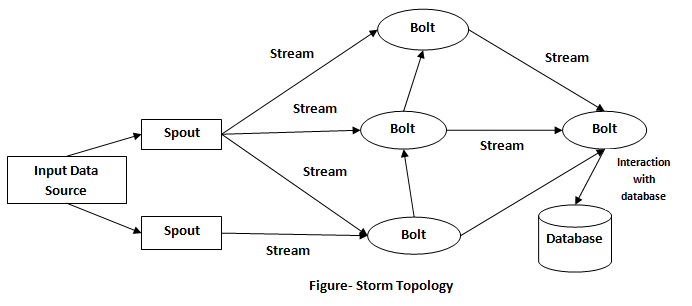
Para entender Storm, hay que comprender el concepto de arquitecturas lambda (λ) y su interés. También es clave entender el concepto de objetos conectados. Los objetos conectados o Internet de las cosas (IoT) representan la extensión de Internet a nuestra vida diaria. Generan datos en streaming y exigen que, en la mayoría de casos, se procesen en tiempo real. Los modelos que conoces, como los modelos batch, no se adaptan a los retos de tiempo real que plantea el IoT. Incluso los modelos de cómputo interactivo no sirven para procesar de forma continua en tiempo real. A diferencia de los datos operacionales producidos por sistemas de una empresa —finanzas, marketing—, que aunque se generen en streaming pueden historificarse para su procesamiento posterior, los datos generados en streaming en fenómenos como IoT o Internet caducan (o dejan de ser válidos) en los instantes posteriores a su creación y, por tanto, requieren procesamiento inmediato. Más allá de los objetos conectados, problemas de negocio como la lucha contra el fraude, el análisis de datos de redes sociales o la geolocalización requieren tiempos de respuesta muy bajos, de menos de un segundo. Para resolver este problema en un contexto Big Data se han desarrollado las llamadas arquitecturas λ. Estas arquitecturas añaden dos capas de procesamiento adicionales a MapReduce para reducir la latencia. Storm es una implementación software de la arquitectura λ. Permite crear aplicaciones sobre Hadoop que procesan datos en tiempo real (o casi en tiempo real).
ZooKeeper
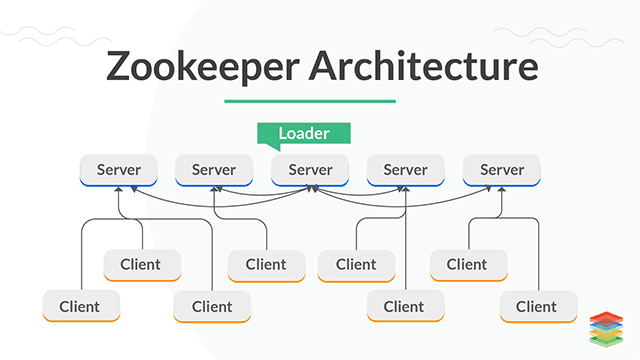
Sincronizar o coordinar la comunicación entre nodos al ejecutar tareas en paralelo es uno de los problemas más complejos en el desarrollo de aplicaciones distribuidas. Para resolverlo, Hadoop ha incorporado herramientas de coordinación de servicios en su ecosistema; en este caso, ZooKeeper. ZooKeeper se encarga de la complejidad inherente a la sincronización de la ejecución de jobs distribuidos en el clúster, lo que evita que otras herramientas del ecosistema Hadoop tengan que lidiar con este problema. También permite a los usuarios desarrollar aplicaciones distribuidas sin ser expertos en programación distribuida. Sin entrar en los detalles complejos de la coordinación de datos entre nodos en un clúster Hadoop, ZooKeeper proporciona un servicio de configuración distribuida, un servicio de sincronización y un registro de nombres para aplicaciones distribuidas. ZooKeeper es la vía por la que Hadoop coordina los jobs distribuidos.
Oozie
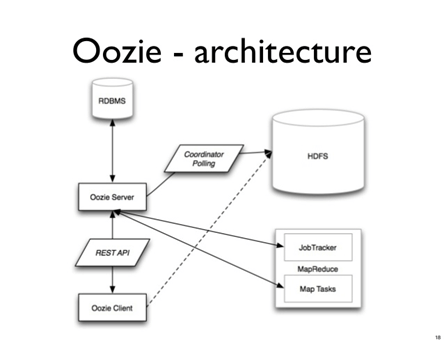
Por defecto, Hadoop ejecuta los jobs tal y como los envía el usuario sin considerar la relación que puedan tener entre sí. Sin embargo, los problemas para los que se usa Hadoop suelen requerir la escritura de uno o varios jobs complejos. Cuando se envían dos jobs al JobTracker (o a YARN), este los ejecutará sin prestar atención al vínculo entre ellos, lo que puede provocar un error (excepción) y la detención del código. ¿Cómo gestionamos la ejecución de varios jobs que están relacionados con un mismo problema? Para gestionar este tipo de casuística, la solución más sencilla hoy es usar un planificador de jobs, en este caso, Oozie.
Oozie es un planificador de jobs que se ejecuta como servicio en un clúster Hadoop. Se utiliza para programar jobs de Hadoop y, en general, para programar la ejecución de todos los jobs que pueden correr en un clúster, como un script de Hive, un job de MapReduce, un job de Hama, un job de Storm, etc. Está diseñado para gestionar automáticamente la ejecución inmediata o diferida de miles de jobs interdependientes en un clúster Hadoop. Para usar Oozie, solo necesitas configurar 2 archivos XML: un archivo de configuración del motor Oozie y un archivo de configuración del workflow del job.
Presentación de Cloudera
Cloudera es una empresa estadounidense con sede en California, dedicada a desarrollar una solución de Big Data basada históricamente en el framework distribuido Hadoop; actualmente se está reorientando hacia la nube. Desde hace más de un año, Cloudera ha ampliado su solución en las nubes públicas AWS, Azure y GCP.
Presentación de CDP
Cloudera Data Platform (CDP) es una plataforma que permite a las empresas analizar datos con analítica autoservicio en entornos híbridos y multicloud. Permite a las organizaciones extraer más valor de todos sus datos creando data lakes en la nube en cuestión de horas.
CDP proporciona herramientas integradas, multifuncionales y de autoservicio para analizar y centralizar datos. Además, ofrece seguridad y gobierno a nivel empresarial y puede implantarse en entornos públicos, privados y multicloud. CDP es la distribución que sucede a las dos distribuciones previas de Hadoop de Cloudera: Cloudera Distribution of Hadoop (CDH) y Hortonworks Data Platform (HDP).
El acceso autoservicio a los datos empresariales está en el centro de este servicio. Los nuevos servicios en la nube integrados en la plataforma también proporcionan acceso autoservicio a datos y analítica para analistas, científicos de datos, profesionales de TI y desarrolladores. Las palabras clave que diferencian la plataforma de su competencia son los tres servicios Cloud-Native de CDP presentados por Cloudera: autoservicio, multicloud y seguridad.
CDP ofrece un enfoque público-privado único, analítica de datos en tiempo real, opciones de despliegue escalables on-premise, en la nube e híbridas, y una arquitectura que prioriza la privacidad.
CDP Public Cloud
CDP Public Cloud es una plataforma como servicio (PaaS) compatible con la infraestructura cloud y fácilmente portable entre diversos proveedores, incluidas soluciones privadas como OpenShift. CDP se diseñó para ser totalmente híbrida y multicloud, lo que significa que una única plataforma puede gestionar todos los casos de uso del ciclo de vida de los datos. La plataforma CDP puede trabajar con datos en múltiples configuraciones, incluidas nubes públicas como AWS, Azure y GCP. Además, puede escalar cargas de trabajo y recursos automáticamente hacia arriba o hacia abajo para mejorar el rendimiento y reducir costes.
Servicios de CDP Public Cloud
Estos son los principales componentes que conforman CDP Public Cloud:
-
CDP Data Engineering es una configuración todo en uno. Está construido sobre Apache Spark. Simplifica los procesos ETL en los equipos de analítica de datos de la empresa al permitir orquestación y automatización con Apache Airflow y ofrece monitorización avanzada de pipelines, depuración visual y herramientas de gestión. Además, cuenta con entornos de trabajo aislados y está contenerizado, es escalable y fácil de transportar.
-
CDP Data Hub es un servicio que permite analítica de alto valor desde el Edge hasta la IA. Cloudera Data Hub es un servicio nativo en la nube para gestión y analítica de datos. Permite a los desarrolladores de TI y de negocio crear aplicaciones empresariales más rápido para cualquier escenario, desde streaming hasta ETL. Data marts, bases de datos y Machine Learning son solo algunos de los servicios cubiertos entre la amplia variedad de cargas analíticas.
-
CDP Data Warehouse es un servicio que permite a TI ofrecer una experiencia de analítica autoservicio nativa en la nube para analistas de BI. El streaming, la ingeniería de datos y la analítica están totalmente integrados en CDP Data Warehouse. Además, cuenta con un marco unificado para securizar y gobernar todos tus datos y metadatos en nubes privadas, múltiples nubes públicas o entornos híbridos. El servicio Cloudera Data Warehouse facilita el despliegue de data warehouses autoservicio para analistas de datos. Se basa en potentes motores SQL probados a nivel empresarial. Cientos de usuarios podrán acceder a los datos con un solo clic, tanto on-premise como en la nube. Los recursos pueden escalarse bajo demanda según se necesite, y la gestión de cargas también es autoservicio con herramientas intuitivas.
-
CDP Machine Learning facilita el despliegue de espacios de trabajo colaborativos de Machine Learning para que los data scientists aprovechen los datos de la empresa. Optimiza los workflows de ML con herramientas nativas y completas para desplegar, escalar y monitorizar modelos. Con esta herramienta, las organizaciones pueden desplegar rápidamente nuevos espacios de trabajo de Machine Learning con pocos clics para habilitar el acceso autoservicio a las herramientas y a los datos necesarios para los flujos de trabajo de ML. Además, la replicación de datos on-premise o en la nube puede realizarse rápidamente sin comprometer la seguridad y el gobierno. Los data scientists también pueden elegir sus herramientas mientras aprovechan recursos elásticos ajustables a sus necesidades. El entrenamiento, la ingeniería de datos, el despliegue y la gestión de modelos se realizan rápidamente desde una interfaz todo en uno, sin tener que saltar entre plataformas.
-
Cloudera Data Visualization permite modelar datos en el data warehouse virtual sin eliminar ni actualizar las estructuras o tablas subyacentes, y consultar grandes volúmenes de datos sin cargarlos constantemente, ahorrando tiempo y dinero.
-
Cloudera Operational Database es una solución gestionada que sintetiza la instancia de clúster subyacente en una base de datos. Escalará automáticamente en función del uso de la carga del clúster, mejorará el rendimiento dentro del mismo perímetro de infraestructura y resolverá automáticamente problemas operativos.
CDP Private Cloud
CDP Private Cloud se adapta mejor a despliegues híbridos, permitiendo conectar on-premise con nubes públicas manteniendo una seguridad y un gobierno coherentes e integrados. En CDP Private Cloud, el procesamiento y el almacenamiento están desacoplados, lo que permite escalar ambos clústeres de forma independiente. Disponible sobre un clúster CDP Private Cloud Base, Cloudera Shared Data Experience (SDX) proporciona seguridad, gobierno y gestión de metadatos unificados. Además, los usuarios de CDP Private Cloud pueden aprovisionar y desplegar rápidamente los servicios de Cloudera Data Warehousing y Cloudera Machine Learning y escalarlos según sea necesario mediante Management Console.
Servicios de CDP Private Cloud
Algunos componentes de CDP Public Cloud, como Machine Learning y Data Warehouse, están disponibles en CDP Private Cloud. Utiliza un conjunto de motores analíticos que cubren streaming, ingeniería de datos, data marts, bases de datos operacionales y ciencia de datos para soportar cargas tradicionales.
Fundamentos de HDFS y MapReduce
HDFS es el sistema de archivos distribuido de Hadoop y el elemento central de Hadoop, que permite almacenar y replicar datos en varios servidores. En combinación con YARN, aumenta las capacidades de gestión de datos del clúster HDFS de Hadoop y posibilita un procesamiento Big Data eficiente.
Puedes ejecutar HDFS en hardware estándar, lo que lo hace muy tolerante a errores. Cada fragmento de datos se almacena en varios lugares y puede recuperarse en cualquier circunstancia. Además, esta replicación ayuda a combatir la posible corrupción de datos.
HDFS utiliza un NameNode y un DataNode. El DataNode es un servidor estándar en el que se almacenan los datos. El NameNode contiene metadatos (información sobre los datos almacenados en los distintos nodos). La aplicación solo interactúa con el NameNode, y este se comunica con los DataNodes según sea necesario.
HDFS también evita la congestión de red priorizando mover las operaciones en lugar de mover los datos. Esto significa que las aplicaciones pueden acceder a los datos donde están almacenados. Su última fortaleza es la portabilidad: puede ejecutarse en distintos tipos de hardware sin problemas de compatibilidad.
¿Qué es MapReduce y cómo funciona?
MapReduce es el motor de procesamiento de Apache Hadoop, directamente derivado de MapReduce de Google. Las aplicaciones MapReduce se escriben esencialmente en Java. Permite computar fácilmente cantidades ingentes de datos aplicando etapas de mapeo y reducción para encontrar una solución al problema planteado. La fase de mapeo toma un conjunto de datos para transformarlo en otro conjunto descomponiendo los elementos individuales en pares clave/valor llamados tuplas. La segunda fase, de reducción, toma la salida derivada del proceso de mapeo y combina las tuplas en un conjunto más pequeño.
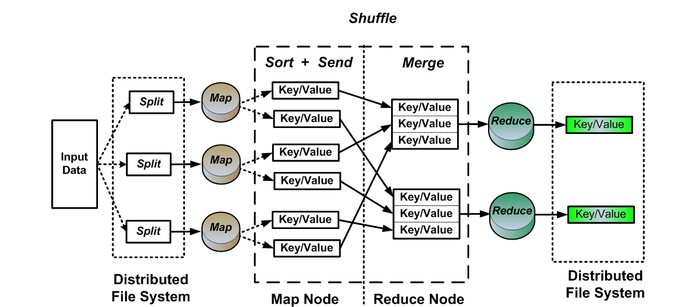
MapReduce es un framework de procesamiento altamente paralelo que puede escalarse fácilmente sobre cantidades masivas de hardware estándar para cubrir la creciente necesidad de procesar grandes volúmenes de datos. Una vez que las tareas de mapeo y reducción funcionan de forma fluida, basta con un cambio de configuración para ejecutarlas sobre un conjunto de datos mayor. Este tipo de escalabilidad extrema, de un solo nodo a cientos o incluso miles de nodos, es lo que hace de MapReduce el favorito de profesionales de Big Data en todo el mundo.
MapReduce permite un amplio abanico de capacidades, entre ellas:
- Habilita el procesamiento en paralelo necesario para tareas de Big Data.
- Es aplicable a una gran variedad de aplicaciones comerciales de procesamiento de datos.
- Es una solución rentable frente a marcos de procesamiento centralizados.
- Puede integrarse con SQL para facilitar capacidades de procesamiento en paralelo.
Cloudera's Distribution Including Apache Hadoop
Cloudera es uno de los pure players históricos de Hadoop, junto con Hortonworks y MapR. El grupo, respaldado por Intel, desarrolla CDH, una distribución de Hadoop que incluye varios otros proyectos open-source, como Impala y Search. También ofrece funciones de seguridad e integración.
El framework Impala es un motor de consultas SQL interactivas que permite consultar directamente datos almacenados en HDFS, Apache HBase o AWS S3. Este motor se apoya en otras tecnologías y componentes de Hive, como su sintaxis SQL (HiveSQL), el controlador Open DataBase Connectivity y Query UI.
El componente Search se basa en el proyecto Apache Solr, un motor de indexación y búsqueda construido sobre Lucene. La integración de esta tecnología en CDH da acceso, por ejemplo, a capacidades de indexación en (casi) tiempo real y a datos almacenados en un clúster Hadoop o HBase. La tecnología Solr permite búsquedas de texto completo complejas sin necesidad de amplios conocimientos de SQL. Solr te permite consultar datos de Hadoop sin tener que moverlos antes.
Cloudera ofrece varias ediciones de CDH, cada una con distintas funciones de servicio y gestión de clúster, y con diferentes niveles de soporte:
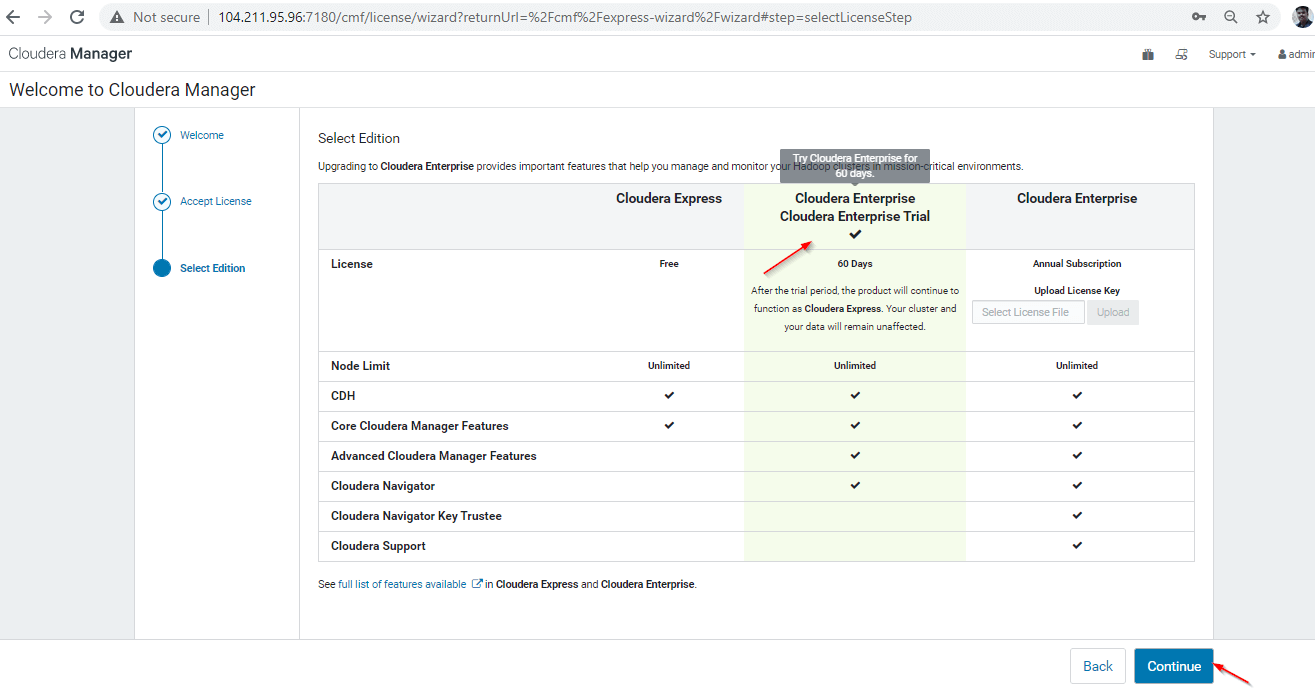
- Cloudera Express es la versión gratuita de CDH, que incluye los elementos de CDH y las funciones principales de Cloudera Manager. Además, da acceso a una versión de evaluación de 30 días de la edición Enterprise.
- Cloudera Manager es la torre de control de CDH. La herramienta proporciona una consola de administración web para desplegar, gestionar, monitorizar y controlar la salud de los despliegues de CDH. También incluye una API para configurar el sistema y recuperar métricas e información sobre el funcionamiento de un clúster CDH.
- Cloudera Enterprise es una versión con licencia de pago y, por tanto, con funciones ampliadas. Incluye, por ejemplo, herramientas avanzadas extraídas de Cloudera Manager y Navigator.
- Cloudera Manager Advanced Features añade funciones clave a Cloudera Express: informes operativos, gestión de cuotas, logs de configuración, actualizaciones continuas, reinicios de servicios, integración con Kerberos, integración con LDAP, soporte SNMP y recuperación automática ante desastres.
- Cloudera Navigator, disponible solo con las ediciones Flex y Data Hub, permite la gestión de seguridad y gobierno de datos dentro de una plataforma CDH. La herramienta soporta las exigencias de cumplimiento de las empresas. Con ella, responsables de datos, analistas y administradores pueden explorar grandes volúmenes de datos almacenados en Hadoop y gestionar con mayor facilidad las claves de cifrado utilizadas para proteger los datos en un clúster CDH.
Para montar un entorno de prueba de concepto, primero debes descargar y ejecutar el instalador de Cloudera Manager Server.
- Primero, abre Cloudera Manager Downloads en tu navegador. En el cuadro de Cloudera Manager, haz clic en Download Now. También puedes descargar el instalador para tu versión de Cloudera Manager. Por ejemplo, para Cloudera Manager 6.3.3:
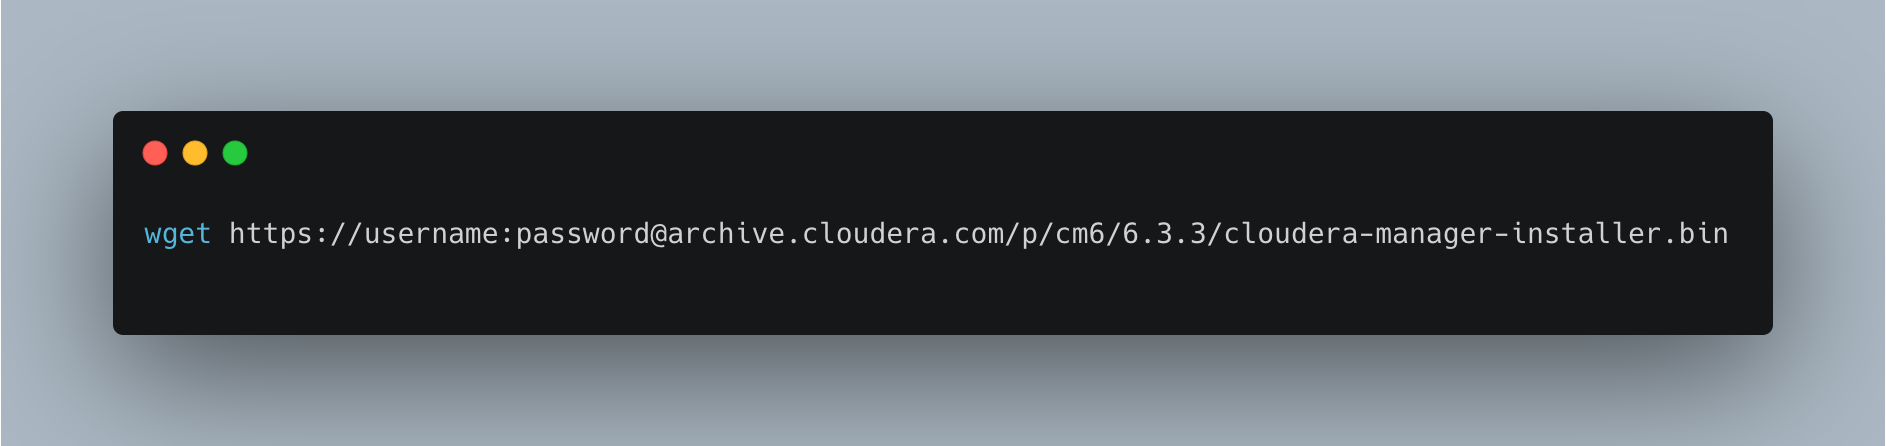
- Después, ejecuta el instalador de Cloudera Manager.
Primero, cambia los permisos de Cloudera-manager-installer.bin para poder ejecutarlo: chmod u+x Cloudera-manager-installer.bin
Para ejecutar el instalador, usa el siguiente comando: sudo ./cloudera-manager-installer.bin --username=username --password=password
- Lee y acepta los acuerdos de licencia asociados
El instalador entonces:
- Instala los archivos del repositorio de Cloudera Manager.
- Instala el Oracle JDK.
- Instala Cloudera Manager Server y los paquetes de PostgreSQL embebidos.
Cuando finalice la instalación, se mostrará la URL completa de la consola de administración de Cloudera Manager, incluido el puerto (7180 por defecto). Toma nota de esta URL. Luego, pulsa Enter para elegir OK, salir del instalador y confirmar la instalación correcta.
El siguiente paso es instalar CDH usando el asistente.
- Ve a tu consola de administración de Cloudera Manager iniciando sesión en: HTTP://:7180, donde es el FQDN o la dirección IP del host en el que se ejecuta Cloudera Manager Server.
- Inicia sesión en Cloudera Manager Admin Console. Las credenciales por defecto son:
  **Username**: admin
  **Password**: admin
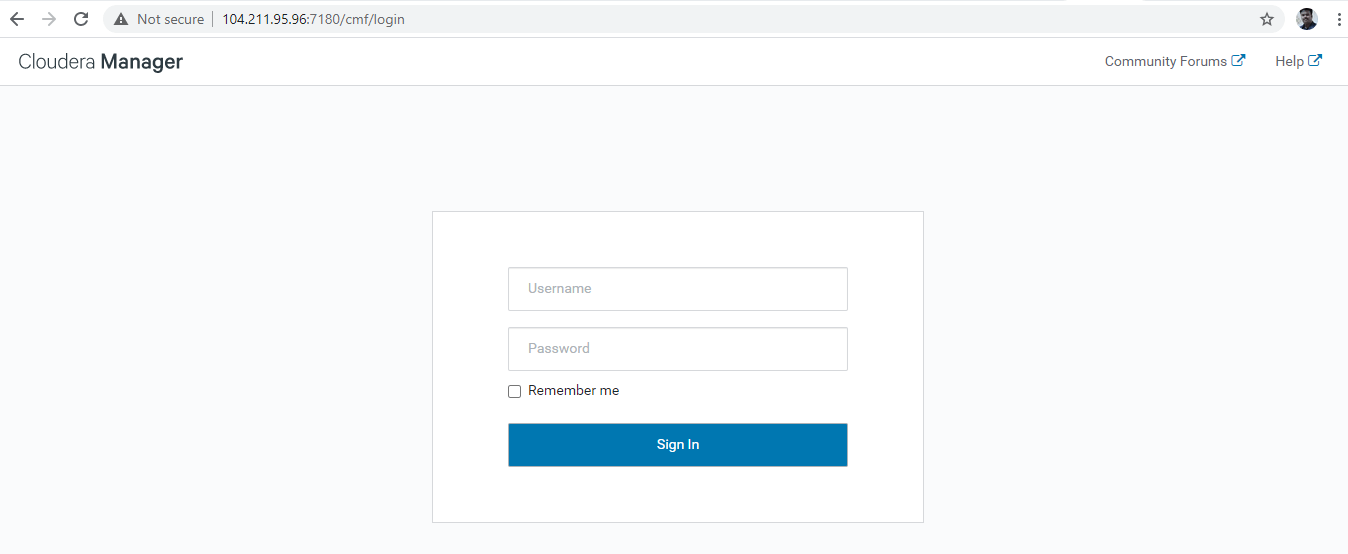
Lee los términos y condiciones y acéptalos: haz clic en Continue y se iniciará el asistente de instalación.
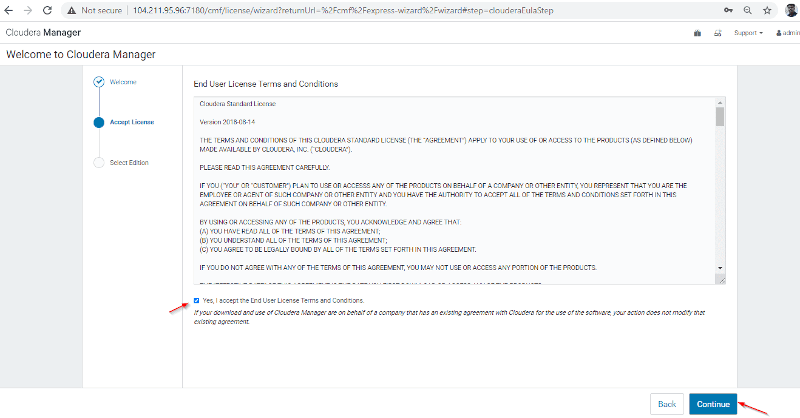
El asistente de instalación de Cloudera Manager te guiará por una serie de pasos como los siguientes: Select Edition Puedes seleccionar la edición a instalar y, opcionalmente, también puedes instalar una licencia.
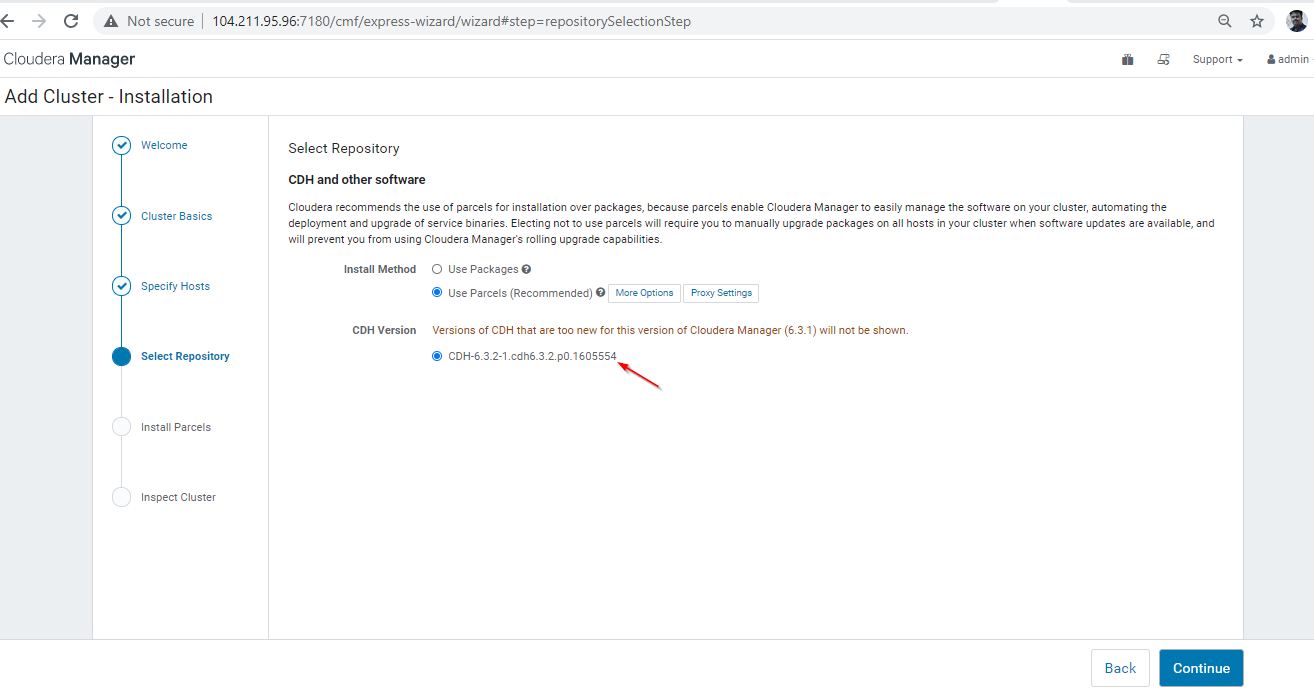
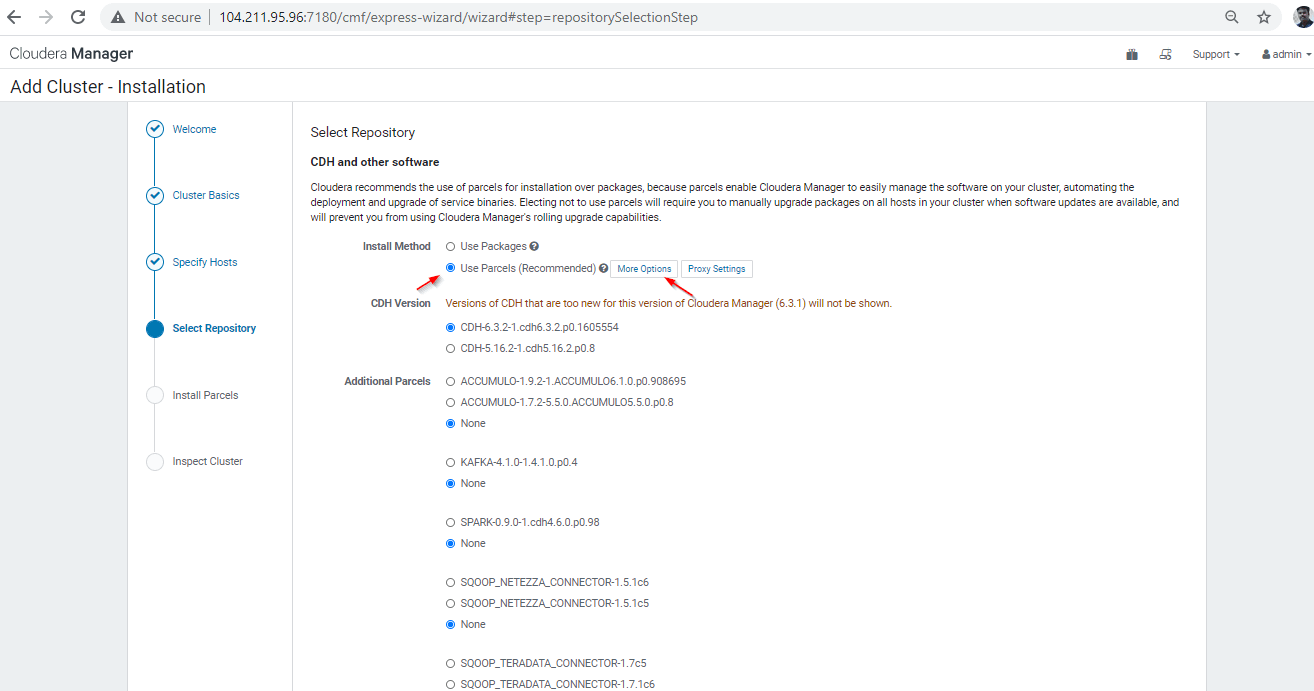
Specify Hosts Elige qué hosts se usarán para ejecutar CDH y otros servicios gestionados. Select Repository Aquí necesitas:
- Primero, seleccionar el tipo de repositorio a usar para la instalación. Se recomienda elegir Use Parcels para este clúster de prueba de concepto.
- Después, seleccionar la versión de CDH que vas a instalar y cualquier Parcel adicional que quieras incluir.
- Podrás seleccionar la versión del Cloudera Manager Agent que quieres instalar.
- Haz clic en Continue.
Accept JDK License Al instalar el software JDK, aceptas quedar vinculado por el Oracle Binary Code License Agreement. Tras leer los términos de la licencia y marcar las casillas correspondientes, haz clic en Continue.
Enter Login Credentials Definiendo una cuenta root, nombre de usuario, método de autenticación, puerto ssh y el número de hosts.
Install Agents La página Install Agents muestra el progreso de la instalación. Puedes desplegar los detalles de cualquier host para ver el log de instalación.
Install Parcels La página Install Parcels muestra el progreso de instalación de los parcels que seleccionaste antes. Puedes hacer clic en cualquier barra de progreso para ver los detalles de ese host.
Inspect Hosts La página Inspect Hosts ejecuta el Host Inspector para buscar problemas de configuración comunes. Revisa los resultados y soluciona cualquier incidencia identificada. Luego, haz clic en el botón Run Again para actualizar los resultados tras aplicar cambios.
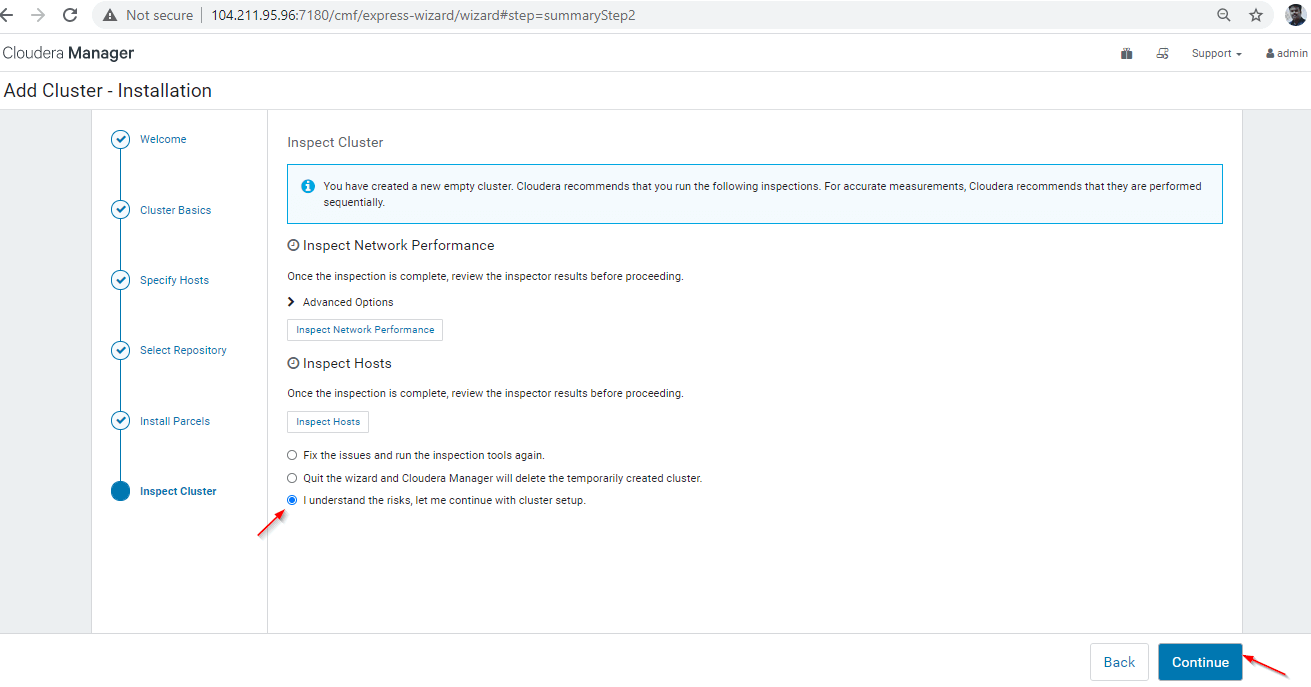
Tras completar todos los pasos anteriores, se iniciará automáticamente el asistente de configuración del clúster.
Resumen
Los beneficios que Hadoop aporta a las empresas son considerables. Gracias a este framework, es posible almacenar y procesar grandes volúmenes de datos con rapidez gracias a su cómputo distribuido. Los datos y aplicaciones en proceso están protegidos frente a fallos de hardware. Si un nodo falla, los jobs se redirigen directamente a otros nodos para asegurar que el cómputo distribuido no se detenga. Varias copias de todos los datos se almacenan automáticamente. Puedes leer más casos de éxito aquí y seguir nuestro blog para más novedades sobre ciencia de datos.
Certifícate en el puesto de Ingeniero de Datos de tus sueños
Nuestros programas de certificación te ayudan a destacar y a demostrar que tus aptitudes están preparadas para el trabajo a posibles empleadores.



