
Curso
Conceitos de Databricks
4 h
23.3K
Primeiro vieram os data warehouses. Eles armazenavam dados em linhas e colunas porque, na época, a Internet e os computadores só conseguiam distribuir informações em texto simples. Muito depois surgiram os data lakes — capazes de guardar praticamente qualquer tipo de dado que você conseguisse coletar. Eles foram perfeitos para a era das redes sociais e do YouTube.
Mas ambos tinham desvantagens — data warehouses eram caros e pouco adequados para a ciência de dados moderna, enquanto data lakes eram bagunçados e muitas vezes viravam verdadeiros pântanos de dados. Com isso, as empresas passaram a ter dois stacks de tecnologia separados — warehouses para BI e analytics e lakes para machine learning.
No entanto, gerenciar duas arquiteturas de dados diferentes era tão trabalhoso que os resultados muitas vezes ficavam aquém. Esse problema deu origem à arquitetura lakehouse, justamente o que tornou a Databricks famosa.
Databricks é uma plataforma em nuvem que permite extrair valor de warehouses e lakes em um ambiente unificado. Este artigo traz uma visão geral da plataforma, mostrando seus recursos mais importantes e como usá-los.
Databricks é uma plataforma tão abrangente que a própria documentação daria um livro. Por isso, o objetivo deste artigo é oferecer uma hierarquia de conceitos — uma sequência de explicações sobre os recursos do Databricks que leva você do zero até um bom nível de prática. Se você está começando do absoluto início, vale conferir também nosso curso Introduction to Databricks.
Vamos lá!
Ao ler a palavra Databricks, pense imediatamente em uma plataforma, não em um framework ou biblioteca Python. Normalmente, plataformas oferecem uma gama ampla de recursos, e com Databricks não é diferente. É uma das poucas plataformas que podem ser usadas por qualquer profissional de dados, de engenheiros de dados a engenheiros de machine learning modernos (ou, como a mídia gosta de chamar hoje, programadores de IA).
Databricks tem os seguintes componentes centrais:
Esses componentes, combinados, desbloqueiam uma série de benefícios:
Se eu consegui convencer você da importância do Databricks no mundo de dados, vamos colocar a plataforma para rodar.
Para configurar sua conta, acesse https://www.databricks.com/try-databricks e inscreva-se na Community Edition.
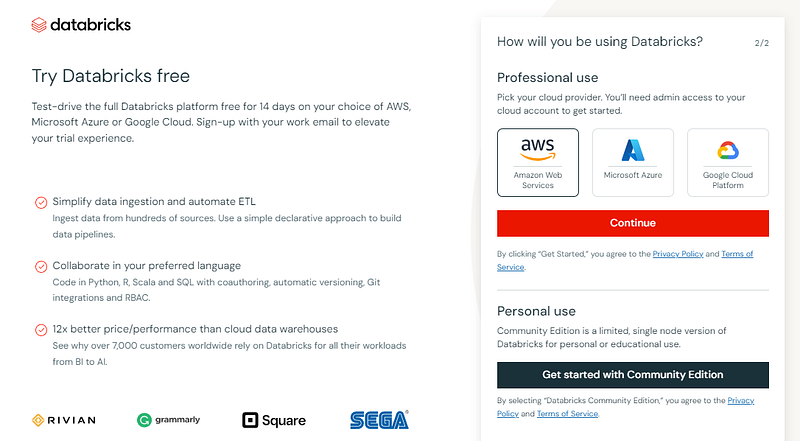
A Community Edition tem menos recursos que a Enterprise, mas não exige configuração de provedor de nuvem, o que é ótimo para usos simples como tutoriais.
Se esta página aparecer após a verificação de e-mail, está tudo certo:
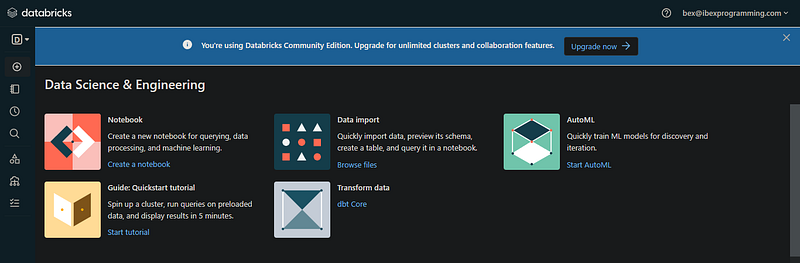
A interface que você viu é o Workspace associado ao seu e-mail (o workspace da Community Edition é fácil de encontrar). Na prática, normalmente um administrador da sua empresa cria uma conta única do Databricks e gerencia o acesso ao workspace.
Agora, vamos entender o UI da plataforma. No painel esquerdo, fica o menu com os diferentes componentes do Databricks. A versão enterprise terá ainda mais opções:
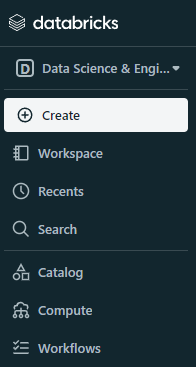
A primeira opção do menu é o tipo de workspace, que por padrão é data science and engineering. Se você mudar para machine learning, aparece uma nova opção de Experiments:
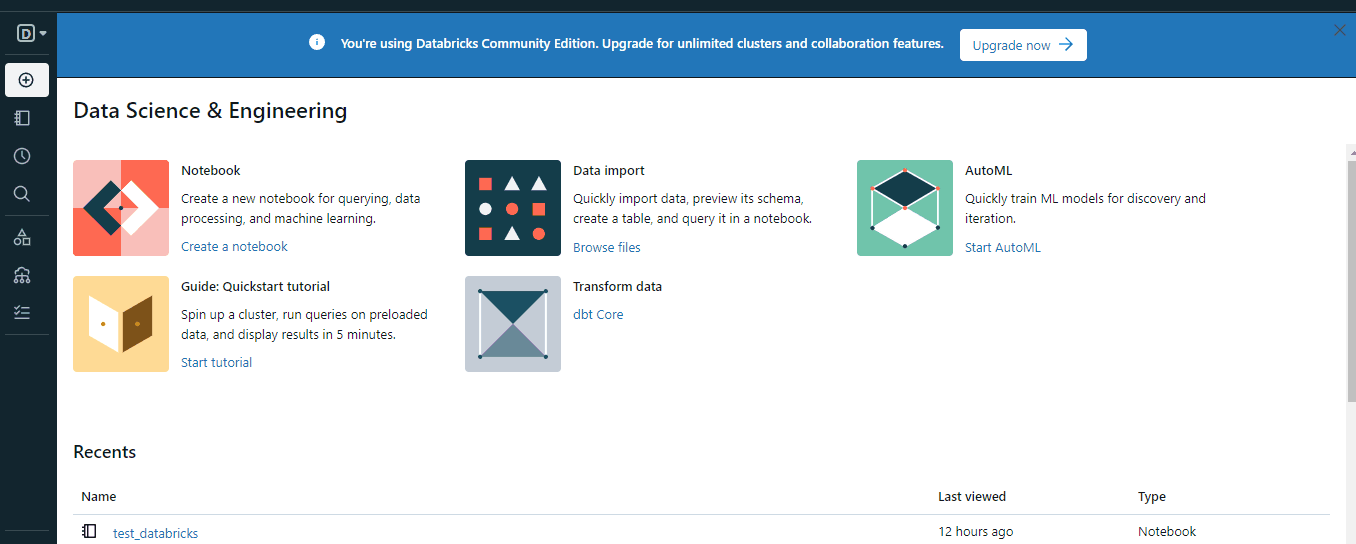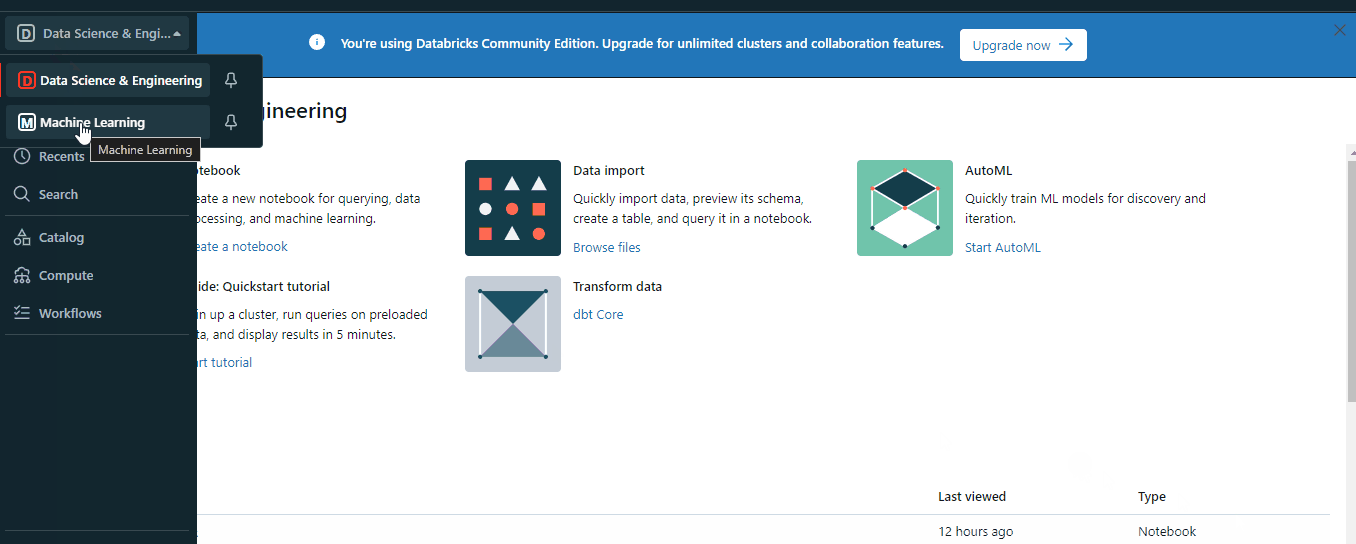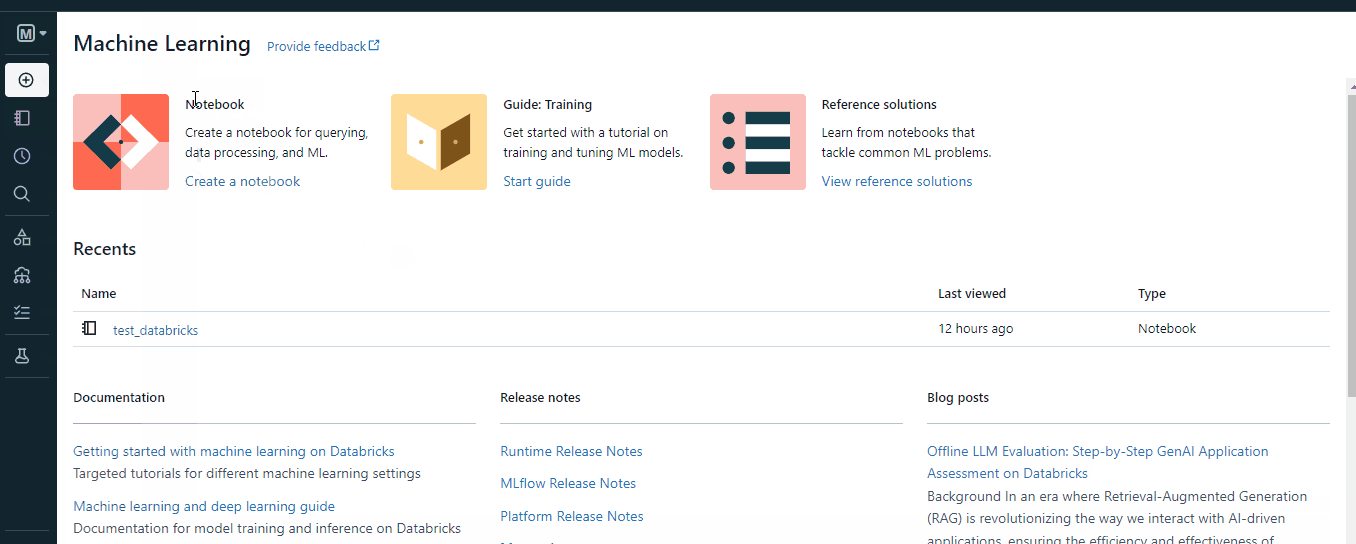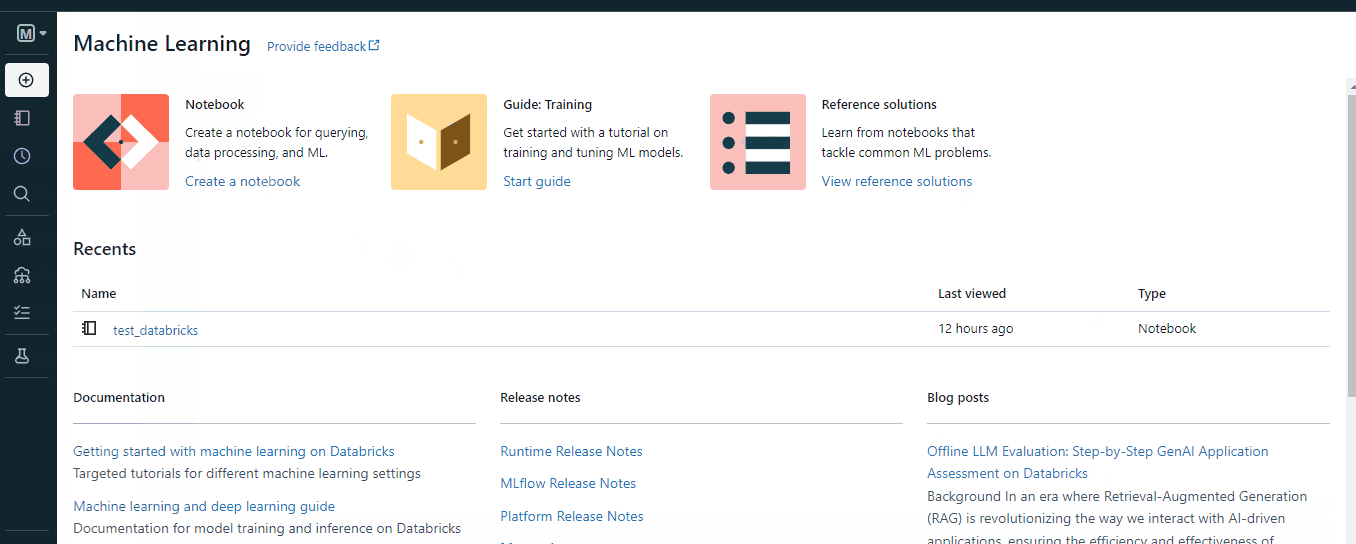
À primeira vista pode parecer que não muda muita coisa, mas quando você faz upgrade da conta e começa a explorar, percebe alguns ótimos recursos da plataforma:
e por aí vai.
Agora, vamos analisar alguns desses componentes com mais atenção.
Clusters no Databricks são os recursos computacionais usados para executar tarefas de processamento de dados. Em geral, os clusters são providos pelo provedor de nuvem escolhido durante a configuração da conta.
Na Community Edition, os clusters são limitados em RAM e CPU, e não incluem GPUs. Já usuários premium costumam conseguir fazer o seguinte de forma simples:
Para criar um cluster, use o botão “Create” ou a opção “Compute” no menu:
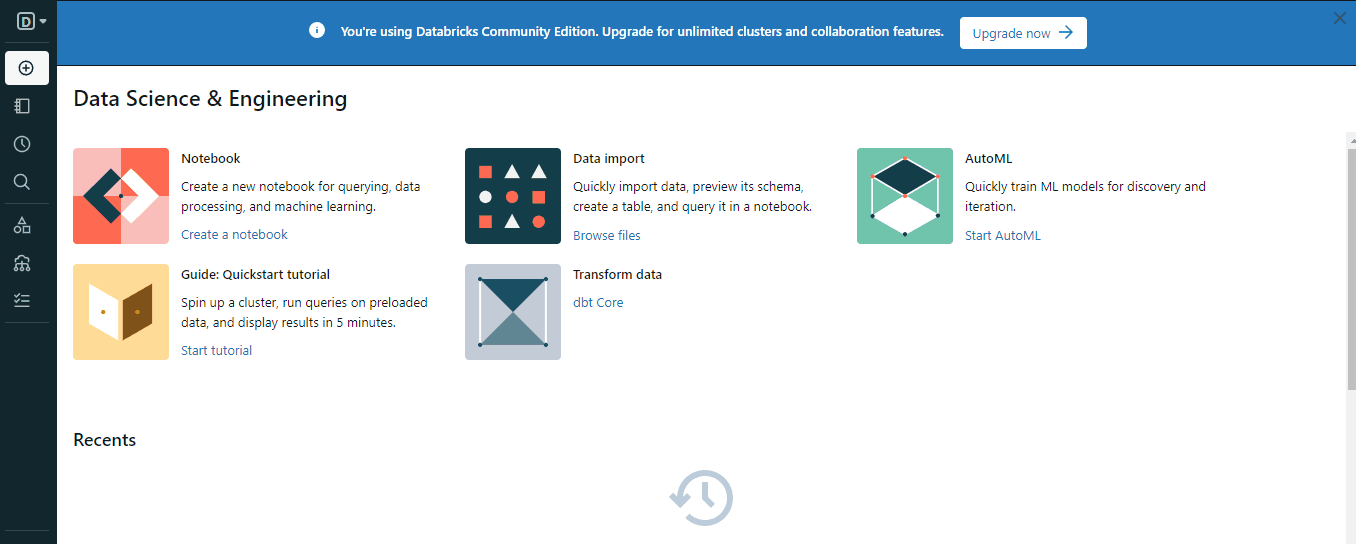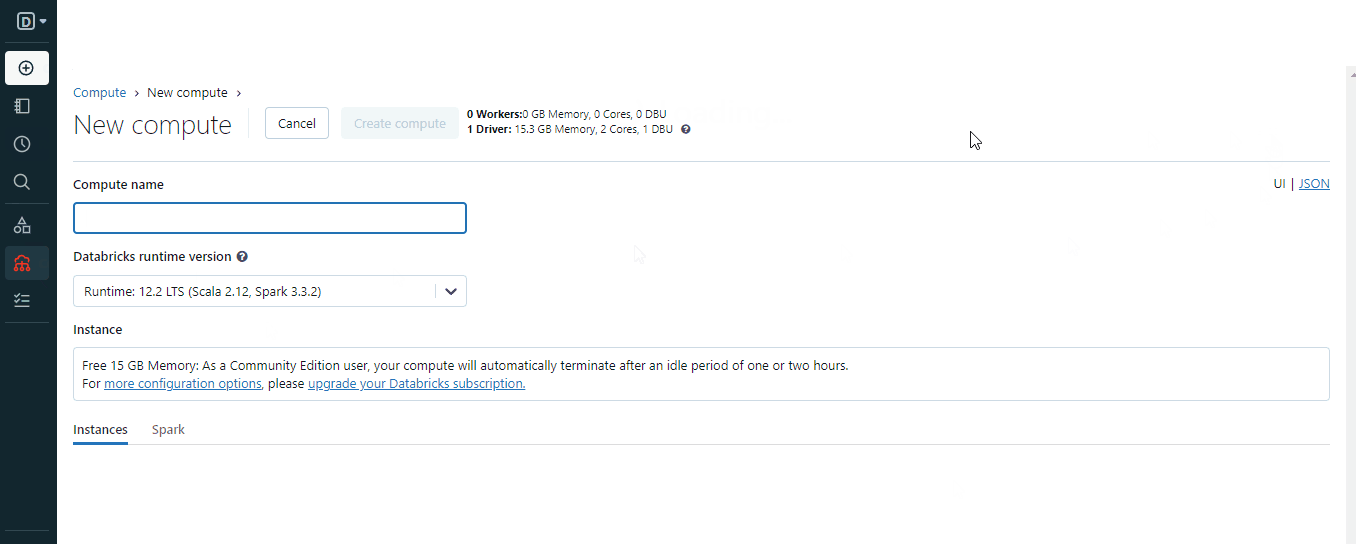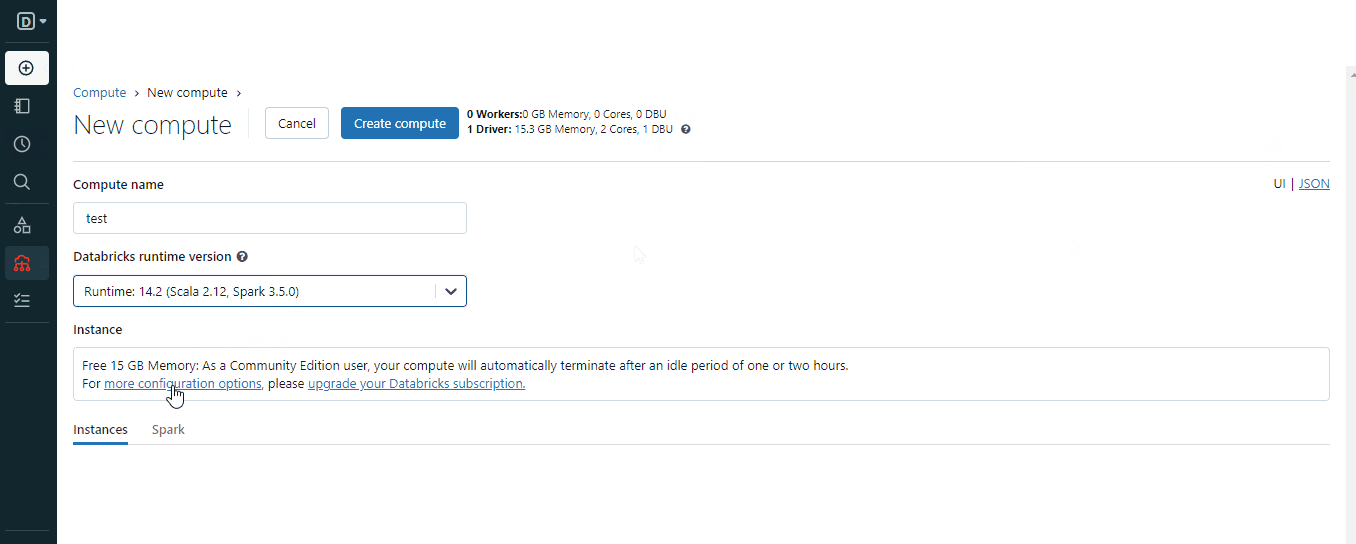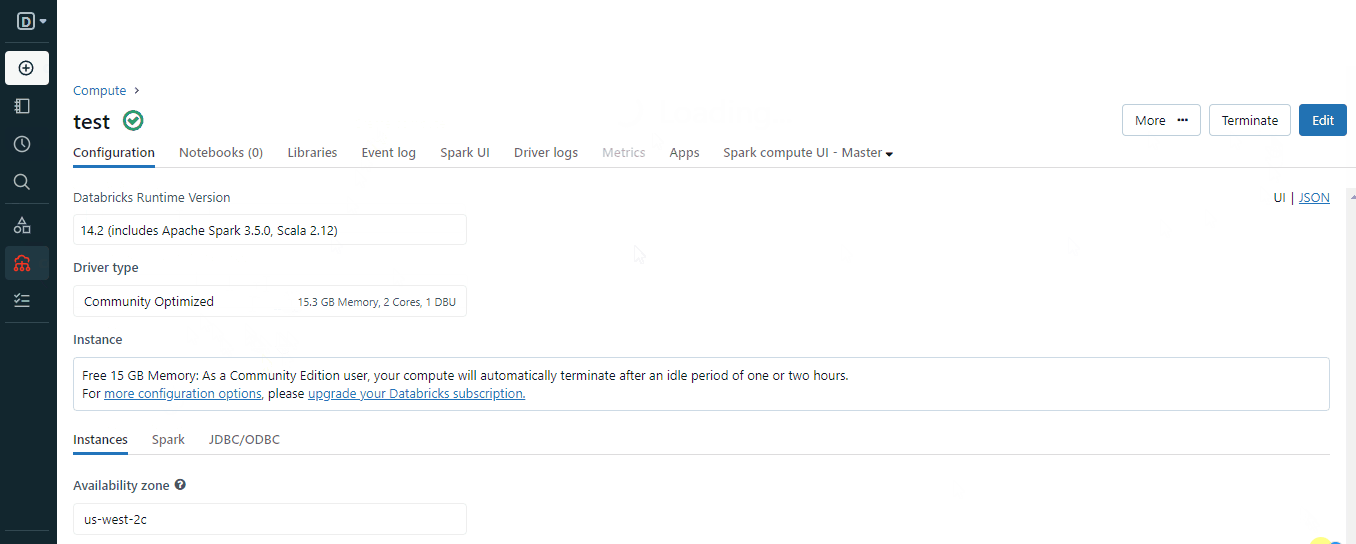
Ao criar o cluster, escolha uma versão adequada do Spark para o seu ambiente e aguarde alguns minutos até ficar operacional.
Com um cluster em execução, você já pode criar notebooks. Se você já usou Jupyter, Colab ou o DataCamp Workspaces, o formato será familiar:
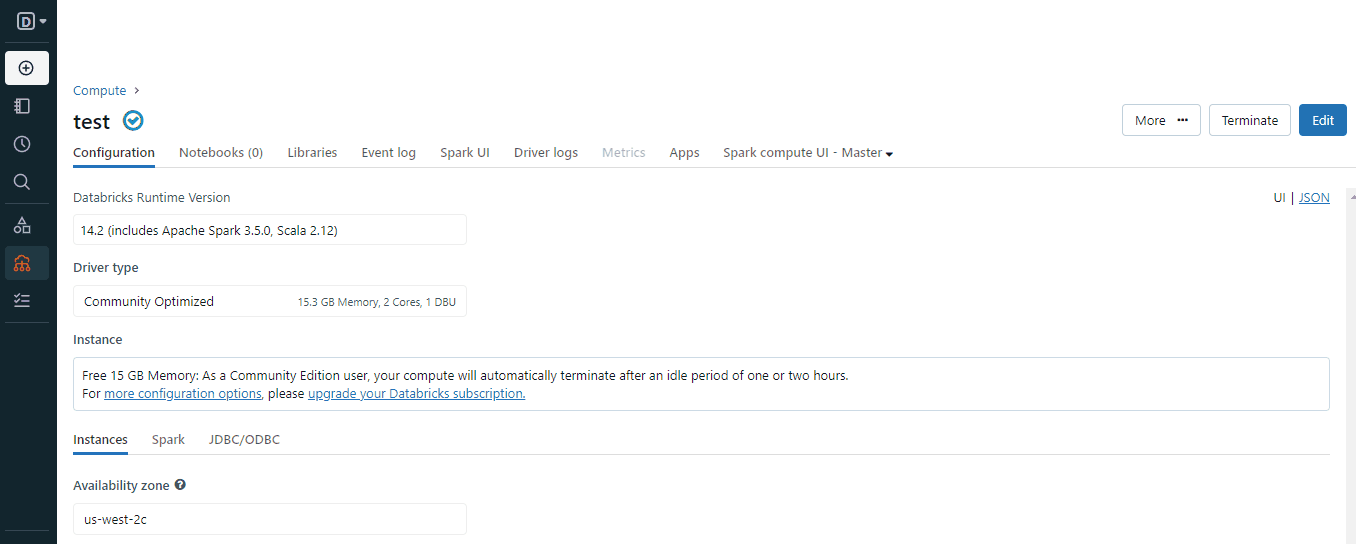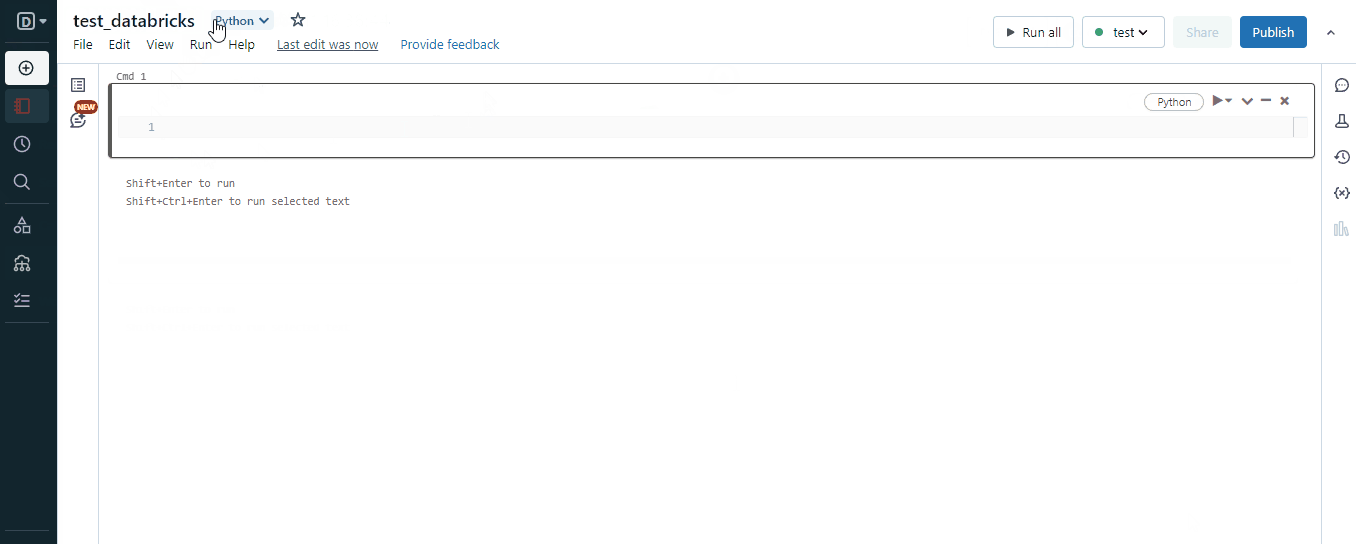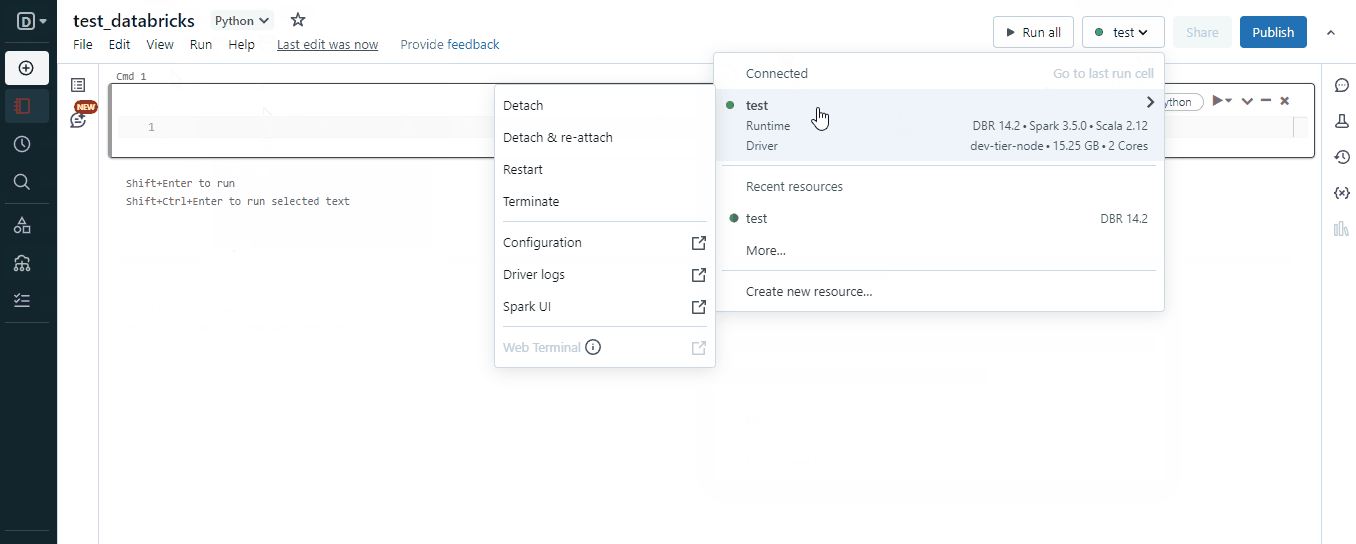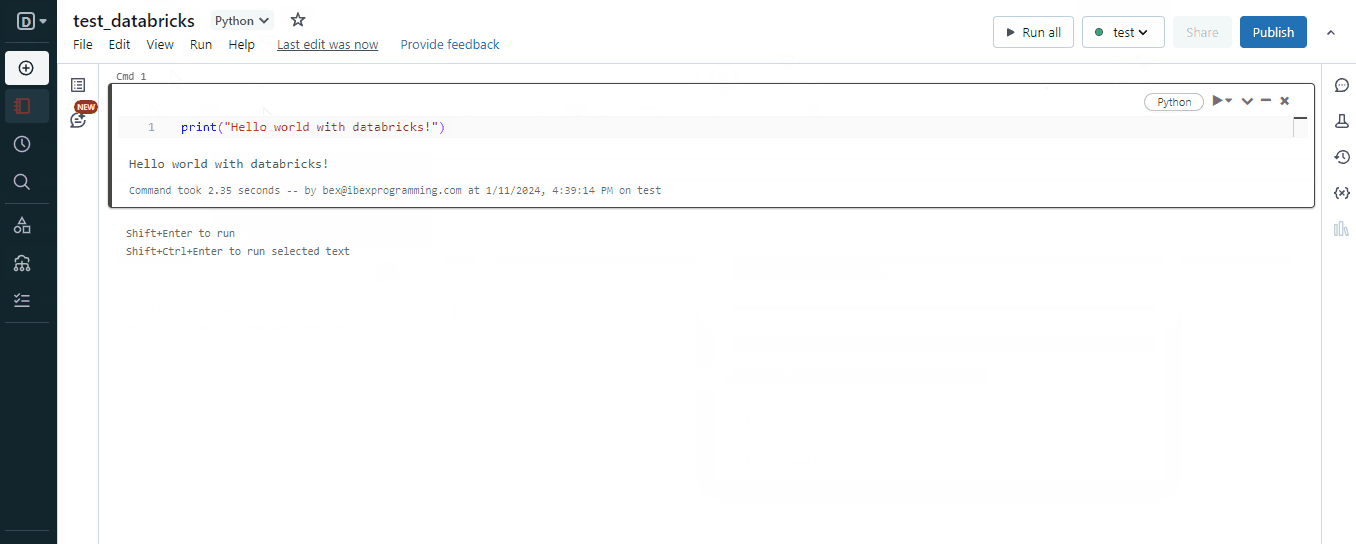
Mas, num mundo em que existe o Jupyter tradicional, por que usar algo “parecido com o Jupyter”? Bem, os notebooks do Databricks têm estas vantagens sobre os notebooks Jupyter:
Há muitas outras vantagens dos notebooks do Databricks em relação ao Jupyter; a tabela abaixo resume as diferenças:
|
Recurso |
Jupyter Notebooks |
Databricks Notebooks |
|
Plataforma |
Open source, roda localmente ou em nuvem |
Exclusivo da plataforma Databricks |
|
Colaboração e compartilhamento |
Recursos limitados de colaboração, compartilhamento manual |
Colaboração nativa, edição simultânea em tempo real |
|
Execução |
Depende de máquinas locais ou servidores externos |
Execução em clusters do Databricks |
|
Integração com Big Data |
Pode integrar com Spark, requer configurações adicionais |
Integração nativa com Apache Spark, otimizado para big data |
|
Recursos nativos |
Ferramentas/extensões externas para versionamento, colaboração e visualização |
Integração com recursos específicos do Databricks como Delta Lake e suporte nativo a colaboração e ferramentas de analytics |
|
Custo e escalabilidade |
Instalações locais costumam ser gratuitas; soluções em nuvem podem ter custos |
Serviço pago, custo depende do uso; escala de forma transparente com clusters do Databricks |
|
Facilidade de uso |
Familiar e amplamente usado na comunidade de data science |
Voltado para big data analytics; alguns recursos específicos podem ter curva de aprendizado maior |
|
Visualização de dados |
Suporte nativo limitado |
Suporte nativo à visualização dentro do notebook |
|
Gestão de cluster |
Usuário gerencia sessões do Spark e dependências manualmente |
A plataforma Databricks gerencia clusters e escala automaticamente |
|
Casos de uso |
Versátil para várias tarefas de ciência de dados |
Especializado em analytics colaborativo de big data dentro do Databricks |
No fim das contas, as vantagens dos notebooks do Databricks aparecem em casos específicos. Se você quer brincar com um CSV no Pandas no seu laptop, o Jupyter é bem melhor.
Mas, para aplicações em nível corporativo, o Databricks como plataforma tende a ser a melhor opção.
Ingestão de dados é o processo de importar dados de várias fontes. O Databricks dá suporte a ingestão de:
e muito mais.
Agora, vamos ver na prática como carregar alguns tipos de dados no Databricks. Começamos com arquivos locais:
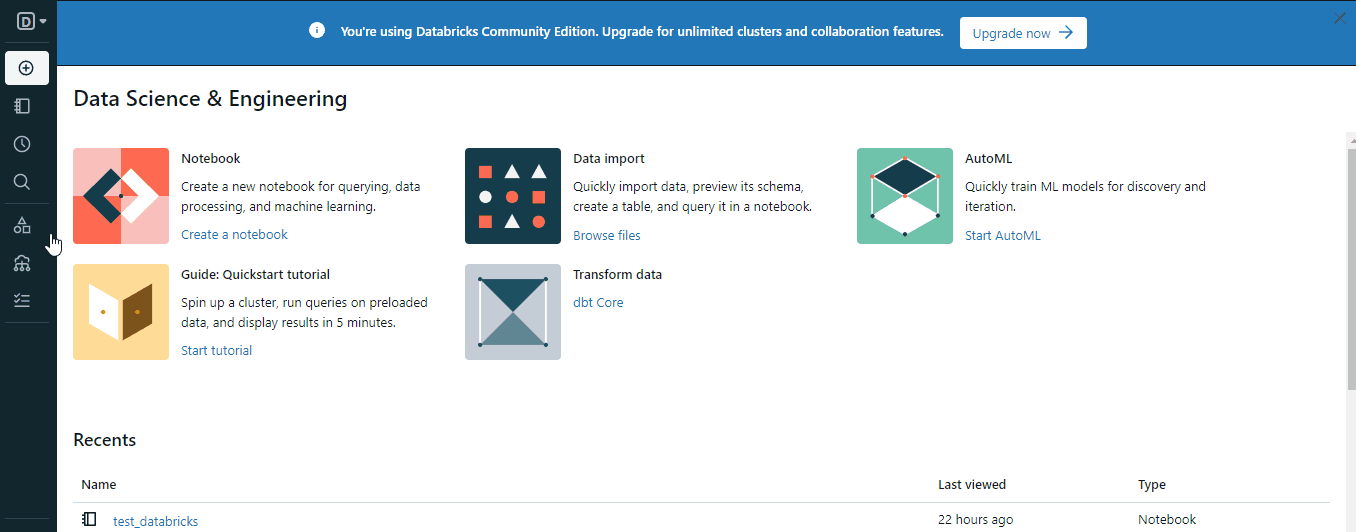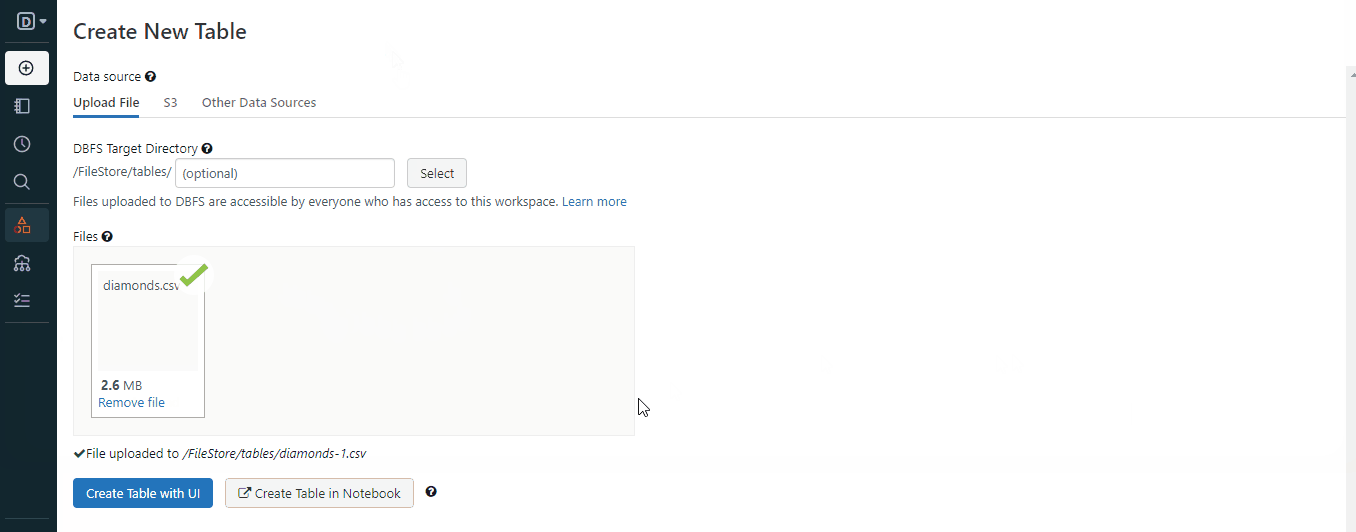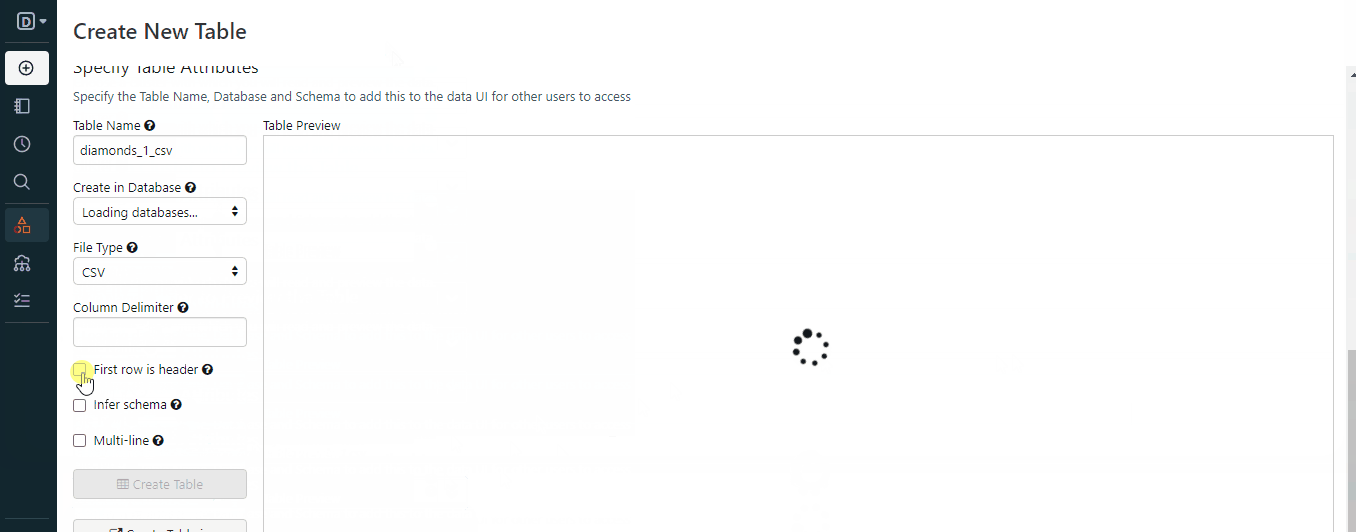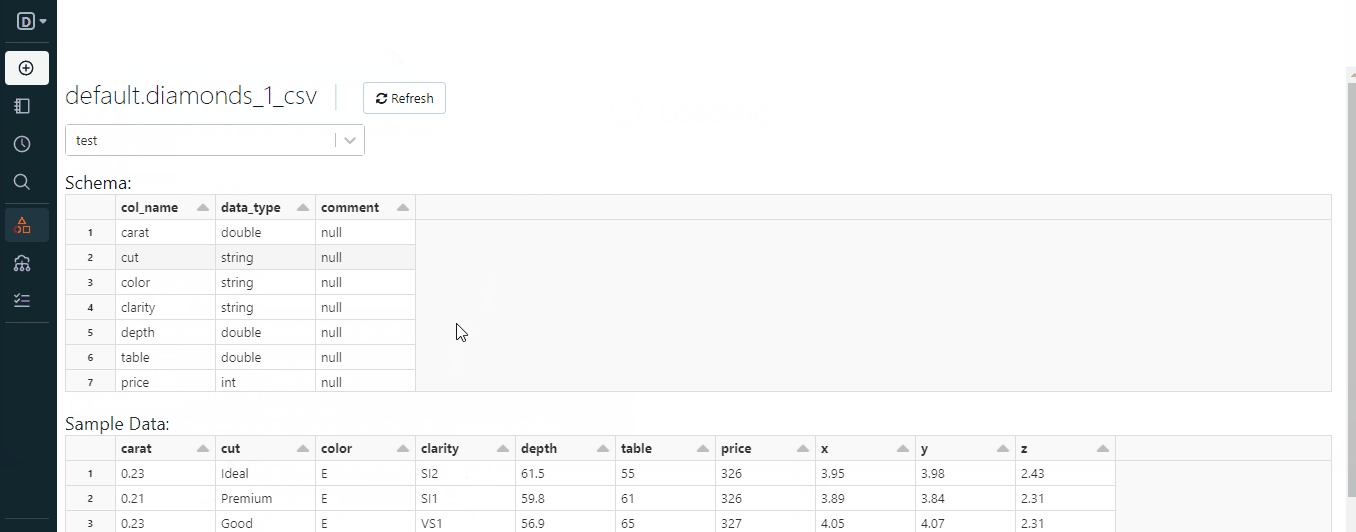
Depois de seguir os passos do GIF, o arquivo ficará armazenado no workspace. Veja como carregá-lo com Spark:
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the CSV path to the data
path = "dbfs:/FileStore/tables/diamonds.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Repare no prefixo dbfs:. Todos os arquivos do workspace precisam incluí-lo para que o Spark carregue o arquivo corretamente. DBFS significa Databricks File System.
Importar dados de um bucket S3 é semelhante (para contas enterprise):
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the S3 path to the data
s3_path = "s3://your-bucket/your-data.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(s3_path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Para outros tipos de dados, consulte as seções Data engineering e Connect to data sources da documentação do Databricks.
Quando fizemos upload do arquivo diamonds.csv, ele virou uma tabela do Databricks em um banco chamado default:
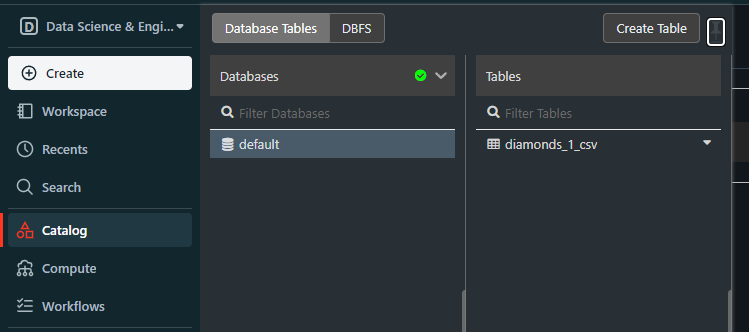
Esse banco default é criado sempre que tentamos carregar arquivos estruturados sem criar o banco antes.
Se temos um banco, dá para consultá-lo com SQL, não apenas com Spark. Para isso, crie um novo notebook ou mude a linguagem do notebook atual para SQL. Depois, rode este trecho:
SELECT * FROM default.diamonds_1_csv
LIMIT 5;
Ele deve retornar as cinco primeiras linhas da tabela diamonds:
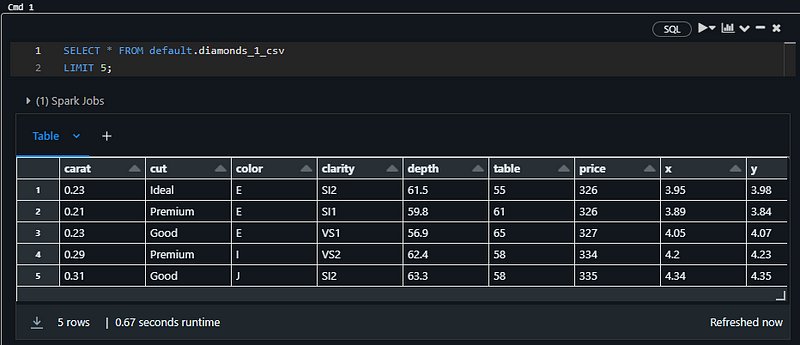
Observação: estou usando um notebook SQL no snippet acima
Você também pode carregar essa tabela no Pandas. No mesmo notebook, cole este código:
%python
# Import the necessary libraries
import pandas as pd

# Assuming 'default' is the database name and 'diamonds' is the table name
# Use the spark.sql function to query the table and retrieve the data
table_df = spark.sql("SELECT * FROM default.diamonds_1_csv")

# Convert the Spark DataFrame to a Pandas DataFrame
pandas_df = table_df.toPandas()

# Display the Pandas DataFrame
pandas_df.head()
Isso vai imprimir o head da tabela:
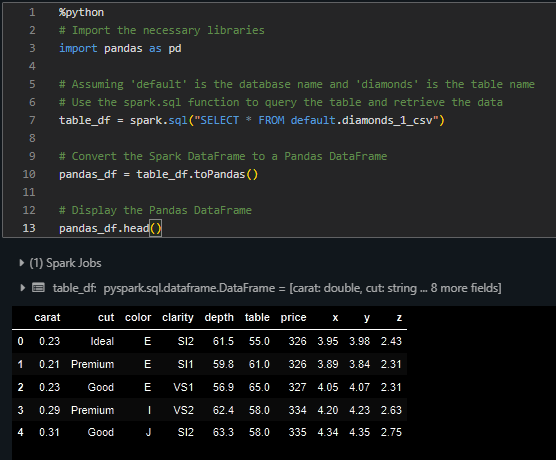
Agora você pode fazer qualquer análise típica na tabela usando tanto SQL quanto Pandas.
Usando apenas a conta básica da Community Edition, já deu para aprender e fazer bastante coisa no Databricks. Para continuar, o primeiro passo é aproveitar o teste gratuito de duas semanas que o Databricks oferece para contas premium.
Depois, você pode tirar o máximo das aulas do curso Introduction to Databricks da DataCamp. Além da configuração de conta, você vai aprender e praticar estes recursos essenciais do Databricks:
Comece sua jornada com Databricks hoje!
Curso
Programa
Programa
blog
Gus Frazer
11 min
blog
Abid Ali Awan
9 min
blog
Kurtis Pykes
11 min
blog
Tim Lu
12 min
Tutorial
DataCamp Team
13 min
Tutorial
Natassha Selvaraj
10 min


