Frågor om systemdesign dyker upp i fler intervjuer än du tror. Backendroller, självklart. Men också infrastruktur, data engineering och till och med produktnära roller där ingen förväntar sig att du skriver en rad kod under loopen.
Så vad testar intervjuaren egentligen? Inte om du kan den "korrekta" arkitekturen, för det finns ingen. De vill se strukturerat tänkande, ärliga avvägningar och om du kan resonera vidare när förutsättningarna är luddiga och klockan tickar.
Förväntningarna skiftar mycket mellan nivåer. En junior kandidat som ställer bra förtydligande frågor och skissar ett rent diagram med ett fåtal rutor gör det jättebra. En senior kandidat som bara gör det är illa ute, för på den nivån förväntar sig folk siffror, felmoder och en åsikt om vad som ska byggas först.
Rollen spelar också roll. En dataingenjör pressas på pipelines och backfills, en frontendutvecklare på caching och tillstånd, en infraperson på utrullningar och blast radius. Samma underliggande förmåga, olika vokabulär.
Jag tar upp detta eftersom de flesta frågelistor ignorerar båda dimensionerna och bara tippar ur sig 50 promptar. Den här är organiserad efter nivå först, sedan efter roll, med scenariosfrågor i slutet. Om lagringsdelen av svaren känns skakig täcker vår Database Design-kurs grunderna.
Så här angriper du en intervju om systemdesign
Samma struktur varje gång, ungefär 45 minuter:
- Förtydliga (5 min). Vem använder det, vad måste det göra, vad är utanför scope, och hur "bra" ser ut.
- Sätt siffror på det (2 min). Användare, förfrågningar per sekund, läs-/skrivmix, lagringstillväxt per år. Grovt duger, tystnad gör det inte.
- Skissa på hög nivå (10 min). Klienter, API-lager, lagring, cache, kö. Fem eller sex rutor, inte fler.
- Visa datamodellen (5 min). Tabeller eller samlingar, nycklar och åtkomstmönstren de stödjer.
- Djupdyk i en del (10 min). Låt intervjuaren välja, eller erbjud den del du tycker är mest intressant.
- Felmoder och avvägningar (resten). Vad går sönder, vad du skulle övervaka, vad du skulle bygga först om detta var på riktigt.
Berätta högt genom hela upplägget. En intervjuare kan inte bedöma tyst tänkande.
Intervjufrågor om systemdesign för nybörjare
Dessa testar grunderna: att förtydliga krav innan du ritar något, ta fram ett enkelt arkitekturdiagram och göra vettiga lagringsval. Ingen förväntar sig konsensusalgoritmer här.
1. Designa en URL-förkortare
En förkortare gör en lång URL till en kort kod och omdirigerar vid besök, så det första att reda ut är om länkar löper ut och hur många du förväntar dig. En rimlig antagande är 100 miljoner nya länkar i månaden, med läsningar cirka 100x skrivningar.
Den lästunga mixen styr designen: en API-server, en databas och en cache framför den. För den korta koden: antingen base62-koda ett autoincrement-ID (sju tecken ger cirka 3,5 biljoner kombinationer) eller generera en slumpmässig sträng och kolla kollisioner.
En enda tabell räcker: short_code som primärnyckel, long_url, created_at, expires_at och en valfri user_id. Heta koder ligger i Redis så att databasen bara ser missar. Använd en 302-omdirigering om du vill ha klickanalys, eftersom webbläsare cachar en 301 och du aldrig ser det andra besöket.
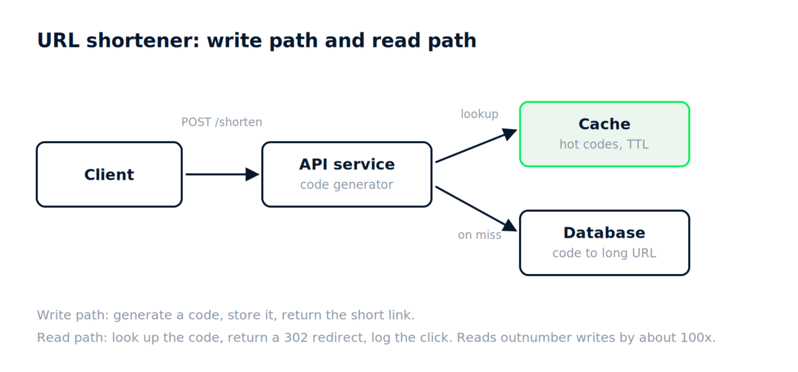
Vid 10 miljarder länkar shardar du på kod och ID-generatorn blir flaskhalsen, och om folk börjar gissa koder går du från sekventiellt till slumpmässigt och lägger till ratelimiting.
2. Designa en enkel ratelimiter
En ratelimiter tillåter N förfrågningar per användare och minut och returnerar 429 därefter. Det första att klargöra är om gränsen är per användare, per IP eller per API-nyckel, eftersom det avgör din cache-nyckel.
Tre algoritmer täcker de flesta svar. Fast fönster räknar förfrågningar i varje minutspann, vilket är enkelt men tillåter dubbla gränsen vid gränsen. Glidande fönster-logg lagrar varje tidsstämpel, vilket är exakt men minneskrävande. Token bucket fylls på i jämn takt och släpper igenom små burstar, vilket är varför många gateways använder den.
Kör limiteringen som middleware i API-gatewayen med räknare i Redis under en TTL; INCR plus EXPIRE täcker varianten med fasta fönster.
Med tio gateway-instanser delar du antingen Redis-räknarna eller accepterar lätt överslag med lokala, och du bör bestämma i förväg vad som händer om Redis dör: fail open och riskera missbruk, eller fail closed och blockera alla.
3. Designa en enkel nyckel-värdes-butik
En nyckel-värdes-butik behöver get, put och delete, och för en nybörjarfråga bör du hålla det till en enda nod. En hashkarta i minnet hanterar operationerna. För uthållighet, lägg till varje skrivning i en logg på disk innan du bekräftar den, och ta periodiska snapshots så att återställning inte spelar upp hela historiken.
Vad intervjuaren vill höra är att du har separerat den snabba vägen i minnet från den hållbara vägen på disk, och att du förstår varför loggen kommer först.
Om datan växer ur minnet är svaret ett LSM-träd, vilket i stort sett är hur RocksDB och Cassandra fungerar. Om du behöver en andra nod replikeras loggen från primären till en följare, och konsekvent hashning tar över när du går bortom det.
4. Designa en cache (konceptuellt)
En cache sitter mellan din applikation och ett långsammare lager, och grundmönstret är cache-aside. Appen kollar cachen, missar, läser databasen, skriver tillbaka resultatet med en TTL. Enkelt, men du äger ogiltigförklaringslogiken.
Utkastning betyder oftast LRU, ibland LFU för skeva arbetslaster. Den viktiga metriken är träffkvot; under ~80% bör du fråga om cachen hjälper alls.
Där det blir intressant: inaktualitet. Om databasen ändras och den cachade kopian inte gör det ser användarna gammal data tills TTL:en går ut. Korta TTL:er minskar fönstret men ökar belastningen på databasen.
När en populär nyckel löper ut och 10 000 förfrågningar träffar databasen samtidigt, samlar du antingen ihop dessa förfrågningar eller uppdaterar nyckeln innan den löper ut. Om write-through kontra write-back: write-through håller cachen korrekt till priset av långsammare skrivningar, medan write-back är snabbt men tappar senaste skrivningar om cachen dör innan den flushar.
5. Designa en grundläggande notifieringstjänst
En notifieringstjänst skickar e-post, SMS och pushmeddelanden och försöker igen när en leverantör fallerar. Innan du designar den, fråga om volym och om leveransordning spelar roll, vilket det oftast inte gör.
Kärnan i designen är en kö. Producenter skriver en notifieringshändelse till den, och en arbetare per kanal drar händelser och anropar en leverantör som SendGrid eller Twilio. Den uppdelningen håller det som beslutar om att notifiera separat från det som faktiskt skickar, så en långsam SMS-leverantör aldrig blockerar appen.
Lagra varje notifiering med en status (pending, sent, failed) och en idempotensnyckel så att en retriad händelse inte skickar två gånger.
Användare som vill stänga av marknadsföring men ha säkerhetsvarningar behöver en preferenstabell som kontrolleras innan något köas, och en leverantör som kapar dig till 100 meddelanden per sekund kräver kanalspecifik strypning i arbetaren.
6. Designa en enkel fil lagringstjänst
Tänk Dropbox i liten skala. Användare laddar upp en fil, får en länk, laddar ner den senare. Klargör maximal filstorlek och om delning spelar roll.
Metadata (ägare, filnamn, storlek, checksumma, skapandedatum) hamnar i en relationsdatabas. Själva byten hamnar i objektlagring som S3, aldrig i databasen. För uppladdningar returnerar API:t en försignerad URL så att klienten skriver direkt till objektlagringen och dina servrar aldrig rör filen.
Två användare som laddar upp samma 2 GB-fil är ett dedupe-problem som löses genom att hasha innehållet, och filer över 5 GB behöver multipart-upload med en checksumma per del.
7. Designa en spel-topplista
En topplista måste uppdatera en spelares poäng, returnera topp 10 och returnera en spelares rankning, och det första att fråga är hur många spelare det finns och hur ofta poäng ändras.
En relationstabell med ett index på poäng funkar till en gräns, men "vad är min rankning" blir ett COUNT över alla ovanför dig. Redis sorterade mängder löser detta: ZADD för att uppdatera, ZREVRANGE för topp N, ZREVRANK för en enskild spelare, allt i logaritmisk tid.
Dagliga och totaltidtopplistor är en sorterad mängd per period, nycklade som lb:2026-09-14. Om 50 miljoner spelare pressar Redis-minnet för långt, behåll bara topp 100k där och resten i databasen.
Intervjufrågor om systemdesign på mellannivå
På den här nivån antar intervjuaren att du har byggt och drivit riktiga system. Frågorna introducerar köer, läs-/skrivsäkning och spänningen mellan latens, kostnad och konsistens.
8. Designa ett nyhetsflöde
Ett flöde behöver att användare kan posta, följa andra och läsa vad de de följer skrivit, i omvänd kronologi eller rankat. Anta 10 miljoner dagliga aktiva användare som öppnar det fem gånger om dagen, vilket blir ungefär 600 läsningar per sekund i snitt och betydligt mer på toppar.
Det centrala valet är när flödet sammanställs. Fan-out vid skrivning puttar varje ny post in i varje följares förberäknade flöde, vilket ger snabba läsningar till priset av dyra skrivningar. Fan-out vid läsning sätter ihop det vid förfrågan, vilket vänder på avvägningen. De flesta riktiga system blandar, med fan-out vid skrivning för vanliga användare och vid läsning för konton med miljoner följare.
Datamodellen är posts, follows och en per-användare-flödeslista i Redis som håller post-ID:n. Paginera med en cursor på post-ID i stället för en offset.
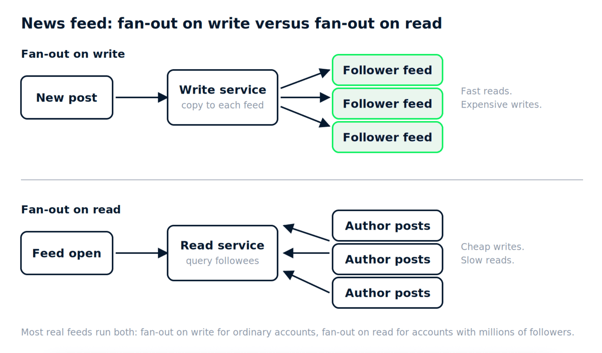
Att lägga till rankning senare betyder inte att bygga om något av detta; du poängsätter kandidat-ID:n från flödeslistan vid läsning.
9. Designa ett chatsystem med synk mellan flera enheter
Chat med multienhetssynk betyder en-till-en och gruppmeddelanden, leverans till varje enhet en användare äger, och historik som överlever ett telefonbyte. Anta 50 miljoner dagliga användare som skickar cirka 40 meddelanden var, vilket är 2 miljarder om dagen, eller ungefär 23 000 skrivningar per sekund i snitt och flera gånger det vid regionala toppar.
Varje klient håller en WebSocket till en chatserver, som skriver meddelanden till ett lager partitionerat per konversations-ID med ett stigande sekvensnummer per konversation. Varje enhet minns det senaste sekvensnumret den såg och ber om allt nyare vid återanslutning, vilket är det som får synk mellan flera enheter att fungera.
Lagringen behöver hög skrivgenomströmning och läsningar i intervall per konversation, så bredkolumnsdatabaser som Cassandra är det vanliga svaret. Leverans- och läskvitton är små händelser som flyter tillbaka längs samma väg.
När två vänner är anslutna till olika chatservrar får antingen pub/sub mellan servrarna eller en routingtjänst som mappar användare till servrar meddelandet över. Grupper på 500 sprids ut på serversidan, och ordningsgarantier blir svårare att hålla.
10. Designa en matchningstjänst för samåkning
Håll detta lättare än den seniora versionen. Förare skickar sin position var några sekunder, passagerare begär en resa, och tjänsten måste returnera en närliggande förare inom ett par sekunder.
Positionsuppdateringar är volymproblemet: 200 000 aktiva förare med en uppdatering var 4:e sekund betyder 50 000 skrivningar per sekund. Lagra aktuella positioner i minnet indexerat med geohash eller H3-cell, inte i en relationstabell. Matchning betyder sedan "hitta förare i min cell och de angränsande", rangordna efter ETA och lås en förare så att två passagerare inte får samma bil.
Om en förare accepterar och sedan tappar uppkopplingen löper låset ut och passageraren matchas om. En het cell i en stadskärna får finare celler i täta områden, vilket är precis vad hierarkiska index som H3 ger dig.
11. Designa ett system för insamling av metrics
Ett metricssystem tar emot ett par hundra metrics var tionde sekund från tusentals servrar och låter ingenjörer fråga dem i dashboards.
Agenter batchar metrics och pushar till ett inmatningslager, som skriver till en tidsseriedatabas (eller ett Kafka-ämne med konsumenter som skriver till en sådan). Lagring är skiktad: rå upplösning i en dag eller två, enminuts-aggregat i en månad, timvisa i ett år. Nedsampling körs som bakgrundsjobb.
Frågor träffar det aggregat som matchar det begärda tidsintervallet, vilket hindrar en 30-dagarsgraf från att skanna rådata. Taggkardinalitet (t.ex. användar-ID som label) kommer att ta kål på databasen, så säg det högt.
Om push kontra pull: Prometheus drar, men push funkar bättre genom brandväggar och för kortlivade jobb. En agent som rapporterar tidsstämplar i fel ordning accepteras inom ett begränsat förseningsfönster och nekas bortom det, med en räknare på nekningar så att en trasig klocka syns.
12. Designa ett system för autokomplettering i sök
Autokomplettering returnerar de fem bästa förslagen inom cirka 100 millisekunder efter varje tangenttryckning. Klargör om förslagen är globala eller personaliserade, för personalisering ändrar allt.
svaret är att förberäkna. En offline-pipeline aggregerar frågeloggar, räknar frekvenser och bygger en trie (eller en prefix-till-top-k-tabell) där varje nod redan lagrar sina bästa kompletteringar. Betjäningslagret gör sedan en enda uppslagning per tangenttryckning, och hela strukturen ryms i minnet över några repliker.
Uppdateringar sker batchvis, kanske timvis, genom att bygga om strukturen och byta in den. Trender kan få ett litet realtidslager som mergas vid förfrågan.
Ett prefix som ”a” skulle träffa ett enormt delträd, vilket är varför du lagrar top-k vid varje nod i stället för att traversera. Stavfel kräver ett separat fuzzy-index, eller så accepterar du missen.
13. Designa en distribuerad jobbschemaläggare
En distribuerad schemaläggare är cron för ett helt företag: definiera ett jobb och ett schema, kör vid rätt tid och högst en gång per tick, försök igen vid fel och visa vad som hände.
Lagra jobbdefinitioner och scheman i en databas. En schemaläggartjänst beräknar nästa körtid för varje jobb och trycker förfallna jobb på en kö; arbetarpooler drar och exekverar. Det knepiga är att köra exakt en schemaläggarinstans per jobb utan en single point of failure, vilket oftast betyder ledarval (ett lås i ZooKeeper, etcd eller en databasedrad med ett lease).
Registrera varje körning med status, starttid, sluttid och loggplats. Den tabellen blir det som folk faktiskt tittar på.
Ett jobb som kör längre än sitt intervall bör hoppas över, köas eller överlappa, och det ska vara konfigurerbart. När jobb B beror på jobb A blir beroenden en DAG, och schemaläggaren köar bara när uppströms har lyckats.
Avancerade intervjufrågor om systemdesign
Seniornivå. Enorm skala, flera regioner, tillförlitlighetsmål du kan ange som siffror och kostnaden för varje beslut. Intervjuaren förväntar sig att du själv tar upp felmoder innan du blir tillfrågad.
Videostreaming är två system under ett namn. Vid uppladdning skickar en användare en rå fil och en pipeline transkoderar den till flera upplösningar och bithastigheter, delar upp den i några sekunder styck och lagrar delarna i objektlagring. Vid uppspelning serverar ett CDN dessa delar och spelaren byter bithastighet för att matcha användarens bandbredd, vilket är adaptiv streaming via HLS eller DASH.
Ange skalan: hundratals timmar laddas upp per minut, miljarder visningar per dag, lagring i exabyten. Transkodning är pinsamt parallellt, så en stor arbetarflotta drar jobb från en kö. Metadata som titel, ägare och visningsräkning ligger i en shardad databas med tung caching eftersom startsidan läser den konstant. Objektlagring och CDN-kanter replikeras över regioner, och SLO:t som spelar roll är starttid för uppspelning, med rebufferingskvot som metrik användarna märker.
Visningsräkningar på en viral video är approximativa räknare som aggregeras i batchar, aldrig en databasinkrement per visning, och upphovsrättsmatchning är ett fingerprintjobb i samma uppladdningspipeline.
En loggningsplattform tar emot loggar från varje tjänst, gör dem sökbara inom sekunder och behåller dem 30 dagar varma och ett år kalla.
Agenter svansar loggfiler och skickar dem till en hållbar buffert som Kafka, som absorberar spikar och låter indexerare hamna efter utan att tappa data. Indexerare skriver till ett sökkluster med ett index per dag och tjänst, och gamla index rullas ner till komprimerade filer i objektlagring.
Kostnad är den verkliga begränsningen, så indexera strukturerade fält och håll råtext billig. Ge varje tjänst en kvot, övervaka index-lag och tvätta PII vid inläsning.
En tjänst som loggar 100x sin normala volym blir kvoterad, samplad, droppad och larmad på, i den ordningen. Frågor över regioner betyder federerad sökning, där varje region äger sina egna data.
16. Designa ett system för realtidsanalys
Realtidsanalys betyder dashboards som visar aggregat över de senaste minuterna, uppdaterade inom sekunder, ovanpå en ström på kanske en miljon händelser per sekund.
En strömprocessor som Flink upprätthåller fönster-aggregat, säg per-minut-räknare per dimension, och skriver dem till ett snabb-läs-lager som ClickHouse eller Druid. Dashboards frågar det lagret, aldrig den råa strömmen.
Nämn avvägningarna: exakta räkningar kontra HyperLogLog för unika användare, tumlande kontra glidande fönster och vattenstämplar för sena händelser. Sätt ett färskhets-SLO och övervaka processorns lagg mot det.
En högkardinalitetsdimension som användar-ID kommer att explodera aggregattabellen, så fråga råhändelser för just den. Backfill efter en bugg betyder uppspelning från strömmen med bevarade offsetar.
17. Designa ett betalningssystem
Betalningar är den design där korrekthet slår skala. Systemet måste debitera en kund, registrera det, aldrig debitera dubbelt, aldrig tappa en post och stämma av med banken dagligen.
Idempotens bär det mesta av detta: varje begäran har en nyckel, och tjänsten lagrar resultatet mot den och returnerar samma resultat vid retrys. Pengar rör sig genom en append-only dubbel bokföringshuvudbok där varje transaktions poster summerar till noll, i en relationsdatabas med serialiserbar isolering. Detta är ett ställe där eventual konsistens är fel svar.
Anrop till kortnät kan timea ut tvetydigt, så debiteringar får status pending och ett avstämningsjobb reglerar dem. Flera regioner betyder en hemregion per konto, aldrig aktiv-aktiv-skrivningar på samma saldo.
Flera valutor betyder heltalsbelopp i minor units med valutakod, och en återbetalning som anländer innan dess debitering reglerats hanteras av en tillståndsmaskin med explicita övergångar.
18. Designa ett storskaligt meddelandesystem
Ett storskaligt meddelandesystem låter producenter publicera och konsumenter prenumerera, överlever omstarter av brokers och bevarar ordning där det spelar roll, i miljoner meddelanden per sekund.
Partitionera varje ämne så att meddelanden med samma nyckel landar på samma partition, vilket ger ordning per nyckel utan global ordning. Varje partition är en append-only-logg replikerad till några brokers, och konsumenter commitar sin offset efter bearbetning.
Utgå från at-least-once-leverans med idempotenta konsumenter. Retries går genom ett retry-ämne med backoff och giftiga meddelanden till en dead-letter-kö. Konsumentlagg är signalen att sätta ett SLO på, och över regioner äger en region skrivningar per nyckel annars kommer de två att omordna varandra.
En konsument som kraschar efter bearbetning men före commit producerar en dubblett, vilket är varför idempotens spelar roll. Rebalanseringsstormar tämjs med sticky assignment och kooperativ rebalansering.
Intervjufrågor om systemdesign för backendutvecklare
Dessa fokuserar på API:er, datamodeller och var tjänstegränser ska gå. Förvänta dig följdfrågor om konsistens, caching och vad du skulle logga.
19. Designa en autentiserings- och auktorisationstjänst
Autentisering svarar på ”vem är du” och auktorisering svarar på ”vad får du göra”, och intervjuare gillar kandidater som håller isär dem.
Använd OAuth 2.0 och OpenID Connect i stället för att uppfinna ett protokoll. Utfärda kortlivade access tokens och längre livslängd för refresh tokens som lagras på serversidan så att du kan återkalla dem. Behörigheter ligger i en rollmodell som kontrolleras av ett litet bibliotek eller en policytjänst. Logga varje inloggningsförsök, förnyelse och nekning med IP och enhet, och logga aldrig själva token.
JWT:er undviker en uppslagning per förfrågan, men att återkalla en i förtid kräver en denylist, vilket sätter uppslagningen tillbaka. Credential stuffing bromsas med ratelimiting per IP och per konto, fördröjningar efter upprepade fel och en andra faktor vid misstänkta inloggningar.
20. Designa en API-gateway
En API-gateway är en enda ingång framför dina tjänster som hanterar det tvärgående arbetet så att varje tjänst slipper: routing per sökväg och version, TLS-terminering, autentisering, ratelimiting och förfrågningsloggning.
Själva gatewayen bör vara tillståndslös och skalas horisontellt bakom en lastbalanserare. Ruttkonfiguration bor i en kontrollplan och pushas till gateway-instanser, så du behöver aldrig rulla ut gatewayen för att lägga till en rutt. Autentiseringstoken valideras en gång vid kanten och gatewayen vidarebefordrar användaridentiteten som en header.
Blast radius är det du ska säga högt. Gatewayen ligger på varje förfrågningsväg, så en dålig konfigpush tar ner allt; validera konfigurationer, rulla ut dem gradvis och håll gatewayens egen logik tunn.
Versionering utan att bryta mobilklienter du inte kan uppdatera betyder versionssättning i sökväg eller header med gamla versioner som hålls vid liv. Och gatewayen ska inte aggregera svar från flera tjänster; det hör hemma i ett backend-for-frontend-lager.
21. Designa ett ordersystem för en e-handelssajt
Ett ordersystem skapar en order, reserverar lager, tar betalt, skickar och låter kunden se status. Ordrar är en tillståndsmaskin (created, paid, packed, shipped, delivered, cancelled), och de tillåtna övergångarna ska vara explicita.
Orderläggning är en POST med en idempotensnyckel så att ett dubbelklick inte skapar två ordrar. Lagerreservation och betalning involverar andra tjänster, så använd en saga: varje steg publicerar en händelse, och fel triggar kompenserande åtgärder (släpp lager, återbetala). Skriv händelsen till en outbox-tabell i samma transaktion som orderuppdateringen så att databasen och meddelandebussen aldrig är oense.
På lässidan: en ordertabell plus en order_items-tabell, med en materialiserad ordersammanfattning cachad för sidan "mina ordrar".
Två kunder som köper sista exemplaret samtidigt löses med en radringlåsning eller atomisk dekrement på lager, där en av dem får ett slut i lager-meddelande. Det du ska övervaka är ordrar som fastnar i ett tillstånd längre än väntat.
22. Designa en feature flag-tjänst
En feature flag-tjänst växlar funktioner per miljö, riktar in sig på användarattribut eller procent och kan slå om en flagga globalt inom sekunder när något går sönder.
Flaggdefinitioner och målriktningregler ligger i en liten databas bakom ett admin-API. Applikationer bäddar in ett SDK som hämtar alla flaggor vid uppstart, cachar dem lokalt och utvärderar regler i processen, så en flaggkontroll kostar inget vid förfrågan. Uppdateringar sprids via en strömmad koppling eller kort polling, och SDK:t behåller det senast kända tillståndet om flaggtjänsten är nere.
Utvärdera procentuella utrullningar med en stabil hash av användar-ID och flaggnyckel, så att samma användare alltid hamnar på samma sida.
Inaktuella flaggor hittas genom att spåra senast utvärderade tidsstämplar och påminna ägare, och om flaggtjänsten är nere vid uppstart faller applikationen tillbaka till defaultvärden som levereras i koden.
23. Designa ett API för rekommendationsbetjäning
Ett rekommendations-API returnerar 20 objekt för en användare på under 100 millisekunder vid några tusen förfrågningar per sekund, och ingen djup ML krävs för att designa det.
Dela upp offline och online. Ett offlinejobb beräknar kandidatslistor per användare in i en nyckel-värdes-butik med låg latens. Det online-API:t hämtar dem, rankar om med några färska signaler som lagersaldo, filtrerar bort vad användaren redan köpt och returnerar listan. Ha en fallback med populära objekt per kategori, och logga varje serverad lista med ett request-ID så att du kan förena den med klick senare.
En ny användare får fallback tills några interaktioner kommer in. De 100 millisekunderna delas ungefär i 10 för hämtning, 30 för omrankning, 10 för serialisering och 50 i luftmarginal.
Intervjufrågor om systemdesign för infrastruktur/DevOps
Tillförlitlighet, driftsättning, automatisering och observabilitet. Det återkommande temat: hur ändrar du saker säkert och vet snabbt när du hade fel.
24. Designa en CI/CD-pipeline för mikrotjänster
En CI/CD-pipeline för mikrotjänster måste hantera dussintals oberoende driftsättbara tjänster med tester, säkerhetskontroller och en väg till produktion som inte kräver en människa klockan 03.00.
Bygg en gång, driftsätt samma artefakt överallt. Pipelinen lintar, kör enhetstester, bygger en containerimage taggad med commit-SHA, skannar den och pushar den till ett register. Driftsättning främjar sedan den imagen genom miljöer (dev, staging, produktion) med konfiguration i stället för att bygga om.
Produktionsutrullning bör vara progressiv: kanariet till några procent av trafiken, övervaka felfrekvens och latens under ett definierat fönster, fortsätt sedan eller rulla tillbaka automatiskt. Rollback betyder att rulla ut föregående imagetag, vilket går fort just för att du aldrig byggde om.
När en förändring i tjänst A bryter tjänst B:s kontrakt är lösningen kontraktstester i CI och bakåtkompatibla API-ändringar. Monorepo kontra många repo spelar mindre roll än folk tror, så länge pipelinen bara bygger det som ändrats.
25. Designa centraliserad övervakning och larm
Centraliserad övervakning samlar metrics, loggar och spår från varje tjänst på ett ställe, med larm som väcker folk bara när användare påverkas.
Metrics går till ett tidsserielager, loggar till plattformen från fråga 15, spår till en tracing-backend, allt korrelerat med ett gemensamt request-ID. Designbeslutet som spelar roll är vad du larmar på. Larma på symptom (felfrekvens, latenser i percentiler, mättnad) knutna till SLO:er, inte på orsaker som "CPU på 80%."
Pagingtrötthet dödar jourrotationer, så varje page behöver en runbook och en genomgång. Allt som pajar två gånger på en vecka utan tydlig åtgärd degraderas till ett ärende.
Ett SLO för en helt ny tjänst kommer av att mäta i ett par veckor och sedan sätta ett mål något bättre än nuvarande. Och när övervakningssystemet självt är nere är externa syntetiska tester och ett dead man’s switch-larm det som säger till.
26. Designa en strategi för hemlighetshantering
Hemlighetshantering gör databaslösenord, API-nycklar och certifikat tillgängliga för tjänster vid körning, aldrig i källkod, roterade regelbundet och reviderade.
Ett centralt hemlighetsförråd (HashiCorp Vault, en molnleverantörs secrets manager) håller allt. Tjänster autentiserar sig mot det med sin arbetsladsidentitet (ett Kubernetes servicekonto, en IAM-roll), aldrig en långlivad token, och hämtar hemligheter vid uppstart eller on demand. Föredra dynamiska hemligheter där det är möjligt: förrådet genererar en databaskreditiv giltigt i en timme, och rotation sker automatiskt.
Granska varje läsning. Och ha en dokumenterad break-glass-väg för när hemlighetsförrådet självt ligger nere, för det kommer att hända.
En nyckel som en utvecklare av misstag committar fångas av skanning i CI, roteras omedelbart och behandlas som komprometterad oavsett. Hemligheter i miljövariabler är vanliga men läcker via kraschdumpningar och barnprocesser, så montera dem som filer eller hämta dem i processen.
27. Designa autoskalning och en utrullningsstrategi
Autoskalning och utrullning måste tillsammans låta en tjänst hantera dagliga trafiksvängningar på 5x utan manuell insats, samtidigt som deployer sker flera gånger om dagen.
Skala på en signal som speglar användarsmärta, vanligtvis begärandehastighet eller latens per instans, snarare än enbart CPU. Sätt ett minsta antal repliker så att en kallstart aldrig möter en puckel, och ett max så att en bugg inte ruinerar dig. Skala upp snabbt och ner långsamt.
För utrullning: använd blå/grön när du behöver ett omedelbart skifte och omedelbar rollback, och canary när du vill observera riktig trafik på en liten andel först. Kombinera canary med autoskalaren varsamt, eftersom en canary som skalar oberoende kan snedvrida jämförelsen.
Om skalningen släpar efter en plötslig puckel med två minuter täcker prediktiv skalning enligt schema eller en högre miniminivå glappet. Och 50 nya instanser som tömmer databasanslutningar är anledningen till att anslutningspoolning hör hemma i ett proxylager.
Intervjufrågor om systemdesign för dataingenjörer
Pipelines, lagringsformat, batch kontra strömning och om datan går att lita på. Samma ramverk som tidigare, men felmoderna handlar om förlorad, duplicerad eller försenad data snarare än tappade förfrågningar.
28. Designa en pipeline för händelseintag
En pipeline för händelseintag tar beteendehändelser från webb- och mobilklienter och gör dem sökbara inom en timme. Anta 50 000 händelser per sekund vid topp, med klienter som går offline och försöker igen.
Klienter batchar händelser via ett SDK och postar till en insamlingstjänst som validerar mot ett schemaregister och skriver till en ström (Kafka eller en hanterad motsvarighet). En konsument landar råa händelser i objektlagring partitionerad per timme, i ett kolumnärt format som Parquet. Nedströmsjobb läser därifrån.
Retries innebär dubbletter, så varje händelse bär en klientgenererad UUID och landningsjobbet avdubblar inom ett fönster. Schematändringar går via registret med kompatibilitetskontroller, eftersom en mobilapp på en gammal version kommer fortsätta skicka det gamla formatet i månader.
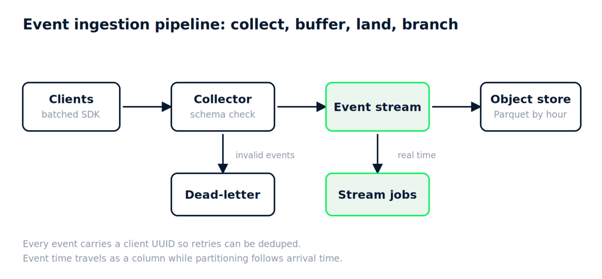
En händelse med en tidsstämpel från tre dagar sedan landar efter ankomsttid, behåller sin händelsetid som en kolumn och låter nedströms bestämma. Felaktiga händelser går till en dead-letter-väg och släpps aldrig tyst.
29. Designa ett strömmande ETL-system
Strömmande ETL transformerar händelser när de anländer, förenar dem med referensdata och skriver resultat till en serving-butik inom sekunder.
En strömprocessor läser från intagsämnet, applicerar transformationer och berikar med referensdata inlästa i minnet och uppdaterade periodiskt. Tillstånd (för fönsterbaserade joins eller aggregeringar) checkpointas till varaktig lagring så att ett kraschat jobb återupptas utan att omprocessa från början.
Den avvägning intervjuare vill höra namnges: exakt en gång kontra minst en gång. Exakt en gång är möjligt från ände till ände om sänkan stöder transaktioner eller idempotenta skrivningar, men det kostar latens och komplexitet. Minst en gång med idempotenta sänkor ger dig det mesta av nyttan.
Sen data hanteras med vattenmärken och en definierad respitperiod, varefter den går till en tabell för sena ankomster.
Referensdata som ändras mitt i strömmen bör versionshanteras, med join på den version som gällde vid händelsetiden. En backfill sex månader efter en logikfix spelas om från rålagring i batch, inte via strömmen.
30. Designa ett datalager och en modelleringsmetod
Ett lager måste ge analytiker och instrumentpaneler konsekventa mått över sälj-, marknads- och produktdata, med historik bevarad.
Landa rådata orörd i ett bronslager, rengör och konforma i silver, och bygg verksamhetsnära tabeller i guld. Modellera guld som ett stjärnschema: faktatabeller på den finaste användbara nivån (en rad per orderrad, till exempel) och dimensionstabeller för kunder, produkter, datum. Långsamt föränderliga dimensioner får Typ 2-behandling där historik är viktig, så att en kunds regionsbyte inte skriver om fjolårets intäkter.
Partitionera stora faktatabeller per datum, klustra efter kolumner som folk filtrerar på, och håll transformationer i versionskontroll (dbt eller motsvarande) med tester.
När två team definierar ”aktiv kund” olika, löser ett metrisklager med en enhetlig definition det. Ett sent ankommet faktum som refererar till en dimensionsnyckel som ännu inte finns får en platshållardimensionrad som fylls i i efterhand.
31. Designa en feature store
En feature store beräknar features en gång och återanvänder dem för både modellträning och onlineprediktion utan träning/serving-drift, och denna hålls på hög nivå. Det är två butiker med en definition: offline-butiken (ett lager eller en sjö) håller feature-historik för att bygga träningsset, och online-butiken (Redis, DynamoDB) håller senaste värdet per entitet för låglatensuppslag vid prediktion.
En enda featuredefinition driver båda, och ett jobb materialiserar från offline till online enligt schema.
Det kritiska begreppet är punkt-i-tid-korrekthet. När du bygger ett träningsset måste varje rad använda featurevärden så som de såg ut vid radens tidsstämpel, inte de aktuella. Annars lär sig din modell från framtiden och ser fantastisk ut tills den skeppas.
En feature som är dyr att beräkna i realtid förberäknas antingen med viss ålder eller beräknas vid skrivning. För att veta att online- och offlinevärden matchar, sampla och jämför dem, och logga de features du faktiskt serverade.
32. Designa ett lager för datakvalitet och härledning
Ett lager för datakvalitet och härledning upptäcker trasig data innan instrumentpaneler gör det och svarar på ”var kom den här kolumnen ifrån” utan att läsa kod.
Kvalitetskontroller körs som pipelinesteg: räkna rader mot förväntade intervall, null-frekvenser, färskhet (landade partitionen i tid), och några affärsassertioner (intäkter är aldrig negativa). Fel blockerar nedströmsjobb och larmar ägaren. Spara kontrollresultat över tid så att du kan se drift, inte bara dagens godkänt eller underkänt.
Härledning fångas från själva transformationskoden (SQL-parsning eller orkestreringsverktygets metadata) och lagras som en graf: tabell till tabell, kolumn till kolumn där det är möjligt. Den grafen driver konsekvensanalys när någon vill ta bort en kolumn.
Om kontroller tar längre tid än pipelinen, sampelera, eller kör de tunga asynkront och larma i stället för att blockera. Härledning över verktyg som inte pratar med varandra innebär OpenLineage eller manuella annoteringar, med luckorna dokumenterade.
Intervjufrågor om systemdesign för frontend/fullstack
Klientprestanda, tillståndshantering, cachning och hur webbläsaren pratar med API:et. Säkerhetsgrunder dyker upp här också.
33. Designa arkitekturen för en högtrafikerad webbapp
En högtrafikerad webbapp här betyder en innehållstung sajt med miljoner dagliga besökare, snabb första rendering och personliga sektioner för inloggade användare.
Statiska tillgångar läggs på en CDN med långa cache-livstider och hashade filnamn. Sidor som är samma för alla renderas på servern och cachas vid kanten; personliga delar laddas på klientsidan efter att skalet målats. Den hybriden håller time-to-first-byte låg utan att servera inaktuell personlig data.
API-anrop från klienten går via gatewayen med kortlivade token. Sätt cache-headrar med avsikt: Cache-Control med stale-while-revalidate för innehåll som kan vara några sekunder gammalt, no-store för allt personligt.
För en instrumentpanel bakom inloggning är rendering på klientsidan oftast bra, eftersom SSR ger lite utan SEO. Och en cache-nyckel som av misstag inkluderar sessionscookien ger alla sin egen kopia, så träfffrekvensen kollapsar.
34. Designa offline-först-synk
Offline-först-synk betyder en antecknings- eller fältdataapp som fungerar utan uppkoppling och synkar när den är tillbaka, utan att tappa någons ändringar.
Varje skrivning går först till en lokal butik (IndexedDB, SQLite på mobil) och till en kö av väntande mutationer. När uppkoppling återvänder trycker klienten kön i ordning och hämtar ändringar sedan sin senaste synk-token. Varje mutation bär ett klient-ID och ett sekvensnummer så att servern kan avdubbla.
Konflikter är hela problemet. Sista skrivning vinner är enkelt och tappar data. Sammanfogning på fältnivå hanterar de flesta fall.
CRDT:er ger automatiska sammanslagningar för text och listor till priset av komplexitet, och jag skulle bara välja dem om samredigering verkligen är ett krav.
En användare som redigerar på två enheter offline och tar tillbaka båda får båda ändringarna applicerade, konflikten flaggad och UI:t som visar den. En väntande kö som växer till 10 000 mutationer bör komprimeras, så att tio ändringar av ett fält blir en.
35. Designa realtidsuppdateringar i UI
Realtidsuppdateringar i UI betyder en instrumentpanel eller chattvy som speglar serverside-ändringar inom en sekund för tusentals samtidiga användare.
Välj transport efter riktning. Server-Sent Events när data bara flödar server till klient (livescore, aviseringar); WebSockets när klienten skickar mycket också (chatt, samredigering). Long polling som fallback för nätverk som blockerar båda.
På servern sprider ett pub/sub-lager ut ändringar till den anslutningsserver som håller användaren. På klienten, hantera återanslutning med backoff och återuppta från senaste händelse-ID så att en tappad anslutning inte betyder en missad uppdatering. Stryp rendering: 50 uppdateringar i sekunden till ett diagram bör batchas till några omritningar, inte 50.
100 000 användare som tittar på ett liveevenemang är serverside-fan-out, möjligen via en CDN som stöder strömning. Att autentisera en WebSocket innebär en token i initiala handskakningen, återvaliderad periodiskt.
36. Designa en klientprestandaplan för instrumentpaneler
Målet är en analysinstrumentpanel med 20 diagram som laddar på under tre sekunder och förblir responsiv vid filtrering.
Hämta inte 20 diagram på en gång. Ladda de synliga först, lazy-loada resten vid scroll, och visa skelett i stället för snurror. Föraggregera på servern så att klienten tar emot några hundra rader per diagram, aldrig råa händelser.
Cacha frågeresultat i minnet nycklat på filtertillstånd, så att växling av ett filter fram och tillbaka inte hämtar igen.
Tabeller med tusentals rader behöver virtualisering (rendera bara det som syns). Tunga beräkningar går till en web worker så att huvudtråden förblir fri för interaktion.
Om API:et är långsamt och du inte kan ändra det, cacha aggressivt, visa inaktuell data med tidsstämpel och uppdatera i bakgrunden. CORS-fel när instrumentpanelen anropar ett nytt API betyder att API:et måste tillåta instrumentpanelens ursprung, och du bör kunna förklara preflight-förfrågningar.
Scenariobaserade intervjufrågor om systemdesign
Dessa testar omdöme snarare än arkitektur. Krav ändras, produktion går sönder, och intervjuaren vill se hur du prioriterar.
37. Trafiken ökar 10x över en natt. Vad ändras först?
Börja med det som går sönder först, och det är sällan det tillståndslösa lagret. Autoskalning hanterar webbservrarna; databasen, cachen och eventuella tredjeparts gränser för hastighet är där det fallerar.
Omedelbart: kolla mättnadsmåtten (anslutningar, CPU, ködjup) för databas och cache, höj autoskalarens tak och slå på eventuell load shedding du har, såsom att släppa icke-kritiska funktioner eller servera cachade sidor. Inom en dag: lägg till läsrepliker, trimma cacheträfffrekvensen och hitta de frågor som dominerar. På längre sikt: gör sharding- och köarbetet du skjutit upp.
Att skilja verklig tillväxt från en bot handlar om förfrågningsmönster, user agents och om konverteringar rörde sig.
38. Du når gränser för databasläsning. Cache, repliker eller sharding?
I den ordningen, oftast. En cache framför de hetaste läsningarna är billig och kan halvera databastromsen inom en dag; kolla träfffrekvensen och frågeloggen för att bekräfta att läsningarna faktiskt är repetitiva.
Läsrepliker kommer härnäst när läsmixen är bred snarare än het. De lägger till replikeringsfördröjning, så alla read-after-write-vägar (en användare sparar och ser sin ändring direkt) måste gå till primären. Sharding löser skrivgränser mer än läsgränser och kostar dig kors-shard-frågor och en migrering, så det är sist, och bara när de två första är uttömda.
Om en massiv kund på en enda tabell orsakar belastningen, isolera den hyresgästen eller partitionera efter kund-ID.
39. Ett kritiskt nedströmsberoende är fladdrigt. Retries, timeouts, circuit breakers?
Allihop, och i rätt ordning. Först en timeout, för ett anrop utan timeout gör ett långsamt beroende till ditt eget avbrott när trådar hopar sig. Sedan retries med exponentiell backoff och jitter, men bara för idempotenta anrop och bara ett par gånger, annars förstärker du lasten på en tjänst som redan kämpar.
Sedan en circuit breaker: efter en tröskel av fel, sluta anropa ett tag och servera en fallback (cachad data, ett degraderat svar, ett vänligt fel). Övervaka brytarens tillstånd; en brytare som fastnar öppen är ett eget incident.
När det fladdriga beroendet är din betalningsleverantör finns ingen fallback för själva debiteringen; köa ordern som väntande och behandla den senare.
40. Latens försämrades efter en lansering. Hur diagnostiserar du?
Bekräfta först att det är verkligt och avgränsat: vilken percentil flyttade sig (p50 eller bara p99), vilka endpoints, vilken region. Jämför mot deploytidslinjen; om försämringen stämmer med en release, rulla tillbaka först och undersök sedan.
Om rollback inte är svaret, följ förfrågan. Traces visar vilken span som växte. Vanliga bovar: en ny fråga utan index, ett N+1-mönster introducerat av ett nytt fält, en cache-nyckeländring som sänkte träfffrekvensen, eller ett nedströmsanrop som brukade vara asynkront och nu ligger på förfrågningsvägen.
Om bara p99 flyttade sig och tillbaka-rullning inte hjälpte, leta efter garbage collection-pauser, en bullrig granne eller en låsning.
41. Ett datainkonsekvensfel dyker upp. Vad kollar du, vad rullar du tillbaka?
Avgränsa skadan innan du rör något. Vilka tabeller eller poster är oense, sedan när, och händer det fortfarande? Svaret på ”sedan när” pekar oftast på en deploy eller ett jobbkörning.
Kolla skrivvägen för de berörda posterna: senaste migrationer, ett jobb som körde två gånger, en retry utan idempotens, en kapprustning mellan två skrivare. Stoppa blödningen genom att pausa det felande jobbet eller rulla tillbaka koden, reparera sedan från en källa till sanning (den råa händelseloggen, huvudboken, en backup) snarare än att handredigera rader. För protokoll över vad du ändrade och varför.
Utan en sanningskälla att reparera från, återskapa det du kan, flagga resten och lägg till outbox-mönstret så att det inte händer igen.
Vanliga misstag i systemdesignintervjuer
De flesta kandidater misslyckas av samma handfull skäl. Inget av dem handlar om att veta mindre.
- Hoppar över förtydligande frågor. Att gå direkt till lådor betyder att du kan lösa fel problem i 40 minuter.
- Inga siffror. ”Det måste skala” betyder inget. 5 000 skrivningar per sekund och 2 TB per år betyder något, och det ändrar designen.
- En perfekt arkitektur. Intervjuare vill höra ”Jag skulle välja X på grund av Y, och kostnaden är Z.” Ett enda självsäkert svar utan avvägningar låter memorerat.
- Mikrotjänster för tidigt. En monolit med bra gränser är ett bra svar för de flesta nybörjar- och mellannivåfrågor. Att dela upp i 12 tjänster på whiteboarden lägger till felmoder som du nu måste försvara.
- Ignorerar drift. Hur deployas det, vad övervakar du, vad händer när en nod dör. Seniora intervjuare kommer fråga, och juniorer får pluspoäng för att nämna det självmant.
- Glömmer datamodellen. Lådor och pilar utan aning om vad som finns i tabellerna. Denna är särskilt kostsam för dataroller.
- Blir tyst. Att tänka tyst i två minuter känns som en evighet för intervjuaren. Berätta högt, även om det är ”Jag väger två alternativ här.”
Hur du förbereder dig för systemdesignintervjuer
Förberedelse fungerar när den är upprepningsbar. Här är en process jag faktiskt skulle följa.
- Använd samma struktur varje gång. De sex stegen från toppen av denna artikel, i den ordningen, på varje fråga du övar på. Skriv dem på ett kort och öva tills sekvensen är automatisk och du slutar slösa uppmärksamhet på vad som kommer härnäst.
- Gör tidsatta låtsasintervjuer. Ta en vän, en kollega eller bara en röstinspelare och kör 45 minuter högt med någon som avbryter dig med följdfrågor. De första blir skakiga, och det är poängen.
- Bygg en designtemplate. Ett en-sides fusklapp som listar mönstren du ofta återkommer till: cache-aside, köer för avkoppling, pub/sub för fan-out, CQRS när läsningar och skrivningar divergerar, sharding per nyckel, outbox för konsistens över en databas och en buss. Gå igenom den före varje pass.
- Öva på att förklara avvägningar, inte bara rita. För varje mönster på det bladet, kunna säga i en mening vad det ger dig och vad det kostar. Den meningen är det som skiljer ett godkänt från ett starkt godkänt.
- Gå efter nivå och roll. Välj fem frågor från din nivå och fyra från din roll i den här listan, och repetera dem ordentligt i stället för att skumma alla 41. Om datapipeline-frågorna kändes ovana, våra Introduction to Data Engineering och Streaming Concepts-kurser täcker vokabulären som de svaren bygger på.
Slutsats
Varje fråga i den här listan kom från ett system som någon var tvungen att bygga och sedan hålla vid liv klockan 03.00, så ju mer av det du gör, desto mindre känns intervjun som en uppvisning och desto mer som att beskriva din tisdag. Kör ett sidoprojekt med en riktig kö i, anmäl dig till jourrotationen, be att få sitta med på en designgranskning även när designen inte är din.
Och om du vill ha strukturerad mark att täcka mellan nu och din nästa loop, går dessa djupare på delarna som svaren lutar sig mot:
Frågor om systemdesign dyker upp i fler intervjuer än du tror. Backendroller, självklart. Men också infrastruktur, data engineering och till och med produktnära roller där ingen förväntar sig att du skriver en rad kod under loopen.
Så vad testar intervjuaren egentligen? Inte om du kan den "korrekta" arkitekturen, för det finns ingen. De vill se strukturerat tänkande, ärliga avvägningar och om du kan resonera vidare när förutsättningarna är luddiga och klockan tickar.
Förväntningarna skiftar mycket mellan nivåer. En junior kandidat som ställer bra förtydligande frågor och skissar ett rent diagram med ett fåtal rutor gör det jättebra. En senior kandidat som bara gör det är illa ute, för på den nivån förväntar sig folk siffror, felmoder och en åsikt om vad som ska byggas först.
Rollen spelar också roll. En dataingenjör pressas på pipelines och backfills, en frontendutvecklare på caching och tillstånd, en infraperson på utrullningar och blast radius. Samma underliggande förmåga, olika vokabulär.
Jag tar upp detta eftersom de flesta frågelistor ignorerar båda dimensionerna och bara tippar ur sig 50 promptar. Den här är organiserad efter nivå först, sedan efter roll, med scenariosfrågor i slutet. Om lagringsdelen av svaren känns skakig täcker vår Database Design-kurs grunderna.
Så här angriper du en intervju om systemdesign
Samma struktur varje gång, ungefär 45 minuter:
Berätta högt genom hela upplägget. En intervjuare kan inte bedöma tyst tänkande.
Intervjufrågor om systemdesign för nybörjare
Dessa testar grunderna: att förtydliga krav innan du ritar något, ta fram ett enkelt arkitekturdiagram och göra vettiga lagringsval. Ingen förväntar sig konsensusalgoritmer här.
1. Designa en URL-förkortare
En förkortare gör en lång URL till en kort kod och omdirigerar vid besök, så det första att reda ut är om länkar löper ut och hur många du förväntar dig. En rimlig antagande är 100 miljoner nya länkar i månaden, med läsningar cirka 100x skrivningar.
Den lästunga mixen styr designen: en API-server, en databas och en cache framför den. För den korta koden: antingen base62-koda ett autoincrement-ID (sju tecken ger cirka 3,5 biljoner kombinationer) eller generera en slumpmässig sträng och kolla kollisioner.
En enda tabell räcker:
short_codesom primärnyckel,long_url,created_at,expires_atoch en valfriuser_id. Heta koder ligger i Redis så att databasen bara ser missar. Använd en 302-omdirigering om du vill ha klickanalys, eftersom webbläsare cachar en 301 och du aldrig ser det andra besöket.Vid 10 miljarder länkar shardar du på kod och ID-generatorn blir flaskhalsen, och om folk börjar gissa koder går du från sekventiellt till slumpmässigt och lägger till ratelimiting.
2. Designa en enkel ratelimiter
En ratelimiter tillåter N förfrågningar per användare och minut och returnerar 429 därefter. Det första att klargöra är om gränsen är per användare, per IP eller per API-nyckel, eftersom det avgör din cache-nyckel.
Tre algoritmer täcker de flesta svar. Fast fönster räknar förfrågningar i varje minutspann, vilket är enkelt men tillåter dubbla gränsen vid gränsen. Glidande fönster-logg lagrar varje tidsstämpel, vilket är exakt men minneskrävande. Token bucket fylls på i jämn takt och släpper igenom små burstar, vilket är varför många gateways använder den.
Kör limiteringen som middleware i API-gatewayen med räknare i Redis under en TTL; INCR plus EXPIRE täcker varianten med fasta fönster.
Med tio gateway-instanser delar du antingen Redis-räknarna eller accepterar lätt överslag med lokala, och du bör bestämma i förväg vad som händer om Redis dör: fail open och riskera missbruk, eller fail closed och blockera alla.
3. Designa en enkel nyckel-värdes-butik
En nyckel-värdes-butik behöver get, put och delete, och för en nybörjarfråga bör du hålla det till en enda nod. En hashkarta i minnet hanterar operationerna. För uthållighet, lägg till varje skrivning i en logg på disk innan du bekräftar den, och ta periodiska snapshots så att återställning inte spelar upp hela historiken.
Vad intervjuaren vill höra är att du har separerat den snabba vägen i minnet från den hållbara vägen på disk, och att du förstår varför loggen kommer först.
Om datan växer ur minnet är svaret ett LSM-träd, vilket i stort sett är hur RocksDB och Cassandra fungerar. Om du behöver en andra nod replikeras loggen från primären till en följare, och konsekvent hashning tar över när du går bortom det.
4. Designa en cache (konceptuellt)
En cache sitter mellan din applikation och ett långsammare lager, och grundmönstret är cache-aside. Appen kollar cachen, missar, läser databasen, skriver tillbaka resultatet med en TTL. Enkelt, men du äger ogiltigförklaringslogiken.
Utkastning betyder oftast LRU, ibland LFU för skeva arbetslaster. Den viktiga metriken är träffkvot; under ~80% bör du fråga om cachen hjälper alls.
Där det blir intressant: inaktualitet. Om databasen ändras och den cachade kopian inte gör det ser användarna gammal data tills TTL:en går ut. Korta TTL:er minskar fönstret men ökar belastningen på databasen.
När en populär nyckel löper ut och 10 000 förfrågningar träffar databasen samtidigt, samlar du antingen ihop dessa förfrågningar eller uppdaterar nyckeln innan den löper ut. Om write-through kontra write-back: write-through håller cachen korrekt till priset av långsammare skrivningar, medan write-back är snabbt men tappar senaste skrivningar om cachen dör innan den flushar.
5. Designa en grundläggande notifieringstjänst
En notifieringstjänst skickar e-post, SMS och pushmeddelanden och försöker igen när en leverantör fallerar. Innan du designar den, fråga om volym och om leveransordning spelar roll, vilket det oftast inte gör.
Kärnan i designen är en kö. Producenter skriver en notifieringshändelse till den, och en arbetare per kanal drar händelser och anropar en leverantör som SendGrid eller Twilio. Den uppdelningen håller det som beslutar om att notifiera separat från det som faktiskt skickar, så en långsam SMS-leverantör aldrig blockerar appen.
Lagra varje notifiering med en status (pending, sent, failed) och en idempotensnyckel så att en retriad händelse inte skickar två gånger.
Användare som vill stänga av marknadsföring men ha säkerhetsvarningar behöver en preferenstabell som kontrolleras innan något köas, och en leverantör som kapar dig till 100 meddelanden per sekund kräver kanalspecifik strypning i arbetaren.
6. Designa en enkel fil lagringstjänst
Tänk Dropbox i liten skala. Användare laddar upp en fil, får en länk, laddar ner den senare. Klargör maximal filstorlek och om delning spelar roll.
Metadata (ägare, filnamn, storlek, checksumma, skapandedatum) hamnar i en relationsdatabas. Själva byten hamnar i objektlagring som S3, aldrig i databasen. För uppladdningar returnerar API:t en försignerad URL så att klienten skriver direkt till objektlagringen och dina servrar aldrig rör filen.
Två användare som laddar upp samma 2 GB-fil är ett dedupe-problem som löses genom att hasha innehållet, och filer över 5 GB behöver multipart-upload med en checksumma per del.
7. Designa en spel-topplista
En topplista måste uppdatera en spelares poäng, returnera topp 10 och returnera en spelares rankning, och det första att fråga är hur många spelare det finns och hur ofta poäng ändras.
En relationstabell med ett index på poäng funkar till en gräns, men "vad är min rankning" blir ett
COUNTöver alla ovanför dig. Redis sorterade mängder löser detta:ZADDför att uppdatera,ZREVRANGEför topp N,ZREVRANKför en enskild spelare, allt i logaritmisk tid.Dagliga och totaltidtopplistor är en sorterad mängd per period, nycklade som
lb:2026-09-14. Om 50 miljoner spelare pressar Redis-minnet för långt, behåll bara topp 100k där och resten i databasen.Intervjufrågor om systemdesign på mellannivå
På den här nivån antar intervjuaren att du har byggt och drivit riktiga system. Frågorna introducerar köer, läs-/skrivsäkning och spänningen mellan latens, kostnad och konsistens.
8. Designa ett nyhetsflöde
Ett flöde behöver att användare kan posta, följa andra och läsa vad de de följer skrivit, i omvänd kronologi eller rankat. Anta 10 miljoner dagliga aktiva användare som öppnar det fem gånger om dagen, vilket blir ungefär 600 läsningar per sekund i snitt och betydligt mer på toppar.
Det centrala valet är när flödet sammanställs. Fan-out vid skrivning puttar varje ny post in i varje följares förberäknade flöde, vilket ger snabba läsningar till priset av dyra skrivningar. Fan-out vid läsning sätter ihop det vid förfrågan, vilket vänder på avvägningen. De flesta riktiga system blandar, med fan-out vid skrivning för vanliga användare och vid läsning för konton med miljoner följare.
Datamodellen är
posts,followsoch en per-användare-flödeslista i Redis som håller post-ID:n. Paginera med en cursor på post-ID i stället för en offset.Att lägga till rankning senare betyder inte att bygga om något av detta; du poängsätter kandidat-ID:n från flödeslistan vid läsning.
9. Designa ett chatsystem med synk mellan flera enheter
Chat med multienhetssynk betyder en-till-en och gruppmeddelanden, leverans till varje enhet en användare äger, och historik som överlever ett telefonbyte. Anta 50 miljoner dagliga användare som skickar cirka 40 meddelanden var, vilket är 2 miljarder om dagen, eller ungefär 23 000 skrivningar per sekund i snitt och flera gånger det vid regionala toppar.
Varje klient håller en WebSocket till en chatserver, som skriver meddelanden till ett lager partitionerat per konversations-ID med ett stigande sekvensnummer per konversation. Varje enhet minns det senaste sekvensnumret den såg och ber om allt nyare vid återanslutning, vilket är det som får synk mellan flera enheter att fungera.
Lagringen behöver hög skrivgenomströmning och läsningar i intervall per konversation, så bredkolumnsdatabaser som Cassandra är det vanliga svaret. Leverans- och läskvitton är små händelser som flyter tillbaka längs samma väg.
När två vänner är anslutna till olika chatservrar får antingen pub/sub mellan servrarna eller en routingtjänst som mappar användare till servrar meddelandet över. Grupper på 500 sprids ut på serversidan, och ordningsgarantier blir svårare att hålla.
10. Designa en matchningstjänst för samåkning
Håll detta lättare än den seniora versionen. Förare skickar sin position var några sekunder, passagerare begär en resa, och tjänsten måste returnera en närliggande förare inom ett par sekunder.
Positionsuppdateringar är volymproblemet: 200 000 aktiva förare med en uppdatering var 4:e sekund betyder 50 000 skrivningar per sekund. Lagra aktuella positioner i minnet indexerat med geohash eller H3-cell, inte i en relationstabell. Matchning betyder sedan "hitta förare i min cell och de angränsande", rangordna efter ETA och lås en förare så att två passagerare inte får samma bil.
Om en förare accepterar och sedan tappar uppkopplingen löper låset ut och passageraren matchas om. En het cell i en stadskärna får finare celler i täta områden, vilket är precis vad hierarkiska index som H3 ger dig.
11. Designa ett system för insamling av metrics
Ett metricssystem tar emot ett par hundra metrics var tionde sekund från tusentals servrar och låter ingenjörer fråga dem i dashboards.
Agenter batchar metrics och pushar till ett inmatningslager, som skriver till en tidsseriedatabas (eller ett Kafka-ämne med konsumenter som skriver till en sådan). Lagring är skiktad: rå upplösning i en dag eller två, enminuts-aggregat i en månad, timvisa i ett år. Nedsampling körs som bakgrundsjobb.
Frågor träffar det aggregat som matchar det begärda tidsintervallet, vilket hindrar en 30-dagarsgraf från att skanna rådata. Taggkardinalitet (t.ex. användar-ID som label) kommer att ta kål på databasen, så säg det högt.
Om push kontra pull: Prometheus drar, men push funkar bättre genom brandväggar och för kortlivade jobb. En agent som rapporterar tidsstämplar i fel ordning accepteras inom ett begränsat förseningsfönster och nekas bortom det, med en räknare på nekningar så att en trasig klocka syns.
12. Designa ett system för autokomplettering i sök
Autokomplettering returnerar de fem bästa förslagen inom cirka 100 millisekunder efter varje tangenttryckning. Klargör om förslagen är globala eller personaliserade, för personalisering ändrar allt.
svaret är att förberäkna. En offline-pipeline aggregerar frågeloggar, räknar frekvenser och bygger en trie (eller en prefix-till-top-k-tabell) där varje nod redan lagrar sina bästa kompletteringar. Betjäningslagret gör sedan en enda uppslagning per tangenttryckning, och hela strukturen ryms i minnet över några repliker.
Uppdateringar sker batchvis, kanske timvis, genom att bygga om strukturen och byta in den. Trender kan få ett litet realtidslager som mergas vid förfrågan.
Ett prefix som ”a” skulle träffa ett enormt delträd, vilket är varför du lagrar top-k vid varje nod i stället för att traversera. Stavfel kräver ett separat fuzzy-index, eller så accepterar du missen.
13. Designa en distribuerad jobbschemaläggare
En distribuerad schemaläggare är cron för ett helt företag: definiera ett jobb och ett schema, kör vid rätt tid och högst en gång per tick, försök igen vid fel och visa vad som hände.
Lagra jobbdefinitioner och scheman i en databas. En schemaläggartjänst beräknar nästa körtid för varje jobb och trycker förfallna jobb på en kö; arbetarpooler drar och exekverar. Det knepiga är att köra exakt en schemaläggarinstans per jobb utan en single point of failure, vilket oftast betyder ledarval (ett lås i ZooKeeper, etcd eller en databasedrad med ett lease).
Registrera varje körning med status, starttid, sluttid och loggplats. Den tabellen blir det som folk faktiskt tittar på.
Ett jobb som kör längre än sitt intervall bör hoppas över, köas eller överlappa, och det ska vara konfigurerbart. När jobb B beror på jobb A blir beroenden en DAG, och schemaläggaren köar bara när uppströms har lyckats.
Avancerade intervjufrågor om systemdesign
Seniornivå. Enorm skala, flera regioner, tillförlitlighetsmål du kan ange som siffror och kostnaden för varje beslut. Intervjuaren förväntar sig att du själv tar upp felmoder innan du blir tillfrågad.
14. Designa en videostreamingplattform som YouTube
Videostreaming är två system under ett namn. Vid uppladdning skickar en användare en rå fil och en pipeline transkoderar den till flera upplösningar och bithastigheter, delar upp den i några sekunder styck och lagrar delarna i objektlagring. Vid uppspelning serverar ett CDN dessa delar och spelaren byter bithastighet för att matcha användarens bandbredd, vilket är adaptiv streaming via HLS eller DASH.
Ange skalan: hundratals timmar laddas upp per minut, miljarder visningar per dag, lagring i exabyten. Transkodning är pinsamt parallellt, så en stor arbetarflotta drar jobb från en kö. Metadata som titel, ägare och visningsräkning ligger i en shardad databas med tung caching eftersom startsidan läser den konstant. Objektlagring och CDN-kanter replikeras över regioner, och SLO:t som spelar roll är starttid för uppspelning, med rebufferingskvot som metrik användarna märker.
Visningsräkningar på en viral video är approximativa räknare som aggregeras i batchar, aldrig en databasinkrement per visning, och upphovsrättsmatchning är ett fingerprintjobb i samma uppladdningspipeline.
15. Designa en distribuerad loggningsplattform
En loggningsplattform tar emot loggar från varje tjänst, gör dem sökbara inom sekunder och behåller dem 30 dagar varma och ett år kalla.
Agenter svansar loggfiler och skickar dem till en hållbar buffert som Kafka, som absorberar spikar och låter indexerare hamna efter utan att tappa data. Indexerare skriver till ett sökkluster med ett index per dag och tjänst, och gamla index rullas ner till komprimerade filer i objektlagring.
Kostnad är den verkliga begränsningen, så indexera strukturerade fält och håll råtext billig. Ge varje tjänst en kvot, övervaka index-lag och tvätta PII vid inläsning.
En tjänst som loggar 100x sin normala volym blir kvoterad, samplad, droppad och larmad på, i den ordningen. Frågor över regioner betyder federerad sökning, där varje region äger sina egna data.
16. Designa ett system för realtidsanalys
Realtidsanalys betyder dashboards som visar aggregat över de senaste minuterna, uppdaterade inom sekunder, ovanpå en ström på kanske en miljon händelser per sekund.
En strömprocessor som Flink upprätthåller fönster-aggregat, säg per-minut-räknare per dimension, och skriver dem till ett snabb-läs-lager som ClickHouse eller Druid. Dashboards frågar det lagret, aldrig den råa strömmen.
Nämn avvägningarna: exakta räkningar kontra HyperLogLog för unika användare, tumlande kontra glidande fönster och vattenstämplar för sena händelser. Sätt ett färskhets-SLO och övervaka processorns lagg mot det.
En högkardinalitetsdimension som användar-ID kommer att explodera aggregattabellen, så fråga råhändelser för just den. Backfill efter en bugg betyder uppspelning från strömmen med bevarade offsetar.
17. Designa ett betalningssystem
Betalningar är den design där korrekthet slår skala. Systemet måste debitera en kund, registrera det, aldrig debitera dubbelt, aldrig tappa en post och stämma av med banken dagligen.
Idempotens bär det mesta av detta: varje begäran har en nyckel, och tjänsten lagrar resultatet mot den och returnerar samma resultat vid retrys. Pengar rör sig genom en append-only dubbel bokföringshuvudbok där varje transaktions poster summerar till noll, i en relationsdatabas med serialiserbar isolering. Detta är ett ställe där eventual konsistens är fel svar.
Anrop till kortnät kan timea ut tvetydigt, så debiteringar får status pending och ett avstämningsjobb reglerar dem. Flera regioner betyder en hemregion per konto, aldrig aktiv-aktiv-skrivningar på samma saldo.
Flera valutor betyder heltalsbelopp i minor units med valutakod, och en återbetalning som anländer innan dess debitering reglerats hanteras av en tillståndsmaskin med explicita övergångar.
18. Designa ett storskaligt meddelandesystem
Ett storskaligt meddelandesystem låter producenter publicera och konsumenter prenumerera, överlever omstarter av brokers och bevarar ordning där det spelar roll, i miljoner meddelanden per sekund.
Partitionera varje ämne så att meddelanden med samma nyckel landar på samma partition, vilket ger ordning per nyckel utan global ordning. Varje partition är en append-only-logg replikerad till några brokers, och konsumenter commitar sin offset efter bearbetning.
Utgå från at-least-once-leverans med idempotenta konsumenter. Retries går genom ett retry-ämne med backoff och giftiga meddelanden till en dead-letter-kö. Konsumentlagg är signalen att sätta ett SLO på, och över regioner äger en region skrivningar per nyckel annars kommer de två att omordna varandra.
En konsument som kraschar efter bearbetning men före commit producerar en dubblett, vilket är varför idempotens spelar roll. Rebalanseringsstormar tämjs med sticky assignment och kooperativ rebalansering.
Intervjufrågor om systemdesign för backendutvecklare
Dessa fokuserar på API:er, datamodeller och var tjänstegränser ska gå. Förvänta dig följdfrågor om konsistens, caching och vad du skulle logga.
19. Designa en autentiserings- och auktorisationstjänst
Autentisering svarar på ”vem är du” och auktorisering svarar på ”vad får du göra”, och intervjuare gillar kandidater som håller isär dem.
Använd OAuth 2.0 och OpenID Connect i stället för att uppfinna ett protokoll. Utfärda kortlivade access tokens och längre livslängd för refresh tokens som lagras på serversidan så att du kan återkalla dem. Behörigheter ligger i en rollmodell som kontrolleras av ett litet bibliotek eller en policytjänst. Logga varje inloggningsförsök, förnyelse och nekning med IP och enhet, och logga aldrig själva token.
JWT:er undviker en uppslagning per förfrågan, men att återkalla en i förtid kräver en denylist, vilket sätter uppslagningen tillbaka. Credential stuffing bromsas med ratelimiting per IP och per konto, fördröjningar efter upprepade fel och en andra faktor vid misstänkta inloggningar.
20. Designa en API-gateway
En API-gateway är en enda ingång framför dina tjänster som hanterar det tvärgående arbetet så att varje tjänst slipper: routing per sökväg och version, TLS-terminering, autentisering, ratelimiting och förfrågningsloggning.
Själva gatewayen bör vara tillståndslös och skalas horisontellt bakom en lastbalanserare. Ruttkonfiguration bor i en kontrollplan och pushas till gateway-instanser, så du behöver aldrig rulla ut gatewayen för att lägga till en rutt. Autentiseringstoken valideras en gång vid kanten och gatewayen vidarebefordrar användaridentiteten som en header.
Blast radius är det du ska säga högt. Gatewayen ligger på varje förfrågningsväg, så en dålig konfigpush tar ner allt; validera konfigurationer, rulla ut dem gradvis och håll gatewayens egen logik tunn.
Versionering utan att bryta mobilklienter du inte kan uppdatera betyder versionssättning i sökväg eller header med gamla versioner som hålls vid liv. Och gatewayen ska inte aggregera svar från flera tjänster; det hör hemma i ett backend-for-frontend-lager.
21. Designa ett ordersystem för en e-handelssajt
Ett ordersystem skapar en order, reserverar lager, tar betalt, skickar och låter kunden se status. Ordrar är en tillståndsmaskin (
created,paid,packed,shipped,delivered,cancelled), och de tillåtna övergångarna ska vara explicita.Orderläggning är en
POSTmed en idempotensnyckel så att ett dubbelklick inte skapar två ordrar. Lagerreservation och betalning involverar andra tjänster, så använd en saga: varje steg publicerar en händelse, och fel triggar kompenserande åtgärder (släpp lager, återbetala). Skriv händelsen till en outbox-tabell i samma transaktion som orderuppdateringen så att databasen och meddelandebussen aldrig är oense.På lässidan: en ordertabell plus en
order_items-tabell, med en materialiserad ordersammanfattning cachad för sidan "mina ordrar".Två kunder som köper sista exemplaret samtidigt löses med en radringlåsning eller atomisk dekrement på lager, där en av dem får ett slut i lager-meddelande. Det du ska övervaka är ordrar som fastnar i ett tillstånd längre än väntat.
22. Designa en feature flag-tjänst
En feature flag-tjänst växlar funktioner per miljö, riktar in sig på användarattribut eller procent och kan slå om en flagga globalt inom sekunder när något går sönder.
Flaggdefinitioner och målriktningregler ligger i en liten databas bakom ett admin-API. Applikationer bäddar in ett SDK som hämtar alla flaggor vid uppstart, cachar dem lokalt och utvärderar regler i processen, så en flaggkontroll kostar inget vid förfrågan. Uppdateringar sprids via en strömmad koppling eller kort polling, och SDK:t behåller det senast kända tillståndet om flaggtjänsten är nere.
Utvärdera procentuella utrullningar med en stabil hash av användar-ID och flaggnyckel, så att samma användare alltid hamnar på samma sida.
Inaktuella flaggor hittas genom att spåra senast utvärderade tidsstämplar och påminna ägare, och om flaggtjänsten är nere vid uppstart faller applikationen tillbaka till defaultvärden som levereras i koden.
23. Designa ett API för rekommendationsbetjäning
Ett rekommendations-API returnerar 20 objekt för en användare på under 100 millisekunder vid några tusen förfrågningar per sekund, och ingen djup ML krävs för att designa det.
Dela upp offline och online. Ett offlinejobb beräknar kandidatslistor per användare in i en nyckel-värdes-butik med låg latens. Det online-API:t hämtar dem, rankar om med några färska signaler som lagersaldo, filtrerar bort vad användaren redan köpt och returnerar listan. Ha en fallback med populära objekt per kategori, och logga varje serverad lista med ett request-ID så att du kan förena den med klick senare.
En ny användare får fallback tills några interaktioner kommer in. De 100 millisekunderna delas ungefär i 10 för hämtning, 30 för omrankning, 10 för serialisering och 50 i luftmarginal.
Intervjufrågor om systemdesign för infrastruktur/DevOps
Tillförlitlighet, driftsättning, automatisering och observabilitet. Det återkommande temat: hur ändrar du saker säkert och vet snabbt när du hade fel.
24. Designa en CI/CD-pipeline för mikrotjänster
En CI/CD-pipeline för mikrotjänster måste hantera dussintals oberoende driftsättbara tjänster med tester, säkerhetskontroller och en väg till produktion som inte kräver en människa klockan 03.00.
Bygg en gång, driftsätt samma artefakt överallt. Pipelinen lintar, kör enhetstester, bygger en containerimage taggad med commit-SHA, skannar den och pushar den till ett register. Driftsättning främjar sedan den imagen genom miljöer (dev, staging, produktion) med konfiguration i stället för att bygga om.
Produktionsutrullning bör vara progressiv: kanariet till några procent av trafiken, övervaka felfrekvens och latens under ett definierat fönster, fortsätt sedan eller rulla tillbaka automatiskt. Rollback betyder att rulla ut föregående imagetag, vilket går fort just för att du aldrig byggde om.
När en förändring i tjänst A bryter tjänst B:s kontrakt är lösningen kontraktstester i CI och bakåtkompatibla API-ändringar. Monorepo kontra många repo spelar mindre roll än folk tror, så länge pipelinen bara bygger det som ändrats.
25. Designa centraliserad övervakning och larm
Centraliserad övervakning samlar metrics, loggar och spår från varje tjänst på ett ställe, med larm som väcker folk bara när användare påverkas.
Metrics går till ett tidsserielager, loggar till plattformen från fråga 15, spår till en tracing-backend, allt korrelerat med ett gemensamt request-ID. Designbeslutet som spelar roll är vad du larmar på. Larma på symptom (felfrekvens, latenser i percentiler, mättnad) knutna till SLO:er, inte på orsaker som "CPU på 80%."
Pagingtrötthet dödar jourrotationer, så varje page behöver en runbook och en genomgång. Allt som pajar två gånger på en vecka utan tydlig åtgärd degraderas till ett ärende.
Ett SLO för en helt ny tjänst kommer av att mäta i ett par veckor och sedan sätta ett mål något bättre än nuvarande. Och när övervakningssystemet självt är nere är externa syntetiska tester och ett dead man’s switch-larm det som säger till.
26. Designa en strategi för hemlighetshantering
Hemlighetshantering gör databaslösenord, API-nycklar och certifikat tillgängliga för tjänster vid körning, aldrig i källkod, roterade regelbundet och reviderade.
Ett centralt hemlighetsförråd (HashiCorp Vault, en molnleverantörs secrets manager) håller allt. Tjänster autentiserar sig mot det med sin arbetsladsidentitet (ett Kubernetes servicekonto, en IAM-roll), aldrig en långlivad token, och hämtar hemligheter vid uppstart eller on demand. Föredra dynamiska hemligheter där det är möjligt: förrådet genererar en databaskreditiv giltigt i en timme, och rotation sker automatiskt.
Granska varje läsning. Och ha en dokumenterad break-glass-väg för när hemlighetsförrådet självt ligger nere, för det kommer att hända.
En nyckel som en utvecklare av misstag committar fångas av skanning i CI, roteras omedelbart och behandlas som komprometterad oavsett. Hemligheter i miljövariabler är vanliga men läcker via kraschdumpningar och barnprocesser, så montera dem som filer eller hämta dem i processen.
27. Designa autoskalning och en utrullningsstrategi
Autoskalning och utrullning måste tillsammans låta en tjänst hantera dagliga trafiksvängningar på 5x utan manuell insats, samtidigt som deployer sker flera gånger om dagen.
Skala på en signal som speglar användarsmärta, vanligtvis begärandehastighet eller latens per instans, snarare än enbart CPU. Sätt ett minsta antal repliker så att en kallstart aldrig möter en puckel, och ett max så att en bugg inte ruinerar dig. Skala upp snabbt och ner långsamt.
För utrullning: använd blå/grön när du behöver ett omedelbart skifte och omedelbar rollback, och canary när du vill observera riktig trafik på en liten andel först. Kombinera canary med autoskalaren varsamt, eftersom en canary som skalar oberoende kan snedvrida jämförelsen.
Om skalningen släpar efter en plötslig puckel med två minuter täcker prediktiv skalning enligt schema eller en högre miniminivå glappet. Och 50 nya instanser som tömmer databasanslutningar är anledningen till att anslutningspoolning hör hemma i ett proxylager.
Intervjufrågor om systemdesign för dataingenjörer
Pipelines, lagringsformat, batch kontra strömning och om datan går att lita på. Samma ramverk som tidigare, men felmoderna handlar om förlorad, duplicerad eller försenad data snarare än tappade förfrågningar.
28. Designa en pipeline för händelseintag
En pipeline för händelseintag tar beteendehändelser från webb- och mobilklienter och gör dem sökbara inom en timme. Anta 50 000 händelser per sekund vid topp, med klienter som går offline och försöker igen.
Klienter batchar händelser via ett SDK och postar till en insamlingstjänst som validerar mot ett schemaregister och skriver till en ström (Kafka eller en hanterad motsvarighet). En konsument landar råa händelser i objektlagring partitionerad per timme, i ett kolumnärt format som Parquet. Nedströmsjobb läser därifrån.
Retries innebär dubbletter, så varje händelse bär en klientgenererad UUID och landningsjobbet avdubblar inom ett fönster. Schematändringar går via registret med kompatibilitetskontroller, eftersom en mobilapp på en gammal version kommer fortsätta skicka det gamla formatet i månader.
En händelse med en tidsstämpel från tre dagar sedan landar efter ankomsttid, behåller sin händelsetid som en kolumn och låter nedströms bestämma. Felaktiga händelser går till en dead-letter-väg och släpps aldrig tyst.
29. Designa ett strömmande ETL-system
Strömmande ETL transformerar händelser när de anländer, förenar dem med referensdata och skriver resultat till en serving-butik inom sekunder.
En strömprocessor läser från intagsämnet, applicerar transformationer och berikar med referensdata inlästa i minnet och uppdaterade periodiskt. Tillstånd (för fönsterbaserade joins eller aggregeringar) checkpointas till varaktig lagring så att ett kraschat jobb återupptas utan att omprocessa från början.
Den avvägning intervjuare vill höra namnges: exakt en gång kontra minst en gång. Exakt en gång är möjligt från ände till ände om sänkan stöder transaktioner eller idempotenta skrivningar, men det kostar latens och komplexitet. Minst en gång med idempotenta sänkor ger dig det mesta av nyttan.
Sen data hanteras med vattenmärken och en definierad respitperiod, varefter den går till en tabell för sena ankomster.
Referensdata som ändras mitt i strömmen bör versionshanteras, med join på den version som gällde vid händelsetiden. En backfill sex månader efter en logikfix spelas om från rålagring i batch, inte via strömmen.
30. Designa ett datalager och en modelleringsmetod
Ett lager måste ge analytiker och instrumentpaneler konsekventa mått över sälj-, marknads- och produktdata, med historik bevarad.
Landa rådata orörd i ett bronslager, rengör och konforma i silver, och bygg verksamhetsnära tabeller i guld. Modellera guld som ett stjärnschema: faktatabeller på den finaste användbara nivån (en rad per orderrad, till exempel) och dimensionstabeller för kunder, produkter, datum. Långsamt föränderliga dimensioner får Typ 2-behandling där historik är viktig, så att en kunds regionsbyte inte skriver om fjolårets intäkter.
Partitionera stora faktatabeller per datum, klustra efter kolumner som folk filtrerar på, och håll transformationer i versionskontroll (dbt eller motsvarande) med tester.
När två team definierar ”aktiv kund” olika, löser ett metrisklager med en enhetlig definition det. Ett sent ankommet faktum som refererar till en dimensionsnyckel som ännu inte finns får en platshållardimensionrad som fylls i i efterhand.
31. Designa en feature store
En feature store beräknar features en gång och återanvänder dem för både modellträning och onlineprediktion utan träning/serving-drift, och denna hålls på hög nivå. Det är två butiker med en definition: offline-butiken (ett lager eller en sjö) håller feature-historik för att bygga träningsset, och online-butiken (Redis, DynamoDB) håller senaste värdet per entitet för låglatensuppslag vid prediktion.
En enda featuredefinition driver båda, och ett jobb materialiserar från offline till online enligt schema.
Det kritiska begreppet är punkt-i-tid-korrekthet. När du bygger ett träningsset måste varje rad använda featurevärden så som de såg ut vid radens tidsstämpel, inte de aktuella. Annars lär sig din modell från framtiden och ser fantastisk ut tills den skeppas.
En feature som är dyr att beräkna i realtid förberäknas antingen med viss ålder eller beräknas vid skrivning. För att veta att online- och offlinevärden matchar, sampla och jämför dem, och logga de features du faktiskt serverade.
32. Designa ett lager för datakvalitet och härledning
Ett lager för datakvalitet och härledning upptäcker trasig data innan instrumentpaneler gör det och svarar på ”var kom den här kolumnen ifrån” utan att läsa kod.
Kvalitetskontroller körs som pipelinesteg: räkna rader mot förväntade intervall, null-frekvenser, färskhet (landade partitionen i tid), och några affärsassertioner (intäkter är aldrig negativa). Fel blockerar nedströmsjobb och larmar ägaren. Spara kontrollresultat över tid så att du kan se drift, inte bara dagens godkänt eller underkänt.
Härledning fångas från själva transformationskoden (SQL-parsning eller orkestreringsverktygets metadata) och lagras som en graf: tabell till tabell, kolumn till kolumn där det är möjligt. Den grafen driver konsekvensanalys när någon vill ta bort en kolumn.
Om kontroller tar längre tid än pipelinen, sampelera, eller kör de tunga asynkront och larma i stället för att blockera. Härledning över verktyg som inte pratar med varandra innebär OpenLineage eller manuella annoteringar, med luckorna dokumenterade.
Intervjufrågor om systemdesign för frontend/fullstack
Klientprestanda, tillståndshantering, cachning och hur webbläsaren pratar med API:et. Säkerhetsgrunder dyker upp här också.
33. Designa arkitekturen för en högtrafikerad webbapp
En högtrafikerad webbapp här betyder en innehållstung sajt med miljoner dagliga besökare, snabb första rendering och personliga sektioner för inloggade användare.
Statiska tillgångar läggs på en CDN med långa cache-livstider och hashade filnamn. Sidor som är samma för alla renderas på servern och cachas vid kanten; personliga delar laddas på klientsidan efter att skalet målats. Den hybriden håller time-to-first-byte låg utan att servera inaktuell personlig data.
API-anrop från klienten går via gatewayen med kortlivade token. Sätt cache-headrar med avsikt:
Cache-Controlmedstale-while-revalidateför innehåll som kan vara några sekunder gammalt,no-storeför allt personligt.För en instrumentpanel bakom inloggning är rendering på klientsidan oftast bra, eftersom SSR ger lite utan SEO. Och en cache-nyckel som av misstag inkluderar sessionscookien ger alla sin egen kopia, så träfffrekvensen kollapsar.
34. Designa offline-först-synk
Offline-först-synk betyder en antecknings- eller fältdataapp som fungerar utan uppkoppling och synkar när den är tillbaka, utan att tappa någons ändringar.
Varje skrivning går först till en lokal butik (IndexedDB, SQLite på mobil) och till en kö av väntande mutationer. När uppkoppling återvänder trycker klienten kön i ordning och hämtar ändringar sedan sin senaste synk-token. Varje mutation bär ett klient-ID och ett sekvensnummer så att servern kan avdubbla.
Konflikter är hela problemet. Sista skrivning vinner är enkelt och tappar data. Sammanfogning på fältnivå hanterar de flesta fall.
CRDT:er ger automatiska sammanslagningar för text och listor till priset av komplexitet, och jag skulle bara välja dem om samredigering verkligen är ett krav.
En användare som redigerar på två enheter offline och tar tillbaka båda får båda ändringarna applicerade, konflikten flaggad och UI:t som visar den. En väntande kö som växer till 10 000 mutationer bör komprimeras, så att tio ändringar av ett fält blir en.
35. Designa realtidsuppdateringar i UI
Realtidsuppdateringar i UI betyder en instrumentpanel eller chattvy som speglar serverside-ändringar inom en sekund för tusentals samtidiga användare.
Välj transport efter riktning. Server-Sent Events när data bara flödar server till klient (livescore, aviseringar); WebSockets när klienten skickar mycket också (chatt, samredigering). Long polling som fallback för nätverk som blockerar båda.
På servern sprider ett pub/sub-lager ut ändringar till den anslutningsserver som håller användaren. På klienten, hantera återanslutning med backoff och återuppta från senaste händelse-ID så att en tappad anslutning inte betyder en missad uppdatering. Stryp rendering: 50 uppdateringar i sekunden till ett diagram bör batchas till några omritningar, inte 50.
100 000 användare som tittar på ett liveevenemang är serverside-fan-out, möjligen via en CDN som stöder strömning. Att autentisera en WebSocket innebär en token i initiala handskakningen, återvaliderad periodiskt.
36. Designa en klientprestandaplan för instrumentpaneler
Målet är en analysinstrumentpanel med 20 diagram som laddar på under tre sekunder och förblir responsiv vid filtrering.
Hämta inte 20 diagram på en gång. Ladda de synliga först, lazy-loada resten vid scroll, och visa skelett i stället för snurror. Föraggregera på servern så att klienten tar emot några hundra rader per diagram, aldrig råa händelser.
Cacha frågeresultat i minnet nycklat på filtertillstånd, så att växling av ett filter fram och tillbaka inte hämtar igen.
Tabeller med tusentals rader behöver virtualisering (rendera bara det som syns). Tunga beräkningar går till en web worker så att huvudtråden förblir fri för interaktion.
Om API:et är långsamt och du inte kan ändra det, cacha aggressivt, visa inaktuell data med tidsstämpel och uppdatera i bakgrunden. CORS-fel när instrumentpanelen anropar ett nytt API betyder att API:et måste tillåta instrumentpanelens ursprung, och du bör kunna förklara preflight-förfrågningar.
Scenariobaserade intervjufrågor om systemdesign
Dessa testar omdöme snarare än arkitektur. Krav ändras, produktion går sönder, och intervjuaren vill se hur du prioriterar.
37. Trafiken ökar 10x över en natt. Vad ändras först?
Börja med det som går sönder först, och det är sällan det tillståndslösa lagret. Autoskalning hanterar webbservrarna; databasen, cachen och eventuella tredjeparts gränser för hastighet är där det fallerar.
Omedelbart: kolla mättnadsmåtten (anslutningar, CPU, ködjup) för databas och cache, höj autoskalarens tak och slå på eventuell load shedding du har, såsom att släppa icke-kritiska funktioner eller servera cachade sidor. Inom en dag: lägg till läsrepliker, trimma cacheträfffrekvensen och hitta de frågor som dominerar. På längre sikt: gör sharding- och köarbetet du skjutit upp.
Att skilja verklig tillväxt från en bot handlar om förfrågningsmönster, user agents och om konverteringar rörde sig.
38. Du når gränser för databasläsning. Cache, repliker eller sharding?
I den ordningen, oftast. En cache framför de hetaste läsningarna är billig och kan halvera databastromsen inom en dag; kolla träfffrekvensen och frågeloggen för att bekräfta att läsningarna faktiskt är repetitiva.
Läsrepliker kommer härnäst när läsmixen är bred snarare än het. De lägger till replikeringsfördröjning, så alla read-after-write-vägar (en användare sparar och ser sin ändring direkt) måste gå till primären. Sharding löser skrivgränser mer än läsgränser och kostar dig kors-shard-frågor och en migrering, så det är sist, och bara när de två första är uttömda.
Om en massiv kund på en enda tabell orsakar belastningen, isolera den hyresgästen eller partitionera efter kund-ID.
39. Ett kritiskt nedströmsberoende är fladdrigt. Retries, timeouts, circuit breakers?
Allihop, och i rätt ordning. Först en timeout, för ett anrop utan timeout gör ett långsamt beroende till ditt eget avbrott när trådar hopar sig. Sedan retries med exponentiell backoff och jitter, men bara för idempotenta anrop och bara ett par gånger, annars förstärker du lasten på en tjänst som redan kämpar.
Sedan en circuit breaker: efter en tröskel av fel, sluta anropa ett tag och servera en fallback (cachad data, ett degraderat svar, ett vänligt fel). Övervaka brytarens tillstånd; en brytare som fastnar öppen är ett eget incident.
När det fladdriga beroendet är din betalningsleverantör finns ingen fallback för själva debiteringen; köa ordern som väntande och behandla den senare.
40. Latens försämrades efter en lansering. Hur diagnostiserar du?
Bekräfta först att det är verkligt och avgränsat: vilken percentil flyttade sig (p50 eller bara p99), vilka endpoints, vilken region. Jämför mot deploytidslinjen; om försämringen stämmer med en release, rulla tillbaka först och undersök sedan.
Om rollback inte är svaret, följ förfrågan. Traces visar vilken span som växte. Vanliga bovar: en ny fråga utan index, ett N+1-mönster introducerat av ett nytt fält, en cache-nyckeländring som sänkte träfffrekvensen, eller ett nedströmsanrop som brukade vara asynkront och nu ligger på förfrågningsvägen.
Om bara p99 flyttade sig och tillbaka-rullning inte hjälpte, leta efter garbage collection-pauser, en bullrig granne eller en låsning.
41. Ett datainkonsekvensfel dyker upp. Vad kollar du, vad rullar du tillbaka?
Avgränsa skadan innan du rör något. Vilka tabeller eller poster är oense, sedan när, och händer det fortfarande? Svaret på ”sedan när” pekar oftast på en deploy eller ett jobbkörning.
Kolla skrivvägen för de berörda posterna: senaste migrationer, ett jobb som körde två gånger, en retry utan idempotens, en kapprustning mellan två skrivare. Stoppa blödningen genom att pausa det felande jobbet eller rulla tillbaka koden, reparera sedan från en källa till sanning (den råa händelseloggen, huvudboken, en backup) snarare än att handredigera rader. För protokoll över vad du ändrade och varför.
Utan en sanningskälla att reparera från, återskapa det du kan, flagga resten och lägg till outbox-mönstret så att det inte händer igen.
Vanliga misstag i systemdesignintervjuer
De flesta kandidater misslyckas av samma handfull skäl. Inget av dem handlar om att veta mindre.
Hur du förbereder dig för systemdesignintervjuer
Förberedelse fungerar när den är upprepningsbar. Här är en process jag faktiskt skulle följa.
Slutsats
Varje fråga i den här listan kom från ett system som någon var tvungen att bygga och sedan hålla vid liv klockan 03.00, så ju mer av det du gör, desto mindre känns intervjun som en uppvisning och desto mer som att beskriva din tisdag. Kör ett sidoprojekt med en riktig kö i, anmäl dig till jourrotationen, be att få sitta med på en designgranskning även när designen inte är din.
Och om du vill ha strukturerad mark att täcka mellan nu och din nästa loop, går dessa djupare på delarna som svaren lutar sig mot: