Las preguntas de diseño de sistemas aparecen en más entrevistas de las que imaginas. Roles de backend, claro. Pero también en infraestructura, ingeniería de datos e incluso en posiciones muy orientadas a producto donde nadie espera que escribas una línea de código durante la entrevista.
Entonces, ¿qué está evaluando realmente la persona entrevistadora? No si conoces la arquitectura "correcta", porque no existe. Quieren ver pensamiento estructurado, concesiones sinceras y que sigas razonando cuando las restricciones son difusas y el reloj corre.
Las expectativas cambian bastante según el nivel. Una persona junior que hace buenas preguntas de aclaración y esboza un diagrama limpio con unas pocas cajas lo está haciendo muy bien. Una persona senior que solo hace eso está en problemas, porque a ese nivel se esperan números, modos de fallo y una opinión sobre qué construir primero.
El rol también importa. A una data engineer le apretarán con pipelines y backfills, a una frontend con caché y estado, y a alguien de infra con despliegues y radio de impacto. La misma habilidad de base, distinto vocabulario.
Lo digo porque la mayoría de listas de preguntas ignoran ambas dimensiones y simplemente te sueltan 50 prompts. Esta está organizada primero por nivel y luego por rol, con preguntas de escenarios al final. Si la parte de almacenamiento en estas respuestas te suena floja, nuestro Database Design course cubre los fundamentos.
Cómo afrontar una entrevista de diseño de sistemas
La misma estructura siempre, unos 45 minutos:
- Aclarar (5 min). Quién lo usa, qué debe hacer, qué queda fuera de alcance y cómo es un resultado "bueno".
- Poner números (2 min). Usuarios, peticiones por segundo, mezcla de lecturas/escrituras, crecimiento de almacenamiento por año. A ojo vale; en silencio no.
- Esbozar lo alto nivel (10 min). Clientes, capa de API, almacenamiento, caché, cola. Cinco o seis cajas, no más.
- Mostrar el modelo de datos (5 min). Tablas o colecciones, claves y los patrones de acceso que cubren.
- Profundizar en una pieza (10 min). Deja que la persona entrevistadora elija o propone la parte que te parezca más interesante.
- Modos de fallo y trade-offs (el resto). Qué se rompe, qué monitorizarías y qué construirías primero si fuera real.
Narra todo en voz alta. Una persona entrevistadora no puede puntuar pensamientos en silencio.
Preguntas de entrevistas de diseño de sistemas para principiantes
Estas prueban los fundamentos: aclarar requisitos antes de dibujar, producir un diagrama de arquitectura sencillo y tomar decisiones sensatas de almacenamiento. Nadie espera algoritmos de consenso aquí.
1. Diseña un acortador de URL
Un acortador convierte una URL larga en un código corto y redirige al visitarlo, así que lo primero es decidir si los enlaces caducan y cuántos esperas. Una suposición razonable: 100 millones de enlaces nuevos al mes, con lecturas unas 100 veces las escrituras.
Esa mezcla intensiva en lectura moldea el diseño: un servidor de API, una base de datos y una caché delante. Para el código corto, o bien codificas en base62 un ID autoincremental (siete caracteres dan unos 3,5 billones de combinaciones) o generas una cadena aleatoria y compruebas colisiones.
Una sola tabla basta: short_code como clave primaria, long_url, created_at, expires_at y un user_id opcional. Los códigos calientes viven en Redis para que la base de datos solo vea los fallos de caché. Usa un 302 si quieres analítica de clics, porque los navegadores almacenan en caché un 301 y no verás la segunda visita.
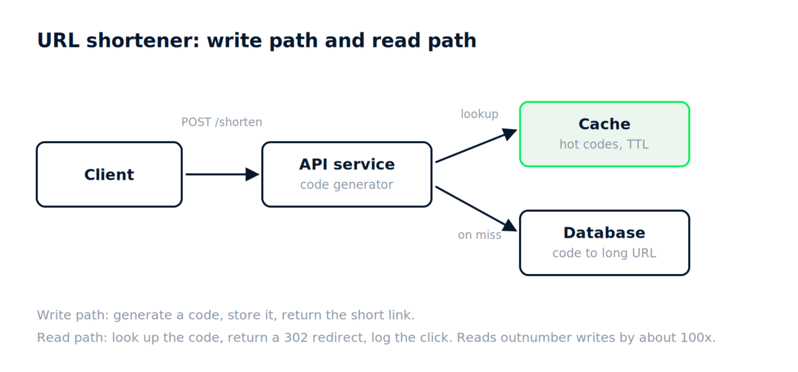
Con 10.000 millones de enlaces, fragmentas por código y el generador de IDs se vuelve el cuello de botella; y si la gente empieza a adivinar códigos, pasas de secuencial a aleatorio y añades limitación de tasa.
2. Diseña un limitador de tasa básico
Un limitador de tasa permite N peticiones por usuario por minuto y devuelve un 429 a partir de ahí. Lo primero es aclarar si el límite es por usuario, por IP o por clave de API, porque eso determina tu clave de caché.
Tres algoritmos cubren la mayoría de respuestas. Ventana fija cuenta peticiones por minuto, es simple pero permite doblar el límite en el borde. Ventana deslizante con log almacena cada marca de tiempo, es exacto pero consume mucha memoria. Token bucket se rellena a ritmo constante y permite pequeños picos, por eso muchos gateways lo usan.
Ejecuta el limitador como middleware en el API gateway con contadores en Redis bajo un TTL; INCR más EXPIRE cubren la versión de ventana fija.
Con diez instancias del gateway o compartes contadores en Redis o aceptas un ligero sobreconteo con contadores locales, y deberías decidir de antemano qué pasa si Redis cae: ¿fallo abierto y arriesgar abuso, o fallo cerrado y bloquear a todo el mundo?
3. Diseña un almacén clave-valor simple
Un almacén clave-valor necesita get, put y delete, y para una pregunta de principiante conviene mantenerlo en un solo nodo. Un mapa hash en memoria maneja las operaciones. Para durabilidad, añade cada escritura a un log en disco antes de confirmarla y haz snapshots periódicos para que la recuperación no tenga que reproducir toda la historia.
Lo que la persona entrevistadora quiere oír es que separas la vía rápida en memoria de la vía duradera en disco y que entiendes por qué el log va primero.
Si los datos crecen más que la memoria, la respuesta es un árbol LSM, que es más o menos cómo funcionan RocksDB y Cassandra. Si necesitas un segundo nodo, el primario replica el log a un seguidor y, al ir más allá, entra en juego el hash consistente.
4. Diseña una caché (conceptual)
Una caché se sitúa entre tu aplicación y un almacén más lento, y el patrón básico es cache-aside. La app consulta la caché, falla, lee la base de datos y escribe el resultado con un TTL. Simple, pero la invalidación es tu responsabilidad.
La expulsión suele ser LRU, a veces LFU para cargas sesgadas. La métrica que importa es la tasa de aciertos; por debajo del 80% deberías preguntarte si la caché ayuda realmente.
Donde se pone interesante: la obsolescencia. Si la base de datos cambia y la copia en caché no, los usuarios ven datos antiguos hasta que expire el TTL. TTLs cortos reducen esa ventana pero aumentan la carga en la base de datos.
Cuando una clave popular caduca y 10.000 peticiones golpean la base de datos a la vez, o fusionas esas peticiones o refrescas la clave antes de que expire. Sobre write-through frente a write-back: write-through mantiene la caché correcta a costa de escrituras más lentas, mientras que write-back es rápido pero pierde escrituras recientes si la caché muere antes de vaciarse.
5. Diseña un servicio básico de notificaciones
Un servicio de notificaciones envía email, SMS y push y reintenta cuando un proveedor falla. Antes de diseñar, pregunta por el volumen y si el orden de entrega importa, que normalmente no.
El corazón del diseño es una cola. Los productores escriben un evento de notificación y un worker por canal tira de eventos y llama a un proveedor como SendGrid o Twilio. Esa separación mantiene aparte la decisión de notificar del envío real, para que un proveedor de SMS lento no bloquee la app.
Guarda cada notificación con un estado (pendiente, enviada, fallida) y una clave de idempotencia para que un reintento no la envíe dos veces.
Quienes quieren apagar marketing pero mantener alertas de seguridad necesitan una tabla de preferencias consultada antes de encolar, y un proveedor que te limite a 100 mensajes por segundo requiere limitación por canal en el worker.
6. Diseña un servicio sencillo de almacenamiento de archivos
Piensa en Dropbox a pequeña escala. Las personas suben un archivo, obtienen un enlace y lo descargan después. Aclara el tamaño máximo de archivo y si compartir importa.
Los metadatos (propietario, nombre, tamaño, checksum, fecha de creación) van en una base de datos relacional. Los bytes van a almacenamiento de objetos tipo S3, nunca a la base de datos. Para subidas, la API devuelve una URL prefirmada para que el cliente escriba directamente en el almacenamiento de objetos y tus servidores no toquen el archivo.
Dos personas subiendo el mismo archivo de 2 GB es un problema de deduplicación que se resuelve con un hash del contenido, y archivos de más de 5 GB requieren subida multiparte con checksum por bloque.
7. Diseña un ranking de juego
Un leaderboard tiene que actualizar la puntuación de un jugador, devolver el top 10 y devolver el puesto de un jugador, y lo primero a preguntar es cuántos jugadores hay y con qué frecuencia cambian las puntuaciones.
Una tabla relacional con un índice por puntuación sirve hasta cierto punto, pero "¿cuál es mi puesto?" pasa a ser un COUNT sobre todo el mundo por encima de ti. Los conjuntos ordenados de Redis lo solucionan: ZADD para actualizar, ZREVRANGE para el top N, ZREVRANK para una jugadora, todo en tiempo logarítmico.
Tablas diarias y de todos los tiempos son un conjunto ordenado por periodo, con claves tipo lb:2026-09-14. Si 50 millones de jugadores fuerzan demasiado la memoria de Redis, guarda solo el top 100k ahí y el resto en la base de datos.
A este nivel se asume que has construido y operado sistemas reales. Las preguntas introducen colas, escalado de lecturas/escrituras y la tensión entre latencia, coste y consistencia.
8. Diseña un feed de noticias
Un feed necesita que usuarios publiquen, sigan a otros y lean lo que han escrito quienes siguen, en orden inverso cronológico o con ranking. Asume 10 millones de usuarios activos diarios abriéndolo cinco veces al día, lo que equivale a unas 600 lecturas por segundo de media y muchas más en picos.
La decisión central es cuándo ensamblar el feed. Fan-out on write empuja cada nueva publicación al feed precomputado de cada seguidor: lecturas rápidas a costa de escrituras caras. Fan-out on read lo ensambla al pedirlo, invirtiendo el trade-off. La mayoría de sistemas mezclan: fan-out on write para usuarios normales y on read para cuentas con millones de seguidores.
El modelo de datos es posts, follows y una lista de feed por usuario en Redis con IDs de posts. Pagina con un cursor sobre el ID del post, no con offset.
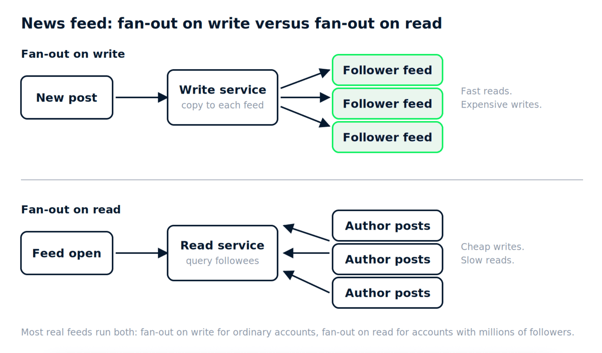
Añadir ranking después no implica rehacer nada de esto; puntúas los IDs candidatos de la lista del feed en tiempo de lectura.
9. Diseña un sistema de chat con sincronización multi-dispositivo
Chat con sincronización multi-dispositivo implica mensajes uno a uno y de grupo, entrega a todos los dispositivos de una persona usuaria y un historial que sobrevive a cambiar de móvil. Asume 50 millones de usuarios diarios enviando unos 40 mensajes cada uno: 2.000 millones al día, unas 23.000 escrituras por segundo de media y varias veces más en picos regionales.
Cada cliente mantiene un WebSocket con un servidor de chat, que escribe mensajes en un almacén particionado por ID de conversación con un número de secuencia creciente por conversación. Cada dispositivo recuerda el último número visto y pide lo nuevo al reconectar: esto hace que la sincronización multi-dispositivo funcione.
El almacén necesita alto throughput de escritura y lecturas por rango por conversación, así que bases de datos de columnas anchas como Cassandra son la respuesta habitual. Entregas y lecturas recibidas son eventos pequeños que fluyen por el mismo camino.
Cuando dos amigas están conectadas a distintos servidores de chat, o pub/sub entre servidores o un servicio de routing que mapea usuarios a servidores hace llegar el mensaje. Grupos de 500 se expanden del lado servidor, y mantener el orden se complica.
10. Diseña un servicio de emparejamiento para ride-sharing
Mantén esto más ligero que la versión senior. Las personas conductoras envían su ubicación cada pocos segundos, las pasajeras piden un viaje y el servicio debe devolver una conductora cercana en un par de segundos.
Las actualizaciones de ubicación son el problema de volumen: 200.000 conductores activos a una actualización cada 4 segundos son 50.000 escrituras por segundo. Guarda ubicaciones actuales en memoria indexadas por geohash o celdas H3, no en una relacional. Emparejar significa "encuentra conductoras en mi celda y vecinas", clasifica por ETA y bloquea a una para que dos pasajeras no reciban el mismo coche.
Si una conductora acepta y luego pierde conectividad, el bloqueo expira y la pasajera se reasigna. Una celda caliente en el centro tiene celdas más finas en áreas densas, justo lo que dan los índices jerárquicos como H3.
11. Diseña un sistema de recogida de métricas
Un sistema de métricas recoge unos cientos de métricas cada 10 segundos de miles de servidores y permite consultarlas en dashboards.
Agentes agrupan métricas y las envían a una capa de ingesta, que escribe en una base de datos de series temporales (o en un tópico de Kafka con consumidores escribiendo en una). El almacenamiento es por niveles: resolución bruta un día o dos, agregados al minuto un mes, por hora un año. El downsampling corre como job en segundo plano.
Las consultas van al nivel de agregación que encaja con el rango temporal, para que un gráfico de 30 días no escanee datos brutos. La cardinalidad de etiquetas (por ejemplo, IDs de usuario) puede tumbar la base; dilo explícitamente.
Sobre push versus pull, Prometheus tira de los datos, pero push funciona mejor a través de firewalls y para jobs de corta vida. Un agente que reporta timestamps fuera de orden se acepta dentro de una ventana de tolerancia y se rechaza más allá, con un contador de rechazos para que un reloj roto se vea.
12. Diseña un sistema de autocompletado de búsqueda
Autocomplete devuelve las cinco mejores completaciones en unos 100 milisegundos por pulsación. Aclara si las sugerencias son globales o personalizadas, porque la personalización lo cambia todo.
La respuesta es precomputar. Un pipeline offline agrega logs de consulta, cuenta frecuencias y construye un trie (o una tabla de prefijo a top-k) donde cada nodo ya guarda sus mejores completaciones. La capa de servicio hace una sola búsqueda por pulsación, y toda la estructura cabe en memoria repartida entre varias réplicas.
Las actualizaciones van en lotes, quizá cada hora, reconstruyendo la estructura y conmutándola. Las tendencias pueden tener una pequeña capa en tiempo real fusionada al pedir.
Un prefijo como “a” tocaría un subárbol enorme, por eso guardas el top-k en cada nodo en lugar de recorrer. Los typos necesitan un índice difuso aparte, o aceptas el fallo.
13. Diseña un planificador de trabajos distribuido
Un planificador distribuido es un cron para toda la empresa: defines un job y un horario, lo ejecutas a su hora y como máximo una vez por tick, reintentas si falla y muestras qué pasó.
Guarda definiciones de jobs y horarios en una base de datos. Un servicio planificador calcula la próxima ejecución y empuja los jobs vencidos a una cola; pools de workers tiran y ejecutan. La parte delicada es ejecutar exactamente una instancia del planificador por job sin punto único de fallo, lo que suele implicar elección de líder (un lock en ZooKeeper, etcd o una fila con leasing en la base).
Registra cada ejecución con estado, hora de inicio, fin y ubicación de logs. Esa tabla será lo que la gente mire de verdad.
Un job que dura más que su intervalo debería saltarse, encolarse o solaparse, y que sea configurable. Cuando el job B depende del A, las dependencias forman un DAG y el planificador solo encola cuando upstream ha tenido éxito.
Preguntas de entrevistas de diseño de sistemas avanzadas
Terreno senior. Escala enorme, multi-región, objetivos de fiabilidad que puedas expresar en números y el coste de cada decisión. Se espera que menciones modos de fallo sin que te lo pregunten.
El streaming de vídeo son dos sistemas bajo un mismo nombre. En la subida, la persona usuaria envía un archivo bruto y un pipeline lo transcodifica a varias resoluciones y bitrates, lo divide en chunks de unos segundos y guarda los trozos en almacenamiento de objetos. En la reproducción, una CDN sirve esos chunks y el reproductor cambia el bitrate según el ancho de banda: streaming adaptativo vía HLS o DASH.
Declara la escala: cientos de horas subidas por minuto, miles de millones de visualizaciones al día, almacenamiento en exabytes. La transcodificación es paralelizable a lo bestia, así que un gran grupo de workers tira de una cola. Metadatos como título, propietario y recuento de vistas viven en una base particionada con mucha caché porque la home los lee constantemente. El almacenamiento de objetos y los bordes de la CDN se replican entre regiones, y el SLO que importa es el tiempo de inicio de reproducción, con la ratio de rebuffering como métrica que la gente nota.
Los contadores de vistas en un vídeo viral son contadores aproximados agregados por lotes, nunca un incremento por vista en base de datos, y el matching de copyright es un trabajo de fingerprinting en el mismo pipeline de subida.
Una plataforma de logs recoge logs de todos los servicios, los hace buscables en segundos y los guarda 30 días en caliente y un año en frío.
Agentes leen los ficheros y los envían a un buffer duradero como Kafka, que absorbe picos y permite que los indexadores se retrasen sin perder datos. Los indexadores escriben en un clúster de búsqueda con un índice por día y servicio, y los índices antiguos bajan a ficheros comprimidos en almacenamiento de objetos.
El coste es la restricción real, así que indexa campos estructurados y mantén el texto bruto barato. Da cuotas por servicio, monitoriza el lag de indexación y elimina PII en la ingesta.
Un servicio que loguea a 100x de su volumen normal recibe cuota, muestreo, drop y alerta, en ese orden. Consultas entre regiones implican búsqueda federada, con cada región dueña de sus datos.
16. Diseña un sistema de analítica en tiempo real
Analítica en tiempo real significa dashboards con agregados de los últimos minutos, actualizados en segundos, sobre un flujo de quizá un millón de eventos por segundo.
Un procesador de streams como Flink mantiene agregados con ventanas (por ejemplo, conteos por minuto por dimensión) y los escribe en un almacén de lectura rápida como ClickHouse o Druid. Los dashboards consultan ese almacén, nunca el stream bruto.
Nombra los trade-offs: conteos exactos frente a HyperLogLog para usuarios únicos, ventanas tumbantes vs. deslizantes y watermarks para eventos tardíos. Define un SLO de frescura y monitoriza el lag del procesador.
Una dimensión de alta cardinalidad como user ID explotará la tabla de agregados, así que consulta eventos brutos para ese caso. Rellenar tras un bug implica reproducir desde el stream con offsets retenidos.
17. Diseña un sistema de pagos
Pagos es el único diseño donde la corrección pesa más que la escala. El sistema debe cobrar, registrarlo, no cobrar dos veces, no perder registros y conciliar con el banco a diario.
La idempotencia sostiene gran parte: cada petición lleva una clave y el servicio guarda el resultado asociado y devuelve lo mismo en reintentos. El dinero se mueve en un libro mayor de doble entrada solo-adición donde cada transacción suma cero, en una base relacional con aislamiento serializable. Aquí la consistencia eventual no es la respuesta.
Las llamadas a la red de tarjetas pueden expirar con ambigüedad, así que los cargos quedan en pendiente y un job de conciliación los liquida. Multi-región implica una región de origen por cuenta, nunca escrituras activo-activo sobre el mismo saldo.
Multidivisa significa importes enteros en unidades menores con código de moneda, y un reembolso que llega antes de que el cargo se liquide se gestiona con una máquina de estados con transiciones explícitas.
18. Diseña un sistema de mensajería a gran escala
Un sistema de mensajería a gran escala permite publicar y suscribirse, sobrevive a reinicios de brokers y preserva el orden donde importa, a millones de mensajes por segundo.
Particiona cada tópico para que mensajes con la misma clave caigan en la misma partición, dando orden por clave sin orden global. Cada partición es un log append-only replicado a varios brokers, y los consumidores confirman su offset tras procesar.
Por defecto, entrega al menos una vez con consumidores idempotentes. Los reintentos van a un tópico de retry con backoff y los mensajes envenenados a una dead-letter queue. El lag del consumidor es la señal para fijar un SLO y, entre regiones, una región debe ser dueña de escrituras por clave o se reordenarán.
Un consumidor que cae tras procesar pero antes de confirmar produce un duplicado; por eso la idempotencia importa. Las tormentas de reequilibrio se calman con asignación sticky y reequilibrio cooperativo.
Preguntas de diseño de sistemas para backend engineers
Se centran en APIs, modelos de datos y límites entre servicios. Espera repreguntas sobre consistencia, caché y qué registrarías.
19. Diseña un servicio de autenticación y autorización
Autenticación responde “quién eres” y autorización “qué puedes hacer”, y gusta quien mantiene esas capas separadas.
Usa OAuth 2.0 y OpenID Connect en lugar de inventar un protocolo. Emite tokens de acceso de corta vida y refresh tokens más largos almacenados en servidor para poder revocarlos. Los permisos viven en un modelo de roles comprobado por una librería pequeña o un servicio de políticas. Registra cada intento de login, refresh y denegación con IP y dispositivo, y nunca registres los tokens.
Los JWT evitan una consulta por petición, pero revocarlos antes de tiempo requiere una denylist, que vuelve a introducir la consulta. Las intrusiones por relleno de credenciales se frenan con rate limiting por IP y por cuenta, retrasos tras fallos repetidos y un segundo factor en inicios de sesión sospechosos.
20. Diseña un API gateway
Un API gateway es un punto de entrada delante de tus servicios que se encarga del trabajo transversal para que cada servicio no tenga que hacerlo: ruteo por path y versión, terminación TLS, autenticación, rate limiting y logging de peticiones.
El gateway debe ser sin estado y escalar horizontalmente detrás de un balanceador. La configuración de rutas vive en un plano de control y se empuja a las instancias, para no redeplegar el gateway al añadir una ruta. Los tokens se validan una vez en el edge y el gateway reenvía la identidad de usuario como cabecera.
El radio de impacto es lo que hay que decir en voz alta. El gateway está en todas las rutas, así que una mala configuración tumba todo; valida configs, despliega gradualmente y mantén la lógica del gateway fina.
Versionar sin romper apps móviles que no puedes actualizar implica versionado por path o cabecera con versiones antiguas vivas. Y el gateway no debería agregar respuestas de varios servicios; eso pertenece a una capa backend-for-frontend.
21. Diseña un sistema de pedidos para un e-commerce
Un sistema de pedidos crea un pedido, reserva inventario, cobra, envía y deja ver el estado al cliente. Los pedidos son una máquina de estados (created, paid, packed, shipped, delivered, cancelled), y las transiciones permitidas deben ser explícitas.
La creación es un POST con clave de idempotencia para que un doble clic no cree dos pedidos. Inventario y pago implican otros servicios, así que usa una saga: cada paso publica un evento y los fallos disparan acciones compensatorias (liberar inventario, reembolsar). Escribe el evento en una tabla outbox en la misma transacción que la actualización del pedido para que base de datos y bus de mensajes nunca discrepen.
En lectura, una tabla de pedidos más order_items, con un resumen materializado en caché para la página "mis pedidos".
Dos clientes comprando la última unidad a la vez se resuelve con un bloqueo de fila o decremento atómico en inventario; uno recibirá un fuera de stock. Lo clave a monitorizar es pedidos atascados en un estado más de lo esperado.
22. Diseña un servicio de feature flags
Un servicio de feature flags activa funciones por entorno, segmenta por atributos de usuario o porcentaje y permite desactivar globalmente en segundos si algo se rompe.
Las definiciones y reglas viven en una base pequeña tras una API de administración. Las apps integran un SDK que obtiene todas las flags al arrancar, las cachea localmente y evalúa reglas en proceso, de modo que consultar una flag no cuesta nada por petición. Las actualizaciones se propagan por conexión de streaming o polling corto, y el SDK mantiene el último estado conocido si el servicio de flags cae.
Evalúa rollouts por porcentaje con un hash estable del user ID y la clave de la flag, para que la misma persona caiga siempre en el mismo lado.
Las flags obsoletas se detectan siguiendo la última evaluación y avisando a las personas dueñas, y si el servicio de flags está caído al inicio la app recurre a valores por defecto en código.
23. Diseña una API de recomendación
Una API de recomendación devuelve 20 ítems para una persona usuaria en menos de 100 ms a unos miles de RPS, y no hace falta ML profundo para diseñarla.
Separa offline y online. Un job offline calcula listas candidatas por usuario en un KV de baja latencia. La API online las recupera, reordena con señales frescas como stock, filtra lo ya comprado y devuelve. Ten un fallback de populares por categoría y registra cada lista servida con un request ID para cruzarla con clics.
Una persona nueva recibe el fallback hasta que haya algunas interacciones. Los 100 ms se reparten más o menos en 10 para la lectura, 30 para el rerank, 10 para serializar y 50 de margen.
Preguntas de diseño de sistemas para Infraestructura / DevOps
Fiabilidad, despliegue, automatización y observabilidad. El tema recurrente: cómo cambiar cosas con seguridad y saber rápido cuando te has equivocado.
24. Diseña un pipeline de CI/CD para microservicios
Un pipeline de CI/CD para microservicios debe manejar decenas de servicios desplegables de forma independiente con tests, checks de seguridad y un camino a producción que no requiera a nadie a las 3 a.m.
Compila una vez, despliega el mismo artefacto en todas partes. El pipeline lintéa, ejecuta tests unitarios, construye una imagen de contenedor etiquetada con el SHA del commit, la escanea y la sube al registro. El despliegue promueve esa imagen por entornos (dev, staging, producción) usando configuración, no recompilando.
El despliegue a producción debe ser progresivo: canario a un pequeño porcentaje de tráfico, observa tasa de errores y latencia un tiempo definido y continúa o revierte automáticamente. Revertir es redeplegar la etiqueta anterior, rápido precisamente porque no recompilaste.
Cuando un cambio en el servicio A rompe el contrato de B, la solución son contract tests en CI y cambios de API retrocompatibles. Monorepo versus multi-repo importa menos de lo que se cree, mientras el pipeline solo construya lo que ha cambiado.
25. Diseña monitorización y alertas centralizadas
La monitorización centraliza métricas, logs y trazas de todos los servicios en un lugar, con alertas que despiertan solo cuando hay impacto en usuarios.
Las métricas van a una serie temporal, los logs a la plataforma de la pregunta 15, las trazas a su backend, todo correlacionado por un request ID compartido. La decisión importante es sobre qué alertar. Alerta sobre síntomas (tasa de errores, percentiles de latencia, saturación) ligados a SLOs, no sobre causas como "CPU al 80%".
La fatiga por pagers mata las guardias, así que cada página necesita runbook y revisión. Cualquier alerta que dispare dos veces en una semana sin acción clara baja a ticket.
Un SLO para un servicio nuevo sale de medir un par de semanas y fijar un objetivo ligeramente mejor que el actual. Y cuando la monitorización cae, checks sintéticos externos y un dead-man’s switch te avisan.
26. Diseña un enfoque de gestión de secretos
La gestión de secretos hace que contraseñas de base de datos, claves de API y certificados estén disponibles en tiempo de ejecución, nunca en código fuente, rotados con regularidad y auditados.
Un almacén central (HashiCorp Vault, el gestor del cloud) guarda todo. Los servicios se autentican con su identidad de workload (service account de Kubernetes, rol IAM), nunca con un token de larga vida, y obtienen secretos al arrancar o bajo demanda. Prefiere secretos dinámicos: el almacén genera credenciales de base válidas una hora y la rotación es gratis.
Audita cada lectura. Y documenta un camino de emergencia cuando el almacén de secretos caiga, porque pasará.
Una clave que una persona desarrolladora comete por error se detecta con escaneo en CI, se rota de inmediato y se trata como comprometida. Secretos en variables de entorno son comunes pero se filtran por volcados y procesos hijos; móntalos como ficheros o recógelos en proceso.
27. Diseña autoescalado y una estrategia de despliegue
Autoescalado y despliegue juntos deben permitir manejar picos diarios de 5x sin intervención manual mientras se despliega varias veces al día.
Escala con una señal que refleje el dolor de usuario, normalmente tasa de peticiones o latencia por instancia, no solo CPU. Fija réplicas mínimas para que un arranque en frío no encare un pico y un máximo para que un bug no te arruine. Escala rápido hacia arriba y lento hacia abajo.
Para desplegar, usa blue/green cuando quieras cambio y rollback instantáneos, y canario cuando quieras observar tráfico real en un trozo pequeño primero. Combina canario con el autoescalador con cuidado, porque un canario que escala por su cuenta sesga la comparación.
Si el escalado se queda dos minutos corto ante un pico súbito, escalado predictivo por horario o un mínimo más alto cubren el hueco. Y 50 instancias nuevas agotando conexiones a la base es por lo que el pooling debe ir en una capa proxy.
Preguntas de diseño de sistemas para data engineers
Pipelines, formatos de almacenamiento, batch vs. streaming y si los datos son de fiar. El mismo marco de antes, pero los fallos van de datos perdidos, duplicados o tardíos más que de peticiones perdidas.
28. Diseña un pipeline de ingesta de eventos
Un pipeline de ingesta toma eventos de comportamiento de web y móvil y los hace consultables en una hora. Asume 50.000 eventos por segundo en pico, con clientes que se desconectan y reintentan.
Los clientes agrupan eventos con un SDK y publican a un collector que valida contra un registro de esquemas y escribe a un stream (Kafka o gestionado). Un consumidor aterriza eventos brutos en almacenamiento de objetos particionado por hora, en formato columnar como Parquet. Los trabajos downstream leen de ahí.
Los reintentos implican duplicados, así que cada evento lleva un UUID generado en cliente y el job de aterrizaje deduplica en una ventana. Cambios de esquema pasan por el registro con comprobaciones de compatibilidad, porque una app móvil antigua seguirá enviando la forma vieja durante meses.
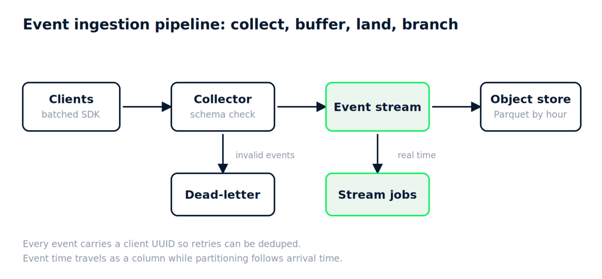
Un evento con timestamp de hace tres días aterriza por hora de llegada, mantiene su hora de evento como columna y deja que downstream decida. Los eventos malos van a una ruta de dead-letter y nunca se descartan en silencio.
29. Diseña un sistema de ETL en streaming
ETL en streaming transforma eventos al llegar, los une con datos de referencia y escribe resultados a un almacén de servicio en segundos.
Un procesador de streams lee del tópico de ingesta, aplica transformaciones y enriquece con datos de referencia cargados en memoria y refrescados periódicamente. El estado (para joins en ventana o agregaciones) hace checkpoint a almacenamiento duradero para que un job caído no reprocesa desde el principio.
El trade-off que quieren oír: exactly-once vs. at-least-once. Exactly-once es lograble extremo a extremo si el sink soporta transacciones o escrituras idempotentes, pero cuesta latencia y complejidad. At-least-once con sinks idempotentes te da casi todo el beneficio.
Los datos tardíos se gestionan con watermarks y un periodo de gracia definido, tras el cual van a una tabla de late-arrivals.
Datos de referencia que cambian en medio del stream deben versionarse, con el join en la versión válida al tiempo del evento. Un backfill seis meses después de corregir lógica se reproduce desde almacenamiento bruto en batch, no por el stream.
30. Diseña un data warehouse y un enfoque de modelado
Un warehouse debe dar métricas coherentes en analistas y dashboards de ventas, marketing y producto, con historial preservado.
Aterriza datos brutos intactos en bronce, límpialos y conforma en plata y construye tablas de negocio en oro. Modela oro como esquema en estrella: tablas de hechos al grano más fino útil (una fila por línea de pedido, por ejemplo) y dimensiones de clientes, productos, fechas. Dimensiones lentamente cambiantes con Tipo 2 donde importe el historial, para que un cambio de región de cliente no reescriba los ingresos del año pasado.
Particiona hechos grandes por fecha, agrupa por columnas de filtro y guarda transformaciones en control de versiones (dbt o equivalente) con tests.
Cuando dos equipos definen “cliente activo” distinto, una capa de métricas con una definición única lo resuelve. Un hecho tardío que referencia una clave de dimensión aún no presente obtiene una fila placeholder que se rellena más tarde.
31. Diseña un feature store
Un feature store calcula features una vez y las reutiliza para entrenamiento y predicción online sin sesgo entre entrenamiento/serving, y aquí nos quedamos en alto nivel. Son dos almacenes con una definición: el offline (un warehouse o lake) guarda el historial para sets de entrenamiento, y el online (Redis, DynamoDB) guarda el último valor por entidad para consultas de baja latencia en predicción.
Una única definición de feature gobierna ambos, y un job materializa de offline a online en un horario.
El concepto crítico es el point-in-time correctness. Al construir el set de entrenamiento, cada fila debe usar valores de features como existían en su timestamp, no los actuales. Si no, tu modelo aprende del futuro y luce genial hasta que se despliega.
Una feature cara de calcular en tiempo real se precomputa con cierta obsolescencia o se calcula en escritura. Para verificar que online y offline coinciden, muestrea y compara, y registra las features realmente servidas.
32. Diseña una capa de calidad y linaje de datos
Una capa de calidad y linaje detecta datos rotos antes que los dashboards y responde “de dónde sale esta columna” sin leer código.
Los checks de calidad corren como pasos del pipeline: conteos de filas en rangos esperados, tasas de nulos, frescura (si la partición llegó a tiempo) y algunas aserciones de negocio (los ingresos nunca son negativos). Los fallos bloquean jobs downstream y alertan a la persona dueña. Guarda resultados en el tiempo para ver deriva, no solo el OK de hoy.
El linaje se captura del código de transformación (parseo de SQL o metadata del orquestador) y se guarda como grafo: de tabla a tabla y, cuando se pueda, de columna a columna. Ese grafo permite análisis de impacto cuando alguien quiere eliminar una columna.
Si los checks tardan más que el pipeline, muestrea o ejecuta los pesados en asíncrono y alerta en vez de bloquear. Linaje entre herramientas que no se hablan implica OpenLineage o anotaciones manuales, con las lagunas documentadas.
Preguntas de diseño de sistemas para Frontend / Full-Stack
Rendimiento en cliente, gestión de estado, caché y cómo el navegador habla con la API. También aparecen nociones de seguridad.
33. Diseña la arquitectura de una web de alto tráfico
Aquí, una web de alto tráfico es un sitio con mucho contenido, millones de visitantes diarios, primer pintado rápido y secciones personalizadas para usuarios con login.
Los assets estáticos van a una CDN con caché larga y nombres con hash. Las páginas iguales para todos se renderizan en servidor y se cachean en el edge; las partes personalizadas cargan en cliente tras pintar el shell. Ese híbrido mantiene bajo el time-to-first-byte sin servir datos personales obsoletos.
Las llamadas desde el cliente pasan por el gateway con tokens de corta vida. Define cabeceras de caché con intención: Cache-Control con stale-while-revalidate para contenido que puede ir unos segundos atrasado y no-store para lo personal.
Para un dashboard tras login, el render en cliente suele bastar: SSR aporta poco sin SEO. Y una clave de caché que incluye por accidente la cookie de sesión hace que cada cual tenga su copia y la tasa de aciertos se hunda.
34. Diseña sincronización offline-first
Offline-first implica una app de notas o de datos de campo que funciona sin conexión y sincroniza al volver, sin perder ediciones.
Cada escritura va primero a un almacén local (IndexedDB, SQLite en móvil) y a una cola de mutaciones pendientes. Al volver la conectividad, el cliente empuja la cola en orden y tira de cambios desde su último token. Cada mutación lleva un ID de cliente y un número de secuencia para que el servidor pueda deduplicar.
Los conflictos son el quid. El último en escribir gana es simple y pierde datos. La fusión a nivel de campo cubre la mayoría.
Los CRDT dan fusiones automáticas para texto y listas a costa de complejidad; solo los usaría si la edición colaborativa es requisito real.
Una usuaria que edita en dos dispositivos offline y los reconecta aplica ambas ediciones, se marca el conflicto y la UI lo muestra. Una cola pendiente que crece a 10.000 mutaciones debe compactarse: diez ediciones al mismo campo se vuelven una.
35. Diseña actualizaciones de UI en tiempo real
Actualizaciones en tiempo real significan un dashboard o chat que reflejan cambios del servidor en un segundo para miles de usuarios concurrentes.
Elige el transporte por dirección. Server-Sent Events cuando los datos solo van del servidor al cliente (marcadores en vivo, notificaciones); WebSockets cuando el cliente también envía mucho (chat, edición colaborativa). Long polling como fallback cuando la red bloquea ambos.
En el servidor, una capa pub/sub distribuye cambios al servidor de conexiones que tenga a la usuaria. En el cliente, maneja la reconexión con backoff y reanuda desde el último event ID para que una caída no implique pérdida de actualizaciones. Acelera el render: 50 updates por segundo a un gráfico deben agruparse en pocas repintadas, no 50.
100.000 personas viendo un evento en directo es fan-out en servidor, quizá a través de una CDN que soporte streaming. Autenticar un WebSocket implica un token en el handshake inicial, revalidado periódicamente.
36. Diseña un plan de rendimiento en cliente para dashboards
El objetivo es un dashboard analítico con 20 gráficos que cargue en menos de tres segundos y siga fluido al filtrar.
No pidas 20 gráficos a la vez. Carga primero los visibles, lazy-load el resto al hacer scroll y muestra skeletons, no spinners. Preagrega en servidor para que el cliente reciba unos cientos de filas por gráfico, nunca eventos brutos.
Cacha resultados en memoria con clave por estado de filtro, para que alternar un filtro no vuelva a pedir.
Tablas con miles de filas necesitan virtualización (render solo lo visible). Cálculos pesados a un web worker para liberar el hilo principal.
Si la API es lenta y no puedes cambiarla, cacha agresivamente, muestra datos obsoletos con marca temporal y refresca en segundo plano. Errores CORS al llamar a una API nueva significan que la API debe permitir el origen del dashboard, y deberías saber explicar las preflight requests.
Preguntas de entrevistas de diseño de sistemas basadas en escenarios
Estas evalúan criterio más que arquitectura. Cambian los requisitos, producción se rompe y la persona entrevistadora quiere ver cómo priorizas.
37. El tráfico se multiplica por 10 de la noche a la mañana. ¿Qué cambia primero?
Empieza por lo que se rompe primero, y rara vez es la capa sin estado. El autoscaling maneja los web servers; la base de datos, la caché y los límites de terceros son donde todo cae.
Inmediatamente, mira las métricas de saturación (conexiones, CPU, profundidad de cola) de la base y la caché, sube el techo del autoscaler y activa cualquier reducción de carga que tengas, como desactivar funciones no críticas o servir páginas cacheadas. En un día, añade réplicas de lectura, ajusta la tasa de aciertos de caché y localiza las queries dominantes. A largo plazo, haz el sharding y las colas que venías posponiendo.
Distinguir crecimiento real de bot se reduce a patrones de petición, user agents y si las conversiones se movieron.
38. Estás tocando límites de lectura de la base. ¿Caché, réplicas o sharding?
En ese orden, normalmente. Una caché delante de las lecturas más calientes es barata y puede cortar la carga a la mitad en un día; comprueba la tasa de aciertos y el log de consultas para confirmar que las lecturas son realmente repetitivas.
Las réplicas de lectura van después cuando la mezcla de lecturas es amplia, no caliente. Añaden lag de replicación, así que cualquier ruta de read-after-write (guardar y ver de inmediato) debe ir al primario. El sharding resuelve límites de escritura más que de lectura y te cuesta consultas entre shards y una migración, así que va al final y solo cuando las dos primeras se agotan.
Si un cliente enorme en una sola tabla causa la carga, aisla ese tenant o particiona por ID de cliente.
39. Una dependencia crítica downstream es inestable. ¿Reintentos, timeouts, circuit breakers?
Todo y en el orden adecuado. Primero un timeout, porque una llamada sin timeout convierte una dependencia lenta en tu propia caída a medida que se acumulan hilos. Luego reintentos con backoff exponencial y jitter, pero solo para llamadas idempotentes y solo un par de veces, o amplificas la carga sobre un servicio ya tocado.
Luego un circuit breaker: tras un umbral de fallos, deja de llamar un tiempo y sirve un fallback (datos cacheados, respuesta degradada, error amable). Monitoriza el estado del breaker; un breaker atascado abierto es su propio incidente.
Cuando la dependencia inestable es tu proveedor de pagos, no hay fallback para el cargo; encola el pedido como pendiente y procésalo después.
40. La latencia ha empeorado tras un lanzamiento. ¿Cómo lo diagnosticas?
Primero, confirma que es real y acotado: qué percentil se movió (p50 o solo p99), qué endpoints, qué región. Compáralo con la línea temporal de despliegues; si el empeoramiento coincide con una release, revierte primero e investiga después.
Si revertir no es la respuesta, sigue la petición. Las trazas muestran qué span creció. Sospechosos comunes: una query nueva sin índice, un patrón N+1 introducido por un campo nuevo, un cambio en la clave de caché que hundió la tasa de aciertos o una llamada downstream que era asíncrona y ahora está en el camino síncrono.
Si solo se movió p99 y revertir no ayudó, busca pausas de GC, un vecino ruidoso o un lock.
41. Aparece un bug de inconsistencia de datos. ¿Qué compruebas, qué reviertes?
Acota el daño antes de tocar nada. Qué tablas o registros discrepan, desde cuándo y si sigue ocurriendo. El “desde cuándo” suele apuntar a un despliegue o a una ejecución de job.
Revisa la ruta de escritura de los registros afectados: migraciones recientes, un job que corrió dos veces, un reintento sin idempotencia, una carrera entre dos escritores. Corta la hemorragia pausando el job culpable o revirtiendo código y luego repara desde una fuente de verdad (log de eventos brutos, ledger, backup) en lugar de editar filas a mano. Deja registro de qué cambiaste y por qué.
Sin fuente de verdad para reparar, reconstruye lo que puedas, marca el resto y añade el patrón outbox para que no vuelva a pasar.
Errores comunes en entrevistas de diseño de sistemas
La mayoría falla por el mismo puñado de razones. Ninguna tiene que ver con saber menos.
- Saltar las preguntas de aclaración. Ir directo a las cajas puede hacerte resolver el problema equivocado durante 40 minutos.
- Sin números. "Tiene que escalar" no dice nada. 5.000 escrituras por segundo y 2 TB al año sí, y cambian el diseño.
- Una arquitectura perfecta. Quieren oír "elegiría X por Y, y el coste es Z". Una única respuesta segura sin concesiones suena memorizada.
- Microservicios demasiado pronto. Un monolito con buenos límites es una respuesta válida para muchas preguntas de nivel básico e intermedio. Dividir en 12 servicios en la pizarra añade fallos que ahora debes defender.
- Ignorar las operaciones. Cómo se despliega, qué monitorizas, qué pasa si un nodo muere. Personas senior lo preguntarán, y a juniors les da puntos extra si lo sacan.
- Olvidar el modelo de datos. Cajas y flechas sin idea de qué hay en las tablas. Esto duele especialmente en roles de datos.
- Quedarse en silencio. Pensar en silencio dos minutos se le hace eterno a quien entrevista. Narra, aunque sea "estoy valorando dos opciones".
Cómo prepararte para entrevistas de diseño de sistemas
La preparación funciona cuando es repetible. Aquí va un proceso que yo sí seguiría.
- Usa la misma estructura siempre. Los seis pasos del inicio de este artículo, en ese orden, en cada pregunta que practiques. Escríbelos en una tarjeta y ensaya hasta que la secuencia sea automática y no gastes atención en qué viene después.
- Simula entrevistas cronometradas. Con una amiga, un colega o un grabador de voz, haz 45 minutos en voz alta con alguien interrumpiéndote con repreguntas. Las primeras serán duras, y de eso se trata.
- Crea una plantilla de diseño. Una chuleta de una página con los patrones a los que recurres: cache-aside, colas para desacoplar, pub/sub para fan-out, CQRS cuando lecturas y escrituras divergen, sharding por clave, outbox para consistencia entre base y bus. Repásala antes de cada sesión.
- Practica explicar trade-offs, no solo dibujar. Para cada patrón, di en una frase qué te aporta y qué te cuesta. Esa frase separa un aprobado de un aprobado excelente.
- Ve por nivel y por rol. Elige cinco preguntas de tu nivel y cuatro de tu rol en esta lista, y ensáyalas de verdad en lugar de hojear las 41. Si las de pipeline de datos te sonaron lejanas, Our Introduction to Data Engineering y Streaming Concepts courses cubren el vocabulario del que dependen esas respuestas.
Conclusión
Cada pregunta de esta lista salió de un sistema que alguien tuvo que construir y mantener vivo a las 3 a.m., así que cuanto más hagas de eso, menos te parecerá una actuación la entrevista y más te sonará a describir tu martes. Monta un side project con una cola de verdad, apúntate a la rotación de guardias, pide sentarte en una revisión de diseño aunque no sea el tuyo.
Y si quieres terreno estructurado que cubrir de aquí a tu próxima entrevista, esto profundiza en las piezas que sostienen estas respuestas:





Las preguntas de diseño de sistemas aparecen en más entrevistas de las que imaginas. Roles de backend, claro. Pero también en infraestructura, ingeniería de datos e incluso en posiciones muy orientadas a producto donde nadie espera que escribas una línea de código durante la entrevista.
Entonces, ¿qué está evaluando realmente la persona entrevistadora? No si conoces la arquitectura "correcta", porque no existe. Quieren ver pensamiento estructurado, concesiones sinceras y que sigas razonando cuando las restricciones son difusas y el reloj corre.
Las expectativas cambian bastante según el nivel. Una persona junior que hace buenas preguntas de aclaración y esboza un diagrama limpio con unas pocas cajas lo está haciendo muy bien. Una persona senior que solo hace eso está en problemas, porque a ese nivel se esperan números, modos de fallo y una opinión sobre qué construir primero.
El rol también importa. A una data engineer le apretarán con pipelines y backfills, a una frontend con caché y estado, y a alguien de infra con despliegues y radio de impacto. La misma habilidad de base, distinto vocabulario.
Lo digo porque la mayoría de listas de preguntas ignoran ambas dimensiones y simplemente te sueltan 50 prompts. Esta está organizada primero por nivel y luego por rol, con preguntas de escenarios al final. Si la parte de almacenamiento en estas respuestas te suena floja, nuestro Database Design course cubre los fundamentos.
Cómo afrontar una entrevista de diseño de sistemas
La misma estructura siempre, unos 45 minutos:
Narra todo en voz alta. Una persona entrevistadora no puede puntuar pensamientos en silencio.
Preguntas de entrevistas de diseño de sistemas para principiantes
Estas prueban los fundamentos: aclarar requisitos antes de dibujar, producir un diagrama de arquitectura sencillo y tomar decisiones sensatas de almacenamiento. Nadie espera algoritmos de consenso aquí.
1. Diseña un acortador de URL
Un acortador convierte una URL larga en un código corto y redirige al visitarlo, así que lo primero es decidir si los enlaces caducan y cuántos esperas. Una suposición razonable: 100 millones de enlaces nuevos al mes, con lecturas unas 100 veces las escrituras.
Esa mezcla intensiva en lectura moldea el diseño: un servidor de API, una base de datos y una caché delante. Para el código corto, o bien codificas en base62 un ID autoincremental (siete caracteres dan unos 3,5 billones de combinaciones) o generas una cadena aleatoria y compruebas colisiones.
Una sola tabla basta:
short_codecomo clave primaria,long_url,created_at,expires_aty unuser_idopcional. Los códigos calientes viven en Redis para que la base de datos solo vea los fallos de caché. Usa un 302 si quieres analítica de clics, porque los navegadores almacenan en caché un 301 y no verás la segunda visita.Con 10.000 millones de enlaces, fragmentas por código y el generador de IDs se vuelve el cuello de botella; y si la gente empieza a adivinar códigos, pasas de secuencial a aleatorio y añades limitación de tasa.
2. Diseña un limitador de tasa básico
Un limitador de tasa permite N peticiones por usuario por minuto y devuelve un 429 a partir de ahí. Lo primero es aclarar si el límite es por usuario, por IP o por clave de API, porque eso determina tu clave de caché.
Tres algoritmos cubren la mayoría de respuestas. Ventana fija cuenta peticiones por minuto, es simple pero permite doblar el límite en el borde. Ventana deslizante con log almacena cada marca de tiempo, es exacto pero consume mucha memoria. Token bucket se rellena a ritmo constante y permite pequeños picos, por eso muchos gateways lo usan.
Ejecuta el limitador como middleware en el API gateway con contadores en Redis bajo un TTL; INCR más EXPIRE cubren la versión de ventana fija.
Con diez instancias del gateway o compartes contadores en Redis o aceptas un ligero sobreconteo con contadores locales, y deberías decidir de antemano qué pasa si Redis cae: ¿fallo abierto y arriesgar abuso, o fallo cerrado y bloquear a todo el mundo?
3. Diseña un almacén clave-valor simple
Un almacén clave-valor necesita get, put y delete, y para una pregunta de principiante conviene mantenerlo en un solo nodo. Un mapa hash en memoria maneja las operaciones. Para durabilidad, añade cada escritura a un log en disco antes de confirmarla y haz snapshots periódicos para que la recuperación no tenga que reproducir toda la historia.
Lo que la persona entrevistadora quiere oír es que separas la vía rápida en memoria de la vía duradera en disco y que entiendes por qué el log va primero.
Si los datos crecen más que la memoria, la respuesta es un árbol LSM, que es más o menos cómo funcionan RocksDB y Cassandra. Si necesitas un segundo nodo, el primario replica el log a un seguidor y, al ir más allá, entra en juego el hash consistente.
4. Diseña una caché (conceptual)
Una caché se sitúa entre tu aplicación y un almacén más lento, y el patrón básico es cache-aside. La app consulta la caché, falla, lee la base de datos y escribe el resultado con un TTL. Simple, pero la invalidación es tu responsabilidad.
La expulsión suele ser LRU, a veces LFU para cargas sesgadas. La métrica que importa es la tasa de aciertos; por debajo del 80% deberías preguntarte si la caché ayuda realmente.
Donde se pone interesante: la obsolescencia. Si la base de datos cambia y la copia en caché no, los usuarios ven datos antiguos hasta que expire el TTL. TTLs cortos reducen esa ventana pero aumentan la carga en la base de datos.
Cuando una clave popular caduca y 10.000 peticiones golpean la base de datos a la vez, o fusionas esas peticiones o refrescas la clave antes de que expire. Sobre write-through frente a write-back: write-through mantiene la caché correcta a costa de escrituras más lentas, mientras que write-back es rápido pero pierde escrituras recientes si la caché muere antes de vaciarse.
5. Diseña un servicio básico de notificaciones
Un servicio de notificaciones envía email, SMS y push y reintenta cuando un proveedor falla. Antes de diseñar, pregunta por el volumen y si el orden de entrega importa, que normalmente no.
El corazón del diseño es una cola. Los productores escriben un evento de notificación y un worker por canal tira de eventos y llama a un proveedor como SendGrid o Twilio. Esa separación mantiene aparte la decisión de notificar del envío real, para que un proveedor de SMS lento no bloquee la app.
Guarda cada notificación con un estado (pendiente, enviada, fallida) y una clave de idempotencia para que un reintento no la envíe dos veces.
Quienes quieren apagar marketing pero mantener alertas de seguridad necesitan una tabla de preferencias consultada antes de encolar, y un proveedor que te limite a 100 mensajes por segundo requiere limitación por canal en el worker.
6. Diseña un servicio sencillo de almacenamiento de archivos
Piensa en Dropbox a pequeña escala. Las personas suben un archivo, obtienen un enlace y lo descargan después. Aclara el tamaño máximo de archivo y si compartir importa.
Los metadatos (propietario, nombre, tamaño, checksum, fecha de creación) van en una base de datos relacional. Los bytes van a almacenamiento de objetos tipo S3, nunca a la base de datos. Para subidas, la API devuelve una URL prefirmada para que el cliente escriba directamente en el almacenamiento de objetos y tus servidores no toquen el archivo.
Dos personas subiendo el mismo archivo de 2 GB es un problema de deduplicación que se resuelve con un hash del contenido, y archivos de más de 5 GB requieren subida multiparte con checksum por bloque.
7. Diseña un ranking de juego
Un leaderboard tiene que actualizar la puntuación de un jugador, devolver el top 10 y devolver el puesto de un jugador, y lo primero a preguntar es cuántos jugadores hay y con qué frecuencia cambian las puntuaciones.
Una tabla relacional con un índice por puntuación sirve hasta cierto punto, pero "¿cuál es mi puesto?" pasa a ser un
COUNTsobre todo el mundo por encima de ti. Los conjuntos ordenados de Redis lo solucionan:ZADDpara actualizar,ZREVRANGEpara el top N,ZREVRANKpara una jugadora, todo en tiempo logarítmico.Tablas diarias y de todos los tiempos son un conjunto ordenado por periodo, con claves tipo
lb:2026-09-14. Si 50 millones de jugadores fuerzan demasiado la memoria de Redis, guarda solo el top 100k ahí y el resto en la base de datos.Preguntas de entrevistas de diseño de sistemas intermedias
A este nivel se asume que has construido y operado sistemas reales. Las preguntas introducen colas, escalado de lecturas/escrituras y la tensión entre latencia, coste y consistencia.
8. Diseña un feed de noticias
Un feed necesita que usuarios publiquen, sigan a otros y lean lo que han escrito quienes siguen, en orden inverso cronológico o con ranking. Asume 10 millones de usuarios activos diarios abriéndolo cinco veces al día, lo que equivale a unas 600 lecturas por segundo de media y muchas más en picos.
La decisión central es cuándo ensamblar el feed. Fan-out on write empuja cada nueva publicación al feed precomputado de cada seguidor: lecturas rápidas a costa de escrituras caras. Fan-out on read lo ensambla al pedirlo, invirtiendo el trade-off. La mayoría de sistemas mezclan: fan-out on write para usuarios normales y on read para cuentas con millones de seguidores.
El modelo de datos es
posts,followsy una lista de feed por usuario en Redis con IDs de posts. Pagina con un cursor sobre el ID del post, no con offset.Añadir ranking después no implica rehacer nada de esto; puntúas los IDs candidatos de la lista del feed en tiempo de lectura.
9. Diseña un sistema de chat con sincronización multi-dispositivo
Chat con sincronización multi-dispositivo implica mensajes uno a uno y de grupo, entrega a todos los dispositivos de una persona usuaria y un historial que sobrevive a cambiar de móvil. Asume 50 millones de usuarios diarios enviando unos 40 mensajes cada uno: 2.000 millones al día, unas 23.000 escrituras por segundo de media y varias veces más en picos regionales.
Cada cliente mantiene un WebSocket con un servidor de chat, que escribe mensajes en un almacén particionado por ID de conversación con un número de secuencia creciente por conversación. Cada dispositivo recuerda el último número visto y pide lo nuevo al reconectar: esto hace que la sincronización multi-dispositivo funcione.
El almacén necesita alto throughput de escritura y lecturas por rango por conversación, así que bases de datos de columnas anchas como Cassandra son la respuesta habitual. Entregas y lecturas recibidas son eventos pequeños que fluyen por el mismo camino.
Cuando dos amigas están conectadas a distintos servidores de chat, o pub/sub entre servidores o un servicio de routing que mapea usuarios a servidores hace llegar el mensaje. Grupos de 500 se expanden del lado servidor, y mantener el orden se complica.
10. Diseña un servicio de emparejamiento para ride-sharing
Mantén esto más ligero que la versión senior. Las personas conductoras envían su ubicación cada pocos segundos, las pasajeras piden un viaje y el servicio debe devolver una conductora cercana en un par de segundos.
Las actualizaciones de ubicación son el problema de volumen: 200.000 conductores activos a una actualización cada 4 segundos son 50.000 escrituras por segundo. Guarda ubicaciones actuales en memoria indexadas por geohash o celdas H3, no en una relacional. Emparejar significa "encuentra conductoras en mi celda y vecinas", clasifica por ETA y bloquea a una para que dos pasajeras no reciban el mismo coche.
Si una conductora acepta y luego pierde conectividad, el bloqueo expira y la pasajera se reasigna. Una celda caliente en el centro tiene celdas más finas en áreas densas, justo lo que dan los índices jerárquicos como H3.
11. Diseña un sistema de recogida de métricas
Un sistema de métricas recoge unos cientos de métricas cada 10 segundos de miles de servidores y permite consultarlas en dashboards.
Agentes agrupan métricas y las envían a una capa de ingesta, que escribe en una base de datos de series temporales (o en un tópico de Kafka con consumidores escribiendo en una). El almacenamiento es por niveles: resolución bruta un día o dos, agregados al minuto un mes, por hora un año. El downsampling corre como job en segundo plano.
Las consultas van al nivel de agregación que encaja con el rango temporal, para que un gráfico de 30 días no escanee datos brutos. La cardinalidad de etiquetas (por ejemplo, IDs de usuario) puede tumbar la base; dilo explícitamente.
Sobre push versus pull, Prometheus tira de los datos, pero push funciona mejor a través de firewalls y para jobs de corta vida. Un agente que reporta timestamps fuera de orden se acepta dentro de una ventana de tolerancia y se rechaza más allá, con un contador de rechazos para que un reloj roto se vea.
12. Diseña un sistema de autocompletado de búsqueda
Autocomplete devuelve las cinco mejores completaciones en unos 100 milisegundos por pulsación. Aclara si las sugerencias son globales o personalizadas, porque la personalización lo cambia todo.
La respuesta es precomputar. Un pipeline offline agrega logs de consulta, cuenta frecuencias y construye un trie (o una tabla de prefijo a top-k) donde cada nodo ya guarda sus mejores completaciones. La capa de servicio hace una sola búsqueda por pulsación, y toda la estructura cabe en memoria repartida entre varias réplicas.
Las actualizaciones van en lotes, quizá cada hora, reconstruyendo la estructura y conmutándola. Las tendencias pueden tener una pequeña capa en tiempo real fusionada al pedir.
Un prefijo como “a” tocaría un subárbol enorme, por eso guardas el top-k en cada nodo en lugar de recorrer. Los typos necesitan un índice difuso aparte, o aceptas el fallo.
13. Diseña un planificador de trabajos distribuido
Un planificador distribuido es un cron para toda la empresa: defines un job y un horario, lo ejecutas a su hora y como máximo una vez por tick, reintentas si falla y muestras qué pasó.
Guarda definiciones de jobs y horarios en una base de datos. Un servicio planificador calcula la próxima ejecución y empuja los jobs vencidos a una cola; pools de workers tiran y ejecutan. La parte delicada es ejecutar exactamente una instancia del planificador por job sin punto único de fallo, lo que suele implicar elección de líder (un lock en ZooKeeper, etcd o una fila con leasing en la base).
Registra cada ejecución con estado, hora de inicio, fin y ubicación de logs. Esa tabla será lo que la gente mire de verdad.
Un job que dura más que su intervalo debería saltarse, encolarse o solaparse, y que sea configurable. Cuando el job B depende del A, las dependencias forman un DAG y el planificador solo encola cuando upstream ha tenido éxito.
Preguntas de entrevistas de diseño de sistemas avanzadas
Terreno senior. Escala enorme, multi-región, objetivos de fiabilidad que puedas expresar en números y el coste de cada decisión. Se espera que menciones modos de fallo sin que te lo pregunten.
14. Diseña una plataforma de streaming de vídeo tipo YouTube
El streaming de vídeo son dos sistemas bajo un mismo nombre. En la subida, la persona usuaria envía un archivo bruto y un pipeline lo transcodifica a varias resoluciones y bitrates, lo divide en chunks de unos segundos y guarda los trozos en almacenamiento de objetos. En la reproducción, una CDN sirve esos chunks y el reproductor cambia el bitrate según el ancho de banda: streaming adaptativo vía HLS o DASH.
Declara la escala: cientos de horas subidas por minuto, miles de millones de visualizaciones al día, almacenamiento en exabytes. La transcodificación es paralelizable a lo bestia, así que un gran grupo de workers tira de una cola. Metadatos como título, propietario y recuento de vistas viven en una base particionada con mucha caché porque la home los lee constantemente. El almacenamiento de objetos y los bordes de la CDN se replican entre regiones, y el SLO que importa es el tiempo de inicio de reproducción, con la ratio de rebuffering como métrica que la gente nota.
Los contadores de vistas en un vídeo viral son contadores aproximados agregados por lotes, nunca un incremento por vista en base de datos, y el matching de copyright es un trabajo de fingerprinting en el mismo pipeline de subida.
15. Diseña una plataforma de logging distribuido
Una plataforma de logs recoge logs de todos los servicios, los hace buscables en segundos y los guarda 30 días en caliente y un año en frío.
Agentes leen los ficheros y los envían a un buffer duradero como Kafka, que absorbe picos y permite que los indexadores se retrasen sin perder datos. Los indexadores escriben en un clúster de búsqueda con un índice por día y servicio, y los índices antiguos bajan a ficheros comprimidos en almacenamiento de objetos.
El coste es la restricción real, así que indexa campos estructurados y mantén el texto bruto barato. Da cuotas por servicio, monitoriza el lag de indexación y elimina PII en la ingesta.
Un servicio que loguea a 100x de su volumen normal recibe cuota, muestreo, drop y alerta, en ese orden. Consultas entre regiones implican búsqueda federada, con cada región dueña de sus datos.
16. Diseña un sistema de analítica en tiempo real
Analítica en tiempo real significa dashboards con agregados de los últimos minutos, actualizados en segundos, sobre un flujo de quizá un millón de eventos por segundo.
Un procesador de streams como Flink mantiene agregados con ventanas (por ejemplo, conteos por minuto por dimensión) y los escribe en un almacén de lectura rápida como ClickHouse o Druid. Los dashboards consultan ese almacén, nunca el stream bruto.
Nombra los trade-offs: conteos exactos frente a HyperLogLog para usuarios únicos, ventanas tumbantes vs. deslizantes y watermarks para eventos tardíos. Define un SLO de frescura y monitoriza el lag del procesador.
Una dimensión de alta cardinalidad como user ID explotará la tabla de agregados, así que consulta eventos brutos para ese caso. Rellenar tras un bug implica reproducir desde el stream con offsets retenidos.
17. Diseña un sistema de pagos
Pagos es el único diseño donde la corrección pesa más que la escala. El sistema debe cobrar, registrarlo, no cobrar dos veces, no perder registros y conciliar con el banco a diario.
La idempotencia sostiene gran parte: cada petición lleva una clave y el servicio guarda el resultado asociado y devuelve lo mismo en reintentos. El dinero se mueve en un libro mayor de doble entrada solo-adición donde cada transacción suma cero, en una base relacional con aislamiento serializable. Aquí la consistencia eventual no es la respuesta.
Las llamadas a la red de tarjetas pueden expirar con ambigüedad, así que los cargos quedan en pendiente y un job de conciliación los liquida. Multi-región implica una región de origen por cuenta, nunca escrituras activo-activo sobre el mismo saldo.
Multidivisa significa importes enteros en unidades menores con código de moneda, y un reembolso que llega antes de que el cargo se liquide se gestiona con una máquina de estados con transiciones explícitas.
18. Diseña un sistema de mensajería a gran escala
Un sistema de mensajería a gran escala permite publicar y suscribirse, sobrevive a reinicios de brokers y preserva el orden donde importa, a millones de mensajes por segundo.
Particiona cada tópico para que mensajes con la misma clave caigan en la misma partición, dando orden por clave sin orden global. Cada partición es un log append-only replicado a varios brokers, y los consumidores confirman su offset tras procesar.
Por defecto, entrega al menos una vez con consumidores idempotentes. Los reintentos van a un tópico de retry con backoff y los mensajes envenenados a una dead-letter queue. El lag del consumidor es la señal para fijar un SLO y, entre regiones, una región debe ser dueña de escrituras por clave o se reordenarán.
Un consumidor que cae tras procesar pero antes de confirmar produce un duplicado; por eso la idempotencia importa. Las tormentas de reequilibrio se calman con asignación sticky y reequilibrio cooperativo.
Preguntas de diseño de sistemas para backend engineers
Se centran en APIs, modelos de datos y límites entre servicios. Espera repreguntas sobre consistencia, caché y qué registrarías.
19. Diseña un servicio de autenticación y autorización
Autenticación responde “quién eres” y autorización “qué puedes hacer”, y gusta quien mantiene esas capas separadas.
Usa OAuth 2.0 y OpenID Connect en lugar de inventar un protocolo. Emite tokens de acceso de corta vida y refresh tokens más largos almacenados en servidor para poder revocarlos. Los permisos viven en un modelo de roles comprobado por una librería pequeña o un servicio de políticas. Registra cada intento de login, refresh y denegación con IP y dispositivo, y nunca registres los tokens.
Los JWT evitan una consulta por petición, pero revocarlos antes de tiempo requiere una denylist, que vuelve a introducir la consulta. Las intrusiones por relleno de credenciales se frenan con rate limiting por IP y por cuenta, retrasos tras fallos repetidos y un segundo factor en inicios de sesión sospechosos.
20. Diseña un API gateway
Un API gateway es un punto de entrada delante de tus servicios que se encarga del trabajo transversal para que cada servicio no tenga que hacerlo: ruteo por path y versión, terminación TLS, autenticación, rate limiting y logging de peticiones.
El gateway debe ser sin estado y escalar horizontalmente detrás de un balanceador. La configuración de rutas vive en un plano de control y se empuja a las instancias, para no redeplegar el gateway al añadir una ruta. Los tokens se validan una vez en el edge y el gateway reenvía la identidad de usuario como cabecera.
El radio de impacto es lo que hay que decir en voz alta. El gateway está en todas las rutas, así que una mala configuración tumba todo; valida configs, despliega gradualmente y mantén la lógica del gateway fina.
Versionar sin romper apps móviles que no puedes actualizar implica versionado por path o cabecera con versiones antiguas vivas. Y el gateway no debería agregar respuestas de varios servicios; eso pertenece a una capa backend-for-frontend.
21. Diseña un sistema de pedidos para un e-commerce
Un sistema de pedidos crea un pedido, reserva inventario, cobra, envía y deja ver el estado al cliente. Los pedidos son una máquina de estados (
created,paid,packed,shipped,delivered,cancelled), y las transiciones permitidas deben ser explícitas.La creación es un
POSTcon clave de idempotencia para que un doble clic no cree dos pedidos. Inventario y pago implican otros servicios, así que usa una saga: cada paso publica un evento y los fallos disparan acciones compensatorias (liberar inventario, reembolsar). Escribe el evento en una tabla outbox en la misma transacción que la actualización del pedido para que base de datos y bus de mensajes nunca discrepen.En lectura, una tabla de pedidos más
order_items, con un resumen materializado en caché para la página "mis pedidos".Dos clientes comprando la última unidad a la vez se resuelve con un bloqueo de fila o decremento atómico en inventario; uno recibirá un fuera de stock. Lo clave a monitorizar es pedidos atascados en un estado más de lo esperado.
22. Diseña un servicio de feature flags
Un servicio de feature flags activa funciones por entorno, segmenta por atributos de usuario o porcentaje y permite desactivar globalmente en segundos si algo se rompe.
Las definiciones y reglas viven en una base pequeña tras una API de administración. Las apps integran un SDK que obtiene todas las flags al arrancar, las cachea localmente y evalúa reglas en proceso, de modo que consultar una flag no cuesta nada por petición. Las actualizaciones se propagan por conexión de streaming o polling corto, y el SDK mantiene el último estado conocido si el servicio de flags cae.
Evalúa rollouts por porcentaje con un hash estable del user ID y la clave de la flag, para que la misma persona caiga siempre en el mismo lado.
Las flags obsoletas se detectan siguiendo la última evaluación y avisando a las personas dueñas, y si el servicio de flags está caído al inicio la app recurre a valores por defecto en código.
23. Diseña una API de recomendación
Una API de recomendación devuelve 20 ítems para una persona usuaria en menos de 100 ms a unos miles de RPS, y no hace falta ML profundo para diseñarla.
Separa offline y online. Un job offline calcula listas candidatas por usuario en un KV de baja latencia. La API online las recupera, reordena con señales frescas como stock, filtra lo ya comprado y devuelve. Ten un fallback de populares por categoría y registra cada lista servida con un request ID para cruzarla con clics.
Una persona nueva recibe el fallback hasta que haya algunas interacciones. Los 100 ms se reparten más o menos en 10 para la lectura, 30 para el rerank, 10 para serializar y 50 de margen.
Preguntas de diseño de sistemas para Infraestructura / DevOps
Fiabilidad, despliegue, automatización y observabilidad. El tema recurrente: cómo cambiar cosas con seguridad y saber rápido cuando te has equivocado.
24. Diseña un pipeline de CI/CD para microservicios
Un pipeline de CI/CD para microservicios debe manejar decenas de servicios desplegables de forma independiente con tests, checks de seguridad y un camino a producción que no requiera a nadie a las 3 a.m.
Compila una vez, despliega el mismo artefacto en todas partes. El pipeline lintéa, ejecuta tests unitarios, construye una imagen de contenedor etiquetada con el SHA del commit, la escanea y la sube al registro. El despliegue promueve esa imagen por entornos (dev, staging, producción) usando configuración, no recompilando.
El despliegue a producción debe ser progresivo: canario a un pequeño porcentaje de tráfico, observa tasa de errores y latencia un tiempo definido y continúa o revierte automáticamente. Revertir es redeplegar la etiqueta anterior, rápido precisamente porque no recompilaste.
Cuando un cambio en el servicio A rompe el contrato de B, la solución son contract tests en CI y cambios de API retrocompatibles. Monorepo versus multi-repo importa menos de lo que se cree, mientras el pipeline solo construya lo que ha cambiado.
25. Diseña monitorización y alertas centralizadas
La monitorización centraliza métricas, logs y trazas de todos los servicios en un lugar, con alertas que despiertan solo cuando hay impacto en usuarios.
Las métricas van a una serie temporal, los logs a la plataforma de la pregunta 15, las trazas a su backend, todo correlacionado por un request ID compartido. La decisión importante es sobre qué alertar. Alerta sobre síntomas (tasa de errores, percentiles de latencia, saturación) ligados a SLOs, no sobre causas como "CPU al 80%".
La fatiga por pagers mata las guardias, así que cada página necesita runbook y revisión. Cualquier alerta que dispare dos veces en una semana sin acción clara baja a ticket.
Un SLO para un servicio nuevo sale de medir un par de semanas y fijar un objetivo ligeramente mejor que el actual. Y cuando la monitorización cae, checks sintéticos externos y un dead-man’s switch te avisan.
26. Diseña un enfoque de gestión de secretos
La gestión de secretos hace que contraseñas de base de datos, claves de API y certificados estén disponibles en tiempo de ejecución, nunca en código fuente, rotados con regularidad y auditados.
Un almacén central (HashiCorp Vault, el gestor del cloud) guarda todo. Los servicios se autentican con su identidad de workload (service account de Kubernetes, rol IAM), nunca con un token de larga vida, y obtienen secretos al arrancar o bajo demanda. Prefiere secretos dinámicos: el almacén genera credenciales de base válidas una hora y la rotación es gratis.
Audita cada lectura. Y documenta un camino de emergencia cuando el almacén de secretos caiga, porque pasará.
Una clave que una persona desarrolladora comete por error se detecta con escaneo en CI, se rota de inmediato y se trata como comprometida. Secretos en variables de entorno son comunes pero se filtran por volcados y procesos hijos; móntalos como ficheros o recógelos en proceso.
27. Diseña autoescalado y una estrategia de despliegue
Autoescalado y despliegue juntos deben permitir manejar picos diarios de 5x sin intervención manual mientras se despliega varias veces al día.
Escala con una señal que refleje el dolor de usuario, normalmente tasa de peticiones o latencia por instancia, no solo CPU. Fija réplicas mínimas para que un arranque en frío no encare un pico y un máximo para que un bug no te arruine. Escala rápido hacia arriba y lento hacia abajo.
Para desplegar, usa blue/green cuando quieras cambio y rollback instantáneos, y canario cuando quieras observar tráfico real en un trozo pequeño primero. Combina canario con el autoescalador con cuidado, porque un canario que escala por su cuenta sesga la comparación.
Si el escalado se queda dos minutos corto ante un pico súbito, escalado predictivo por horario o un mínimo más alto cubren el hueco. Y 50 instancias nuevas agotando conexiones a la base es por lo que el pooling debe ir en una capa proxy.
Preguntas de diseño de sistemas para data engineers
Pipelines, formatos de almacenamiento, batch vs. streaming y si los datos son de fiar. El mismo marco de antes, pero los fallos van de datos perdidos, duplicados o tardíos más que de peticiones perdidas.
28. Diseña un pipeline de ingesta de eventos
Un pipeline de ingesta toma eventos de comportamiento de web y móvil y los hace consultables en una hora. Asume 50.000 eventos por segundo en pico, con clientes que se desconectan y reintentan.
Los clientes agrupan eventos con un SDK y publican a un collector que valida contra un registro de esquemas y escribe a un stream (Kafka o gestionado). Un consumidor aterriza eventos brutos en almacenamiento de objetos particionado por hora, en formato columnar como Parquet. Los trabajos downstream leen de ahí.
Los reintentos implican duplicados, así que cada evento lleva un UUID generado en cliente y el job de aterrizaje deduplica en una ventana. Cambios de esquema pasan por el registro con comprobaciones de compatibilidad, porque una app móvil antigua seguirá enviando la forma vieja durante meses.
Un evento con timestamp de hace tres días aterriza por hora de llegada, mantiene su hora de evento como columna y deja que downstream decida. Los eventos malos van a una ruta de dead-letter y nunca se descartan en silencio.
29. Diseña un sistema de ETL en streaming
ETL en streaming transforma eventos al llegar, los une con datos de referencia y escribe resultados a un almacén de servicio en segundos.
Un procesador de streams lee del tópico de ingesta, aplica transformaciones y enriquece con datos de referencia cargados en memoria y refrescados periódicamente. El estado (para joins en ventana o agregaciones) hace checkpoint a almacenamiento duradero para que un job caído no reprocesa desde el principio.
El trade-off que quieren oír: exactly-once vs. at-least-once. Exactly-once es lograble extremo a extremo si el sink soporta transacciones o escrituras idempotentes, pero cuesta latencia y complejidad. At-least-once con sinks idempotentes te da casi todo el beneficio.
Los datos tardíos se gestionan con watermarks y un periodo de gracia definido, tras el cual van a una tabla de late-arrivals.
Datos de referencia que cambian en medio del stream deben versionarse, con el join en la versión válida al tiempo del evento. Un backfill seis meses después de corregir lógica se reproduce desde almacenamiento bruto en batch, no por el stream.
30. Diseña un data warehouse y un enfoque de modelado
Un warehouse debe dar métricas coherentes en analistas y dashboards de ventas, marketing y producto, con historial preservado.
Aterriza datos brutos intactos en bronce, límpialos y conforma en plata y construye tablas de negocio en oro. Modela oro como esquema en estrella: tablas de hechos al grano más fino útil (una fila por línea de pedido, por ejemplo) y dimensiones de clientes, productos, fechas. Dimensiones lentamente cambiantes con Tipo 2 donde importe el historial, para que un cambio de región de cliente no reescriba los ingresos del año pasado.
Particiona hechos grandes por fecha, agrupa por columnas de filtro y guarda transformaciones en control de versiones (dbt o equivalente) con tests.
Cuando dos equipos definen “cliente activo” distinto, una capa de métricas con una definición única lo resuelve. Un hecho tardío que referencia una clave de dimensión aún no presente obtiene una fila placeholder que se rellena más tarde.
31. Diseña un feature store
Un feature store calcula features una vez y las reutiliza para entrenamiento y predicción online sin sesgo entre entrenamiento/serving, y aquí nos quedamos en alto nivel. Son dos almacenes con una definición: el offline (un warehouse o lake) guarda el historial para sets de entrenamiento, y el online (Redis, DynamoDB) guarda el último valor por entidad para consultas de baja latencia en predicción.
Una única definición de feature gobierna ambos, y un job materializa de offline a online en un horario.
El concepto crítico es el point-in-time correctness. Al construir el set de entrenamiento, cada fila debe usar valores de features como existían en su timestamp, no los actuales. Si no, tu modelo aprende del futuro y luce genial hasta que se despliega.
Una feature cara de calcular en tiempo real se precomputa con cierta obsolescencia o se calcula en escritura. Para verificar que online y offline coinciden, muestrea y compara, y registra las features realmente servidas.
32. Diseña una capa de calidad y linaje de datos
Una capa de calidad y linaje detecta datos rotos antes que los dashboards y responde “de dónde sale esta columna” sin leer código.
Los checks de calidad corren como pasos del pipeline: conteos de filas en rangos esperados, tasas de nulos, frescura (si la partición llegó a tiempo) y algunas aserciones de negocio (los ingresos nunca son negativos). Los fallos bloquean jobs downstream y alertan a la persona dueña. Guarda resultados en el tiempo para ver deriva, no solo el OK de hoy.
El linaje se captura del código de transformación (parseo de SQL o metadata del orquestador) y se guarda como grafo: de tabla a tabla y, cuando se pueda, de columna a columna. Ese grafo permite análisis de impacto cuando alguien quiere eliminar una columna.
Si los checks tardan más que el pipeline, muestrea o ejecuta los pesados en asíncrono y alerta en vez de bloquear. Linaje entre herramientas que no se hablan implica OpenLineage o anotaciones manuales, con las lagunas documentadas.
Preguntas de diseño de sistemas para Frontend / Full-Stack
Rendimiento en cliente, gestión de estado, caché y cómo el navegador habla con la API. También aparecen nociones de seguridad.
33. Diseña la arquitectura de una web de alto tráfico
Aquí, una web de alto tráfico es un sitio con mucho contenido, millones de visitantes diarios, primer pintado rápido y secciones personalizadas para usuarios con login.
Los assets estáticos van a una CDN con caché larga y nombres con hash. Las páginas iguales para todos se renderizan en servidor y se cachean en el edge; las partes personalizadas cargan en cliente tras pintar el shell. Ese híbrido mantiene bajo el time-to-first-byte sin servir datos personales obsoletos.
Las llamadas desde el cliente pasan por el gateway con tokens de corta vida. Define cabeceras de caché con intención:
Cache-Controlconstale-while-revalidatepara contenido que puede ir unos segundos atrasado yno-storepara lo personal.Para un dashboard tras login, el render en cliente suele bastar: SSR aporta poco sin SEO. Y una clave de caché que incluye por accidente la cookie de sesión hace que cada cual tenga su copia y la tasa de aciertos se hunda.
34. Diseña sincronización offline-first
Offline-first implica una app de notas o de datos de campo que funciona sin conexión y sincroniza al volver, sin perder ediciones.
Cada escritura va primero a un almacén local (IndexedDB, SQLite en móvil) y a una cola de mutaciones pendientes. Al volver la conectividad, el cliente empuja la cola en orden y tira de cambios desde su último token. Cada mutación lleva un ID de cliente y un número de secuencia para que el servidor pueda deduplicar.
Los conflictos son el quid. El último en escribir gana es simple y pierde datos. La fusión a nivel de campo cubre la mayoría.
Los CRDT dan fusiones automáticas para texto y listas a costa de complejidad; solo los usaría si la edición colaborativa es requisito real.
Una usuaria que edita en dos dispositivos offline y los reconecta aplica ambas ediciones, se marca el conflicto y la UI lo muestra. Una cola pendiente que crece a 10.000 mutaciones debe compactarse: diez ediciones al mismo campo se vuelven una.
35. Diseña actualizaciones de UI en tiempo real
Actualizaciones en tiempo real significan un dashboard o chat que reflejan cambios del servidor en un segundo para miles de usuarios concurrentes.
Elige el transporte por dirección. Server-Sent Events cuando los datos solo van del servidor al cliente (marcadores en vivo, notificaciones); WebSockets cuando el cliente también envía mucho (chat, edición colaborativa). Long polling como fallback cuando la red bloquea ambos.
En el servidor, una capa pub/sub distribuye cambios al servidor de conexiones que tenga a la usuaria. En el cliente, maneja la reconexión con backoff y reanuda desde el último event ID para que una caída no implique pérdida de actualizaciones. Acelera el render: 50 updates por segundo a un gráfico deben agruparse en pocas repintadas, no 50.
100.000 personas viendo un evento en directo es fan-out en servidor, quizá a través de una CDN que soporte streaming. Autenticar un WebSocket implica un token en el handshake inicial, revalidado periódicamente.
36. Diseña un plan de rendimiento en cliente para dashboards
El objetivo es un dashboard analítico con 20 gráficos que cargue en menos de tres segundos y siga fluido al filtrar.
No pidas 20 gráficos a la vez. Carga primero los visibles, lazy-load el resto al hacer scroll y muestra skeletons, no spinners. Preagrega en servidor para que el cliente reciba unos cientos de filas por gráfico, nunca eventos brutos.
Cacha resultados en memoria con clave por estado de filtro, para que alternar un filtro no vuelva a pedir.
Tablas con miles de filas necesitan virtualización (render solo lo visible). Cálculos pesados a un web worker para liberar el hilo principal.
Si la API es lenta y no puedes cambiarla, cacha agresivamente, muestra datos obsoletos con marca temporal y refresca en segundo plano. Errores CORS al llamar a una API nueva significan que la API debe permitir el origen del dashboard, y deberías saber explicar las preflight requests.
Preguntas de entrevistas de diseño de sistemas basadas en escenarios
Estas evalúan criterio más que arquitectura. Cambian los requisitos, producción se rompe y la persona entrevistadora quiere ver cómo priorizas.
37. El tráfico se multiplica por 10 de la noche a la mañana. ¿Qué cambia primero?
Empieza por lo que se rompe primero, y rara vez es la capa sin estado. El autoscaling maneja los web servers; la base de datos, la caché y los límites de terceros son donde todo cae.
Inmediatamente, mira las métricas de saturación (conexiones, CPU, profundidad de cola) de la base y la caché, sube el techo del autoscaler y activa cualquier reducción de carga que tengas, como desactivar funciones no críticas o servir páginas cacheadas. En un día, añade réplicas de lectura, ajusta la tasa de aciertos de caché y localiza las queries dominantes. A largo plazo, haz el sharding y las colas que venías posponiendo.
Distinguir crecimiento real de bot se reduce a patrones de petición, user agents y si las conversiones se movieron.
38. Estás tocando límites de lectura de la base. ¿Caché, réplicas o sharding?
En ese orden, normalmente. Una caché delante de las lecturas más calientes es barata y puede cortar la carga a la mitad en un día; comprueba la tasa de aciertos y el log de consultas para confirmar que las lecturas son realmente repetitivas.
Las réplicas de lectura van después cuando la mezcla de lecturas es amplia, no caliente. Añaden lag de replicación, así que cualquier ruta de read-after-write (guardar y ver de inmediato) debe ir al primario. El sharding resuelve límites de escritura más que de lectura y te cuesta consultas entre shards y una migración, así que va al final y solo cuando las dos primeras se agotan.
Si un cliente enorme en una sola tabla causa la carga, aisla ese tenant o particiona por ID de cliente.
39. Una dependencia crítica downstream es inestable. ¿Reintentos, timeouts, circuit breakers?
Todo y en el orden adecuado. Primero un timeout, porque una llamada sin timeout convierte una dependencia lenta en tu propia caída a medida que se acumulan hilos. Luego reintentos con backoff exponencial y jitter, pero solo para llamadas idempotentes y solo un par de veces, o amplificas la carga sobre un servicio ya tocado.
Luego un circuit breaker: tras un umbral de fallos, deja de llamar un tiempo y sirve un fallback (datos cacheados, respuesta degradada, error amable). Monitoriza el estado del breaker; un breaker atascado abierto es su propio incidente.
Cuando la dependencia inestable es tu proveedor de pagos, no hay fallback para el cargo; encola el pedido como pendiente y procésalo después.
40. La latencia ha empeorado tras un lanzamiento. ¿Cómo lo diagnosticas?
Primero, confirma que es real y acotado: qué percentil se movió (p50 o solo p99), qué endpoints, qué región. Compáralo con la línea temporal de despliegues; si el empeoramiento coincide con una release, revierte primero e investiga después.
Si revertir no es la respuesta, sigue la petición. Las trazas muestran qué span creció. Sospechosos comunes: una query nueva sin índice, un patrón N+1 introducido por un campo nuevo, un cambio en la clave de caché que hundió la tasa de aciertos o una llamada downstream que era asíncrona y ahora está en el camino síncrono.
Si solo se movió p99 y revertir no ayudó, busca pausas de GC, un vecino ruidoso o un lock.
41. Aparece un bug de inconsistencia de datos. ¿Qué compruebas, qué reviertes?
Acota el daño antes de tocar nada. Qué tablas o registros discrepan, desde cuándo y si sigue ocurriendo. El “desde cuándo” suele apuntar a un despliegue o a una ejecución de job.
Revisa la ruta de escritura de los registros afectados: migraciones recientes, un job que corrió dos veces, un reintento sin idempotencia, una carrera entre dos escritores. Corta la hemorragia pausando el job culpable o revirtiendo código y luego repara desde una fuente de verdad (log de eventos brutos, ledger, backup) en lugar de editar filas a mano. Deja registro de qué cambiaste y por qué.
Sin fuente de verdad para reparar, reconstruye lo que puedas, marca el resto y añade el patrón outbox para que no vuelva a pasar.
Errores comunes en entrevistas de diseño de sistemas
La mayoría falla por el mismo puñado de razones. Ninguna tiene que ver con saber menos.
Cómo prepararte para entrevistas de diseño de sistemas
La preparación funciona cuando es repetible. Aquí va un proceso que yo sí seguiría.
Conclusión
Cada pregunta de esta lista salió de un sistema que alguien tuvo que construir y mantener vivo a las 3 a.m., así que cuanto más hagas de eso, menos te parecerá una actuación la entrevista y más te sonará a describir tu martes. Monta un side project con una cola de verdad, apúntate a la rotación de guardias, pide sentarte en una revisión de diseño aunque no sea el tuyo.
Y si quieres terreno estructurado que cubrir de aquí a tu próxima entrevista, esto profundiza en las piezas que sostienen estas respuestas: